Ein n8n-Dokumentenextraktions-Workflow
der keine Dateien überspringt
Der Ausführungsverlauf meldet Success und die Tabelle ist eine Zeile zu kurz. Beides kann gleichzeitig stimmen, denn n8n meldet, dass seine Nodes zurückgekehrt sind, nicht dass die Rechnung im Ordner zu einer Zeile wurde.
Bei Rechnungsvolumen hat diese Lücke Kosten. Der State of ePayables Benchmark von Ardent Partners beziffert die durchschnittlichen Kosten für die Verarbeitung einer Rechnung auf $9.84 (Ardent Partners). Eine Datei, die nie zu einer Zeile wird, beseitigt diese Arbeit nicht. Sie verschiebt die Arbeit zu der Person, die die Tabelle abgleicht, meist Tage später, ohne Ausführungsprotokoll zur Erklärung.
Die Lösung ist kein besserer OCR-Node. Es geht darum, die Extraktion als asynchronen Job zu behandeln und um drei Momente herum zu bauen: hochgeladen, in Verarbeitung, abgeschlossen. Die Node-Sequenz unten macht das, dann folgen die vier Übergabepunkte, an denen Dateien noch verschwinden.
Wichtige Erkenntnisse
- Das grüne Häkchen in n8n bedeutet nur, dass jeder Node abgeschlossen wurde, und nichts weiter.
- Dateien verschwinden an den Übergabepunkten, nicht im Extraktionsaufruf, daher behebt ein besserer OCR-Node nichts.
- Geben Sie jedem Dokument eine Zeile, auch Fehlern, damit die Tabelle gegen den Ordner abgeglichen werden kann.
Ein grüner n8n-Lauf beweist nur, dass die Nodes zurückgegeben wurden
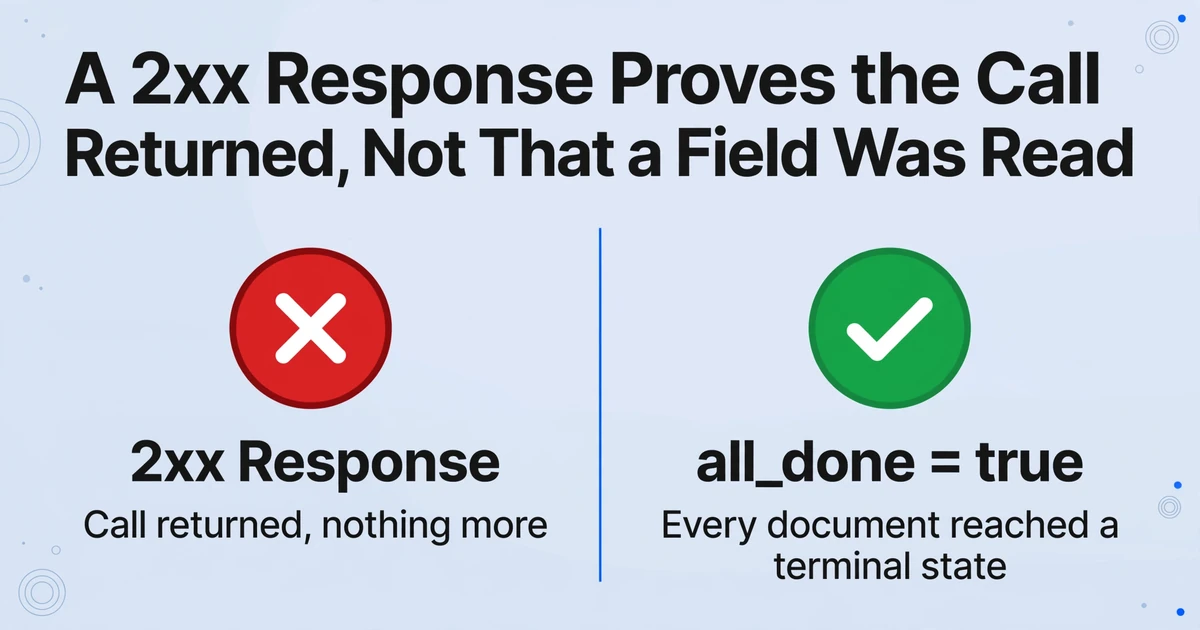
Das Häkchen in n8n bedeutet, dass jeder Node ohne Fehler abgeschlossen wurde, und eine 2xx-Antwort reicht aus, um einen HTTP Request-Node abzuschließen. Das ist alles, was es bedeutet. Der HTTP Request-Node behandelt eine Antwort als erfolgreich, wenn der Statuscode 2xx ist (n8n docs). Die Extraktions-API verwendet dasselbe Fenster für drei verschiedene Vorgänge: Ein Dokument wurde erstellt, ein Batch wurde zur Verarbeitung angenommen oder ein Ergebnis wurde gelesen. Nur der letzte ist ein Lesen extrahierter Daten.
| Aufruf | So sieht Erfolg aus | Was er beweist | Was er nicht beweist |
|---|---|---|---|
POST /api/v1/documents | 201 | Die Datei ist in einem Batch gespeichert, und ein PDF wurde in ein Dokument pro Seite aufgeteilt | Dass ein Feld gelesen wurde |
POST /api/v1/batches/{batch_name}/process | 200 | Die Verarbeitung wurde in die Warteschlange gestellt und Credits wurden für berechtigte Dokumente abgezogen | Dass die Extraktion begonnen oder abgeschlossen wurde |
GET /api/v1/batches/{batch_name} | 200 | Aktuelle Zählungen pro Status und ein all_done-Flag | Dass ein fehlgeschlagenes Dokument eine Zeile erzeugt hat |
GET /api/v1/batches/{batch_name}/results | 200 | Alles, was bisher abgeschlossen ist, als line_items | Dass jedes Dokument terminal ist, es sei denn all_done ist true |
Das Statusvokabular der API macht die Lücke deutlich: queued, processing, succeeded, failed, canceled. Ein Dokument befindet sich zu jedem Zeitpunkt in genau einem davon. Ein Batch ist erst abgeschlossen, wenn jedes Dokument einen terminalen Zustand erreicht hat, weshalb sein completed_at null bleibt, solange noch etwas in Bearbeitung ist.
Wenn Sie nach einem n8n OCR-Workflow gesucht haben, ist die Form dieselbe: ein Trigger, ein Leseschritt und ein Ziel. Der Unterschied besteht darin, dass ein n8n-Dokumentenextraktions-Workflow, der auf dieser API aufbaut, den Leseschritt als Job behandeln muss, nicht als Funktionsaufruf. Er gibt strukturiertes JSON zurück, aber erst nachdem der Batch abgeschlossen ist.
Ein 200 vom Process-Endpunkt bedeutet, dass der Batch akzeptiert wurde. Es bedeutet nicht, dass ein einziges Feld gelesen wurde.
Das ist der Fehler, der im Editor wie ein Erfolg aussieht. Der Workflow lädt hoch, ruft process auf, schreibt den Antworttext in ein Sheet und endet grün mit einer Zeile, die den Batch-Status statt Rechnungsdaten enthält. Der nächste Lauf hängt eine weitere an. Das Sheet füllt sich mit Statusmeldungen statt mit Rechnungen.
Die fünf Phasen, die einen echten Ordner überstehen
Ein Dokument-Workflow, der standhält, hat fünf Phasen, und jede hat genau eine Aufgabe: eine Datei pro Element holen, sie in einen benannten Batch hochladen, das Abschlusssignal registrieren, die Verarbeitung starten, dann Ergebnisse lesen und Zeilen schreiben.
Den Ordner auslösen, nicht die Datei
Ein Google Drive Trigger überwacht einen Ordner auf neu erstellte Dateien. Ein Gmail Trigger tut dasselbe für Anhänge, und ein Webhook-Node deckt Uploads aus einem Formular oder einem anderen System ab. Normalisieren Sie die Ausgabe auf ein Element pro Datei mit file_id, filename und mime_type. Gehen Sie nicht davon aus, dass das Ereignis nur eine Datei enthält.
Jede Datei in einen benannten Batch hochladen
Verwenden Sie einen HTTP Request-Node, um POST https://imagetotable.ai/api/v1/documents als Multipart-Formulardaten zu senden. Senden Sie die Binärdatei in file, einen batch_name für diesen Lauf und optional eine template_id. Fügen Sie Authorization: Bearer <api_key> hinzu, gespeichert in einer n8n Header Auth-Anmeldeinformation statt in den Node eingefügt, sowie einen Idempotency-Key, der aus der Drive-Datei-ID abgeleitet wird. Ein Batch ist die Einheit, mit der Sie die Verarbeitung starten: Uploads sammeln sich an, dann startet ein Aufruf sie alle. Eine PDF wird zu einem Dokument pro Seite, daher ist ihre document_id ein Array; ein einzelnes Bild gibt einen String zurück.
Den Abschluss-Callback registrieren
Rufen Sie vor der Verarbeitung PUT /api/v1/batches/{batch_name}/webhook mit einer callback_url auf. Ein Batch-Webhook ist ein HTTP POST, den die API an diese URL sendet, wenn jedes Dokument im Batch einen Endzustand erreicht. Die Produktions-URL eines festen n8n Webhook-Node ist die dauerhafte Wahl; die $execution.resumeUrl des Wait-Node funktioniert für einen interaktiven Lauf. Speichern Sie das webhook_secret für die Signaturprüfung. Eine Registrierung nach der Verarbeitung ist ein Wettlauf, den Sie bei kleinen Batches verlieren werden.
Verarbeitung mit definierten Spalten starten
Rufen Sie POST /api/v1/batches/{batch_name}/process mit einer template_id oder einem fields-Array auf. Das fields-Array ist der Ort, an dem Custom Column Extraction konfiguriert wird: Jeder Name wird zu einer Kopfzeile, und die KI findet den Wert anhand der Bedeutung statt der Position. Bei Rechnungen könnte dieses Array vendor, invoice_number, invoice_date und total benennen. Das ermöglicht es, dass Rechnungen verschiedener Lieferanten in denselben Spalten landen. Die Antwort meldet queued und webhook_registered, keine extrahierten Daten.
Ergebnisse lesen und eine Zeile pro Dokument schreiben
Rufen Sie nach dem Callback oder wenn all_done true ist GET /api/v1/batches/{batch_name}/results auf. Jeder Eintrag in documents enthält document_id, filename, status und line_items, das Array der extrahierten Zeilen für dieses Dokument. Erweitern Sie jedes line_item zu einer Tabellenzeile, übernehmen Sie die Metadaten und schreiben Sie mit Google Sheets Append or Update.
Eine gespeicherte Vorlage enthält die Spaltennamen und Merge-Einstellungen; ein ad hoc fields-Array enthält sie für einen Batch. Multi-Page Merge ist die Vorlageneinstellung, die Seiten eines logischen Dokuments zu einem einzigen Datensatz gruppiert. Wenn eine Rechnung als mehrere Seiten eintrifft und diese Einstellung aktiv ist, fügt ?merge=true zu results sie zu einem Eintrag mit source_document_ids zusammen. Ohne sie kann jede Seite zu einer eigenen Zeile werden.
Dateien werden sicher verarbeitet und nicht gespeichert.
Der Callback muss registriert sein, bevor der Batch abgeschlossen ist
Der häufigste Webhook-Fehler ist die Reihenfolge: Der Batch wird zuerst verarbeitet und der Callback erst danach registriert. Ein Batch, der in Sekunden fertig ist, schließt also ab, bevor es überhaupt ein Ziel für die Benachrichtigung gibt. Das Abschlussereignis ist ein Hinweis, nicht die Daten. Es enthält batch_name, status und document_count. Die line_items erhalten Sie weiterhin über den Results-Endpunkt. Der Callback muss den Workflow nur aufwecken, aber er muss ankommen.
Es gibt zwei Wege, ihm ein Ziel zu geben. Der robuste ist ein zweiter Workflow, der mit einem Webhook-Node unter einer festen URL startet. Registrieren Sie diese URL bei jedem Batch. Wenn der Callback ausgelöst wird, lesen Sie batch_name, verifizieren die Signatur, holen die Ergebnisse und schreiben die Zeilen. Der hochladende Workflow kann abschließen; nichts bleibt pausiert, und ein Neustart verliert keinen Ausführungszustand.
Der bequeme ist ein Wait-Node, der auf Webhook-Aufruf fortgesetzt wird. n8n stellt $execution.resumeUrl bereit, generiert die URL zur Laufzeit und macht sie für jede Ausführung eindeutig. Wenn der Workflow pausiert, lagert n8n seine Ausführungsdaten in der Datenbank aus und lädt sie wieder, wenn der Aufruf eintrifft (n8n Wait node docs). Das ist in Ordnung für eine Ausführung, die einen Batch besitzt. Es ist fragil, wenn der Workflow bearbeitet wird, die Ausführung bereinigt wird oder der Callback zu spät eintrifft.
Die Zustellung wird sofort versucht, dann nach 1 Minute, 5 Minuten, 30 Minuten, 2 Stunden, 6 Stunden und 24 Stunden erneut, bis zu sieben Versuche. Ein 500 von einem neu startenden n8n ist wiederherstellbar; eine Resume-URL, die nicht mehr existiert, ist es nicht. Das ist das Argument für den festen Endpunkt, wenn die Pipeline wichtig ist.
Antworten Sie schnell, aber bedenken Sie, was ein schnelles 200 kostet. Ein Nicht-2xx veranlasst die API zu erneutem Versuch, sodass ein langsames Schreiben in das Sheet innerhalb des Callbacks doppelte Zustellungen erzeugen kann. Ein 200, das gesendet wird, bevor die Zeilen geschrieben sind, bedeutet, dass ein Absturz nach der Antwort nie erneut versucht wird. Erfassen Sie zuerst batch_name, antworten Sie mit 200, schreiben Sie dann, und lassen Sie einen n8n Error Workflow das fehlgeschlagene Schreiben übernehmen.
Jede Zustellung enthält webhook-id, webhook-timestamp und webhook-signature, gemäß der Standard Webhooks-Spezifikation. Verifizieren Sie den HMAC über den rohen Request-Body, bevor Sie batch_name vertrauen, und holen Sie dann die Ergebnisse. Das Secret ist ein einfacher Hex-String, verwenden Sie es also als rohe HMAC-Key-Bytes; ein whsec_-bewusster Verifier dekodiert es und schlägt fehl. Ein Callback, der die Verifizierung überspringt, ist eine unauthentifizierte Anweisung, Zeilen zu schreiben.
Die Payload sagt Ihnen, dass ein Batch abgeschlossen ist. Der Results-Endpunkt sagt Ihnen, was er produziert hat. Behandeln Sie das Erste niemals als das Zweite.
Vier Übergabepunkte, an denen eine Datei verschwindet
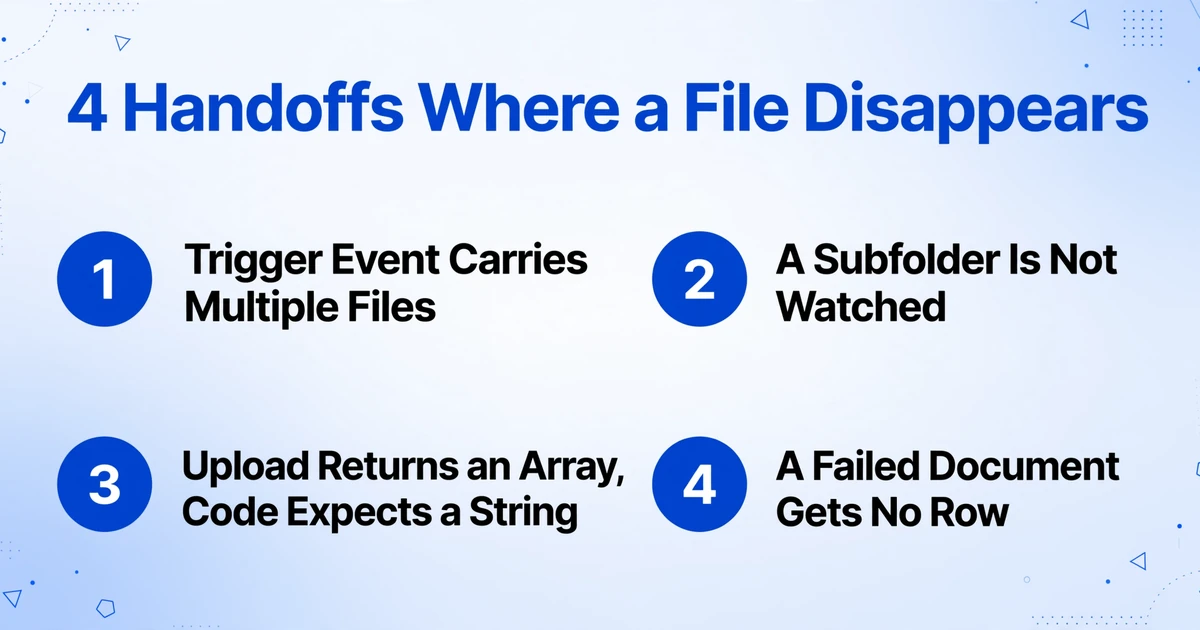
Jeder stille Fehler in einer n8n-Dokumentpipeline entsteht an einem Übergabepunkt, nicht im Extraktionsaufruf. Die Extraktion liefert ein Ergebnis oder einen Fehlerstatus zurück. Die Datei geht verloren, bevor sie dort ankommt, oder nachdem sie zurückkommt.
Das Trigger-Ereignis enthält mehr als eine Datei. Der Google Drive Trigger fragt standardmäßig einmal pro Minute ab, und mehrere Änderungen innerhalb dieses Intervalls kommen als ein einzelnes Ereignis mit mehreren Elementen an (n8n docs). Eine manuelle Ausführung liefert das letzte passende Ereignis zurück, sodass ein Test mit einer Datei dies nie reproduziert. Ein Node, der auf das erste Element des Triggers statt auf das aktuelle verweist, oder ein HTTP Request-Node mit aktiviertem Execute Once lädt die erste Datei hoch und verwirft den Rest. Kein Node schlägt fehl, weil die anderen Elemente nie adressiert wurden. Schleifen Sie über die Ausgabe, ein Upload pro Element, und protokollieren Sie zuerst die file_id.
Ein Unterordner ist der zweite Ort, an dem Dateien verschwinden. Der Trigger überwacht einen Ordner. Änderungen in dessen Unterordnern lösen ihn nicht aus, sodass ein Team, das Rechnungen nach Monat oder Anbieter ablegt, nur sieht, was im Stammverzeichnis landet. Machen Sie diesen Ordner zum einzigen Eingangspunkt, oder fügen Sie eine geplante rekursive Suche in denselben Upload-Zweig hinzu. Wenn die Dateien von außerhalb des Teams kommen, deckt der Workflow zur Dokumentenerfassung und -extraktion diesen Eingang ab.
Der Upload liefert ein Array zurück und der Workflow erwartet einen String. Aus einem mehrseitigen PDF wird ein Dokument pro Seite. Seine document_id ist ein Array in Seitenreihenfolge; ein einzelnes Bild liefert einen String. Code, der einen String annimmt, schreibt undefined in die Zeile und kann das Dokument nicht nachschlagen. Verzweigen Sie anhand der Form der Antwort, führen Sie page_count mit und behandeln Sie jede Seite als eigenes Element. Wenn die Seiten zu einer Rechnung gehören, konfigurieren Sie Multi-Page Merge und hängen Sie ?merge=true an results an, damit sie als ein Eintrag zurückkommen.
Ein Dokument kann innerhalb eines ansonsten erfolgreichen Batches fehlschlagen. Der Callback meldet failed oder canceled, wenn der Batch nicht vollständig erfolgreich war, aber das results-Array enthält weiterhin die Dokumente, die erfolgreich waren. Ein Workflow, der line_items schreibt, ohne status zu prüfen, schreibt die guten Zeilen und verwirft die fehlerhafte. Die Tabelle sieht vollständig aus, weil sie Zeilen hat; die Ordneranzahl stimmt nicht überein. Schreiben Sie eine Zeile für jedes Dokument, auch für fehlgeschlagene, mit filename, document_id und status. Die results-Nutzlast liefert den Status; der Konto-Ereignis-Feed (GET /events) fügt ein document.failed-Ereignis mit einem error-Feld für die Prüfwarteschlange hinzu.
Ein Retry fügt eine zweite Zeile hinzu, weil n8n At-Least-Once ist
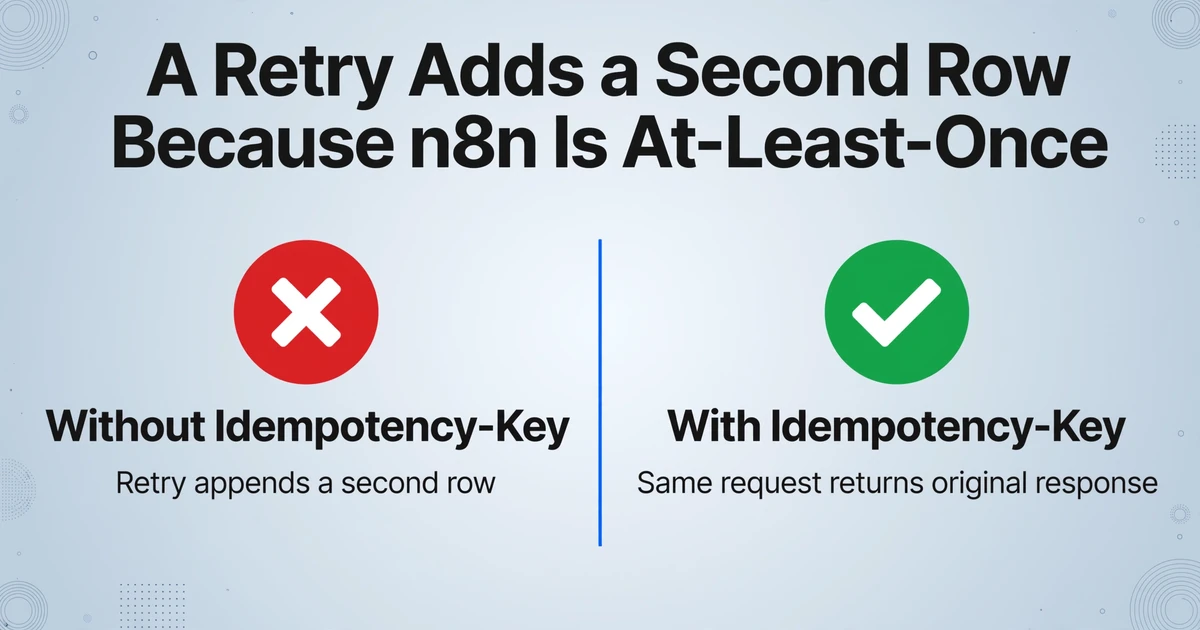
n8n-Retries sind At-Least-Once: Ein Retry spielt gespeicherte Ausführungsdaten erneut ab, aber jeder Side-Effect-Node nach dem Fehlerpunkt kann erneut ausgeführt werden, und die Plattform bietet keine integrierte Exactly-Once-Garantie (n8n-Community-Diskussion). Der Upload erstellt ein Dokument und verbraucht Credits; das Anhängen an das Sheet erstellt eine Zeile. Ein Retry nach einem Timeout kann eines von beidem wiederholen.
Auf API-Ebene akzeptieren POST /documents und POST /batches/{batch_name}/process einen Idempotency-Key, der pro Konto, Schlüsselwert und Endpunkt 24 Stunden lang gespeichert wird. Dieselbe Anfrage mit demselben Schlüssel liefert die ursprüngliche Antwort zurück, ohne ein zweites Dokument zu erstellen oder Credits doppelt abzuziehen. Eine andere Anfrage unter demselben Schlüssel liefert einen 400-Fehler. Leiten Sie den Schlüssel aus der Quelldatei ab, nicht aus dem Versuch: die Drive-Datei-ID oder <file_id>:<modified_time>, wenn eine ersetzte Datei als neu gelten soll. Eine zufällige UUID pro Versuch macht den Mechanismus zunichte.
Auf Sheet-Ebene hilft der API-Schlüssel nicht. Wenn der Workflow drei Zeilen geschrieben hat und dann bei der vierten fehlgeschlagen ist, kann der Retry die ersten drei erneut anhängen. Verwenden Sie in Google Sheets Append or Update mit einer stabilen dedupe_key-Spalte: vendor + invoice_number, wenn beide vorhanden sind, document_id, wenn nicht. Gleichen Sie auf dieser Spalte ab. Das erfasst sowohl denselben erneut versuchten Upload als auch dieselbe Rechnung, die als neue Datei eintrifft – zwei verschiedene Duplikate.
Nebenläufigkeit ist das zweite Sheet-Problem. Die Google-Sheets-Append-API ist nicht atomar, und gleichzeitige Schreibvorgänge können auf derselben Zeile landen; ein Community-Thread beschreibt grüne n8n-Ausführungen, bei denen der Geschäftsdatensatz fehlt (n8n-Community). Halten Sie einen einzigen Schreiber: ein Batch nach dem anderen, Anhänge in Reihenfolge, kein Fan-out am Sheet-Node.
Ein Idempotency-Key schützt den Upload. Er schützt nicht die Tabellenkalkulation.
Das Sheet sollte ein Prüfpfad sein, kein Erfolgsprotokoll
Ein Sheet, das nur erfolgreiche Zeilen erhält, kann Ihnen nicht sagen, was der Workflow übersehen hat. Geben Sie jedem Dokument eine Zeile, auch den fehlgeschlagenen, und fügen Sie die Metadaten hinzu, die die Zeile nachvollziehbar machen: batch_name, document_id, source_filename, status und processed_at, zusammen mit den extrahierten Feldern wie Lieferant, Rechnungsnummer, Datum und Gesamtbetrag.
Diese Spalten ermöglichen den Abgleich. In einer Kopftabelle kann der Kreditorenbuchhalter nach Batch filtern, sehen, dass der Batch 47 Dokumente meldet und das Sheet 47 Zeilen hat, und die zwei finden, die failed anzeigen, statt sich zu fragen, warum die Summe nicht stimmt. Ohne sie kann nur die Person das Sheet erklären, die den Workflow gebaut hat.
Wenn die Vorlage Positionen extrahiert, erzeugt ein Dokument mehrere line_items. Entscheiden Sie vor dem Aufbau, ob das Sheet eine Kopftabelle ist, eine Zeile pro Rechnung, oder eine Positionstabelle, eine Zeile pro Position mit wiederholten Kopffeldern. Beides ist gültig; eine Mischung erzeugt ein Sheet, in dem Summen doppelt zählen, was wie ein Extraktionsfehler aussieht.
Die nachgelagerte Ebene ist ein separates Design. Sobald die Zeilen nachvollziehbar sind, stellt sich die Frage, was das Sheet speisen muss: Zahlungsplanung, ein Lieferantenbuch oder einen Abgleich. Die Lieferantenrechnungs-Pipeline in die Kreditorenbuchhaltung deckt diese Ebene ab. Der n8n-Job endet, wenn die Zeile geschrieben und nachvollziehbar ist, nicht wenn der HTTP-Aufruf zurückkehrt.
Bei Zeilen, die falsch aussehen, hebt Review Mode in der Web-App den Quellbereich auf der Originalseite hervor, wenn Sie auf eine Zelle klicken, sodass die Person, die einen Betrag prüft, sehen kann, woher er stammt, ohne das PDF erneut zu öffnen. Das ist eine manuelle Prüfung. Die Aufgabe des Workflows ist es, die verdächtige Zeile an eine Person weiterzuleiten, nicht die Zahl zu bestätigen.
Was dieser Workflow trotzdem selbst übernehmen muss
Es gibt keinen offiziellen n8n-Node für ImageToTable.ai, und der Workflow muss Authentifizierung, Wiederholungsversuche und fehlgeschlagene Dateien selbst handhaben. Die v1-API ist eine REST-Schnittstelle, der generische HTTP Request-Node ist also die Integration.
Der Trigger gehört zu n8n. Der Google Drive-, Gmail- oder Webhook-Node ist keine ImageToTable-Funktion, und es gibt keinen ImageToTable-Button, der einen Ordner überwacht. Der Workflow muss trotzdem entscheiden, welche Dateien neu sind und welche bereits verarbeitet wurden.
Die Retry-Richtlinie ist das Nächste, was Sie selbst verantworten. Die API wiederholt die Webhook-Zustellung und akzeptiert Idempotency-Keys. Ein fehlgeschlagenes Dokument erneut zu versuchen, es zu markieren oder eine Person zu fragen, ist Ihre Entscheidung. Ein pauschaler Retry bei einem 400 kostet Zeit und behebt die Datei nicht.
Harte Limits gehören zum Design. Ein PDF ist auf 50 Seiten pro Upload begrenzt, jeder Plan hat eine Batch-Kapazität, die als remaining_batch_capacity zurückgegeben wird, und Status-Endpunkte sind auf 120 Anfragen pro Minute begrenzt. Ein 60-seitiges PDF ist ein 400, kein Teilerfolg, und eine Polling-Schleife, die das Limit ignoriert, verbringt ihre Zeit mit 429ern.
Es extrahiert; es genehmigt nicht, gleicht keine Bestellungen ab und bucht nichts in ein ERP. Der Workflow braucht trotzdem eine Regel, was als doppelte Rechnung zählt, wer einen Betrag genehmigt und welches System den endgültigen Datensatz erhält. Das sind Geschäftsentscheidungen, keine Extraktionseinstellungen.
Die Genauigkeit ist bei gedruckten Tabellen hoch und bei schlechten Scans nicht perfekt. Unsere eigene Zahl liegt bei bis zu 99 % Erkennung bei gedruckten Tabellendaten, und eine Seite wird typischerweise in 5-10 Sekunden verarbeitet. Das ist die Verarbeitungszeit pro Seite, nicht die Ende-zu-Ende-Latenz: Ein Batch wartet auf sein langsamstes Dokument, und das Callback- oder Polling-Intervall kommt obendrauf. Leiten Sie unsichere Beträge an eine Person weiter, statt sie in die Tabelle einzumitteln.
Wenn das Team gar nicht auf n8n ist, zeigt die No-Code-Screenshot-Pipeline denselben Übergabepunkt ohne Workflow-Engine.
Häufig gestellte Fragen
Gibt es einen offiziellen n8n-Node für ImageToTable.ai?
Nein. Sie verbinden sich über die v1-API mit einem HTTP Request-Node: hochladen mit POST /documents, starten mit POST /batches/{batch_name}/process und auslesen mit GET /batches/{batch_name}/results. Die API übernimmt die Extraktion; n8n übernimmt Trigger, Wiederholungen und Routing.
Kann n8n einen Google Drive-Ordner überwachen und nur neue Dateien verarbeiten?
Ja, mit dem Google Drive Trigger-Node. Er fragt standardmäßig einmal pro Minute ab, überwacht einen Ordner und kann mehrere neue Dateien zu einem Ereignis bündeln. Der Workflow muss die Elemente durchlaufen, und er kann nicht davon ausgehen, dass Unterordner enthalten sind. Wenn der Workflow selbst in denselben Ordner schreibt, legen Sie die verarbeiteten Dateien an einem separaten Ort ab, damit der Schreibvorgang nicht zum nächsten Trigger wird.
Sollte ich den Webhook verwenden oder den Batch-Status abfragen?
Verwenden Sie den Webhook, wenn der Workflow sofort fortgesetzt werden soll und Sie eine stabile URL bereitstellen können. Fragen Sie GET /batches/{batch_name} ab, wenn ein einfacherer Workflow wichtiger ist als die Latenz: Prüfen Sie all_done und bleiben Sie unter 120 Anfragen pro Minute. Ein kleiner Batch ist oft vor dem ersten Abfrageintervall fertig, sodass die Abfrage Latenz hinzufügt, statt Arbeit zu sparen.
Wie verhindere ich doppelte Zeilen, wenn ein Workflow wiederholt wird?
Setzen Sie einen Idempotency-Key auf POST /documents und POST /process, abgeleitet aus der ID der Quelldatei. Machen Sie dann das Schreiben in das Sheet idempotent mit Append or Update, basierend auf document_id, plus einem Geschäftsschlüssel wie Lieferant und Rechnungsnummer für Dateien, die unter einer neuen ID erneut hochgeladen werden. Der API-Schlüssel deckt den API-Aufruf ab; das Sheet braucht seinen eigenen Schutz.
Was passiert mit einem Dokument, dessen Extraktion fehlschlägt?
Es erreicht failed, der Callback meldet failed, und das Ergebnis-Array enthält dieses Dokument mit einem leeren line_items-Array. Schreiben Sie eine Zeile dafür mit Dateiname und Status, damit die Anzahl im Sheet mit der Anzahl im Ordner übereinstimmt. Das document.failed-Ereignis des Ereignis-Feeds enthält ein error-Feld, das Sie an eine Prüfwarteschlange weiterleiten können.
Ein zuverlässiger Workflow hinterlässt für jede Datei eine Spur
Ein Dokument-Workflow ist nicht zuverlässig, weil er nie fehlschlägt. Er ist zuverlässig, weil jede eingehende Datei eine Spur hinterlässt – auch die, die fehlschlägt: eine document_id, ein Batch-Name, ein Status und eine Zeile, die eine Person finden kann. Der Extraktionsaufruf ist der einfache Teil; die Designarbeit sind die vier Übergabepunkte darum herum.
Wenn der Ordner und die Spalten bereits vorhanden sind, testen Sie das Design, indem Sie eine Rechnung über die API senden, bevor Sie den Callback und den Idempotency-Key verdrahten. Die Antwort zeigt Ihnen, was der Rest des Workflows empfangen wird.
Wenn die Dokumente über ein Formular statt über einen Ordner eingehen, setzt die Formular-Extraktionspipeline bei der Übermittlung an.