Un flujo de trabajo de extracción de documentos en n8n
que no omite archivos
El historial de ejecución dice Success y la hoja de cálculo tiene una fila menos. Ambas cosas pueden ser ciertas a la vez, porque n8n informa que sus nodos finalizaron, no que la factura de la carpeta se convirtió en una fila.
Con volumen de facturas, esa brecha tiene un costo. El benchmark State of ePayables de Ardent Partners sitúa el costo promedio de procesar una factura en $9.84 (Ardent Partners). Un archivo que nunca se convierte en fila no elimina ese trabajo. Lo traslada a quien concilia la hoja, normalmente días después, sin un registro de ejecución que lo explique.
La solución no es un mejor nodo de OCR. Es tratar la extracción como un trabajo asíncrono y construir en torno a tres momentos: subido, procesando, finalizado. La secuencia de nodos a continuación hace eso, y luego los cuatro traspasos donde los archivos aún desaparecen.
Puntos clave
- La marca de verificación verde en n8n solo significa que todos los nodos finalizaron, y eso es todo lo que significa.
- Los archivos desaparecen en los traspasos, no dentro de la llamada de extracción, así que un mejor nodo de OCR no arregla nada.
- Dele una fila a cada documento, incluidos los fallos, para que la hoja se pueda contar contra la carpeta.
Una ejecución verde de n8n solo demuestra que los nodos devolvieron respuesta
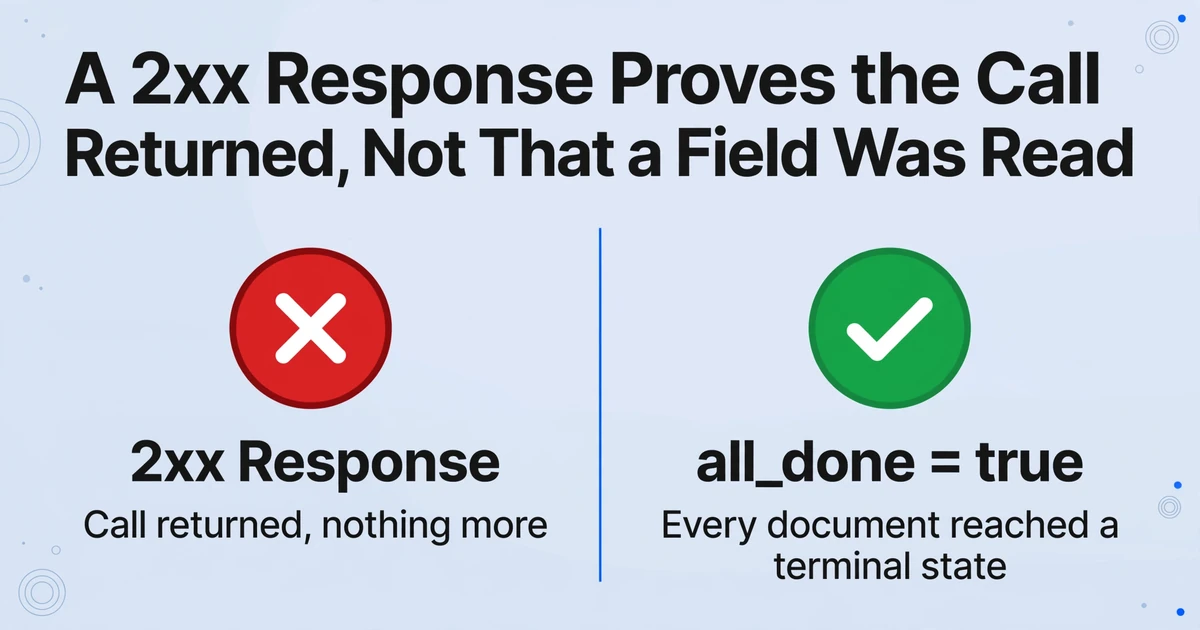
La marca de verificación en n8n significa que cada nodo terminó sin lanzar errores, y una respuesta 2xx basta para completar un nodo HTTP Request. Eso es todo lo que significa. El nodo HTTP Request considera una respuesta exitosa cuando el código de estado es 2xx (n8n docs). La API de extracción usa esa misma ventana para tres operaciones distintas: se creó un documento, se aceptó un lote para procesamiento, o se leyó un resultado. Solo la última es una lectura de datos extraídos.
| Llamada | El éxito se ve así | Qué demuestra | Qué no demuestra |
|---|---|---|---|
POST /api/v1/documents | 201 | El archivo está almacenado en un lote, y un PDF se ha dividido en un documento por página | Que se haya leído algún campo |
POST /api/v1/batches/{batch_name}/process | 200 | El procesamiento se puso en cola y se descontaron Credits para los documentos elegibles | Que la extracción haya comenzado o terminado |
GET /api/v1/batches/{batch_name} | 200 | Recuentos actuales por estado y un indicador all_done | Que un documento fallido haya producido una fila |
GET /api/v1/batches/{batch_name}/results | 200 | Todo lo que se haya completado hasta el momento, como line_items | Que todos los documentos estén en estado terminal, a menos que all_done sea true |
El vocabulario de estados de la API hace explícita la brecha: queued, processing, succeeded, failed, canceled. Un documento está en exactamente uno de ellos en cualquier momento. Un lote está completo solo cuando todos los documentos han alcanzado un estado terminal, por eso su completed_at permanece null mientras algo siga en curso.
Si buscó un flujo de trabajo OCR en n8n, la forma es la misma: un disparador, un paso de lectura y un destino. La diferencia es que un flujo de trabajo de extracción de documentos en n8n construido sobre esta API tiene que tratar el paso de lectura como un trabajo, no como una llamada a función. Devuelve JSON estructurado, pero solo después de que el lote termina.
Un 200 del endpoint de proceso significa que el lote fue aceptado. No significa que se haya leído un solo campo.
Este es el fallo que parece un éxito en el editor. El flujo de trabajo se sube, llama a process, escribe el cuerpo de la respuesta en una hoja y termina en verde con una fila que contiene el estado del lote en lugar de los datos de la factura. La siguiente ejecución añade otra. La hoja se llena de mensajes de estado en lugar de facturas.
Las cinco etapas que sobreviven a una carpeta real
Un flujo de trabajo de documentos que resiste tiene cinco etapas, y cada una tiene una única función: obtener un archivo por elemento, subirlo a un lote con nombre, registrar la señal de finalización, iniciar el procesamiento y luego leer los resultados y escribir las filas.
Active la carpeta, no el archivo
Un Google Drive Trigger vigila una carpeta en busca de archivos creados. Un Gmail Trigger hace lo mismo con los archivos adjuntos, y un nodo Webhook cubre las cargas desde un formulario u otro sistema. Normalice la salida a un elemento por archivo con file_id, filename y mime_type. No asuma que el evento incluye un solo archivo.
Cargue cada archivo en un lote con nombre
Use un nodo HTTP Request para POST https://imagetotable.ai/api/v1/documents como multipart form-data. Envíe el binario en file, un batch_name para esta ejecución y, opcionalmente, un template_id. Añada Authorization: Bearer <api_key>, almacenado en una credencial Header Auth de n8n en lugar de pegarlo en el nodo, y un Idempotency-Key derivado del id del archivo de Drive. Un lote es la unidad con la que inicia el procesamiento: las cargas se acumulan y luego una sola llamada las inicia todas. Un PDF se convierte en un documento por página, por lo que su document_id es un array; una sola imagen devuelve una cadena.
Registre la devolución de llamada de finalización
Antes de procesar, llame a PUT /api/v1/batches/{batch_name}/webhook con un callback_url. Un webhook de lote es un HTTP POST que la API envía a esa URL cuando cada documento del lote alcanza un estado terminal. La URL de producción de un nodo Webhook fijo de n8n es la opción duradera; el $execution.resumeUrl del nodo Wait funciona para una ejecución interactiva. Guarde el webhook_secret para la verificación de firma. Registrar después de procesar es una carrera que perderá con lotes pequeños.
Inicie el procesamiento con las columnas definidas
Llame a POST /api/v1/batches/{batch_name}/process con un template_id o un array fields. El array fields es donde se configura Custom Column Extraction: cada nombre se convierte en un encabezado, y la IA localiza el valor por su significado en lugar de por su posición. Para facturas, ese array podría nombrar vendor, invoice_number, invoice_date y total. Eso es lo que permite que facturas de distintos proveedores lleguen a las mismas columnas. La respuesta informa queued y webhook_registered, no datos extraídos.
Lea los resultados y escriba una fila por documento
Después del callback o cuando all_done sea true, llame a GET /api/v1/batches/{batch_name}/results. Cada entrada en documents incluye document_id, filename, status y line_items, el arreglo de filas extraídas para ese documento. Expanda cada line_item en una fila de la hoja, conserve los metadatos y escriba con Append or Update de Google Sheets.
Una plantilla guardada contiene los nombres de las columnas y la configuración de fusión; un arreglo fields ad hoc los contiene para un lote. Multi-Page Merge es la configuración de la plantilla que agrupa las páginas de un mismo documento lógico en un único registro. Si una factura llega en varias páginas y esa configuración está activada, añadir ?merge=true a los resultados las une en una sola entrada con source_document_ids. Sin ella, cada página puede convertirse en su propia fila.
Los archivos se procesan de forma segura y no se almacenan.
El callback debe registrarse antes de que termine el lote
El error de webhook más común es el orden: primero se procesa el lote y después se registra el callback, así que un lote que termina en segundos se completa antes de que haya un destino al cual enviar la notificación. El evento de finalización es un aviso, no los datos. Incluye batch_name, status y document_count. Usted sigue llamando al endpoint de resultados para obtener line_items. El callback solo tiene que despertar el flujo de trabajo, pero tiene que llegar.
Hay dos formas de darle un destino al cual llegar. La duradera es un segundo flujo de trabajo que comienza con un nodo Webhook en una URL estable. Registre esa URL en cada lote. Cuando se dispare el callback, lea batch_name, verifique la firma, obtenga los resultados y escriba las filas. El flujo de trabajo de carga puede terminar; nada queda en pausa y un reinicio no pierde el estado de ejecución.
La cómoda es un nodo Wait configurado para reanudarse con una llamada de webhook. n8n expone $execution.resumeUrl, genera la URL en tiempo de ejecución y la hace única para cada ejecución. Cuando el flujo de trabajo se pausa, n8n descarga sus datos de ejecución a la base de datos y los recarga cuando llega la llamada (documentación del nodo Wait de n8n). Eso está bien para una ejecución que posee un lote. Es frágil cuando se edita el flujo de trabajo, se limpia la ejecución o el callback llega tarde.
La entrega se intenta de inmediato y luego se reintenta a 1 minuto, 5 minutos, 30 minutos, 2 horas, 6 horas y 24 horas, hasta siete intentos. Un 500 de un n8n que se está reiniciando es recuperable; una URL de reanudación que ya no existe, no. Ese es el argumento a favor del endpoint fijo cuando la canalización importa.
Responda rápido, pero decida qué le cuesta un 200 veloz. Un código que no sea 2xx hace que la API reintente, así que una escritura lenta en la hoja dentro del callback puede producir entregas duplicadas. Un 200 enviado antes de escribir las filas significa que una caída después de la respuesta nunca se reintenta. Registre primero batch_name, responda 200, luego escriba, y deje que un flujo de trabajo de errores de n8n se encargue de la escritura fallida.
Cada entrega incluye webhook-id, webhook-timestamp y webhook-signature, siguiendo la especificación Standard Webhooks. Verifique el HMAC sobre el cuerpo sin procesar de la solicitud antes de confiar en batch_name, y luego obtenga los resultados. El secreto es una cadena hexadecimal simple, así que úselo como bytes de clave HMAC sin procesar; un verificador que reconozca whsec_ lo decodificará y fallará. Un callback que omite la verificación es una instrucción no autenticada de escribir filas.
El payload le dice que un lote terminó. El endpoint de resultados le dice qué produjo. Nunca trate lo primero como lo segundo.
Cuatro traspasos donde un archivo desaparece
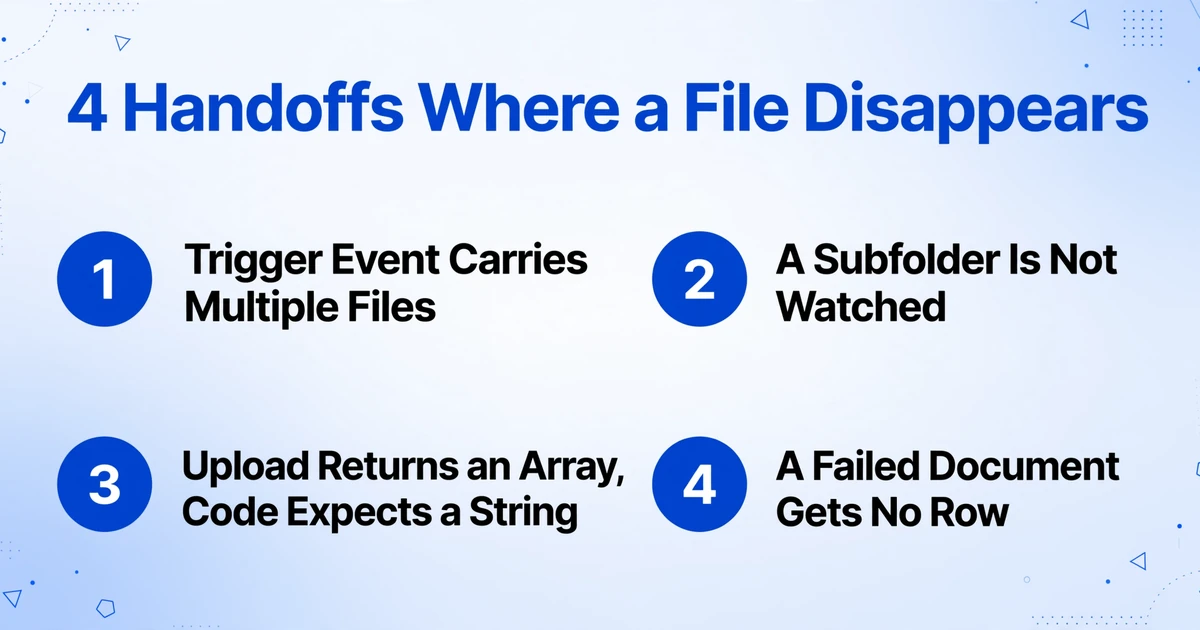
Cada omisión silenciosa en un pipeline de documentos de n8n ocurre en un traspaso, no dentro de la llamada de extracción. La extracción devuelve un resultado o un estado de fallo. El archivo se pierde antes de llegar allí, o después de que vuelve.
El evento de activación lleva más de un archivo. Google Drive Trigger sondea una vez por minuto de forma predeterminada, y varios cambios dentro de ese intervalo llegan como un único evento que contiene varios elementos (documentación de n8n). Una ejecución manual devuelve el último evento coincidente, así que una prueba con un solo archivo nunca lo reproduce. Un nodo que hace referencia al primer elemento del activador en lugar del actual, o un nodo HTTP Request con Execute Once activado, carga el primer archivo y descarta el resto. Ningún nodo falla, porque los demás elementos nunca se abordaron. Recorra la salida, una carga por elemento, y registre primero el file_id.
Una subcarpeta es el segundo lugar donde desaparecen los archivos. El activador vigila una carpeta. Los cambios dentro de sus subcarpetas no lo activan, así que un equipo que archiva facturas por mes o por proveedor solo ve lo que llega a la raíz. Convierta esa carpeta en el único punto de entrada, o añada una búsqueda recursiva programada en la misma rama de carga. Si los archivos vienen de fuera del equipo, el flujo de trabajo de recopilación y extracción de documentos cubre esa entrada.
La carga devuelve un array y el flujo de trabajo espera una cadena. Un PDF de varias páginas se convierte en un documento por página. Su document_id es un array en orden de páginas; una sola imagen devuelve una cadena. El código que asume una cadena escribe undefined en la fila y no puede buscar el documento. Ramifique según la forma de la respuesta, lleve page_count y trate cada página como su propio elemento. Si las páginas pertenecen a una sola factura, configure Multi-Page Merge y añada ?merge=true a los resultados para que vuelvan como una sola entrada.
Un documento puede fallar dentro de un lote que por lo demás tuvo éxito. La devolución de llamada informa failed o canceled cuando el lote no tuvo éxito por completo, pero el array de resultados aún contiene los documentos que sí lo tuvieron. Un flujo de trabajo que escribe line_items sin comprobar status escribe las filas buenas y descarta la mala. La hoja parece completa porque tiene filas; el recuento de la carpeta no coincide. Escriba una fila por cada documento, incluidos los fallidos, con filename, document_id y status. La carga útil de resultados da el estado; el feed de eventos de la cuenta (GET /events) añade un evento document.failed con un campo error para la cola de revisión.
Un reintento añade una segunda fila porque n8n es de tipo at-least-once
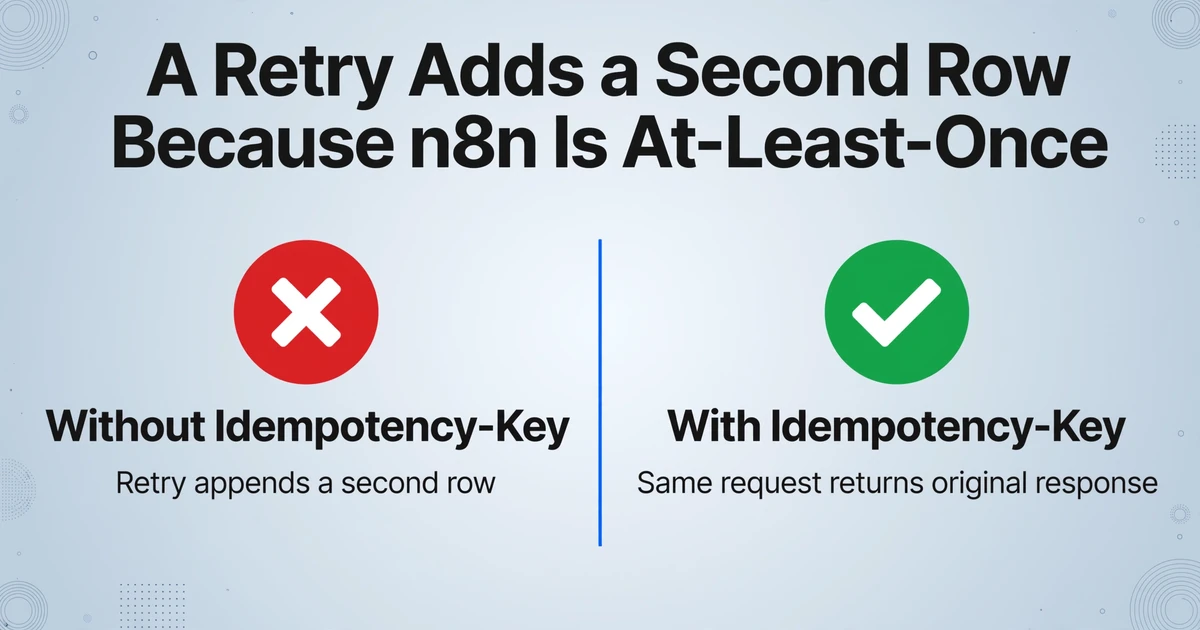
Los reintentos de n8n son de tipo at-least-once: un reintento reproduce los datos de ejecución guardados, pero cualquier nodo con efectos secundarios posterior al punto de fallo puede ejecutarse de nuevo, y la plataforma no tiene una garantía integrada de exactly-once (debate de la comunidad de n8n). La carga crea un documento y consume Credits; el append en la hoja crea una fila. Un reintento tras un timeout puede repetir cualquiera de los dos.
En la capa de la API, POST /documents y POST /batches/{batch_name}/process aceptan un Idempotency-Key, almacenado por cuenta, valor de clave y endpoint durante 24 horas. La misma solicitud con la misma clave devuelve la respuesta original sin crear un segundo documento ni descontar Credits dos veces. Una solicitud diferente con la misma clave devuelve un 400. Derive la clave a partir del archivo de origen, no del intento: el id del archivo de Drive, o <file_id>:<modified_time> si un archivo reemplazado debe contar como nuevo. Un UUID aleatorio por intento anula el mecanismo.
En la capa de la hoja, la clave de API no ayuda. Si el flujo de trabajo escribió tres filas y luego falló en la cuarta, el reintento puede añadir las tres primeras de nuevo. Use Append or Update de Google Sheets con una columna dedupe_key estable: vendor + invoice_number cuando ambas estén presentes, document_id cuando no lo estén. Coincida en esa columna. Detecta la misma carga reintentada y la misma factura que llega como un archivo nuevo, que son dos duplicados diferentes.
La concurrencia es el segundo problema de la hoja. La API de append de Google Sheets no es atómica, y las escrituras concurrentes pueden recaer en la misma fila; un hilo de la comunidad describe ejecuciones de n8n en verde con el registro de negocio ausente (comunidad de n8n). Mantenga un solo escritor: un lote a la vez, appends en secuencia, sin fan-out en el nodo de la hoja.
Una clave de idempotencia protege la carga. No protege la hoja de cálculo.
La hoja debe ser un registro de auditoría, no un registro de éxitos
Una hoja que solo recibe filas exitosas no puede decirle qué se le escapó al flujo de trabajo. Asigne una fila a cada documento, incluidos los fallidos, y agregue los metadatos que hacen trazable la fila: batch_name, document_id, source_filename, status y processed_at, junto con los campos extraídos como proveedor, número de factura, fecha y total.
Esas columnas hacen posible la conciliación. En una tabla de encabezados, el auxiliar de cuentas por pagar puede filtrar por lote, ver que el lote reporta 47 documentos y que la hoja tiene 47 filas, y encontrar las dos que dicen failed en lugar de preguntarse por qué falta en el total. Sin ellas, la única persona que puede explicar la hoja es quien construyó el flujo de trabajo.
Si la plantilla extrae partidas, un documento produce varios line_items. Decida antes de construir si la hoja es una tabla de encabezados, una fila por factura, o una tabla de partidas, una fila por línea con los campos de encabezado repetidos. Ambas son válidas; mezclarlas crea una hoja donde las sumas se duplican, lo que parece un error de extracción.
La capa posterior es un diseño aparte. Una vez que las filas son trazables, la pregunta pasa a ser qué debe alimentar la hoja: programación de pagos, un libro mayor de proveedores o una verificación de conciliación. El flujo de facturas de proveedores hacia cuentas por pagar cubre esa capa. El trabajo de n8n termina cuando la fila se escribe y es trazable, no cuando regresa la llamada HTTP.
Para las filas que parecen incorrectas, Review Mode en la aplicación web resalta la región de origen en la página original cuando usted hace clic en una celda, de modo que quien verifica un monto puede ver de dónde salió sin reabrir el PDF. Esa es una verificación manual. El trabajo del flujo es enrutar la fila sospechosa a una persona, no certificar el número.
Lo que este flujo de trabajo aún debe asumir
No existe un nodo oficial de n8n para ImageToTable.ai, y el flujo de trabajo debe gestionar la autenticación, los reintentos y los archivos fallidos por sí mismo. La API v1 es una interfaz REST, por lo que el nodo genérico HTTP Request es la integración.
El disparador pertenece a n8n. El nodo de Google Drive, Gmail o Webhook no es una función de ImageToTable, y no hay ningún botón de ImageToTable que vigile una carpeta. El flujo de trabajo aún debe decidir qué archivos son nuevos y cuáles ya se han procesado.
La política de reintentos es lo siguiente que debe asumir. La API reintenta la entrega de webhooks y acepta claves de idempotencia. Reintentar un documento fallido, marcarlo o preguntar a una persona es su decisión. Un reintento general ante un 400 consume tiempo y no soluciona el archivo.
Los límites estrictos forman parte del diseño. Un PDF está limitado a 50 páginas por carga, cada plan tiene una capacidad de lote que se devuelve como remaining_batch_capacity, y los endpoints de estado están limitados a 120 solicitudes por minuto. Un PDF de 60 páginas es un 400, no un éxito parcial, y un bucle de sondeo que ignora el límite dedica su tiempo a errores 429.
Extrae; no aprueba, no concilia órdenes de compra ni publica en un ERP. El flujo de trabajo aún necesita una regla sobre qué cuenta como factura duplicada, quién aprueba un importe y qué sistema recibe el registro final. Esas son decisiones de negocio, no ajustes de extracción.
La precisión es alta en tablas impresas y no es perfecta en escaneos deficientes. Nuestra propia cifra es de hasta un 99% de reconocimiento en datos de tablas impresas, y una página suele procesarse en 5-10 segundos. Ese es el tiempo de procesamiento por página, no la latencia de extremo a extremo: un lote espera a su documento más lento, y el callback o el intervalo de sondeo se suman por encima. Dirija los importes dudosos a una persona en lugar de promediarlos en la hoja.
Si el equipo no usa n8n en absoluto, el flujo de capturas sin código muestra el mismo punto de inserción sin un motor de flujo de trabajo.
Preguntas frecuentes
¿Existe un nodo oficial de n8n para ImageToTable.ai?
No. Se conecta a través de la API v1 con un nodo HTTP Request: suba con POST /documents, inicie con POST /batches/{batch_name}/process y lea con GET /batches/{batch_name}/results. La API gestiona la extracción; n8n gestiona el disparador, los reintentos y el enrutamiento.
¿Puede n8n vigilar una carpeta de Google Drive y procesar solo archivos nuevos?
Sí, con el nodo Google Drive Trigger. Consulta una vez por minuto de forma predeterminada, vigila una carpeta y puede agrupar varios archivos nuevos en un solo evento. El flujo de trabajo debe recorrer los elementos y no puede asumir que las subcarpetas estén incluidas. Si el propio flujo de trabajo también escribe en la misma carpeta, guarde los archivos procesados en una ubicación aparte para que la escritura no se convierta en el siguiente disparador.
¿Debo usar el webhook o consultar el estado del lote?
Use el webhook cuando quiera que el flujo de trabajo se reanude de inmediato y pueda exponer una URL estable. Consulte GET /batches/{batch_name} cuando un flujo de trabajo más sencillo importe más que la latencia: compruebe all_done y manténgase por debajo de 120 solicitudes por minuto. Un lote pequeño a menudo termina antes del primer intervalo de consulta, por lo que la consulta añade latencia en lugar de ahorrar trabajo.
¿Cómo evito filas duplicadas cuando un flujo de trabajo reintenta?
Coloque una Idempotency-Key en POST /documents y POST /process, derivada del id del archivo de origen. Luego haga que la escritura en la hoja sea idempotente con Append or Update con clave en document_id, más una clave de negocio como proveedor y número de factura para los archivos que se vuelvan a subir con un id nuevo. La clave de API cubre la llamada a la API; la hoja necesita su propia protección.
¿Qué ocurre con un documento cuya extracción falla?
Llega a failed, la devolución de llamada informa failed y el arreglo de resultados incluye ese documento con un arreglo line_items vacío. Escriba una fila para él con su filename y su estado para que el recuento de la hoja coincida con el recuento de la carpeta. El evento document.failed del feed de eventos incluye un campo error que puede dirigir a una cola de revisión.
Un flujo de trabajo confiable deja un rastro por cada archivo
Un flujo de trabajo de documentos no es confiable porque nunca falla. Es confiable porque cada archivo que entra deja un rastro, incluidos los que fallan: un document id, un batch name, un estado y una fila que una persona puede encontrar. La llamada de extracción es la parte fácil; el trabajo de diseño son los cuatro traspasos que la rodean.
Si la carpeta y las columnas ya están ahí, pruebe el diseño enviando una factura a través de la API antes de conectar el callback y la dedupe key. La respuesta le dice lo que recibirá el resto del flujo de trabajo.
Si los documentos llegan a través de un formulario en lugar de una carpeta, el flujo de extracción de formularios retoma en el envío.