Un workflow d'extraction de documents n8n
qui ne saute aucun fichier
L'historique d'exécution indique Success et la feuille de calcul a une ligne de moins. Les deux peuvent être vrais en même temps, car n8n signale que ses nœuds ont terminé, pas que la facture du dossier est devenue une ligne.
À volume de factures, cet écart a un coût. Le benchmark State of ePayables d'Ardent Partners évalue le coût moyen de traitement d'une facture à $9.84 (Ardent Partners). Un fichier qui ne devient jamais une ligne ne supprime pas ce travail. Il déplace le travail vers la personne qui rapproche la feuille, généralement des jours plus tard, sans journal d'exécution pour l'expliquer.
La solution n'est pas un meilleur nœud OCR. Il s'agit de traiter l'extraction comme une tâche asynchrone et de construire autour de trois moments : téléversé, en traitement, terminé. La séquence de nœuds ci-dessous fait cela, puis les quatre points de passage où les fichiers disparaissent encore.
Points clés
- La coche verte dans n8n signifie uniquement que chaque nœud a terminé, et c'est tout ce qu'elle signifie.
- Les fichiers disparaissent aux points de passage, pas dans l'appel d'extraction, donc un meilleur nœud OCR ne corrige rien.
- Donnez une ligne à chaque document, échecs inclus, afin que la feuille puisse être comptée par rapport au dossier.
Une exécution n8n au vert prouve seulement que les nœuds ont répondu
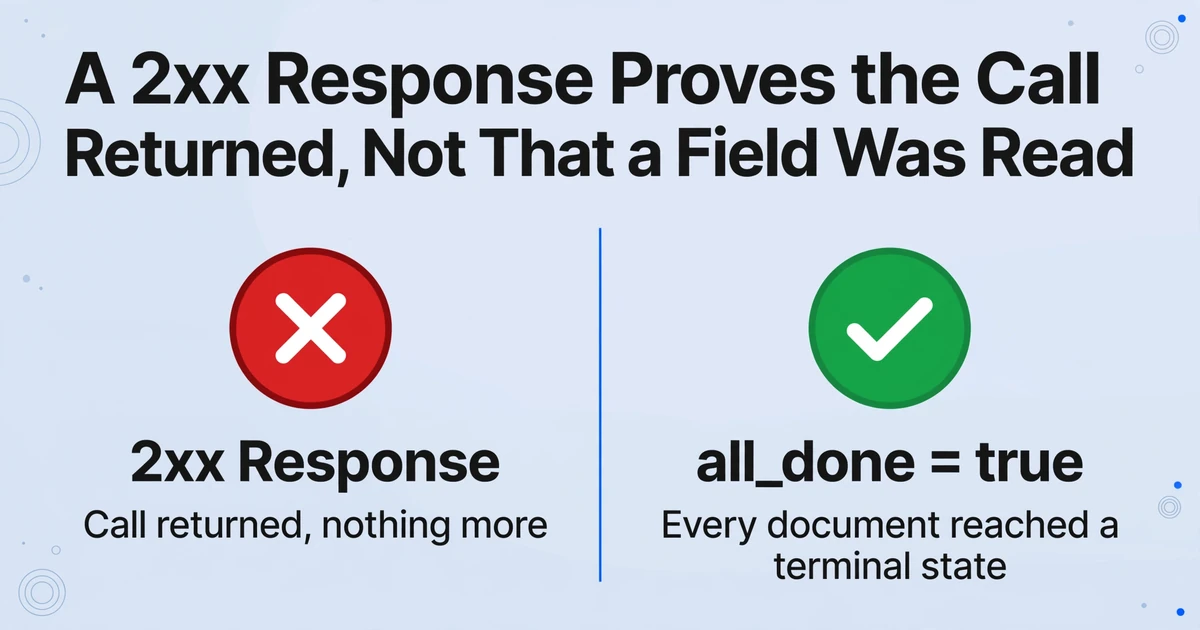
La coche dans n8n signifie que chaque nœud s'est terminé sans lever d'erreur, et une réponse 2xx suffit à terminer un nœud HTTP Request. C'est tout ce que cela signifie. Le nœud HTTP Request considère une réponse comme réussie lorsque le code de statut est 2xx (docs n8n). L'API d'extraction utilise cette même fenêtre pour trois opérations différentes : un document a été créé, un lot a été accepté pour traitement, ou un résultat a été lu. Seule la dernière est une lecture de données extraites.
| Appel | À quoi ressemble le succès | Ce que cela prouve | Ce que cela ne prouve pas |
|---|---|---|---|
POST /api/v1/documents | 201 | Le fichier est stocké dans un lot, et un PDF a été découpé en un document par page | Qu'un champ quelconque ait été lu |
POST /api/v1/batches/{batch_name}/process | 200 | Le traitement a été mis en file d'attente et des crédits ont été déduits pour les documents éligibles | Que l'extraction ait commencé ou se soit terminée |
GET /api/v1/batches/{batch_name} | 200 | Les compteurs actuels par statut et un indicateur all_done | Qu'un document en échec ait produit une ligne |
GET /api/v1/batches/{batch_name}/results | 200 | Tout ce qui est terminé à ce stade, sous forme de line_items | Que chaque document soit en état terminal, sauf si all_done est vrai |
Le vocabulaire de statut de l'API rend l'écart explicite : queued, processing, succeeded, failed, canceled. Un document se trouve dans exactement l'un d'eux à tout moment. Un lot n'est complet que lorsque chaque document a atteint un état terminal, c'est pourquoi son completed_at reste null tant que quelque chose est encore en cours.
Si vous avez cherché un workflow n8n OCR, la structure est la même : un déclencheur, une étape de lecture et une destination. La différence est qu'un workflow n8n d'extraction de documents bâti sur cette API doit traiter l'étape de lecture comme une tâche, et non comme un appel de fonction. Il renvoie du JSON structuré, mais seulement une fois le lot terminé.
Un 200 renvoyé par le point de terminaison process signifie que le lot a été accepté. Cela ne signifie pas qu'un seul champ a été lu.
Voici la défaillance qui ressemble à une réussite dans l'éditeur. Le workflow téléverse, appelle process, écrit le corps de la réponse dans une feuille, et se termine au vert avec une ligne qui contient le statut du lot au lieu des données de facture. L'exécution suivante en ajoute une autre. La feuille se remplit de messages de statut au lieu de factures.
Les cinq étapes qui survivent à un vrai dossier
Un workflow documentaire qui tient bon comporte cinq étapes, et chacune a une seule mission : obtenir un fichier par élément, le téléverser dans un lot nommé, enregistrer le signal de fin, lancer le traitement, puis lire les résultats et écrire les lignes.
Déclenchez le dossier, pas le fichier
Un Google Drive Trigger surveille un dossier pour les fichiers créés. Un Gmail Trigger fait de même pour les pièces jointes, et un nœud Webhook couvre les envois depuis un formulaire ou un autre système. Normalisez la sortie en un élément par fichier avec file_id, filename et mime_type. Ne partez pas du principe que l'événement ne contient qu'un seul fichier.
Importez chaque fichier dans un lot nommé
Utilisez un nœud HTTP Request pour POST https://imagetotable.ai/api/v1/documents en multipart form-data. Envoyez le binaire dans file, un batch_name pour cette exécution, et éventuellement un template_id. Ajoutez Authorization: Bearer <api_key>, stocké dans un identifiant Header Auth n8n plutôt que collé dans le nœud, et une Idempotency-Key dérivée de l'id du fichier Drive. Un lot est l'unité sur laquelle vous lancez le traitement : les imports s'accumulent, puis un seul appel les démarre tous. Un PDF devient un document par page, donc son document_id est un tableau ; une image unique renvoie une chaîne.
Enregistrez le callback de fin
Avant le traitement, appelez PUT /api/v1/batches/{batch_name}/webhook avec un callback_url. Un webhook de lot est un POST HTTP que l'API envoie à cette URL lorsque chaque document du lot atteint un état terminal. L'URL de production d'un nœud Webhook n8n fixe est le choix durable ; le $execution.resumeUrl du nœud Wait fonctionne pour une exécution interactive. Enregistrez le webhook_secret pour la vérification de signature. Enregistrer après le traitement est une course que vous perdrez sur les petits lots.
Lancez le traitement avec les colonnes définies
Appelez POST /api/v1/batches/{batch_name}/process avec un template_id ou un tableau fields. Le tableau fields est l'endroit où Custom Column Extraction est configuré : chaque nom devient un en-tête, et l'IA localise la valeur par le sens plutôt que par la position. Pour les factures, ce tableau peut nommer vendor, invoice_number, invoice_date et total. C'est ce qui permet aux factures de différents fournisseurs d'arriver dans les mêmes colonnes. La réponse indique queued et webhook_registered, pas les données extraites.
Lisez les résultats et écrivez une ligne par document
Après le callback ou une fois all_done à true, appelez GET /api/v1/batches/{batch_name}/results. Chaque entrée dans documents contient document_id, filename, status et line_items, le tableau des lignes extraites pour ce document. Développez chaque line_item en une ligne de feuille, conservez les métadonnées et écrivez avec Google Sheets Append or Update.
Un modèle enregistré contient les noms de colonnes et les paramètres de fusion ; un tableau fields ad hoc les contient pour un seul lot. Multi-Page Merge est le paramètre du modèle qui regroupe les pages d'un même document logique en un seul enregistrement. Si une facture arrive en plusieurs pages et que ce paramètre est activé, ajouter ?merge=true aux résultats les fusionne en une seule entrée avec source_document_ids. Sans cela, chaque page peut devenir sa propre ligne.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Le callback doit être enregistré avant la fin du lot
Le bug de webhook le plus courant est un problème d'ordre : le lot est traité d'abord et le callback est enregistré ensuite, si bien qu'un lot qui se termine en quelques secondes se termine avant qu'il n'y ait un endroit où envoyer la notification. L'événement de fin est un avis, pas la donnée. Il transporte batch_name, status et document_count. Vous appelez toujours le point de terminaison des résultats pour obtenir line_items. Le callback doit seulement réveiller le workflow, mais il doit arriver.
Il y a deux façons de lui donner un endroit où arriver. La durable est un second workflow qui démarre par un nœud Webhook à une URL stable. Enregistrez cette URL sur chaque lot. Quand le callback se déclenche, lisez batch_name, vérifiez la signature, récupérez les résultats et écrivez les lignes. Le workflow d'envoi peut se terminer ; rien ne reste en pause, et un redémarrage ne perd pas l'état d'exécution.
La pratique est un nœud Wait configuré pour reprendre sur appel webhook. n8n expose $execution.resumeUrl, génère l'URL à l'exécution et la rend unique à chaque exécution. Quand le workflow se met en pause, n8n décharge ses données d'exécution vers la base de données et les recharge à l'arrivée de l'appel (docs du nœud Wait de n8n). C'est acceptable pour une exécution qui possède un lot. C'est fragile quand le workflow est modifié, que l'exécution est nettoyée ou que le callback arrive en retard.
La livraison est tentée immédiatement, puis réessayée après 1 minute, 5 minutes, 30 minutes, 2 heures, 6 heures et 24 heures, jusqu'à sept tentatives. Un 500 d'un n8n en redémarrage est récupérable ; une URL de reprise qui n'existe plus ne l'est pas. C'est l'argument en faveur du point de terminaison fixe quand le pipeline compte.
Répondez vite, mais décidez ce que coûte un 200 rapide. Un code non-2xx pousse l'API à réessayer, donc une écriture lente dans la feuille pendant le callback peut produire des livraisons en double. Un 200 envoyé avant l'écriture des lignes signifie qu'un plantage après la réponse ne sera jamais réessayé. Enregistrez d'abord batch_name, répondez 200, puis écrivez, et laissez un workflow d'erreur n8n prendre en charge l'écriture échouée.
Chaque livraison transporte webhook-id, webhook-timestamp et webhook-signature, conformément à la spécification Standard Webhooks. Vérifiez le HMAC sur le corps brut de la requête avant de faire confiance à batch_name, puis récupérez les résultats. Le secret est une simple chaîne hexadécimale, utilisez-le donc comme octets bruts de clé HMAC ; un vérificateur qui gère whsec_ le décodera et échouera. Un callback qui saute la vérification est une instruction non authentifiée d'écrire des lignes.
La charge utile vous dit qu'un lot est terminé. Le point de terminaison des résultats vous dit ce qu'il a produit. Ne traitez jamais le premier comme le second.
Quatre points de passage où un fichier disparaît
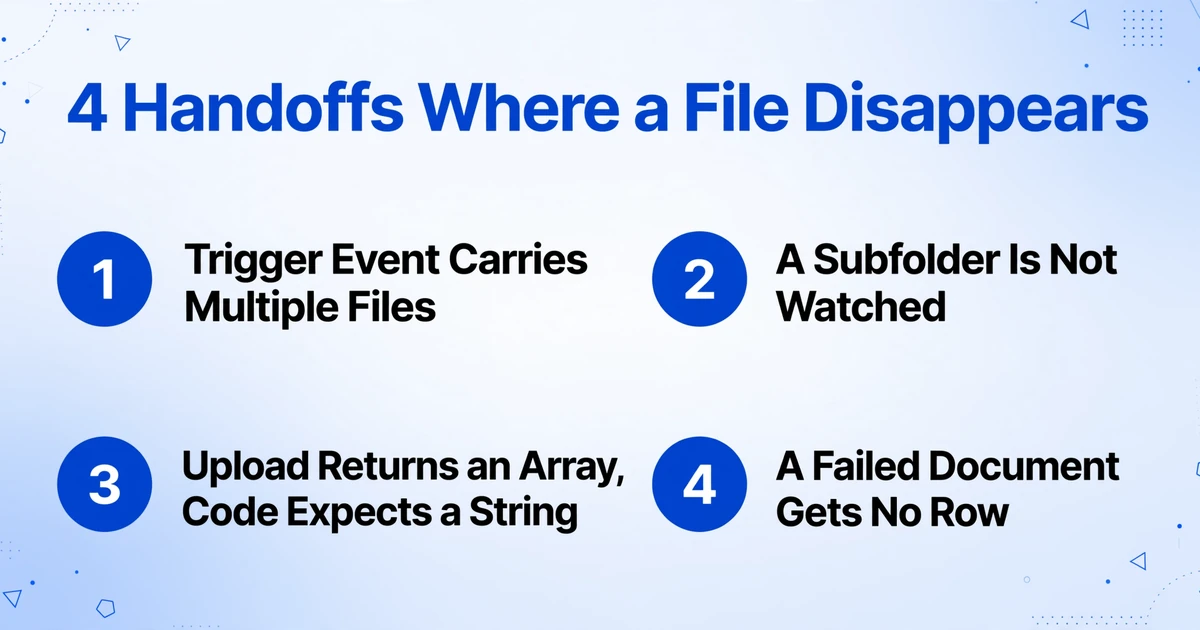
Chaque saut silencieux dans un pipeline de documents n8n se produit à un point de passage, pas à l'intérieur de l'appel d'extraction. L'extraction renvoie un résultat ou un statut d'échec. Le fichier est perdu avant d'y arriver, ou après son retour.
L'événement déclencheur transporte plus d'un fichier. Google Drive Trigger interroge une fois par minute par défaut, et plusieurs modifications survenues dans cet intervalle arrivent sous forme d'un seul événement contenant plusieurs éléments (docs n8n). Une exécution manuelle renvoie le dernier événement correspondant, donc un test sur un seul fichier ne le reproduit jamais. Un nœud qui référence le premier élément du déclencheur au lieu de l'élément courant, ou un nœud HTTP Request avec Execute Once activé, envoie le premier fichier et abandonne les autres. Aucun nœud n'échoue, car les autres éléments n'ont jamais été traités. Bouclez sur la sortie, un upload par élément, et journalisez d'abord le file_id.
Un sous-dossier est le deuxième endroit où les fichiers disparaissent. Le déclencheur surveille un seul dossier. Les modifications dans ses sous-dossiers ne le déclenchent pas, donc une équipe qui classe ses factures par mois ou par fournisseur ne voit que ce qui arrive à la racine. Faites de ce dossier le seul point d'entrée, ou ajoutez une recherche récursive planifiée dans la même branche d'upload. Si les fichiers viennent de l'extérieur de l'équipe, le workflow de collecte et d'extraction de documents couvre ce point d'entrée.
L'upload renvoie un tableau et le workflow attend une chaîne. Un PDF multipage devient un document par page. Son document_id est un tableau dans l'ordre des pages ; une image unique renvoie une chaîne. Un code qui suppose une chaîne écrit undefined dans la ligne et ne peut pas retrouver le document. Branchez selon la forme de la réponse, transportez page_count et traitez chaque page comme un élément à part. Si les pages appartiennent à une même facture, configurez Multi-Page Merge et ajoutez ?merge=true aux résultats pour qu'ils reviennent en une seule entrée.
Un document peut échouer dans un lot qui a par ailleurs réussi. Le callback signale failed ou canceled lorsque le lot n'a pas entièrement réussi, mais le tableau de résultats contient toujours les documents qui ont réussi. Un workflow qui écrit line_items sans vérifier status écrit les bonnes lignes et abandonne la mauvaise. La feuille semble complète car elle a des lignes ; le décompte du dossier ne correspond pas. Écrivez une ligne pour chaque document, y compris ceux en échec, avec filename, document_id et status. La charge utile des résultats fournit le statut ; le flux d'événements du compte (GET /events) ajoute un événement document.failed avec un champ error pour la file de révision.
Une nouvelle tentative ajoute une deuxième ligne car n8n est en mode at-least-once
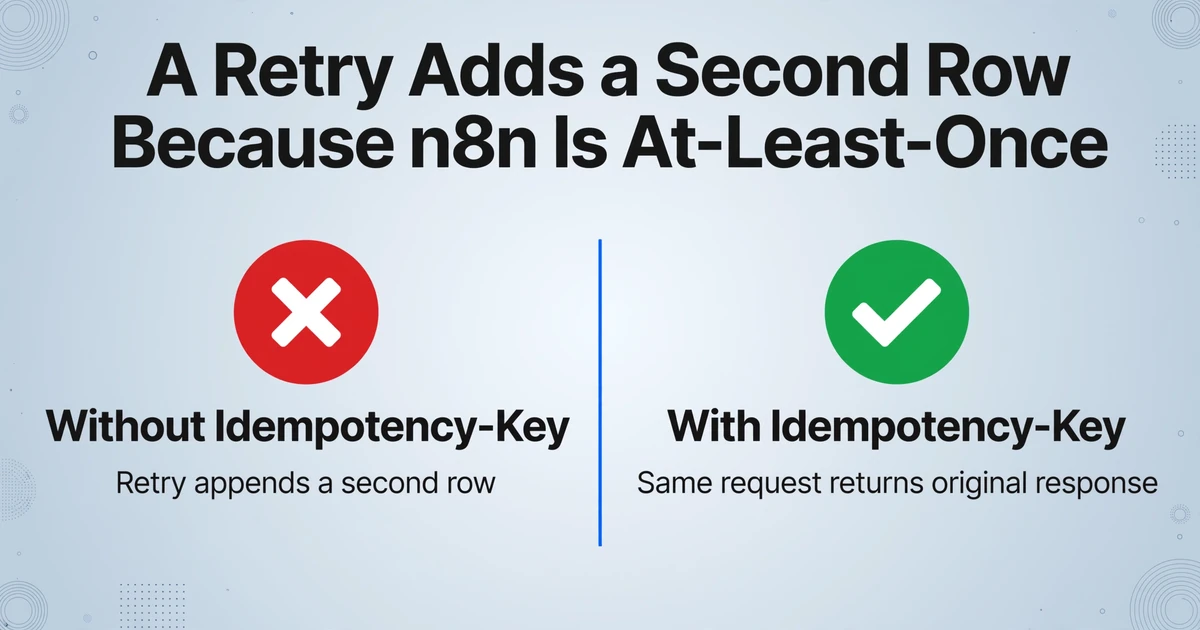
Les nouvelles tentatives n8n sont at-least-once : une nouvelle tentative rejoue les données d'exécution enregistrées, mais tout nœud à effet de bord en aval du point de défaillance peut s'exécuter à nouveau, et la plateforme n'offre aucune garantie exactly-once intégrée (discussion de la communauté n8n). L'upload crée un document et consomme des Credits ; l'ajout dans la feuille crée une ligne. Une nouvelle tentative après un timeout peut répéter l'un ou l'autre.
Au niveau de l'API, POST /documents et POST /batches/{batch_name}/process acceptent une Idempotency-Key, stockée par compte, valeur de clé et point de terminaison pendant 24 heures. La même requête avec la même clé renvoie la réponse d'origine sans créer un second document ni déduire les Credits deux fois. Une requête différente sous la même clé renvoie un 400. Dérivez la clé du fichier source, pas de la tentative : l'id du fichier Drive, ou <file_id>:<modified_time> si un fichier remplacé doit compter comme nouveau. Un UUID aléatoire par tentative neutralise le mécanisme.
Au niveau de la feuille, la clé API n'aide pas. Si le workflow a écrit trois lignes puis échoué sur la quatrième, la nouvelle tentative peut ajouter à nouveau les trois premières. Utilisez Append or Update de Google Sheets avec une colonne dedupe_key stable : vendor + invoice_number quand les deux sont présents, document_id sinon. Faites la correspondance sur cette colonne. Cela intercepte le même upload retenté et la même facture arrivant comme nouveau fichier, qui sont deux doublons différents.
La concurrence est le second problème de la feuille. L'API d'ajout de Google Sheets n'est pas atomique, et des écritures concurrentes peuvent atterrir sur la même ligne ; un fil de la communauté décrit des exécutions n8n vertes avec l'enregistrement métier absent (communauté n8n). Gardez un seul writer : un lot à la fois, des ajouts en séquence, pas de fan-out sur le nœud de la feuille.
Une clé d'idempotence protège l'upload. Elle ne protège pas le tableur.
La feuille doit être une piste d'audit, pas un journal de succès
Une feuille qui ne reçoit que les lignes réussies ne peut pas vous dire ce que le workflow a manqué. Attribuez une ligne à chaque document, y compris les échecs, et ajoutez les métadonnées qui rendent la ligne traçable : batch_name, document_id, source_filename, status et processed_at, aux côtés des champs extraits tels que le fournisseur, le numéro de facture, la date et le total.
Ces colonnes rendent le rapprochement possible. Dans une table d'en-têtes, le comptable fournisseurs peut filtrer par lot, constater que le lot indique 47 documents et que la feuille compte 47 lignes, puis trouver les deux qui affichent failed au lieu de se demander pourquoi le total est incomplet. Sans elles, la seule personne capable d'expliquer la feuille est celle qui a construit le workflow.
Si le modèle extrait des lignes d'articles, un document produit plusieurs line_items. Décidez avant de construire si la feuille est une table d'en-têtes, une ligne par facture, ou une table de lignes d'articles, une ligne par article avec les champs d'en-tête répétés. Les deux sont valides ; les mélanger crée une feuille où les sommes comptent double, ce qui ressemble à une erreur d'extraction.
La couche en aval est une conception distincte. Une fois les lignes traçables, la question devient ce que la feuille doit alimenter : la planification des paiements, un grand livre fournisseurs ou un contrôle de rapprochement. Le pipeline de factures fournisseurs vers la comptabilité fournisseurs couvre cette couche. La tâche n8n se termine lorsque la ligne est écrite et traçable, pas lorsque l'appel HTTP renvoie une réponse.
Pour les lignes qui semblent erronées, le Review Mode dans l'application web met en évidence la zone source sur la page d'origine lorsque vous cliquez sur une cellule, de sorte que la personne qui vérifie un montant peut voir d'où il vient sans rouvrir le PDF. Il s'agit d'une vérification manuelle. Le rôle du workflow est d'acheminer la ligne suspecte vers une personne, pas de certifier le chiffre.
Ce que ce workflow doit encore prendre en charge
Il n'existe pas de nœud n8n officiel pour ImageToTable.ai, et le workflow doit gérer lui-même l'authentification, les tentatives et les fichiers en échec. L'API v1 est une interface REST, le nœud HTTP Request générique constitue donc l'intégration.
Le déclencheur appartient à n8n. Le nœud Google Drive, Gmail ou Webhook n'est pas une fonctionnalité ImageToTable, et aucun bouton ImageToTable ne surveille un dossier. Le workflow doit encore déterminer quels fichiers sont nouveaux et lesquels ont déjà été traités.
La politique de nouvelle tentative est le point suivant à votre charge. L'API relance la livraison des webhooks et accepte les clés d'idempotence. Relancer un document en échec, le signaler ou solliciter une personne relève de votre décision. Une relance systématique sur un 400 consomme du temps sans corriger le fichier.
Les limites strictes font partie de la conception. Un PDF est plafonné à 50 pages par envoi, chaque forfait dispose d'une capacité de lot renvoyée sous remaining_batch_capacity, et les points de terminaison de statut sont limités à 120 requêtes par minute. Un PDF de 60 pages renvoie un 400, pas un succès partiel, et une boucle d'interrogation qui ignore la limite passe son temps sur des 429.
Il extrait ; il n'approuve pas, ne rapproche pas les bons de commande et ne publie pas dans un ERP. Le workflow a encore besoin d'une règle définissant ce qui compte comme une facture en doublon, qui approuve un montant et quel système reçoit l'enregistrement final. Ce sont des décisions métier, pas des paramètres d'extraction.
La précision est élevée sur les tableaux imprimés et imparfaite sur les scans de mauvaise qualité. Notre propre chiffre est jusqu'à 99 % de reconnaissance sur les données de tableaux imprimés, et une page est généralement traitée en 5-10 secondes. Il s'agit du temps de traitement par page, pas de la latence de bout en bout : un lot attend son document le plus lent, et l'intervalle de rappel ou d'interrogation s'y ajoute. Orientez les montants incertains vers une personne plutôt que de les moyenner dans la feuille.
Si l'équipe n'utilise pas du tout n8n, le pipeline de captures d'écran sans code montre le même point d'insertion sans moteur de workflow.
Questions fréquentes
Existe-t-il un nœud n8n officiel pour ImageToTable.ai ?
Non. Vous vous connectez via l'API v1 avec un nœud HTTP Request : téléversez avec POST /documents, lancez avec POST /batches/{batch_name}/process, et lisez avec GET /batches/{batch_name}/results. L'API gère l'extraction ; n8n gère le déclencheur, les tentatives et le routage.
n8n peut-il surveiller un dossier Google Drive et ne traiter que les nouveaux fichiers ?
Oui, avec le nœud Google Drive Trigger. Il interroge une fois par minute par défaut, surveille un seul dossier et peut regrouper plusieurs nouveaux fichiers dans un même événement. Le workflow doit parcourir les éléments, et il ne peut pas supposer que les sous-dossiers sont inclus. Si le workflow écrit lui-même dans ce même dossier, conservez les fichiers traités dans un emplacement distinct pour que l'écriture ne devienne pas le prochain déclencheur.
Faut-il utiliser le webhook ou interroger le statut du lot ?
Utilisez le webhook lorsque vous voulez que le workflow reprenne immédiatement et que vous pouvez exposer une URL stable. Interrogez GET /batches/{batch_name} lorsqu'un workflow plus simple compte plus que la latence : vérifiez all_done et restez sous 120 requêtes par minute. Un petit lot se termine souvent avant le premier intervalle d'interrogation, donc l'interrogation ajoute de la latence plutôt que d'économiser du travail.
Comment éviter les lignes en double lorsqu'un workflow réessaie ?
Placez une Idempotency-Key sur POST /documents et POST /process, dérivée de l'id du fichier source. Rendez ensuite l'écriture dans la feuille idempotente avec Append or Update basé sur document_id, plus une clé métier telle que le fournisseur et le numéro de facture pour les fichiers re-téléversés sous un nouvel id. La clé API couvre l'appel API ; la feuille a besoin de sa propre protection.
Que se passe-t-il pour un document dont l'extraction échoue ?
Il atteint l'état failed, le callback signale failed, et le tableau de résultats inclut ce document avec un tableau line_items vide. Écrivez une ligne pour lui avec son filename et son statut afin que le nombre de lignes de la feuille corresponde au nombre de fichiers du dossier. L'événement document.failed du flux d'événements porte un champ error que vous pouvez router vers une file de révision.
Un workflow fiable laisse une trace pour chaque fichier
Un workflow documentaire n'est pas fiable parce qu'il n'échoue jamais. Il est fiable parce que chaque fichier qui entre laisse une trace, y compris ceux qui échouent : un document_id, un batch_name, un statut et une ligne qu'une personne peut retrouver. L'appel d'extraction est la partie facile ; le travail de conception porte sur les quatre handoffs qui l'entourent.
Si le dossier et les colonnes sont déjà en place, testez la conception en envoyant une facture via l'API avant de câbler le callback et la clé de déduplication. La réponse vous indique ce que le reste du workflow recevra.
Si les documents arrivent via un formulaire plutôt qu'un dossier, le pipeline d'extraction par formulaire prend le relais à la soumission.