Um fluxo de trabalho de extração de documentos no n8n
que não ignora arquivos
O histórico de execução diz Sucesso e a planilha está com uma linha a menos. As duas coisas podem ser verdade ao mesmo tempo, porque o n8n está informando que seus nós retornaram, não que a fatura na pasta virou uma linha.
Em volume de faturas, essa lacuna tem um custo. O benchmark State of ePayables da Ardent Partners estima o custo médio de processar uma fatura em $9.84 (Ardent Partners). Um arquivo que nunca vira uma linha não elimina esse trabalho. Ele transfere o trabalho para quem reconcilia a planilha, geralmente dias depois, sem nenhum log de execução para explicar.
A solução não é um nó de OCR melhor. É tratar a extração como um trabalho assíncrono e construir em torno de três momentos: enviado, processando, concluído. A sequência de nós abaixo faz isso, e depois vêm os quatro pontos de transferência onde os arquivos ainda desaparecem.
Principais conclusões
- O check verde no n8n significa apenas que todos os nós terminaram, e é só isso que significa.
- Os arquivos desaparecem nos pontos de transferência, não dentro da chamada de extração, então um nó de OCR melhor não corrige nada.
- Dê uma linha a cada documento, incluindo as falhas, para que a planilha possa ser contada em relação à pasta.
Uma execução verde no n8n só prova que os nós retornaram
O check no n8n significa que todos os nós terminaram sem lançar erro, e uma resposta 2xx basta para concluir um nó HTTP Request. É só isso que significa. O nó HTTP Request considera uma resposta bem-sucedida quando o código de status é 2xx (n8n docs). A API de extração usa essa mesma janela para três operações diferentes: um documento foi criado, um lote foi aceito para processamento ou um resultado foi lido. Só a última é uma leitura de dados extraídos.
| Chamada | Sucesso se parece com | O que prova | O que não prova |
|---|---|---|---|
POST /api/v1/documents | 201 | O arquivo está armazenado em um lote, e um PDF foi dividido em um documento por página | Que algum campo tenha sido lido |
POST /api/v1/batches/{batch_name}/process | 200 | O processamento foi enfileirado e os créditos foram debitados para os documentos elegíveis | Que a extração tenha começado ou terminado |
GET /api/v1/batches/{batch_name} | 200 | Contagens atuais por status e um sinalizador all_done | Que um documento com falha tenha gerado uma linha |
GET /api/v1/batches/{batch_name}/results | 200 | Tudo o que foi concluído até agora, como line_items | Que todo documento esteja em estado terminal, a menos que all_done seja true |
O vocabulário de status da API deixa a lacuna explícita: queued, processing, succeeded, failed, canceled. Um documento está em exatamente um deles a qualquer momento. Um lote só está completo quando todo documento atingiu um estado terminal, e é por isso que seu completed_at permanece null enquanto algo ainda está em andamento.
Se você pesquisou por um fluxo de trabalho de OCR no n8n, o formato é o mesmo: um gatilho, uma etapa de leitura e um destino. A diferença é que um fluxo de trabalho de extração de documentos no n8n construído sobre esta API precisa tratar a etapa de leitura como um job, não como uma chamada de função. Ele retorna JSON estruturado, mas só depois que o lote termina.
Um 200 do endpoint de processamento significa que o lote foi aceito. Não significa que um único campo tenha sido lido.
Esta é a falha que parece sucesso no editor. O workflow faz upload, chama process, grava o corpo da resposta em uma planilha e termina em verde com uma linha que contém o status do lote em vez dos dados da fatura. A próxima execução acrescenta outra. A planilha se enche de mensagens de status em vez de faturas.
As Cinco Etapas Que Sobrevivem a uma Pasta Real
Um workflow de documentos que se sustenta tem cinco etapas, e cada uma tem uma única função: obter um arquivo por item, enviá-lo para um lote nomeado, registrar o sinal de conclusão, iniciar o processamento e então ler os resultados e gravar as linhas.
Dispare a pasta, não o arquivo
Um Google Drive Trigger observa uma pasta em busca de arquivos criados. Um Gmail Trigger faz o mesmo para anexos, e um nó Webhook cobre uploads de um formulário ou de outro sistema. Normalize a saída para um item por arquivo com file_id, filename e mime_type. Não presuma que o evento carrega um único arquivo.
Envie cada arquivo para um lote nomeado
Use um nó HTTP Request para POST https://imagetotable.ai/api/v1/documents como multipart form-data. Envie o binário em file, um batch_name para esta execução e, opcionalmente, um template_id. Adicione Authorization: Bearer <api_key>, armazenado em uma credencial Header Auth do n8n em vez de colado no nó, e uma Idempotency-Key derivada do id do arquivo do Drive. Um lote é a unidade na qual você inicia o processamento: os uploads se acumulam e, depois, uma única chamada inicia todos. Um PDF vira um documento por página, então seu document_id é um array; uma única imagem retorna uma string.
Registre o callback de conclusão
Antes de processar, chame PUT /api/v1/batches/{batch_name}/webhook com um callback_url. Um webhook de lote é um HTTP POST que a API envia para essa URL quando todos os documentos do lote atingem um estado terminal. A URL de produção de um nó Webhook fixo do n8n é a escolha durável; o $execution.resumeUrl do nó Wait funciona para uma execução interativa. Salve o webhook_secret para verificação de assinatura. Registrar depois do processamento é uma corrida que você vai perder em lotes pequenos.
Inicie o processamento com as colunas definidas
Chame POST /api/v1/batches/{batch_name}/process com um template_id ou um array fields. O array fields é onde a Extração de Colunas Personalizadas é configurada: cada nome vira um cabeçalho, e a IA localiza o valor pelo significado, não pela posição. Para faturas, esse array pode nomear vendor, invoice_number, invoice_date e total. É isso que permite que faturas de fornecedores diferentes caiam nas mesmas colunas. A resposta informa queued e webhook_registered, não os dados extraídos.
Leia os resultados e grave uma linha por documento
Após o callback ou depois que all_done for verdadeiro, chame GET /api/v1/batches/{batch_name}/results. Cada entrada em documents carrega document_id, filename, status e line_items, o array de linhas extraídas daquele documento. Expanda cada line_item em uma linha da planilha, carregue os metadados e grave com o Append or Update do Google Sheets.
Um modelo salvo contém os nomes das colunas e as configurações de mesclagem; um array fields ad hoc os contém para um lote. Multi-Page Merge é a configuração do modelo que agrupa páginas de um mesmo documento lógico em um único registro. Se uma fatura chega em várias páginas e essa configuração está ativada, adicionar ?merge=true aos resultados as une em uma única entrada com source_document_ids. Sem isso, cada página pode virar sua própria linha.
Os arquivos são processados com segurança e não são armazenados.
O Callback Precisa Ser Registrado Antes que o Lote Termine
O bug de webhook mais comum é a ordem: o lote é processado primeiro e o callback é registrado depois, então um lote que termina em segundos é concluído antes de haver onde enviar a notificação. O evento de conclusão é um aviso, não os dados. Ele carrega batch_name, status e document_count. Você ainda chama o endpoint de resultados para obter os line_items. O callback só precisa acordar o workflow, mas precisa chegar.
Há duas formas de dar a ele um lugar para chegar. A durável é um segundo workflow que começa com um nó Webhook em uma URL estável. Registre essa URL em cada lote. Quando o callback dispara, leia batch_name, verifique a assinatura, busque os resultados e grave as linhas. O workflow de upload pode terminar; nada fica pausado, e uma reinicialização não perde o estado de execução.
A conveniente é um nó Wait configurado para retomar na chamada do webhook. O n8n expõe $execution.resumeUrl, gera a URL em tempo de execução e a torna única para cada execução. Quando o workflow pausa, o n8n descarrega seus dados de execução para o banco de dados e os recarrega quando a chamada chega (documentação do nó Wait do n8n). Isso é adequado para uma execução que é dona de um lote. É frágil quando o workflow é editado, a execução é limpa ou o callback chega atrasado.
A entrega é tentada imediatamente e depois repetida após 1 minuto, 5 minutos, 30 minutos, 2 horas, 6 horas e 24 horas, até sete tentativas. Um 500 de um n8n reiniciando é recuperável; uma URL de retomada que não existe mais não é. Esse é o argumento para o endpoint fixo quando o pipeline importa.
Responda rápido, mas decida o que custa um 200 veloz. Um status não-2xx faz a API tentar novamente, então uma gravação lenta na planilha dentro do callback pode produzir entregas duplicadas. Um 200 enviado antes de as linhas serem gravadas significa que uma falha após a resposta nunca será repetida. Registre batch_name primeiro, responda 200, depois grave, e deixe um workflow de erro do n8n cuidar da gravação que falhou.
Toda entrega carrega webhook-id, webhook-timestamp e webhook-signature, seguindo a especificação Standard Webhooks. Verifique o HMAC sobre o corpo bruto da requisição antes de confiar no batch_name, depois busque os resultados. O segredo é uma string hexadecimal simples, então use-o como bytes brutos de chave HMAC; um verificador que reconhece whsec_ vai decodificá-lo e falhar. Um callback que pula a verificação é uma instrução não autenticada para gravar linhas.
O payload informa que um lote terminou. O endpoint de resultados informa o que ele produziu. Nunca trate o primeiro como o segundo.
Quatro pontos de transferência onde um arquivo desaparece
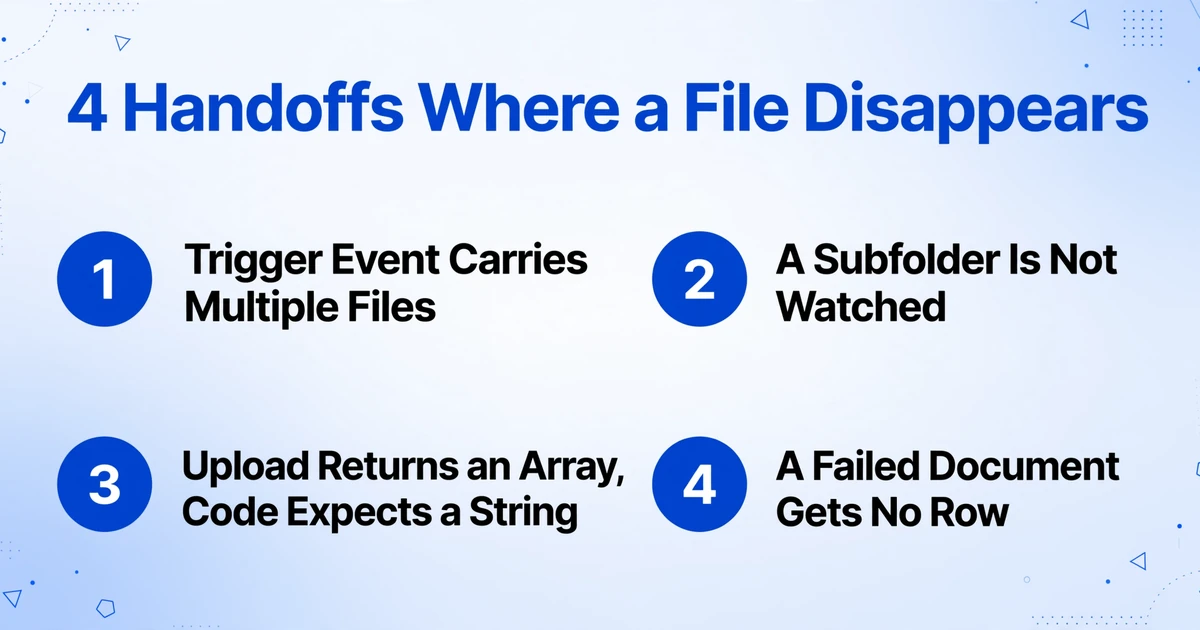
Toda falha silenciosa em um pipeline de documentos do n8n acontece em um ponto de transferência, não dentro da chamada de extração. A extração retorna um resultado ou um status de falha. O arquivo se perde antes de chegar lá, ou depois de voltar.
O evento de gatilho carrega mais de um arquivo. O Google Drive Trigger faz polling uma vez por minuto por padrão, e várias alterações dentro desse intervalo chegam como um único evento contendo vários itens (n8n docs). Uma execução manual retorna o último evento correspondente, então um teste com um único arquivo nunca reproduz isso. Um nó que referencia o primeiro item do gatilho em vez do atual, ou um nó HTTP Request com Execute Once ativado, faz o upload do primeiro arquivo e descarta o restante. Nenhum nó falha, porque os outros itens nunca foram endereçados. Faça um loop sobre a saída, um upload por item, e registre o file_id primeiro.
Uma subpasta é o segundo lugar onde arquivos desaparecem. O gatilho monitora uma pasta. Alterações dentro de suas subpastas não o disparam, então uma equipe que arquiva faturas por mês ou fornecedor vê apenas o que chega na raiz. Faça dessa pasta o único ponto de entrada, ou adicione uma busca recursiva agendada no mesmo ramo de upload. Se os arquivos vierem de fora da equipe, o fluxo de coleta e extração de documentos cobre essa entrada.
O upload retorna um array e o fluxo de trabalho espera uma string. Um PDF de várias páginas se torna um documento por página. Seu document_id é um array na ordem das páginas; uma única imagem retorna uma string. Código que assume uma string grava undefined na linha e não consegue localizar o documento. Ramifique pelo formato da resposta, carregue page_count e trate cada página como seu próprio item. Se as páginas pertencem a uma única fatura, configure Multi-Page Merge e adicione ?merge=true aos resultados para que retornem como uma única entrada.
Um documento pode falhar dentro de um lote que, fora isso, teve sucesso. O callback reporta failed ou canceled quando o lote não teve sucesso total, mas o array de resultados ainda contém os documentos que tiveram. Um fluxo de trabalho que grava line_items sem verificar status grava as linhas boas e descarta a ruim. A planilha parece completa porque tem linhas; a contagem da pasta discorda. Grave uma linha para cada documento, incluindo os que falharam, com filename, document_id e status. O payload de resultados fornece o status; o feed de eventos da conta (GET /events) adiciona um evento document.failed com um campo error para a fila de revisão.
Uma nova tentativa adiciona uma segunda linha porque o n8n é at-least-once
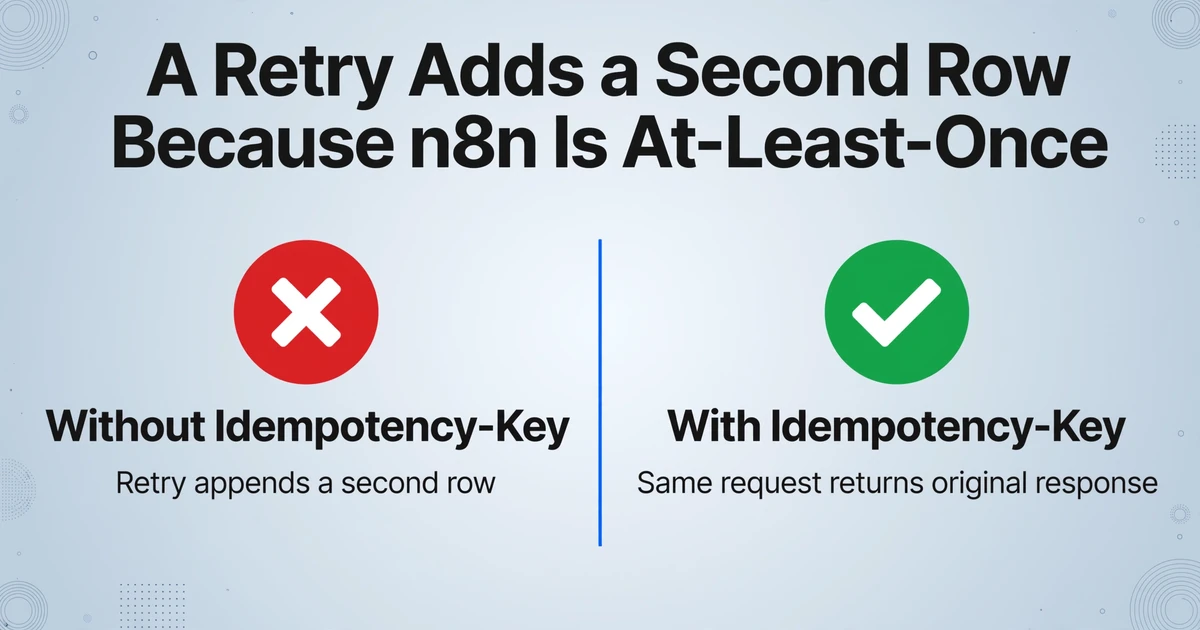
As novas tentativas do n8n são at-least-once: uma nova tentativa reproduz os dados de execução salvos, mas qualquer nó de efeito colateral a jusante do ponto de falha pode ser executado novamente, e a plataforma não tem garantia exactly-once integrada (discussão da comunidade n8n). O upload cria um documento e consome credits; a inserção na planilha cria uma linha. Uma nova tentativa após um timeout pode repetir qualquer uma das duas.
Na camada da API, POST /documents e POST /batches/{batch_name}/process aceitam uma Idempotency-Key, armazenada por conta, valor de chave e endpoint por 24 horas. A mesma requisição com a mesma chave retorna a resposta original sem criar um segundo documento ou descontar credits duas vezes. Uma requisição diferente com a mesma chave retorna um 400. Derive a chave do arquivo de origem, não da tentativa: o id do arquivo no Drive, ou <file_id>:<modified_time> se um arquivo substituído deve contar como novo. Um UUID aleatório por tentativa anula o mecanismo.
Na camada da planilha, a chave de API não ajuda. Se o fluxo de trabalho gravou três linhas e depois falhou na quarta, a nova tentativa pode inserir as três primeiras novamente. Use Append or Update do Google Sheets com uma coluna dedupe_key estável: vendor + invoice_number quando ambos estiverem presentes, document_id quando não estiverem. Faça a correspondência nessa coluna. Isso captura o mesmo upload repetido e a mesma fatura chegando como um novo arquivo, que são dois duplicados diferentes.
A concorrência é o segundo problema da planilha. A API de inserção do Google Sheets não é atômica, e gravações simultâneas podem cair na mesma linha; um tópico da comunidade descreve execuções verdes do n8n com o registro de negócio ausente (comunidade n8n). Mantenha um único gravador: um lote por vez, inserções em sequência, sem fan-out no nó da planilha.
Uma chave de idempotência protege o upload. Ela não protege a planilha.
A Planilha Deve Ser uma Trilha de Auditoria, Não um Registro de Sucessos
Uma planilha que só recebe linhas bem-sucedidas não consegue dizer o que o fluxo de trabalho deixou passar. Dê uma linha a cada documento, incluindo as falhas, e adicione os metadados que tornam a linha rastreável: batch_name, document_id, source_filename, status e processed_at, junto com os campos extraídos, como fornecedor, número da fatura, data e total.
Essas colunas tornam a conciliação possível. Em uma tabela de cabeçalho, o analista de contas a pagar pode filtrar por lote, ver que o lote reporta 47 documentos e que a planilha tem 47 linhas, e encontrar as duas que dizem failed em vez de se perguntar por que o total está faltando. Sem elas, a única pessoa capaz de explicar a planilha é quem construiu o fluxo de trabalho.
Se o modelo extrai itens de linha, um documento produz vários line_items. Decida antes de construir se a planilha é uma tabela de cabeçalho, uma linha por fatura, ou uma tabela de itens de linha, uma linha por item com os campos de cabeçalho repetidos. Ambas são válidas; misturá-las cria uma planilha em que as somas contam em dobro, o que parece um erro de extração.
A camada seguinte é um design separado. Depois que as linhas são rastreáveis, a questão passa a ser o que a planilha precisa alimentar: agendamento de pagamentos, um razão de fornecedores ou uma verificação de conciliação. O pipeline de faturas de fornecedores para contas a pagar cobre essa camada. O trabalho no n8n termina quando a linha é gravada e rastreável, não quando a chamada HTTP retorna.
Para linhas que parecem erradas, o Review Mode no aplicativo web destaca a região de origem na página original quando você clica em uma célula, para que a pessoa que verifica um valor possa ver de onde ele veio sem reabrir o PDF. Essa é uma verificação manual. O trabalho do fluxo é encaminhar a linha suspeita para uma pessoa, não certificar o número.
O Que Este Fluxo de Trabalho Ainda Precisa Assumir
Não existe um nó oficial do n8n para o ImageToTable.ai, e o fluxo de trabalho precisa lidar sozinho com autenticação, novas tentativas e arquivos com falha. A API v1 é uma interface REST, então o nó genérico HTTP Request é a integração.
O gatilho pertence ao n8n. O nó do Google Drive, Gmail ou Webhook não é um recurso do ImageToTable, e não existe um botão do ImageToTable que monitora uma pasta. O fluxo de trabalho ainda precisa decidir quais arquivos são novos e quais já foram processados.
A política de novas tentativas é a próxima coisa que você assume. A API tenta novamente a entrega do webhook e aceita chaves de idempotência. Tentar novamente um documento com falha, sinalizá-lo ou perguntar a uma pessoa é sua decisão. Uma nova tentativa generalizada em um 400 consome tempo e não corrige o arquivo.
Os limites rígidos fazem parte do projeto. Um PDF é limitado a 50 páginas por upload, cada plano tem uma capacidade de lote retornada como remaining_batch_capacity, e os endpoints de status são limitados a 120 requisições por minuto. Um PDF de 60 páginas é um 400, não um sucesso parcial, e um loop de polling que ignora o limite gasta seu tempo em 429s.
Ele extrai; não aprova, não faz correspondência com ordens de compra nem lança em um ERP. O fluxo de trabalho ainda precisa de uma regra para o que conta como fatura duplicada, quem aprova um valor e qual sistema recebe o registro final. Essas são decisões de negócio, não configurações de extração.
A precisão é alta em tabelas impressas e não é perfeita em digitalizações ruins. Nosso próprio número é de até 99% de reconhecimento em dados de tabelas impressas, e uma página normalmente é processada em 5-10 segundos. Esse é o tempo de processamento por página, não a latência de ponta a ponta: um lote espera pelo seu documento mais lento, e o callback ou o intervalo de polling fica por cima. Encaminhe valores incertos para uma pessoa em vez de tirar a média deles na planilha.
Se a equipe não usa o n8n, o pipeline de captura de tela sem código mostra o mesmo ponto de inserção sem um mecanismo de fluxo de trabalho.
Perguntas Frequentes
Existe um node oficial do n8n para o ImageToTable.ai?
Não. Você se conecta através da API v1 com um node HTTP Request: faça upload com POST /documents, inicie com POST /batches/{batch_name}/process e leia com GET /batches/{batch_name}/results. A API cuida da extração; o n8n cuida do gatilho, das tentativas e do roteamento.
O n8n pode monitorar uma pasta do Google Drive e processar apenas arquivos novos?
Sim, com o node Google Drive Trigger. Ele verifica uma vez por minuto por padrão, monitora uma pasta e pode agrupar vários arquivos novos em um único evento. O workflow precisa percorrer os itens em loop, e não pode presumir que as subpastas estejam incluídas. Se a mesma pasta também for gravada pelo próprio workflow, mantenha os arquivos processados em um local separado para que a gravação não se torne o próximo gatilho.
Devo usar o webhook ou consultar o status do lote?
Use o webhook quando quiser que o workflow seja retomado imediatamente e puder expor uma URL estável. Consulte GET /batches/{batch_name} quando um workflow mais simples importar mais do que a latência: verifique all_done e fique abaixo de 120 requisições por minuto. Um lote pequeno geralmente termina antes do primeiro intervalo de consulta, então a consulta adiciona latência em vez de economizar trabalho.
Como evito linhas duplicadas quando um workflow é repetido?
Coloque um Idempotency-Key em POST /documents e POST /process, derivado do id do arquivo de origem. Depois, torne a gravação na planilha idempotente com Append or Update com chave em document_id, além de uma chave de negócio como fornecedor e número da fatura para arquivos reenviados com um novo id. A chave da API cobre a chamada à API; a planilha precisa da própria proteção.
O que acontece com um documento que falha na extração?
Ele chega a failed, o callback informa failed, e o array de resultados inclui esse documento com um array line_items vazio. Grave uma linha para ele com seu filename e status para que a contagem da planilha corresponda à contagem da pasta. O evento document.failed do feed de eventos carrega um campo error que você pode encaminhar para uma fila de revisão.
Um fluxo de trabalho confiável deixa um rastro para cada arquivo
Um fluxo de trabalho de documentos não é confiável porque nunca falha. É confiável porque cada arquivo que entra deixa um rastro, incluindo os que falham: um document id, um batch name, um status e uma linha que uma pessoa consegue encontrar. A chamada de extração é a parte fácil; o trabalho de design são os quatro pontos de transferência ao redor dela.
Se a pasta e as colunas já existem, teste o design enviando uma fatura pela API antes de configurar o callback e a dedupe key. A resposta mostra o que o restante do fluxo de trabalho vai receber.
Se os documentos chegam por um formulário em vez de uma pasta, o pipeline de extração de formulários começa no envio.