파일을 건너뛰지 않는
n8n 문서 추출 워크플로
실행 기록에는 성공이라고 표시되지만 스프레드시트는 한 행이 부족합니다. n8n은 노드가 반환되었다고 보고할 뿐, 폴더 안의 인보이스가 행이 되었다고 보고하는 것이 아니므로 두 가지가 동시에 사실일 수 있습니다.
인보이스 물량이 많아지면 이 격차는 비용을 발생시킵니다. Ardent Partners의 State of ePayables 벤치마크에 따르면 인보이스 한 건을 처리하는 평균 비용은 $9.84입니다(Ardent Partners). 행이 되지 않는 파일이 그 작업을 없애주지는 않습니다. 그 작업은 보통 며칠 후 시트를 대사하는 사람에게로 넘어가며, 이를 설명할 실행 로그도 없습니다.
해결책은 더 나은 OCR 노드가 아닙니다. 추출을 비동기 작업으로 취급하고 업로드됨, 처리 중, 완료됨의 세 순간을 중심으로 구축하는 것입니다. 아래 노드 시퀀스가 그렇게 하며, 그다음에는 파일이 여전히 사라지는 네 가지 인계 지점을 다룹니다.
핵심 요약
- n8n의 녹색 체크 표시는 모든 노드가 완료되었다는 의미일 뿐이며, 그 이상은 아닙니다.
- 파일은 추출 호출 내부가 아니라 인계 지점에서 사라지므로, 더 나은 OCR 노드로는 아무것도 해결되지 않습니다.
- 실패를 포함한 모든 문서에 행을 부여하여 시트를 폴더와 대조해 셀 수 있게 합니다.
n8n 실행이 초록불이라고 해서 노드가 반환되었다는 것만 증명합니다
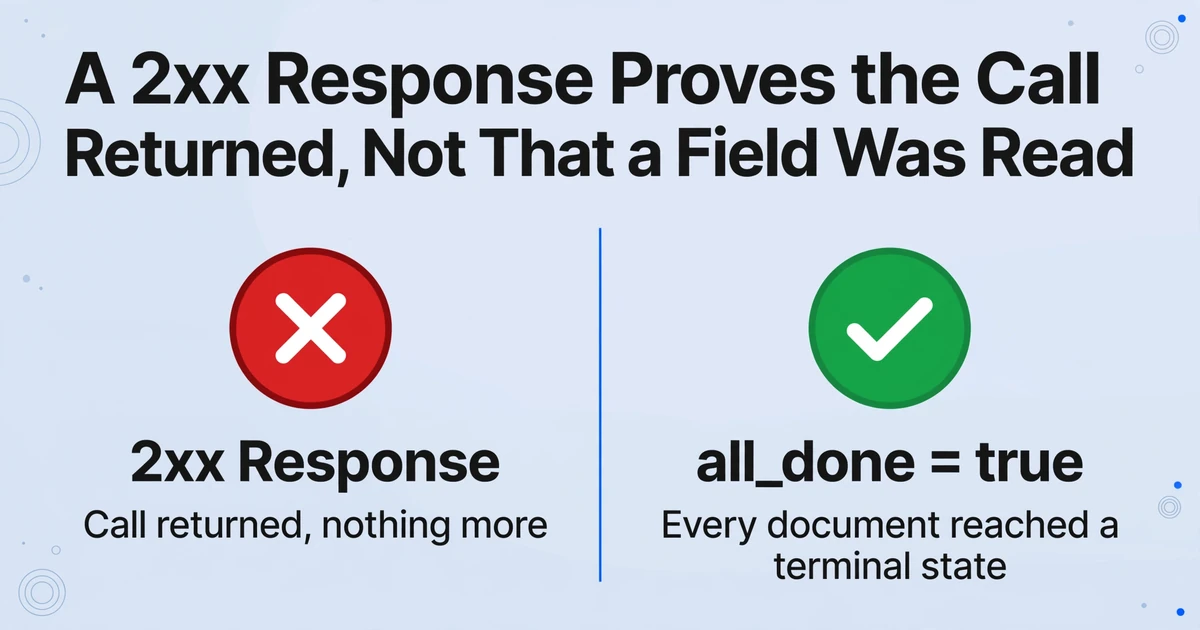
n8n의 체크 표시는 모든 노드가 예외 없이 끝났다는 뜻이며, HTTP Request 노드는 2xx 응답만으로도 완료됩니다. 의미는 그게 전부입니다. HTTP Request 노드는 상태 코드가 2xx일 때 응답을 성공으로 간주합니다(n8n 문서). 추출 API는 이 동일한 범위를 세 가지 다른 작업에 사용합니다. 문서가 생성되었거나, 배치가 처리 대기로 접수되었거나, 결과를 읽었을 때입니다. 추출된 데이터를 읽는 것은 마지막 하나뿐입니다.
| 호출 | 성공으로 보이는 경우 | 증명하는 것 | 증명하지 않는 것 |
|---|---|---|---|
POST /api/v1/documents | 201 | 파일이 배치에 저장되었고, PDF가 페이지당 하나의 문서로 분할되었음 | 어떤 필드든 읽혔다는 것 |
POST /api/v1/batches/{batch_name}/process | 200 | 처리가 대기열에 들어갔고, 대상 문서에 대해 Credits가 차감되었음 | 추출이 시작되었거나 끝났다는 것 |
GET /api/v1/batches/{batch_name} | 200 | 상태별 현재 개수와 all_done 플래그 | 실패한 문서가 행을 생성했다는 것 |
GET /api/v1/batches/{batch_name}/results | 200 | 지금까지 완료된 항목을 line_items로 반환 | all_done이 true가 아닌 한 모든 문서가 종료 상태라는 것 |
API의 상태 용어는 이 간극을 명확히 보여줍니다. queued, processing, succeeded, failed, canceled입니다. 문서는 어느 순간이든 이 중 정확히 하나에 속합니다. 배치는 모든 문서가 종료 상태에 도달했을 때만 완료되며, 그래서 아직 진행 중인 항목이 있으면 completed_at은 null로 남습니다.
n8n OCR 워크플로를 검색하셨다면 구조는 같습니다. 트리거, 읽기 단계, 목적지입니다. 차이는 이 API로 구축한 n8n 문서 추출 워크플로는 읽기 단계를 함수 호출이 아니라 작업으로 취급해야 한다는 점입니다. 구조화된 JSON을 반환하지만, 배치가 끝난 뒤에만 그렇습니다.
process 엔드포인트의 200은 배치가 접수되었다는 뜻입니다. 필드 하나라도 읽혔다는 뜻이 아닙니다.
편집기에서 성공처럼 보이는 실패입니다. 워크플로가 업로드하고, process를 호출하고, 응답 본문을 시트에 기록한 뒤, 인보이스 데이터 대신 배치 상태가 담긴 행과 함께 초록불로 끝납니다. 다음 실행에서 또 하나가 추가됩니다. 시트는 인보이스 대신 상태 메시지로 채워집니다.
실제 폴더에서도 살아남는 다섯 단계
견고한 문서 워크플로에는 다섯 단계가 있으며, 각 단계는 하나의 역할만 수행합니다. 항목당 파일 하나를 가져오고, 이름이 지정된 배치에 업로드하고, 완료 신호를 등록하고, 처리를 시작한 다음, 결과를 읽고 행을 기록합니다.
파일이 아니라 폴더를 트리거하십시오
Google Drive Trigger는 생성된 파일을 위해 하나의 폴더를 감시합니다. Gmail Trigger는 첨부파일에 대해 동일한 역할을 하며, Webhook 노드는 양식이나 다른 시스템에서의 업로드를 처리합니다. 출력을 file_id, filename, mime_type을 포함한 파일당 하나의 항목으로 정규화하십시오. 이벤트가 하나의 파일만 전달한다고 가정하지 마십시오.
각 파일을 이름이 지정된 배치에 업로드하십시오
HTTP Request 노드를 사용하여 POST https://imagetotable.ai/api/v1/documents를 multipart form-data로 호출하십시오. 바이너리는 file에, 이번 실행을 위한 batch_name을, 선택적으로 template_id를 전송하십시오. Authorization: Bearer <api_key>를 추가하되, 노드에 붙여넣지 말고 n8n Header Auth 자격 증명에 저장하십시오. 또한 Drive 파일 id에서 파생된 Idempotency-Key를 추가하십시오. 배치는 처리를 시작하는 단위입니다. 업로드가 누적된 후 한 번의 호출로 모두 시작됩니다. PDF는 페이지당 하나의 문서가 되므로 document_id가 배열이 되고, 단일 이미지는 문자열을 반환합니다.
완료 콜백을 등록하십시오
처리 전에 callback_url과 함께 PUT /api/v1/batches/{batch_name}/webhook을 호출하십시오. 배치 webhook은 배치 내 모든 문서가 종료 상태에 도달했을 때 API가 해당 URL로 전송하는 HTTP POST입니다. 고정된 n8n Webhook 노드의 프로덕션 URL이 안정적인 선택이며, Wait 노드의 $execution.resumeUrl은 한 번의 대화형 실행에 적합합니다. 서명 검증을 위해 webhook_secret을 저장하십시오. 처리 후에 등록하는 것은 소규모 배치에서 패배할 경쟁입니다.
정의된 열과 함께 처리를 시작하십시오
template_id 또는 fields 배열과 함께 POST /api/v1/batches/{batch_name}/process를 호출하십시오. fields 배열은 맞춤 열 추출이 구성되는 곳입니다. 각 이름이 헤더가 되며, AI는 위치가 아닌 의미로 값을 찾습니다. 인보이스의 경우 해당 배열에 vendor, invoice_number, invoice_date, total을 지정할 수 있습니다. 이것이 서로 다른 공급업체의 인보이스가 동일한 열에 들어갈 수 있게 하는 원리입니다. 응답은 추출된 데이터가 아니라 queued와 webhook_registered를 보고합니다.
결과를 읽고 문서마다 행 하나씩 작성하기
콜백 이후 또는 all_done이 true가 된 후에 GET /api/v1/batches/{batch_name}/results를 호출합니다. documents의 각 항목에는 document_id, filename, status, 그리고 해당 문서에서 추출된 행 배열인 line_items가 포함됩니다. 각 line_item을 시트 행으로 확장하고 메타데이터를 함께 전달한 뒤 Google Sheets Append or Update로 작성합니다.
저장된 템플릿은 열 이름과 병합 설정을 담고 있으며, 임시 fields 배열은 한 배치에 대해 이를 담습니다. Multi-Page Merge는 하나의 논리적 문서에 속한 페이지들을 단일 레코드로 묶는 템플릿 설정입니다. 인보이스가 여러 페이지로 도착하고 이 설정이 켜져 있으면, 결과에 ?merge=true를 추가하여 source_document_ids와 함께 하나의 항목으로 합칩니다. 이 설정이 없으면 각 페이지가 각각의 행이 될 수 있습니다.
파일은 안전하게 처리되며 저장되지 않습니다.
콜백은 배치가 끝나기 전에 등록해야 합니다
가장 흔한 Webhook 버그는 순서 문제입니다. 배치를 먼저 처리하고 콜백을 나중에 등록하면, 몇 초 만에 끝나는 배치는 알림을 보낼 곳이 생기기 전에 완료됩니다. 완료 이벤트는 알림이며 데이터가 아닙니다. 이 이벤트는 batch_name, status, document_count를 전달합니다. line_items를 얻으려면 여전히 results 엔드포인트를 호출해야 합니다. 콜백은 워크플로를 깨우기만 하면 되지만, 반드시 도착해야 합니다.
콜백이 도착할 곳을 마련하는 방법은 두 가지입니다. 안정적인 방법은 안정적인 URL에 Webhook 노드를 두고 시작하는 두 번째 워크플로입니다. 모든 배치에 이 URL을 등록합니다. 콜백이 발생하면 batch_name을 읽고, 서명을 검증하고, 결과를 가져와 행을 기록합니다. 업로드 워크플로는 종료될 수 있으며, 일시 중지된 상태로 남는 것이 없고 재시작해도 실행 상태가 유실되지 않습니다.
편리한 방법은 Webhook 호출 시 재개하도록 설정한 Wait 노드입니다. n8n은 $execution.resumeUrl을 노출하고, 런타임에 URL을 생성하며, 각 실행마다 고유하게 만듭니다. 워크플로가 일시 중지되면 n8n은 실행 데이터를 데이터베이스로 오프로드하고 호출이 도착하면 다시 로드합니다(n8n Wait node docs). 하나의 배치를 소유한 하나의 실행에는 적합합니다. 하지만 워크플로가 편집되거나, 실행이 정리되거나, 콜백이 늦게 도착하면 취약합니다.
전송은 즉시 시도되고, 이후 1분, 5분, 30분, 2시간, 6시간, 24시간 후에 재시도되며 최대 7회 시도됩니다. 재시작 중인 n8n에서 발생한 500은 복구할 수 있지만, 더 이상 존재하지 않는 resume URL은 복구할 수 없습니다. 파이프라인이 중요할 때 고정 엔드포인트를 사용해야 하는 이유입니다.
빠르게 응답하되, 빠른 200이 어떤 비용을 치르는지 판단해야 합니다. 2xx가 아니면 API가 재시도하므로, 콜백 내부의 느린 시트 쓰기는 중복 전송을 일으킬 수 있습니다. 행을 기록하기 전에 200을 보내면 응답 이후의 충돌은 재시도되지 않습니다. batch_name을 먼저 기록하고, 200을 응답한 다음, 기록하고, 실패한 쓰기는 n8n 오류 워크플로가 담당하게 하십시오.
모든 전송은 Standard Webhooks 사양에 따라 webhook-id, webhook-timestamp, webhook-signature를 전달합니다. batch_name을 신뢰하기 전에 원시 요청 본문에 대한 HMAC을 검증한 다음 결과를 가져오십시오. 시크릿은 일반 hex 문자열이므로 원시 HMAC 키 바이트로 사용해야 합니다. whsec_을 인식하는 검증기는 이를 디코딩하려다 실패합니다. 검증을 건너뛰는 콜백은 행을 기록하라는 인증되지 않은 지시입니다.
페이로드는 배치가 끝났다고 알려줍니다. results 엔드포인트는 무엇을 생성했는지 알려줍니다. 전자를 후자로 취급하지 마십시오.
파일이 사라지는 네 가지 인계 지점
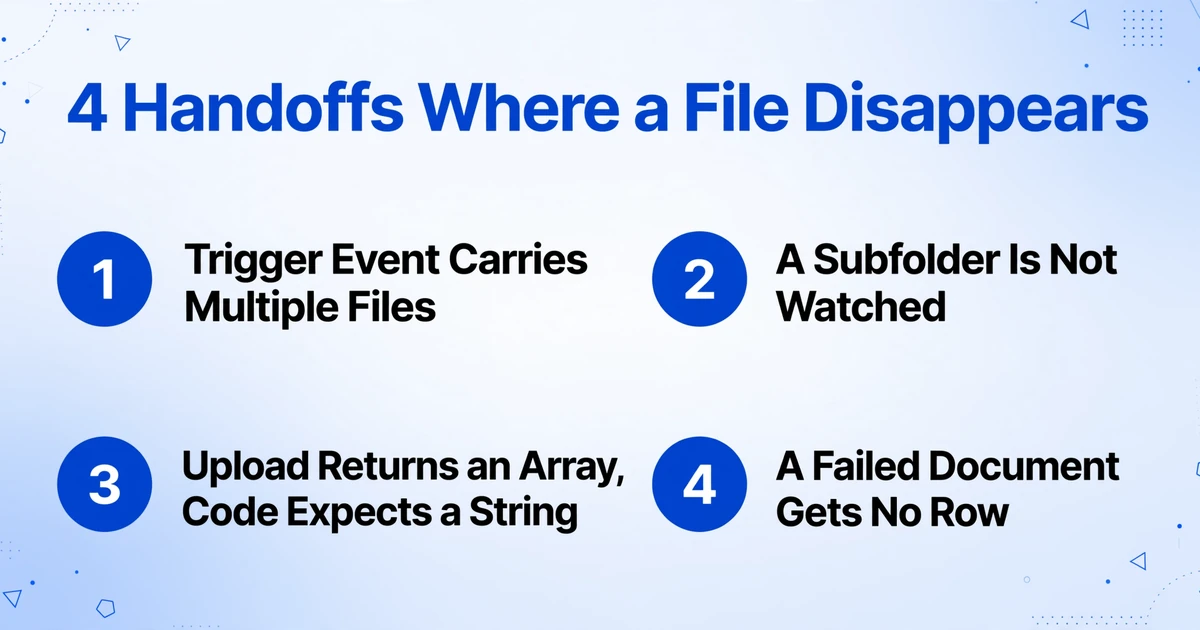
n8n 문서 파이프라인에서 발생하는 모든 조용한 실패는 추출 호출 내부가 아니라 인계 지점에서 일어납니다. 추출은 결과 또는 실패 상태를 반환합니다. 파일은 그 지점에 도달하기 전이나, 결과가 돌아온 후에 유실됩니다.
트리거 이벤트가 둘 이상의 파일을 전달합니다. Google Drive Trigger는 기본적으로 1분에 한 번 폴링하며, 그 간격 내의 여러 변경 사항은 여러 항목을 포함한 단일 이벤트로 도착합니다(n8n 문서). 수동 실행은 마지막으로 일치한 이벤트를 반환하므로, 파일 하나짜리 테스트로는 이 문제를 재현할 수 없습니다. 현재 항목 대신 트리거의 첫 번째 항목을 참조하는 노드나 Execute Once가 켜진 HTTP Request 노드는 첫 번째 파일만 업로드하고 나머지를 버립니다. 나머지 항목은 아예 처리되지 않았으므로 어떤 노드도 실패하지 않습니다. 출력을 반복 처리하여 항목당 하나씩 업로드하고, file_id를 가장 먼저 기록하십시오.
하위 폴더는 파일이 사라지는 두 번째 지점입니다. 트리거는 하나의 폴더만 감시합니다. 그 하위 폴더 내의 변경 사항은 트리거를 발동시키지 않으므로, 월별 또는 거래처별로 인보이스를 분류하는 팀은 루트에 도착한 것만 보게 됩니다. 해당 폴더를 유일한 수집 지점으로 만들거나, 동일한 업로드 분기에 예약된 재귀 검색을 추가하십시오. 파일이 팀 외부에서 들어오는 경우, 문서 수집 및 추출 워크플로가 그 수집을 담당합니다.
업로드가 배열을 반환하는데 워크플로는 문자열을 기대합니다. 다중 페이지 PDF는 페이지당 하나의 문서가 됩니다. 그 document_id는 페이지 순서의 배열이며, 단일 이미지는 문자열을 반환합니다. 문자열을 가정하는 코드는 행에 undefined를 기록하고 문서를 조회할 수 없게 됩니다. 응답 형태에 따라 분기하고, page_count를 전달하며, 각 페이지를 자체 항목으로 처리하십시오. 페이지가 하나의 인보이스에 속한다면 Multi-Page Merge를 구성하고 결과에 ?merge=true를 추가하여 하나의 항목으로 반환되게 하십시오.
하나의 문서는 나머지가 성공한 배치 내에서 실패할 수 있습니다. 콜백은 배치가 완전히 성공하지 않았을 때 failed 또는 canceled를 보고하지만, 결과 배열에는 성공한 문서가 여전히 포함되어 있습니다. status를 확인하지 않고 line_items를 기록하는 워크플로는 정상 행만 기록하고 실패한 행을 누락시킵니다. 시트에는 행이 있으므로 완전해 보이지만, 폴더 개수는 일치하지 않습니다. 실패한 문서를 포함한 모든 문서에 대해 filename, document_id, status와 함께 행을 기록하십시오. 결과 페이로드가 상태를 제공하며, 계정 이벤트 피드(GET /events)는 검토 대기열을 위해 error 필드와 함께 document.failed 이벤트를 추가합니다.
n8n이 최소 1회 실행이므로 재시도 시 두 번째 행이 추가됩니다
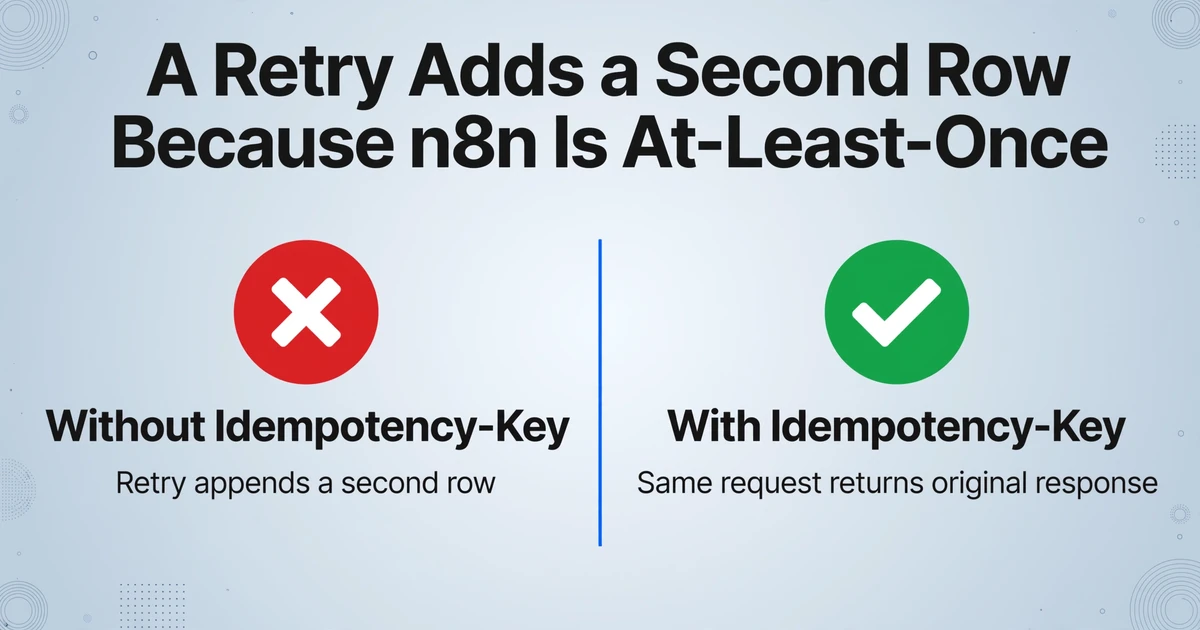
n8n 재시도는 최소 1회 실행입니다. 재시도는 저장된 실행 데이터를 재생하지만, 실패 지점 이후의 부수 효과 노드는 다시 실행될 수 있으며, 플랫폼에는 정확히 1회 실행을 보장하는 기본 기능이 없습니다 (n8n 커뮤니티 토론). 업로드는 문서를 생성하고 Credits를 소모하며, 시트 추가는 행을 생성합니다. 타임아웃 후 재시도하면 둘 중 하나가 반복될 수 있습니다.
API 계층에서 POST /documents와 POST /batches/{batch_name}/process는 Idempotency-Key를 허용하며, 이 키는 계정, 키 값, 엔드포인트별로 24시간 동안 저장됩니다. 동일한 키로 동일한 요청을 보내면 두 번째 문서를 생성하거나 Credits를 두 번 차감하지 않고 원래 응답을 반환합니다. 동일한 키로 다른 요청을 보내면 400이 반환됩니다. 키는 시도가 아니라 원본 파일에서 파생하십시오. Drive 파일 id, 또는 교체된 파일을 새 파일로 간주해야 하는 경우 <file_id>:<modified_time>을 사용하십시오. 시도마다 임의의 UUID를 사용하면 이 메커니즘이 무력화됩니다.
시트 계층에서는 API 키가 도움이 되지 않습니다. 워크플로가 세 개의 행을 쓴 후 네 번째에서 실패하면, 재시도 시 처음 세 개가 다시 추가될 수 있습니다. Google Sheets Append or Update를 하나의 안정적인 dedupe_key 열과 함께 사용하십시오. 둘 다 있는 경우 vendor + invoice_number, 없는 경우 document_id를 사용합니다. 해당 열을 기준으로 일치시키십시오. 이는 재시도된 동일한 업로드와 새 파일로 도착한 동일한 인보이스를 모두 잡아내며, 이 둘은 서로 다른 중복입니다.
동시성은 두 번째 시트 문제입니다. Google Sheets 추가 API는 원자적이지 않으며, 동시 쓰기가 동일한 행에 도달할 수 있습니다. 한 커뮤니티 스레드에서는 n8n 실행이 녹색으로 표시되지만 비즈니스 레코드가 없는 경우를 설명합니다 (n8n 커뮤니티). 작성자를 하나로 유지하십시오. 한 번에 하나의 배치, 순차적 추가, 시트 노드에서 팬아웃 없음.
멱등성 키는 업로드를 보호합니다. 스프레드시트는 보호하지 않습니다.
시트는 성공 로그가 아니라 감사 추적이어야 합니다
성공한 행만 받는 시트는 워크플로가 무엇을 놓쳤는지 알려줄 수 없습니다. 실패를 포함한 모든 문서에 행을 부여하고, 행을 추적 가능하게 만드는 메타데이터를 추가하십시오: batch_name, document_id, source_filename, status, processed_at을 vendor, invoice number, date, total 같은 추출된 필드와 함께 넣습니다.
이러한 열이 있어야 대사가 가능합니다. 헤더 테이블에서 AP 담당자는 배치별로 필터링하여 배치가 47개의 문서를 보고하고 시트에 47개의 행이 있는지 확인하고, 합계가 왜 부족한지 궁금해하는 대신 failed라고 표시된 두 개를 찾을 수 있습니다. 이것이 없으면 시트를 설명할 수 있는 사람은 워크플로를 만든 사람뿐입니다.
템플릿이 line items를 추출하는 경우, 하나의 문서가 여러 개의 line_items를 생성합니다. 시트가 인보이스당 한 행인 헤더 테이블인지, 헤더 필드가 반복되는 라인당 한 행인 line-item 테이블인지 구축 전에 결정하십시오. 둘 다 유효하지만, 이를 혼합하면 합계가 이중 계산되는 시트가 만들어지며, 이는 추출 오류처럼 보입니다.
다운스트림 계층은 별개의 설계입니다. 행을 추적할 수 있게 되면, 문제는 시트가 무엇을 공급해야 하는가입니다: 지급 일정, 공급업체 원장, 또는 대사 확인. AP로의 공급업체 인보이스 파이프라인이 그 계층을 다룹니다. n8n 작업은 HTTP 호출이 반환될 때가 아니라 행이 작성되고 추적 가능해질 때 끝납니다.
잘못 보이는 행의 경우, 웹 앱의 Review Mode는 셀을 클릭하면 원본 페이지에서 소스 영역을 강조 표시하므로, 금액을 확인하는 사람이 PDF를 다시 열지 않고도 출처를 볼 수 있습니다. 이는 수동 확인입니다. 워크플로의 임무는 의심스러운 행을 사람에게 라우팅하는 것이지 숫자를 인증하는 것이 아닙니다.
이 워크플로가 여전히 직접 감당해야 하는 부분
ImageToTable.ai를 위한 공식 n8n 노드는 없으며, 워크플로가 인증, 재시도, 실패한 파일을 스스로 처리해야 합니다. v1 API는 REST 인터페이스이므로 범용 HTTP Request 노드가 곧 연동 수단입니다.
트리거는 n8n의 몫입니다. Google Drive, Gmail, Webhook 노드는 ImageToTable 기능이 아니며, 폴더를 감시하는 ImageToTable 버튼도 없습니다. 어떤 파일이 새로운 파일이고 어떤 파일이 이미 처리되었는지는 여전히 워크플로가 판단해야 합니다.
다음으로 직접 소유할 것은 재시도 정책입니다. API는 webhook 전달을 재시도하고 idempotency key를 허용합니다. 실패한 문서를 재시도할지, 플래그를 달지, 사람에게 물어볼지는 직접 결정하셔야 합니다. 400에 대한 무조건적인 재시도는 시간만 소모할 뿐 파일을 고치지 못합니다.
하드 한도는 설계의 일부입니다. PDF는 업로드당 50페이지로 제한되며, 각 플랜에는 remaining_batch_capacity로 반환되는 배치 용량이 있고, 상태 엔드포인트는 분당 120회 요청으로 제한됩니다. 60페이지 PDF는 부분 성공이 아니라 400이며, 한도를 무시하는 폴링 루프는 429에 시간을 낭비합니다.
이 도구는 추출만 하며, 승인하거나 발주서를 대조하거나 ERP에 전송하지 않습니다. 워크플로에는 여전히 중복 청구서의 기준, 금액 승인 권한자, 최종 레코드를 받을 시스템에 대한 규칙이 필요합니다. 이는 추출 설정이 아니라 비즈니스 결정입니다.
인쇄된 표에서는 정확도가 높지만 품질이 낮은 스캔에서는 완벽하지 않습니다. 자체 수치는 인쇄된 표 데이터 기준 최대 99% 인식률이며, 페이지는 일반적으로 5-10초 내에 처리됩니다. 이는 페이지당 처리 시간이며 종단 간 지연 시간이 아닙니다. 배치는 가장 느린 문서를 기다리고, 콜백 또는 폴링 간격이 그 위에 더해집니다. 불확실한 금액은 시트에 평균으로 넣지 말고 사람에게 넘기십시오.
팀이 n8n을 전혀 사용하지 않는다면, 노코드 스크린샷 파이프라인에서 워크플로 엔진 없이 동일한 삽입 지점을 확인하실 수 있습니다.
자주 묻는 질문
ImageToTable.ai용 공식 n8n 노드가 있나요?
아닙니다. HTTP Request 노드로 v1 API를 통해 연결합니다. POST /documents로 업로드하고, POST /batches/{batch_name}/process로 시작하며, GET /batches/{batch_name}/results로 읽습니다. API는 추출을 처리하고, n8n은 트리거, 재시도, 라우팅을 처리합니다.
n8n이 Google Drive 폴더를 감시하고 새 파일만 처리할 수 있나요?
예, Google Drive Trigger 노드로 가능합니다. 기본적으로 1분에 한 번 폴링하며, 하나의 폴더를 감시하고, 여러 새 파일을 하나의 이벤트로 묶을 수 있습니다. 워크플로는 항목을 반복 처리해야 하며, 하위 폴더가 포함된다고 가정할 수 없습니다. 워크플로 자체가 같은 폴더에 쓰는 경우, 처리된 파일을 별도 위치에 보관하여 쓰기가 다음 트리거가 되지 않도록 하십시오.
Webhook을 사용해야 하나요, 아니면 배치 상태를 폴링해야 하나요?
워크플로를 즉시 재개하고 안정적인 URL을 노출할 수 있을 때는 Webhook을 사용하십시오. 지연 시간보다 단순한 워크플로가 더 중요할 때는 GET /batches/{batch_name}을 폴링하십시오. all_done을 확인하고 분당 120회 요청 이하를 유지하십시오. 작은 배치는 첫 폴링 간격 전에 완료되는 경우가 많아, 폴링은 작업을 절약하기보다 지연을 추가합니다.
워크플로가 재시도될 때 중복 행을 어떻게 막나요?
소스 파일 id에서 파생된 Idempotency-Key를 POST /documents와 POST /process에 넣으십시오. 그런 다음 document_id를 키로 하는 Append or Update로 시트 쓰기를 멱등하게 만들고, 새 id로 다시 업로드된 파일을 위해 vendor와 invoice number 같은 비즈니스 키를 추가하십시오. API 키는 API 호출을 보호하지만, 시트에는 자체 보호 장치가 필요합니다.
추출에 실패한 문서는 어떻게 되나요?
failed 상태가 되고, 콜백은 failed를 보고하며, 결과 배열에는 빈 line_items 배열과 함께 해당 문서가 포함됩니다. 파일 이름과 상태를 담은 행을 기록하여 시트 수가 폴더 수와 일치하도록 하십시오. 이벤트 피드의 document.failed 이벤트에는 검토 대기열로 라우팅할 수 있는 error 필드가 있습니다.
신뢰할 수 있는 워크플로는 모든 파일에 흔적을 남깁니다
문서 워크플로가 신뢰할 수 있는 이유는 결코 실패하지 않기 때문이 아닙니다. 들어오는 모든 파일이 흔적을 남기기 때문이며, 실패한 파일도 마찬가지입니다. 문서 id, 배치 이름, 상태, 그리고 사람이 찾을 수 있는 행이 남습니다. 추출 호출은 쉬운 부분이고, 설계의 핵심은 그 주위의 네 가지 인계 지점입니다.
폴더와 열이 이미 준비되어 있다면, 콜백과 dedupe_key를 연결하기 전에 API로 인보이스 하나를 보내 설계를 테스트하십시오. 응답을 보면 워크플로의 나머지 부분이 무엇을 받게 될지 알 수 있습니다.
문서가 폴더가 아니라 양식으로 들어온다면, 양식 추출 파이프라인이 제출 시점부터 이어받습니다.