ファイルをスキップしない
n8nドキュメント抽出ワークフロー
実行履歴は成功と表示しているのに、スプレッドシートは1行足りません。n8nが報告しているのはノードが戻ったことであり、フォルダ内の請求書が行になったことではないため、この2つは同時に起こり得ます。
請求書の量が増えると、このギャップにはコストが伴います。Ardent PartnersのState of ePayablesベンチマークによると、請求書1件の処理にかかる平均コストは$9.84です(Ardent Partners)。行にならなかったファイルはその作業をなくすわけではありません。通常は数日後に、説明する実行ログもないまま、シートを照合する担当者に作業が移るだけです。
解決策はより優れたOCRノードではありません。抽出を非同期ジョブとして扱い、アップロード済み、処理中、完了という3つの瞬間を中心に構築することです。以下のノードシーケンスがそれを行い、その後、ファイルが依然として消える4つの受け渡しを扱います。
主なポイント
- n8nの緑のチェックマークは、すべてのノードが完了したことだけを意味し、それ以上の意味はありません。
- ファイルが消えるのは抽出呼び出しの内部ではなく受け渡しの時点なので、より優れたOCRノードでは何も解決しません。
- 失敗を含め、すべてのドキュメントに行を持たせることで、シートをフォルダと照合して数えられます。
n8nのグリーンの実行は、ノードが応答を返したことしか証明しない
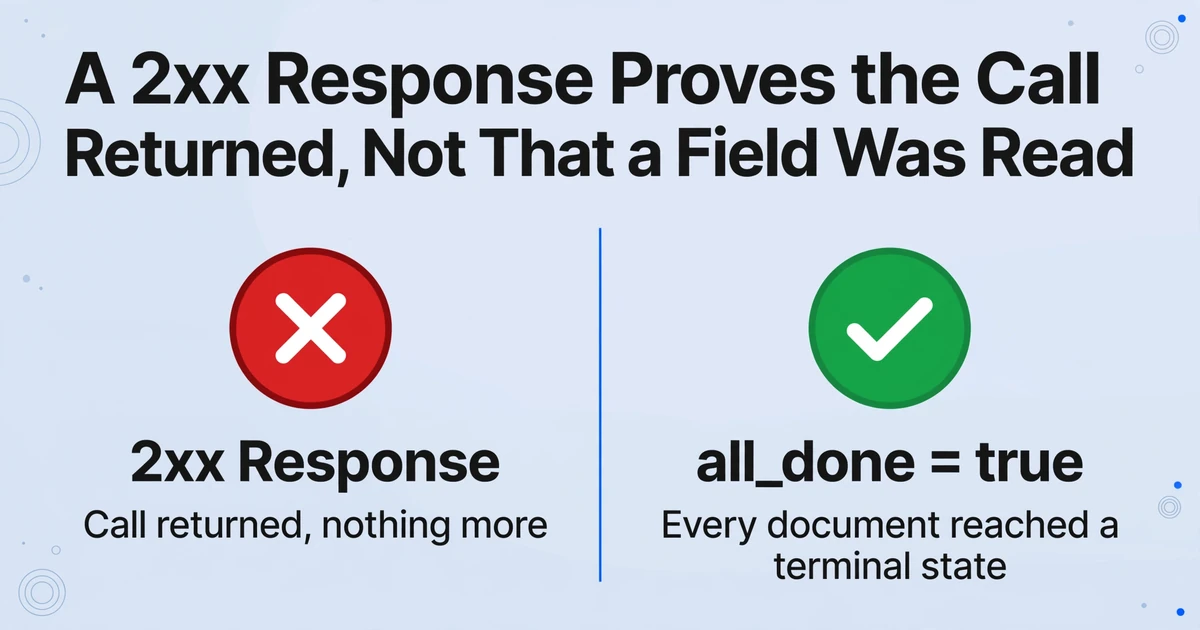
n8nのチェックマークは、すべてのノードが例外を投げずに完了したことを意味し、HTTP Requestノードを完了させるには2xxレスポンスで十分です。 意味はそれだけです。HTTP Requestノードは、ステータスコードが2xxであればレスポンスを成功とみなします(n8n docs)。抽出APIは同じ範囲を3つの異なる操作に使用します。ドキュメントが作成された、バッチが処理のために受け付けられた、または結果が読み取られた、のいずれかです。抽出データの読み取りであるのは最後の1つだけです。
| 呼び出し | 成功の形 | 証明すること | 証明しないこと |
|---|---|---|---|
POST /api/v1/documents | 201 | ファイルがバッチに保存され、PDFが1ページにつき1ドキュメントに分割された | いずれかのフィールドが読み取られたこと |
POST /api/v1/batches/{batch_name}/process | 200 | 処理がキューに入り、対象ドキュメントのCreditsが差し引かれた | 抽出が開始された、または完了したこと |
GET /api/v1/batches/{batch_name} | 200 | ステータスごとの現在の件数とall_doneフラグ | 失敗したドキュメントが行を生成したこと |
GET /api/v1/batches/{batch_name}/results | 200 | その時点までに完了した内容をline_itemsとして返す | all_doneがtrueでない限り、すべてのドキュメントが終端状態であること |
APIのステータス用語がこのギャップを明確にします。queued、processing、succeeded、failed、canceledです。ドキュメントは常にそのうちの1つの状態にあります。バッチが完了するのは、すべてのドキュメントが終端状態に達したときだけであり、そのため処理中のものがある間はcompleted_atがnullのままです。
n8n OCRワークフローを検索した場合も、形は同じです。トリガー、読み取りステップ、出力先です。違いは、このAPI上に構築されたn8nドキュメント抽出ワークフローでは、読み取りステップを関数呼び出しではなくジョブとして扱う必要があることです。構造化JSONを返しますが、それはバッチが完了した後だけです。
processエンドポイントからの200は、バッチが受け付けられたことを意味します。1つのフィールドが読み取られたことを意味するものではありません。
これはエディタ上では成功に見える障害です。ワークフローはアップロードし、processを呼び出し、レスポンスボディをシートに書き込み、請求書データではなくバッチステータスを含む行で緑のまま完了します。次回の実行でさらに1行追加されます。シートは請求書ではなくステータスメッセージで埋まっていきます。
実際のフォルダに耐える5つのステージ
堅牢なドキュメントワークフローには5つのステージがあり、それぞれに1つの役割があります。アイテムごとに1ファイルを取得し、名前付きバッチにアップロードし、完了シグナルを登録し、処理を開始し、結果を読み取って行を書き込みます。
ファイルではなくフォルダをトリガーする
Google Drive Triggerは1つのフォルダを監視して作成されたファイルを検知します。Gmail Triggerは添付ファイルに対して同じ役割を果たし、Webhookノードはフォームや他のシステムからのアップロードをカバーします。出力をfile_id、filename、mime_typeを持つ1ファイル1アイテムに正規化します。イベントが1つのファイルだけを運ぶと想定しないでください。
各ファイルを名前付きバッチにアップロードする
HTTP RequestノードでPOST https://imagetotable.ai/api/v1/documentsをmultipart form-dataとして呼び出します。バイナリをfileに、この実行用のbatch_nameを、任意でtemplate_idを送信します。ノードに貼り付けるのではなくn8nのHeader Auth認証情報に保存したAuthorization: Bearer <api_key>と、DriveのファイルIDから導出したIdempotency-Keyを追加します。バッチは処理を開始する単位です。アップロードが蓄積され、1回の呼び出しでそれらすべてが開始されます。PDFは1ページにつき1ドキュメントになるため、そのdocument_idは配列になります。単一の画像は文字列を返します。
完了コールバックを登録する
処理の前に、callback_urlを指定してPUT /api/v1/batches/{batch_name}/webhookを呼び出します。バッチWebhookは、バッチ内のすべてのドキュメントが終端状態に達したときにAPIがそのURLへ送信するHTTP POSTです。固定のn8n Webhookノードの本番URLが耐久性のある選択です。Waitノードの$execution.resumeUrlは1回の対話的な実行には機能します。署名検証のためにwebhook_secretを保存します。処理後に登録するのは、小さなバッチでは負ける競争です。
列を定義して処理を開始する
template_idまたはfields配列を指定してPOST /api/v1/batches/{batch_name}/processを呼び出します。fields配列はカスタム列抽出を設定する場所です。各名前がヘッダーになり、AIは位置ではなく意味によって値を特定します。請求書の場合、その配列はvendor、invoice_number、invoice_date、totalを指定するかもしれません。これにより、異なるサプライヤーの請求書が同じ列に収まります。レスポンスは抽出データではなく、queuedとwebhook_registeredを報告します。
結果を読み取り、ドキュメントごとに1行を書き込む
コールバック後、または all_done が true になったら、GET /api/v1/batches/{batch_name}/results を呼び出します。documents の各エントリには document_id、filename、status、およびそのドキュメントの抽出済み行の配列である line_items が含まれます。各 line_item をシートの行に展開し、メタデータを引き継いで Google Sheets の Append or Update で書き込みます。
保存済みテンプレートは列名とマージ設定を保持し、一時的なfields配列は1つのバッチのためにそれらを保持します。Multi-Page Mergeは、1つの論理ドキュメントのページを単一のレコードにグループ化するテンプレート設定です。請求書が複数ページで届き、この設定がオンの場合、resultsに?merge=trueを追加すると、source_document_idsを持つ1つのエントリにまとめられます。これがないと、各ページがそれぞれ独自の行になる可能性があります。
ファイルは安全に処理され、保存されません。
コールバックはバッチ完了前に登録する必要がある
最もよくあるWebhookのバグは順序です。バッチを先に処理し、コールバックを後で登録するため、数秒で完了するバッチは通知の送信先ができる前に完了してしまいます。 完了イベントは通知であり、データではありません。これにはbatch_name、status、document_countが含まれます。line_itemsを取得するには、引き続きresultsエンドポイントを呼び出す必要があります。コールバックはワークフローを起動するだけで十分ですが、必ず到達する必要があります。
到達先を用意する方法は2つあります。堅牢なのは、安定したURLのWebhookノードで始まる2つ目のワークフローです。そのURLをすべてのバッチに登録します。コールバックが発火したら、batch_nameを読み取り、署名を検証し、結果を取得して行を書き込みます。アップロード側のワークフローは終了でき、何も一時停止したままにならず、再起動しても実行状態が失われません。
便利なのは、Webhook呼び出しで再開するように設定したWaitノードです。n8nは$execution.resumeUrlを公開し、実行時にURLを生成して、各実行に固有のものにします。ワークフローが一時停止すると、n8nは実行データをデータベースに退避し、呼び出しが届いたときに再読み込みします(n8n Waitノードのドキュメント)。これは1つのバッチを所有する1回の実行には問題ありませんが、ワークフローが編集されたり、実行がクリーンアップされたり、コールバックが遅れて到着したりすると脆弱になります。
配信は即座に試行され、その後1分、5分、30分、2時間、6時間、24時間後に再試行され、最大7回まで行われます。再起動中のn8nからの500は回復可能ですが、存在しなくなったresume URLは回復できません。これが、パイプラインが重要な場合に固定エンドポイントを選ぶ理由です。
素早く応答してください。ただし、高速な200が何を犠牲にするかを考えてください。非2xxはAPIに再試行を促すため、コールバック内での遅いシート書き込みは重複配信を引き起こす可能性があります。行が書き込まれる前に200を返すと、応答後のクラッシュは再試行されません。まずbatch_nameを記録し、200を返してから書き込み、失敗した書き込みはn8nのエラーワークフローに任せてください。
すべての配信にはwebhook-id、webhook-timestamp、webhook-signatureが含まれ、Standard Webhooks仕様に従います。batch_nameを信頼する前に、生のリクエストボディに対してHMACを検証し、その後で結果を取得してください。シークレットはプレーンな16進文字列なので、生のHMACキーバイトとして使用します。whsec_を認識する検証器はこれをデコードして失敗します。検証を省略したコールバックは、行を書き込むための認証されていない命令です。
ペイロードはバッチが完了したことを伝えます。resultsエンドポイントは何を生成したかを伝えます。前者を後者として扱わないでください。
ファイルが消える4つの受け渡し
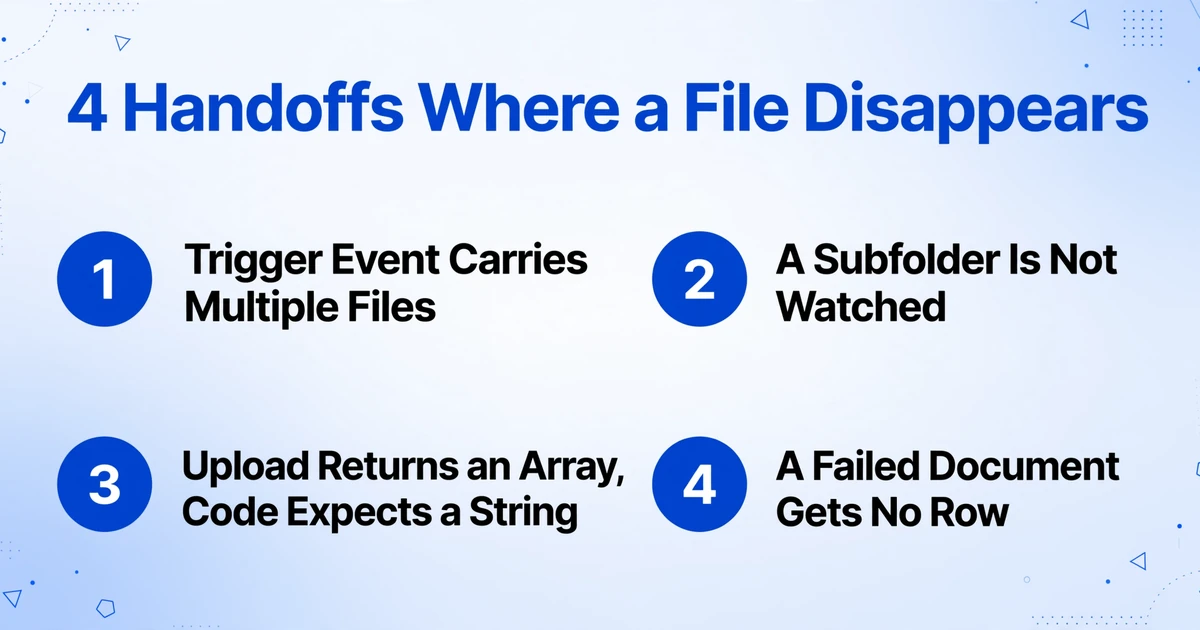
n8nドキュメントパイプラインにおけるサイレントスキップは、抽出呼び出しの内部ではなく、必ず受け渡しの地点で発生します。 抽出は結果または失敗ステータスを返します。ファイルはそこに到達する前、あるいは戻ってきた後に失われます。
トリガーイベントが複数のファイルを運びます。 Google Drive Triggerはデフォルトで1分に1回ポーリングし、その間隔内の複数の変更は複数のアイテムを含む単一のイベントとして届きます(n8n docs)。手動実行は最後に一致したイベントを返すため、1ファイルのテストでは再現できません。トリガーの現在のアイテムではなく最初のアイテムを参照するノード、またはExecute Onceを有効にしたHTTP Requestノードは、最初のファイルだけをアップロードし残りを破棄します。他のアイテムはそもそも処理されないため、どのノードも失敗しません。出力をループし、1アイテムにつき1回アップロードし、最初にfile_idをログに記録します。
サブフォルダはファイルが消える2つ目の場所です。トリガーは1つのフォルダを監視します。そのサブフォルダ内の変更では発火しないため、請求書を月別や取引先別に整理しているチームには、ルート直下に置かれたものしか見えません。そのフォルダを唯一の取り込み地点にするか、同じアップロードブランチにスケジュールされた再帰検索を追加します。ファイルがチーム外から来る場合は、ドキュメント収集・抽出ワークフローがその取り込みをカバーします。
アップロードは配列を返すのに、ワークフローは文字列を期待します。 複数ページのPDFは1ページにつき1つのドキュメントになります。そのdocument_idはページ順の配列であり、単一画像は文字列を返します。文字列を前提としたコードは行にundefinedを書き込み、ドキュメントを検索できなくなります。レスポンスの形状で分岐し、page_countを引き継ぎ、各ページをそれぞれのアイテムとして扱います。ページが1つの請求書に属する場合は、Multi-Page Mergeを設定し、結果に?merge=trueを追加して1つのエントリとして返すようにします。
あるドキュメントは、それ以外は成功したバッチの中で失敗することがあります。バッチが完全には成功しなかった場合、コールバックはfailedまたはcanceledを報告しますが、結果配列には成功したドキュメントが依然として含まれています。statusを確認せずにline_itemsを書き込むワークフローは、正常な行を書き込み、失敗した行を落とします。シートには行があるため完全に見えますが、フォルダの件数とは一致しません。失敗したものも含め、すべてのドキュメントに対してfilename、document_id、statusを含む行を書き込みます。結果ペイロードがステータスを提供し、アカウントイベントフィード(GET /events)がレビューキュー用にerrorフィールド付きのdocument.failedイベントを追加します。
n8nはat-least-onceのため、リトライで2行目が追加される
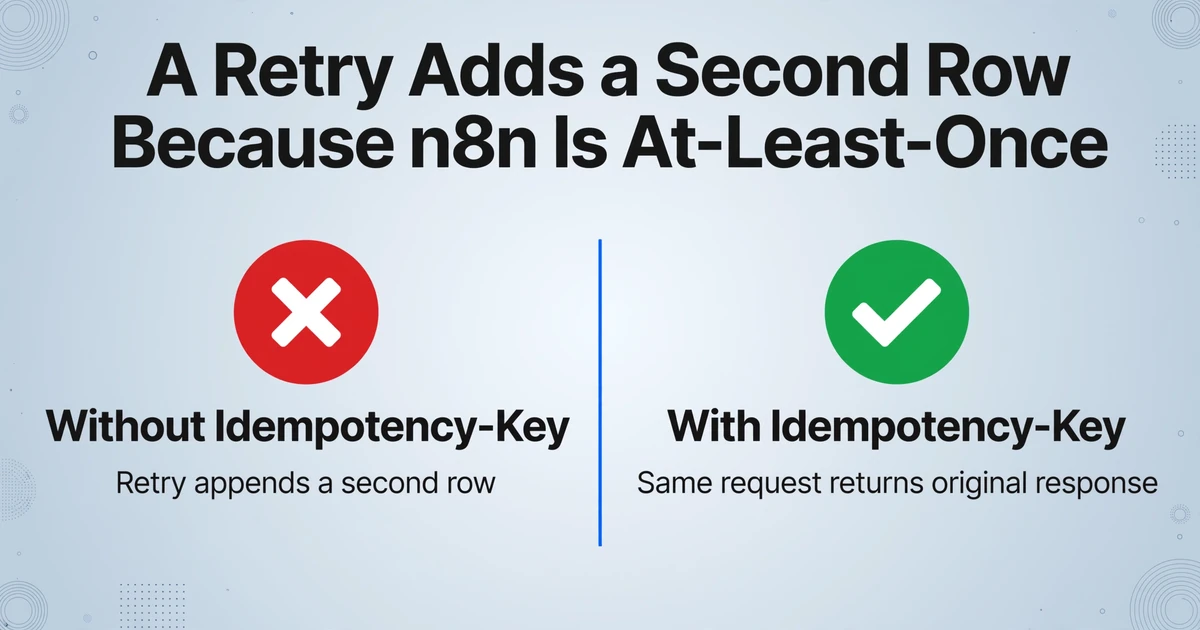
n8nのリトライはat-least-onceです。リトライは保存された実行データを再生しますが、失敗ポイントより下流の副作用ノードは再実行される可能性があり、プラットフォームにはexactly-onceの保証が組み込まれていません(n8nコミュニティの議論)。アップロードはドキュメントを作成し、Creditsを消費します。シートへの追加は行を作成します。タイムアウト後のリトライは、どちらも繰り返す可能性があります。
APIレイヤーでは、POST /documentsとPOST /batches/{batch_name}/processがIdempotency-Keyを受け付け、アカウント、キー値、エンドポイントごとに24時間保存されます。同じキーを持つ同じリクエストは、2つ目のドキュメントを作成したりCreditsを二重に差し引いたりすることなく、元のレスポンスを返します。同じキーで異なるリクエストを送ると400が返ります。キーは試行ではなくソースファイルから導出してください。Driveのfile id、または置き換えられたファイルを新規として扱うべき場合は<file_id>:<modified_time>を使用します。試行ごとにランダムなUUIDを使うと、この仕組みが機能しません。
シートレイヤーでは、APIキーは役に立ちません。ワークフローが3行を書き込んだ後に4行目で失敗した場合、リトライで最初の3行が再び追加される可能性があります。Google SheetsのAppend or Updateを、安定した1つのdedupe_key列とともに使用してください。両方が存在する場合はvendor + invoice_number、存在しない場合はdocument_idを使用します。その列で照合します。これにより、同じアップロードのリトライと、同じ請求書が新しいファイルとして届くケースの両方を捕捉できます。これは2つの異なる重複です。
同時実行はシートの2つ目の問題です。Google Sheetsの追加APIはアトミックではなく、同時書き込みが同じ行に着地する可能性があります。あるコミュニティスレッドでは、n8nの実行が緑色で成功しているのにビジネスレコードが存在しないケースが説明されています(n8nコミュニティ)。書き込みは1つに保ってください。一度に1つのバッチ、追加は順次実行、シートノードでのファンアウトは行いません。
Idempotency-Keyはアップロードを保護します。スプレッドシートは保護しません。
シートは成功ログではなく監査証跡であるべき
成功した行だけを受け取るシートでは、ワークフローが何を見落としたか分かりません。失敗を含むすべてのドキュメントに行を付け、その行を追跡可能にするメタデータを追加します:batch_name、document_id、source_filename、status、processed_at、そしてベンダー、請求書番号、日付、合計などの抽出フィールドです。
これらの列が照合を可能にします。ヘッダーテーブルでは、経理担当者がバッチでフィルタリングし、バッチが47件のドキュメントを報告しているのに対しシートには47行あることを確認し、合計が足りない理由を疑問に思う代わりにfailedと表示された2件を見つけられます。これらがなければ、シートを説明できるのはワークフローを構築した人だけです。
テンプレートが明細行を抽出する場合、1件のドキュメントから複数のline_itemsが生成されます。シートをヘッダーテーブル(請求書ごとに1行)にするか、明細行テーブル(ヘッダーフィールドを繰り返して明細ごとに1行)にするかを構築前に決めます。どちらも有効ですが、混在させると合計が二重計上されるシートになり、抽出エラーのように見えます。
下流のレイヤーは別の設計です。行が追跡可能になったら、次はシートが何に供給するかという問題になります:支払いスケジュール、仕入先元帳、または照合チェックです。APへの仕入先請求書パイプラインがそのレイヤーを扱います。n8nのジョブは、HTTP呼び出しが返ったときではなく、行が書き込まれ追跡可能になったときに終了します。
誤っているように見える行については、WebアプリのReview Modeでセルをクリックすると元のページ上のソース領域がハイライトされるため、金額を確認する人がPDFを開き直さずにその出所を確認できます。これは手動チェックです。ワークフローの役割は、疑わしい行を人に回すことであり、数値を保証することではありません。
このワークフローが依然として担う必要があること
ImageToTable.ai には公式の n8n ノードがなく、ワークフローが認証、リトライ、失敗ファイルを自身で処理する必要があります。 v1 API は REST インターフェースであるため、汎用の HTTP Request ノードがその統合手段となります。
トリガーは n8n に属します。Google Drive、Gmail、Webhook ノードは ImageToTable の機能ではなく、フォルダを監視する ImageToTable のボタンも存在しません。どのファイルが新規で、どれが処理済みかを判断するのは依然としてワークフローの役割です。
次に自身で担うのはリトライポリシーです。API は Webhook 配信をリトライし、Idempotency-Key を受け付けます。失敗したドキュメントをリトライするか、フラグを立てるか、人に確認するかは判断次第です。400 に対する一律リトライは時間を浪費するだけで、ファイルは修正されません。
厳格な制限も設計の一部です。 PDF は 1 回のアップロードにつき 50 ページまで、各プランには remaining_batch_capacity として返されるバッチ容量があり、ステータスエンドポイントは毎分 120 リクエストに制限されています。60 ページの PDF は部分的な成功ではなく 400 となり、制限を無視したポーリングループは 429 への対応に時間を費やします。
これは抽出を行うものであり、承認、発注書の照合、ERP への登録は行いません。 ワークフローには依然として、何が重複請求書と見なされるか、誰が金額を承認するか、どのシステムが最終レコードを受け取るかというルールが必要です。これらはビジネス上の判断であり、抽出設定ではありません。
印刷された表では精度は高く、劣悪なスキャンでは完全ではありません。当社の実績値は印刷された表データで最大 99% の認識率であり、1 ページは通常 5〜10 秒で処理されます。これはページ単位の処理時間であり、エンドツーエンドのレイテンシではありません。バッチは最も遅いドキュメントを待ち、さらにコールバックまたはポーリング間隔が加わります。不確実な金額はシートに平均化するのではなく、人に回してください。
チームがそもそも n8n を使っていない場合、ノーコードのスクリーンショットパイプラインがワークフローエンジンなしで同じ挿入ポイントを示します。
よくある質問
ImageToTable.ai の公式 n8n ノードはありますか?
いいえ。v1 API に HTTP Request ノードで接続します。アップロードは POST /documents、開始は POST /batches/{batch_name}/process、結果の取得は GET /batches/{batch_name}/results です。抽出は API が処理し、n8n はトリガー、リトライ、ルーティングを担当します。
n8n で Google Drive フォルダを監視し、新規ファイルだけを処理できますか?
はい、Google Drive Trigger ノードで可能です。デフォルトでは1分ごとにポーリングし、1つのフォルダを監視して、複数の新規ファイルを1つのイベントにまとめることができます。ワークフローは項目をループ処理する必要があり、サブフォルダが含まれるとは想定できません。同じフォルダにワークフロー自身も書き込む場合は、処理済みファイルを別の場所に保存し、その書き込みが次のトリガーにならないようにしてください。
Webhook とバッチステータスのポーリング、どちらを使うべきですか?
ワークフローをすぐ再開させたい場合で、安定した URL を公開できるなら Webhook を使います。レイテンシよりもシンプルなワークフローを優先するなら GET /batches/{batch_name} をポーリングします。all_done を確認し、毎分120リクエスト以下に抑えてください。小規模なバッチは最初のポーリング間隔より前に完了することが多く、ポーリングは作業を減らすどころかレイテンシを増やします。
ワークフローのリトライ時に重複行を防ぐには?
POST /documents と POST /process に、ソースファイル id から生成した Idempotency-Key を付けます。次に、document_id をキーにした Append or Update でシートへの書き込みを冪等にし、新しい id で再アップロードされたファイルにはベンダーや請求書番号などのビジネスキーも加えます。API キーは API 呼び出しを保護しますが、シートには独自のガードが必要です。
抽出に失敗したドキュメントはどうなりますか?
ステータスは failed になり、コールバックは failed を報告し、結果配列には空の line_items 配列を持つそのドキュメントが含まれます。ファイル名とステータスを記録した行を書き込み、シートの件数がフォルダの件数と一致するようにしてください。イベントフィードの document.failed イベントには error フィールドがあり、レビューキューにルーティングできます。
信頼できるワークフローはすべてのファイルに痕跡を残す
ドキュメントワークフローが信頼できるのは、決して失敗しないからではありません。入ってくるすべてのファイルが痕跡を残すからです。失敗したファイルも含めて、document id、batch name、ステータス、そして人が見つけられる行が残ります。抽出呼び出しは簡単な部分であり、設計の要点はその周囲にある4つの受け渡しです。
フォルダと列がすでにあるなら、コールバックとdedupe keyを配線する前に、API経由で請求書を1件送って設計をテストします。レスポンスから、ワークフローの残りの部分が何を受け取るかがわかります。
ドキュメントがフォルダではなくフォームから届く場合、フォーム抽出パイプラインが送信時点から引き継ぎます。