Extraktion von Bergbaudokumenten
scheitert am Intervall im Schichtenverzeichnis
Das kanadische Wertpapierrecht definiert die Datenverifizierung als den Prozess, mit dem bestätigt wird, dass Daten nach ordnungsgemäßen Verfahren erzeugt, korrekt aus der Originalquelle übertragen und zur Verwendung geeignet sind. Die korrekte Übertragung ist Teil der Definition der Verifizierung, noch bevor jemand eine Ressourcenschätzung erwähnt. Die meisten Projekte zur Extraktion von Bergbaudokumenten werden als Leseproblem angegangen: Kann die Software mit dem verblassten Scan umgehen? Die Fehler treten einen Schritt später auf, wo eine einzelne Intervallzeile mit ihrer Bohrloch-ID, ihren Von- und Bis-Tiefen, ihrer Einheit und ihrer Probennummer unverändert in die Bohrdatenbank gelangen muss.
Die wichtigsten Erkenntnisse
- Ein Analysezertifikat kann fehlerfrei gelesen werden, doch wenn die Bohrloch-ID nicht übereinstimmt, existiert diese ganze Zeile für das Modell nicht.
- Die Importprüfung erkennt überlappende Intervalle und fehlende Bohrloch-IDs, sagt aber kein Wort zu einer Zelle, in der aus 1,24 plötzlich 1,42 wird.
- Kopieren Sie in ImageToTable.ai die Spaltennamen exakt als Feldnamen der Datenbank, und geben Sie der Zertifikatsnummer eine eigene Spalte, damit neu ausgestellte Analyseergebnisse als ganze Zeile ersetzt werden können.
Fünf Arten von Aufzeichnungen stecken hinter einer einzigen Bohrdatenbank
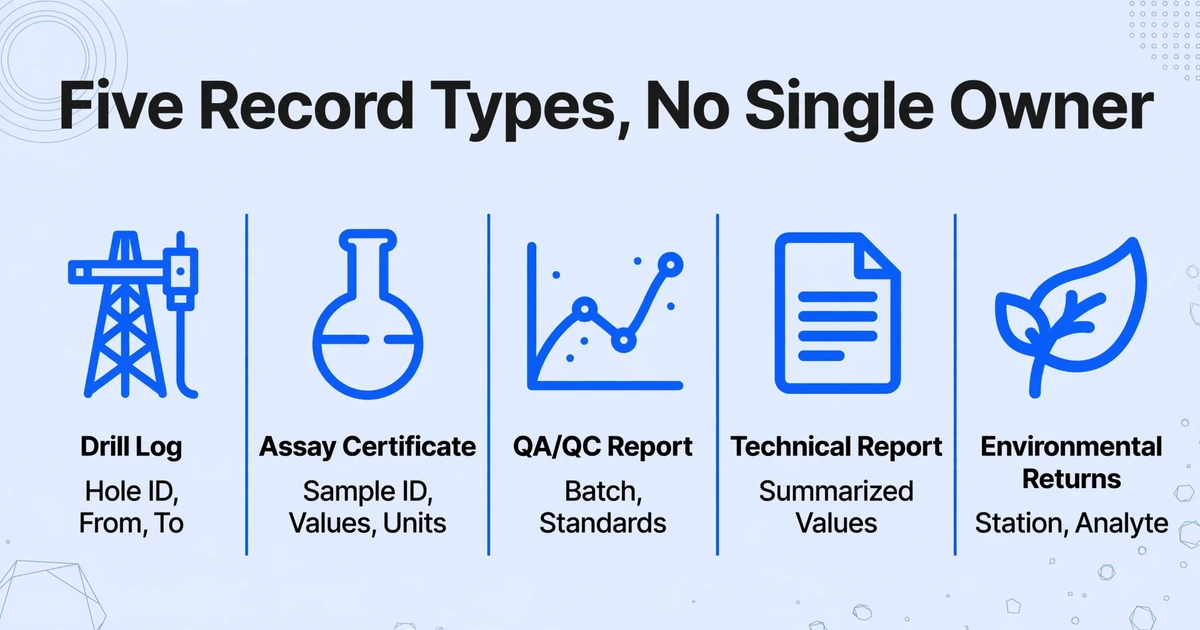
Ein Bohrprogramm erzeugt fünf Aufzeichnungstypen, bevor irgendjemand die Lagerstätte modellieren kann, und keine einzelne Rolle verantwortet sie alle. Diese Aufteilung ist der Grund, warum ein Wert auf der Seite einwandfrei gelesen werden kann und in der Datenbank trotzdem falsch ankommt.
Das Schichtenverzeichnis ist der Ort, an dem das Probenintervall festgelegt wird – am Bohrgerät, auf Papier oder in einer Logging-App. Das Analysezertifikat kommt aus dem Labor als ein PDF pro eingereichtem Batch zurück, mit Proben-IDs, Elementspalten, Einheiten, Nachweisgrenzen und den in diesen Batch eingefügten Kontrollproben. Der QA/QC-Bericht enthält die Diagramme, die entscheiden, ob ein Batch verwendbar ist. Ein technischer Bericht gibt die Ergebnisse für Investoren wieder, und Umwelt- oder Genehmigungsunterlagen folgen für eine Aufsichtsbehörde derselben Tabellenlogik.
| Aufzeichnung | Erstellt von | Wer darauf reagiert | Was erhalten bleiben muss |
|---|---|---|---|
| Schichtenverzeichnis | Geologe am Bohrgerät | Datenbankgeologe | Bohrloch-ID, Probennummer, Von- und Bis-Tiefen |
| Analysezertifikat | Analyselabor | Datenbankgeologe | Proben-IDs, Elementwerte, Einheiten, Nachweisgrenzen |
| QA/QC-Bericht | Labor- und Firmengeologe | Datenbankgeologe, QP | Batch-Referenz, Standard- und Blindproben-Ergebnisse |
| Technischer Bericht | Qualifizierte oder sachkundige Person | Investoren, Aufsichtsbehörden | Tabellenwerte, die mit der zusammengefassten Datenbank übereinstimmen |
| Umwelt- und Genehmigungsmeldungen | Standort- und Umweltpersonal | Compliance-Leiter, Aufsichtsbehörde | Stations-ID, Datum, Analyt, Einheit, Grenzwert |
Das Schichtenverzeichnis entscheidet, was beprobt wurde. Das Analysezertifikat entscheidet, was das Labor gefunden hat. Wenn die beiden bei der Probennummer nicht übereinstimmen, ist keines der Dokumente falsch – und die Zeile trotzdem unbrauchbar.
Dasselbe Muster zeigt sich einen Schritt weiter downstream in der Beschaffung, wo Wiegescheine und Gewichtszertifikate in die Abrechnung einfließen. Dieser Dokumentensatz hat seine eigene Feldlogik, behandelt im Leitfaden zum Extrahieren von Wiegeschein-Daten für die Massenbeschaffung.
Eine Bohrdatenbank akzeptiert genau eine Form
Geologische Software speichert Bohrdaten in vier Tabellen, und jedes Dokument muss auf eine davon reduziert werden: Ansatzpunkt, Vermessung, Intervall und Ereignis. Die Tabelle Ansatzpunkt enthält die Bohrloch-ID, Koordinaten, Höhe und Gesamttiefe. Die Tabelle Vermessung enthält Tiefen-, Neigungs- und Azimutwerte entlang des Bohrlochs. Intervall-Tabellen enthalten alles, was zwischen zwei Tiefen gemessen wurde – hier liegen Analysen und Lithologie. Ereignis-Tabellen enthalten Beobachtungen an einer einzelnen Tiefe.
Micromine dokumentiert die Struktur als vier Dateitypen, und dieselbe Anordnung findet sich in Datamine, Leapfrog, Maptek und acQuire, egal wie der Anbieter die Tabellen nennt. Die Intervall-Tabelle wird über drei Felder verschlüsselt: Bohrloch-ID, Von und Bis. Eine Analysezeile, die ihren Ansatzpunkt nicht findet, ist keine unvollständige Zeile. Sie ist unsichtbar für das Modell und für alles, was auf dem Modell aufbaut.
Deshalb ist eine extrahierte Tabelle eine Staging-Tabelle. Staging enthält, was im Dokument stand. Beim Laden werden das Schema, die Codes und die Validierungsregeln angewendet, auf die sich das Geologenteam geeinigt hat. Eine Datei, die Staging überspringt, hat den Workflow nicht automatisiert; sie hat die Nacharbeit zu demjenigen verschoben, der nun eine fertig aussehende Tabelle gegen eine Seite abgleichen muss.
Der Datensatz bricht an vier Stellen
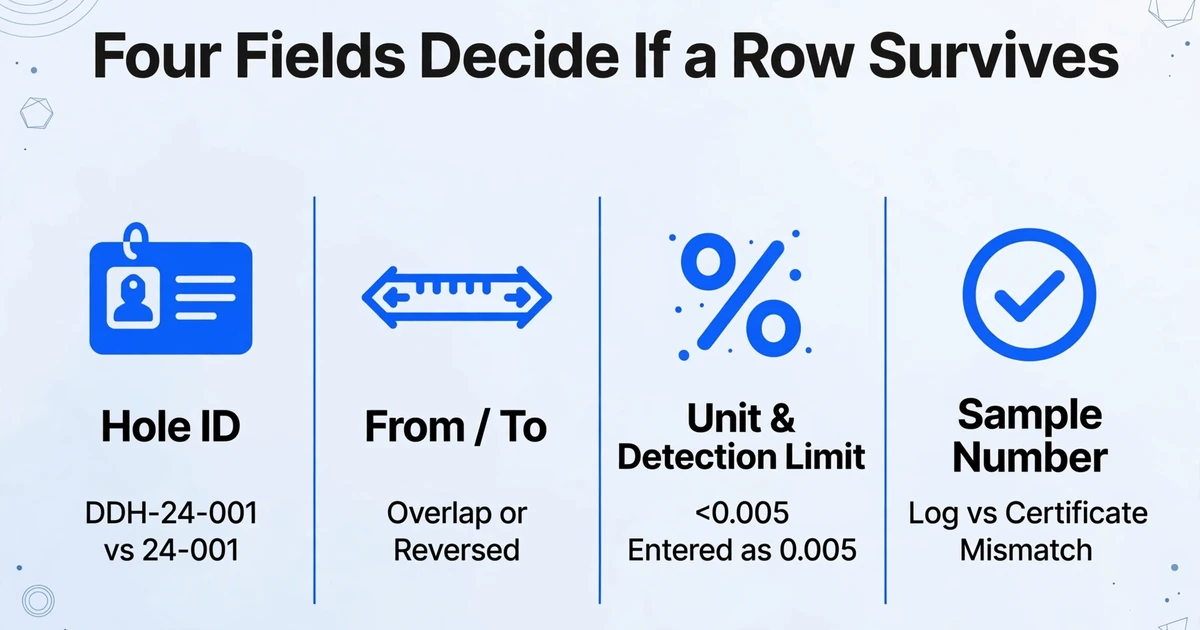
Vier Felder entscheiden, ob eine Zeile die Reise übersteht: Bohrloch-ID, das Von-und-Bis-Paar, die Einheit und Nachweisgrenze sowie die Probennummer, die das Schichtenverzeichnis mit dem Analysezertifikat verbindet.
Bohrloch-ID und ihre Varianten
Dasselbe Bohrloch erscheint als DDH-24-001 im Schichtenverzeichnis, als DDH24-001 im Kopf des Analysezertifikats und als 24-001 in einer historischen Zusammenfassung, mit dem Suffix A oder B, wo immer ein Bohrloch abgelenkt wurde. Leapfrog meldet diese als doppelte Bohrloch-ID oder als Bohrloch-ID, die nicht in der Ansatzpunkttabelle steht, und die dahinterliegenden Intervalle können nicht angezeigt werden, bis jemand entscheidet, welche Variante kanonisch ist. Diese Entscheidung obliegt dem Datenbankgeologen, und sie ist leicht einmal richtig und vierzigmal falsch zu treffen.
Von und Bis
Intervalle dürfen sich nicht überlappen, nicht über die Endteufe hinausgehen und nicht rückwärts verlaufen. Datamines Validierungshinweise besagen, dass eine Überlappung von mehr als einem Meter meist ein Dateneingabefehler ist, was eine höfliche Art zu sagen ist, dass jemand eine Tiefe aus der Zeile darüber eingegeben hat. Eine Tabelle, die auf die nächste Seite übergeht, ist die andere häufige Quelle: Die letzte Zeile wird als Kopfzeile wiederholt, als Daten gelesen und erzeugt ein Intervall, das das vorherige dupliziert.
Einheit und Nachweisgrenze
Labore drucken die Einheit einmal in der Spaltenüberschrift und drucken ein Kleiner-als-Zeichen, wenn ein Ergebnis unter der Nachweisgrenze liegt. Beide Konventionen brechen eine naive Extraktion. Ein Goldwert von <0,005 als 0,005 eingegeben, überzeichnet den Gehalt; als 0 eingegeben wird er zu einer Null, die jeden Durchschnitt nach unten zieht und auf einer logarithmischen Skala nicht dargestellt werden kann. Einheiten verschärfen das, weil Gold für dieselbe Zahl in ppm und in g/t angegeben wird (1 g/t entspricht 1 ppm), während Kupfer mit dem Faktor 10.000 zwischen Prozent und ppm wechselt. Eine Spalte, die ihre Einheit verliert, ist eine Spalte, die niemand sicher mit einer anderen kombinieren kann.
Probennummer und Zertifikatsnummer
Die Probennummer ist die einzige Verbindung zwischen dem Intervall im Schichtenverzeichnis und dem Wert im Analysezertifikat. Hier gehen Labore und Unternehmen auch auseinander, denn ein Labor kann seine eigene interne Nummerierung parallel zur Nummerierung des Auftraggebers führen, und ein Analysezertifikat kann nach einer erneuten Analyse neu ausgestellt werden. Wenn die Zertifikatsnummer nicht mit der Zeile mitgeführt wird, kann ein überholtes Ergebnis nicht gefunden und ersetzt werden, sodass beide Versionen geladen werden und eine davon stillschweigend gewinnt.
Die Validierung erfasst die Struktur und übersieht die Werte
Die Importvalidierung erfasst die strukturelle Fehlerklasse und sagt nichts über die Werteklasse aus, weshalb ein sauberer Import kein korrekter Import ist.
Überlappungen, umgekehrte Intervalle, fehlende Ansatzpunkte und Tiefen jenseits des Endes des Bohrlochs sind allein aus der Tabelle erkennbar, und die großen Modellierungsprogramme prüfen sie beim Import. Ein Gehalt, der als 1,42 statt 1,24 eingegeben wird, erzeugt überhaupt keine Warnung: Er liegt in einem gültigen Intervall, unter einer gültigen Bohrloch-ID und sieht aus wie jede andere Zahl in der Spalte. Die einzige Möglichkeit, ihn zu finden, ist der Vergleich der Zelle mit der Seite, aus der sie stammt – genau das beschreibt die rechtliche Definition der Verifizierung.
Der Vergleich ist der teure Teil, und diejenigen, die ihn durchführen, beschreiben ihn als Konvertierungsprojekt. Ein r/geology-Thread beginnt mit „Ich war jetzt bei mehreren Unternehmen, die versucht haben, von Papierprotokollen auf digitale Protokolle umzustellen." Der British Columbia Geological Survey veröffentlichte eine Bohrdatenbank, die aus mehr als 400 Bewertungsberichten aufgebaut wurde und über 6.000 Bohrlöcher, 80.000 Proben und 3,8 Millionen Bestimmungen aus 1.300 Analysezertifikaten enthält. Das ergibt grob 60 Proben pro Zertifikat und etwa 47 Elementergebnisse pro Probe, sodass ein einzelnes Zertifikat eine breite Tabelle mit einigen tausend Zellen ist. Deren Pipeline führte mehr als 60 Verifizierungsprüfungen an den bereitgestellten Tabellen durch und schickte Zeichen mit geringer Zuverlässigkeit dennoch zurück zum Originaldokument, damit eine Person sie mit dem Auge vergleicht.
Sechzig automatisierte Prüfungen sagen Ihnen nicht, dass aus 1,24 eine 1,42 geworden ist. Das tut nur ein Vergleich mit der Quellseite.
Hier ist auch der Punkt, an dem die manuelle Eingabe aufhört, die günstigere Option zu sein. Wenn Sie die Rechnung dazu wollen, wie sich Tippfehler auf Feldebene unter Termindruck zu Fehlern auf Datensatzebene summieren, arbeitet der Vergleich von OCR und manueller Dateneingabe das an einem Dokumentensatz mit derselben Struktur durch.
Technische Berichte sind ein anderes Extraktionsproblem
Ein technischer Bericht gibt eine Datenbank wieder, die bereits existiert. Wenn Sie seine Tabellen extrahieren, erhalten Sie also eine Zusammenfassung einer Zusammenfassung und keine Originalquelle.
Die drei Regelwerke laufen auf denselben Punkt hinaus. NI 43-101 verlangt eine schriftliche Erklärung, ob eine qualifizierte Person die Daten verifiziert hat, wie und mit welchen Einschränkungen, und das Formular fragt nach den Verifizierungsschritten und der Einschätzung des QP, ob die Daten für den verwendeten Zweck ausreichend sind. Tabelle 1 des JORC-Code 2012 verlangt von der sachkundigen Person, Primärdaten, Dateneingabeverfahren, Datenverifizierung und Speicherprotokolle zu dokumentieren und jede Anpassung der Analysedaten zu erörtern. SEC-Regelung S-K 1300 verlangt eine datierte und unterzeichnete Zusammenfassung des technischen Berichts von einer qualifizierten Person, die die Verantwortung für Informationen eines externen Spezialisten nicht ablehnen kann.
Zusammen gelesen beschreiben diese Anforderungen eine Kette, die mit einer namentlich genannten Person endet, die unterschreibt. Einen technischen Bericht zu extrahieren ist nützlich für die Due Diligence, für den Vergleich der offengelegten Abschnitte eines Wettbewerbers mit Ihrem eigenen Gebiet und für die Prüfung, ob eine Tabelle im Bericht mit der Datenbank übereinstimmt, die sie angeblich zusammenfasst. Zum Wiederaufbau einer Datenbank ist es ein schlechter Weg, denn diese Tabellen wurden aggregiert, gerundet und gefiltert, bevor sie gedruckt wurden.
Was eine Extraktionsschicht bewahren muss
Die Extraktion hat eine Aufgabe: Zeilen zu erzeugen, deren Zellen sich auf eine Seite zurückführen und ohne Neueingabe in das Staging übernehmen lassen.
ImageToTable.ai erledigt das durch Custom Column Extraction. Sie geben die gewünschten Spaltennamen ein, und die KI findet den passenden Wert überall auf der Seite, indem sie versteht, was das Feld bedeutet, statt wo es steht. So füllt ein Zertifikat mit anderem Layout dieselbe Spalte. Die von Ihnen eingegebenen Namen werden zu den Überschriften der Ausgabetabelle. Der schnellste Weg zu einer Staging-Tabelle, die Ihrem Schema entspricht, ist daher die direkte Übernahme der Feldnamen des Schemas: Hole ID, Sample ID, From (m), To (m), Au (ppm), Certificate No.
Ein Ordner mit Zertifikaten, der als ein Batch hochgeladen wird, liefert eine Tabelle, wobei die Zertifikatsnummer in einer Spalte mitgeführt wird, sodass ein neu ausgestelltes Ergebnis auffindbar bleibt. Multi-Page Merge gruppiert Ergebnisse nach einer verfolgten Spalte, sodass ein Schichtenverzeichnis, dessen Intervalltabelle auf eine zweite Seite überläuft, als eine durchgehende Intervallfolge unter einer Bohrloch-ID zurückkommt statt als zwei unzusammenhängende Tabellen. Berechnete Spalten decken die Intervalllänge als To minus From ab, eine bedingte Prüfung, die die Differenz zurückgibt, wenn To nicht größer als From ist, und eine Einheitenumrechnung mit einem festen Faktor wie 10.000 für Prozent in ppm.
Der Überprüfungsmodus hebt den genauen Bereich der Originalseite hinter jeder Zelle hervor, wodurch die Verifizierung zu einem Klick pro Zelle wird statt zu einem Scrollen zwischen zwei Dokumenten. Gedruckte Tabellendaten werden mit bis zu 99 Prozent erkannt, und eine Seite wird in Sekunden verarbeitet statt in den Minuten, die ein Mensch zum Abtippen braucht. Dichte Handschrift, verblasste Durchschläge und gedrehte Scans sind der Bereich, in dem eine höhere Verarbeitungsstufe ihre Kosten rechtfertigt, und dort ist die Verifizierung am wichtigsten.
Ein Workflow, der den Import übersteht
Fünf Schritte, und der erste erfolgt, bevor überhaupt etwas hochgeladen wird.
Beginnen Sie beim Schema
Listen Sie die Felder auf, die Ihre Intervalltabelle erwartet, mit Einheiten, und verwenden Sie diese Namen wörtlich als Ihre Spalten. Eine Spalte namens Au (ppm) kann nicht stillschweigend einen Wert in g/t erhalten.
Extrahieren Sie eine Zeile pro Probe
Behalten Sie die Zertifikatsnummer und die Proben-ID des Labors in eigenen Spalten. Über diese beiden Felder finden Sie die Zeilen, die ersetzt werden müssen, wenn ein Zertifikat neu ausgestellt wird.
Führen Sie die strukturellen Prüfungen in der Tabelle aus
Intervalllänge, vertauschte Tiefen, doppelte Proben-IDs und fehlende Bohrloch-IDs lassen sich alle finden, bevor der Import-Validator sie sieht.
Stichprobenprüfung der Zeilen, die zählen
Prüfen Sie anhand der Quelle die Intervalle mit den höchsten Gehalten, jede Zeile, die eine strukturelle Prüfung nicht bestanden hat, und eine Zufallsstichprobe des Rests.
Übergeben Sie Staging, keine Datenbank
Die Datei geht mit angehängten Zertifikatsnummern an den Datenbankgeologen, für Schema-Mapping, Code-Validierung und Import.
Wenn Sie auch Extraktionsplattformen für andere industrielle Dokumenttypen vergleichen, deckt der Test von Extraktionstools anhand von Fertigungsdokumenten ab, wie sich vorlagenbasierte, trainierte und Vision-Modell-Ansätze bei der tatsächlichen Genauigkeit auf Feldebene unterscheiden.
Was beim Geologen, Datenbankadministrator und QP bleibt
Die Extraktion endet dort, wo das Urteilsvermögen beginnt, und die Liste der Dinge, die sie nicht tut, ist länger als die Liste der Dinge, die sie tut.
Sie interpretiert keine Geologie, entscheidet nicht, ob ein Lithologiecode korrekt ist, führt keine Desurveying eines Bohrlochs durch, erstellt keine QA/QC-Statistiken wie Bias und Präzision bei Standards und Duplikaten und urteilt nicht darüber, ob ein Batch akzeptabel ist. Sie importiert nicht in acQuire, Datamine, Micromine, Leapfrog oder Maptek, schätzt keine Ressource und bietet keine Beratung zur Konformität mit NI 43-101, JORC oder S-K 1300. Sie weiß nicht, dass ein Zertifikat ein früheres ersetzt, es sei denn, die Zertifikatsnummer steht in der Ausgabe, damit eine Person sie vergleichen kann.
Was bleibt, ist der Teil, der die Unterschrift trägt: der Datenbankgeologe, der Unstimmigkeiten zwischen Schichtenverzeichnis und Analysezertifikat auflöst, der Ressourcengeologe, der die Intervalle interpretiert, und die qualifizierte oder sachkundige Person, die die Daten verifiziert und ihren Namen dafür hergibt.
Häufig gestellte Fragen
Kann es handschriftliche Schichtenverzeichnisse aus den 1970er- und 1980er-Jahren lesen?
Oft, aber nicht zuverlässig genug, um die Prüfung zu überspringen. Die Engine verarbeitet gedruckten Text, Handschrift, Schreibschrift, Tabellen und Kontrollkästchen, und eine höhere Verarbeitungsstufe verbessert dichte Handschrift. Maschinengeschriebene Schichtenverzeichnisse mit handschriftlichen Korrekturen, verblasste Fotokopien und gedrehte Seiten sind die schwierigen Fälle, planen Sie also ein, einen größeren Anteil der Zellen gegen die Quellseite zu prüfen.
Wie sollte ein Wert wie <0.005 behandelt werden?
Extrahieren Sie ihn wie gedruckt, einschließlich des Kleiner-als-Zeichens, und entscheiden Sie die Ersetzung innerhalb der Datenbank, wo die Regel dokumentiert werden kann. Ihn während der Extraktion in 0.005 oder 0 umzuwandeln, verbirgt eine Entscheidung, die jeden aus der Tabelle berechneten Durchschnitt beeinflusst. Eine separate Spalte mit der Nachweisgrenze hält diese Entscheidung nachvollziehbar.
Kann es direkt in acQuire, Datamine oder Leapfrog schreiben?
Nein. Die Ausgabe erfolgt als Excel, CSV, JSON oder Word, und der Import in eine geologische Datenbank erfolgt durch den Datenbankgeologen über die Import- und Validierungswerkzeuge der jeweiligen Software. Die API kann strukturiertes JSON in Ihre eigenen Systeme übertragen, aber die Feldzuordnung und die Validierungsregeln gehören weiterhin zu Ihrer Datenbank.
Sollte ich die Tabellen in einem NI 43-101 technischen Bericht extrahieren?
Für Prüfung, Vergleich und Due Diligence: ja. Diese Tabellen sind aggregierte und gefilterte Zusammenfassungen und daher ein schwacher Ersatz für Analysezertifikate und Schichtenverzeichnisse, wenn das Ziel der Aufbau oder Wiederaufbau einer Datenbank ist. Extrahieren Sie sie, um eine Aussage zu prüfen, nicht um eine Tabelle zu befüllen, die in eine Ressourcenschätzung einfließt.
Welche Genauigkeit sollte ich bei Analysezertifikaten erwarten?
Gedruckte Tabellendaten werden mit bis zu 99 Prozent erkannt, und Genauigkeit ist nicht dasselbe wie Korrektheit für Ihre Datenbank: Ein Wert kann korrekt gelesen werden und trotzdem in der falschen Spalte landen, wenn die Spaltennamen nicht zu Ihrem Schema passen.
Brauche ich noch einen Datenbankgeologen, wenn die Extraktion automatisiert ist?
Ja. Jemand muss entscheiden, welche Bohrloch-ID-Variante kanonisch ist, ob ein Batch QA/QC besteht, wie Werte unterhalb der Nachweisgrenze behandelt werden und was in welcher Reihenfolge geladen wird. Die Extraktion reduziert das Tippen, das diesen Entscheidungen vorausgeht. Sie trifft sie nicht.
Die Branche hat ein Jahrzehnt damit verbracht, zu verbessern, wie Maschinen Seiten lesen, und das Lesen ist selten der Grund, warum ein Projekt ins Stocken gerät. Was das Ergebnis entscheidet, ist kleiner und langweiliger: ob jede Intervallzeile mit derselben Bohrloch-ID, demselben Von und Bis, derselben Einheit und derselben Probennummer in der Datenbank ankommt, die das Zertifikat verwendet hat. Wenn das stimmt, haben die Modellierungssoftware, die QA/QC-Prüfung und die qualifizierte Person etwas Solides, womit sie arbeiten können.