Wie funktioniert Handschrifterkennung?
Warum KI die herkömmliche OCR übertrifft
Denken Sie daran, wie Sie die unleserliche Handschrift eines Freundes auf einem Haftzettel lesen. Sie entschlüsseln nicht jeden Buchstaben einzeln – Sie erfassen das ganze Wort auf einmal, ergänzen mehrdeutige Zeichen aus dem Kontext und nutzen die Struktur des Zettels („Einkäufe:“ oben, „$“ vor einer Zahl), um ihn zu verstehen. So liest KI Handschrift: ganzheitliches Verständnis statt buchstabenweiser Entschlüsselung. Herkömmliche OCR macht das Gegenteil – sie isoliert jedes Zeichen, gleicht es mit einer Vorlage ab und bricht zusammen, sobald Buchstaben sich verbinden. Der architektonische Unterschied ist auf Zeichenebene messbar: Beim IAM-Handschrift-Benchmark erreichen führende KI-Modelle eine Zeichenfehlerrate von etwa 1,2 %, während Tesseract, die am weitesten verbreitete Open-Source-OCR-Engine, 12,5 % liefert – und bei Schreibschrift wird diese Lücke nur noch größer. Das ist keine Kalibrierungslücke – es sind zwei grundlegend verschiedene Arten, eine Seite zu sehen.
Wo das einzuordnen ist: Diese Seite ist der tiefe Einblick in den Mechanismus – wie die Technologie unter der Haube funktioniert. Für die Definition und den Überblick beginnen Sie mit was KI-Handschrifterkennung ist; für die Genauigkeit nach Handschrifttyp siehe kann KI Handschrift aus Fotos lesen.
Die wichtigsten Erkenntnisse
- Die meisten Menschen greifen zur OCR, um Handschrift zu lesen, weil es das einzige Werkzeug ist, das sie kennen. OCR wurde in den 1970er-Jahren für Schreibmaschinen entwickelt, und ihre Grundannahme – dass Zeichen als trennbare, standardisierte Formen existieren – ist für jedes jemals geschriebene handschriftliche Wort falsch.
- OCR lässt sich für Handschrift nicht „verbessern“, weil das Problem nicht die Genauigkeitsabstimmung ist – es ist die Architektur. Die Zeichensegmentierung bricht bei Schreibschrift-Verbindungen zusammen, der schriftartenbasierte Merkmalsabgleich scheitert bei variablem Strichdruck, und die Engine hat keinen Dokumentkontext, um Mehrdeutigkeiten aufzulösen.
- KI liest Handschrift so wie Sie: Sie erkennt ganze Wörter visuell, füllt Lücken aus dem Kontext und nutzt die Dokumentstruktur, um zu entscheiden, ob ein mehrdeutiges Gekritzel eine „5“ oder eine „6“ ist. Der Architekturwechsel von Zeichen für Zeichen zum ganzheitlichen Lesen schafft einen Genauigkeitsvorsprung von 40 Punkten bei Schreibschrift.
Warum herkömmliche OCR bei Handschrift versagt
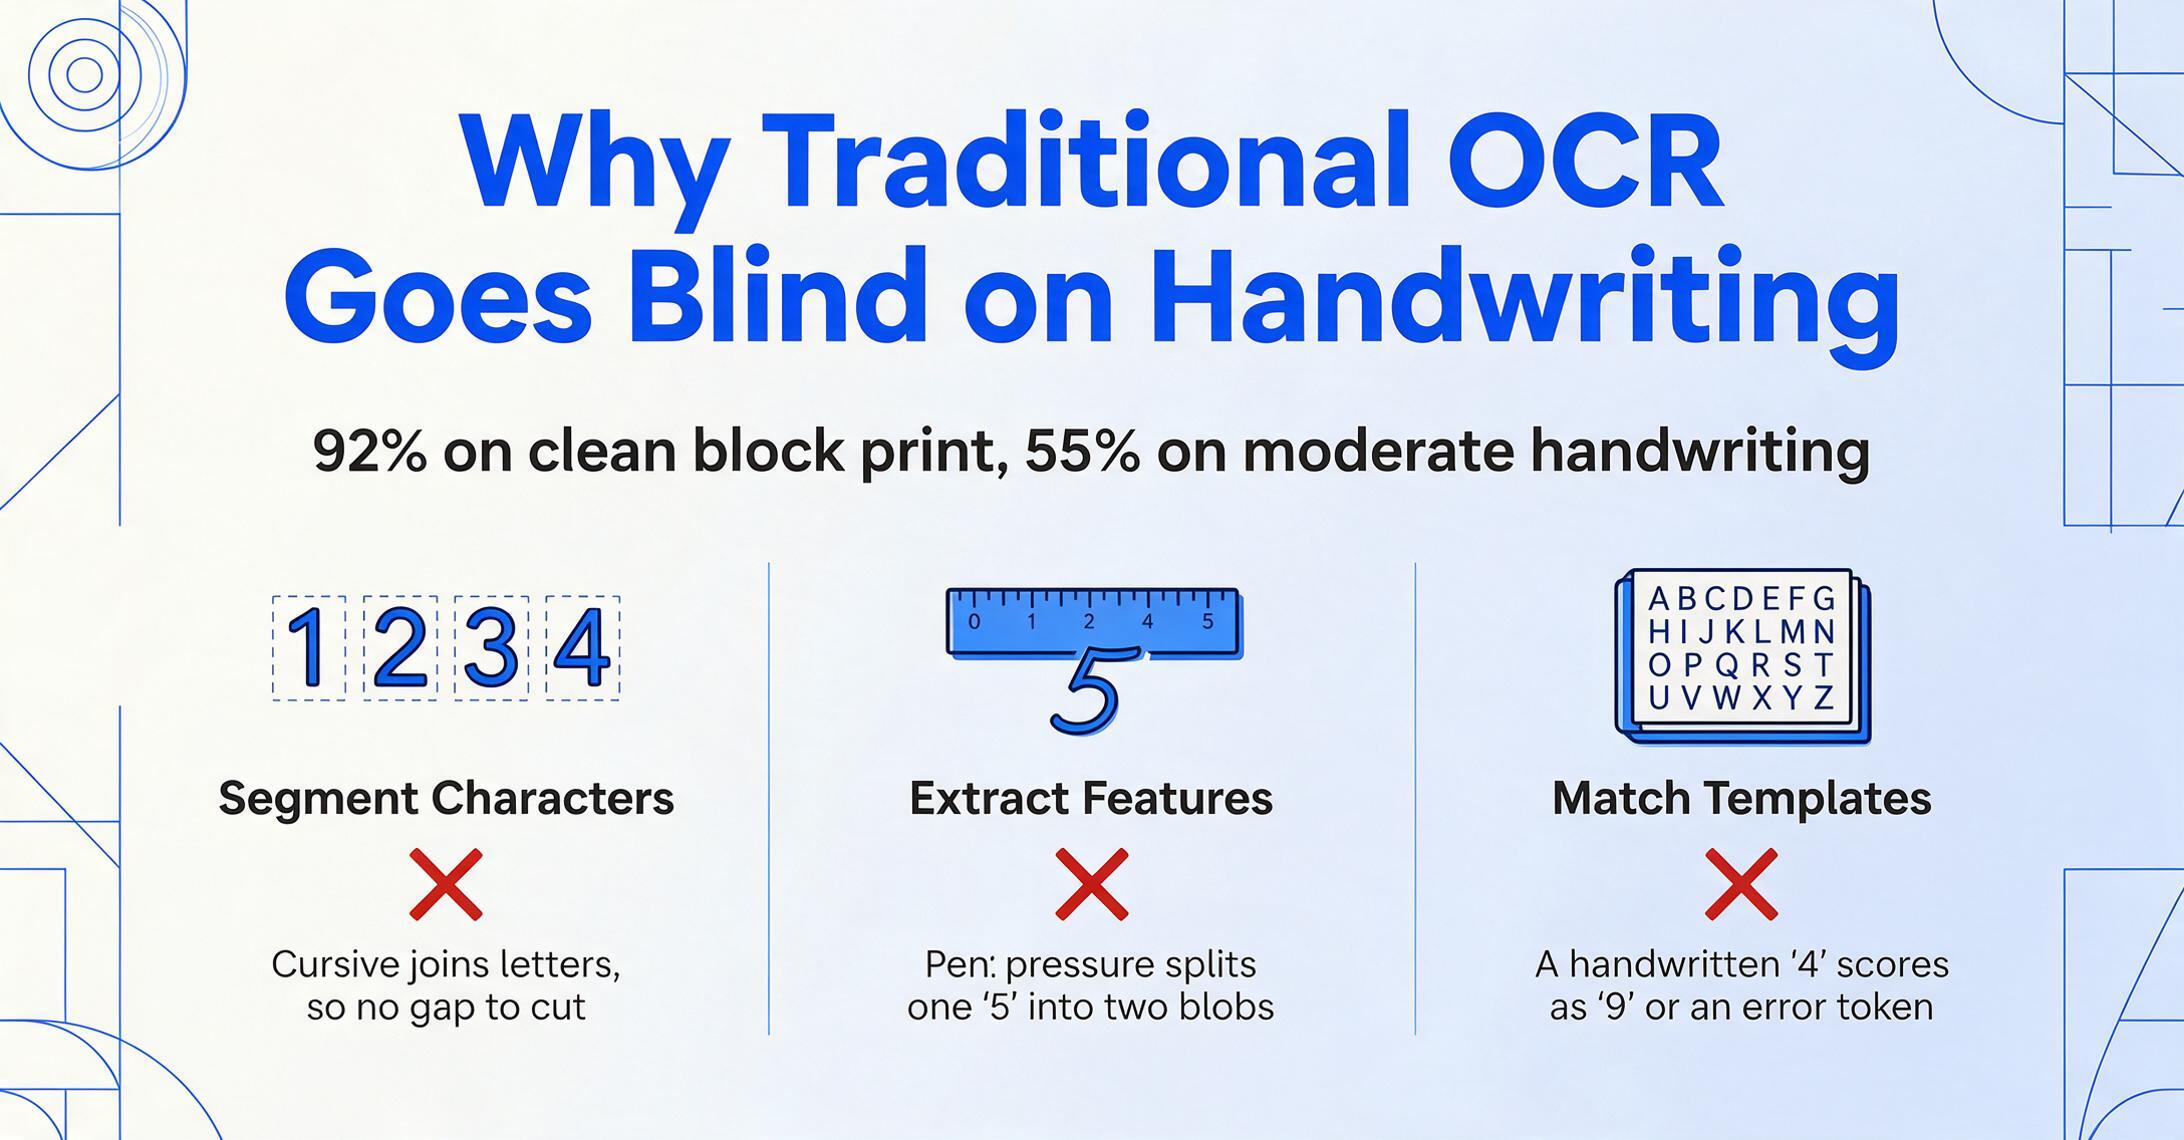
Herkömmliche OCR wurde in den 1970er-Jahren für Schreibmaschinen und gedruckte Formulare entwickelt. Ihre Architektur beruht auf drei aufeinander aufbauenden Annahmen – und Handschrift bricht jede einzelne davon.
Schritt eins: Zeichensegmentierung. Die Engine erkennt Leerraum-Lücken zwischen Zeichen und isoliert jedes Glyph in einer Begrenzungsbox. Das funktioniert bei Courier New; es scheitert bei Schreibschrift, wo die Verbindung zwischen einem „a" und einem „r" keine Lücke hinterlässt, die erkannt werden könnte. Eine Studie aus dem Jahr 2025 ergab, dass herkömmliche OCR von 92 % Genauigkeit bei sauberer Druckschrift auf 55 % bei mäßiger Handschriftverschlechterung abfällt – Bedingungen, die bei gedrucktem Text kaum als Rauschen wahrgenommen werden.
Schritt zwei: Merkmalsextraktion. Nach der Isolierung misst die Engine die geometrischen Eigenschaften jedes Zeichens – Strichanzahl, Kurvenwinkel – und vergleicht sie mit gespeicherten Merkmalsvektoren. Handschrift macht das zunichte, weil der variable Druck eines Kugelschreibers eine einzelne „5" in einen Klecks plus einen separaten Strich zerlegen kann. Der Merkmalsvektor passt zu keiner Vorlage – nicht weil das Zeichen falsch ist, sondern weil die Bibliothek für Schriftarten und nicht für Hände gebaut wurde.
Schritt drei: Vorlagenabgleich. Extrahierte Merkmale werden gegen eine Datenbank bewertet, die ausschließlich mit Drucktypen trainiert wurde. Die beste Vermutung der Engine bei einer handgeschriebenen „4" ist oft „9", „A" oder ein Fehlertoken. Sie kann nicht um Hilfe bitten – sie gibt ihre beste Vermutung aus und der Fehler pflanzt sich nachgelagert fort.
Segmentierungsfehler speisen fehlerhafte Merkmale in einen schriftartenbasierten Abgleicher ein und erzeugen Unsinn. Bei der IAM-Handschriftendatenbank – 13.353 Textzeilen von 657 Schreibern – erzielte Tesseract, die am weitesten verbreitete Open-Source-OCR-Engine, eine Zeichenfehlerrate (CER) von 12,5 %. Bei Schreibschrift übersteigt ihre Wortfehlerrate (WER) 95 % (codesota.com, 2026). Das ist kein Abstimmungsproblem. Es ist eine Architektur, die für getrennte Zeichen gebaut wurde und auf ein Medium trifft, das sie bewusst verbindet.
Wie KI Handschrift liest: Von Zeichen zu Kontext
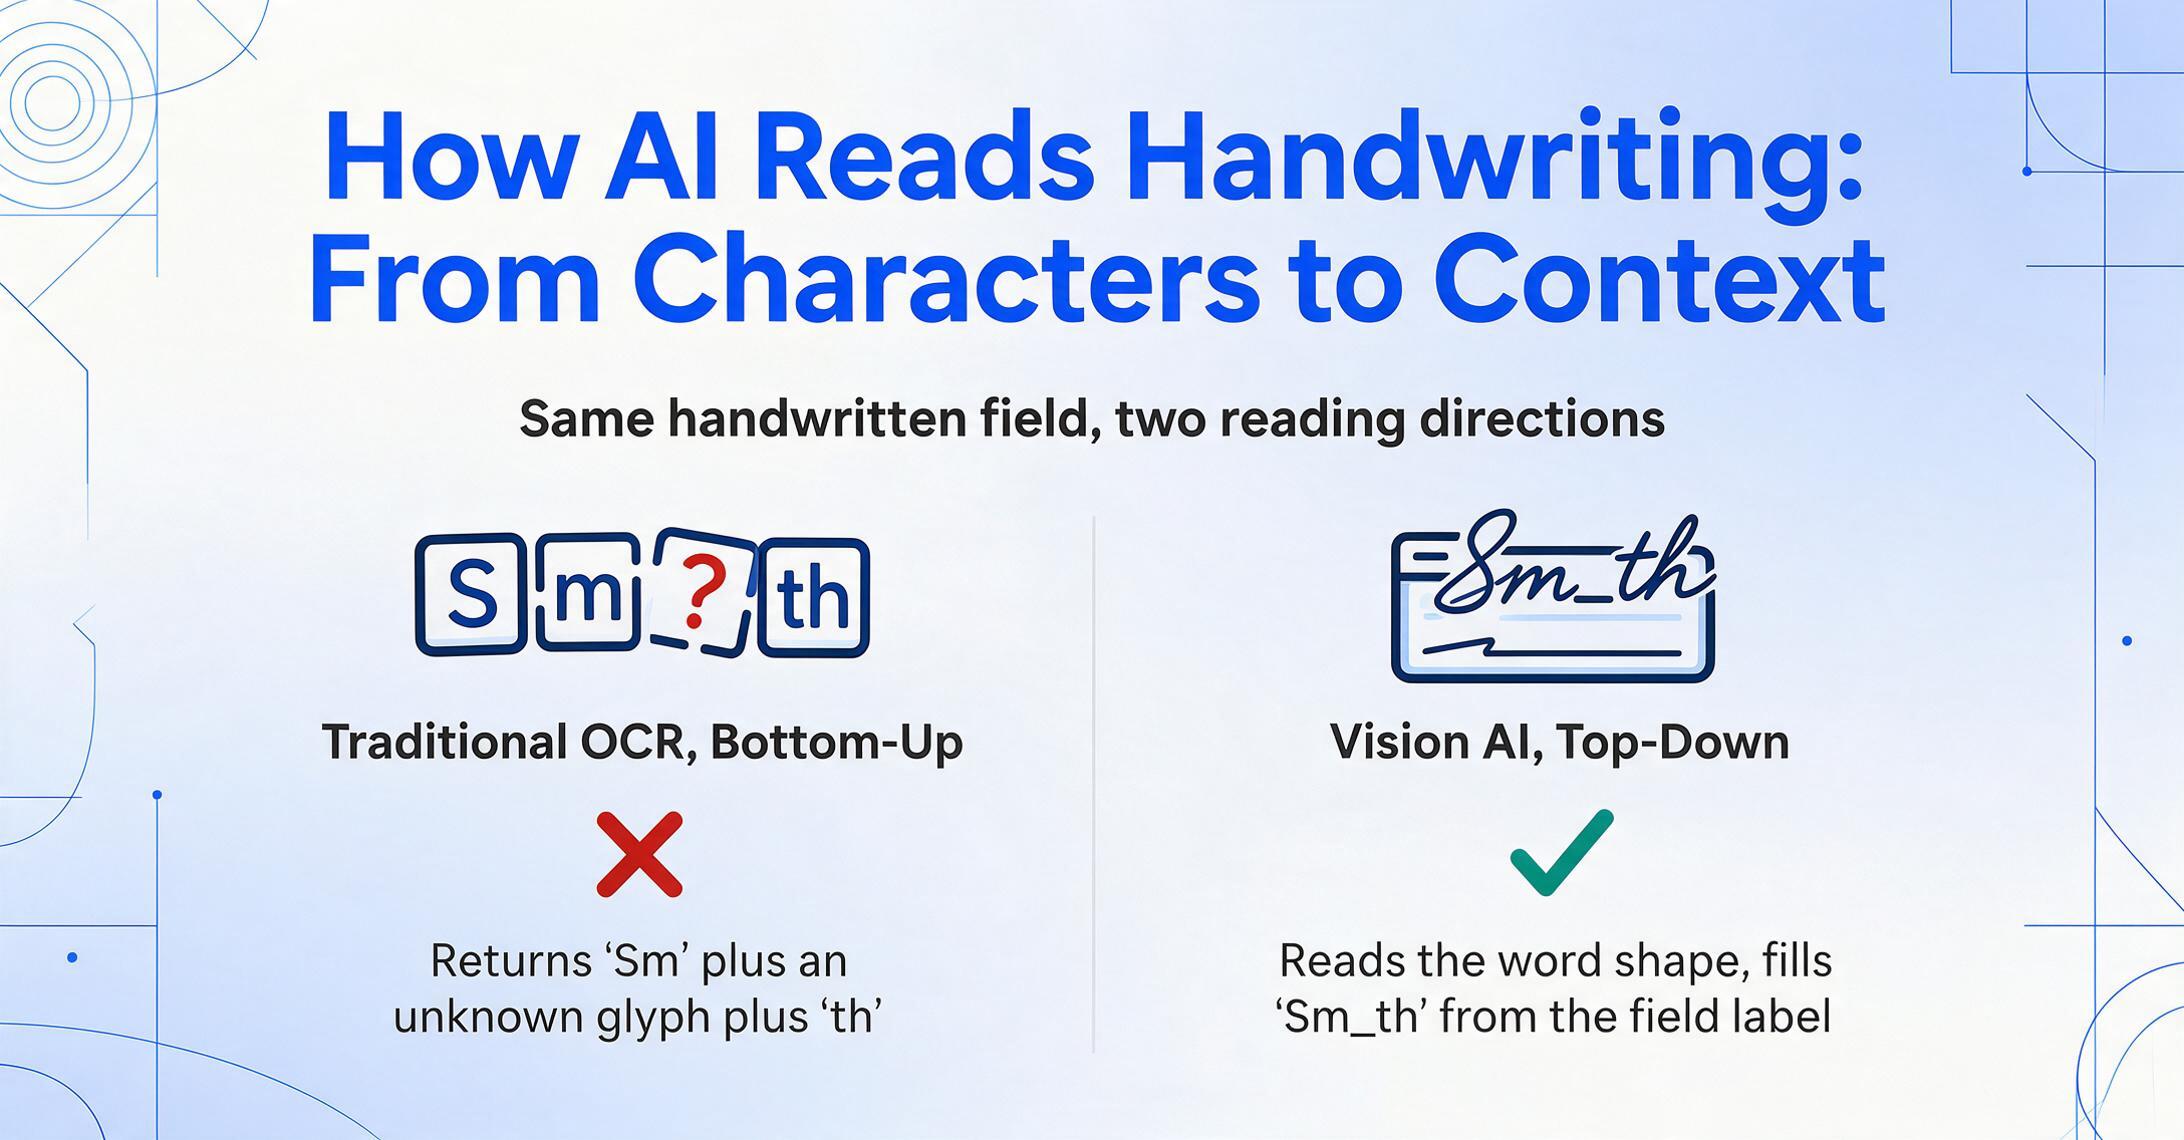
Moderne KI-Handschrifterkennung – unterstützt durch Vision-Sprachmodelle – kehrt die herkömmliche OCR-Pipeline komplett um. Statt Wörter aus Zeichen aufzubauen (Bottom-up), erkennt sie Wörter als visuelle Ganzheiten und nutzt Dokumentverständnis, um einzelne Striche zu disambiguieren (Top-down). Dies ist dieselbe kognitive Strategie, die Sie beim Lesen einer handgeschriebenen Notiz anwenden.
Ganzheitliche Worterkennung. Statt eine Seite in einzelne Zeichen zu segmentieren, verarbeitet die KI-Vision das gesamte Bild durch ein tiefes neuronales Netzwerk, das visuelle Merkmale gleichzeitig auf mehreren Ebenen extrahiert – Striche, Buchstabenteile, Wortformen, Zeilenmuster. Ein Wort wie „Total“ wird nicht aus T-o-t-a-l zusammengesetzt. Es wird als einheitliches visuelles Muster erkannt – so wie Sie das Gesicht eines Freundes erkennen, ohne einzelne Merkmale zu katalogisieren. Kursive Verbindungen verwirren ein Modell nicht, das nie Zeichen segmentiert hat.
Kontextbasierte Disambiguierung. Ein handschriftlicher Eintrag mit einem schwachen oder fehlenden Zeichen in „Sm_th“ lässt herkömmliche OCR nur „Sm“ plus ein unerkanntes Zeichen plus „th“ zurückgeben. Eine KI-Vision sieht die Wortform und den umgebenden Kontext – dies ist das Feld „Kundenname“ und das Dokument stammt von einem bekannten Kontakt – und füllt die Lücke aus dem Kontext. Derselbe Mechanismus unterscheidet handschriftliche „1“ von „l“, „0“ von „O“ und „7“ von „1“ – indem gefragt wird: Was ergibt in diesem Feld Sinn?
Robustheit gegenüber Strichvariationen. Trainiert auf Millionen von Bildern von Tausenden von Schreibern, hat die KI-Vision eine enorme Bandbreite an Handschriftstilen, Stifttypen und Schreibflächen gesehen. Die variable Strichbreite eines Füllfederhalters, die Druckvariationen eines Kugelschreibers, das schwache Graphit eines Bleistifts – all das liegt in der Trainingsverteilung. Das Modell abstrahiert oberflächliche Variationen und konzentriert sich auf die zugrunde liegende Zeichenstruktur – ohne den Stil jedes Schreibers in einer Vorlagenbibliothek zu benötigen.
Dokumentebenen-Semantikverständnis. Diese Ebene verwandelt die Handschrifterkennung von einem Transkriptionswerkzeug in eine Datenextraktions-Engine. Die Beschriftung „Rechnungsnummer“ sagt dem Modell, dass der handschriftliche Wert daneben ein alphanumerischer Code sein sollte, kein Datum. Dies ist Benutzerdefinierte Spaltenextraktion: Sie definieren die gewünschten Spaltennamen – „Datum“, „Lieferant“, „Gesamt“ – und die KI lokalisiert jeden handschriftlichen Wert, indem sie versteht, was er semantisch bedeutet, nicht durch Abgleich einer Vorlagenposition. Für einen tieferen Einblick, was KI-Handschrifterkennung tatsächlich leisten kann, lesen Sie, ob KI Handschrift aus Fotos lesen kann und mit welcher Genauigkeit.
Die Genauigkeitslücke: OCR vs. KI bei Handschrift
Der Unterschied zwischen der Funktionsweise dieser beiden Ansätze ist nicht akademisch — er erzeugt eine messbare Lücke, die darüber entscheidet, ob ein Tool bei einem bestimmten Dokument brauchbar oder nutzlos ist.
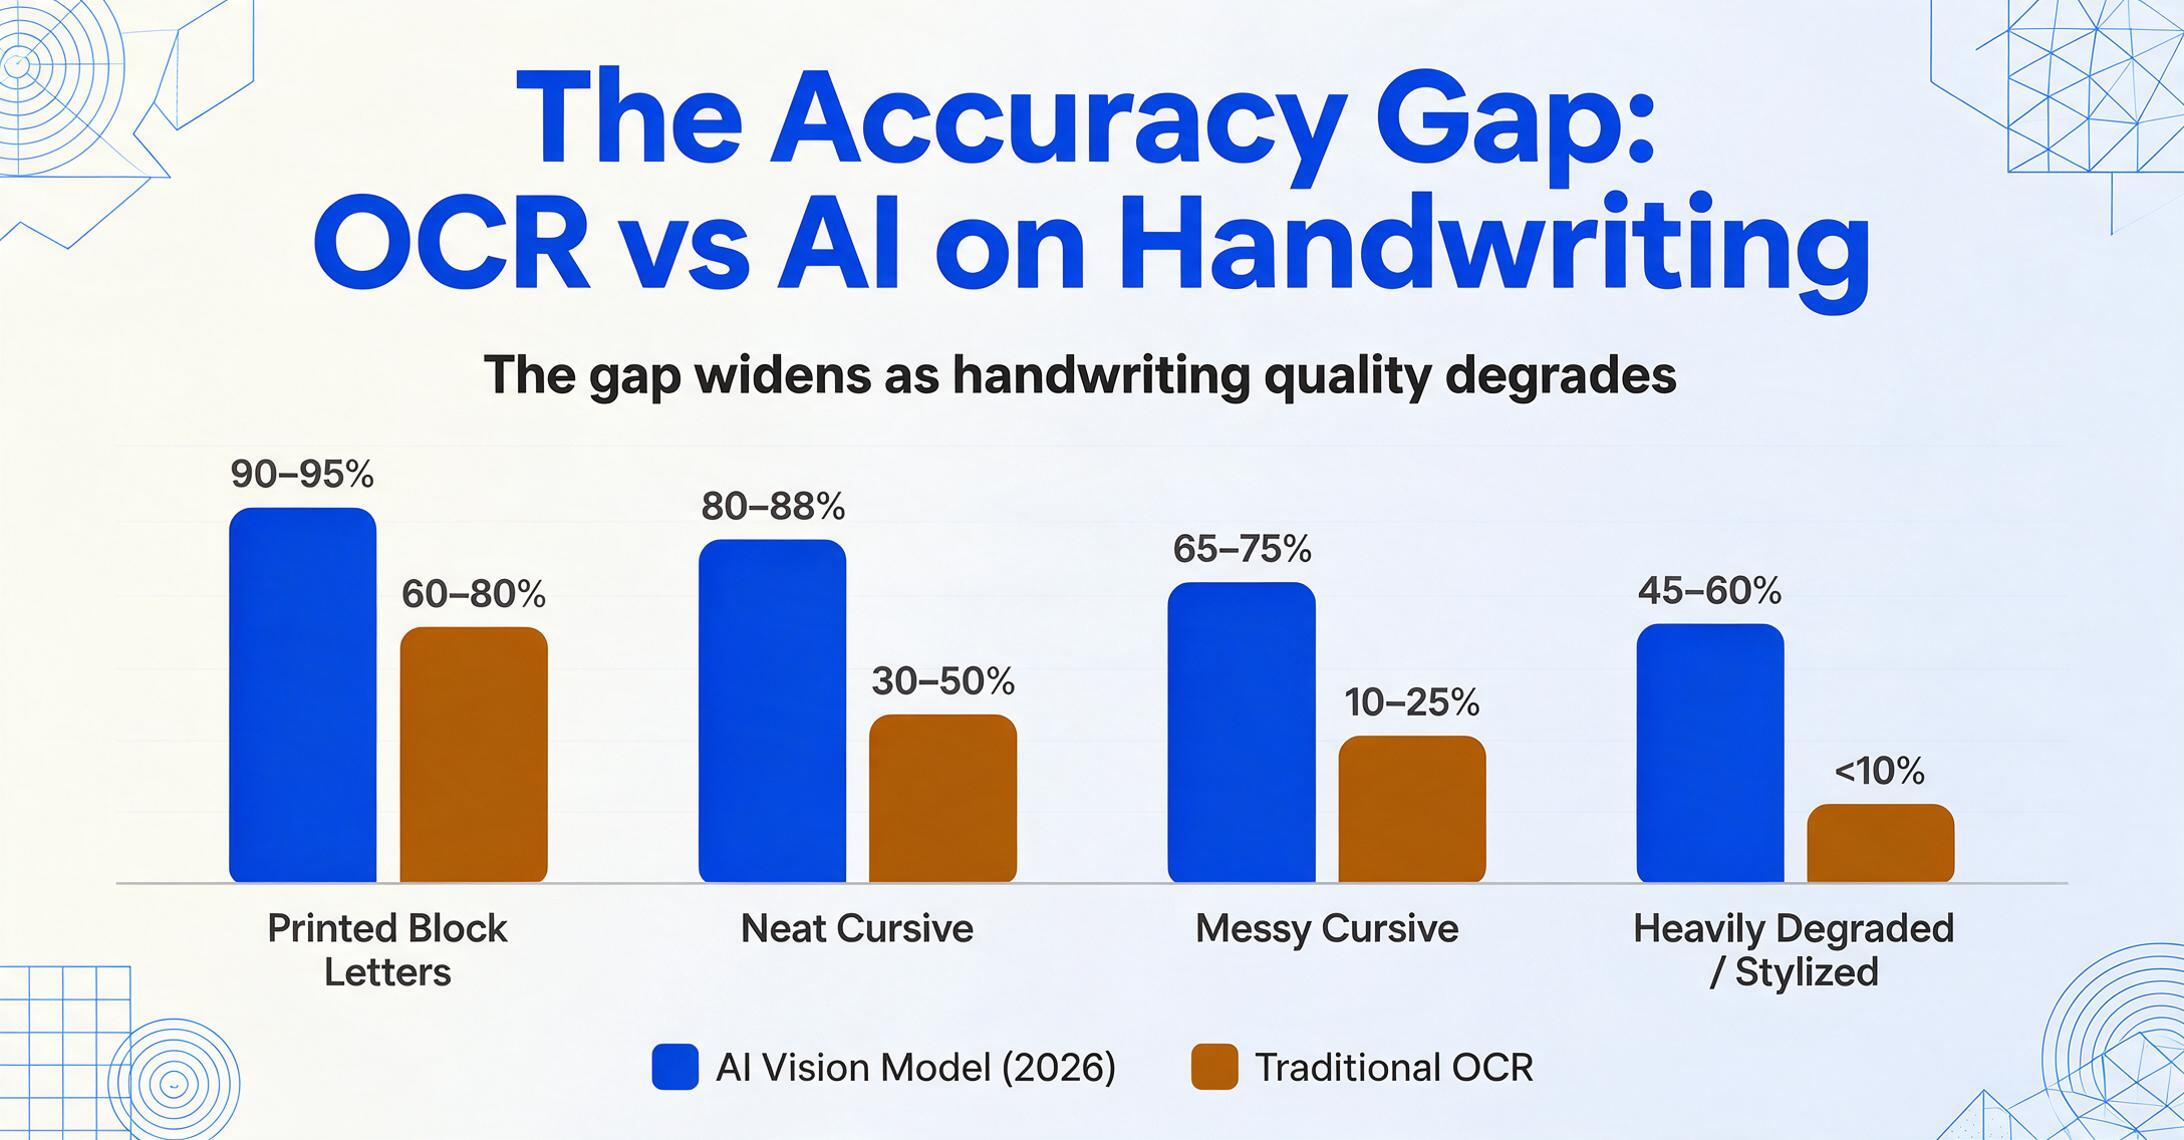
| Handschrifttyp | KI-Vision-Modell (2026) | Herkömmliche OCR | Lücke |
|---|---|---|---|
| Gedruckte Blockschrift | 90–95% | 60–80% | 15–25 Pkt. |
| Saubere Schreibschrift | 80–88% | 30–50% | 38–50 Pkt. |
| Unordentliche Schreibschrift | 65–75% | 10–25% | 40–55 Pkt. |
| Stark beeinträchtigt / stilisiert | 45–60% | <10% | 35–50 Pkt. |
Dies sind reine Erkennungswerte — wie viele Zeichen und Wörter auf Transkriptebene korrekt zurückkommen. Die Genauigkeit auf Feldebene, bei der jeder extrahierte Wert in der richtigen Tabellenkalkulationsspalte landet, ist höher, weil der Dokumentkontext mehrdeutige Zeichen eindeutig auflöst; die Zahlen auf Feldebene sind Gegenstand unseres Vergleichs von KI und herkömmlicher OCR. Wenn Sie ein Tool auswählen und nicht den Mechanismus verstehen möchten, vergleicht unsere Übersicht von Handschrift-OCR-Software, sortiert nach Schreibschriftgenauigkeit, 11 Optionen nach Technologiekategorie.
Die Lücke wird größer, je schlechter die Handschriftqualität wird — genau dort, wo Sie am meisten darauf angewiesen sind, dass das Tool funktioniert. Bei gedruckter Blockschrift ist herkömmliche OCR brauchbar. Bei sauberer Schreibschrift springt die Lücke auf etwa 40 Punkte — nutzbare Daten vs. alles manuell neu tippen. Bei unordentlicher Schreibschrift liefert herkömmliche OCR bei mehr als drei Vierteln der Wörter Kauderwelsch. KI liefert auf dieser Stufe zwar unvollkommene, aber zumindest überprüfenswerte Daten statt solcher, die man verwerfen muss.
Unabhängige Benchmarks bestätigen dies auf Zeichenebene. In der IAM-Handschriftdatenbank erreicht GPT-5 eine Zeichenfehlerrate von ~1,22% — weniger als 2 Fehler pro 100 Zeichen — während Tesseract 12,5% CER erzielt (codesota.com, April 2026). Beim Wortfehlerraten-Benchmark von handwritingocr.com 2026 erreichen die besten spezialisierten Tools unter 1% WER bei sauberer Schreibschrift, während Cloud-OCR-APIs zwischen 8% und 23% WER liegen — das bedeutet, dass bei kostenpflichtigen Cloud-Diensten bis zu ein Viertel aller Wörter falsch zurückkommt. Einen vollständigen Überblick zur Genauigkeit finden Sie unter KI-Handschrifterkennung vs. herkömmliche OCR.
Welche Arten von Handschrift KI am besten verarbeitet – und wo sie noch Schwächen hat
Die Genauigkeitszahlen oben beantworten die Frage „Wie unterscheidet sich KI von OCR?“. Die nächste Frage lautet: Wie wird KI bei meinen Dokumenten abschneiden? Die Antwort hängt von drei Variablen ab.
Strukturierte Formulare mit beschrifteten Feldern liefern die besten Ergebnisse. Wenn ein Dokument klare Feldbeschriftungen hat – „Datum“, „Mitarbeitername“, „Stunden“ – und handschriftliche Einträge in dafür vorgesehenen Bereichen, nutzt die KI diese Beschriftungen als semantische Anker. Das Modell weiß, dass der Inhalt unter „Datum“ einem Datumsmuster entsprechen sollte, was die Erkennung einschränkt und Fehler unterdrückt. Wenn Ihre Dokumente Formulare mit vorgedruckten Beschriftungen und handschriftlichen Antworten in Druckschrift oder sauberer Schreibschrift sind, können Sie mit einer Feldgenauigkeit von über 90 % rechnen.
Konsistente Dokumente von einem einzelnen Verfasser schneiden deutlich besser ab als Sammlungen mit mehreren Verfassern. Wenn derselbe Techniker 50 Inspektionsformulare ausfüllt, lernt die KI implizit über die Seiten hinweg seine Strichmuster – wie er „7“en formt, die Neigung seiner „t“s. Die ersten Seiten etablieren das Muster; nachfolgende Seiten profitieren davon. AIMultiple's Benchmark von 2026 mit 100 handschriftlichen Proben von festen Mitwirkenden zeigte, dass Top-Modelle bei konsistenten Einzelverfasser-Sammlungen eine produktionsreife semantische Ähnlichkeit erreichten.
Unstrukturierte freie Notizen – Seiten mit handschriftlicher Prosa oder Randbemerkungen – drängen die KI in ihren schwächeren Leistungsbereich. Ohne Feldbeschriftungen zur Verankerung der Extraktion führt das Modell eine reine Transkription statt einer strukturierten Extraktion durch. Ein Review von 2025 zeigte, dass GPT-4.1 von ~85 % bei sauberen einseitigen Handschriften auf ~65 % bei der dritten Seite mehrseitiger Notizen abfiel, wo das Modell begann, Text zu erfinden, der nicht auf der Seite stand.
Die praktische Schwelle: Wenn zwei Personen, die dieselbe Handschrift lesen, sich darüber einig sind, was dort steht, wird die KI es wahrscheinlich richtig erkennen. Wenn Menschen uneins sind, wird die KI falsch raten. Für spezifische Fehlermuster und Lösungen finden Sie in unserem Leitfaden zu Fehlerarten bei der Handschriftextraktion.
Häufig gestellte Fragen
Muss KI-Handschrifterkennung auf meine Handschrift trainiert werden?
Nein – und das ist ein grundlegender Unterschied zu älteren ICR-Systemen, die 10–20 Trainingsbeispiele pro Schreiber benötigten. Moderne Vision-KI ist mit Millionen von Handschriftproben von Tausenden von Schreibern vortrainiert. Sie verarbeitet neue Handschriften Zero-Shot: Laden Sie eine Handschrift von einem Schreiber hoch, den das Modell noch nie gesehen hat, und es extrahiert ohne Einrichtung. Weitere Informationen finden Sie unter Was KI-Handschrifterkennung ist und wie Vision-KI Schreibschrift liest.
Wie unterscheidet KI zwischen einer handschriftlichen „5“ und „6“ oder „1“ und „7“?
Durch Kontext. Eine handschriftliche „5“ und „6“ können isoliert identisch aussehen – aber die KI liest sie nicht isoliert. Wenn das Feld mit „Gesamt“ beschriftet ist und das Dokument Positionen mit bekannten Preisen zeigt, kann das Modell validieren, ob eine „5“ oder „6“ ein mathematisch kohärentes Ergebnis ergibt. Diese kontextbasierte Disambiguierung ist der Grund, warum die Feldgenauigkeit die rohe Zeichenerkennungsrate weit übertrifft – die KI nutzt das Dokument als Ganzes, um lokale Mehrdeutigkeiten aufzulösen.
Kann KI Daten aus handschriftlichen Formularen extrahieren oder transkribiert sie nur Text?
KI extrahiert strukturierte Daten – das ist der entscheidende Unterschied zur einfachen Handschrift-zu-Text-Transkription. Statt eines rohen Textblocks platziert die KI jeden Wert in seiner eigenen Spalte: „Rechnungsnummer: 1042“, „Datum: 15.03.26“, „Gesamt: 847,50 $.“ Der Mechanismus ist Benutzerdefinierte Spaltenextraktion: Sie definieren die Ausgabespalten, und die KI ordnet jedes handschriftliche Feld zu, indem sie versteht, was es bedeutet, statt es an einer festen Pixelkoordinate zu finden.
Warum kann herkömmliche OCR nicht einfach für Handschrift verbessert werden?
Weil die nötige Verbesserung keine Erweiterung ist – sondern eine Neuschreibung der grundlegenden Architektur. Die Zeichensegmentierungs-Annahme herkömmlicher OCR ist in jeder Schicht verankert. Sie für Handschrift zu „verbessern“ erfordert, Segmentierung durch ganzheitliche Erkennung zu ersetzen, schriftbasierte Merkmalsextraktion durch gelernte visuelle Merkmale zu ersetzen und dokumentübergreifendes Kontextverständnis hinzuzufügen – und an diesem Punkt haben Sie ein KI-Vision-Modell gebaut. Mehrere Cloud-OCR-Anbieter haben ML-Schichten auf ihre herkömmlichen Engines für Handschrift aufgesetzt, aber die Ergebnisse (60–70 % bei Schreibschrift) spiegeln die Grenzen des Flickens einer unpassenden Architektur wider. Die führenden Lösungen sind zu Vision-Sprachmodellen übergegangen, statt zeichenbasierte OCR nachzurüsten.
Funktioniert Handschrifterkennung bei Handyfotos oder nur bei Scans?
Handyfotos funktionieren gut – und sind heute die häufigste Eingabeart für KI-Handschrifterkennung. Moderne KI-Modelle kommen mit perspektivischer Verzerrung und ungleichmäßiger Beleuchtung zurecht, woran herkömmliche OCR scheitert. Ein gut aufgenommenes Handyfoto (frontal, gleichmäßige Beleuchtung, mindestens 200 DPI) liefert eine Genauigkeit, die nur 3–5 Prozentpunkte unter der eines Flachbettscans liegt. Seit 2024 ist die Robustheit der Modelle gegenüber realen Bildartefakten so weit, dass Handykamera-Eingaben für geschäftliche Handschrift-Workflows praktikabel sind.
Der Unterschied zwischen herkömmlicher OCR und KI-Handschrifterkennung ist keine Frage des Grades – er ist eine Frage der Architektur. Die eine liest Buchstaben. Die andere liest Dokumente. Bei strukturierten handschriftlichen Formularen mit klaren Feldbezeichnungen bedeutet dieser Architekturunterschied einen Genauigkeitsvorsprung von 40 Punkten – der Unterschied zwischen einer fertigen Tabelle und Kauderwelsch.
Beginnen Sie mit der Definition und dem Überblick darüber, wofür KI-Handschrifterkennung steht. Testen Sie dann die Genauigkeitsversprechen – sehen Sie, was KI bei echter Handschrift liest über verschiedene Stile und Dokumenttypen hinweg. Wenn Sie Tools bewerten, schlüsselt unser Vergleich von KI und herkömmlicher OCR bei Handschrift die Zahlen nach Dokumenttyp auf.