Como funciona o reconhecimento de caligrafia?
Por que a IA supera o OCR tradicional
Pense em como você lê a caligrafia bagunçada de um amigo num post-it. Você não decodifica cada letra individualmente — você vê a palavra inteira de uma vez, preenche caracteres ambíguos pelo contexto e usa a estrutura da nota ("mercado:" no topo, "$" antes de um número) para dar sentido a ela. É assim que a IA lê caligrafia: compreensão holística em vez de decodificação letra por letra. O OCR tradicional faz o oposto — isola cada caractere, compara-o com um modelo e desmorona no momento em que as letras se conectam. A diferença arquitetural é mensurável no nível do caractere: no benchmark de caligrafia IAM, modelos de IA de ponta apresentam cerca de 1,2% de taxa de erro de caracteres, enquanto o Tesseract, o mecanismo de OCR de código aberto mais usado, retorna 12,5% — e em cursiva essa diferença só aumenta. Não é uma diferença de calibração — são duas formas fundamentalmente diferentes de enxergar uma página.
Onde isso se encaixa: esta página é o mergulho no mecanismo — como a tecnologia funciona por baixo do capô. Para a definição e o panorama, comece com o que é reconhecimento de caligrafia por IA; para precisão por tipo de caligrafia, veja a IA consegue ler caligrafia em fotos.
Principais Conclusões
- A maioria das pessoas recorre ao OCR para ler caligrafia porque é a única ferramenta que conhece. O OCR foi criado para máquinas de escrever nos anos 1970 e sua premissa central — de que os caracteres existem como formas padronizadas separáveis — é falsa para toda palavra manuscrita já escrita.
- O OCR não pode ser "melhorado" para caligrafia porque o problema não é ajuste de precisão — é arquitetura. A segmentação de caracteres desmorona nas conexões cursivas, a correspondência de características baseada em fontes falha com pressão de traço variável, e o mecanismo não tem contexto do documento para resolver ambiguidades.
- A IA lê caligrafia como você: reconhecendo palavras inteiras visualmente, preenchendo lacunas pelo contexto e usando a estrutura do documento para decidir se um rabisco ambíguo é um "5" ou um "6". A mudança de arquitetura de caractere por caractere para leitura holística cria uma vantagem de 40 pontos de precisão em cursiva.
Por que o OCR tradicional falha com caligrafia
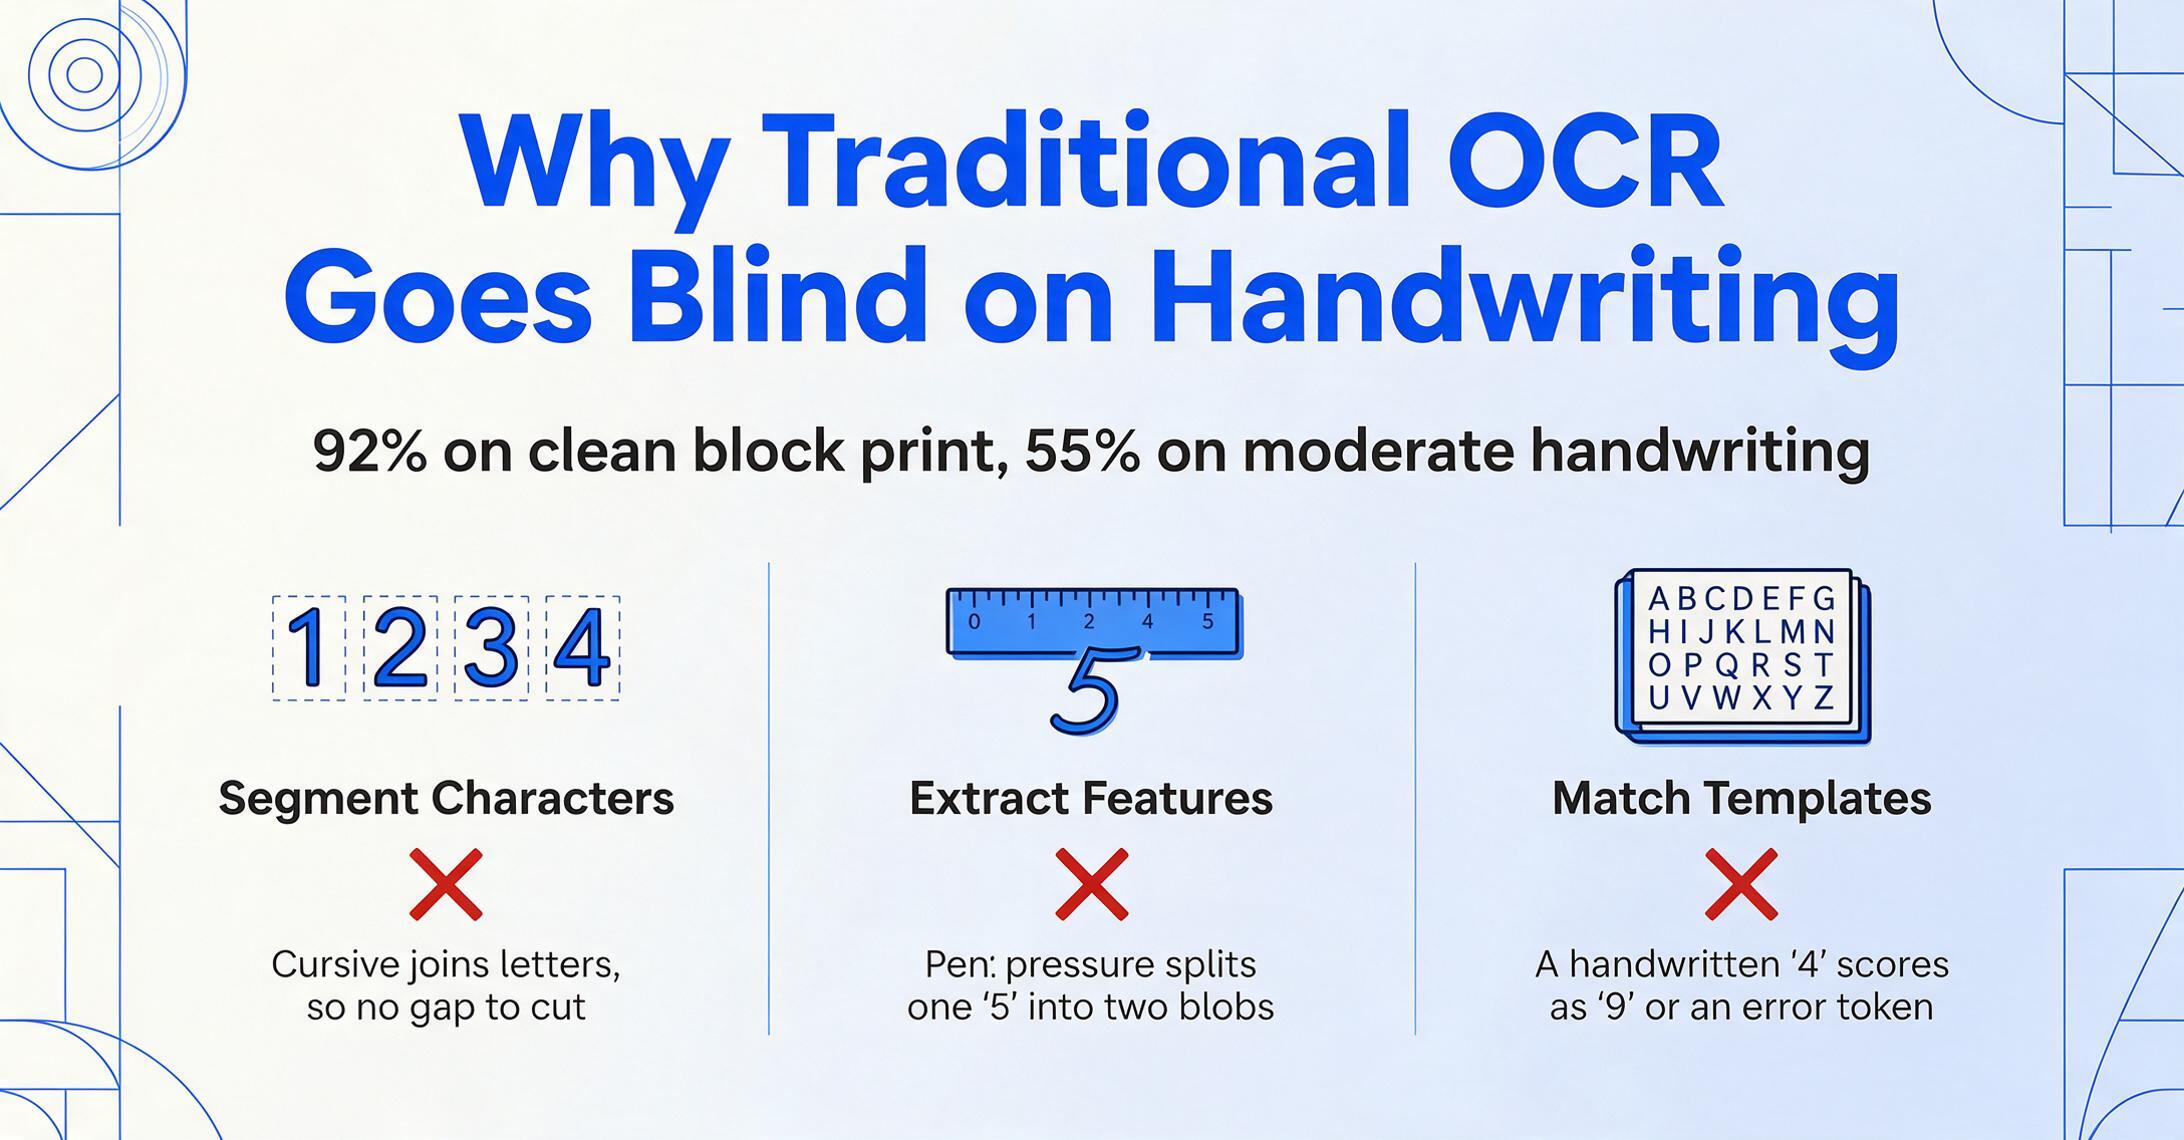
O OCR tradicional foi projetado na década de 1970 para máquinas de escrever e formulários impressos. Sua arquitetura se apoia em três suposições sequenciais — e a caligrafia quebra todas elas.
Passo um: segmentação de caracteres. O mecanismo detecta lacunas de espaço em branco entre caracteres e isola cada glifo em uma caixa delimitadora. Isso funciona em Courier New; colapsa em letra cursiva, onde a conexão entre um "a" e um "r" não deixa lacuna para detectar. Um estudo de 2025 descobriu que o OCR tradicional cai de 92% de precisão em letra de forma limpa para 55% sob degradação moderada de caligrafia — condições que mal contam como ruído para texto impresso.
Passo dois: extração de características. Uma vez isolado, o mecanismo mede as propriedades geométricas de cada caractere — contagem de traços, ângulos de curva — e as compara com vetores de características armazenados. A caligrafia derrota isso porque a pressão variável de uma caneta esferográfica pode fragmentar um único "5" em uma mancha mais um traço separado. O vetor de características não corresponde a nenhum modelo — não porque o caractere está errado, mas porque a biblioteca foi construída para fontes, não para mãos.
Passo três: correspondência de modelos. As características extraídas são pontuadas contra um banco de dados treinado exclusivamente em tipografias. O melhor palpite do mecanismo para um "4" manuscrito costuma ser "9", "A" ou um token de erro. Ele não pode pedir ajuda — emite seu melhor palpite e o erro se propaga adiante.
Erros de segmentação alimentam características malformadas em um correspondente baseado em fontes, produzindo lixo. No banco de dados de caligrafia IAM — 13.353 linhas de texto de 657 escritores — o Tesseract, o mecanismo de OCR de código aberto mais amplamente implantado, retornou uma taxa de erro de caracteres (CER) de 12,5%. Em letra cursiva, sua taxa de erro de palavras (WER) excede 95% (codesota.com, 2026). Isso não é um problema de ajuste. É uma arquitetura construída para caracteres separados confrontando um meio que deliberadamente os conecta.
Como a IA lê a escrita manual: de caracteres a contexto
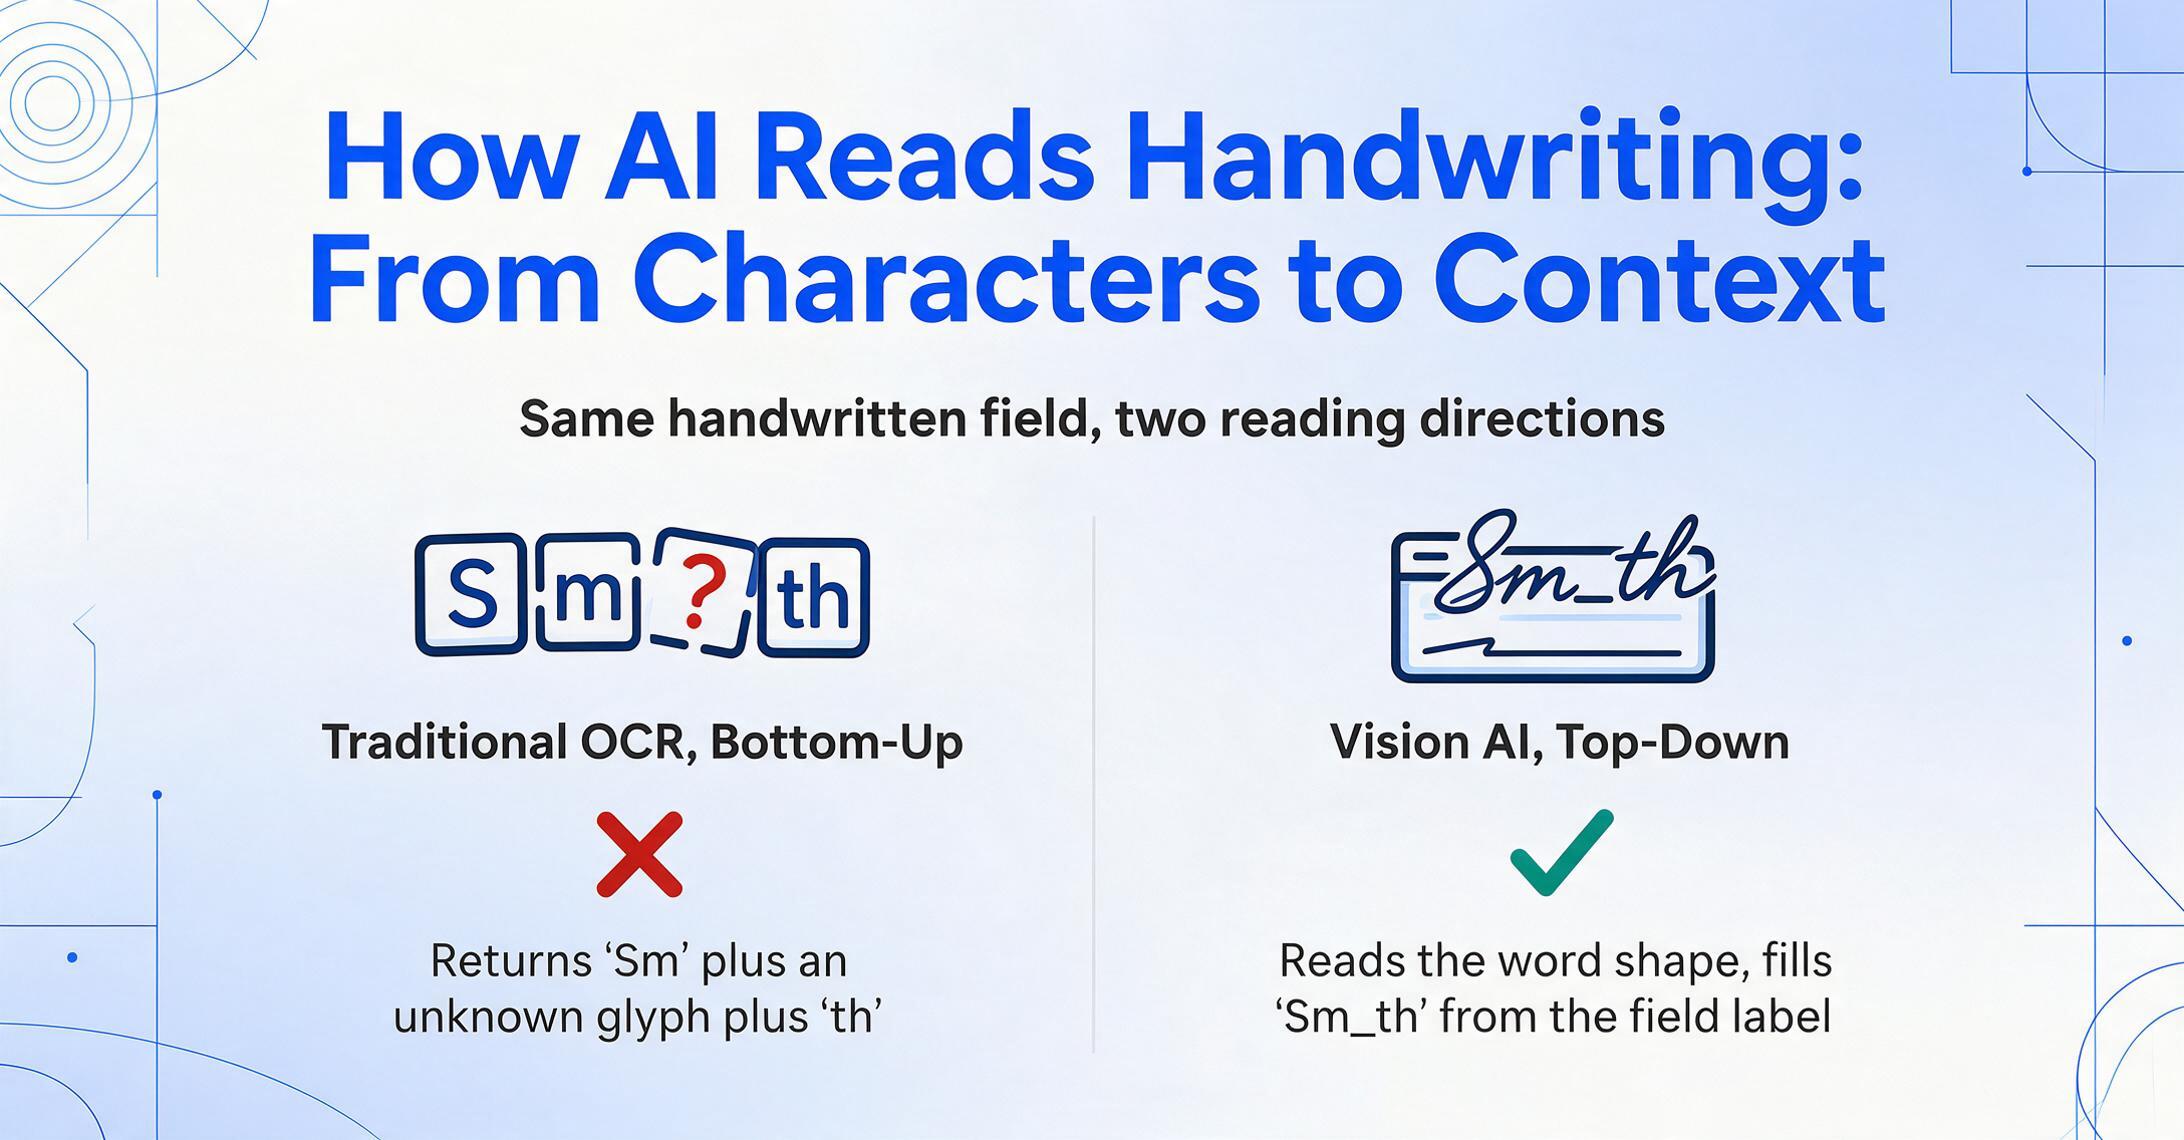
O reconhecimento moderno de escrita manual por IA — baseado em modelos de visão-linguagem — inverte completamente o pipeline tradicional de OCR. Em vez de construir palavras a partir de caracteres (de baixo para cima), ele reconhece palavras como unidades visuais completas e usa a compreensão a nível de documento para desambiguar trazos individuais (de alto nível). Esta é a mesma estratégia cognitiva que você usa ao ler uma nota manuscrita.
Reconhecimento holístico de palavras. Em vez de segmentar uma página em caracteres individuais, a IA de visão processa a imagem inteira através de uma rede neural profunda que extrae características visuais em múltiples escalas simultáneamente — trazos, fragmentos de letras, formas de palavras, padrões de linhas. Uma palavra como "Total" não é montada a partir de T-o-t-a-l. É reconhecida como um padrão visual unificado, da mesma forma que você reconhece o rosto de um amigo sem catalogar características individuais. As conexões cursivas não confundem um modelo que nunca segmentou caracteres para começar.
Desambiguación baseada em contexto. Uma entrada manuscrita com um caractere tênue ou ausente em "Sm_th" faz que o OCR tradicional retorne "Sm" mais um glifo não reconhecido mais "th." Uma IA de visão vê a forma da palavra e o contexto circundante — este é o campo "Nome do Cliente", e o documento é de um contato conhecido — e preenche a lacuna a partir do contexto. O mesmo mecanismo resolve um "1" manuscrito de "l," "0" de "O," e "7" de "1" — perguntando: o que faz sentido neste campo?
Robustez à variação de trazos. Treinada em milhões de imagens de milhares de escritores, a IA de visão viu uma enorme variedade de estilos de escrita, tipos de caneta e superfícies de escrita. A largura variável do trazo de uma caneta-tinteiro, as variações de pressão de uma esferográfica, o grafito tênue de um lápiz — tudo isso está na distribuição de treinamento. O modelo abstrae a variação superficial e se concentra na estrutura subyacente dos caracteres, sem precisar do estilo de cada escritor em uma biblioteca de modelos.
Compreensión semántica a nível de documento. Esta capa transforma o reconhecimento de escrita manual de uma ferramenta de transcrição em um motor de extração de dados. O rótulo "Número de Fatura" diz ao modelo que o valor manuscrito ao lado deve ser um código alfanumérico, não uma data. Isto é Extraction de Colunas Personalizadas: você define os nomes de colunas que deseja — "Data," "Vendedor," "Total" — e a IA localiza cada valor manuscrito entendendo o que significa semanticamente, não combinando uma posição de modelo. Para uma análise mais profunda do que o reconhecimento de escrita manual por IA pode realmente fazer, veja se a IA pode ler escrita manual de fotos e com que precisão.
A Lacuna de Precisão: OCR vs IA em Caligrafia
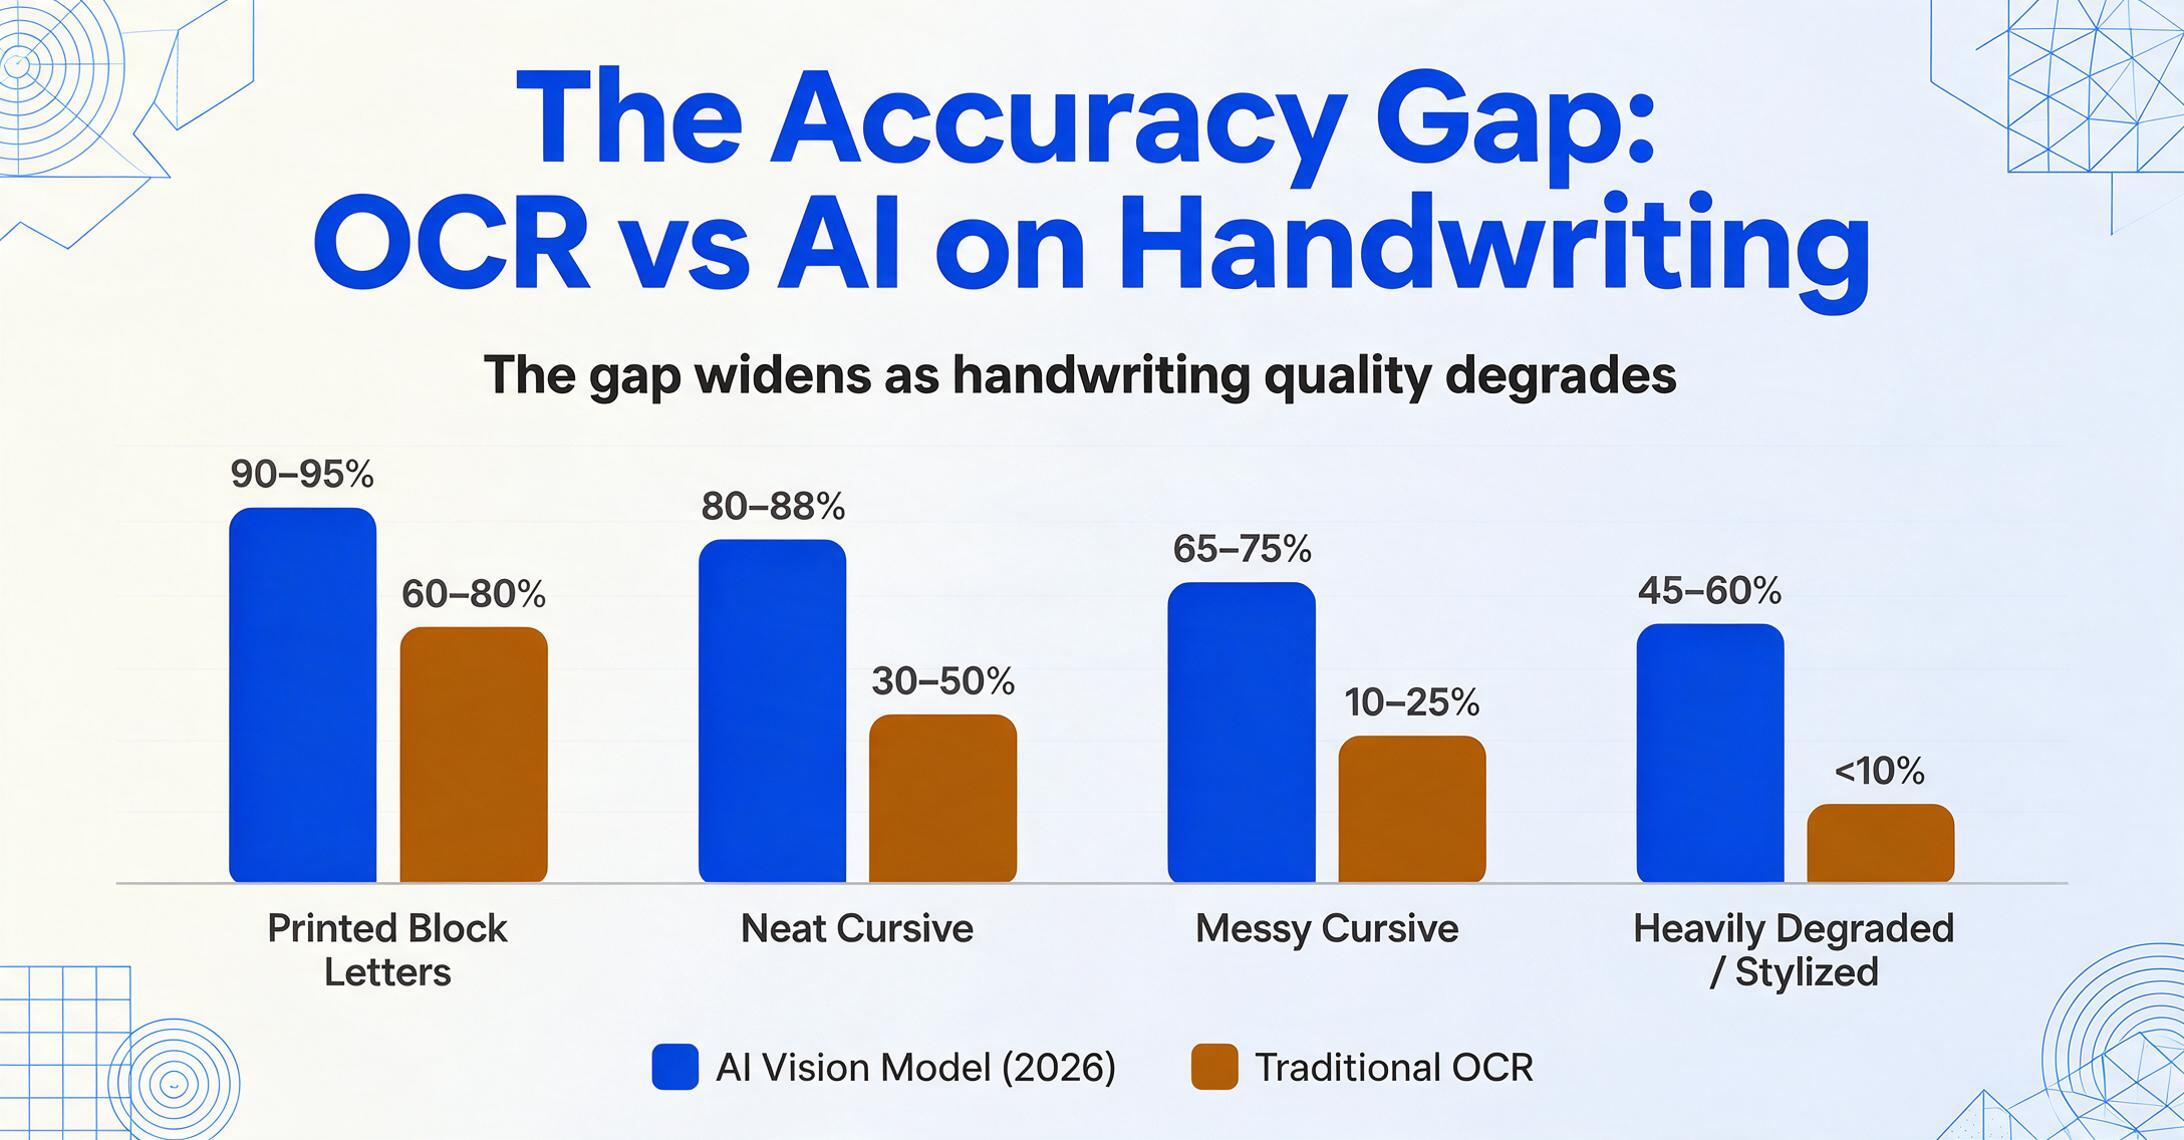
A diferença entre como essas duas abordagens funcionam não é acadêmica — ela produz uma lacuna mensurável que determina se uma ferramenta é útil ou inútil em um determinado documento.
| Tipo de Caligrafia | IA (2026) | OCR tradicional | Lacuna |
|---|---|---|---|
| Letras de forma impressas | 90–95% | 60–80% | 15–25 pts |
| Cursiva bem feita | 80–88% | 30–50% | 38–50 pts |
| Cursiva bagunçada | 65–75% | 10–25% | 40–55 pts |
| Muito degradada / estilizada | 45–60% | <10% | 35–50 pts |
Esses são números de reconhecimento bruto — quantos caracteres e palavras voltam corretos no nível da transcrição. A precisão no nível de campo, em que cada valor extraído cai na coluna correta da planilha, é maior, porque o contexto do documento desambigua caracteres ambíguos; os números no nível de campo são o tema da nossa comparação entre IA e OCR tradicional. Se você está escolhendo uma ferramenta em vez de entender o mecanismo, nossa seleção de softwares de OCR de caligrafia classificados por precisão em cursiva compara 11 opções por categoria de tecnologia.
A lacuna aumenta conforme a qualidade da caligrafia piora — exatamente onde você mais precisa que a ferramenta funcione. Em letras de forma impressas, o OCR tradicional é utilizável. Em cursiva bem feita, a lacuna salta para cerca de 40 pontos — dados utilizáveis vs redigitar tudo manualmente. Em cursiva bagunçada, o OCR tradicional retorna bobagem em mais de três quartos das palavras. A IA, embora imperfeita nesse nível, pelo menos retorna dados que vale a pena revisar em vez de descartar.
Benchmarks independentes confirmam isso no nível de caractere. No banco de dados de caligrafia IAM, o GPT-5 alcança ~1,22% de taxa de erro de caracteres — menos de 2 erros por 100 caracteres — enquanto o Tesseract marca 12,5% de CER (codesota.com, abril de 2026). No benchmark de taxa de erro de palavras de 2026 do handwritingocr.com, as melhores ferramentas especializadas alcançam menos de 1% de WER em cursiva limpa, enquanto as APIs de OCR na nuvem variam de 8% a 23% de WER — ou seja, até um quarto de todas as palavras volta errado em serviços de nuvem pagos. Para um panorama completo de precisão, veja reconhecimento de caligrafia por IA vs OCR tradicional.
Quais Tipos de Caligrafia a IA Lida Melhor — e Onde Ainda Enfrenta Dificuldades
Os números de precisão acima respondem "quão diferente é a IA do OCR?" A próxima pergunta é: como a IA vai se sair nos seus documentos? A resposta depende de três variáveis.
Formulários estruturados com campos rotulados produzem os melhores resultados. Quando um documento tem rótulos de campo claros — "Data", "Nome do Funcionário", "Horas" — e valores manuscritos em espaços designados, a IA usa esses rótulos como âncoras semânticas. O modelo sabe que o conteúdo abaixo de "Data" deve corresponder a um padrão de data, o que restringe o reconhecimento e suprime erros. Se seus documentos são formulários com rótulos pré-impressos e respostas manuscritas em letras de forma ou cursiva caprichada, espere 90%+ de precisão de campo.
Documentos consistentes de um único escritor têm desempenho significativamente melhor do que conjuntos de vários escritores. Quando o mesmo técnico preenche 50 formulários de inspeção, a IA aprende implicitamente os padrões de traço deles ao longo das páginas — a forma como fazem "7", a inclinação dos "t". As primeiras páginas estabelecem o padrão; as páginas seguintes se beneficiam. O benchmark de 2026 da AIMultiple com 100 amostras de caligrafia de contribuidores fixos descobriu que os melhores modelos alcançaram similaridade semântica utilizável em produção em conjuntos consistentes de um único escritor.
Notas livres não estruturadas — páginas de prosa manuscrita ou anotações nas margens — empurram a IA para sua faixa de desempenho mais fraca. Sem rótulos de campo para ancorar a extração, o modelo faz transcrição bruta em vez de extração estruturada. Uma revisão de 2025 descobriu que o GPT-4.1 caiu de ~85% em caligrafia limpa de uma página para ~65% na terceira página de notas de várias páginas, onde o modelo começou a inventar texto que não estava na página.
O limite prático: se duas pessoas lendo a mesma caligrafia concordam sobre o que está escrito, a IA provavelmente acertará. Se os humanos discordarem, a IA errará. Para padrões de falha específicos e correções, veja nosso guia sobre modos de falha de extração de caligrafia.
Perguntas Frequentes
O reconhecimento de caligrafia por IA precisa ser treinado com a minha escrita?
Não — e essa é uma diferença fundamental em relação aos sistemas de ICR mais antigos, que exigiam de 10 a 20 amostras de treinamento por escritor. A IA de visão moderna é pré-treinada com milhões de amostras de caligrafia de milhares de escritores. Ela lida com novas caligrafias zero-shot: envie um documento de um escritor que o modelo nunca viu, e ela extrai sem configuração. Para saber mais, veja o que é reconhecimento de caligrafia por IA e como a IA de visão lê letra cursiva.
Como a IA diferencia um "5" manuscrito de um "6", ou um "1" de um "7"?
Através do contexto. Um "5" e um "6" manuscritos podem parecer idênticos isoladamente — mas a IA não os lê isoladamente. Se o campo estiver rotulado como "Total" e o documento mostrar itens com preços conhecidos, o modelo pode validar se um "5" ou um "6" produz um resultado matematicamente coerente. Essa desambiguação baseada em contexto é o motivo pelo qual a precisão dos campos supera em muito a taxa bruta de reconhecimento de caracteres — a IA usa o documento como um todo para resolver ambiguidades locais.
A IA consegue extrair dados de formulários manuscritos, ou apenas transcrever texto?
A IA extrai dados estruturados — essa é a diferença fundamental da transcrição básica de caligrafia para texto. Em vez de gerar um bloco de texto bruto, a IA coloca cada valor em sua própria coluna: "Número da fatura: 1042", "Data: 15/03/26", "Total: $847.50". O mecanismo é a Extração de Colunas Personalizadas: você define as colunas de saída, e a IA mapeia cada campo manuscrito entendendo o que ele significa, não o encontrando em uma coordenada fixa de pixel.
Por que o OCR tradicional não pode simplesmente ser melhorado para caligrafia?
Porque a melhoria necessária não é um aprimoramento — é uma reescrita da arquitetura fundamental. A suposição de segmentação de caracteres do OCR tradicional está embutida em todas as camadas. "Melhorá-lo" para caligrafia exige substituir a segmentação por reconhecimento holístico, substituir a extração de recursos baseada em fontes por recursos visuais aprendidos e adicionar compreensão de contexto em nível de documento — nesse ponto, você construiu um modelo de visão de IA. Vários provedores de OCR em nuvem adicionaram camadas de ML sobre seus mecanismos tradicionais para caligrafia, mas os resultados (60–70% em cursiva) refletem os limites de remendar uma arquitetura incompatível. As soluções líderes migraram para modelos de visão-linguagem em vez de tentar adaptar o OCR baseado em caracteres.
O reconhecimento de caligrafia funciona em fotos de celular ou apenas em digitalizações?
Fotos de celular funcionam bem — e hoje são o tipo de entrada mais comum para reconhecimento de caligrafia com IA. Os modelos de visão modernos lidam com distorção de perspectiva e iluminação irregular que quebram o OCR tradicional. Uma foto de celular bem tirada (de frente, iluminação uniforme, pelo menos 200 DPI) produz precisão dentro de 3–5 pontos percentuais de uma digitalização em scanner de mesa. Desde 2024, a robustez dos modelos a artefatos de imagem do mundo real tornou a entrada por câmera de celular prática para fluxos de trabalho de caligrafia empresarial.
A diferença entre OCR tradicional e reconhecimento de caligrafia com IA não é uma questão de grau — é uma questão de arquitetura. Um lê letras. O outro lê documentos. Em formulários manuscritos estruturados com rótulos de campo claros, essa diferença arquitetônica se traduz em uma vantagem de precisão de 40 pontos — a diferença entre obter uma planilha e obter algo sem sentido.
Comece pelo que é o reconhecimento de caligrafia com IA para entender a definição e o cenário. Depois teste as alegações de precisão — veja o que a IA lê em caligrafia real em diferentes estilos e tipos de documento. Se você está avaliando ferramentas, nossa comparação de IA vs OCR tradicional em caligrafia detalha os números por tipo de documento.