手書き文字認識の仕組みとは?
AIが従来型OCRに勝る理由
友人が付箋に書いた乱れた字を読むときのことを思い浮かべてください。1文字ずつ解読するのではなく、単語全体を一目で捉え、曖昧な文字は文脈から補い、メモの構造(上部の「買い物:」、数字の前の「$」)を手がかりに意味を理解します。AIが手書き文字を読むのも同じです。1文字ずつの解読ではなく、全体を捉えた理解です。従来型OCRは逆で、各文字を切り離してテンプレートと照合し、文字がつながった瞬間に崩壊します。このアーキテクチャの違いは文字レベルで測定できます。IAM手書き文字ベンチマークでは、最先端のAIモデルは文字誤り率(CER)約1.2%を記録する一方、最も広く使われているオープンソースOCRエンジンであるTesseractは12.5%です。筆記体ではその差はさらに広がります。これは調整の差ではなく、ページを見る根本的に異なる2つの方法なのです。
このページの位置づけ:本ページは仕組みの深掘り解説であり、技術が内部でどう機能するかを扱います。定義と全体像についてはAI手書き文字認識とは何かから始め、手書きの種類別の精度についてはAIは写真の手書き文字を読めるかをご覧ください。
主なポイント
- 多くの人は手書き文字を読むためにOCRを使いますが、それは他に知っているツールがないからです。OCRは1970年代にタイプライター用に作られ、その核心的な前提——文字は分離可能な標準形状として存在する——は、これまでに書かれたあらゆる手書き文字にとって誤りです。
- OCRは手書き文字向けに「改善」できません。問題は精度調整ではなくアーキテクチャだからです。文字分割は筆記体のつながりで崩壊し、フォントベースの特徴照合は変動する筆圧に対応できず、エンジンには曖昧さを解消する文書の文脈がありません。
- AIはあなたと同じように手書き文字を読みます。単語全体を視覚的に認識し、文脈から空白を補い、文書構造を使って曖昧な線が「5」か「6」かを判断します。1文字ずつから全体を捉える読み方へのアーキテクチャの転換が、筆記体で40ポイントの精度優位を生み出します。
従来型OCRが手書き文字で機能しなくなる理由
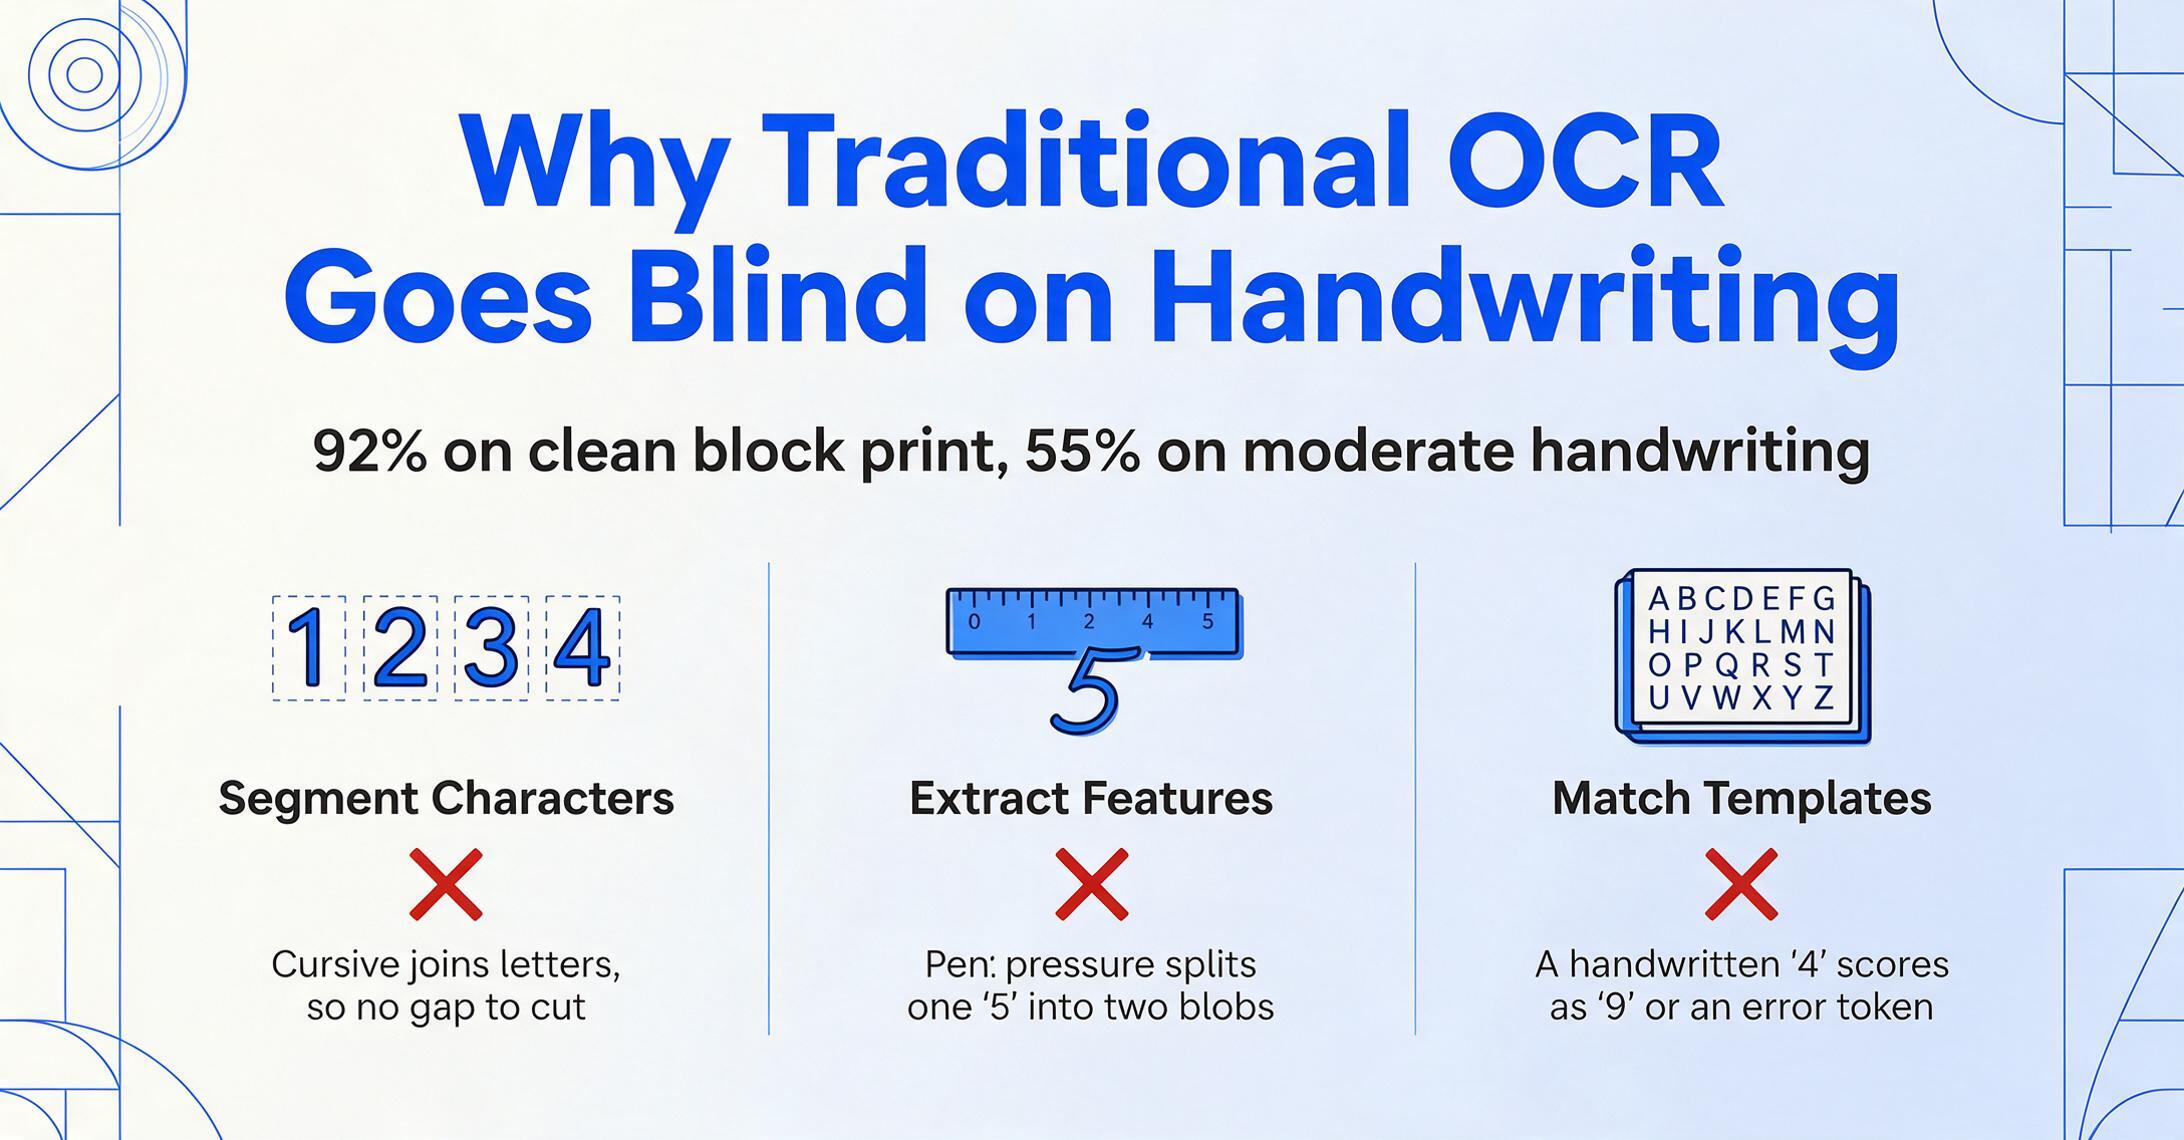
従来型OCRは1970年代にタイプライターと印刷文書向けに設計されました。その構造は3つの連続的な前提に基づいていますが、手書き文字はそのすべてを崩してしまいます。
ステップ1:文字の分割。エンジンは文字間の空白ギャップを検出し、各グリフを境界ボックスに分離します。これはCourier Newでは機能しますが、筆記体では崩壊します。「a」と「r」の接続部分に検出できるギャップが残らないからです。2025年の研究によると、従来型OCRはきれいなブロック体では92%の精度を維持する一方、中程度の手書き文字の劣化条件下では55%まで低下します。これは印刷テキストではノイズとしてほとんど認識されない条件です。
ステップ2:特徴抽出。分離後、エンジンは各文字の幾何学的特性(ストローク数、曲線の角度など)を測定し、保存された特徴ベクトルと比較します。手書き文字はこれを打ち負かします。ボールペンの可変的な筆圧により、単一の「5」が塊と別のダッシュに断片化されることがあるからです。特徴ベクトルはどのテンプレートとも一致しません。文字が間違っているからではなく、ライブラリがフォント用に構築されており、手書き用ではないからです。
ステップ3:テンプレート照合。抽出された特徴は、タイプフェイスのみで訓練されたデータベースと照合されます。手書きの「4」に対するエンジンの最良の推測は、しばしば「9」「A」またはエラートークンです。助けを求めることはできず、最良の推測を出力し、エラーは下流に連鎖します。
分割エラーは、フォントベースのマッチャーに不正な特徴を送り込み、無意味な出力を生み出します。IAM手書き文字データベース(657人の筆記者による13,353行のテキスト)では、最も広く展開されているオープンソースOCRエンジンであるTesseractが12.5%の文字誤り率(CER)を返しました。筆記体では、その単語誤り率(WER)は95%を超えます(codesota.com、2026年)。これはチューニングの問題ではありません。分離された文字向けに構築されたアーキテクチャが、意図的に文字を連結する媒体に直面しているのです。
AIは手書きをどう読むのか:文字から文脈へ
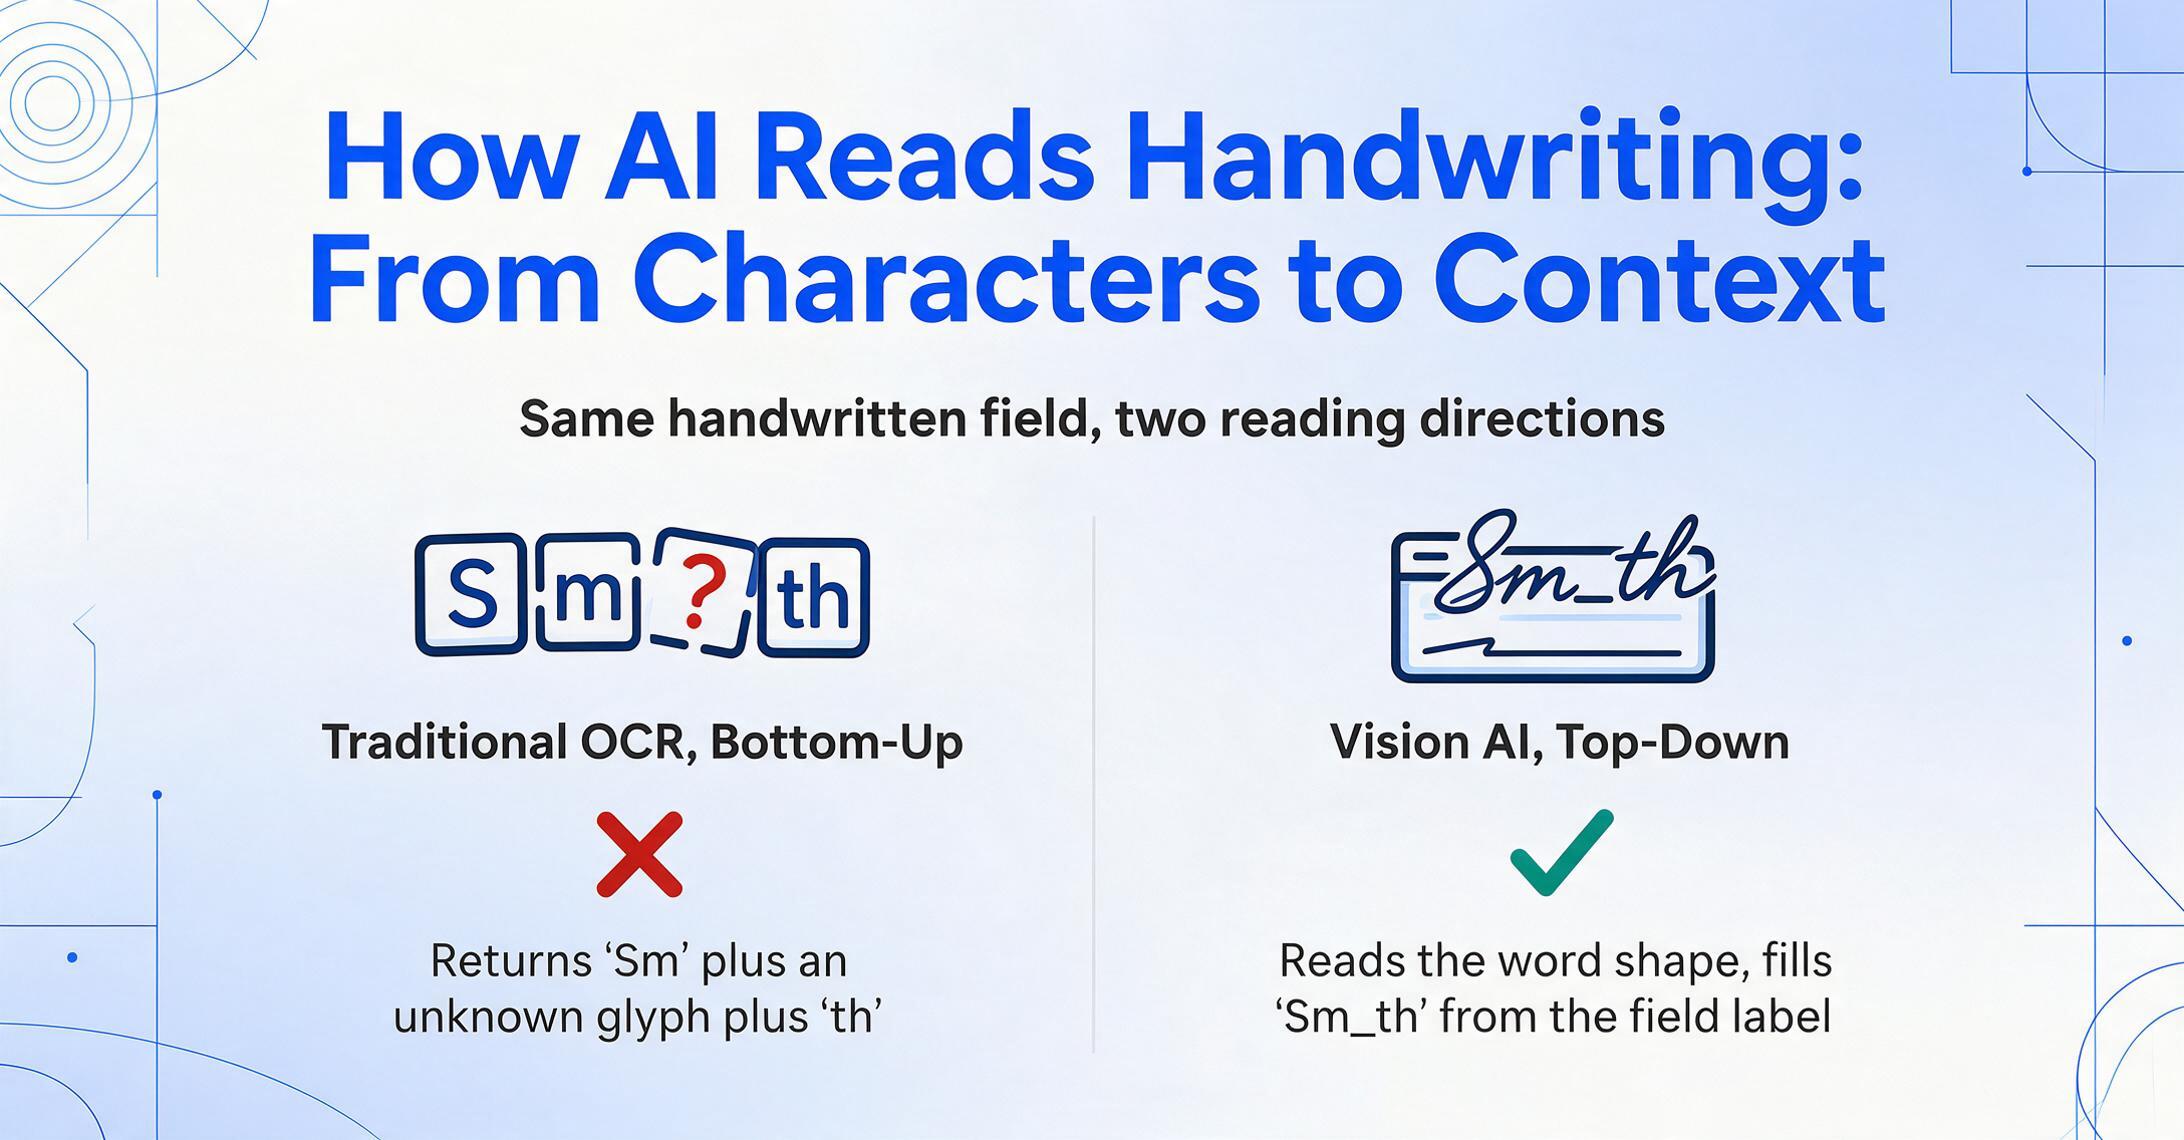
最新のAI手書き認識(視覚言語モデルを搭載)は、従来型OCRのパイプラインを完全に逆転させます。文字から単語を組み立てる(ボトムアップ)代わりに、単語を視覚的なまとまりとして認識し、ドキュメント全体の理解を使って個々のストロークを曖昧さなく解釈します(トップダウン)。これは、手書きのメモを読むときにあなたが使っているのと同じ認知戦略です。
全体的な単語認識。 ページを個々の文字に分割する代わりに、ビジョンAIは画像全体をディープニューラルネットワークで処理し、ストローク、文字の断片、単語の形、行のパターンなど、複数のスケールで視覚的特徴を同時に抽出します。「Total」のような単語は、T-o-t-a-lと一文字ずつ組み立てられるわけではありません。友人を個々の特徴をカタログ化せずに認識するのと同じように、統一された視覚パターンとして認識されるのです。文字を分割したことがないモデルにとって、筆記体のつながりは混乱の原因になりません。
文脈に基づく曖昧さの解消。 「Sm_th」のように薄い文字や欠落した文字がある手書きの項目では、従来型OCRは「Sm」と認識できないグリフと「th」を返すだけです。ビジョンAIは単語の形と周囲の文脈(これは「顧客名」フィールドで、ドキュメントは既知の連絡先からのもの)を見て、文脈から欠落部分を補完します。同じ仕組みで、手書きの「1」と「l」、「0」と「O」、「7」と「1」の区別も、「このフィールドでは何が意味を成すか?」と問いかけることで解決します。
ストロークのばらつきへの耐性。 何千人もの書き手による何百万もの画像でトレーニングされたビジョンAIは、膨大な範囲の手書きスタイル、ペンの種類、筆記面を見てきました。万年筆の可変的なストローク幅、ボールペンの筆圧の変化、鉛筆の薄い黒鉛 — これらはすべてトレーニング分布に含まれています。モデルは表面レベルのばらつきを抽象化し、基礎となる文字構造に焦点を当てるため、各書き手のスタイルをテンプレートライブラリに登録する必要はありません。
ドキュメントレベルの意味理解。 この層は、手書き認識を転写ツールからデータ抽出エンジンへと変貌させます。「請求書番号」というラベルは、その隣の手書きの値が日付ではなく英数字コードであるべきことをモデルに伝えます。これがカスタム列抽出です。「日付」「取引先」「合計」など、必要な列名を定義すると、AIはテンプレートの位置を照合するのではなく、意味的に理解することで各手書きの値を特定します。AI手書き認識が実際に何ができるかをもっと深く知りたい方は、AIが写真から手書きを読めるか、どの程度の精度かをご覧ください。
精度の差:手書き文字におけるOCRとAI
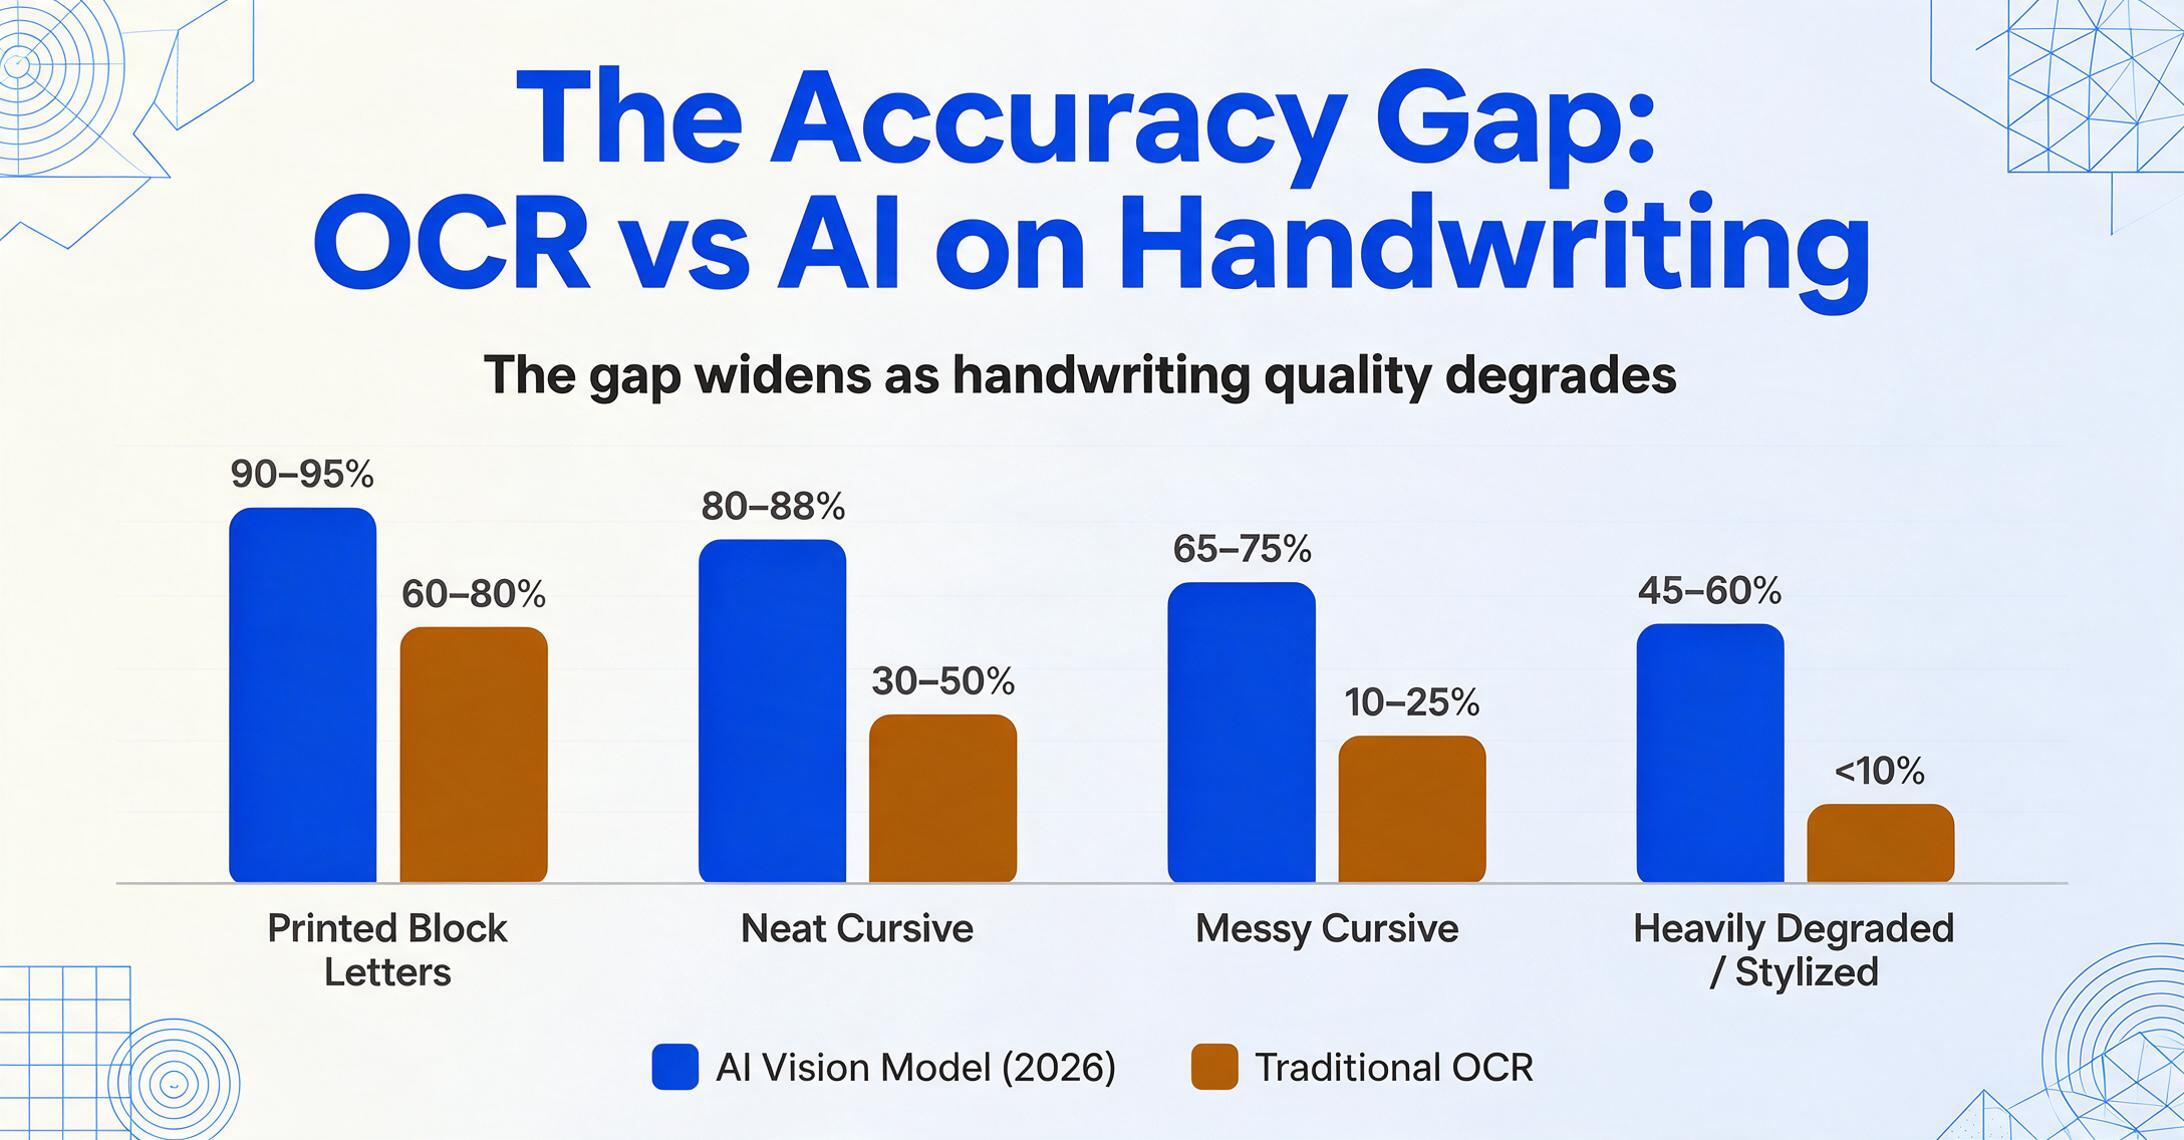
この2つのアプローチの仕組みの違いは理論上の話ではありません。あるドキュメントでツールが使えるか使えないかを決める、測定可能な差を生み出します。
| 手書きの種類 | AIビジョンモデル(2026年) | 従来型OCR | 差 |
|---|---|---|---|
| 活字のブロック体 | 90~95% | 60~80% | 15~25ポイント |
| 整った筆記体 | 80~88% | 30~50% | 38~50ポイント |
| 乱れた筆記体 | 65~75% | 10~25% | 40~55ポイント |
| 著しく劣化・装飾された文字 | 45~60% | <10% | 35~50ポイント |
これらは生の認識数値です。つまり、文字起こしレベルで何文字・何語が正しく返ってくるかを示します。各抽出値が正しいスプレッドシートの列に収まるフィールドレベルの精度は、ドキュメントの文脈が曖昧な文字を判別するため、より高くなります。フィールドレベルの数値については、AIと従来型OCRの比較で扱っています。仕組みの理解ではなくツールの選択をしたい場合は、筆記体精度でランク付けした手書きOCRソフトウェアのまとめで、11の選択肢を技術カテゴリ別に比較しています。
手書きの品質が下がるほど差は広がります。まさにツールに最も働いてほしい場面です。活字のブロック体なら、従来型OCRでも実用になります。整った筆記体では、差はおよそ40ポイントに跳ね上がります。使えるデータか、すべて手作業で打ち直すかです。乱れた筆記体になると、従来型OCRは4分の3以上の単語で意味不明な結果を返します。AIはこのレベルでは完璧ではありませんが、少なくとも捨てるのではなく確認する価値のあるデータを返します。
独立系ベンチマークも文字レベルでこれを裏付けています。IAM手書き文字データベースでは、GPT-5が約1.22%の文字誤り率(CER)を達成しています。100文字あたり2エラー未満です。一方、Tesseractは12.5%のCERです(codesota.com、2026年4月)。handwritingocr.comの2026年単語誤り率(WER)ベンチマークでは、最高の専用ツールが整った筆記体で1%未満のWERを達成する一方、クラウドOCR APIは8%~23%のWERの範囲にあります。つまり、有料クラウドサービスでは全単語の最大4分の1が誤って返ってくるということです。精度の詳細な解説は、AI手書き認識と従来型OCRの比較をご覧ください。
手書きAIが最も得意とする種類と、まだ苦手とする領域
上記の精度数値は「AIはOCRとどれだけ違うのか」に答えるものです。次の疑問は「AIは自分の文書でどう機能するのか」でしょう。その答えは3つの変数に左右されます。
ラベル付きフィールドを持つ構造化フォームは最良の結果をもたらします。文書に明確なフィールドラベル(「日付」「従業員名」「勤務時間」)があり、指定されたスペースに手書きの値が記入されている場合、AIはそれらのラベルを意味的なアンカーとして使用します。モデルは「日付」の下の内容が日付パターンに一致すべきだと認識し、認識を制約してエラーを抑制します。文書が印刷済みラベルとブロック体またはきれいな筆記体の手書き回答を持つフォームであれば、90%以上のフィールド精度が期待できます。
一貫した単一筆者の文書は、複数筆者のセットよりも大幅に良い結果を示します。同じ技術者が50枚の点検フォームに記入する場合、AIはページをまたいでその筆跡パターン(「7」の書き方、「t」の傾きなど)を暗黙的に学習します。最初の数ページでパターンが確立され、以降のページが恩恵を受けます。AIMultipleの2026年ベンチマークでは、固定寄稿者による100件の筆記体サンプルを評価し、トップモデルが一貫した単一筆者セットで実用レベルの意味的類似性を達成しました。
非構造化の自由形式メモ(手書きの散文や余白の注釈のページ)は、AIを弱い性能帯に追い込みます。抽出を固定するフィールドラベルがないため、モデルは構造化抽出ではなく生の文字起こしを行います。2025年のレビューでは、GPT-4.1がきれいな単一ページの手書きで約85%だった精度が、複数ページのメモの3ページ目では約65%に低下し、ページに存在しないテキストをモデルが作り出し始めたことが判明しました。
実用的な目安:同じ手書きを2人が読んで内容が一致するなら、AIもおそらく正しく認識します。人間が解釈に迷う場合、AIも誤る可能性が高いです。具体的な失敗パターンと修正方法については、手書き抽出の失敗モードに関するガイドをご覧ください。
よくある質問
AI手書き文字認識は、自分の手書き文字で学習させる必要がありますか?
いいえ — これは、書き手ごとに10〜20個の学習サンプルを必要とした従来のICRシステムとは根本的に異なる点です。最新のビジョンAIは、何千人もの書き手による何百万もの手書きサンプルで事前学習されています。ゼロショットで新しい手書き文字を処理します。モデルが見たことのない書き手のアップロードでも、設定なしで抽出できます。詳細は、AI手書き文字認識とは何か、ビジョンAIが筆記体をどう読むかをご覧ください。
AIは手書きの「5」と「6」や「1」と「7」をどう見分けるのですか?
文脈を通してです。手書きの「5」と「6」は単体では同じに見えることがあります — しかしAIは単体では読み取りません。フィールドが「合計」とラベル付けされ、ドキュメントに既知の価格の明細項目が表示されている場合、モデルは「5」か「6」のどちらが数学的に一貫した結果を生むかを検証できます。この文脈ベースの曖昧性解消こそが、フィールド精度が生の文字認識率をはるかに上回る理由です — AIはドキュメント全体を使って局所的な曖昧さを解決します。
AIは手書きフォームからデータを抽出できますか、それとも単にテキストを転写するだけですか?
AIは構造化データを抽出します — これが基本的な手書きテキスト転写との重要な違いです。生のテキストブロックを出力する代わりに、AIは各値を独自の列に配置します:「請求書番号:1042」「日付:3/15/26」「合計:$847.50」。その仕組みはカスタム列抽出です。出力列を定義すると、AIは固定ピクセル座標で見つけるのではなく、意味を理解して各手書きフィールドをマッピングします。
従来型OCRを手書き用に改良するだけではダメなのですか?
必要な改善は拡張ではなく、基本アーキテクチャの書き換えだからです。従来型OCRの文字セグメンテーション前提は、すべての層に組み込まれています。手書き用に「改良」するには、セグメンテーションを全体認識に置き換え、フォントベースの特徴抽出を学習された視覚特徴に置き換え、ドキュメントレベルの文脈理解を追加する必要があります — その時点で、AIビジョンモデルを構築したことになります。いくつかのクラウドOCRプロバイダーは、手書き用に従来エンジンの上にML層を追加しましたが、その結果(筆記体で60〜70%)は、ミスマッチなアーキテクチャにパッチを当てることの限界を反映しています。主要ソリューションは、文字ベースのOCRを改造するのではなく、視覚言語モデルに移行しています。
手書き文字認識はスマホの写真でも機能しますか、それともスキャンだけですか?
スマホの写真でも問題なく機能します。そして今や、AI手書き文字認識で最も一般的な入力形式です。最新のAIは、従来型OCRを破綻させるような遠近の歪みや不均一な照明にも対応します。適切に撮影されたスマホ写真(正面から、均一な照明、少なくとも200 DPI)は、フラットベッドスキャンと比べて3~5ポイント以内の精度を実現します。2024年以降、実世界の画像ノイズに対するAIの堅牢性が向上し、ビジネスの手書きワークフローでもスマホカメラ入力が実用的になりました。
従来型OCRとAI手書き文字認識の違いは、程度の問題ではなく、アーキテクチャの問題です。一方は文字を読み、もう一方はドキュメントを読みます。明確なフィールドラベルのある構造化された手書きフォームでは、このアーキテクチャの違いが40ポイントの精度差を生みます。これは、スプレッドシートが得られるか、意味不明な文字列が得られるかの違いです。
まずはAI手書き文字認識の定義と全体像から始めましょう。次に、その精度の主張を検証してください — 実際の手書き文字をAIがどう読むか確認する。さまざまな書き方やドキュメントの種類で試せます。ツールを検討中の方は、手書き文字におけるAIと従来型OCRの比較で、ドキュメントの種類ごとに数値を詳しく解説しています。