¿Cómo funciona el reconocimiento de escritura a mano?
Por qué la IA supera al OCR tradicional
Piensa en cómo lees la letra desordenada de un amigo en una nota adhesiva. No descifras cada letra individualmente: ves la palabra completa de una vez, completas los caracteres ambiguos con el contexto y usas la estructura de la nota («compras:» arriba, «$» antes de un número) para darle sentido. Así es como la IA lee la escritura a mano: comprensión holística en lugar de decodificación letra por letra. El OCR tradicional hace lo contrario: aísla cada carácter, lo compara con una plantilla y se derrumba en el momento en que las letras se conectan. La diferencia arquitectónica es medible a nivel de carácter: en el punto de referencia de escritura a mano IAM, los modelos de IA de vanguardia registran aproximadamente una tasa de error de caracteres del 1,2 %, mientras que Tesseract, el motor OCR de código abierto más utilizado, devuelve un 12,5 % — y en cursiva esa brecha solo se amplía. No es una brecha de calibración: son dos formas fundamentalmente distintas de ver una página.
Dónde encaja esto: esta página es la inmersión en el mecanismo: cómo funciona la tecnología bajo el capó. Para la definición y el panorama general, empieza con qué es el reconocimiento de escritura a mano con IA; para la precisión según el tipo de escritura, consulta si la IA puede leer escritura a mano en fotos.
Conclusiones clave
- La mayoría de la gente recurre al OCR para leer escritura a mano porque es la única herramienta que conoce. El OCR se creó para máquinas de escribir en los años 70 y su suposición central — que los caracteres existen como formas estandarizadas separables — es falsa para cada palabra escrita a mano jamás escrita.
- El OCR no se puede «mejorar» para la escritura a mano porque el problema no es el ajuste de precisión, sino la arquitectura. La segmentación de caracteres falla con las conexiones cursivas, la coincidencia de características basada en fuentes falla con la presión variable del trazo y el motor no tiene contexto del documento para resolver la ambigüedad.
- La IA lee la escritura a mano como tú: reconoce palabras completas visualmente, completa los vacíos con el contexto y usa la estructura del documento para decidir si un garabato ambiguo es un «5» o un «6». El cambio arquitectónico de la lectura carácter por carácter a la lectura holística crea una ventaja de precisión de 40 puntos en cursiva.
Por qué el OCR tradicional se queda ciego ante la escritura a mano
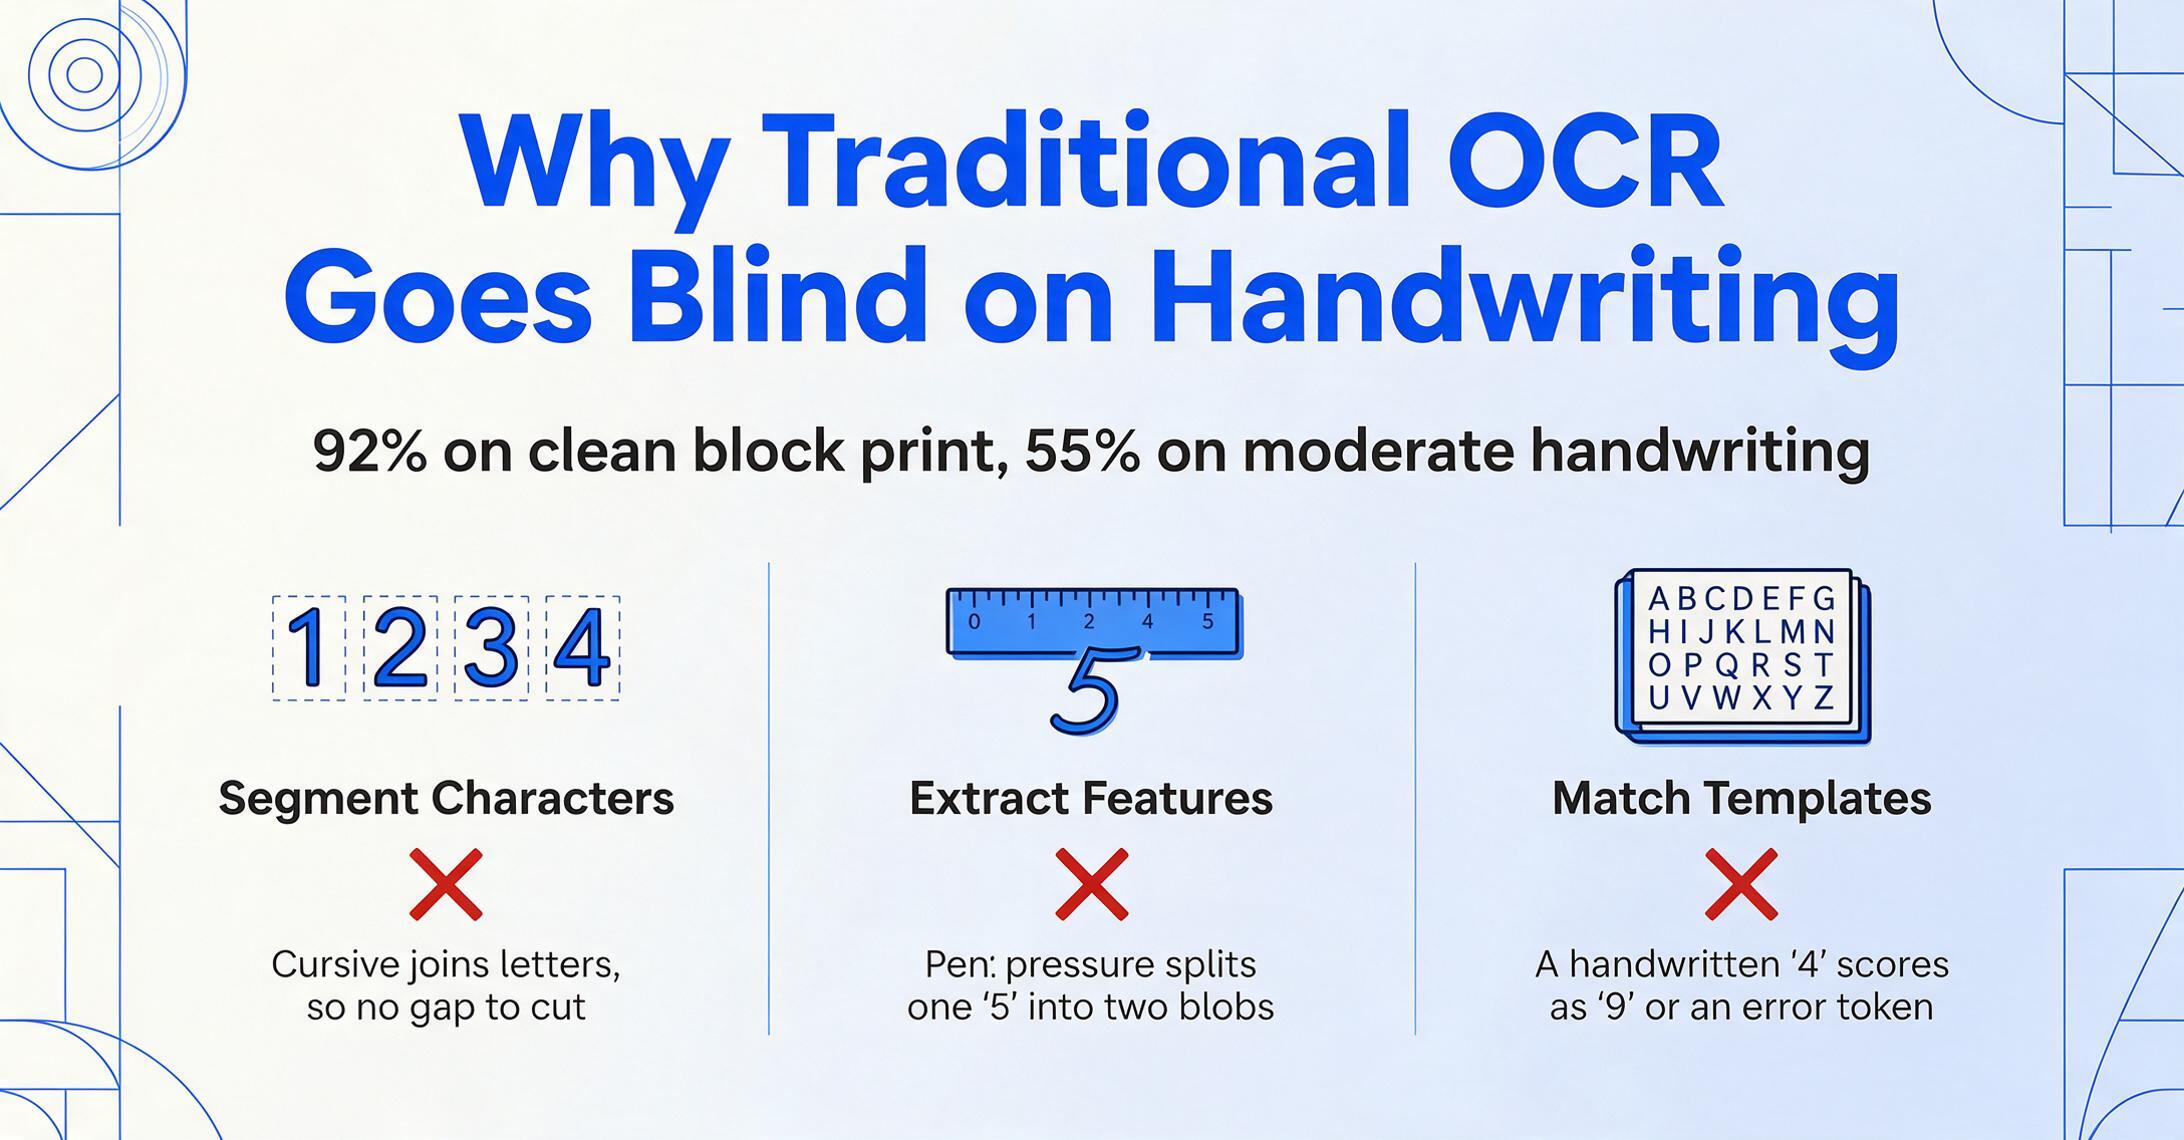
El OCR tradicional se diseñó en los años 70 para máquinas de escribir y formularios impresos. Su arquitectura se apoya en tres supuestos secuenciales — y la escritura a mano rompe cada uno de ellos.
Paso uno: segmentación de caracteres. El motor detecta los espacios en blanco entre caracteres y aísla cada glifo en un cuadro delimitador. Esto funciona con Courier New; se derrumba con la escritura cursiva, donde la conexión entre una "a" y una "r" no deja ningún espacio que detectar. Un estudio de 2025 descubrió que el OCR tradicional cae del 92% de precisión en letra de imprenta limpia al 55% con una degradación moderada de la escritura a mano — condiciones que apenas se registran como ruido para el texto impreso.
Paso dos: extracción de características. Una vez aislado, el motor mide las propiedades geométricas de cada carácter — número de trazos, ángulos de las curvas — y las compara con vectores de características almacenados. La escritura a mano vence esto porque la presión variable de un bolígrafo puede fragmentar un solo "5" en una mancha más un guion separado. El vector de características no coincide con ninguna plantilla — no porque el carácter sea incorrecto, sino porque la biblioteca se creó para fuentes, no para manos.
Paso tres: coincidencia de plantillas. Las características extraídas se puntúan contra una base de datos entrenada exclusivamente con tipografías. La mejor suposición del motor ante un "4" escrito a mano suele ser "9", "A" o un token de error. No puede pedir ayuda — genera su mejor suposición y el error se propaga en cadena.
Los errores de segmentación alimentan características malformadas a un comparador basado en fuentes, produciendo basura. En la base de datos de escritura a mano IAM — 13,353 líneas de texto de 657 escritores — Tesseract, el motor de OCR de código abierto más implementado, devolvió una tasa de error de caracteres (CER) del 12.5%. En cursiva, su tasa de error de palabras (WER) supera el 95% (codesota.com, 2026). Eso no es un problema de ajuste. Es una arquitectura construida para caracteres separados enfrentándose a un medio que los conecta deliberadamente.
Cómo lee la IA la escritura a mano: de los caracteres al contexto
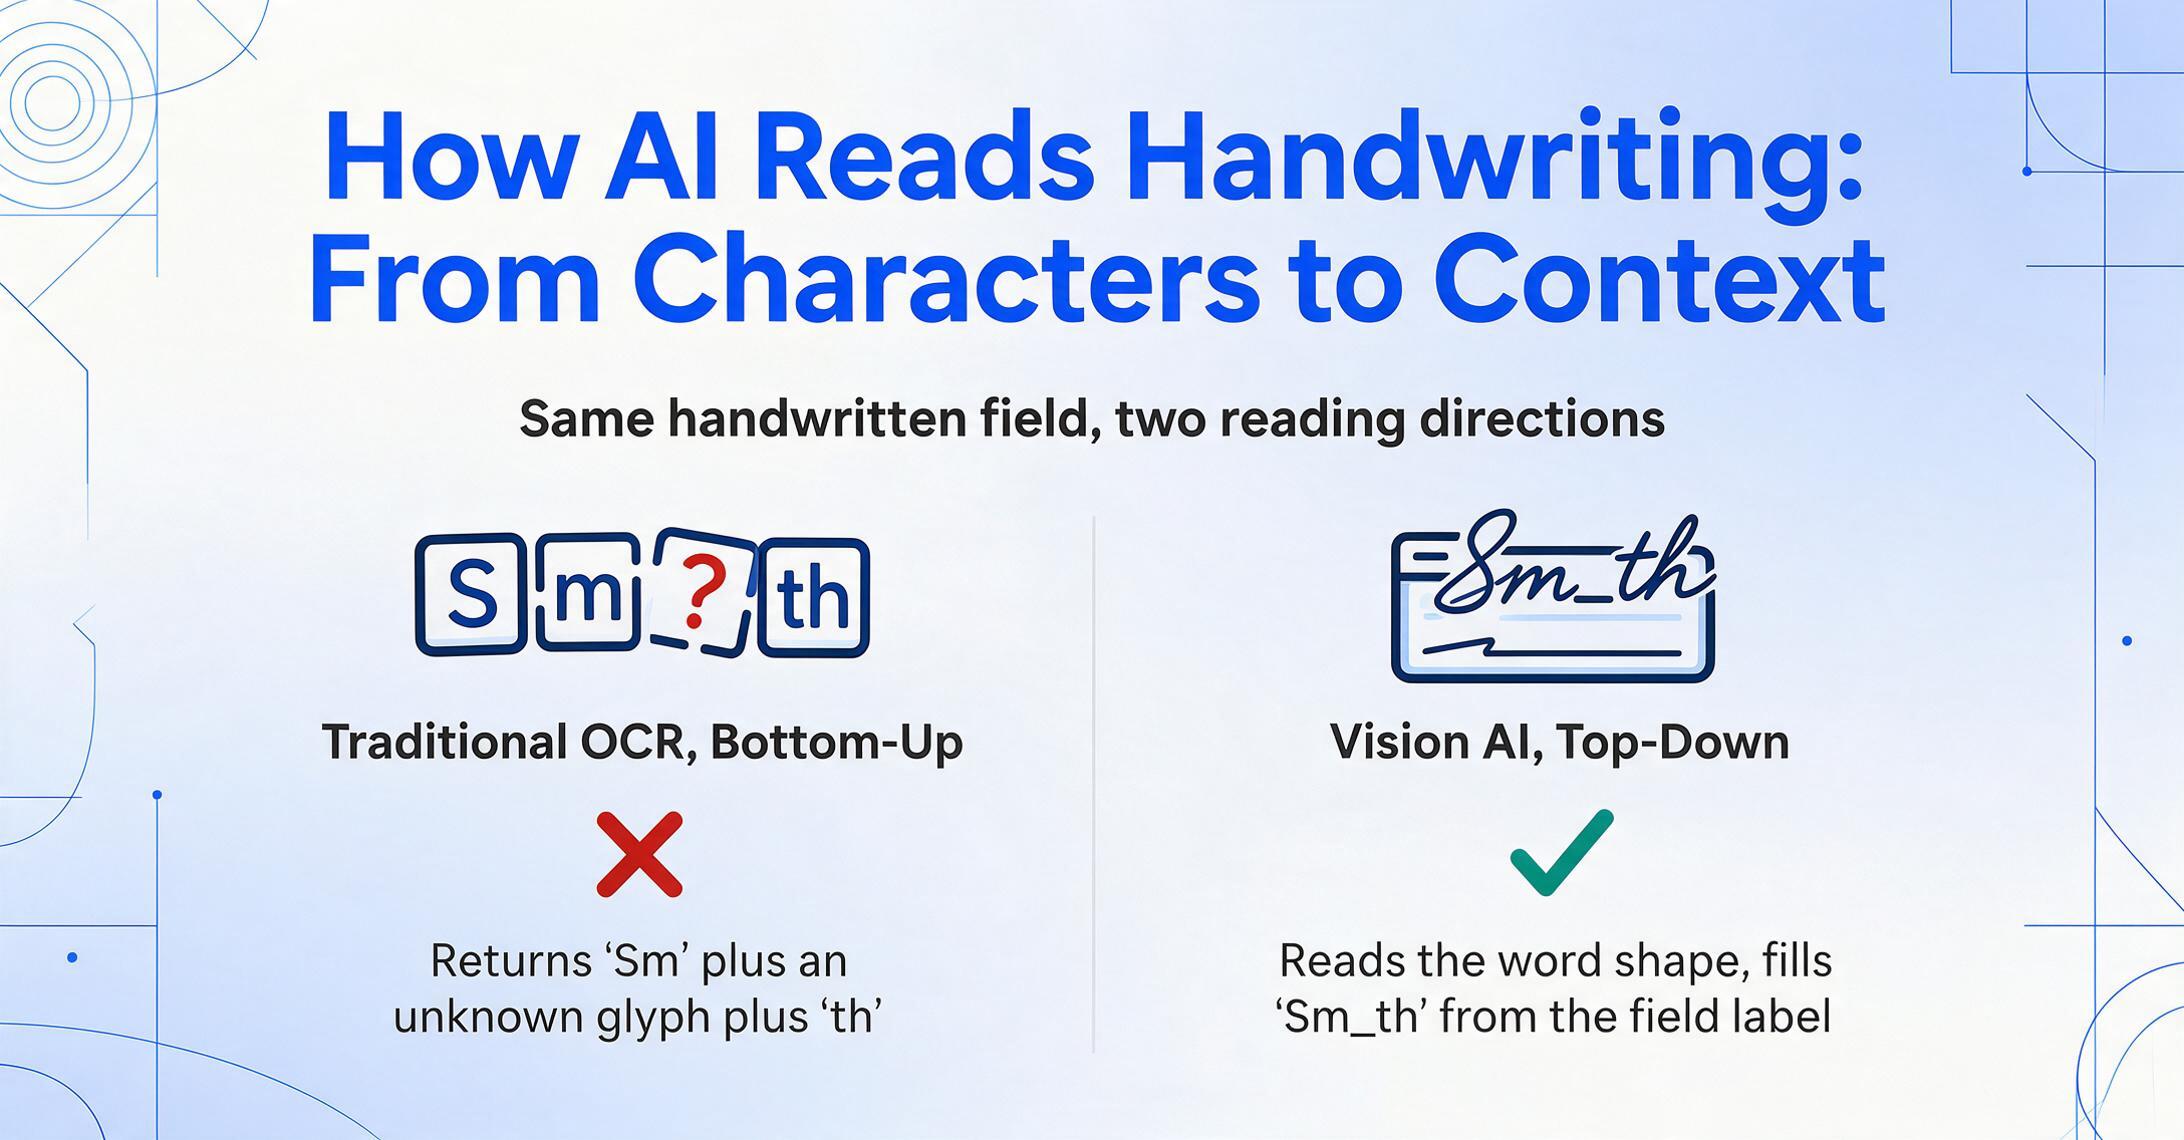
El reconocimiento moderno de escritura a mano con IA — impulsado por modelos de visión-lenguaje — invierte por completo el flujo del OCR tradicional. En lugar de construir palabras a partir de caracteres (de abajo hacia arriba), reconoce las palabras como unidades visuales completas y usa la comprensión a nivel de documento para desambiguar trazos individuales (de arriba hacia abajo). Esta es la misma estrategia cognitiva que usas al leer una nota manuscrita.
Reconocimiento holístico de palabras. En lugar de segmentar una página en caracteres individuales, la IA de visión procesa la imagen completa a través de una red neuronal profunda que extrae características visuales a múltiples escalas simultáneamente: trazos, fragmentos de letras, formas de palabras, patrones de líneas. Una palabra como "Total" no se ensambla a partir de T-o-t-a-l. Se reconoce como un patrón visual unificado, igual que reconoces la cara de un amigo sin catalogar cada rasgo. Las conexiones cursivas no confunden a un modelo que nunca segmentó caracteres en primer lugar.
Desambiguación basada en contexto. Una entrada manuscrita con un carácter tenue o ausente en "Sm_th" hace que el OCR tradicional devuelva "Sm" más un glifo no reconocido más "th". Una IA de visión ve la forma de la palabra y el contexto circundante — este es el campo "Nombre del cliente", y el documento proviene de un contacto conocido — y completa el hueco a partir del contexto. El mismo mecanismo resuelve un "1" manuscrito de una "l", un "0" de una "O" y un "7" de un "1" — preguntándose: ¿qué tiene sentido en este campo?
Robustez ante la variación de trazos. Entrenada con millones de imágenes de miles de escritores, la IA de visión ha visto una enorme variedad de estilos de escritura, tipos de bolígrafo y superficies. El grosor variable del trazo de una pluma estilográfica, las variaciones de presión de un bolígrafo, el grafito tenue de un lápiz — todo esto está en la distribución de entrenamiento. El modelo abstrae la variación superficial y se centra en la estructura subyacente de los caracteres, sin necesidad de tener el estilo de cada escritor en una biblioteca de plantillas.
Comprensión semántica a nivel de documento. Esta capa transforma el reconocimiento de escritura a mano de una herramienta de transcripción en un motor de extracción de datos. La etiqueta "Número de factura" le indica al modelo que el valor manuscrito junto a ella debe ser un código alfanumérico, no una fecha. Esto es Extracción de Columnas Personalizadas: defines los nombres de columna que quieres — "Fecha", "Proveedor", "Total" — y la IA localiza cada valor manuscrito comprendiendo su significado semántico, no haciendo coincidir una posición de plantilla. Para ver más a fondo lo que el reconocimiento de escritura a mano con IA puede hacer realmente, consulta si la IA puede leer escritura a mano a partir de fotos y con qué precisión.
La brecha de precisión: OCR vs IA en escritura a mano
La diferencia entre cómo funcionan estos dos enfoques no es académica: produce una brecha medible que determina si una herramienta es útil o inútil en un documento determinado.
| Tipo de escritura a mano | Modelo de visión de IA (2026) | OCR tradicional | Brecha |
|---|---|---|---|
| Letras de molde impresas | 90–95% | 60–80% | 15–25 pts |
| Letra cursiva clara | 80–88% | 30–50% | 38–50 pts |
| Letra cursiva desordenada | 65–75% | 10–25% | 40–55 pts |
| Muy degradada / estilizada | 45–60% | <10% | 35–50 pts |
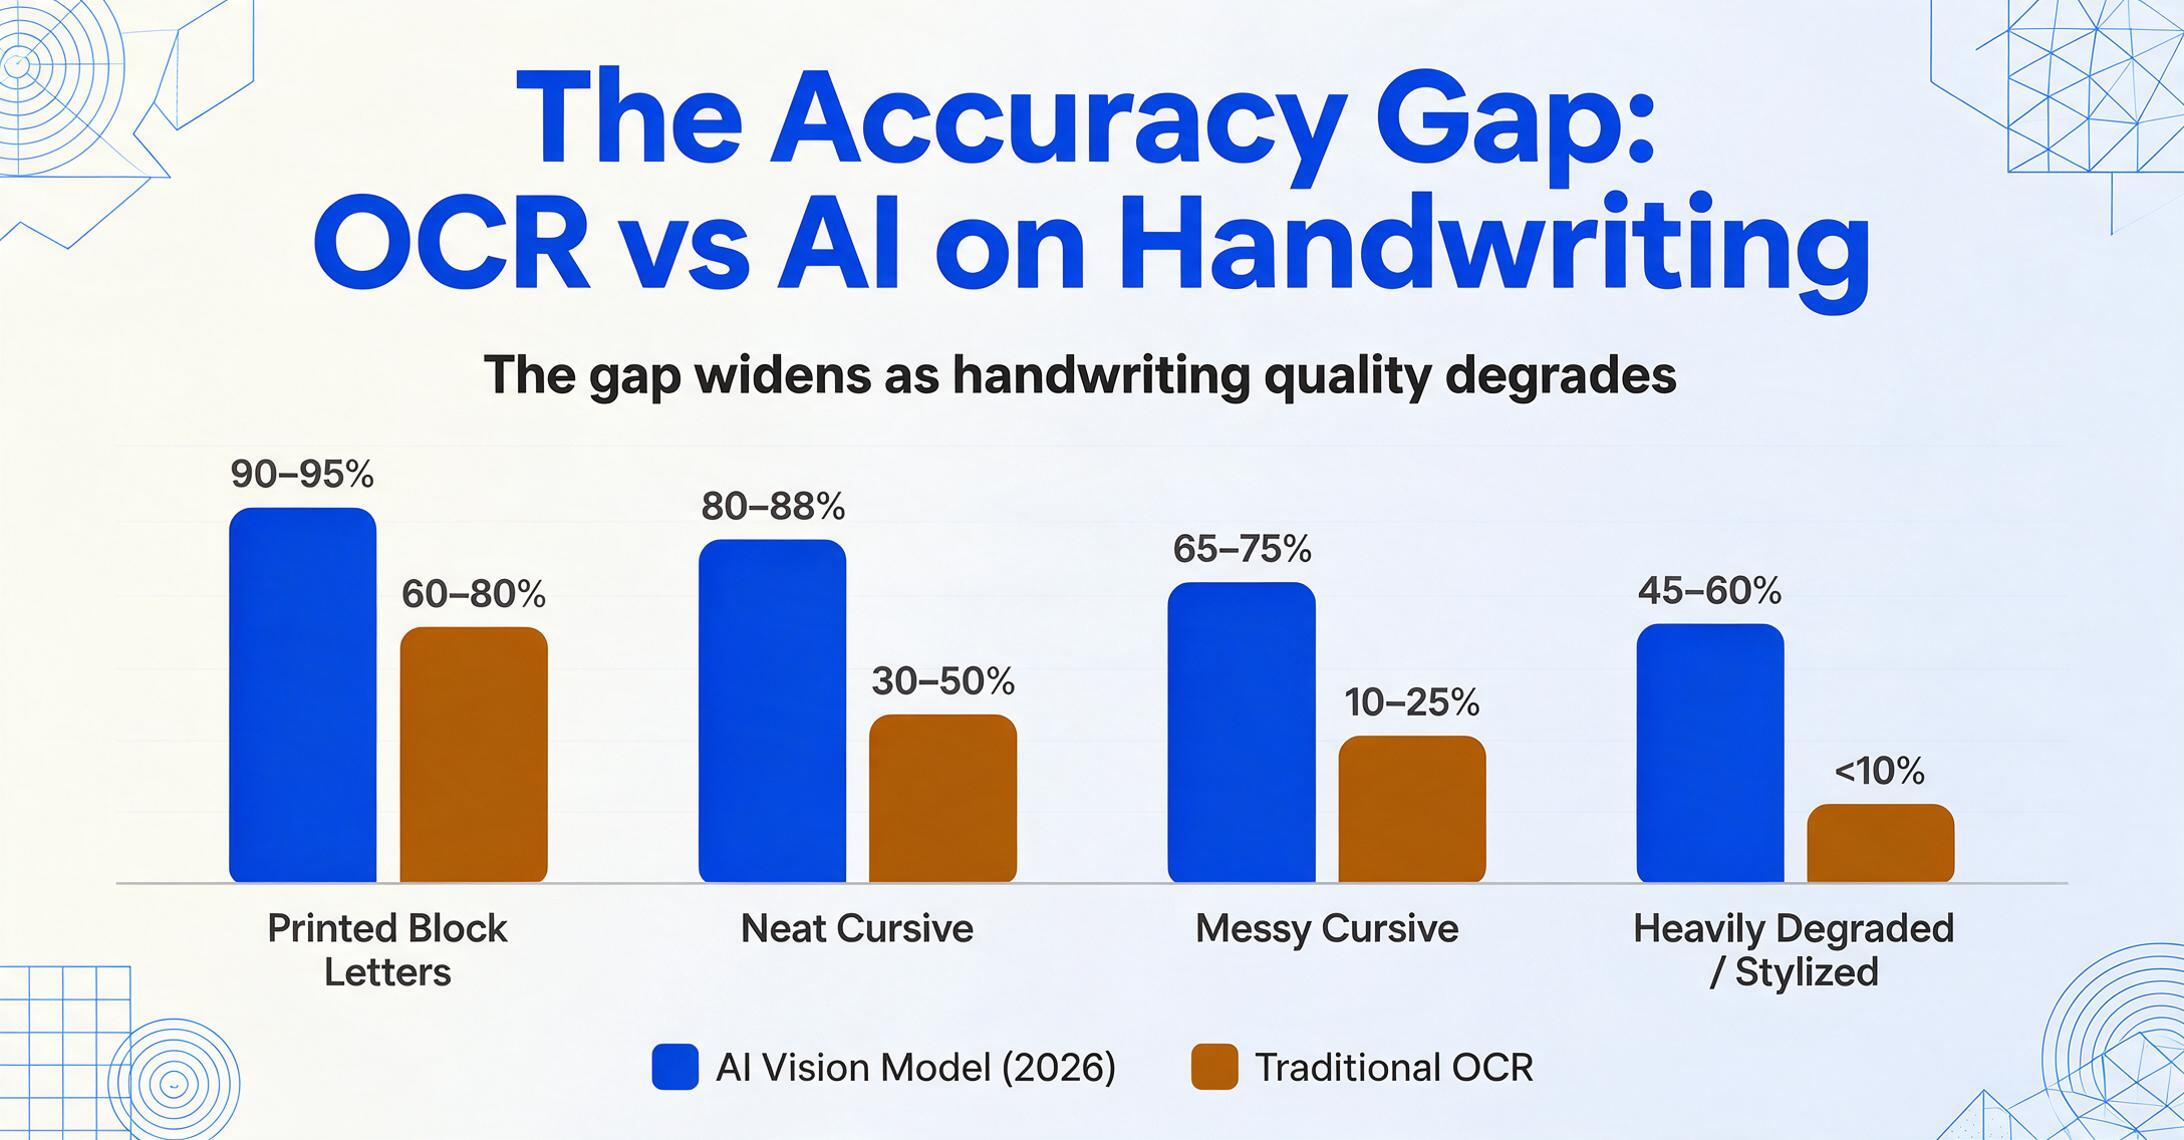
Estas son cifras de reconocimiento bruto: cuántos caracteres y palabras vuelven correctamente a nivel de transcripción. La precisión a nivel de campo, donde cada valor extraído aterriza en la columna correcta de la hoja de cálculo, es mayor, porque el contexto del documento desambigua caracteres ambiguos; las cifras a nivel de campo son el tema de nuestra comparación de IA vs OCR tradicional.
La brecha se amplía a medida que la calidad de la escritura se degrada, justo donde más necesitas que la herramienta funcione. Con letras de molde impresas, el OCR tradicional es aceptable. Con cursiva clara, la brecha salta a unos 40 puntos: datos utilizables vs volver a escribir todo manualmente. Con cursiva desordenada, el OCR tradicional devuelve galimatías en más de tres cuartas partes de las palabras. La IA, aunque imperfecta en este nivel, al menos devuelve datos que vale la pena revisar en lugar de descartar.
Los benchmarks independientes lo confirman a nivel de caracteres. En la base de datos de escritura a mano IAM, GPT-5 logra ~1.22% de tasa de error de caracteres (CER), menos de 2 errores por cada 100 caracteres, mientras que Tesseract obtiene 12.5% de CER (codesota.com, abril de 2026). En el benchmark de tasa de error de palabras (WER) 2026 de handwritingocr.com, las mejores herramientas especializadas logran menos del 1% de WER en cursiva limpia, mientras que las APIs de OCR en la nube oscilan entre 8% y 23% de WER, lo que significa que hasta una cuarta parte de todas las palabras vuelven mal de servicios en la nube de pago. Para un análisis completo de precisión, consulta el reconocimiento de escritura a mano con IA vs OCR tradicional.
Qué tipos de escritura a mano maneja mejor la IA — y dónde todavía le cuesta
Los números de precisión anteriores responden a "¿qué tan diferente es la IA del OCR?". La siguiente pregunta es: ¿cómo se desempeñará la IA en mis documentos? La respuesta depende de tres variables.
Los formularios estructurados con campos etiquetados producen los mejores resultados. Cuando un documento tiene etiquetas de campo claras — "Fecha", "Nombre del empleado", "Horas" — y valores escritos a mano en espacios designados, la IA usa esas etiquetas como anclas semánticas. El modelo sabe que el contenido debajo de "Fecha" debe coincidir con un patrón de fecha, lo que restringe el reconocimiento y suprime errores. Si tus documentos son formularios con etiquetas preimpresas y respuestas manuscritas en letras de molde o cursiva prolija, espera una precisión de campo superior al 90%.
Los documentos consistentes de un solo escritor se desempeñan significativamente mejor que los conjuntos de múltiples escritores. Cuando el mismo técnico llena 50 formularios de inspección, la IA aprende implícitamente sus patrones de trazo a lo largo de las páginas — la forma en que forma los "7", la inclinación de sus "t". Las primeras páginas establecen el patrón; las páginas siguientes se benefician. El benchmark de 2026 de AIMultiple con 100 muestras de cursiva de contribuyentes fijos encontró que los mejores modelos lograron similitud semántica utilizable en producción en conjuntos consistentes de un solo escritor.
Las notas libres no estructuradas — páginas de prosa manuscrita o anotaciones al margen — empujan a la IA a su banda de rendimiento más débil. Sin etiquetas de campo que anclen la extracción, el modelo hace transcripción cruda en lugar de extracción estructurada. Una revisión de 2025 encontró que GPT-4.1 bajó de ~85% en escritura a mano limpia de una sola página a ~65% en la tercera página de notas de varias páginas, donde el modelo comenzó a inventar texto que no estaba presente en la página.
El umbral práctico: si dos personas que leen la misma escritura a mano coinciden en lo que dice, es probable que la IA lo haga bien. Si los humanos no coinciden, la IA adivinará mal. Para patrones de falla específicos y soluciones, consulta nuestra guía sobre modos de falla en la extracción de escritura a mano.
Preguntas Frecuentes
¿El reconocimiento de escritura a mano con IA necesita entrenarse con mi letra?
No — y esta es una diferencia fundamental con los sistemas ICR más antiguos que requerían de 10 a 20 muestras de entrenamiento por escritor. La IA de visión moderna está preentrenada con millones de muestras de escritura a mano de miles de escritores. Maneja escritura nueva zero-shot: sube un documento de un escritor que el modelo nunca ha visto y extrae sin configuración. Para más información, consulta qué es el reconocimiento de escritura a mano con IA y cómo la IA de visión lee la letra cursiva.
¿Cómo distingue la IA entre un "5" y un "6" o un "1" y un "7" escritos a mano?
Mediante el contexto. Un "5" y un "6" escritos a mano pueden parecer idénticos de forma aislada — pero la IA no los lee de forma aislada. Si el campo está etiquetado como "Total" y el documento muestra partidas con precios conocidos, el modelo puede validar si un "5" o un "6" produce un resultado matemáticamente coherente. Esta desambiguación basada en el contexto es la razón por la que la precisión por campo supera con creces la tasa de reconocimiento de caracteres en bruto — la IA utiliza el documento en su conjunto para resolver ambigüedades locales.
¿Puede la IA extraer datos de formularios escritos a mano o solo transcribir texto?
La IA extrae datos estructurados — esta es la diferencia clave con la transcripción básica de escritura a mano a texto. En lugar de generar un bloque de texto en bruto, la IA coloca cada valor en su propia columna: "Número de factura: 1042", "Fecha: 15/3/26", "Total: $847.50". El mecanismo es la Extracción de Columnas Personalizadas: defines las columnas de salida y la IA asigna cada campo escrito a mano comprendiendo su significado, no localizándolo en una coordenada de píxel fija.
¿Por qué no se puede simplemente mejorar el OCR tradicional para la escritura a mano?
Porque la mejora necesaria no es una optimización — es una reescritura de la arquitectura fundamental. La suposición de segmentación de caracteres del OCR tradicional está integrada en cada capa. "Mejorarlo" para escritura a mano requiere reemplazar la segmentación por reconocimiento holístico, reemplazar la extracción de características basada en fuentes por características visuales aprendidas y añadir comprensión del contexto a nivel de documento — momento en el que ya has construido un modelo de IA de visión. Varios proveedores de OCR en la nube han añadido capas de ML sobre sus motores tradicionales para la escritura a mano, pero los resultados (60–70% en cursiva) reflejan los límites de parchear una arquitectura incompatible. Las soluciones líderes han migrado a modelos de visión-lenguaje en lugar de intentar adaptar el OCR basado en caracteres.
¿El reconocimiento de escritura a mano funciona con fotos del teléfono o solo con escaneos?
Las fotos del teléfono funcionan bien y ahora son el tipo de entrada más común para el reconocimiento de escritura a mano con IA. Los modelos de visión modernos manejan la distorsión de perspectiva y la iluminación desigual que rompen el OCR tradicional. Una foto bien tomada con el teléfono (de frente, con iluminación uniforme, al menos 200 DPI) produce una precisión dentro de 3 a 5 puntos porcentuales de un escaneo de cama plana. Desde 2024, la robustez de los modelos ante artefactos de imágenes del mundo real ha hecho que la entrada desde la cámara del teléfono sea práctica para flujos de trabajo empresariales de escritura a mano.
La diferencia entre el OCR tradicional y el reconocimiento de escritura a mano con IA no es una cuestión de grado, sino de arquitectura. Uno lee letras. El otro lee documentos. En formularios estructurados escritos a mano con etiquetas de campo claras, esa diferencia arquitectónica se traduce en una ventaja de precisión de 40 puntos: la diferencia entre obtener una hoja de cálculo y obtener galimatías.
Empieza con lo que es el reconocimiento de escritura a mano con IA para la definición y el panorama general. Luego pon a prueba las afirmaciones de precisión: mira lo que la IA lee en escritura a mano real en diferentes estilos y tipos de documentos. Si estás evaluando herramientas, nuestra comparación de IA vs OCR tradicional en escritura a mano desglosa los números por tipo de documento.