Comment fonctionne la reconnaissance d'écriture manuscrite ?
Pourquoi l'IA surpasse l'OCR traditionnelle
Pense à la façon dont tu lis l'écriture brouillonne d'un ami sur un post-it. Tu ne déchiffres pas chaque lettre individuellement — tu vois le mot entier d'un coup, tu combles les caractères ambigus grâce au contexte, et tu t'appuies sur la structure du post-it (« courses : » en haut, « $ » avant un nombre) pour donner du sens. C'est ainsi que l'IA lit l'écriture manuscrite : une compréhension globale plutôt qu'un décodage lettre par lettre. L'OCR traditionnelle fait l'inverse — elle isole chaque caractère, le compare à un modèle, et s'effondre dès que les lettres se connectent. La différence architecturale est mesurable au niveau du caractère : sur le benchmark d'écriture manuscrite IAM, les modèles d'IA de pointe affichent un taux d'erreur sur les caractères d'environ 1,2 %, tandis que Tesseract, le moteur OCR open source le plus utilisé, atteint 12,5 % — et sur l'écriture cursive, cet écart ne fait que se creuser. Ce n'est pas un écart de calibration — ce sont deux façons fondamentalement différentes de voir une page.
Où cela s'inscrit : cette page est l'analyse approfondie du mécanisme — comment la technologie fonctionne sous le capot. Pour la définition et le paysage, commence par ce qu'est la reconnaissance d'écriture manuscrite par IA ; pour la précision selon le type d'écriture, consulte l'IA peut-elle lire l'écriture manuscrite à partir de photos.
Points clés
- La plupart des gens se tournent vers l'OCR pour lire l'écriture manuscrite parce que c'est le seul outil qu'ils connaissent. L'OCR a été conçue pour les machines à écrire dans les années 1970 et son hypothèse fondamentale — que les caractères existent sous forme de formes standardisées séparables — est fausse pour chaque mot manuscrit jamais écrit.
- L'OCR ne peut pas être « améliorée » pour l'écriture manuscrite car le problème n'est pas un réglage de précision — c'est l'architecture. La segmentation des caractères s'effondre sur les liaisons cursives, la correspondance de caractéristiques basée sur les polices échoue face à une pression de trait variable, et le moteur n'a aucun contexte de document pour résoudre l'ambiguïté.
- L'IA lit l'écriture manuscrite comme toi : en reconnaissant visuellement des mots entiers, en comblant les lacunes grâce au contexte, et en utilisant la structure du document pour décider si un gribouillis ambigu est un « 5 » ou un « 6 ». Le passage d'une architecture caractère par caractère à une lecture globale crée un avantage de précision de 40 points sur l'écriture cursive.
Pourquoi l'OCR traditionnelle devient aveugle face à l'écriture manuscrite
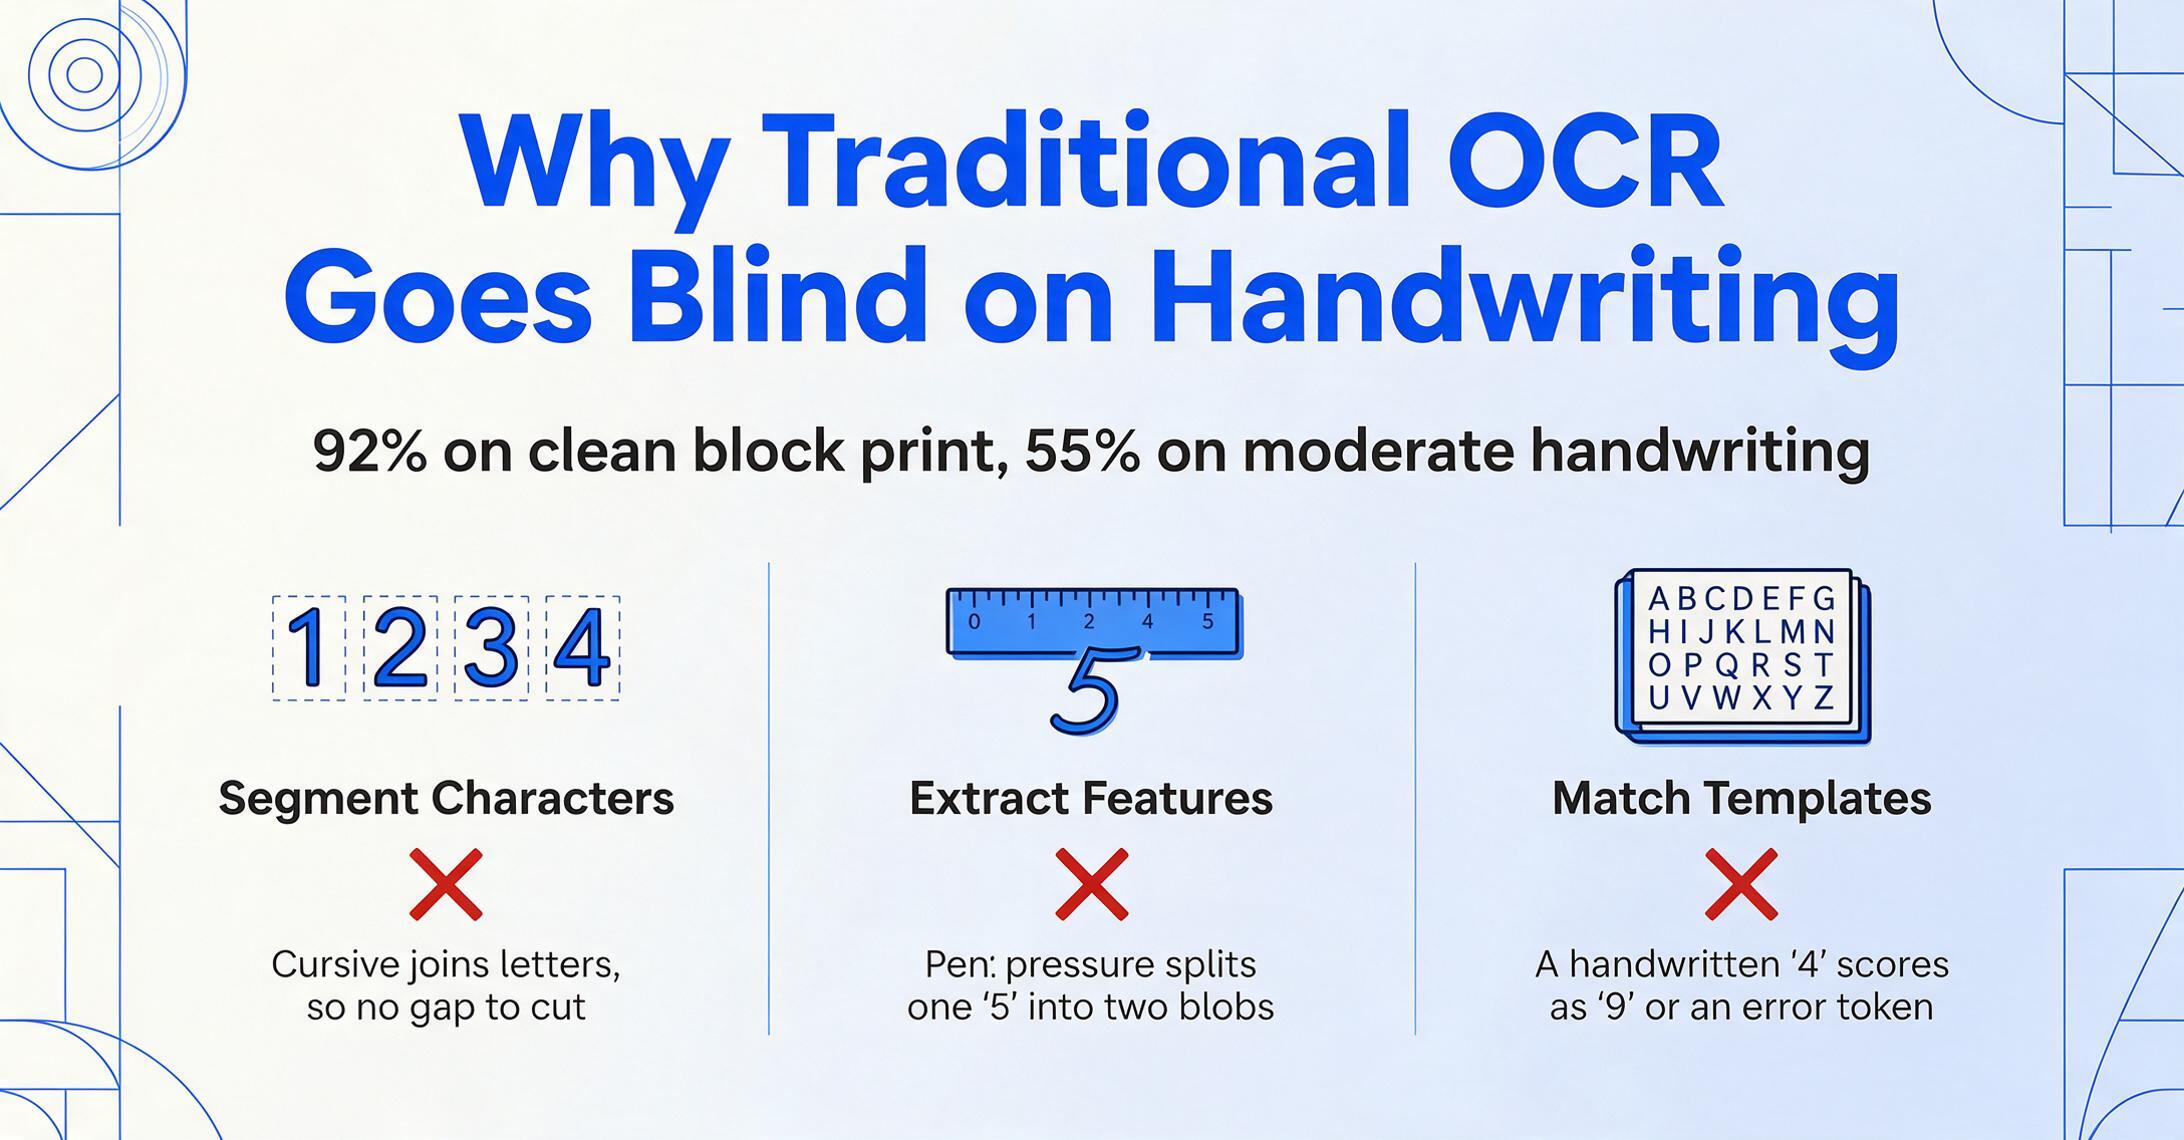
L'OCR traditionnelle a été conçue dans les années 1970 pour les machines à écrire et les formulaires imprimés. Son architecture repose sur trois hypothèses séquentielles — et l'écriture manuscrite les brise toutes.
Première étape : la segmentation des caractères. Le moteur détecte les espaces blancs entre les caractères et isole chaque glyphe dans une boîte englobante. Cela fonctionne avec Courier New ; cela s'effondre sur l'écriture cursive, où la liaison entre un « a » et un « r » ne laisse aucun espace à détecter. Une étude de 2025 a révélé que l'OCR traditionnelle passe de 92 % de précision sur une impression en caractères d'imprimerie propres à 55 % sous une dégradation modérée de l'écriture manuscrite — des conditions qui comptent à peine comme du bruit pour le texte imprimé.
Deuxième étape : l'extraction de caractéristiques. Une fois isolé, le moteur mesure les propriétés géométriques de chaque caractère — nombre de traits, angles de courbe — et les compare à des vecteurs de caractéristiques stockés. L'écriture manuscrite contrecarre cela, car la pression variable d'un stylo à bille peut fragmenter un seul « 5 » en une tache plus un tiret séparé. Le vecteur de caractéristiques ne correspond à aucun modèle — non pas parce que le caractère est incorrect, mais parce que la bibliothèque a été construite pour des polices, pas pour des mains.
Troisième étape : la correspondance de modèles. Les caractéristiques extraites sont notées par rapport à une base de données entraînée exclusivement sur des polices de caractères. La meilleure supposition du moteur sur un « 4 » manuscrit est souvent « 9 », « A » ou un jeton d'erreur. Il ne peut pas demander de l'aide — il émet sa meilleure supposition et l'erreur se propage en aval.
Les erreurs de segmentation alimentent des caractéristiques malformées dans un matcher basé sur les polices, produisant des résultats inutilisables. Sur la base de données d'écriture manuscrite IAM — 13 353 lignes de texte provenant de 657 scripteurs — Tesseract, le moteur OCR open source le plus largement déployé, a renvoyé un taux d'erreur sur les caractères (CER) de 12,5 %. Sur l'écriture cursive, son taux d'erreur sur les mots (WER) dépasse 95 % (codesota.com, 2026). Ce n'est pas un problème de réglage. C'est une architecture construite pour des caractères séparés qui se confronte à un support qui les connecte délibérément.
Comment l'IA lit l'écriture manuscrite : des caractères au contexte
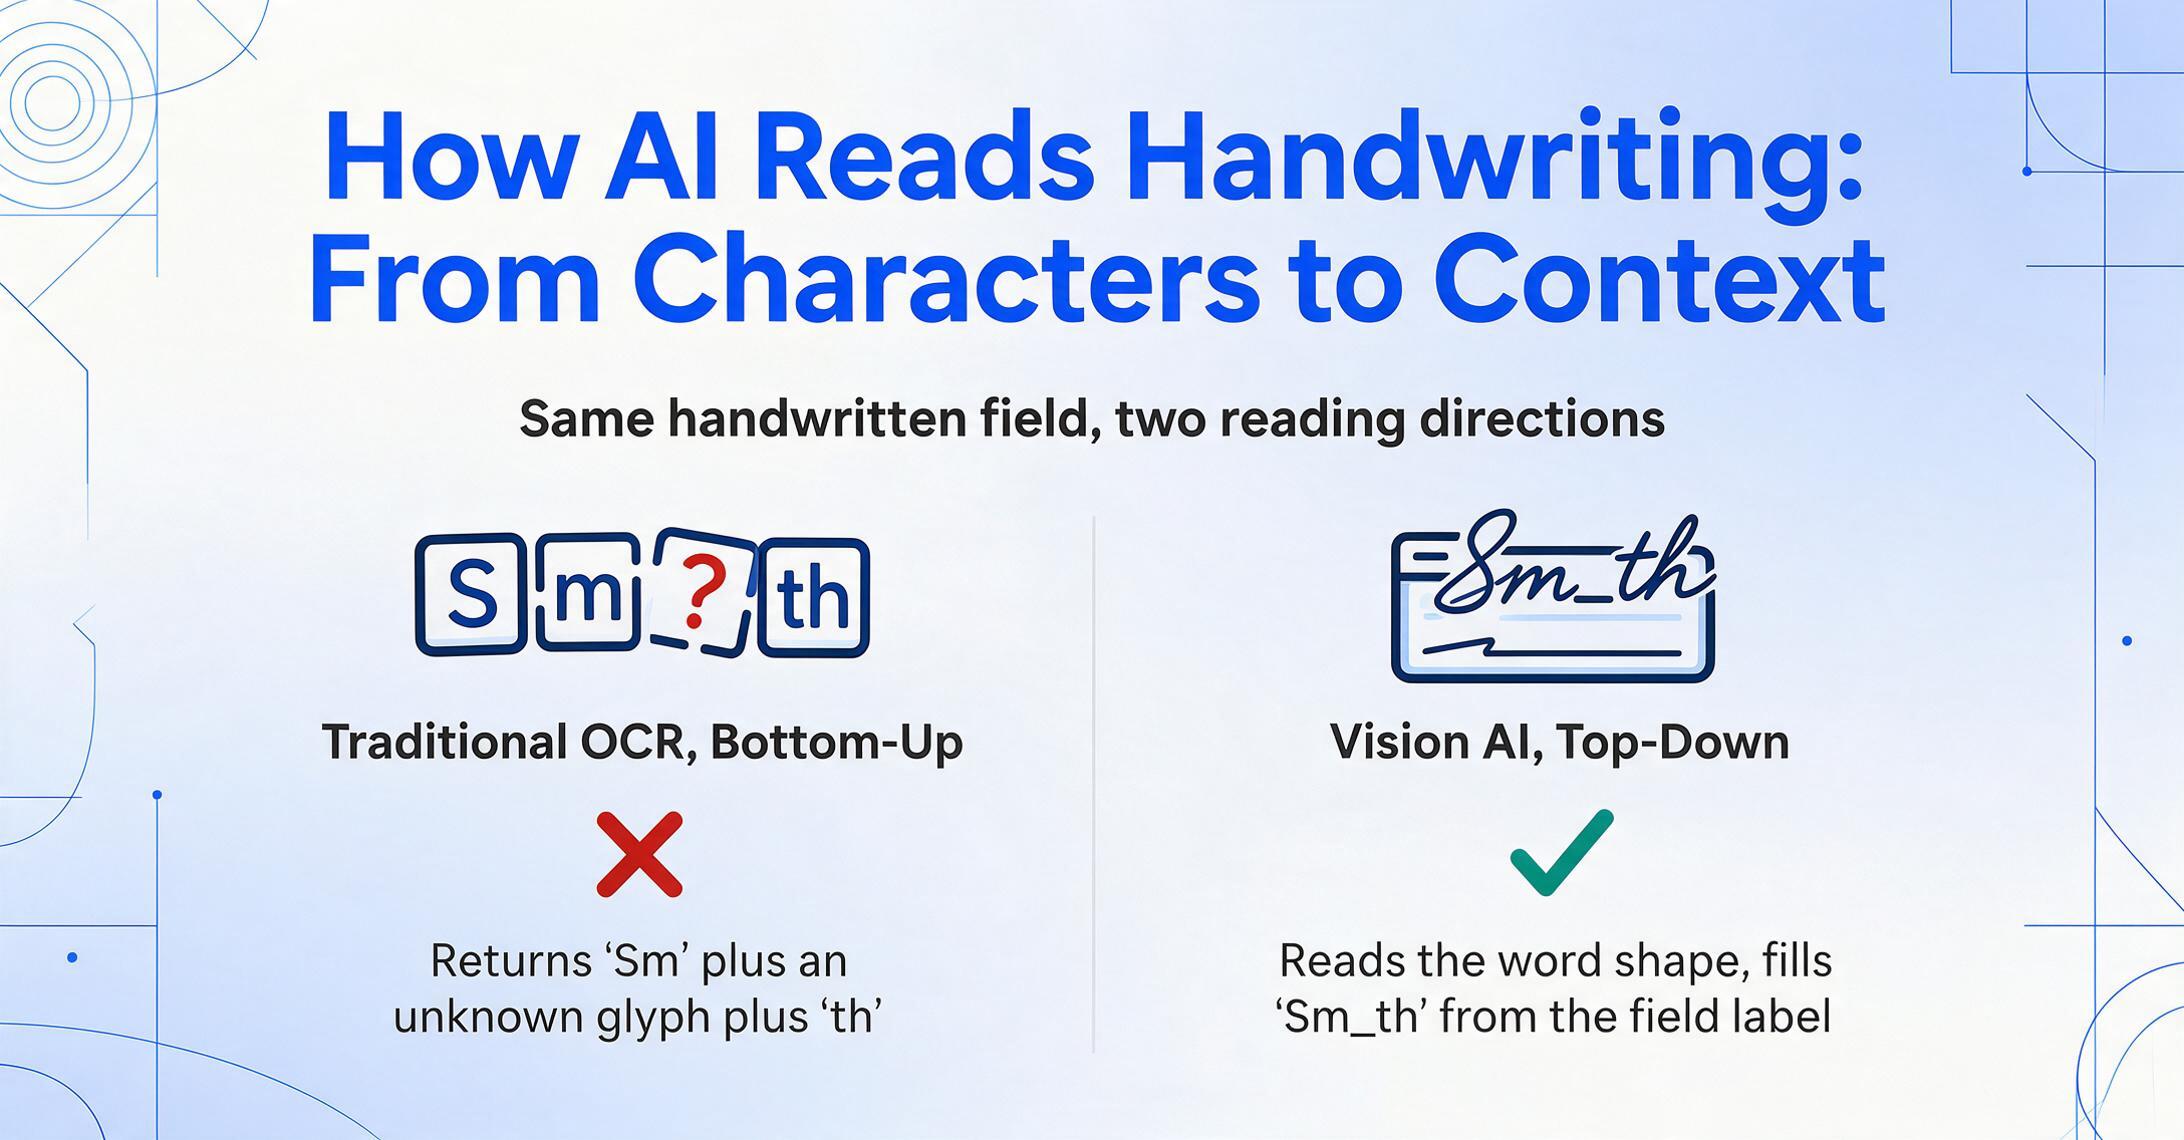
La reconnaissance moderne d'écriture manuscrite par IA — alimentée par des modèles vision-langage — inverse entièrement le pipeline de l'OCR traditionnelle. Au lieu de construire des mots à partir de caractères (ascendante), elle reconnaît les mots comme des ensembles visuels et utilise la compréhension au niveau du document pour lever l'ambiguïté des traits individuels (descendante). C'est la même stratégie cognitive que vous utilisez en lisant une note manuscrite.
Reconnaissance holistique des mots. Plutôt que de segmenter une page en caractères individuels, l'IA de vision traite l'image entière via un réseau neuronal profond qui extrait des caractéristiques visuelles à plusieurs échelles simultanément — traits, fragments de lettres, formes de mots, motifs de lignes. Un mot comme « Total » n'est pas assemblé à partir de T-o-t-a-l. Il est reconnu comme un motif visuel unifié, de la même façon que vous reconnaissez le visage d'un ami sans cataloguer chaque trait. Les liaisons cursives ne déroutent pas un modèle qui n'a jamais segmenté les caractères.
Levée d'ambiguïté contextuelle. Une entrée manuscrite avec un caractère faible ou manquant dans « Sm_th » fait renvoyer à l'OCR traditionnelle « Sm » plus un glyphe non reconnu plus « th ». Une IA de vision voit la forme du mot et le contexte environnant — c'est le champ « Nom du client », et le document provient d'un contact connu — et comble le vide à partir du contexte. Le même mécanisme distingue un « 1 » manuscrit d'un « l », un « 0 » d'un « O », et un « 7 » d'un « 1 » — en se demandant : qu'est-ce qui a du sens dans ce champ ?
Robustesse aux variations d'écriture. Entraînée sur des millions d'images de milliers de scripteurs, l'IA de vision a vu une gamme énorme de styles d'écriture, de types de stylos et de surfaces d'écriture. L'épaisseur variable des traits d'un stylo plume, les variations de pression d'un stylo à bille, le graphite pâle d'un crayon — tout cela fait partie de la distribution d'entraînement. Le modèle abstrait les variations superficielles et se concentre sur la structure sous-jacente des caractères, sans avoir besoin du style de chaque scripteur dans une bibliothèque de modèles.
Compréhension sémantique au niveau du document. Cette couche transforme la reconnaissance d'écriture manuscrite d'un outil de transcription en un moteur d'extraction de données. L'étiquette « Numéro de facture » indique au modèle que la valeur manuscrite à côté doit être un code alphanumérique, pas une date. C'est l'Extraction de colonnes personnalisées : vous définissez les noms de colonnes souhaités — « Date », « Fournisseur », « Total » — et l'IA localise chaque valeur manuscrite en comprenant ce qu'elle signifie sémantiquement, et non en correspondant à une position de modèle. Pour approfondir ce que la reconnaissance d'écriture manuscrite par IA peut réellement faire, voyez si l'IA peut lire l'écriture manuscrite à partir de photos et avec quelle précision.
L'écart de précision : OCR vs IA sur l'écriture manuscrite
La différence entre le fonctionnement de ces deux approches n'est pas théorique — elle produit un écart mesurable qui détermine si un outil est utilisable ou inutile sur un document donné.
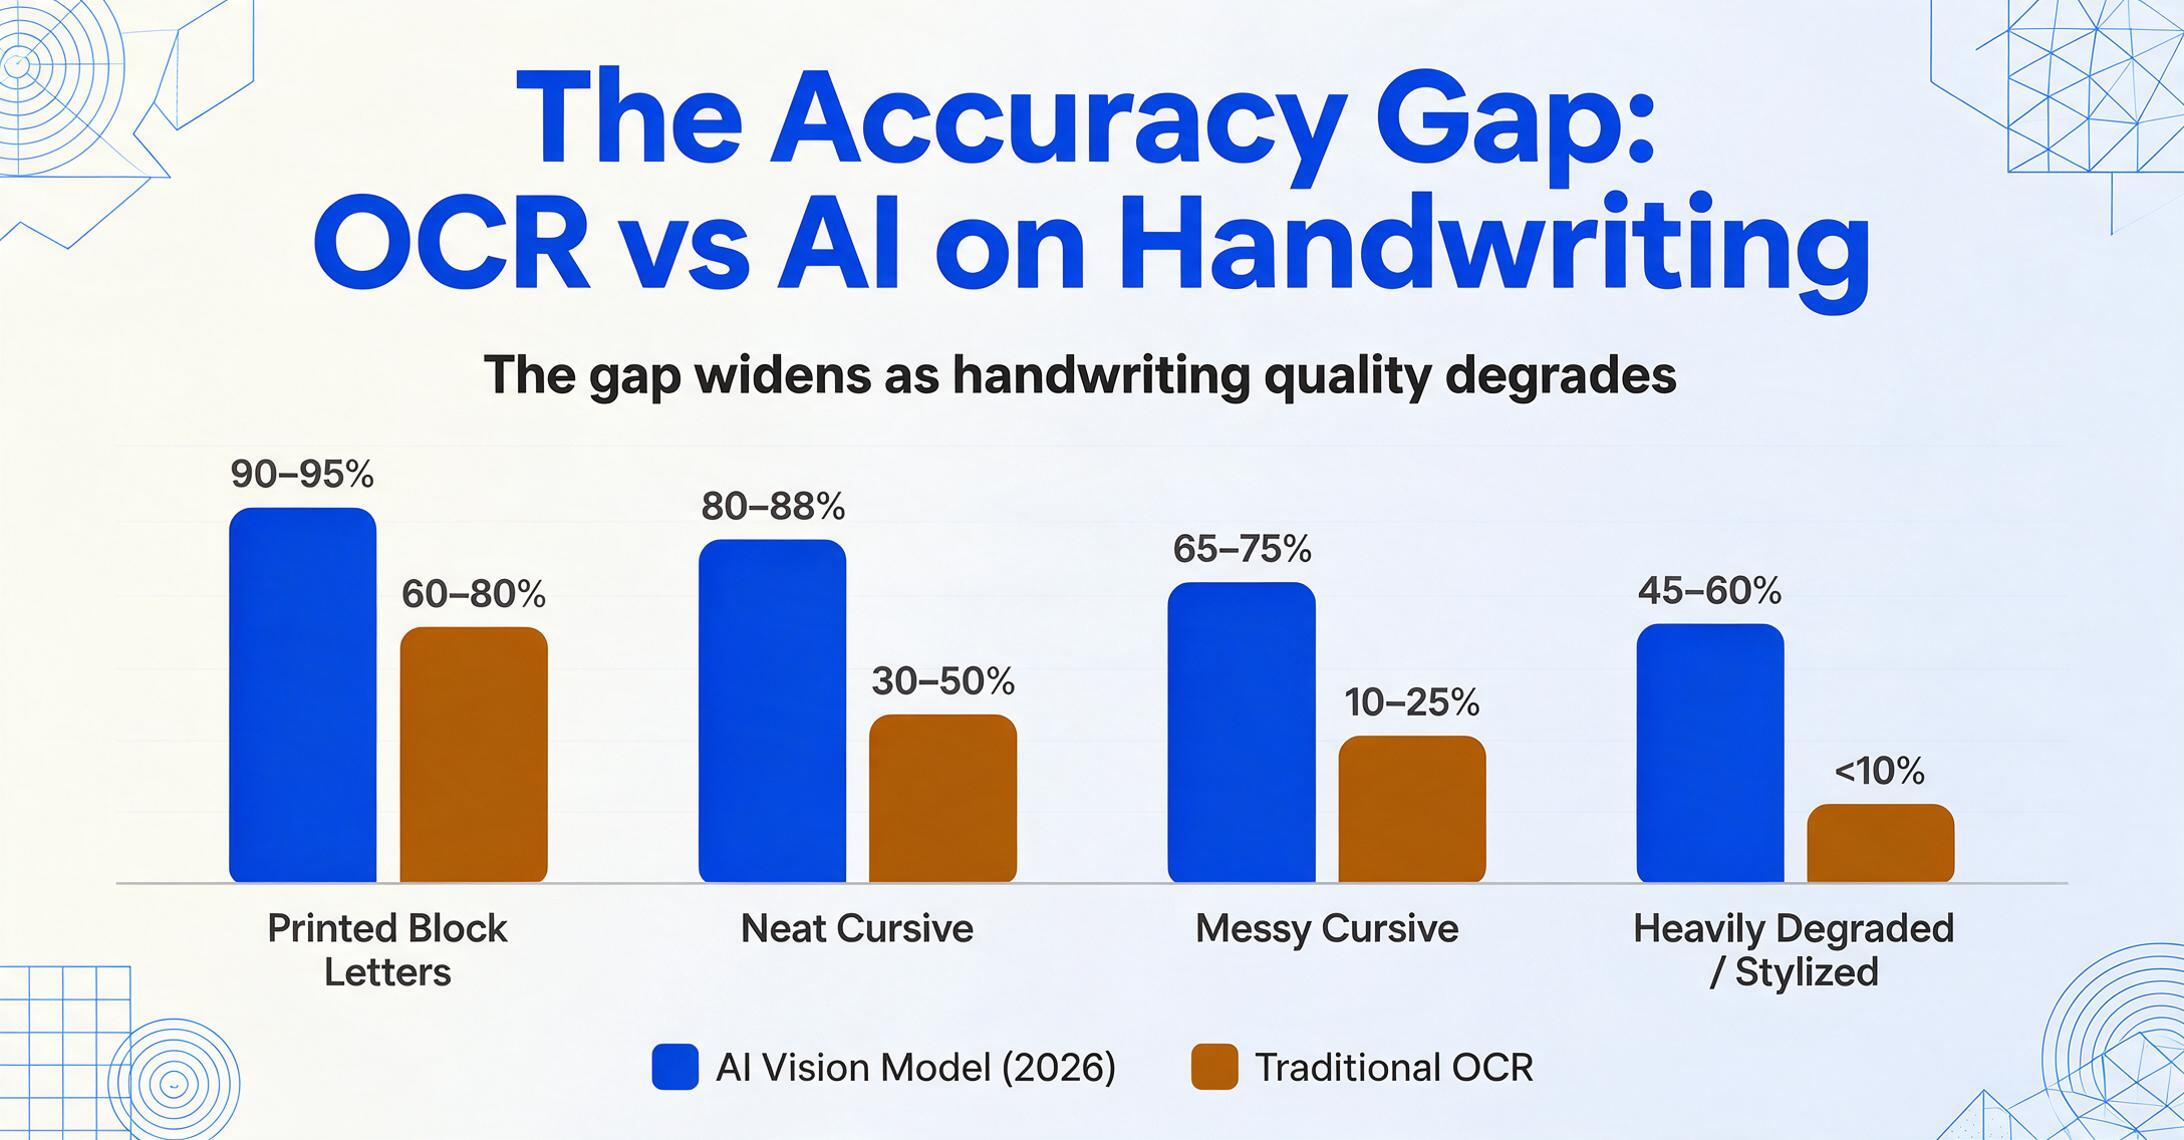
| Type d'écriture manuscrite | Modèle de vision IA (2026) | OCR traditionnelle | Écart |
|---|---|---|---|
| Lettres imprimées en majuscules | 90–95% | 60–80% | 15–25 pts |
| Cursive soignée | 80–88% | 30–50% | 38–50 pts |
| Cursive désordonnée | 65–75% | 10–25% | 40–55 pts |
| Fortement dégradée / stylisée | 45–60% | <10% | 35–50 pts |
Ce sont des chiffres de reconnaissance brute — combien de caractères et de mots sont correctement restitués au niveau de la transcription. La précision au niveau des champs, où chaque valeur extraite atterrit dans la bonne colonne du tableur, est plus élevée, car le contexte du document lève l'ambiguïté sur les caractères ambigus ; les chiffres au niveau des champs font l'objet de notre comparaison IA vs OCR traditionnelle. Si tu choisis un outil plutôt que de comprendre le mécanisme, notre sélection de logiciels d'OCR d'écriture manuscrite classés par précision sur la cursive compare 11 options par catégorie technologique.
L'écart se creuse à mesure que la qualité de l'écriture se dégrade — exactement là où tu as le plus besoin que l'outil fonctionne. Sur les lettres imprimées en majuscules, l'OCR traditionnelle est convenable. Sur la cursive soignée, l'écart grimpe à environ 40 points — des données utilisables contre tout retaper manuellement. Sur la cursive désordonnée, l'OCR traditionnelle renvoie du charabia sur plus des trois quarts des mots. L'IA, bien qu'imparfaite à ce niveau, renvoie au moins des données qui valent la peine d'être examinées plutôt que jetées.
Des benchmarks indépendants le confirment au niveau des caractères. Sur la base de données d'écriture manuscrite IAM, GPT-5 atteint un taux d'erreur sur les caractères (CER) d'environ 1,22 % — moins de 2 erreurs pour 100 caractères — tandis que Tesseract obtient 12,5 % de CER (codesota.com, avril 2026). Sur le benchmark 2026 du taux d'erreur sur les mots (WER) de handwritingocr.com, les meilleurs outils spécialisés atteignent moins de 1 % de WER sur la cursive propre, tandis que les API OCR cloud vont de 8 % à 23 % de WER — ce qui signifie que jusqu'à un quart de tous les mots reviennent erronés depuis des services cloud payants. Pour un tour d'horizon complet de la précision, voir reconnaissance d'écriture manuscrite par IA vs OCR traditionnelle.
Quels types d'écriture manuscrite l'IA gère-t-elle le mieux — et où elle échoue encore
Les chiffres de précision ci-dessus répondent à la question « en quoi l'IA diffère-t-elle de l'OCR ? ». La question suivante est : comment l'IA se comportera-t-elle sur mes documents ? La réponse dépend de trois variables.
Les formulaires structurés avec champs étiquetés donnent les meilleurs résultats. Lorsqu'un document comporte des étiquettes claires — « Date », « Nom de l'employé », « Heures » — et des valeurs manuscrites dans des espaces désignés, l'IA utilise ces étiquettes comme ancres sémantiques. Le modèle sait que le contenu sous « Date » doit correspondre à un format de date, ce qui contraint la reconnaissance et réduit les erreurs. Si vos documents sont des formulaires avec étiquettes pré-imprimées et réponses manuscrites en lettres capitales ou en cursive soignée, attendez-vous à une précision de plus de 90 % sur les champs.
Les documents d'un seul scripteur cohérent donnent de bien meilleurs résultats que les ensembles multi-scripteurs. Lorsque le même technicien remplit 50 formulaires d'inspection, l'IA apprend implicitement ses schémas d'écriture au fil des pages — la façon dont il forme ses « 7 », l'inclinaison de ses « t ». Les premières pages établissent le schéma ; les pages suivantes en bénéficient. Le benchmark 2026 d'AIMultiple sur 100 échantillons de cursive de contributeurs fixes a montré que les meilleurs modèles atteignaient une similarité sémantique exploitable en production sur des ensembles cohérents à scripteur unique.
Les notes libres non structurées — pages de prose manuscrite ou annotations en marge — poussent l'IA dans sa zone de performance la plus faible. Sans étiquettes de champs pour ancrer l'extraction, le modèle effectue une transcription brute plutôt qu'une extraction structurée. Une revue de 2025 a constaté que GPT-4.1 passait d'environ 85 % sur une page manuscrite propre à environ 65 % à la troisième page de notes multipages, où le modèle commençait à inventer du texte absent de la page.
Le seuil pratique : si deux personnes lisant la même écriture s'accordent sur ce qu'elle dit, l'IA réussira probablement. Si les humains divergent, l'IA se trompera. Pour les schémas d'échec spécifiques et leurs solutions, consultez notre guide sur les modes d'échec de l'extraction d'écriture manuscrite.
Questions fréquemment posées
La reconnaissance de l'écriture manuscrite par IA doit-elle être entraînée sur mon écriture ?
Non — et c'est une différence fondamentale par rapport aux anciens systèmes ICR qui exigeaient 10 à 20 échantillons d'entraînement par scripteur. L'IA de vision moderne est pré-entraînée sur des millions d'échantillons d'écriture manuscrite provenant de milliers de scripteurs. Elle traite une nouvelle écriture en mode zero-shot : téléversez un document d'un scripteur que le modèle n'a jamais vu, et il extrait les données sans configuration. Pour en savoir plus, découvrez ce qu'est la reconnaissance de l'écriture manuscrite par IA et comment l'IA de vision lit l'écriture cursive.
Comment l'IA fait-elle la différence entre un « 5 » et un « 6 » ou un « 1 » et un « 7 » manuscrits ?
Grâce au contexte. Un « 5 » et un « 6 » manuscrits peuvent sembler identiques isolément — mais l'IA ne les lit pas isolément. Si le champ est étiqueté « Total » et que le document présente des lignes avec des prix connus, le modèle peut vérifier si un « 5 » ou un « 6 » produit un résultat mathématiquement cohérent. Cette désambiguïsation contextuelle explique pourquoi la précision par champ dépasse largement le taux de reconnaissance des caractères brut — l'IA utilise le document dans son ensemble pour résoudre les ambiguïtés locales.
L'IA peut-elle extraire des données de formulaires manuscrits, ou se contente-t-elle de transcrire le texte ?
L'IA extrait des données structurées — c'est la différence clé avec la transcription manuscrite de base. Au lieu de produire un bloc de texte brut, l'IA place chaque valeur dans sa propre colonne : « Numéro de facture : 1042 », « Date : 15/03/26 », « Total : 847,50 $ ». Le mécanisme est l'Extraction de colonnes personnalisées : vous définissez les colonnes de sortie, et l'IA associe chaque champ manuscrit en comprenant sa signification, et non en le localisant à des coordonnées de pixels fixes.
Pourquoi ne peut-on pas simplement améliorer l'OCR traditionnelle pour l'écriture manuscrite ?
Parce que l'amélioration nécessaire n'est pas un perfectionnement — c'est une réécriture de l'architecture fondamentale. L'hypothèse de segmentation des caractères de l'OCR traditionnelle est intégrée à chaque couche. « Améliorer » l'OCR pour l'écriture manuscrite exige de remplacer la segmentation par une reconnaissance holistique, de remplacer l'extraction de caractéristiques basée sur les polices par des caractéristiques visuelles apprises, et d'ajouter une compréhension contextuelle au niveau du document — à ce stade, vous avez construit un modèle d'IA de vision. Plusieurs fournisseurs d'OCR cloud ont ajouté des couches de ML par-dessus leurs moteurs traditionnels pour l'écriture manuscrite, mais les résultats (60–70 % sur la cursive) reflètent les limites d'une architecture rapiécée. Les solutions leaders sont passées aux modèles vision-langage plutôt que d'essayer de moderniser l'OCR basée sur les caractères.
La reconnaissance d'écriture manuscrite fonctionne-t-elle sur les photos prises avec un téléphone ou uniquement sur les scans ?
Les photos prises avec un téléphone fonctionnent bien — et constituent désormais le type d'entrée le plus courant pour la reconnaissance d'écriture manuscrite par IA. Les modèles de vision modernes gèrent la distorsion de perspective et l'éclairage inégal qui mettent en échec l'OCR traditionnelle. Une photo bien prise avec un téléphone (de face, éclairage uniforme, au moins 200 DPI) produit une précision à 3–5 points de pourcentage près d'un scan à plat. Depuis 2024, la robustesse des modèles aux artefacts d'images du monde réel a rendu l'entrée par caméra de téléphone pratique pour les flux de travail d'écriture manuscrite en entreprise.
La différence entre l'OCR traditionnelle et la reconnaissance d'écriture manuscrite par IA n'est pas une question de degré — c'est une question d'architecture. L'une lit des lettres. L'autre lit des documents. Sur des formulaires manuscrits structurés avec des libellés de champs clairs, cette différence architecturale se traduit par un avantage de précision de 40 points — la différence entre obtenir un tableur et obtenir du charabia.
Commence par ce qu'est la reconnaissance d'écriture manuscrite par IA pour la définition et le paysage. Ensuite, teste les affirmations de précision — découvre ce que l'IA lit sur de vraies écritures manuscrites à travers différents styles et types de documents. Si tu évalues des outils, notre comparaison de l'IA vs l'OCR traditionnelle sur l'écriture manuscrite détaille les chiffres par type de document.