So extrahieren Sie japanische Bestelldaten in Excel
für den Lieferanten-Rechnungsabgleich
Im japanischen B2B-Einkauf ist der Dokumentenfluss gesetzlich vorgeschrieben und durch jahrzehntelange Branchenkonventionen verfeinert: Das Angebot (見積書, mitsumorisho) führt zur Bestellung (発注書, hatchūsho), die den Lieferschein (納品書, nōhinsho) nach sich zieht, der wiederum die Rechnung (請求書, seikyūsho) auslöst. Jedes Dokument enthält eine Teilmenge überlappender Daten – Bestellnummer, Positionszeilen, Mengen, Einzelpreise, Steuerklassifizierung – und die Aufgabe des Einkaufsleiters besteht Monat für Monat darin, zu prüfen, ob das Bestellte mit dem Gelieferten und dem Berechneten übereinstimmt. Das Subcontract Act der japanischen Fair Trade Commission (下請代金支払遅延等防止法) schreibt zwölf spezifische Felder auf jeder an Subunternehmer ausgestellten Bestellung vor, darunter Lieferort (納入場所), Zahlungsbedingungen (支払条件) mit Abrechnungsstichtag (締日) und Prüfungsabschlussdatum. Wenn fünfzig solcher Bestellungen als Faxausdrucke und E-Mail-PDFs von dreißig verschiedenen Lieferanten auf Ihrem Schreibtisch landen und jede vor der Zahlungsfreigabe mit der entsprechenden Rechnung abgeglichen werden muss, ist der Engpass nicht die Genehmigungsentscheidung – sondern die Überführung der Bestelldaten in ein Format, das eine Nachschlageformel verarbeiten kann.
Wichtigste Erkenntnisse
- Fünfzig Lieferanten-Bestellungen treffen jeden Monat ein, jede muss mit einer Rechnung abgeglichen werden, und der Standard-Beschaffungsworkflow beginnt damit, dass jemand Daten manuell in eine Tabelle überträgt.
- Die Bestellung sagt „SUS304 M8×30-Schraube“, die Rechnung sagt „SUS-Schraube M8“ – VLOOKUP gibt #N/A zurück, nicht weil die Daten fehlen, sondern weil drei Dokumente dieselbe Transaktion mit unterschiedlichen Wörtern beschreiben.
- Semantische Extraktion liest, was jedes Feld bedeutet, statt wo es gedruckt ist – Ihre Spaltennamen extrahieren Bestellnummer und Zahlungsbedingungen identisch aus einer Bestellung von Mitsubishi Chemical und einem handschriftlichen Fax.
Was enthält ein japanischer Auftrag? — Feld für Feld
Japanische Aufträge folgen einer Struktur, die zugleich standardisierter und nuancierter ist als ihre westlichen Pendants. Standardisierter, weil die vom JFTC vorgeschriebenen Pflichtfelder für Subunternehmergeschäfte – kodifiziert im Subcontract Act und verstärkt durch das 2026 in Kraft tretende Gesetz zur Förderung fairer Transaktionen für kleine und mittlere Unternehmen (中小受託取引適正化法, kurz 取適法) – bedeuten, dass jeder rechtskonforme Auftrag dieselben Kerninformationen enthält. Nuancierter, weil der Inhalt dieser Felder japanische Geschäftskonventionen widerspiegelt, für die kein generisches Extraktionstool trainiert wurde.
Der JFTC schreibt vor, dass ein Auftrag (formal ein Artikel-4-Dokument gemäß dem Gesetz von 2026) mindestens enthalten muss: Namen beider Parteien, Ausstellungsdatum, Beschreibung der Leistungen, Lieferdatum, Lieferort, Datum der Prüfungsabnahme, Zahlungsbetrag, Zahlungsziel und Zahlungsmethode. In der Praxis enthalten die meisten japanischen Aufträge zusätzliche Felder, die für den Abgleich-Workflow wichtig sind. Hier ist die vollständige Struktur, mit der ein Einkaufsmanager tatsächlich arbeitet:
Kopfzeile & Identifikation
- 発注番号 (Auftragsnummer) — die eindeutige Kennung, die den Auftrag mit seinem Angebot, Lieferschein und der Rechnung verknüpft. Ohne sie ist der Drei-Wege-Abgleich reine Spekulation. Die meisten japanischen Unternehmen verwenden ein Format wie PO-2026-001. Dies ist der Primärschlüssel für jede nachgelagerte Suche.
- 発注日 (Auftragsdatum) — das Ausstellungsdatum. Dient als Ausgangspunkt für die Berechnung des Zahlungsziels, wenn die Bedingungen relativ zur Lieferung angegeben sind (z. B. innerhalb von 60 Tagen nach Lieferung).
- 発注元 (Käufer) — Firmenname, Adresse, Kontaktdaten. Muss der offizielle, im Handelsregister eingetragene Name gemäß dem Gesetz sein.
- 発注先 (Lieferant) — der Auftragnehmer, der den Auftrag erhält. Firmenname gemäß Eintragung.
Positionen & Preise
- 品名 (Artikelbezeichnung) — Beschreibung des Produkts oder der Dienstleistung. Enthält oft Teilenummern (品番) oder Spezifikationscodes, die der Lieferant anders abkürzt als auf der Rechnung – eine bekannte Ursache für fehlgeschlagene SVERWEISE.
- 数量 (Menge) — mit Einheit (単位): 個 (Stück), 式 (Pauschal/Satz), kg, m, Stunde (時間). Einheitenkonflikte zwischen Auftrag und Rechnung – der Auftrag sagt 式, die Rechnung sagt 個 – sind ein häufiges Problem beim Abgleich.
- 単価 (Einzelpreis) — in der Regel netto (税抜). Die Rechnung kann Bruttopreise ausweisen; wenn der Vergleich ohne Normalisierung der Steuerbehandlung erfolgt, sieht jede Position falsch aus.
- 金額 (Betrag) — Positionssumme = Menge × Einzelpreis. Wird normalerweise netto ausgewiesen.
Logistik & Lieferung
- 納期 (Liefertermin) — das Datum oder der Zeitraum, bis zu dem die Ware eintreffen muss. Oft als konkretes Datum (2026年8月15日) oder als relativer Zeitraum (受注後30日以内 — innerhalb von 30 Tagen nach Auftragsannahme) angegeben.
- 納入場所 (Lieferort) — der Ort, an den die Ware geliefert wird. In der japanischen Fertigung kann dies bemerkenswert detailliert sein: „株式会社〇〇 第二工場 第3組立ライン“ (Firma X, Werk 2, Montagelinie 3). Diese Granularität ist für die Produktionsplanung unerlässlich, erzeugt aber lange Zeichenfolgen mit variablem Format, die generische OCR häufig auf mehrere Zellen aufteilt.
Zahlung & Steuer
- 支払条件 (Zahlungsbedingungen) — der Abrechnungszeitplan. Der Standardausdruck ist 締日 (Abrechnungsstichtag) plus ein Zahlungszeitraum. „20日締翌月末払い“ bedeutet, dass der Abrechnungszeitraum am 20. des Monats endet und die Zahlung bis zum Ende des Folgemonats fällig ist. „月末締翌々月末払い“ (Monatsende-Abrechnung, Zahlung bis zum Ende des übernächsten Monats) ist in der Fertigung üblich. Diese Textzeichenfolgen enthalten zwei berechenbare Werte – Abrechnungsstichtag und Zahlungsverzug in Monaten – die ein Mensch auf einen Blick erfasst, eine unstrukturierte Extraktion jedoch zu einer einzigen undifferenzierten Zeichenfolge zusammenfasst.
- 消費税区分 (Verbrauchsteuerklassifizierung) — gibt an, welcher Steuersatz gilt. Japan verwendet ein duales System: 10 % Standardsatz (Standardwaren und -dienstleistungen) und 8 % ermäßigter Satz (Lebensmittel, alkoholfreie Getränke, Abonnementzeitungen). Einige Artikel können steuerbefreit sein (非課税) – Exporttransaktionen, bestimmte medizinische und Bildungsdienstleistungen. Eine Bestellung mit gemischten Steuersätzen auf Positionsebene erzeugt ein Abgleichsproblem: Der Rechnungssteuerbetrag kann nicht mit der Bestellung abgeglichen werden, es sei denn, die Steuerklassifizierung jeder Position bleibt bei der Extraktion erhalten.
Die Muster-Bestellvorlage der JFTC zeigt den vollständigen Satz der Pflichtfelder, wie sie auf einem konformen Dokument erscheinen. Die Schlussfolgerung für die Extraktion: Eine japanische Bestellung ist kein freies Geschäftsschreiben. Es ist ein strukturiertes Dokument mit vorhersagbaren Feldern – aber diese Felder enthalten Inhalte, die von Konventionen bestimmt werden, die für ein Tool, das nicht für den japanischen Beschaffungskontext entwickelt wurde, unsichtbar sind. Die Extraktionsaufgabe ist nicht „dieses Dokument lesen“ – es ist „dieses Dokument lesen und verstehen, was der Abrechnungsstichtag für die Zahlungsberechnung bedeutet.“
Warum sich das Abgleichproblem von 発注書, 納品書 und 請求書 einer einfachen Automatisierung widersetzt
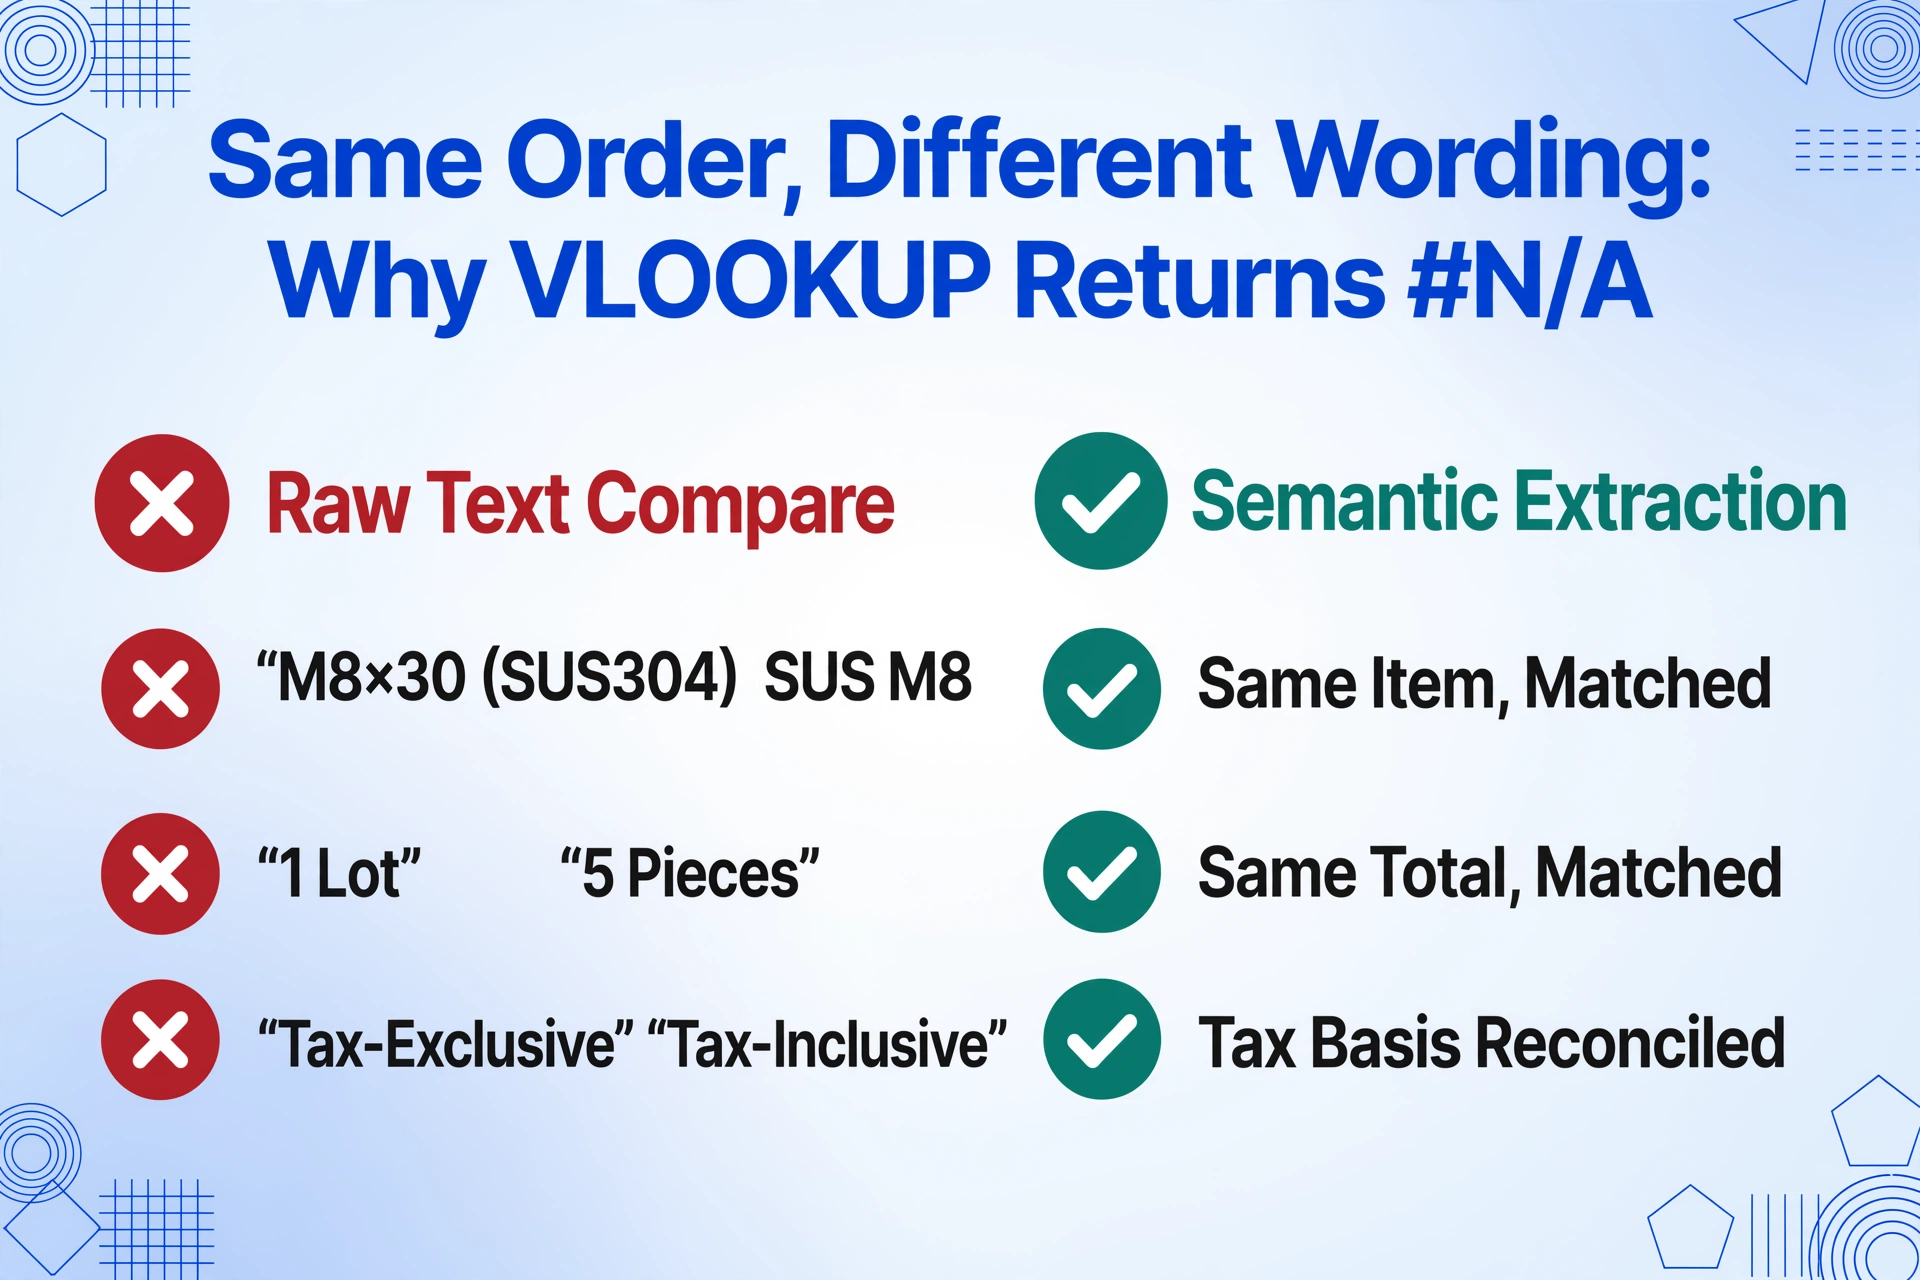
Der Drei-Wege-Abgleich — die Prüfung, ob Bestellung, Lieferschein und Rechnung in Menge, Preis und Konditionen übereinstimmen — ist der Kontrollpunkt, der Überzahlung, Doppelzahlung und Betrug in der japanischen Beschaffung verhindert. Er ist auch der Ort, an dem sich der Engpass der manuellen Datenerfassung konzentriert. Hier ist, warum er sich der naheliegenden „einfach VLOOKUP auf die OCR-Ausgabe“-Lösung widersetzt, die die meisten Teams zuerst ausprobieren.
Die Kernschwierigkeit besteht darin, dass die drei Dokumente dieselbe Transaktion mit unterschiedlichen Textdarstellungen beschreiben. Eine Lieferantenbestellung könnte einen Artikel als „ステンレスボルト M8×30 (SUS304)“ aufführen, während die zugehörige Rechnung ihn zu „SUSボルト M8“ abkürzt — sucht man den einen gegen den anderen, liefert Excel #N/A. Eine Bestellung listet die Menge als „1式“ (ein Los), aber die Rechnung schlüsselt das Los in 5 Stück (個) für dieselbe Gesamtsumme auf — die Mengen stimmen zahlenmäßig nicht überein, repräsentieren aber dieselbe Bestellung. Eine Bestellung zeigt Nettopreise (税抜), die Rechnung Bruttopreise (税込), und ein naiver Vergleich schlussfolgert, dass sich die Preise geändert haben.
Das strukturelle Problem: Japanische Beschaffungsdokumente teilen Daten, verwenden aber unterschiedliche Darstellungen dieser Daten. Ein VLOOKUP oder INDEX-MATCH auf rohen OCR-Text scheitert nicht, weil die Daten fehlen — sondern weil die Darstellungen genau an den Punkten auseinanderdriften, an denen der Abgleich am kritischsten ist: Artikelnamen, Mengen und die steuerliche Behandlung des Einzelpreises.
Hier ändert ein Extraktionsansatz, der die Semantik des Dokuments liest statt Vorlagen abzugleichen, die Gleichung. Wenn Ihr Extraktionsschritt eine Bestellung mit strukturierten Feldern ausgibt — Bestellnummer als Spalte, Artikelname als Spalte, Menge und Einheit in eigenen Spalten, Einzelpreis als Nettobetrag normalisiert — dann wird der Abgleichsschritt gegen einen identisch strukturierten Rechnungsextrakt zu einem einfachen Spaltenvergleich. Die Hauptarbeit verlagert sich von der Tabellenkalkulation (komplexe Multi-Bedingungs-VLOOKUP-Formeln, die brechen, wenn Lieferanten ihre Formatierung ändern) zum Extraktionsschritt (wo die KI die Darstellungen in ein einziges Schema auflöst).
Der Subcontract Act (下請代金支払遅延等防止法) auferlegt zudem eine zeitliche Beschränkung, die die Extraktionsgeschwindigkeit folgenreich macht: Die Zahlung muss innerhalb von 60 Tagen nach Erhalt der Waren oder Dienstleistungen erfolgen (納品日から60日以内). Wenn Extraktion und Abgleich eine Woche aus diesem 60-Tage-Fenster beanspruchen, bleiben dem Beschaffungsteam 53 Tage für alles andere — Genehmigungsrouting, Abweichungsklärung, Zahlungsabwicklung. Die Verkürzung des Extraktionsschritts von Tagen auf Sekunden erweitert direkt den nutzbaren Teil des Compliance-Fensters.
So extrahieren Sie Bestelldaten in Excel – Schritt für Schritt
Der Workflow, der die manuelle Übertragung von Bestellungen in Excel ersetzt, besteht aus drei Phasen. Die erste Phase – das Festlegen, was Sie extrahieren möchten – wird einmal durchgeführt und gilt für jeden Lieferanten, jedes Bestellformat und jede weitere Charge.
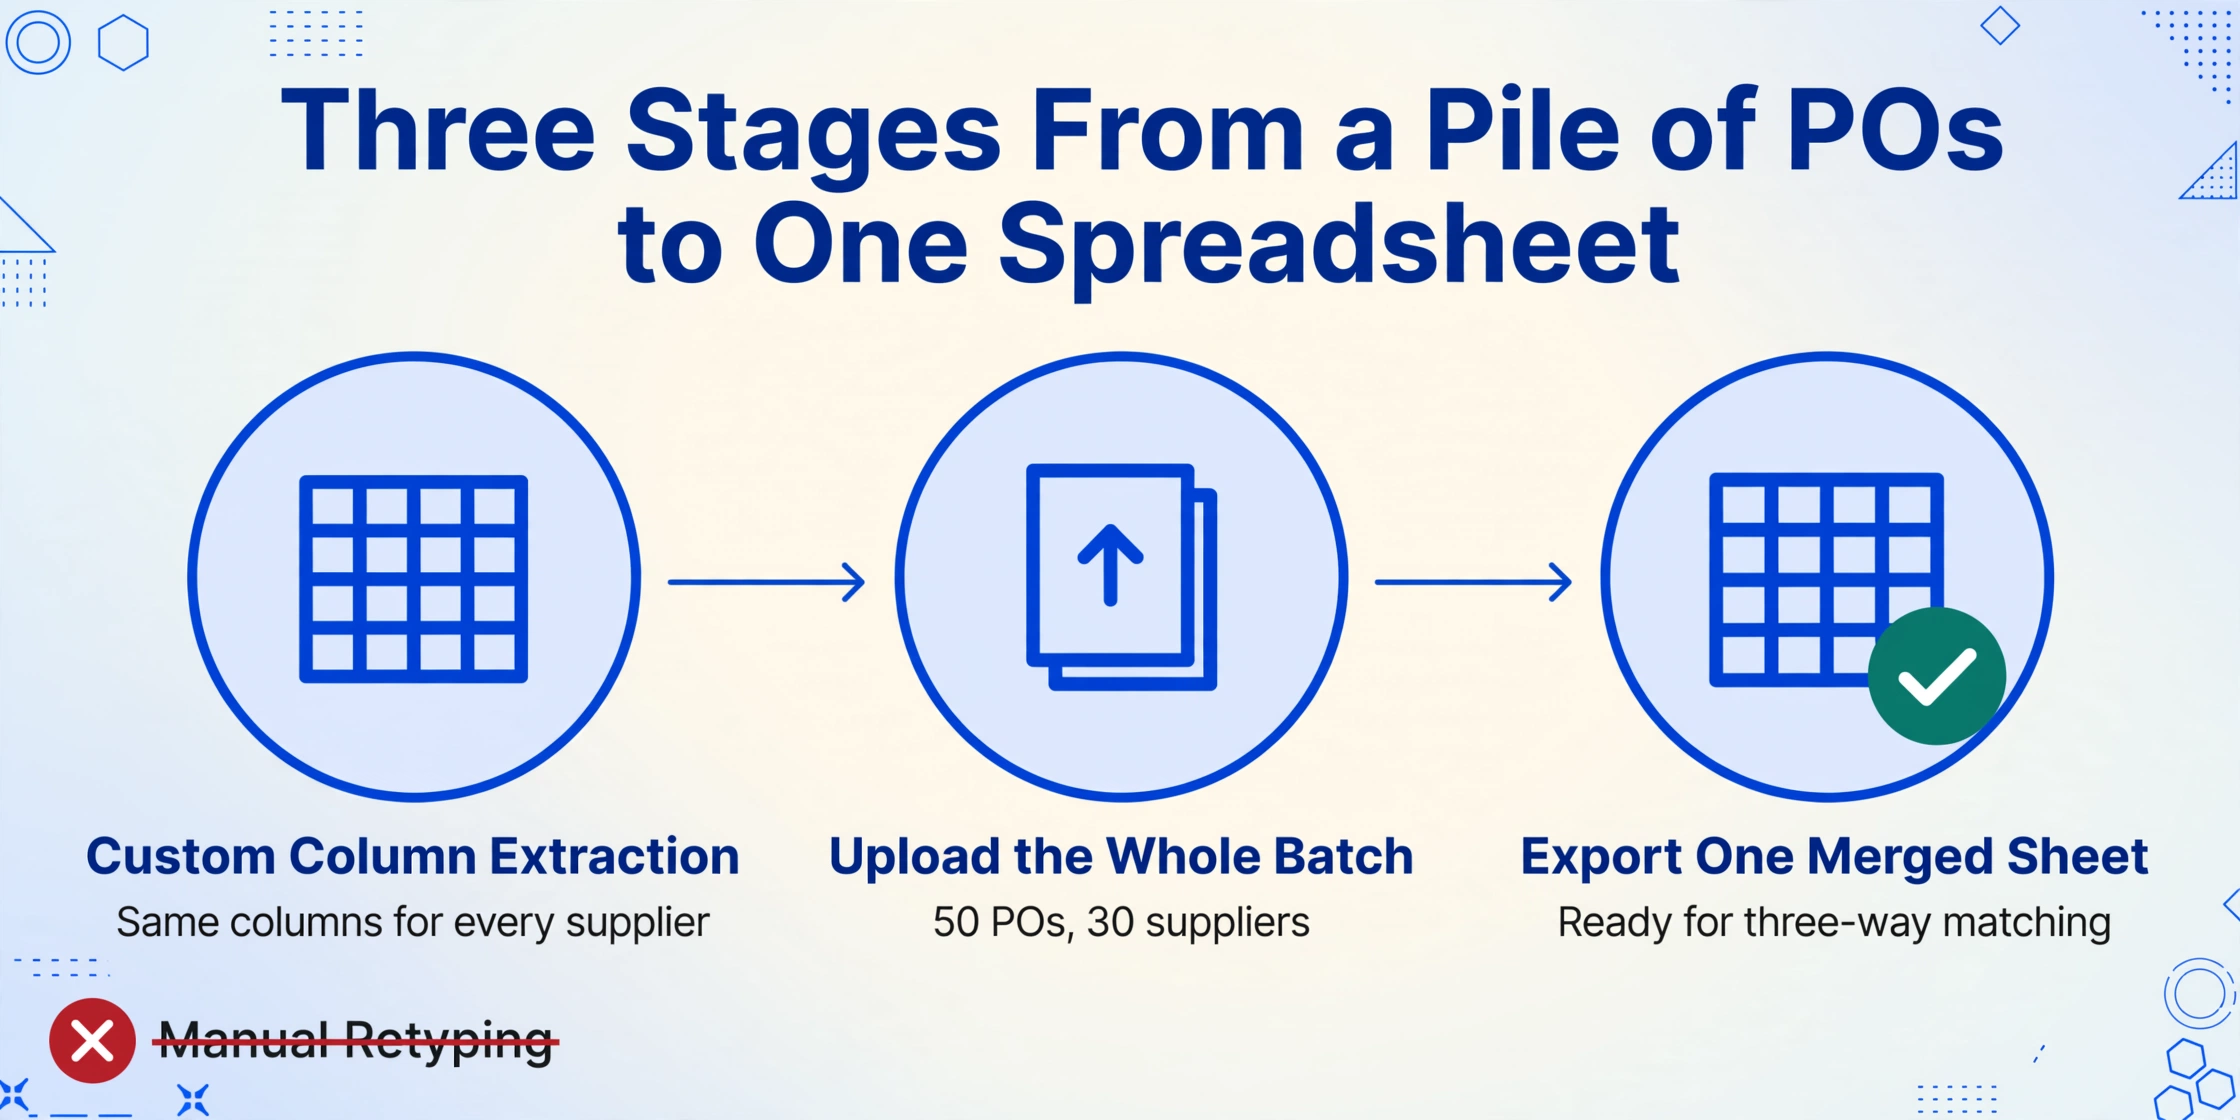
Definieren Sie Ihre Extraktionsspalten einmal – und nutzen Sie sie für alle Lieferanten
Geben Sie die Feldnamen ein, die Sie als Spaltenüberschriften in Ihrer Ausgabetabelle verwenden möchten. Für die Extraktion japanischer Bestellungen ist der praktische Satz: PO-Nummer (発注番号), Bestelldatum (発注日), Lieferant (発注先), Artikelname (品名), Menge (数量), Einheit (単位), Einzelpreis (単価), Positionsbetrag (金額), Liefertermin (納期), Lieferort (納入場所), Zahlungsbedingungen (支払条件), Verbrauchsteuerklassifizierung (消費税区分), Gesamtbetrag (合計金額). Dies nutzt die Benutzerdefinierte Spaltenextraktion: Sie definieren das Ausgabeschema und die KI lokalisiert jedes Feld anhand der semantischen Bedeutung – nicht anhand der Position auf der jeweiligen Lieferanten-Bestellvorlage. Dieselben Spaltennamen funktionieren für Bestellungen von Handelsunternehmen (商社), Herstellern (メーカー) und Dienstleistern, weil die KI liest, was jedes Datenelement bedeutet, nicht wo es gedruckt ist.
Laden Sie alle Bestellungen in einem Batch hoch und lassen Sie die Extraktion laufen
Legen Sie alle Ihre Lieferanten-Bestellungen – Faxausdrucke, E-Mail-PDFs, Smartphone-Fotos von Papierdokumenten – in einen einzigen Upload. Die Batch-Verarbeitung behandelt sie als einen Auftrag: Jede Bestellung wird unabhängig mit Ihrem Spaltenschema verarbeitet, und alle Ergebnisse werden in einer einzigen Tabelle zusammengeführt. Fünfzig Bestellungen von dreißig Lieferanten mit unterschiedlichen Formaten und Layouts werden in einem Durchlauf verarbeitet. Die KI benötigt keine Vorlage pro Lieferant; sie versteht die Dokumentstruktur einer Bestellung – Kopfblock zur Identifikation, Positionstabelle, Fußzeile mit Zahlungsbedingungen und Summen – unabhängig davon, wie ein bestimmter Lieferant diese Elemente anordnet.
Exportieren Sie nach Excel und beginnen Sie mit dem Abgleich gegen Rechnungen
Laden Sie die zusammengeführten Ergebnisse als Excel-Datei (XLSX) herunter. Sie haben nun eine Zeile pro Bestellposition mit jedem Feld in einer eigenen Spalte – bereit für den Import in Ihre Buchhaltungssoftware oder für den VLOOKUP-Abgleich mit Ihrem Rechnungsbuch. Die Tabelle kann direkt in Yayoi (弥生会計), freee, MoneyForward Cloud Accounting (マネーフォワード クラウド会計) oder Kanjo Bugyo (勘定奉行) importiert werden – die Software, die japanische Einkaufs- und Buchhaltungsteams tatsächlich täglich nutzen. Mit Bestelldaten in sauberen Spalten wird der Abgleich zu einem Spalten-zu-Spalten-Vergleich: PO-Nummer aus der Extraktion gegen PO-Nummer im Rechnungsbuch, Positionsbetrag gegen Rechnungsbetrag, Menge gegen gelieferte Menge. Ein Abweichungsbericht statt fünfzig manueller Prüfungen.
Dasselbe Spaltenschema funktioniert im nächsten Monat, für Bestellungen neuer Lieferanten, die Sie anbinden, und für archivierte Bestellungen aus früheren Geschäftsjahren (決算年度), die Sie gesetzlich sieben Jahre lang nach dem Körperschaftsteuergesetz (法人税法) und zwei Jahre lang nach dem Subcontract Act aufbewahren müssen. Ein Lieferant kann sein Bestellformat ändern, wenn er sein ERP-System aktualisiert – die von Ihnen definierten Spaltennamen kümmert das nicht.
Dateien werden sicher verarbeitet und nicht gespeichert.
Die Felder, an denen generische Extraktion scheitert – und wie man sie behandelt
Drei Datenpunkte auf einer japanischen Bestellung widerstehen der automatischen Extraktion mehr als der Rest – nicht weil sie schwer zu lesen sind, sondern weil sie eingebettete Geschäftslogik enthalten, die die Extraktion bewahren statt vereinfachen muss.
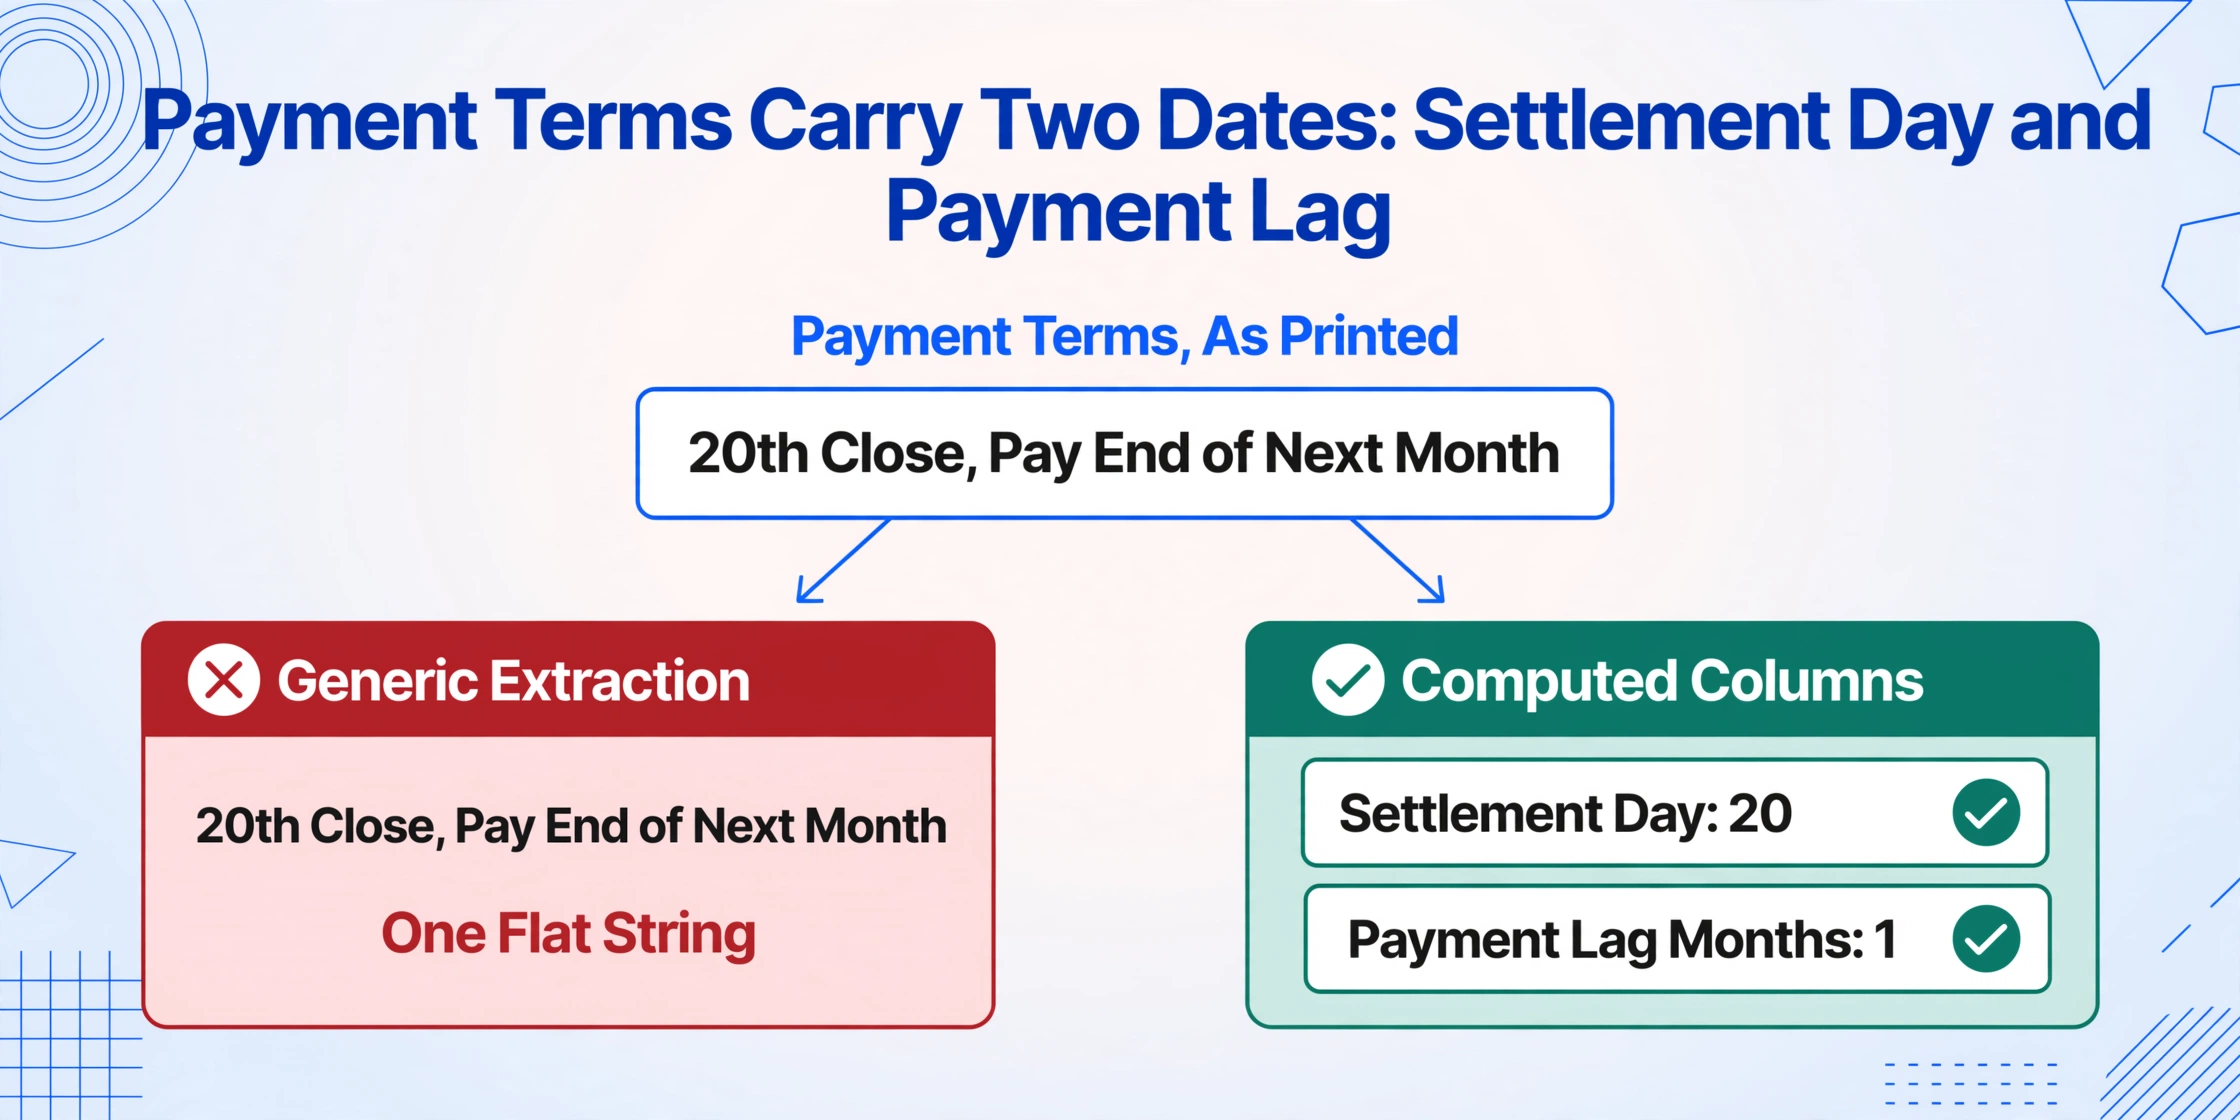
Zahlungsbedingungen (支払条件) — von der Textzeichenfolge bis zum Fälligkeitsdatum
Eine Zahlungsbedingung auf einer japanischen Bestellung ist ein kompakter zusammengesetzter Ausdruck: „20日締翌月末払い“ oder „月末締翌々月末払い“ oder „納品後60日以内.“ Jeder Ausdruck enthält zwei Informationen: wann der Abrechnungszeitraum endet (der 締日, Abrechnungsstichtag) und wann die Zahlung relativ zu diesem Stichtag fällig ist. Ein Einkaufsteam, das Bestellungen mit Rechnungen abgleicht, benötigt beide Informationen in separaten Spalten — den Abrechnungsstichtag, um zu prüfen, ob der Rechnungszeitraum mit der Bestellung übereinstimmt, und die Zahlungsverzögerung, um zu prüfen, ob das Rechnungsfälligkeitsdatum korrekt ist.
Generische Extraktion liefert diese als eine einzige undifferenzierte Textzeichenfolge. Eine berechnete Spalte — eine Spalte, deren Wert die KI während der Extraktion berechnet, statt ihn direkt aus dem Dokument zu lesen — löst dieses Problem. Definieren Sie eine Spalte wie Settlement Day (extract the day number from Payment Terms; if "20日締" then 20, if "月末締" then 31) und eine zweite Spalte wie Payment Lag Months (from Payment Terms; if "翌月末払い" then 1, if "翌々月末払い" then 2). Die KI analysiert die japanische Zahlungsbedingungskonvention und liefert strukturierte Werte, mit denen eine Formel rechnen kann.
Verbrauchsteuerklassifizierung (消費税区分) — Mehrsatz-Abgleich
Japans System der Verbrauchsteuer mit zwei Sätzen bedeutet, dass eine einzelne Bestellung Positionen zu 10 %, 8 % und steuerbefreite Positionen enthalten kann. Die Rechnung muss die Steuer nach Steuersatzkategorie aufschlüsseln, um dem Qualified Invoice System (インボイス制度) zu entsprechen, das im Oktober 2023 in Kraft trat. Wenn die Bestellungsextraktion nicht erhält, welche Positionen zu welchem Satz besteuert werden, kann der Rechnungssteuerbetrag nicht gegen die Bestellung geprüft werden — das Einkaufsteam genehmigt eine Zahlung, ohne die Steuerberechnung bestätigen zu können.
Die Lösung ist eine abgeleitete Spalte — eine Spalte, deren Wert die KI aus dem Kontext ableitet, statt ihn aus einem beschrifteten Feld zu lesen. Definieren Sie Tax Classification (options: 10% Standard, 8% Reduced, Tax-Exempt) — determine from item description. Food/beverage items → 8% Reduced. Standard goods → 10%. Export items or explicitly marked non-taxable → Tax-Exempt. Die KI liest jede Positionsbeschreibung und weist während der Extraktion die korrekte Steuerklassifizierung zu, sodass die Ausgabetabelle bereits mit Steuerkategorien befüllt ankommt — bereit für die satzgruppierte Gesamtprüfung.
Lieferort (納入場所) — granular, variabel, kritisch
Lieferorte auf japanischen Fertigungsbestellungen sind einzigartig spezifisch: „〇〇株式会社 埼玉工場 第二組立課 B棟3階" bezieht sich auf ein bestimmtes Gebäude, eine bestimmte Etage und Abteilung innerhalb eines Werksgeländes. Diese Zeichenfolgen variieren in Länge und Detailgrad je nach Lieferant, werden häufig abgekürzt (埼玉工場 → 埼工) und sind ein Nachschlüssel für die interne Produktionsplanung. Ein beschädigter oder abgeschnittener Lieferort — „〇〇株式会社 埼玉工場 第二組立課 B棟" ohne die Etage — sendet Materialien an den falschen Warenannahme-Dock. Die Extraktion muss die vollständige Zeichenfolge wie gedruckt erhalten, einschließlich Kanji-Zeichen, die von OCR-Engines ohne japanische Sprachmodelle häufig falsch gelesen werden (工場 vs. 工塲, 棟 vs. 楝).
Warum dies für den Abgleich wichtig ist: Diese drei Felder — Zahlungsbedingungen, Steuerklassifizierung, Lieferort — sind nicht dekorativ. Sie sind die Felder, die bestimmen, ob ein abgeglichenes Bestell-Rechnungs-Paar finanziell gültig (Steuer), verfahrenstechnisch korrekt (Zahlungszeitpunkt) und operativ lieferbar (Standort) ist. Eine Extraktion, die sie genau erfasst, ist der Unterschied zwischen einem Abstimmungs-Workflow, der Minuten dauert, und einem, der weiterhin einen Menschen erfordert, der jede Zeile erneut prüft.
Extrahierte Bestelldaten in japanische Buchhaltungssoftware übertragen
Das Ergebnis eines Extraktionsauftrags ist eine Tabellenkalkulation. Das Ziel ist die Buchhaltungs- oder Beschaffungssoftware, in der der Abgleich stattfindet. So verbindet sich die Pipeline mit den Tools, mit denen japanische Unternehmen tatsächlich arbeiten.
Yayoi (弥生会計 / 弥生販売) — der Marktführer in der japanischen KMU-Buchhaltung. Yayois Desktop- und Cloud-Produkte akzeptieren CSV-Importe für Journalbuchungen und Kreditorenbuchhaltungsdaten. Die Spaltenüberschriften Ihrer Extraktion werden zur Feldzuordnung für den Import: Bestellnummer → 伝票番号, Datum → 日付, Lieferant → 仕入先, Betrag → 金額. Yayoi Sales (弥生販売), das Begleitprodukt für Einkaufs- und Bestandsverwaltung, importiert Bestelldaten direkt in sein Einkaufsmodul — eine dedizierte Pipeline, die den Schritt von der Extraktion zum Import auf einen Datei-Upload reduziert.
freee — die Cloud-Buchhaltungsplattform, die von über 70.000 japanischen KMU genutzt wird. freees API und CSV-Import unterstützen die Erfassung von Einkaufstransaktionen mit automatischer Journalbuchungserstellung (自動仕訳). Bestelldaten, die mit Steuerklassifizierung pro Position extrahiert wurden, fließen direkt in freees Verbrauchsteuerberichterstattung ein, die sowohl den Standardsatz von 10 % als auch den ermäßigten Satz von 8 % unterstützt, wie für die Qualified-Invoice-Konformität erforderlich.
MoneyForward Cloud Accounting (マネーフォワード クラウド会計) — freees Hauptkonkurrent mit der größten Anzahl an Finanzinstituts-API-Verbindungen in Japan (2.451+). MoneyForwards Einkaufsverwaltungsmodul akzeptiert CSV-Importe; extrahierte Bestelldaten mit Lieferantennamen und Beträgen füllen das Kreditorenbuch direkt. Die automatische Bankabstimmung der Plattform gleicht extrahierte Zahlungsdatensätze mit Bankfeeds ab — und schließt damit den Kreislauf von der Bestellextraktion bis zur Zahlungsprüfung.
Kanjo Bugyo (勘定奉行) — OBCs Buchhaltungssuite, dominant in mittelgroßen japanischen Unternehmen (Jahresumsatz ¥500M–5B). Kanjo Bugyos Einkaufsmodul unterstützt den Batch-Import von Bestelldaten, mit besonderer Stärke in der abteilungsübergreifenden Kostenzuordnung (部門別原価管理) — wenn Ihre Bestellungen Abteilungscodes oder Kostenstellen enthalten, fließen diese Felder automatisch in die segmentierte GuV-Berichterstattung ein.
Der gemeinsame Nenner: Jede große japanische Buchhaltungsplattform akzeptiert strukturierte Datenimporte. Der Engpass war nie die Importfähigkeit — es war die Gewinnung der Bestelldaten in strukturierter Form. Sobald Sie saubere Excel-Spalten haben, ist der Import ein Datei-Upload oder ein Kopieren-Einfügen.
FAQ
Kann das Tool handschriftliche Bestellungen (発注書) lesen, die per Fax von Lieferanten eingehen?
Ja. Japanische Lieferanten, insbesondere kleinere Hersteller und Handelsunternehmen, faxen häufig handschriftliche oder teilweise handschriftliche Bestellungen – Artikel und Mengen mit Kugelschreiber notiert und mit dem Firmenstempel (社判) versehen. Das KI-Modell liest handschriftliche japanische Zeichen, einschließlich abgekürzter Kanji, die in der Beschaffungskurzschrift üblich sind (㈱ für 株式会社, No. für 番号). Bei stark degradierten Faxen – Papierstruktur, Schräglage, durchschlagende Tinte – kann eine punktuelle Überprüfung schwieriger Zeichen erforderlich sein. Das Scannen mit 300 dpi oder höher verbessert die Genauigkeit bei Faxdokumenten.
Was ist, wenn eine einzelne Bestellung mehrere Seiten umfasst?
Laden Sie alle Seiten der Bestellung in einem Batch hoch. Die Extraktions-Engine behandelt mehrere Seiten derselben Datei als ein fortlaufendes Dokument – die Kopffelder (Bestellnummer, Lieferant, Datum) werden einmal extrahiert, und die Positionen aller Seiten werden im selben Zeilensatz gesammelt. Bei mehrseitigen Fax-Bestellungen, bei denen die Fortsetzungsseite keinen Kopf hat – sondern nur eine Tabelle mit Positionen, die von der vorherigen Seite fortgesetzt wird – bewahrt die Extraktion die Kontinuität, indem alle Positionen der auf der ersten Seite identifizierten Bestellnummer zugeordnet werden.
Funktioniert das Tool, wenn jeder Lieferant ein anderes Bestellformat verwendet?
Ja – das ist der entscheidende Vorteil der semantischen Extraktion gegenüber der vorlagenbasierten OCR. Ein vorlagenbasiertes Tool erfordert, dass Sie für jedes Lieferantenformat eine separate Parsing-Vorlage (mit definierten Zonenkoordinaten oder Feldbezeichnungen) erstellen und pflegen. Wenn ein Lieferant sein Bestelllayout ändert – etwa bei einem Upgrade seines ERP oder einer Neugestaltung seiner Vordrucke – bricht die Vorlage und muss neu erstellt werden. Die semantische Extraktion liest das Dokument, indem sie versteht, was jedes Datenelement ist, nicht wo es auf der Seite erscheint. Eine Bestellnummer ist eine Bestellnummer, egal ob sie oben rechts auf einer Mitsubishi Chemical-Bestellung oder unten mittig auf einer handschriftlichen Fax eines lokalen Subunternehmers steht.
Wie funktioniert die Extraktion bei der Aufteilung der Verbrauchsteuer in 8 % und 10 %?
Das japanische System mit zwei Verbrauchsteuersätzen verlangt, dass Rechnungen die Steuer nach Steuersatzkategorie aufschlüsseln. Wenn Sie bei der Bestellextraktion eine Spalte hinzufügen, die die Logik der Steuerklassifizierung angibt – zum Beispiel Steuersatz (Optionen: 8 %, 10 %, steuerfrei) – Klassifizierung basierend auf Artikelbeschreibung – bewertet die KI jede Position und weist während der Extraktion den korrekten Satz zu. Lebensmittel und Abonnementzeitungen erhalten 8 %; alles andere erhält 10 %; Exporttransaktionen und ausdrücklich befreite Artikel erhalten „Steuerfrei“. Die extrahierten Daten kommen mit bereits zugewiesenen Steuersätzen an, bereit für die nach Steuersatz gruppierte Gesamtberechnung, die der Steueraufschlüsselung der Rechnung entspricht. Dies ist eine abgeleitete Spalte – der Satz ist nicht auf der Bestellung aufgedruckt, sondern wird von der KI während der Extraktion aus der Artikelbeschreibung abgeleitet.
Kann derselbe Workflow auch andere japanische Beschaffungsdokumente verarbeiten?
Der Spaltenschema-Ansatz gilt für die gesamte Beschaffungsdokumentenkette. Für Angebote (見積書): Extrahieren Sie Lieferant, Artikel, Stückpreis und Gültigkeitsdauer – vergleichen Sie diese mit der Bestellung, um zu überprüfen, ob der bestellte Preis dem angebotenen Preis entspricht. Für Lieferscheine (納品書): Extrahieren Sie die gelieferten Mengen – vergleichen Sie diese mit den Bestellmengen, um Minderlieferungen zu identifizieren, bevor die Rechnung eintrifft. Für Rechnungen (請求書): Extrahieren Sie die berechneten Beträge und die Steueraufschlüsselung – vergleichen Sie diese mit den Bestelldaten, um vor der Zahlungsfreigabe zu prüfen. Dieselbe Extraktionsplattform verarbeitet alle vier Dokumenttypen, und dieselbe Spaltenbenennungslogik gilt: Definieren Sie die gewünschten Felder, und die KI findet sie anhand ihrer Bedeutung. Wir behandeln verwandte dokumentenbezogene Workflows in unserem Leitfaden zur Extraktion japanischer Bankbuchdaten, dem australischen BAS-Extraktionsworkflow und der Extraktion kanadischer GST/HST-Steuererklärungsdaten.
Von Papierbestellungen zu abgeglichenen Hauptbüchern
Die japanische Beschaffungsdokumentenkette – Angebot, Bestellung, Lieferschein, Rechnung – wurde für eine Welt entwickelt, in der jedes Dokument von einem Menschen gelesen wurde, der die Konventionen verstand. Die Bestellung sagt „20日締翌月末払い“ und der Mensch weiß, dass das Zahlung bis zum Ende des Monats nach dem 20. des Abrechnungsmonats bedeutet. Die Rechnung kürzt den Artikelnamen ab und der Mensch weiß, dass er sich auf dasselbe Produkt in der Bestellung bezieht. Die Steuerklassifizierung ist in der Artikelbeschreibung implizit enthalten und der Mensch ordnet sie gedanklich zu. Die Reibung bei der Digitalisierung der Beschaffung lag nie darin, dass diesen Dokumenten die Struktur fehlt – sie sind hochstrukturiert –, sondern darin, dass die Struktur vom gemeinsamen Kontext menschlicher Leser abhängt und eine Maschine, die auf diesen Kontext nicht zugreifen kann, die Struktur falsch interpretiert.
Die Bestellextraktion, die die Feldbedeutung statt der Feldposition liest, schließt diese Lücke. Die Bestellnummer wird zu einem Nachschlageschlüssel anstelle eines OCR-Fehlers. Die Zahlungsbedingungen werden zu zwei Spalten – Abrechnungsstichtag und Verzögerung – anstelle einer verstümmelten Zeichenfolge. Die Steuerklassifizierung wird zu einer ausgefüllten Spalte anstelle eines Rätselratens bei der Rechnungsprüfung. Das Beschaffungsteam gewinnt die Zeit zurück, die es derzeit mit dem erneuten Abtippen verbringt, und der Abgleichsworkflow – der Kontrollpunkt, der das Bargeld des Unternehmens schützt – wird schneller und zuverlässiger.