Cómo extraer datos de órdenes de compra japonesas a Excel
para la conciliación de facturas de proveedores
En las adquisiciones B2B japonesas, el rastro documental está prescrito por ley y refinado por décadas de convención industrial: la cotización (見積書, mitsumorisho) conduce a la orden de compra (発注書, hatchūsho), que da lugar al albarán (納品書, nōhinsho), que desencadena la factura (請求書, seikyūsho). Cada documento contiene un subconjunto de datos superpuestos — número de OC, partidas, cantidades, precios unitarios, clasificación fiscal — y la labor del gestor de adquisiciones, mes tras mes, es verificar que lo pedido coincide con lo entregado y con lo facturado. La Ley de Subcontratación de la Comisión de Comercio Justo de Japón (下請代金支払遅延等防止法) exige doce campos específicos en toda OC emitida a subcontratistas, incluidos el lugar de entrega (納入場所), las condiciones de pago (支払条件) con el día de cierre (締日) y la fecha de finalización de la inspección. Cuando cincuenta de estas llegan a su escritorio como impresiones de fax y PDF por correo de treinta proveedores distintos, y cada una debe cotejarse con la factura correspondiente antes de aprobar el pago, el cuello de botella no es la decisión de aprobación — es conseguir que los datos de la OC estén en un formato que una fórmula de búsqueda pueda leer.
Conclusiones clave
- Cincuenta OC de proveedores llegan cada mes, cada una debe coincidir con una factura, y el flujo de trabajo estándar de adquisiciones comienza con alguien reescribiendo los datos en una hoja de cálculo.
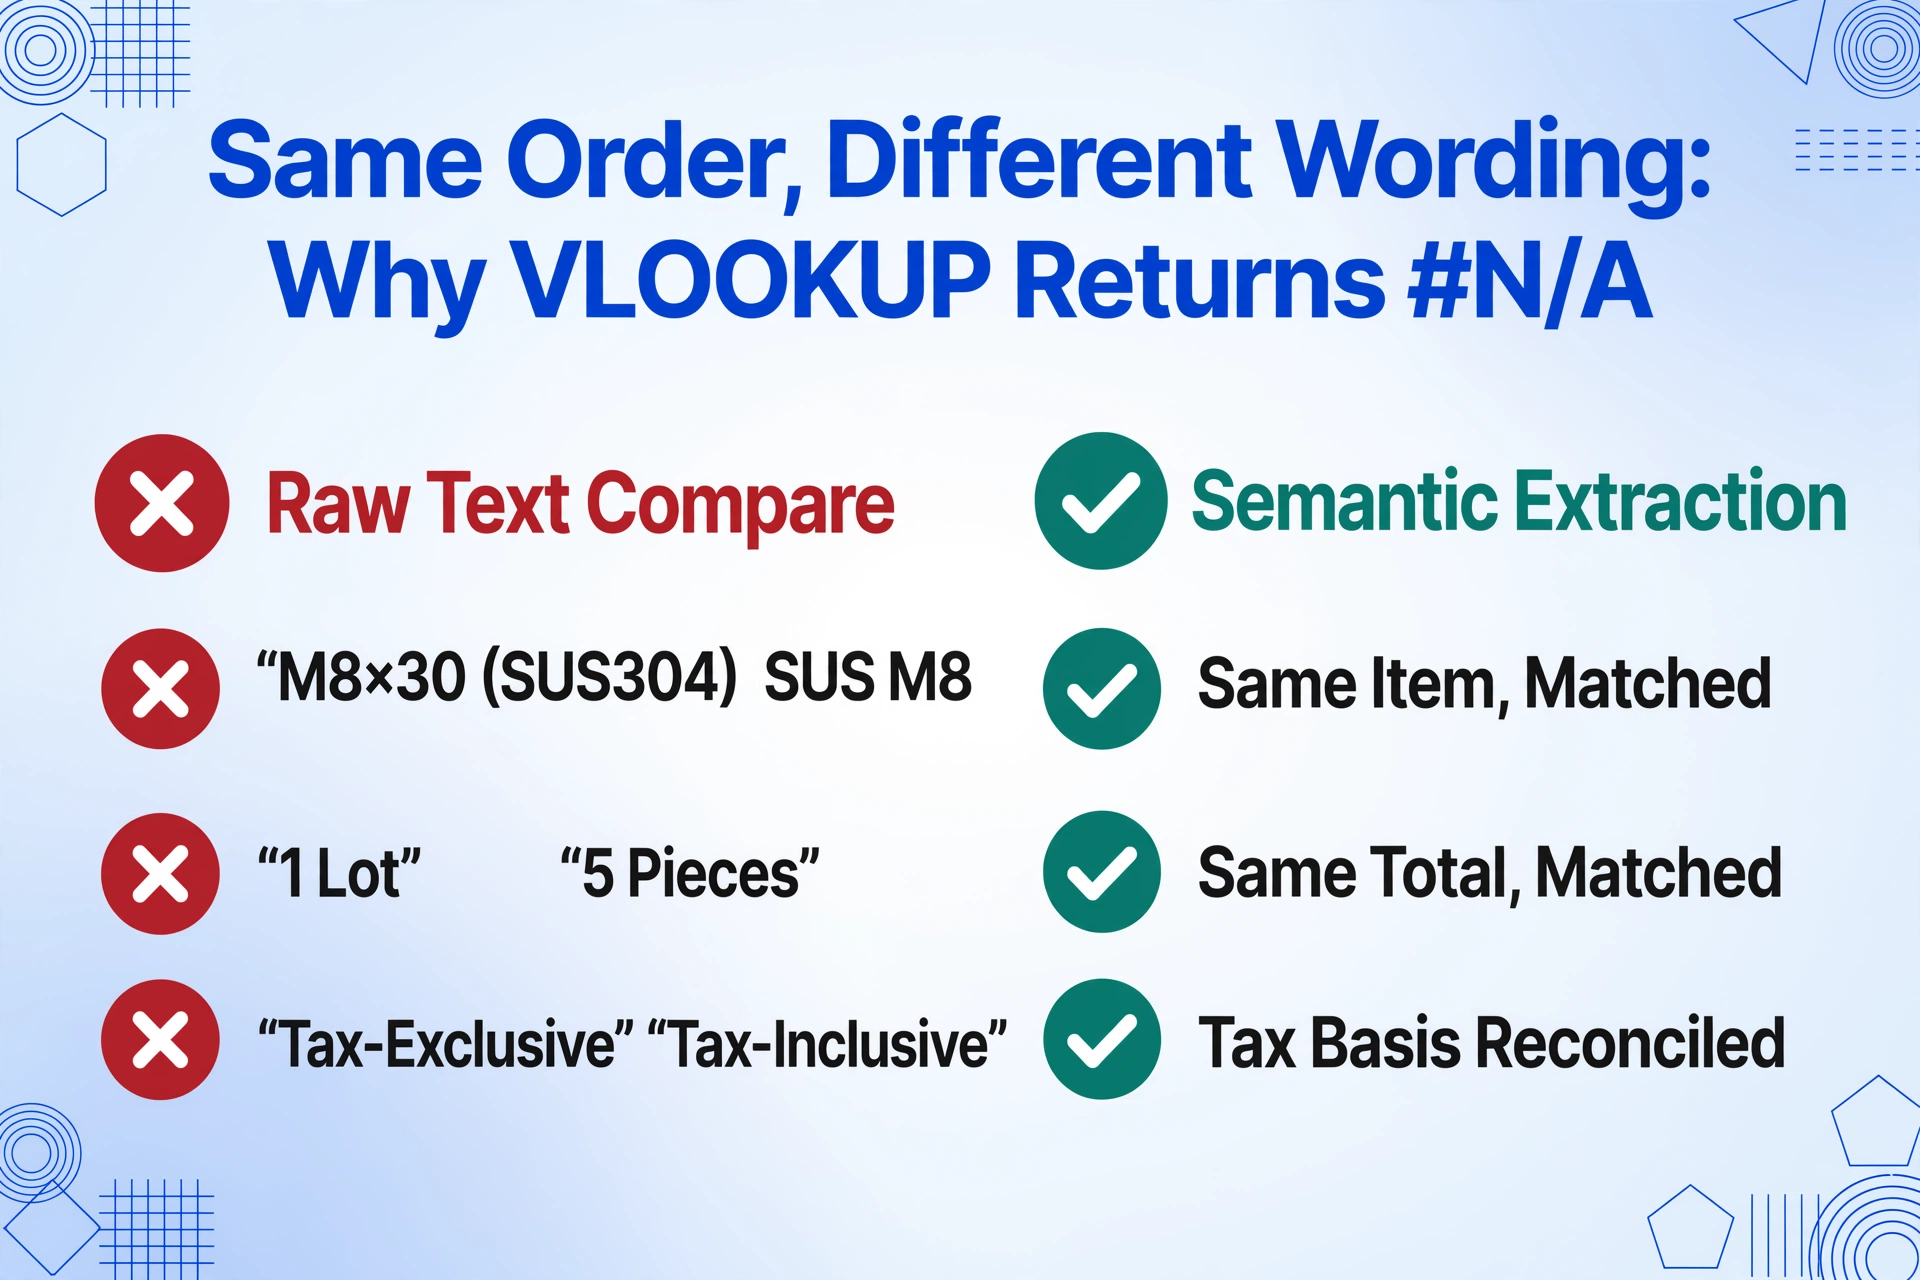
- La OC dice "SUS304 M8×30 bolt", la factura dice "SUS bolt M8" — VLOOKUP devuelve #N/A no porque falten datos, sino porque tres documentos describen la misma transacción con palabras distintas.
- La extracción semántica lee lo que significa cada campo en lugar de dónde está impreso — sus nombres de columna extraen Número de OC y Condiciones de Pago de forma idéntica de una orden de compra de Mitsubishi Chemical y de un fax manuscrito.
Qué contiene una orden de compra japonesa — campo por campo
Las órdenes de compra japonesas siguen una estructura que es a la vez más estandarizada y más matizada que sus contrapartes occidentales. Estandarizada porque los requisitos de campo obligatorios de la JFTC para transacciones de subcontratación — codificados en la Ley de Subcontratación y reforzados por la Ley de Transacciones Justas para Pymes de 2026 (中小受託取引適正化法, o 取適法) — significan que toda orden de compra legalmente conforme contiene la misma información central. Matizada porque el contenido dentro de esos campos refleja convenciones comerciales japonesas que ninguna herramienta de extracción genérica fue entrenada para interpretar.
La JFTC especifica que una orden de compra (formalmente un documento del Artículo 4 según la Ley de 2026) debe contener como mínimo: los nombres de ambas partes, fecha de emisión, descripción de los entregables, fecha de entrega, lugar de entrega, fecha de finalización de la inspección, monto del pago, fecha de vencimiento del pago y método de pago. En la práctica, la mayoría de las órdenes de compra japonesas incluyen campos adicionales que son importantes para el flujo de trabajo de conciliación. Esta es la estructura completa con la que realmente trabaja un gerente de adquisiciones:
Encabezado e identificación
- 発注番号 (N.º de orden de compra) — el identificador único que vincula la orden de compra con su cotización, albarán y factura. Sin él, la conciliación a tres bandas es una adivinanza. La mayoría de las empresas japonesas usan un formato como PO-2026-001. Esta es la clave principal para toda consulta posterior.
- 発注日 (Fecha de pedido) — la fecha de emisión. Se usa como punto de partida para calcular las fechas de vencimiento de pago cuando los plazos se expresan en relación con la entrega (dentro de los 60 días posteriores a la entrega).
- 発注元 (Comprador) — nombre de la empresa, dirección, información de contacto. Debe ser el nombre registrado oficial según la Ley.
- 発注先 (Proveedor) — el vendedor que recibe el pedido. Nombre de la empresa según el registro.
Partidas y precios
- 品名 (Nombre del artículo) — descripción del producto o servicio. A menudo incluye números de pieza (品番) o códigos de especificación que un proveedor abrevia de manera diferente a como aparecen en la factura — una fuente conocida de fallos en BUSCARV.
- 数量 (Cantidad) — con unidad (単位): 個 (piezas), 式 (lote/juego), kg, m, hora (時間). Las discrepancias de unidad entre la orden de compra y la factura — la orden de compra dice 式, la factura dice 個 — son un dolor de cabeza común en la conciliación.
- 単価 (Precio unitario) — normalmente sin impuestos (税抜). La factura puede mostrar precios con impuestos incluidos; si la comparación se hace sin normalizar el tratamiento fiscal, cada línea parecerá no coincidir.
- 金額 (Importe) — total de la línea = cantidad × precio unitario. Generalmente se muestra sin impuestos.
Logística y Entrega
- 納期 (Fecha de entrega) — la fecha o ventana en la que la mercancía debe llegar. A menudo se expresa como una fecha específica (2026年8月15日) o una ventana relativa (受注後30日以内 — dentro de los 30 días posteriores a la aceptación del pedido).
- 納入場所 (Lugar de entrega) — dónde se entrega la mercancía. En la fabricación japonesa, esto puede ser notablemente específico: "株式会社〇〇 第二工場 第3組立ライン" (Compañía X, Fábrica 2, Línea de Ensamblaje 3). Este nivel de detalle es esencial para la planificación de la producción, pero produce cadenas largas y de formato variable que el OCR genérico fragmenta con frecuencia en varias celdas.
Pago e Impuestos
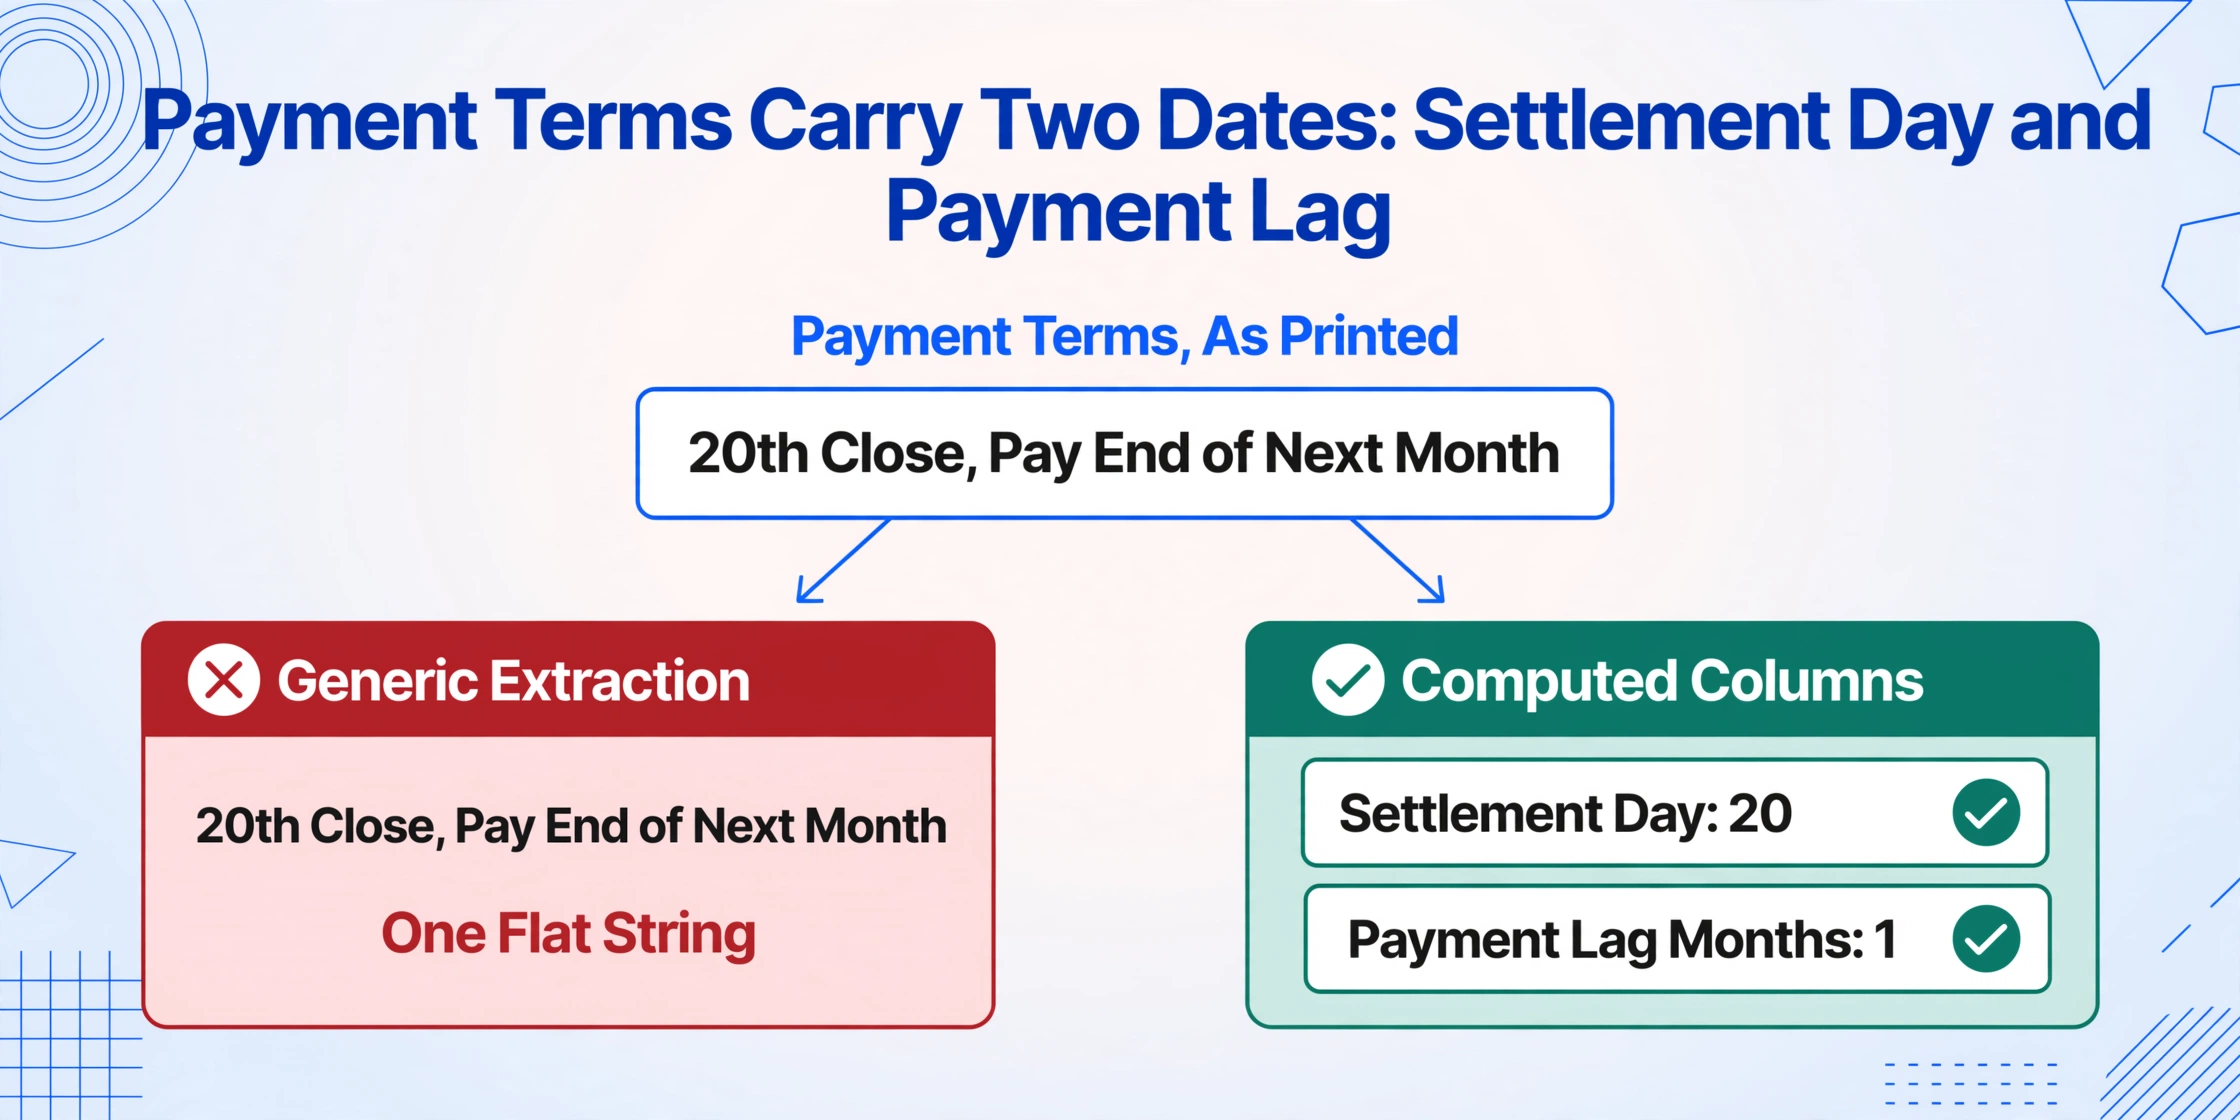
- 支払条件 (Condiciones de pago) — el calendario de liquidación. La expresión estándar es 締日 (día de cierre) más un plazo de pago. "20日締翌月末払い" significa que el período de facturación cierra el día 20 del mes y el pago vence a finales del mes siguiente. "月末締翌々月末払い" (cierre a fin de mes, pago a fin del mes siguiente al siguiente) es común en la fabricación. Estas cadenas de texto contienen dos valores calculables — el día de cierre y el retraso del pago en meses — que una persona lee de un vistazo, pero una extracción no estructurada aplana en una sola cadena indiferenciada.
- 消費税区分 (Clasificación del impuesto al consumo) — indica qué tasa impositiva se aplica. Japón utiliza un sistema de tasa dual: 10% tasa estándar (bienes y servicios estándar) y 8% tasa reducida (alimentos, bebidas no alcohólicas, periódicos por suscripción). Algunos artículos pueden estar exentos de impuestos (非課税) — transacciones de exportación, ciertos servicios médicos y educativos. Una orden de compra con artículos de tasa mixta crea un problema de conciliación: el total del impuesto de la factura no se puede verificar contra la orden de compra a menos que la clasificación impositiva de cada línea se conserve durante la extracción.
La plantilla de orden de compra de muestra de la JFTC muestra el conjunto completo de campos obligatorios tal como aparecen en un documento conforme. La conclusión para la extracción: una orden de compra japonesa no es una carta comercial de formato libre. Es un documento estructurado con campos predecibles, pero esos campos contienen contenido regido por convenciones que son invisibles para una herramienta que no fue diseñada para el contexto de adquisiciones japonés. La tarea de extracción no es "leer este documento" — es "leer este documento y entender qué significa el día de cierre para el cálculo del pago".
Por qué el problema de conciliación entre 発注書, 納品書 y 請求書 resiste la automatización simple
El flujo de conciliación triple —verificar que la orden de compra, el albarán y la factura coincidan en cantidad, precio y condiciones— es el punto de control que previene pagos excesivos, pagos duplicados y fraude en las adquisiciones japonesas. También es donde se concentra el cuello de botella de la entrada manual de datos. He aquí por qué resiste la solución obvia de "simplemente hacer un VLOOKUP de la salida del OCR" que la mayoría de los equipos intentan primero.
La dificultad central es que los tres documentos describen la misma transacción utilizando representaciones textuales diferentes. La orden de compra de un proveedor puede listar un artículo como "ステンレスボルト M8×30 (SUS304)", mientras que la factura correspondiente lo abrevia como "SUSボルト M8" — si se busca uno contra el otro, Excel devuelve #N/A. Una orden de compra indica la cantidad como "1式" (un lote), pero la factura desglosa el lote en 5 piezas (個) por el mismo total — las cantidades no coinciden numéricamente, pero representan el mismo pedido. Una orden de compra muestra precios unitarios sin impuestos (税抜), la factura los muestra con impuestos incluidos (税込), y una comparación ingenua concluye que los precios han cambiado.
El problema estructural: Los documentos de adquisición japoneses comparten datos, pero utilizan representaciones diferentes de esos datos. Un VLOOKUP o INDEX-MATCH sobre texto OCR crudo falla no porque falten los datos, sino porque las representaciones divergen exactamente en los puntos donde la conciliación es más crítica: nombres de artículos, cantidades y tratamiento fiscal del precio unitario.
Aquí es donde un enfoque de extracción que lee la semántica del documento en lugar de hacer coincidir plantillas cambia la ecuación. Si su paso de extracción genera una orden de compra con campos estructurados —número de orden como columna, nombre del artículo como columna, cantidad y unidad separadas en sus propias columnas, precio unitario normalizado sin impuestos— entonces el paso de conciliación contra una extracción de factura estructurada de manera idéntica se convierte en una comparación de columnas sencilla. El trabajo pesado se traslada de la hoja de cálculo (fórmulas VLOOKUP complejas de múltiples condiciones que se rompen cuando los proveedores cambian su formato) al paso de extracción (donde la IA resuelve las representaciones en un único esquema).
La Ley de Subcontratación también impone una restricción de tiempo que hace que la velocidad de extracción sea relevante: el pago debe realizarse dentro de los 60 días posteriores a la recepción de los bienes o servicios (納品日から60日以内). Si la extracción y la conciliación consumen una semana de esa ventana de 60 días, el equipo de adquisiciones tiene 53 días para todo lo demás —aprobaciones, resolución de discrepancias, procesamiento de pagos—. Reducir el paso de extracción de días a segundos expande directamente la porción utilizable de la ventana de cumplimiento.
Cómo extraer datos de órdenes de compra a Excel — Paso a paso
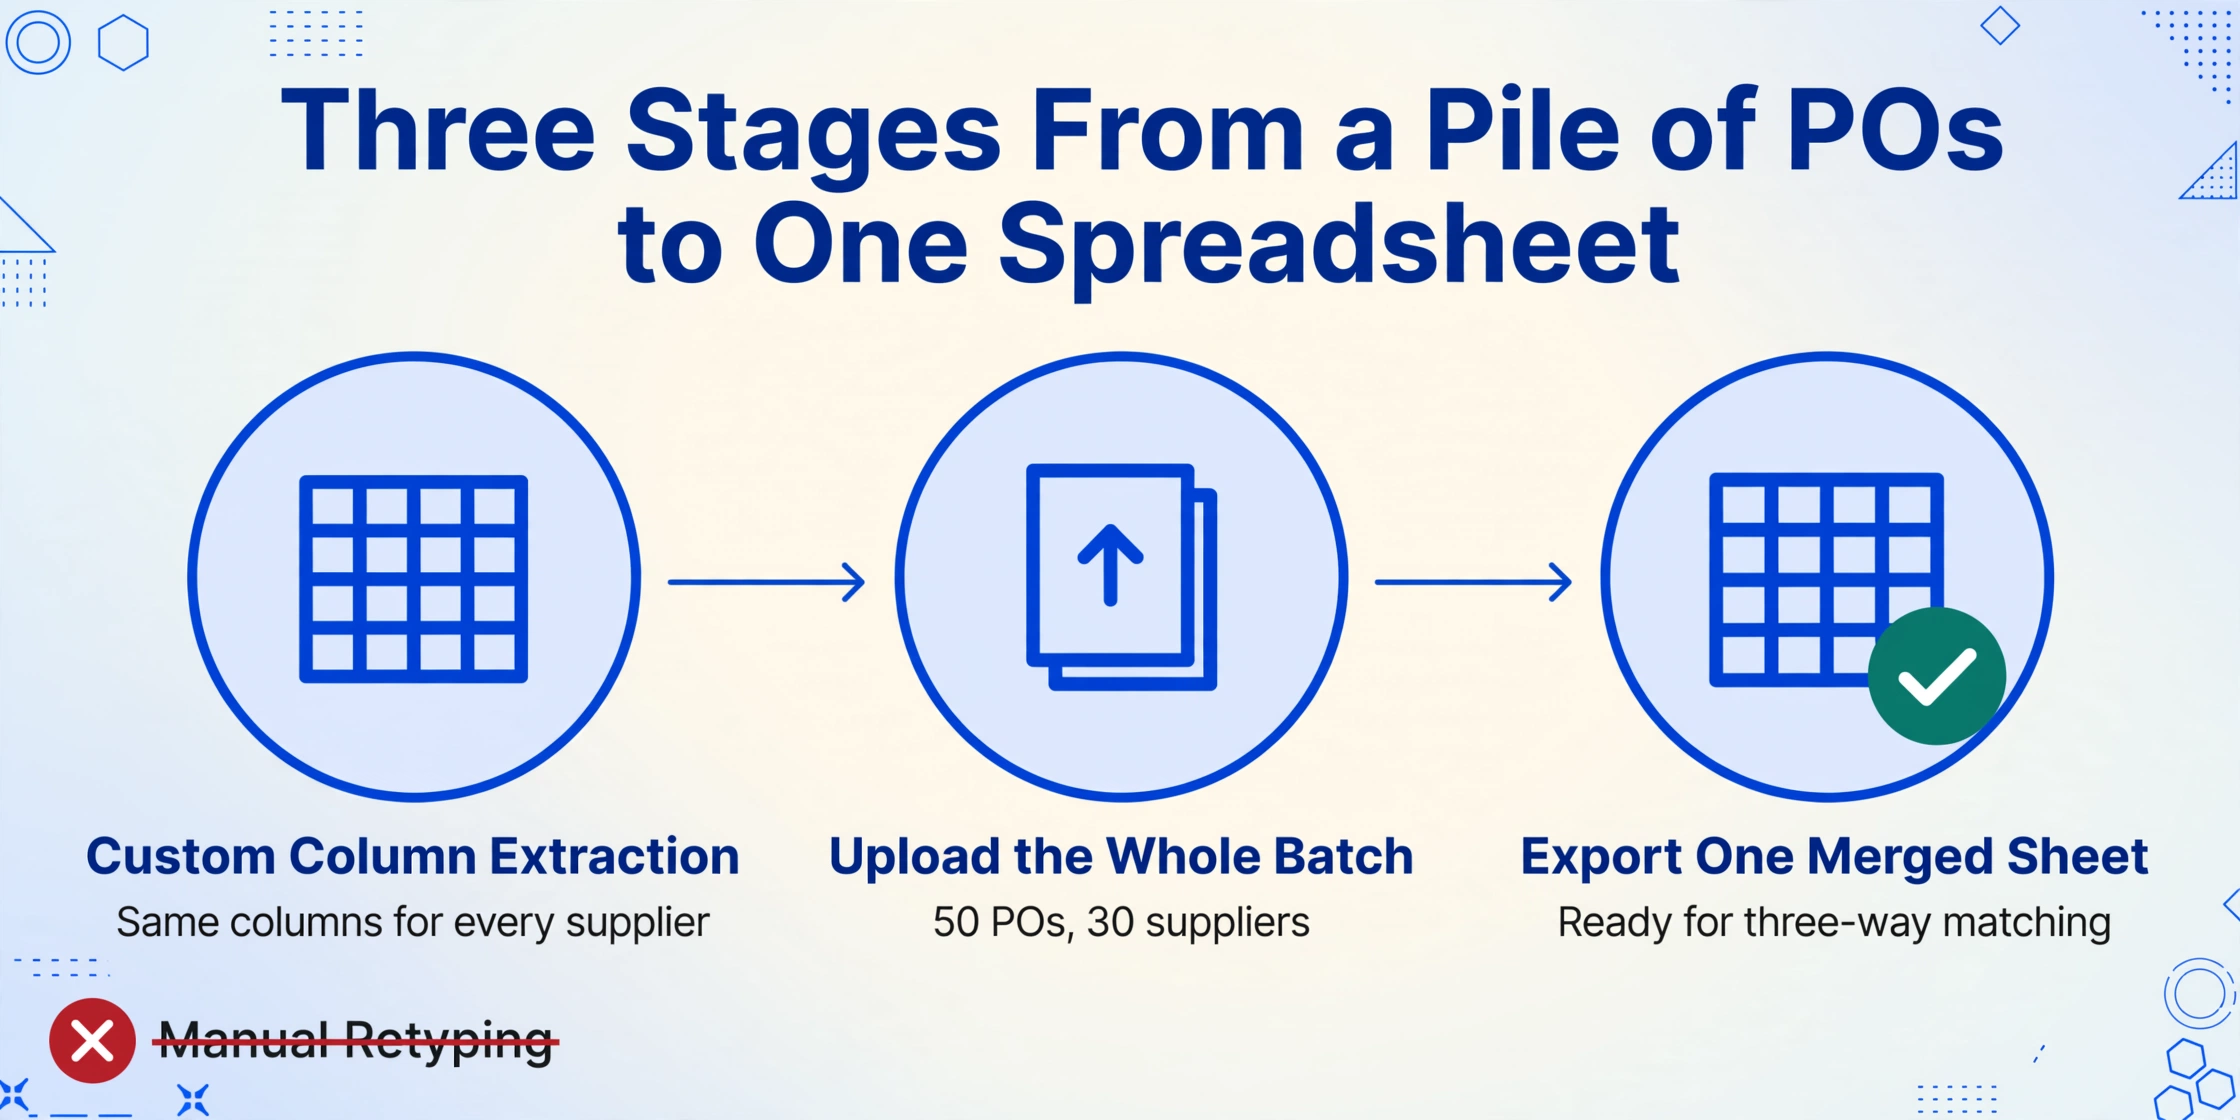
El flujo de trabajo que reemplaza la transcripción manual de órdenes de compra a Excel consta de tres etapas. La primera etapa — definir qué desea extraer — se realiza una sola vez y se aplica a cada proveedor, cada formato de orden de compra y cada lote posterior.
Defina sus columnas de extracción una sola vez — reutilícelas con todos los proveedores
Escriba los nombres de los campos que desea como encabezados de columna en su hoja de cálculo de salida. Para la extracción de órdenes de compra japonesas, el conjunto práctico es: N.º de OC (発注番号), Fecha de la OC (発注日), Proveedor (発注先), Nombre del artículo (品名), Cantidad (数量), Unidad (単位), Precio unitario (単価), Importe por línea (金額), Fecha de entrega (納期), Lugar de entrega (納入場所), Condiciones de pago (支払条件), Clasificación del impuesto al consumo (消費税区分), Importe total (合計金額). Esto utiliza la Extracción de Columnas Personalizadas: usted define el esquema de salida y la IA localiza cada campo por su significado semántico, no por su posición en la plantilla de OC de un proveedor concreto. Los mismos nombres de columna funcionan con OC de empresas comerciales (商社), fabricantes (メーカー) y proveedores de servicios, porque la IA lee lo que cada dato significa, no dónde está impreso.
Sube todas las OC en un solo lote y deja que la extracción se ejecute
Cargue todas las OC de sus proveedores — impresiones de fax, PDF por correo electrónico, fotos de documentos en papel tomadas con el teléfono — en una sola subida. El procesamiento por lotes las gestiona como un único trabajo: cada OC se procesa de forma independiente con su esquema de columnas aplicado, y todos los resultados se fusionan en una sola hoja de cálculo. Cincuenta OC de treinta proveedores con formatos y diseños diferentes se procesan en una sola ejecución. La IA no necesita una plantilla por proveedor; comprende la estructura documental de una orden de compra — bloque de identificación de cabecera, tabla de líneas de artículo, pie con condiciones de pago y totales — independientemente de cómo un proveedor concreto disponga esos elementos.
Exporte a Excel y comience a cotejar contra las facturas
Descargue los resultados fusionados como archivo de Excel (XLSX). Ahora tiene una fila por línea de artículo de OC con cada campo en su propia columna — listo para importar en su software de contabilidad o para el cotejo con BUSCARV contra su libro de facturas. La hoja de cálculo puede importarse directamente en Yayoi (弥生会計), freee, MoneyForward Cloud Accounting (マネーフォワード クラウド会計) o Kanjo Bugyo (勘定奉行) — el software que los equipos japoneses de compras y contabilidad utilizan realmente a diario. Con los datos de las OC estructurados en columnas limpias, el paso de cotejo se convierte en una comparación columna a columna: el N.º de OC de la extracción contra el N.º de OC en el libro de facturas, el Importe por línea contra el importe facturado, la Cantidad contra la cantidad entregada. Un informe de discrepancias en lugar de cincuenta comprobaciones manuales.
El mismo esquema de columnas funciona el mes que viene, y para las OC de nuevos proveedores que incorpore, y para las OC archivadas de ejercicios fiscales anteriores (決算年度) que está legalmente obligado a conservar durante siete años según la Ley del Impuesto sobre Sociedades (法人税法) y dos años según la Ley de Subcontratación. Un proveedor puede cambiar el formato de su OC cuando actualice su ERP — los nombres de columna que usted definió no se ven afectados.
Los archivos se procesan de forma segura y no se almacenan.
Los campos donde la extracción genérica falla — y cómo manejarlos
Tres datos en una orden de compra japonesa resisten la extracción automática más que el resto — no porque sean difíciles de leer, sino porque contienen lógica de negocio integrada que la extracción debe preservar en lugar de simplificar.
Condiciones de Pago (支払条件) — de la cadena de texto a la fecha de liquidación
Una condición de pago en una orden de compra japonesa se presenta como una expresión compuesta compacta: "20日締翌月末払い" o "月末締翌々月末払い" o "納品後60日以内." Cada una codifica dos datos: cuándo cierra el período de facturación (el 締日, o día de cierre) y cuándo vence el pago en relación con ese cierre. Un equipo de adquisiciones que compara órdenes de compra con facturas necesita ambos datos en columnas separadas — el día de cierre para verificar que el período de facturación de la factura coincide con la orden de compra, y el desfase de pago para verificar que la fecha de vencimiento de la factura sea correcta.
La extracción genérica produce estos datos como una única cadena de texto indiferenciada. Una columna calculada — una columna cuyo valor la IA calcula durante la extracción en lugar de leerlo directamente del documento — resuelve este problema. Defina una columna como Día de Cierre (extraer el número del día de las Condiciones de Pago; si "20日締" entonces 20, si "月末締" entonces 31) y una segunda columna como Meses de Desfase de Pago (de las Condiciones de Pago; si "翌月末払い" entonces 1, si "翌々月末払い" entonces 2). La IA analiza la convención japonesa de condiciones de pago y genera valores estructurados sobre los que una fórmula puede calcular.
Clasificación del Impuesto al Consumo (消費税区分) — conciliación de múltiples tasas
El sistema japonés de impuesto al consumo de tasa dual significa que una sola orden de compra puede contener partidas al 10%, al 8% y exentas. La factura debe desglosar el impuesto por categoría de tasa para cumplir con el Sistema de Factura Cualificada (インボイス制度) que entró en vigor en octubre de 2023. Si la extracción de la orden de compra no conserva qué partidas están gravadas a qué tasa, el total de impuestos de la factura no puede verificarse contra la orden de compra — el equipo de adquisiciones estaría aprobando un pago sin poder confirmar el cálculo del impuesto.
La solución es una columna inferida — una columna cuyo valor la IA infiere del contexto en lugar de leerlo de un campo etiquetado. Defina Clasificación del Impuesto (opciones: 10% Estándar, 8% Reducido, Exento) — determinar a partir de la descripción del artículo. Artículos de alimentación y bebidas → 8% Reducido. Bienes estándar → 10%. Artículos de exportación o marcados explícitamente como no gravables → Exento. La IA lee la descripción de cada partida y asigna la clasificación fiscal correcta durante la extracción, de modo que la hoja de cálculo resultante llegue con las categorías fiscales ya completadas — lista para la verificación de totales agrupados por tasa.
Lugar de Entrega (納入場所) — detallado, variable, crítico
Los lugares de entrega en las órdenes de compra de fabricación japonesas son específicos: "〇〇株式会社 埼玉工場 第二組立課 B棟3階" hace referencia a un edificio, piso y departamento concretos dentro de un complejo fabril. Estas cadenas varían en longitud y detalle entre proveedores, se abrevian con frecuencia (埼玉工場 → 埼工) y son una clave de consulta para la programación interna de producción. Un lugar de entrega corrupto o truncado — "〇〇株式会社 埼玉工場 第二組立課 B棟" sin el piso — envía los materiales al muelle de recepción equivocado. La extracción debe conservar la cadena completa tal como está impresa, incluidos los caracteres kanji que los motores de OCR sin modelos de idioma japonés suelen leer mal (工場 vs 工塲, 棟 vs 楝).
Por qué esto importa para la conciliación: Estos tres campos — condiciones de pago, clasificación del impuesto al consumo y lugar de entrega — no son decorativos. Son los campos que determinan si un par orden de compra-factura conciliado es financieramente válido, procesalmente correcto (calendario de pagos) y operativamente entregable (ubicación). Una extracción que los capture con precisión es la diferencia entre un flujo de conciliación que toma minutos y uno que aún requiere que una persona revise cada línea.
Cómo Llevar los Datos Extraídos de la Orden de Compra al Software de Contabilidad Japonés
El resultado de un trabajo de extracción es una hoja de cálculo. El destino es el software de contabilidad o adquisiciones donde ocurre la conciliación. Así es como el flujo se conecta con las herramientas que las empresas japonesas realmente utilizan.
Yayoi (弥生会計 / 弥生販売) — el líder en participación de mercado en la contabilidad de pymes japonesas. Los productos de escritorio y en la nube de Yayoi aceptan importaciones CSV para asientos de diario y datos del libro mayor de compras. Los encabezados de columna de su extracción se convierten en el mapeo de campos para la importación: Número de OC → 伝票番号, Fecha → 日付, Proveedor → 仕入先, Monto → 金額. Yayoi Sales (弥生販売), el producto complementario para la gestión de compras e inventario, importa datos de órdenes de compra directamente a su módulo de adquisiciones — un flujo dedicado que reduce el paso de extracción a importación a una carga de archivo.
freee — la plataforma de contabilidad en la nube utilizada por más de 70,000 pymes japonesas. La API y la importación CSV de freee admiten el registro de transacciones de compra con generación automática de asientos de diario (自動仕訳). Los datos de la orden de compra extraídos con la clasificación del impuesto al consumo por línea de artículo alimentan directamente el informe del impuesto al consumo de freee, que admite los cálculos de la tasa estándar del 10% y la tasa reducida del 8% requeridos para el cumplimiento del Sistema de Factura Cualificada.
MoneyForward Cloud Accounting (マネーフォワード クラウド会計) — el principal competidor de freee, con la mayor cantidad de conexiones API con instituciones financieras en Japón (más de 2,451). El módulo de gestión de compras de MoneyForward acepta importaciones CSV; los datos extraídos de la orden de compra con nombres de proveedores y montos pueblan el libro mayor de compras directamente. La conciliación bancaria automática de la plataforma compara los registros de pago extraídos con los extractos bancarios — cerrando el ciclo desde la extracción de la orden de compra hasta la verificación del pago.
Kanjo Bugyo (勘定奉行) — el paquete contable de OBC, dominante en empresas japonesas medianas (ingresos anuales de ¥500M–5B). El módulo de adquisiciones de Kanjo Bugyo admite la importación por lotes de datos de órdenes de compra, con una fortaleza particular en la asignación de costos por departamento (部門別原価管理) — si sus órdenes de compra incluyen códigos de departamento o centros de costos, esos campos fluyen automáticamente a los informes segmentados de pérdidas y ganancias.
El hilo común: toda plataforma contable japonesa importante acepta importaciones de datos estructurados. El cuello de botella nunca ha sido la capacidad de importación — ha sido obtener los datos de la orden de compra en formato estructurado en primer lugar. Una vez que tiene columnas de Excel limpias, la importación es una carga de archivo o un copiar y pegar.
Preguntas Frecuentes
¿Puede leer órdenes de compra manuscritas enviadas por fax desde proveedores?
Sí. Los proveedores japoneses, en particular los fabricantes pequeños y las empresas comerciales, envían con frecuencia por fax órdenes de compra manuscritas o parcialmente manuscritas: artículos y cantidades escritos con bolígrafo y sellados con el sello de la empresa (社判). El modelo de IA lee caracteres japoneses manuscritos, incluidos kanji abreviados comunes en la jerga de adquisiciones (㈱ para 株式会社, No. para 番号). En el caso de faxes muy degradados (grano del papel, inclinación, traspaso de tinta), es posible que sea necesario verificar caracteres difíciles. Escanear a 300 ppp o más mejora la precisión en documentos de origen de fax.
¿Qué sucede si una sola orden de compra abarca varias páginas?
Cargue todas las páginas de la orden de compra en un solo lote. El motor de extracción trata varias páginas del mismo archivo como un documento continuo: los campos de encabezado (número de orden de compra, proveedor, fecha) se extraen una vez, y las líneas de detalle de todas las páginas se recopilan en el mismo conjunto de filas. Para órdenes de compra por fax de varias páginas donde la página de continuación no tiene encabezado (solo una tabla de líneas de detalle que continúa de la página anterior), la extracción preserva la continuidad asociando todos los artículos con el número de orden de compra identificado en la primera página.
¿Funciona si cada proveedor utiliza un formato de orden de compra diferente?
Sí: esta es la ventaja definitiva de la extracción semántica sobre el OCR basado en plantillas. Una herramienta basada en plantillas requiere que usted cree y mantenga una plantilla de análisis separada (que defina coordenadas de zona o etiquetas de campo) para el formato de cada proveedor. Cuando un proveedor cambia el diseño de su orden de compra (como sucede cuando actualiza su ERP o rediseña su papelería), la plantilla se rompe y debe reconstruirse. La extracción semántica lee el documento comprendiendo qué es cada dato, no dónde aparece en la página. Un número de orden de compra es un número de orden de compra, ya sea que esté impreso en la parte superior derecha de una orden de compra de Mitsubishi Chemical o en el centro inferior de un fax manuscrito de un subcontratista local.
¿Cómo maneja la extracción la división del impuesto al consumo del 8% y el 10%?
El sistema de impuesto al consumo de tasa dual de Japón exige que las facturas detallen el impuesto por categoría de tasa. Para la extracción de órdenes de compra, si agrega una columna que especifique la lógica de clasificación del impuesto — por ejemplo, Tasa de impuesto (opciones: 8%, 10%, Exento) — clasificar según la descripción del artículo — la IA evalúa cada línea de artículo y asigna la tasa correcta durante la extracción. Los alimentos y los periódicos por suscripción obtienen el 8%; todo lo demás, el 10%; las transacciones de exportación y los artículos explícitamente exentos obtienen "Exento". Los datos extraídos llegan con las tasas impositivas ya asignadas, listos para el cálculo del total agrupado por tasa que coincide con el desglose de impuestos de la factura. Esta es una columna inferida: la tasa no está impresa en la OC, sino que la IA la deduce de la descripción del artículo durante la extracción.
¿Puede el mismo flujo de trabajo manejar otros documentos de adquisiciones japoneses?
El enfoque del esquema de columnas se aplica a toda la cadena de documentos de adquisiciones. Para las cotizaciones (見積書): extraiga proveedor, artículo, precio unitario y período de validez — compárelos con la OC para verificar que el precio solicitado coincida con el cotizado. Para los albaranes (納品書): extraiga las cantidades entregadas — compárelas con las cantidades de la OC para identificar envíos incompletos antes de que llegue la factura. Para las facturas (請求書): extraiga los montos facturados y el desglose de impuestos — compárelos con los datos de la OC para verificar antes de aprobar el pago. La misma plataforma de extracción maneja los cuatro tipos de documentos, y se aplica la misma lógica de nomenclatura de columnas: defina los campos que desee y la IA los ubica por significado. Cubrimos flujos de trabajo relacionados a nivel de documentos en nuestra guía para extraer datos de libretas bancarias japonesas, el flujo de extracción del BAS australiano y la extracción de datos de declaraciones de GST/HST canadienses.
De Órdenes de Compra en Papel a Libros Contables Conciliados
La cadena de documentos de adquisiciones japonesa — cotización, orden de compra, albarán, factura — fue diseñada para un mundo donde cada documento era leído por una persona que entendía las convenciones. La OC dice "20日締翌月末払い" y la persona sabe que eso significa pago a fin de mes siguiente al día 20 del mes de facturación. La factura abrevia el nombre del artículo y la persona sabe que se refiere al mismo producto en la OC. La clasificación del impuesto está implícita en la descripción del artículo y la persona la asigna mentalmente. La fricción en la digitalización de adquisiciones nunca ha sido que estos documentos carezcan de estructura — son altamente estructurados — sino que la estructura depende del contexto compartido entre los lectores humanos, y una máquina que no puede acceder a ese contexto malinterpreta la estructura.
La extracción de OC que lee el significado del campo en lugar de su posición cierra esa brecha. El número de OC se convierte en una clave de búsqueda en lugar de un error de OCR. Las condiciones de pago se convierten en dos columnas — día de cierre y plazo — en lugar de una cadena ilegible. La clasificación del impuesto se convierte en una columna poblada en lugar de un dolor de cabeza durante la revisión de la factura. El equipo de adquisiciones recupera el tiempo que ahora dedica a reescribir, y el flujo de conciliación — el punto de control que protege el efectivo de la empresa — se vuelve más rápido y confiable.