日本の発注書データをExcelに抽出する方法
— 仕入先請求書の照合のために
日本のB2B調達業務では、文書の流れは法律で定められ、長年の業界慣行によって洗練されてきました。見積書(mitsumorisho)から発注書(hatchūsho)が生まれ、納品書(nōhinsho)を経て、請求書(seikyūsho)が発行されます。各文書には、発注番号、明細項目、数量、単価、消費税区分など、重複するデータの一部が含まれており、調達担当者の仕事は、注文内容と納品内容、そして請求内容が一致しているかを毎月確認することです。公正取引委員会の下請代金支払遅延等防止法(下請法)は、下請け業者に発行するすべての発注書に、納入場所、締日を含む支払条件、検品完了日など、12の必須項目を定めています。30社の異なる仕入先からFAXの印刷物やメールのPDFで50件の発注書が届き、それぞれを対応する請求書と照合してから支払いを承認する必要がある場合、ボトルネックは承認判断ではなく、ルックアップ関数で参照できる形式に発注書データを変換することなのです。
重要ポイント
- 毎月50件の仕入先発注書が届き、すべてが請求書と一致する必要があります。標準的な調達ワークフローは、誰かがデータをスプレッドシートに打ち直すことから始まります。
- 発注書には「SUS304 M8×30ボルト」と記載され、請求書には「SUSボルトM8」と記載されている場合、VLOOKUPはデータが存在しないからではなく、3つの文書が同じ取引を異なる言葉で表現しているために#N/Aを返します。
- セマンティック抽出は、フィールドが印刷されている場所ではなく、各フィールドの意味を読み取ります。そのため、三菱ケミカルの発注書でも手書きのFAXでも、列名は発注番号と支払条件を同じように抽出します。
日本の発注書の項目 — 項目ごとの解説
日本の発注書は、欧米の発注書と比較して、より標準化されつつも、より微妙なニュアンスを含む構造を持っています。標準化されているのは、公正取引委員会(JFTC)が下請取引に義務付ける必須項目(下請法で定められ、2026年の中小受託取引適正化法(取適法)で強化)により、法的に準拠した発注書にはすべて同じ基本情報が含まれるためです。微妙なニュアンスがあるのは、それらの項目の中身が、一般的な抽出ツールでは解析するように訓練されていない日本のビジネス慣行を反映しているからです。
JFTCは、発注書(2026年法では正式に4条書面)には最低限、双方の当事者名、発行日、納入物の説明、納期、納入場所、検査完了日、支払金額、支払期日、支払方法が含まれなければならないと定めています。実際には、ほとんどの日本の発注書には、照合ワークフローにとって重要な追加項目が含まれています。以下が、購買管理者が実際に扱う完全な構造です。
ヘッダーと識別情報
- 発注番号 — 発注書を見積書、納品書、請求書に紐付ける一意の識別子。これがないと、3点照合は推測に頼ることになります。ほとんどの日本企業はPO-2026-001のような形式を使用します。これは、後続のすべての検索における主キーです。
- 発注日 — 発行日。支払条件が納品を基準にしている場合(納品後60日以内など)、支払期日を計算するための起点として使用されます。
- 発注元 — 会社名、住所、連絡先。法律に基づく正式な登録名である必要があります。
- 発注先 — 注文を受ける取引先。登録上の会社名。
明細行と価格
- 品名 — 製品またはサービスの説明。多くの場合、品番や仕様コードが含まれ、仕入先によって請求書に記載されているものとは異なる省略形で表記されることがあり、これはVLOOKUPエラーの既知の原因です。
- 数量 — 単位(個、式、kg、m、時間)付き。発注書と請求書で単位が異なる(発注書では「式」、請求書では「個」)ことは、照合における一般的な問題点です。
- 単価 — 通常は税抜価格。請求書では税込価格が表示される場合があり、税区分を正規化せずに比較すると、すべての行が不一致に見えます。
- 金額 — 行合計 = 数量 × 単価。通常は税抜で表示されます。
物流・納品
- 納期 — 商品が到着すべき日付または期間。具体的な日付(2026年8月15日)や相対的な期間(受注後30日以内)で表されることが多い。
- 納入場所 — 商品の納品先。日本の製造業では、「株式会社〇〇 第二工場 第3組立ライン」のように非常に具体的な場合がある。この細かさは生産計画に不可欠だが、長く可変的な形式の文字列となるため、一般的なOCRでは複数のセルに分割されてしまうことが多い。
支払・税
- 支払条件 — 決済のスケジュール。標準的な表現は「締日」と支払期間の組み合わせ。「20日締翌月末払い」は、請求期間が毎月20日に締め切られ、支払いが翌月末までに行われることを意味する。「月末締翌々月末払い」は製造業でよく見られる。これらの文字列には、締日と支払いの月数という2つの計算可能な値が含まれているが、人間は一目で読み取れても、非構造化抽出では1つの区別されない文字列に平坦化されてしまう。
- 消費税区分 — 適用される税率を示す。日本では複数税率が採用されており、標準税率10%(標準的な商品・サービス)と軽減税率8%(食品、非アルコール飲料、定期購読新聞)がある。一部の品目は非課税(輸出取引、特定の医療・教育サービスなど)となる場合もある。複数税率の明細行がある発注書では、各明細の消費税区分が抽出時に保持されなければ、請求書の税額合計を発注書と照合できないというマッチング問題が発生する。
公正取引委員会のサンプル発注書テンプレートには、法令準拠文書に記載される必須項目の全セットが示されている。抽出における重要なポイントは、日本の発注書は自由形式のビジネスレターではないということだ。これは予測可能なフィールドを持つ構造化文書である。しかし、そのフィールドには、日本の調達コンテキスト向けに設計されていないツールには見えない慣習に従った内容が含まれている。抽出のタスクは「この文書を読む」ことではなく、「この文書を読み、締日が支払計算において何を意味するのかを理解する」ことなのである。
発注書・納品書・請求書の照合が単純な自動化で解決できない理由
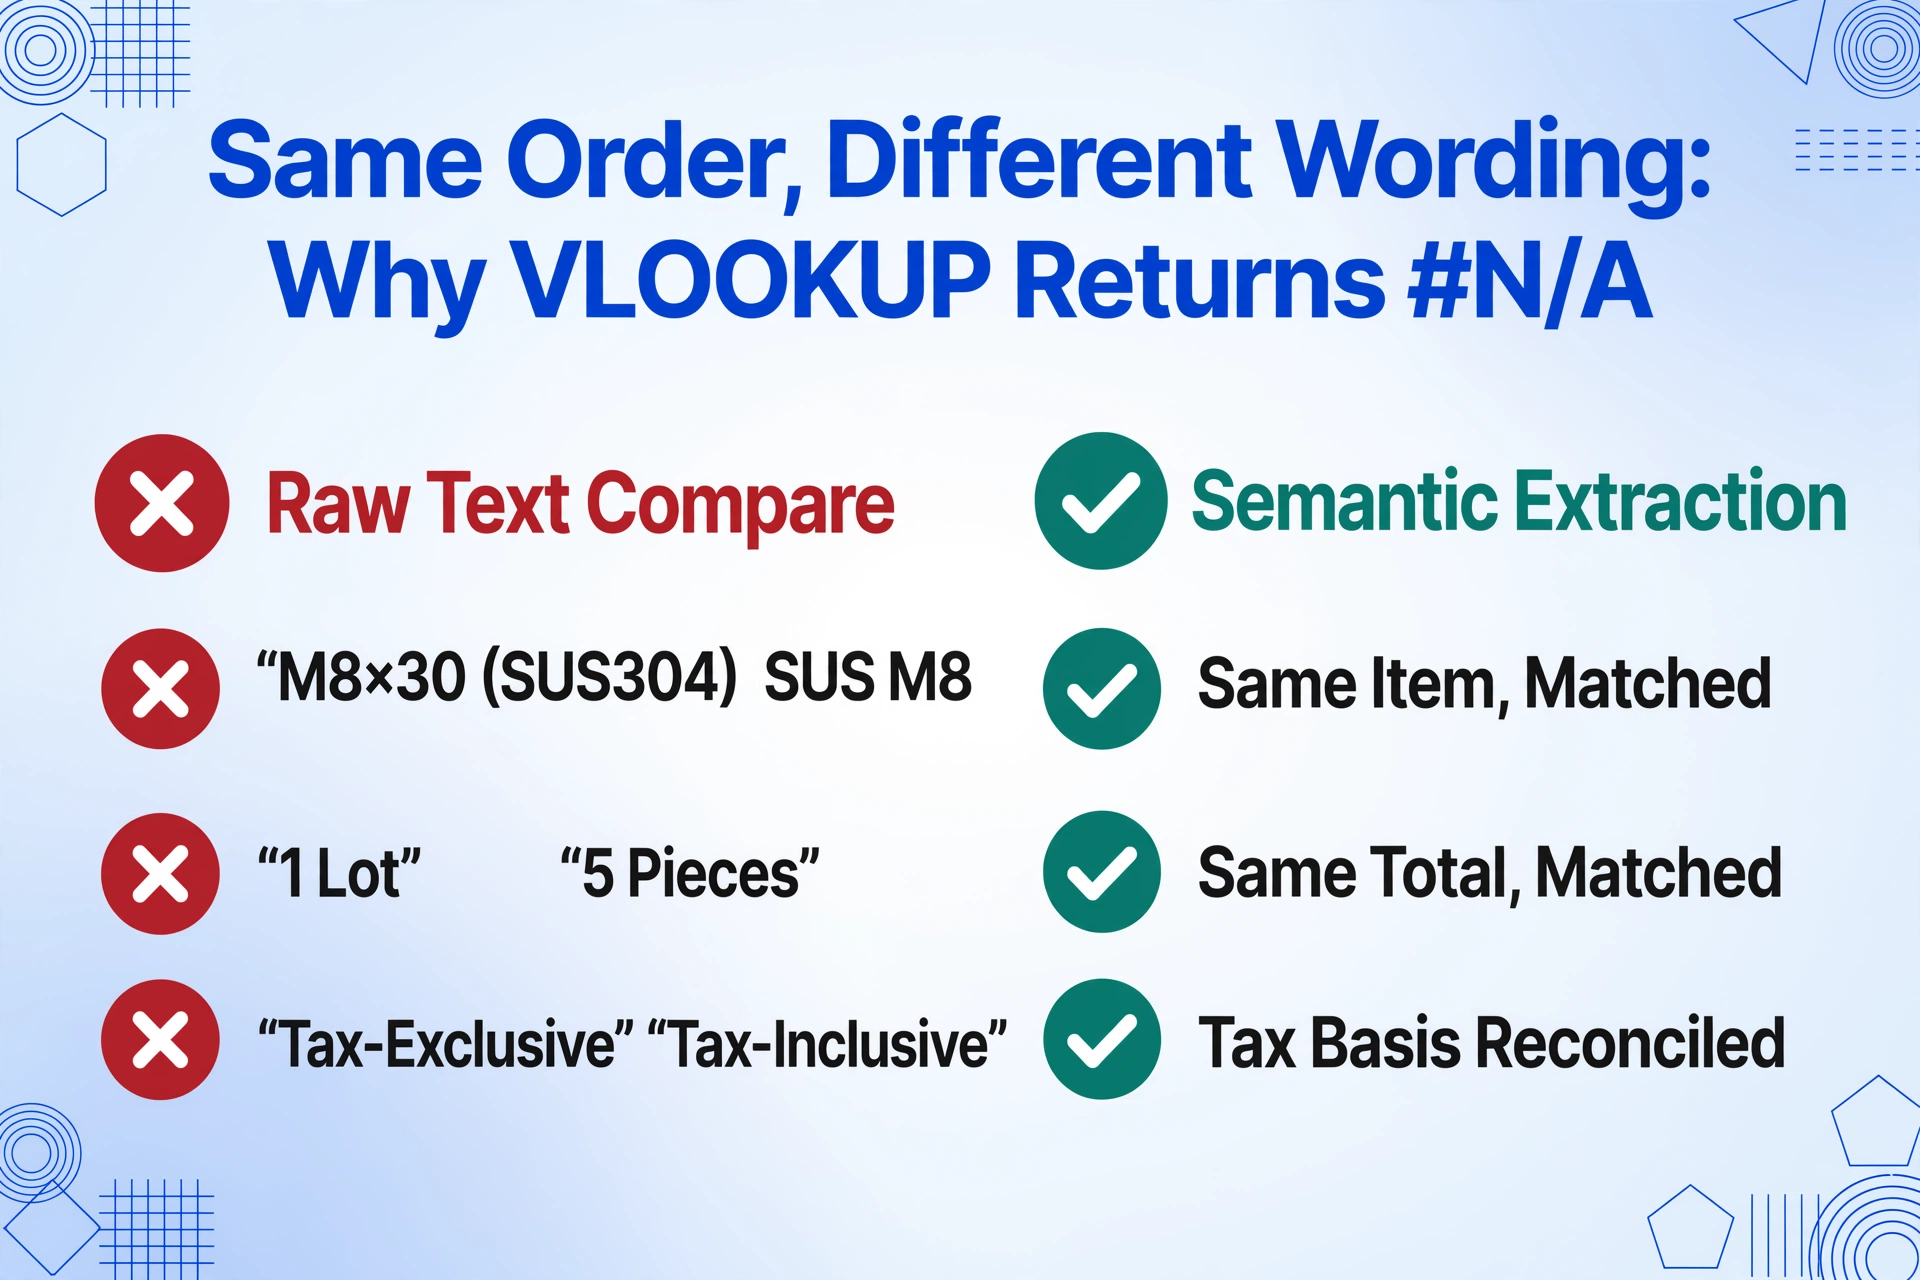
3点照合のワークフロー(発注書・納品書・請求書の数量・単価・条件が一致しているかを確認する作業)は、日本の調達業務において過払い・二重支払い・不正を防ぐための管理ポイントです。同時に、手作業によるデータ入力のボトルネックが集中する場所でもあります。多くのチームが最初に試す「OCR出力をVLOOKUPするだけ」という方法では解決できない理由は、以下の通りです。
核心的な難しさは、3つの文書が同じ取引を異なるテキスト表現で記述している点にあります。仕入先の発注書に「ステンレスボルト M8×30 (SUS304)」と記載されていても、対応する請求書では「SUSボルト M8」と省略されている場合、一方を基準に他方を検索するとExcelは#N/Aを返します。発注書に数量が「1式」と記載されていても、請求書では同じ合計に対して5個に明細化されている場合、数値的には一致しませんが、同じ注文を表しています。発注書の単価が税抜表示で、請求書が税込表示の場合、単純な比較では価格が変わったと結論づけられます。
構造的な問題:日本の調達文書はデータを共有していますが、そのデータの表現方法が異なります。生のOCRテキストに対するVLOOKUPやINDEX-MATCHが失敗するのは、データが欠落しているからではなく、照合が最も重要となる箇所(品名・数量・単価の消費税区分)で表現が分岐するからです。
ここで、テンプレート照合ではなく文書の意味を読み取る抽出アプローチが状況を変えます。抽出ステップが発注書を構造化フィールド(発注番号を列に、品名を列に、数量と単位を別々の列に、単価を税抜に正規化)で出力できれば、同じ構造で抽出された請求書との照合は単純な列比較になります。重い処理はスプレッドシート(仕入先が書式を変更すると壊れる複雑な多条件VLOOKUP数式)から抽出ステップ(AIが表現を単一スキーマに解決する場所)へ移ります。
また、下請法は時間的制約を課しており、抽出の速度が重要になります。支払いは商品・サービスを受け取った日(納品日)から60日以内に行わなければなりません。抽出と照合に60日のうち1週間かかると、調達チームは承認ルート・差異解決・支払い処理など他のすべてに53日しか使えません。抽出ステップを数日から数秒に短縮することで、コンプライアンス期間内で使える時間が直接拡大します。
発注書データをExcelに抽出する方法 — ステップバイステップ
手作業による発注書からExcelへの転記を置き換えるワークフローには、3つの段階があります。最初の段階 — 抽出したい内容の定義 — は一度だけ行い、すべての仕入先、すべての発注書フォーマット、およびその後のすべてのバッチに適用されます。
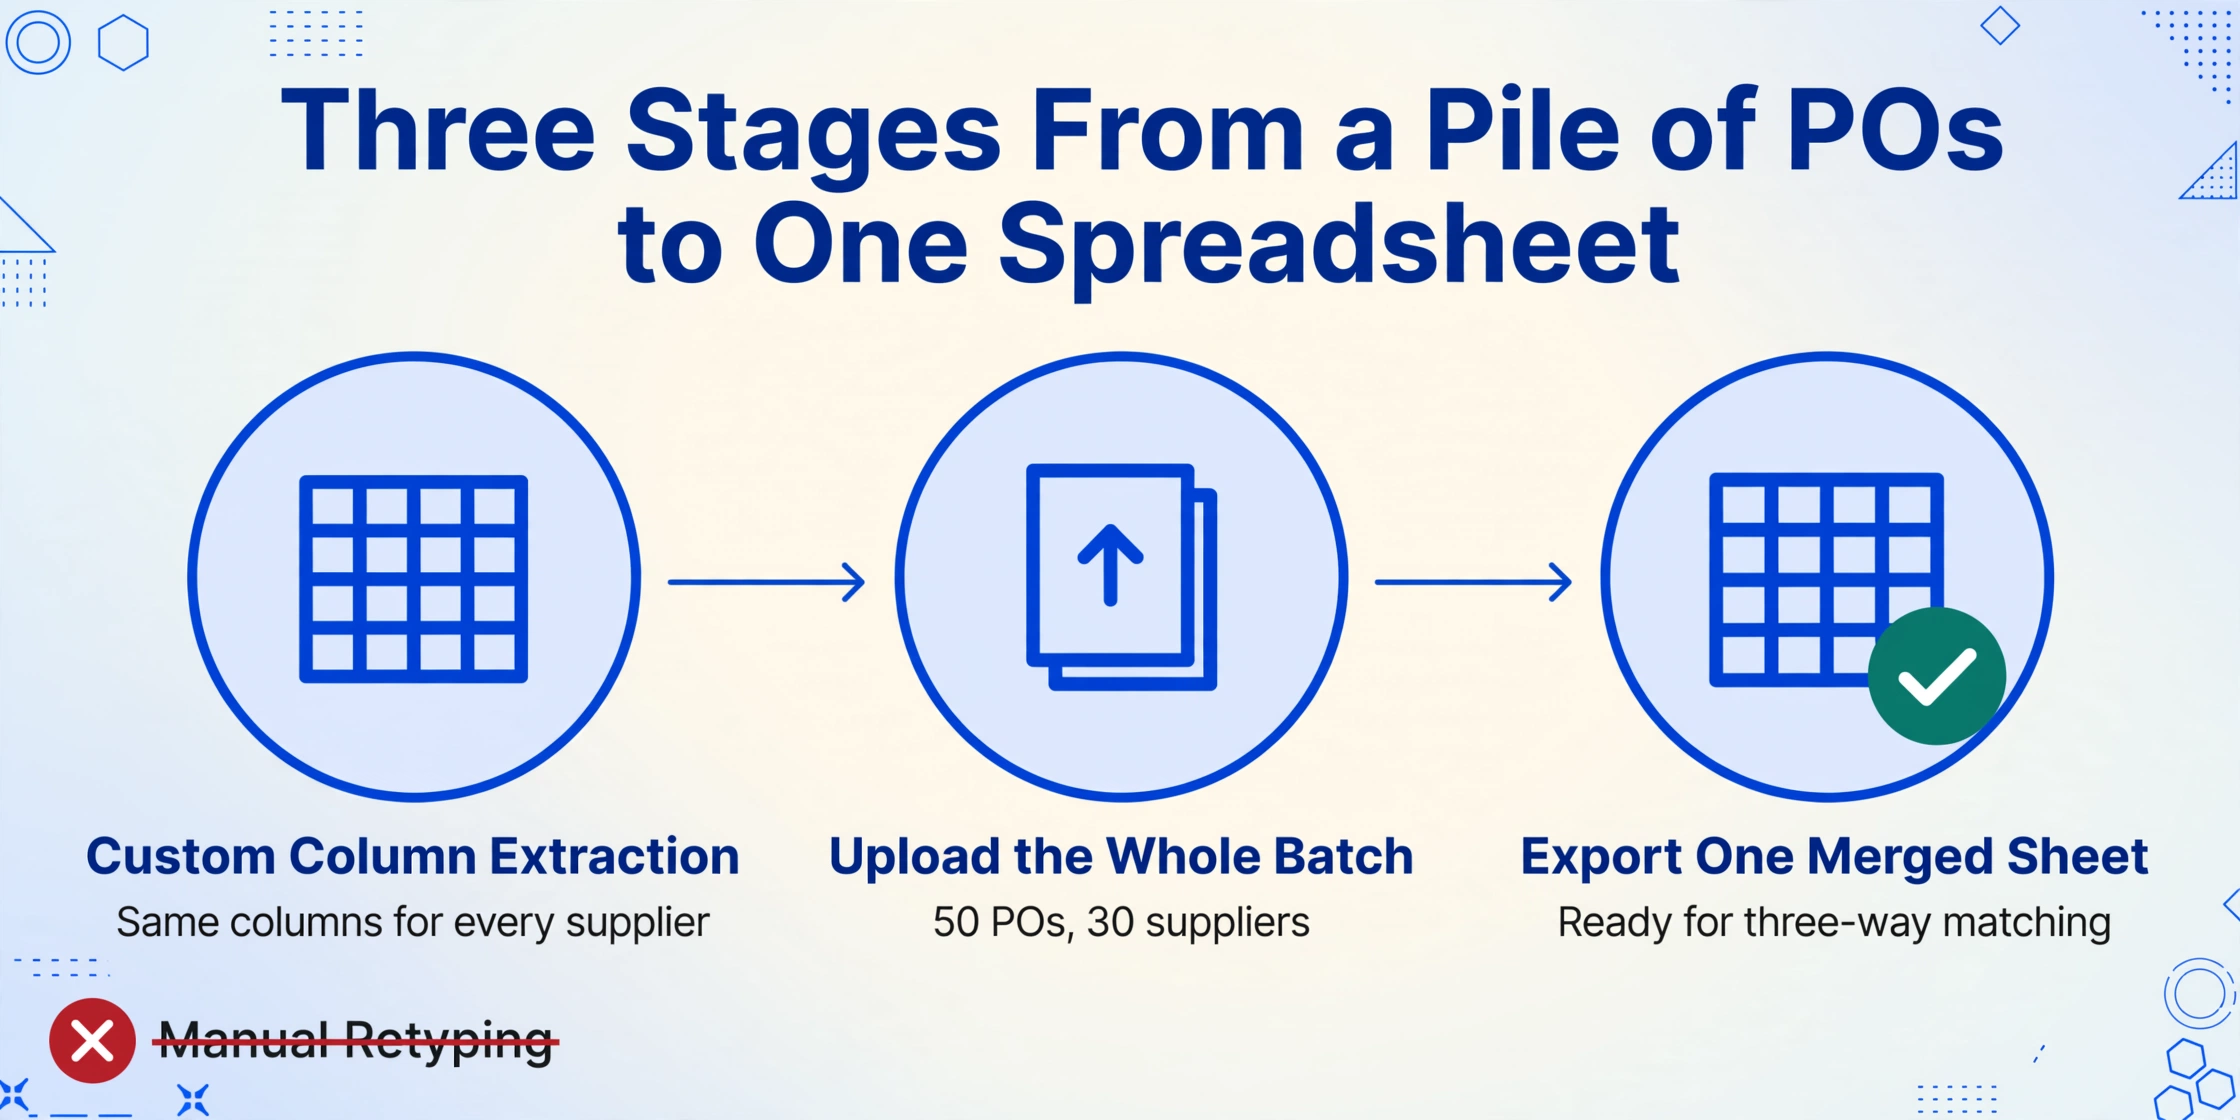
抽出列を一度定義するだけで、すべての取引先で再利用できます
出力スプレッドシートの列ヘッダーにしたいフィールド名を入力します。日本語の発注書抽出では、実用的なセットは次のとおりです:PO番号(発注番号)、発注日、発注先、品名、数量、単位、単価、金額、納期、納入場所、支払条件、消費税区分、合計金額。これはカスタム列抽出を使用しています。出力スキーマを定義すると、AIは各フィールドを意味的に特定します。特定の取引先の発注書テンプレート上の位置によるのではありません。同じ列名は、商社、メーカー、サービス提供者からの発注書でも機能します。AIは各データが意味するものを読み取るからです。印刷された位置ではありません。
すべての発注書を一度にアップロードして、抽出を実行します
FAXの印刷物、メールのPDF、紙文書のスマートフォン写真など、すべての取引先の発注書を1つのアップロードにドロップします。バッチ処理はそれらを1つのジョブとして処理します。各発注書は列スキーマを適用して個別に処理され、すべての結果が1つのスプレッドシートに統合されます。異なる形式やレイアウトを持つ30社からの50件の発注書が1回の実行で処理されます。AIは取引先ごとのテンプレートを必要としません。発注書の文書構造(ヘッダー識別ブロック、明細行テーブル、支払条件と合計を含むフッター)を理解します。特定の取引先がそれらの要素をどのように配置しているかに関係なく。
Excelにエクスポートして、請求書との照合を開始します
統合された結果をExcelファイル(XLSX)としてダウンロードします。これで、発注書の明細行ごとに1行、各フィールドが独自の列に入った状態になります。会計ソフトへのインポートや、請求元帳に対するVLOOKUP照合の準備が整います。このスプレッドシートは、弥生会計、freee、マネーフォワード クラウド会計、勘定奉行に直接インポートできます。これらは、日本の調達・経理チームが日常的に実際に使用しているソフトウェアです。発注書データがきれいな列として構造化されると、照合ステップは列対列の比較になります。抽出結果の発注番号と請求元帳の発注番号、金額と請求額、数量と納品数量の比較です。50件の手動チェックの代わりに、1つの差異レポートで済みます。
同じ列スキーマは翌月も、新しく取引を開始する取引先からの発注書にも、法人税法に基づき7年間、下請法に基づき2年間の保存が法的に義務付けられている前年度(決算年度)のアーカイブ発注書にも機能します。取引先がERPをアップグレードする際に発注書の形式を変更しても、定義した列名は影響を受けません。
ファイルは安全に処理され、保存されません。
汎用抽出が対応できない項目とその対処法
日本の発注書にある3つのデータ項目は、他の項目よりも自動抽出が難しいものです。それは読み取りにくいからではなく、抽出時に単純化せず保持すべき業務ロジックが含まれているからです。
 支払条件 — テキスト文字列から支払期日まで
日本の発注書における支払条件は、「20日締翌月末払い」「月末締翌々月末払い」「納品後60日以内」といった簡潔な複合表現で記載されます。それぞれに、請求期間が締まる日(締日)と、その締日から数えて支払期日がいつになるかという2つの情報が含まれています。発注書と請求書を照合する購買チームは、この2つの情報を別々の列で必要とします。締日は請求書の請求期間が発注書と一致しているかを確認するため、支払ラグは請求書の支払期日が正しいかを確認するためです。
一般的な抽出では、これらは単一の未分化なテキスト文字列として出力されます。計算列(抽出時にAIが文書から直接読み取るのではなく、値を計算して求める列)を使用することで、この問題を解決できます。締日(支払条件から日付を抽出。「20日締」なら20、「月末締」なら31)という列と、支払ラグ月数(支払条件から算出。「翌月末払い」なら1、「翌々月末払い」なら2)という2番目の列を定義します。AIが日本の支払条件の慣例を解析し、数式で計算可能な構造化された値を出力します。
消費税区分 — 複数税率の照合
日本の複数税率の消費税制度では、1枚の発注書に10%、8%、非課税の明細が混在することがあります。2023年10月に施行されたインボイス制度に準拠するには、請求書で税率区分ごとに税額を分けて記載する必要があります。発注書の抽出結果でどの明細がどの税率で課税されているかが保持されていない場合、請求書の税額合計を発注書と照合できません。購買チームは税額計算を確認できないまま支払いを承認することになります。
この問題の解決策は、推論列(AIがラベル付きフィールドから読み取るのではなく、文脈から値を推論する列)です。税区分(選択肢:10%標準、8%軽減、非課税)— 品目説明から判定。食品・飲料品目 → 8%軽減。一般商品 → 10%。輸出物品または非課税と明記された物品 → 非課税と定義します。AIが各明細の説明を読み取り、抽出時に正しい税区分を割り当てるため、出力されるスプレッドシートには税区分がすでに入力された状態で届き、税率グループごとの合計照合にすぐ使用できます。
納入場所 — 詳細かつ可変、重要な項目
日本の製造業の発注書における納入場所は、極めて具体的です。「〇〇株式会社 埼玉工場 第二組立課 B棟3階」のように、工場構内の特定の建物、階、部署を指し示します。これらの文字列は、サプライヤーによって長さや詳細度が異なり、頻繁に省略されます(例:埼玉工場 → 埼工)。また、社内の生産スケジュール管理における検索キーでもあります。納入場所が破損または切り詰められると(例:「〇〇株式会社 埼玉工場 第二組立課 B棟」で階が欠落)、材料が誤った受け取りドックに送られてしまいます。抽出処理では、印刷された文字列全体を、日本語の言語モデルを持たないOCRエンジンが頻繁に誤読する漢字(工場と工塲、棟と楝など)も含めて、そのまま完全に保持する必要があります。
照合において重要な理由: これらの3つのフィールド(支払条件、消費税区分、納入場所)は、単なる飾りではありません。これらは、照合された発注書・請求書のペアが、金銭的に有効(消費税)であり、手続き的に正しく(支払タイミング)、運用上、納品可能(場所)であるかを決定するフィールドです。これらを正確に抽出できるかどうかは、照合ワークフローが数分で完了するか、それともすべての行を人間が再確認する必要があるかの違いを生みます。
抽出した発注書データを日本の会計ソフトへ取り込む
抽出ジョブの出力はスプレッドシートです。その行き先は、照合が行われる会計ソフトまたは購買ソフトウェアです。ここでは、日本の企業が実際に使用しているツールへのパイプラインの接続方法を説明します。
弥生会計 / 弥生販売 — 日本の中小企業向け会計ソフトの市場シェアリーダーです。弥生のデスクトップ製品とクラウド製品は、仕訳帳と買掛元帳データのCSVインポートに対応しています。抽出結果の列ヘッダーがインポートのフィールドマッピングになります。発注書番号 → 伝票番号、日付 → 日付、仕入先 → 仕入先、金額 → 金額。弥生販売は、購買および在庫管理のための関連製品で、発注書データを購買モジュールに直接インポートします。これは、抽出からインポートまでのステップをファイルアップロードに短縮する専用パイプラインです。
freee — 70,000社以上の日本の中小企業が利用するクラウド会計プラットフォームです。freeeのAPIとCSVインポートは、自動仕訳による購買取引の登録をサポートしています。品目ごとの消費税区分を含めて抽出された発注書データは、freeeの消費税申告に直接反映され、適格請求書(インボイス)のコンプライアンスに必要な10%の標準税率と8%の軽減税率の両方の計算に対応しています。
マネーフォワード クラウド会計 — freeeの主要な競合であり、日本で最も多くの金融機関API接続(2,451以上)を誇ります。マネーフォワードの購買管理モジュールはCSVインポートに対応しており、仕入先名と金額を含む抽出された発注書データが買掛元帳に直接反映されます。このプラットフォームの自動銀行照合機能は、抽出された支払い記録を銀行フィードと照合し、発注書の抽出から支払い検証までのループを閉じます。
勘定奉行 — OBCの会計スイートで、中規模の日本企業(年間売上高¥500M–5B)で有力です。勘定奉行の購買モジュールは発注書データの一括インポートをサポートしており、部門別原価管理に特に強みがあります。発注書に部門コードやコストセンターが含まれている場合、それらのフィールドはセグメント化された損益レポートに自動的に反映されます。
共通点は、主要な日本の会計プラットフォームはすべて構造化データのインポートに対応しているということです。ボトルネックはインポート機能ではなく、そもそも発注書データを構造化された形式にすることにありました。クリーンなExcel列ができれば、インポートはファイルアップロードまたはコピー&ペーストに過ぎません。
よくある質問
取引先からFAXで送られてくる手書きの発注書も読み取れますか?
はい、読み取れます。特に中小の製造業や商社からの発注書では、ボールペンで手書きされた品名や数量、会社印(社判)が押印されたものがFAXで送られてくることがよくあります。AIモデルは、調達業務でよく使われる略字(㈱やNo.など)を含む手書きの日本語文字を読み取ります。画質が劣化したFAX(用紙の地紋、傾き、インクの裏抜けなど)の場合、難しい文字については出力結果をスポットチェックすることをお勧めします。FAX原稿の場合は、300dpi以上でスキャンすると精度が向上します。
1枚の発注書が複数ページにわたる場合はどうなりますか?
発注書の全ページを一度にアップロードしてください。抽出エンジンは、同じファイルの複数ページを1つの連続した文書として扱います。ヘッダー情報(発注番号、取引先、日付)は1回だけ抽出され、全ページの明細行が同じ行セットにまとめられます。複数ページのFAX発注書で、継続ページにヘッダーがなく、前ページからの明細テーブルが続いている場合でも、抽出処理は継続性を維持し、すべての明細を1ページ目で特定された発注番号に関連付けます。
取引先ごとに発注書のフォーマットが異なっていても大丈夫ですか?
はい、問題ありません。これこそが、テンプレートベースのOCRに対するセマンティック抽出の決定的な利点です。テンプレートベースのツールでは、取引先ごとに異なる解析テンプレート(フィールドの座標範囲やラベルを定義したもの)を作成し、維持する必要があります。取引先がERPをアップグレードしたり、帳票をリニューアルしたりして発注書のレイアウトが変更されると、テンプレートは使えなくなり、再構築が必要になります。セマンティック抽出は、データがページのどこに表示されているかではなく、それぞれのデータが何であるかを理解して文書を読み取ります。発注番号は、三菱ケミカルの発注書では右上に印刷されていようと、地場の下請け業者からの手書きFAXでは下部中央に書かれていようと、発注番号です。
8%と10%の消費税区分の抽出はどのように行われますか?
日本における複数税率の消費税制度では、税率区分ごとに明細を記載した請求書が求められます。発注書の抽出において、例えば「税率(選択肢:8%、10%、非課税)— 品目説明に基づいて分類」といった税区分ロジックを指定する列を追加すると、AIが各明細行を評価し、抽出時に正しい税率を割り当てます。食品や定期購読新聞は8%、それ以外は10%、輸出取引や明示的に非課税の項目は非課税となります。抽出されたデータには税率が既に割り当てられており、請求書の税区分内訳に合致した税率グループごとの合計計算が可能です。これは推論列です。税率は発注書に印刷されているわけではなく、抽出時にAIが品目説明から導き出します。
同じワークフローで他の日本の調達書類も処理できますか?
列スキーマのアプローチは、調達書類の全チェーンに適用できます。見積書の場合:仕入先、品目、単価、有効期限を抽出し、発注書と照合して、注文価格が見積価格と一致するかを確認します。納品書の場合:納入数量を抽出し、発注書の数量と比較して、請求書が届く前に不足納品を特定します。請求書の場合:請求金額と税区分内訳を抽出し、発注書データと照合して支払承認前に確認します。同じ抽出プラットフォームで4種類すべての書類を処理でき、同じ列命名ロジックが適用されます。つまり、必要なフィールドを定義すれば、AIが意味に基づいてそれらを見つけ出します。関連する書類レベルのワークフローについては、日本の銀行通帳データの抽出、オーストラリアBAS抽出ワークフロー、カナダGST/HST申告データ抽出のガイドもご参照ください。
紙の発注書から照合済みの元帳へ
日本の調達書類チェーン(見積書、発注書、納品書、請求書)は、それぞれの書類を慣習を理解した人間が読むことを前提に設計されていました。発注書に「20日締翌月末払い」とあれば、人間はそれが請求月の20日締めで翌月末までに支払うことを意味すると理解します。請求書で品目名が省略されていても、人間はそれが発注書の同じ製品を指しているとわかります。税区分は品目説明に暗に含まれており、人間はそれを頭の中で対応づけます。調達のデジタル化における障壁は、これらの書類に構造が欠けていることではなく(実際には高度に構造化されています)、その構造が人間の読者間の共通認識に依存しており、その認識にアクセスできない機械が構造を誤読することにありました。
フィールドの位置ではなく意味を読み取る発注書抽出は、そのギャップを埋めます。発注番号はOCRエラーではなく検索キーになります。支払条件は、一つの文字化けした文字列ではなく、締日と支払猶予という二つの列になります。税区分は、請求書レビュー時の頭痛の種ではなく、値が入力された列になります。調達チームは現在手入力に費やしている時間を取り戻し、会社の資金を守る管理ポイントである照合ワークフローは、より迅速かつ信頼性の高いものになります。