Como Extrair Dados de Pedidos de Compra Japoneses para Excel
para Conciliação de Faturas de Fornecedores
Na aquisição B2B japonesa, a trilha documental é prescrita por lei e refinada por décadas de convenção do setor: a cotação (見積書, mitsumorisho) leva ao pedido de compra (発注書, hatchūsho), que gera a nota de entrega (納品書, nōhinsho), que aciona a fatura (請求書, seikyūsho). Cada documento carrega um subconjunto de dados sobrepostos — número do pedido, itens de linha, quantidades, preços unitários, classificação fiscal — e o trabalho do gerente de compras, mês após mês, é verificar se o que foi pedido corresponde ao que foi entregue e ao que está sendo cobrado. A Lei de Subcontratação da Comissão de Comércio Justo do Japão (下請代金支払遅延等防止法) exige doze campos específicos em todo pedido de compra emitido a subcontratados, incluindo local de entrega (納入場所), condições de pagamento (支払条件) com dia de fechamento (締日) e data de conclusão da inspeção. Quando cinquenta desses chegam à sua mesa como impressões de fax e PDFs por e-mail de trinta fornecedores diferentes, e cada um deve ser conciliado com a fatura correspondente antes que o pagamento seja aprovado, o gargalo não é a decisão de aprovação — é colocar os dados do pedido em um formato que uma fórmula de busca possa enxergar.
Principais Conclusões
- Cinquenta pedidos de compra de fornecedores chegam todo mês, cada um deve corresponder a uma fatura, e o fluxo de trabalho padrão de compras começa com alguém redigitando dados em uma planilha.
- O pedido diz "parafuso SUS304 M8×30", a fatura diz "parafuso SUS M8" — PROCV retorna #N/D não porque os dados estão ausentes, mas porque três documentos descrevem a mesma transação usando palavras diferentes.
- A extração semântica lê o que cada campo significa em vez de onde está impresso — seus nomes de coluna extraem Número do Pedido e Condições de Pagamento de forma idêntica de um pedido de compra da Mitsubishi Chemical e de um fax manuscrito.
O que um Pedido de Compra Japonês Contém — Campo por Campo
Os pedidos de compra japoneses seguem uma estrutura que é ao mesmo tempo mais padronizada e mais sutil do que suas contrapartes ocidentais. Padronizada porque os campos obrigatórios da JFTC para transações de subcontratação — codificados na Lei de Subcontratação e reforçados pela Lei de Transações Justas para PMEs de 2026 (中小受託取引適正化法, ou 取適法) — significam que todo PO legalmente conforme carrega as mesmas informações principais. Sutil porque o conteúdo dentro desses campos reflete convenções comerciais japonesas que nenhuma ferramenta genérica de extração foi treinada para interpretar.
A JFTC especifica que um PO (formalmente um documento do Artigo 4 sob a Lei de 2026) deve conter no mínimo: nomes de ambas as partes, data de emissão, descrição dos itens, data de entrega, local de entrega, data de conclusão da inspeção, valor do pagamento, data de vencimento do pagamento e método de pagamento. Na prática, a maioria dos POs japoneses inclui campos adicionais que importam para o fluxo de conciliação. Aqui está a estrutura completa com a qual um gerente de compras realmente trabalha:
Cabeçalho e Identificação
- 発注番号 (Número do PO) — o identificador único que vincula o PO à sua cotação, nota de entrega e fatura. Sem ele, a conciliação de três vias é um palpite. A maioria das empresas japonesas usa um formato como PO-2026-001. Esta é a chave primária para toda consulta downstream.
- 発注日 (Data do Pedido) — a data de emissão. Usada como ponto de partida para calcular as datas de vencimento quando os prazos são expressos em relação à entrega (dentro de 60 dias após a entrega).
- 発注元 (Comprador) — nome da empresa, endereço, informações de contato. Deve ser o nome oficial registrado sob a Lei.
- 発注先 (Fornecedor) — o vendedor que recebe o pedido. Nome da empresa conforme registro.
Itens e Preços
- 品名 (Nome do Item) — descrição do produto ou serviço. Frequentemente inclui números de peça (品番) ou códigos de especificação que um fornecedor abrevia de forma diferente de como aparecem na fatura — uma fonte conhecida de falhas em PROCV.
- 数量 (Quantidade) — com unidade (単位): 個 (peças), 式 (lote/conjunto), kg, m, hora (時間). Incompatibilidades de unidade entre PO e fatura — PO diz 式, fatura diz 個 — são uma dor de cabeça comum na reconciliação.
- 単価 (Preço Unitário) — tipicamente sem impostos (税抜). A fatura pode mostrar preços com impostos; se a comparação for feita sem normalizar o tratamento tributário, cada linha parecerá incompatível.
- 金額 (Valor) — total da linha = quantidade × preço unitário. Geralmente mostrado sem impostos.
Logística e Entrega
- 納期 (Data de Entrega) — a data ou janela em que as mercadorias devem chegar. Frequentemente expressa como uma data específica (15 de agosto de 2026) ou uma janela relativa (dentro de 30 dias após o pedido).
- 納入場所 (Local de Entrega) — onde as mercadorias são entregues. Na manufatura japonesa, isso pode ser surpreendentemente específico: "Empresa X, Fábrica 2, Linha de Montagem 3". Esse nível de detalhe é essencial para o planejamento da produção, mas gera strings longas e de formato variável que o OCR genérico frequentemente fragmenta em várias células.
Pagamento e Impostos
- 支払条件 (Condições de Pagamento) — o cronograma de liquidação. A expressão padrão é dia de fechamento mais uma janela de pagamento. "Fechamento no dia 20, pagamento até o final do mês seguinte" significa que o período de faturamento encerra no dia 20 do mês e o pagamento vence até o final do mês seguinte. "Fechamento no final do mês, pagamento até o final do mês seguinte ao próximo" é comum na manufatura. Essas strings de texto contêm dois valores calculáveis — dia de fechamento e atraso de pagamento em meses — que um humano lê rapidamente, mas uma extração não estruturada achata em uma única string indiferenciada.
- 消費税区分 (Classificação do Imposto sobre Consumo) — indica qual alíquota se aplica. O Japão usa um sistema de alíquotas duplas: 10% (taxa padrão para bens e serviços comuns) e 8% (taxa reduzida para alimentos, bebidas não alcoólicas e jornais assinados). Alguns itens podem ser isentos (exportação, certos serviços médicos e educacionais). Um pedido de compra com itens de alíquotas mistas cria um problema de correspondência: o total de impostos da fatura não pode ser verificado em relação ao pedido, a menos que a classificação de imposto de cada linha seja preservada durante a extração.
O modelo de pedido de compra da JFTC mostra o conjunto completo de campos obrigatórios conforme aparecem em um documento em conformidade. A conclusão para extração: um pedido de compra japonês não é uma carta comercial de formato livre. É um documento estruturado com campos previsíveis — mas esses campos contêm conteúdo regido por convenções que são invisíveis para uma ferramenta que não foi projetada para o contexto de compras japonês. A tarefa de extração não é "ler este documento" — é "ler este documento e entender o que o dia de fechamento significa para o cálculo do pagamento."
Por que o problema de correspondência entre 発注書, 納品書 e 請求書 resiste à automação simples
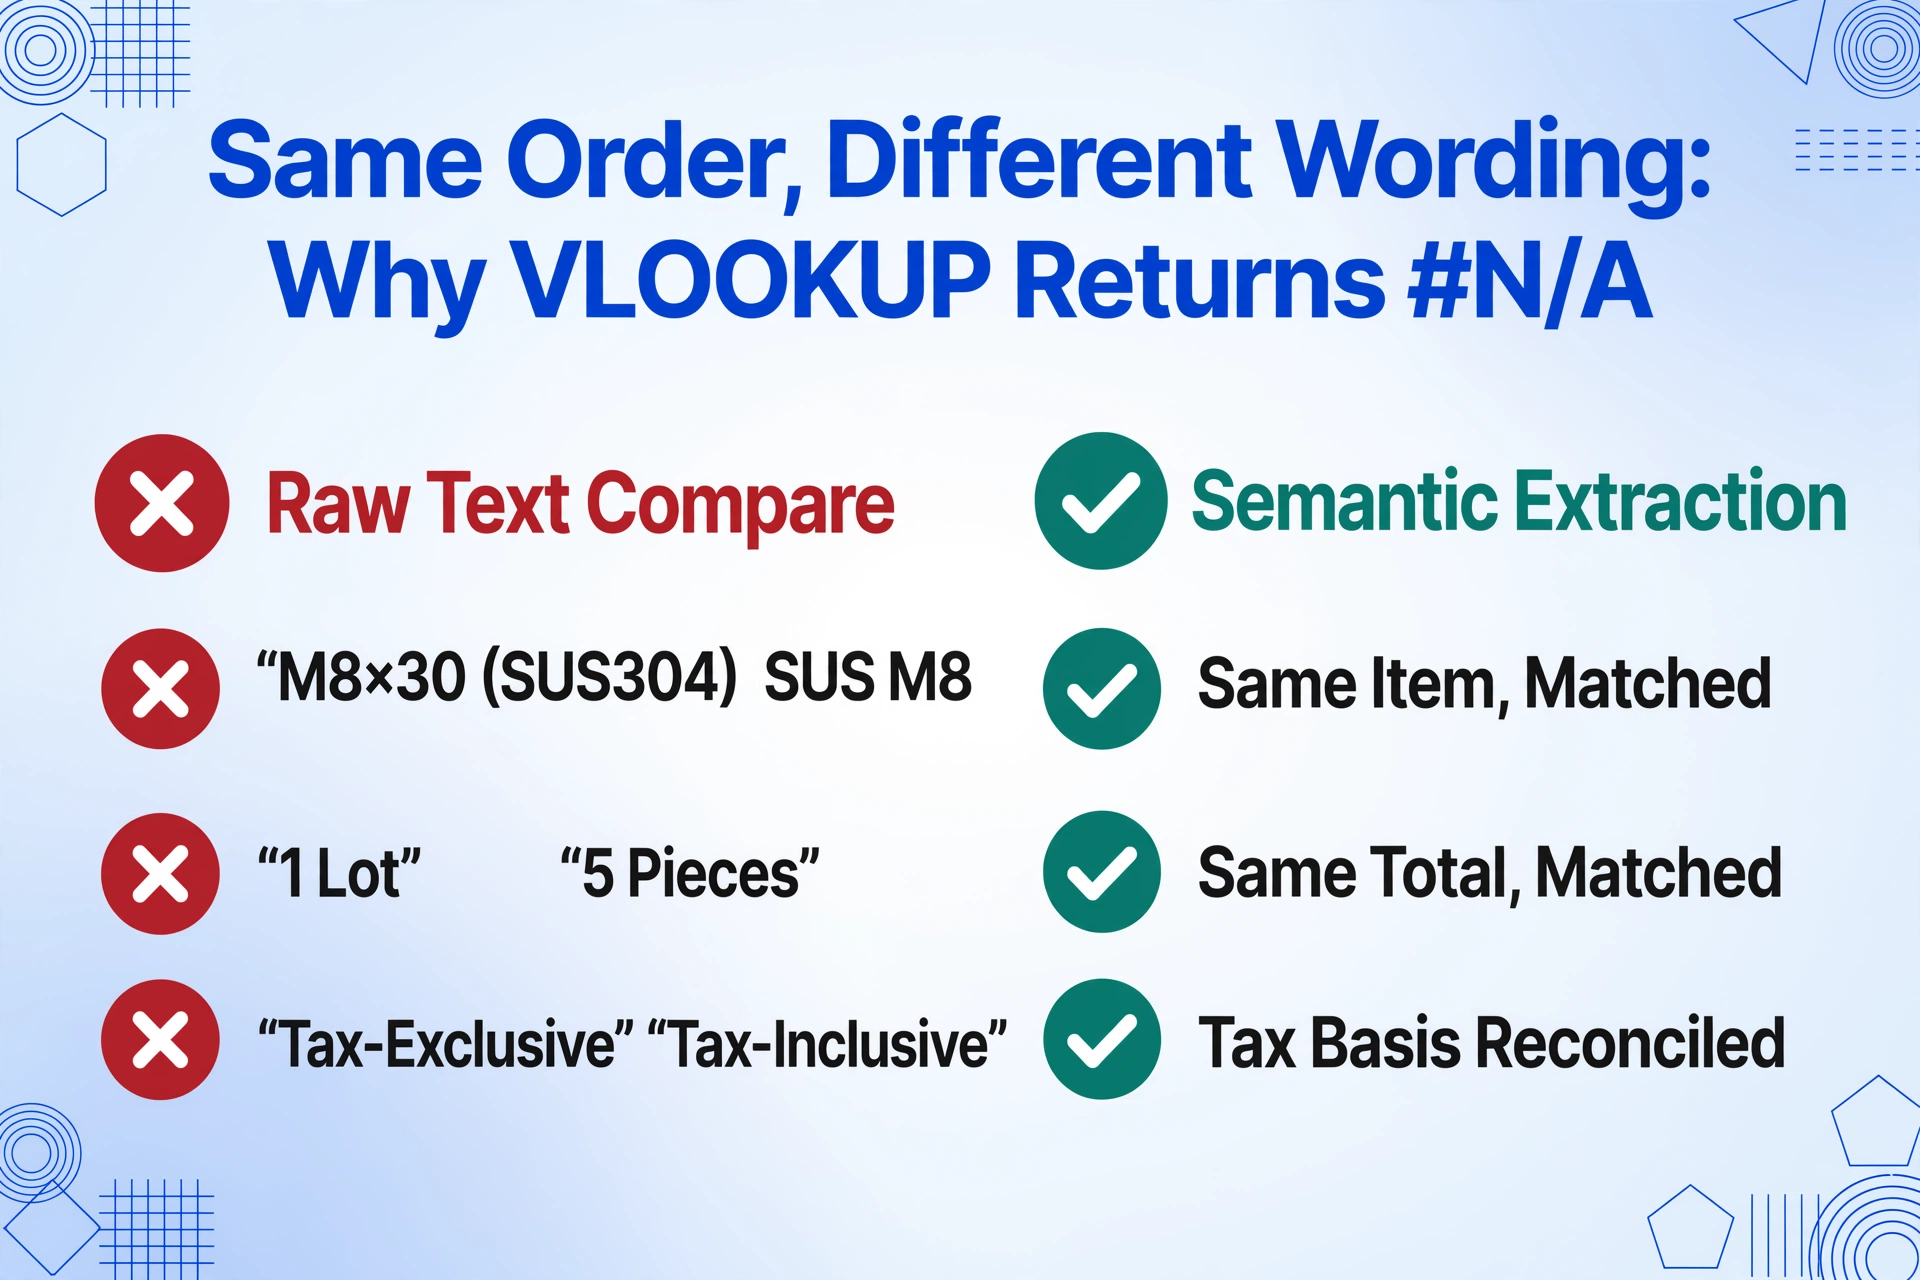
O fluxo de correspondência tripla — verificar se o pedido de compra, a nota de entrega e a fatura concordam em quantidade, preço e condições — é o ponto de controle que evita pagamento em excesso, pagamento duplicado e fraude na aquisição japonesa. É também onde o gargalo da entrada manual de dados se concentra. Aqui está o porquê de ele resistir à solução óbvia de "apenas use PROCV no resultado do OCR" que a maioria das equipes tenta primeiro.
A dificuldade central é que os três documentos descrevem a mesma transação usando representações textuais diferentes. O pedido de compra de um fornecedor pode listar um item como "ステンレスボルト M8×30 (SUS304)" enquanto a fatura correspondente o abrevia para "SUSボルト M8" — procure um contra o outro e o Excel retorna #N/A. Um pedido de compra lista a quantidade como "1式" (um lote), mas a fatura detalha o lote em 5 peças (個) para o mesmo total — as quantidades não correspondem numericamente, mas representam o mesmo pedido. Um pedido de compra mostra preços unitários sem imposto (税抜), a fatura os mostra com imposto (税込), e uma comparação ingênua conclui que os preços mudaram.
A questão estrutural: Documentos de aquisição japoneses compartilham dados, mas usam representações diferentes desses dados. Um PROCV ou INDEX-MATCH no texto bruto do OCR falha não porque os dados estão ausentes — mas porque as representações divergem exatamente nos pontos onde a correspondência é mais crítica: nomes de itens, quantidades e tratamento de imposto no preço unitário.
É aqui que uma abordagem de extração que lê a semântica do documento em vez de corresponder a modelos muda a equação. Se sua etapa de extração gera um pedido de compra com campos estruturados — número do pedido como coluna, nome do item como coluna, quantidade e unidade separadas em suas próprias colunas, preço unitário normalizado como sem imposto — então a etapa de correspondência contra uma extração de fatura estruturada de forma idêntica se torna uma comparação direta de colunas. O trabalho pesado muda da planilha (fórmulas complexas de PROCV com múltiplas condições que quebram quando fornecedores mudam a formatação) para a etapa de extração (onde a IA resolve as representações em um único esquema).
A Lei de Subcontratação também impõe uma restrição de tempo que torna a velocidade de extração consequente: o pagamento deve ser feito dentro de 60 dias após o recebimento dos bens ou serviços (納品日から60日以内). Se a extração e a correspondência levarem uma semana dessa janela de 60 dias, a equipe de aquisição tem 53 dias para todo o resto — roteamento de aprovação, resolução de discrepâncias, processamento de pagamento. Reduzir a etapa de extração de dias para segundos expande diretamente a porção utilizável da janela de conformidade.
Como Extraer Datos de Órdenes de Compra a Excel — Paso a Paso
El flujo de trabajo que reemplaza la transcripción manual de órdenes de compra a Excel tiene tres etapas. La primera etapa — definir lo que deseas extraer — se realiza una sola vez y se aplica a cada proveedor, cada formato de orden de compra y cada lote posterior.
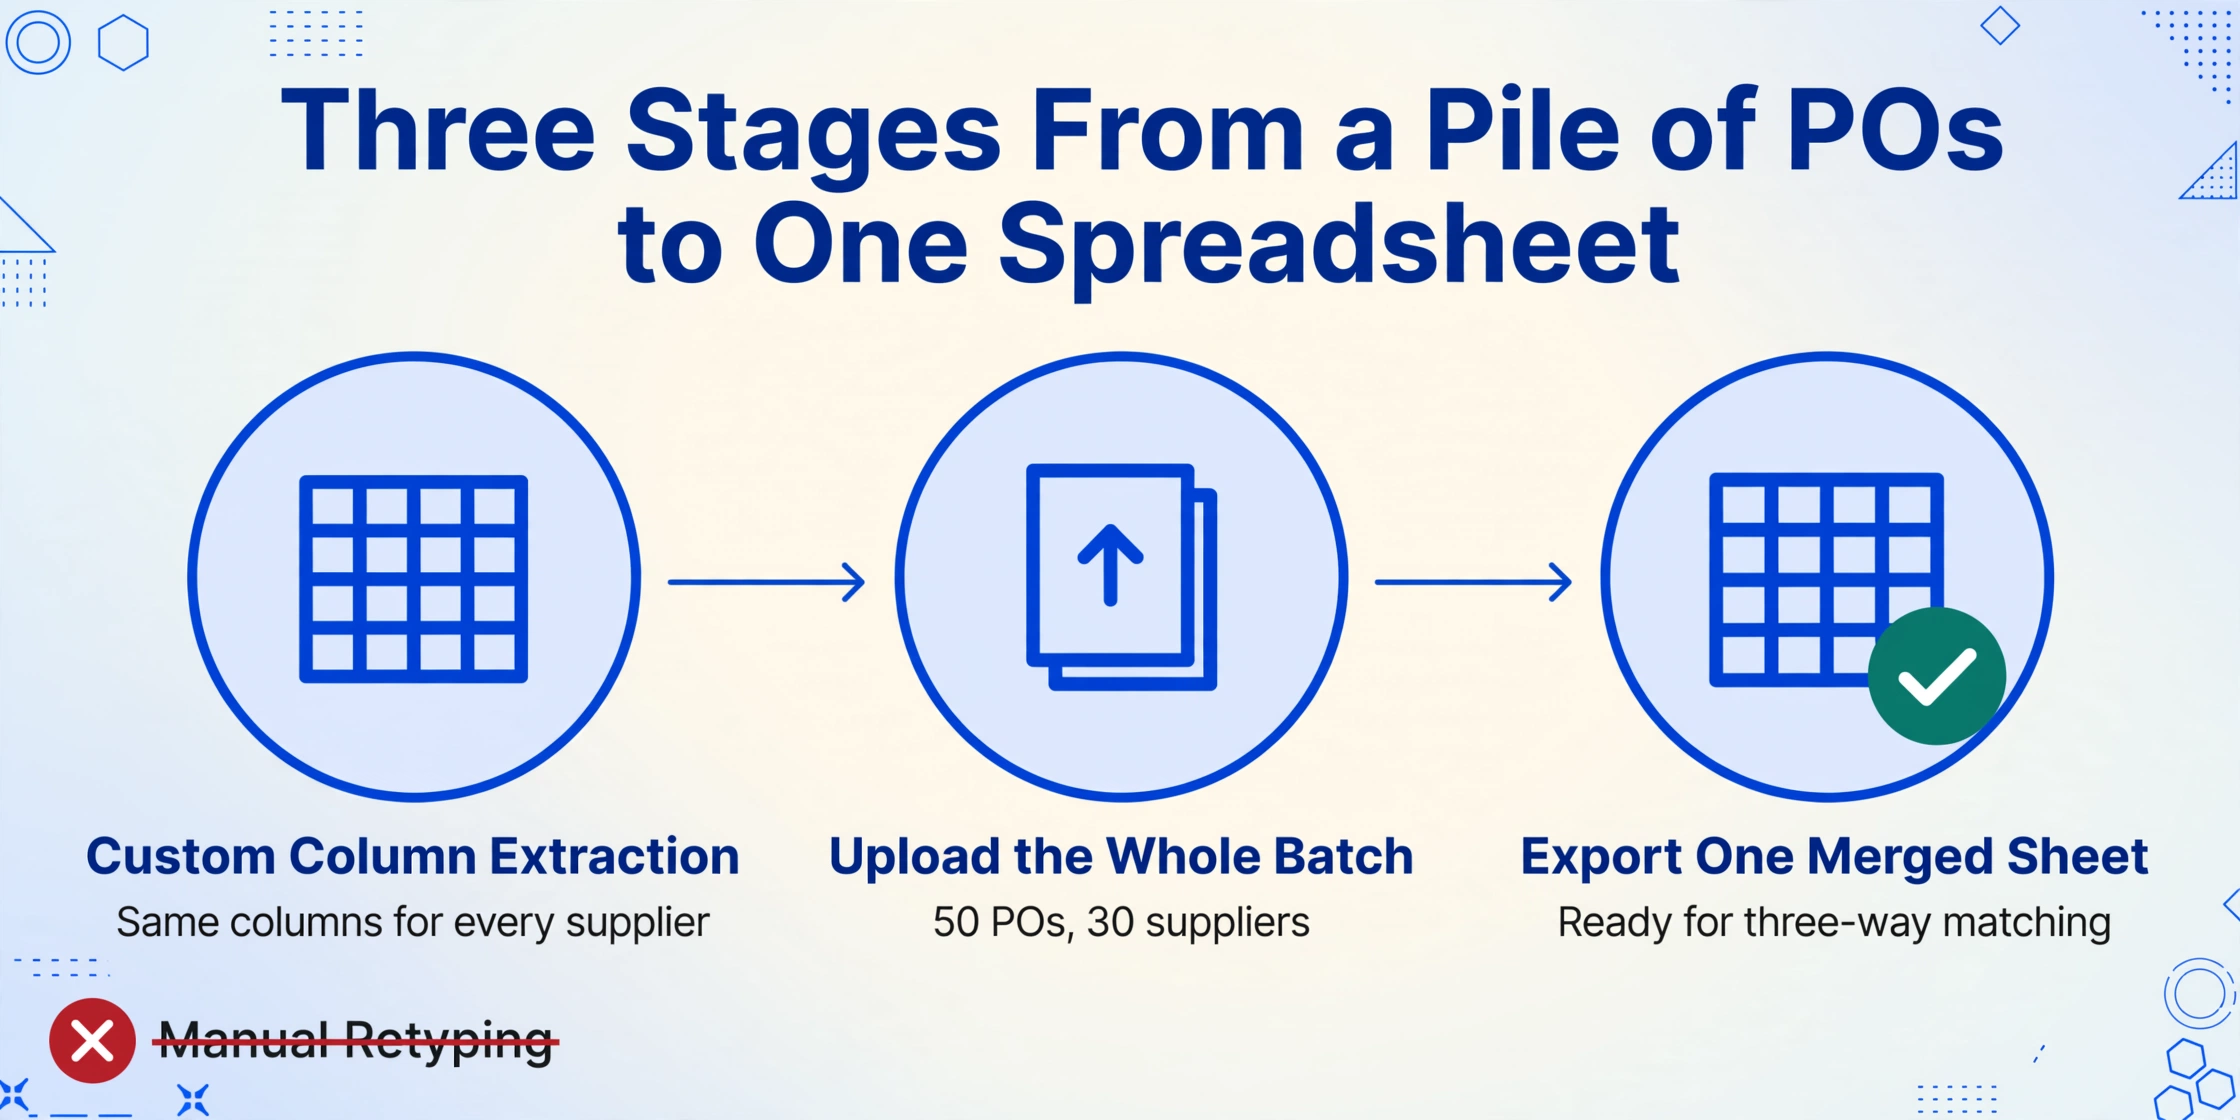
Defina suas colunas de extração uma vez — reutilize em todos os fornecedores
Digite os nomes dos campos que você quer como cabeçalhos de coluna na sua planilha de saída. Para extração de pedidos de compra japoneses, o conjunto prático é: PO Number (発注番号), Order Date (発注日), Supplier (発注先), Item Name (品名), Quantity (数量), Unit (単位), Unit Price (単価), Line Amount (金額), Delivery Date (納期), Delivery Location (納入場所), Payment Terms (支払条件), Consumption Tax Classification (消費税区分), Total Amount (合計金額). Isso usa a Extração de Colunas Personalizadas: você define o esquema de saída e a IA localiza cada campo pelo significado semântico — não pela posição no modelo de PO de um fornecedor específico. Os mesmos nomes de coluna funcionam em POs de trading companies (商社), fabricantes (メーカー) e prestadores de serviços, porque a IA lê o que cada dado significa, não onde ele está impresso.
Envie todos os POs em um único lote e deixe a extração rodar
Envie todos os POs dos seus fornecedores — impressões de fax, PDFs de e-mail, fotos de documentos em papel tiradas com smartphone — em um único upload. O processamento em lote trata tudo como um único job: cada PO é processado de forma independente com o seu esquema de colunas aplicado, e todos os resultados são mesclados em uma única planilha. Cinquenta POs de trinta fornecedores com formatos e layouts diferentes são processados em uma única execução. A IA não precisa de um modelo por fornecedor; ela entende a estrutura documental de um pedido de compra — bloco de identificação do cabeçalho, tabela de itens, rodapé com condições de pagamento e totais — independentemente de como um fornecedor específico organiza esses elementos.
Exporte para Excel e comece a conciliar com as faturas
Baixe os resultados mesclados como um arquivo Excel (XLSX). Agora você tem uma linha por item de PO, com cada campo na sua própria coluna — pronto para importar no seu software de contabilidade ou para conciliação com VLOOKUP no seu livro de faturas. A planilha pode ser importada diretamente no Yayoi (弥生会計), freee, MoneyForward Cloud Accounting (マネーフォワード クラウド会計) ou Kanjo Bugyo (勘定奉行) — os softwares que as equipes japonesas de compras e contabilidade realmente usam no dia a dia. Com os dados de PO estruturados em colunas limpas, a etapa de conciliação vira uma comparação coluna a coluna: PO Number da extração contra PO Number no livro de faturas, Line Amount contra o valor faturado, Quantity contra a quantidade entregue. Um relatório de divergências em vez de cinquenta verificações manuais.
O mesmo esquema de colunas funciona no mês seguinte, para POs de novos fornecedores que você integrar e para POs arquivados de exercícios fiscais anteriores (決算年度) que você é legalmente obrigado a reter por sete anos conforme a lei do imposto corporativo (法人税法) e por dois anos conforme a Lei de Subcontratação. Um fornecedor pode mudar o formato do PO ao atualizar o ERP — os nomes de coluna que você definiu não se importam.
Os arquivos são processados com segurança e não são armazenados.
Os Campos Onde a Extração Genérica Falha — e Como Lidar com Eles
Três pontos de dados em um pedido de compra japonês resistem mais à extração automática do que os demais — não porque sejam difíceis de ler, mas porque contêm lógica de negócios embutida que a extração deve preservar em vez de achatar.
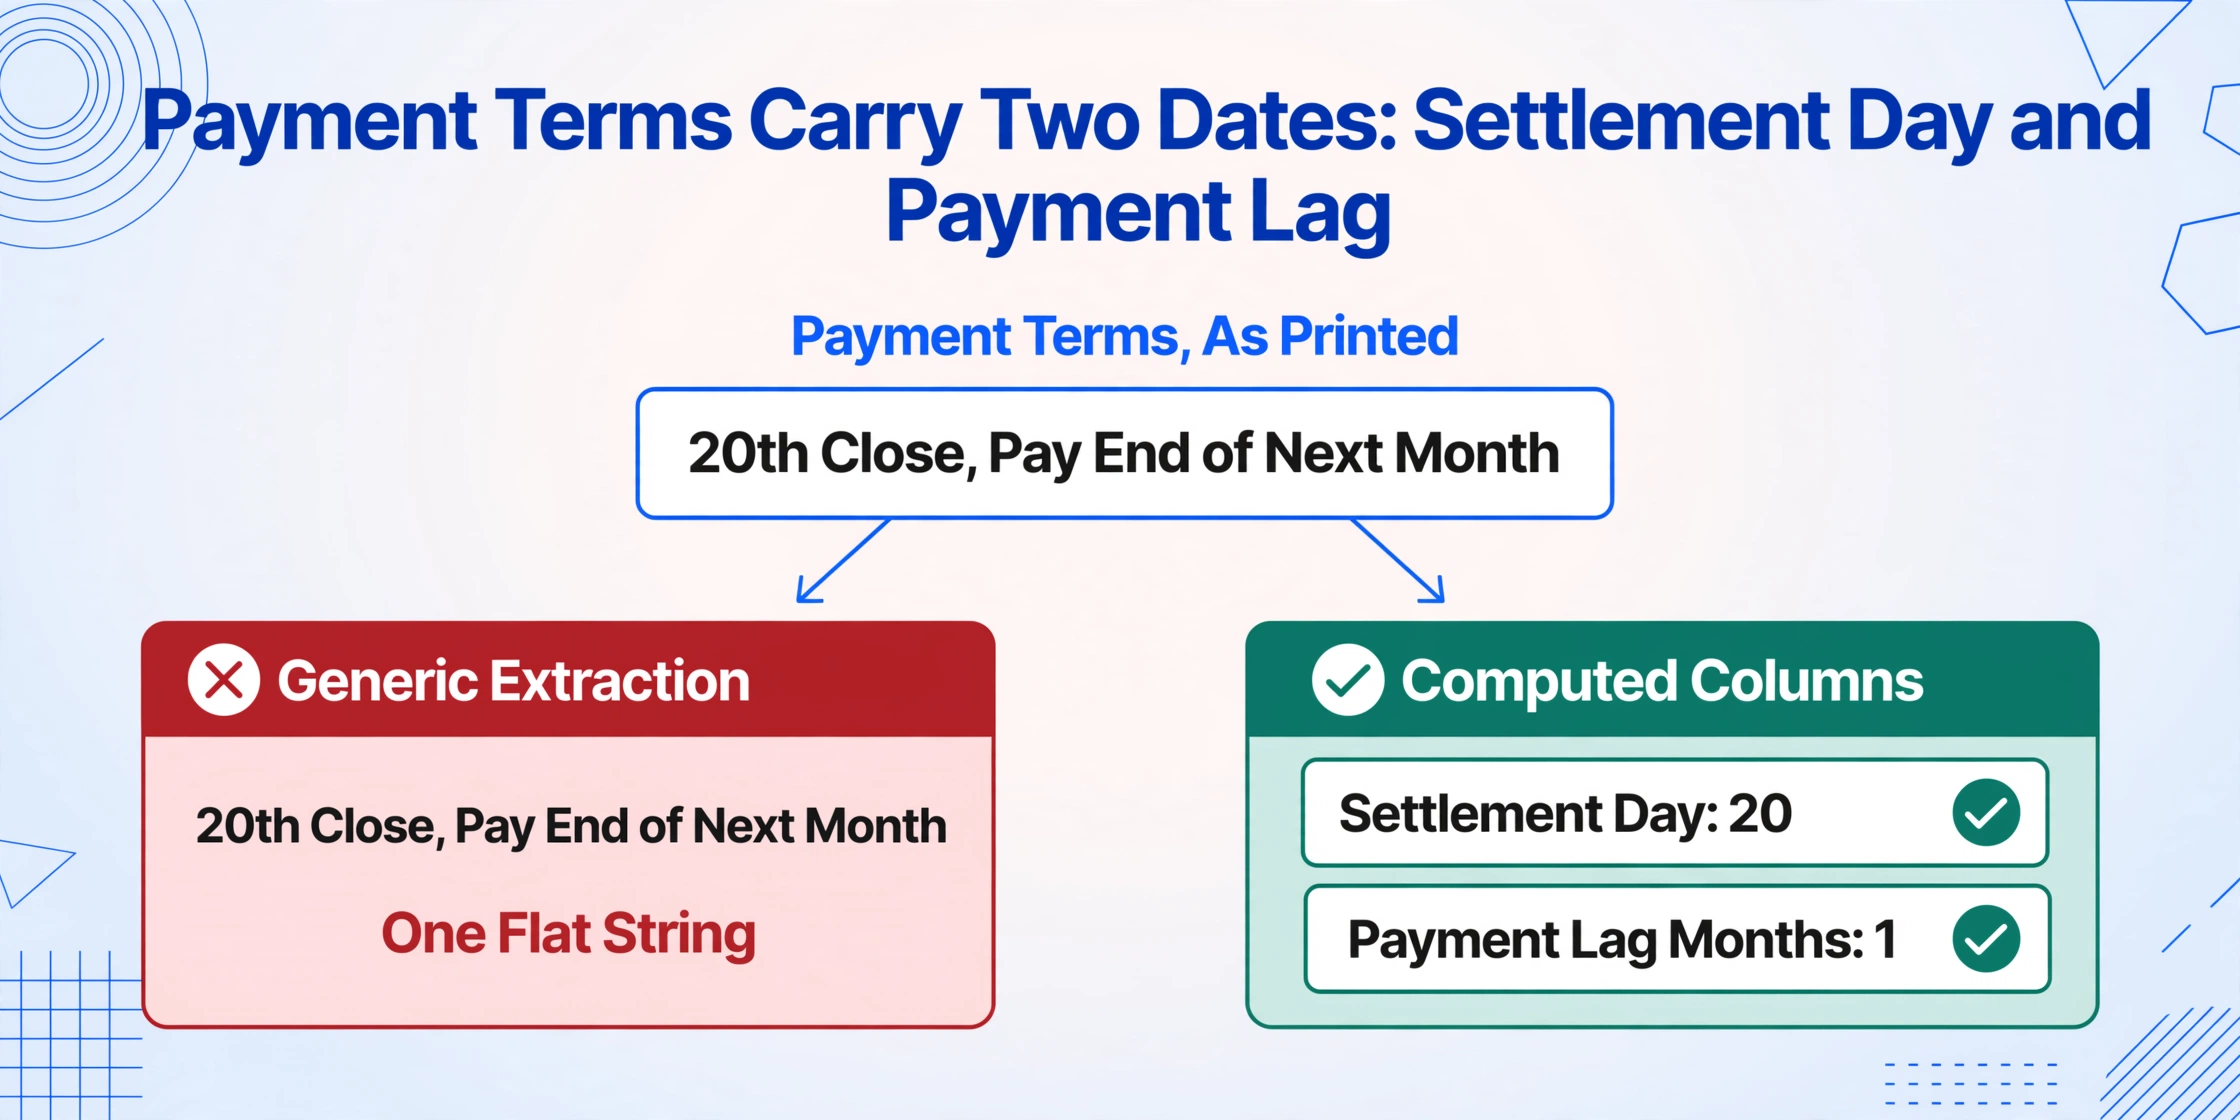
Condições de Pagamento (支払条件) — da string de texto à data de liquidação
Uma condição de pagamento em uma ordem de compra japonesa é uma expressão composta compacta: "20日締翌月末払い" ou "月末締翌々月末払い" ou "納品後60日以内." Cada uma codifica duas informações: quando o período de faturação é encerrado (o 締日, ou dia de fechamento) e quando o pagamento vence em relação a esse encerramento. Uma equipe de procurement que compara ordens de compra com faturas precisa de ambos os dados em colunas separadas — o dia de fechamento para verificar que o período de faturação da fatura está alineado com a ordem de compra, e o atraso de pagamento para verificar que a data de vencimento da fatura é correta.
A extração genérica produz estes como uma única string de texto indiferenciada. Uma coluna calculada — uma coluna cujo valor a IA calcula durante a extração em vez de ler diretamente do documento — resolve isso. Defina uma coluna como Dia de Fechamento (extraer o número do dia das Condições de Pagamento; se "20日締" então 20, se "月末締" então 31) e uma segunda coluna como Meses de Atraso de Pagamento (das Condições de Pagamento; se "翌月末払い" então 1, se "翌々月末払い" então 2). A IA analiza a convenção japonesa de condições de pagamento e produz valores estruturados sobre os quais uma fórmula pode calcular.
Classificação do Imposto sobre Consumo (消費税区分) — correspondência multi-alíquota
O sistema de imposto sobre consumo de dupla alíquota do Japón significa que uma única ordem de compra pode conter itens de linha a 10%, 8% e isentos de imposto. A fatura deve separar o imposto por categoria de alíquota para cumprir com o Sistema de Fatura Qualificada (インボイス制度) que entrou em vigor em outubro de 2023. Se a extração da ordem de compra não preserva quais linhas são tributadas a qual alíquota, o total de imposto da fatura não pode ser verificado contra a ordem de compra — a equipe de procurement está aprovando um pagamento sem poder confirmar o cálculo do imposto.
A solução é uma coluna inferida — uma coluna cujo valor a IA infiere do contexto em vez de ler de um campo rotulado. Defina Classificação do Imposto (opções: 10% Standard, 8% Reducido, Isento de Imposto) — determine a partir da descrição do item. Itens de alimentos/bebidas → 8% Reducido. Bens standard → 10%. Itens de exportação ou explicitamente marcados como não tributáveis → Isento de Imposto. A IA lee cada descrição de item de linha e atribuye a classificação correta do imposto durante a extração, de modo que a planilha de saída chega com as categorías de imposto já preenchidas — pronta para verificação de total agrupado por alíquota.
Local de Entrega (納入場所) — granular, variável, crítico
Os locais de entrega em ordens de compra (POs) de manufatura japonesa são exclusivamente específicos: "〇〇株式会社 埼玉工場 第二組立課 B棟3階" refere-se a um prédio, andar e departamento específicos dentro de um complexo fabril. Essas strings variam em comprimento e detalhe entre fornecedores, são frequentemente abreviadas (埼玉工場 → 埼工) e são uma chave de consulta para o agendamento de produção interno. Um local de entrega corrompido ou truncado — "〇〇株式会社 埼玉工場 第二組立課 B棟" com o andar ausente — envia materiais para o cais de recebimento errado. A extração deve preservar a string completa como impressa, incluindo caracteres kanji que mecanismos de OCR sem modelos de idioma japonês frequentemente leem incorretamente (工場 vs 工塲, 棟 vs 楝).
Por que isso importa para a correspondência: Esses três campos — condições de pagamento, classificação do imposto sobre consumo, local de entrega — não são decorativos. São os campos que determinam se um par PO-fatura correspondido é financeiramente válido, processualmente correto (prazo de pagamento) e operacionalmente entregável (local). Uma extração que os capture com precisão é a diferença entre um fluxo de conciliação que leva minutos e um que ainda exige que um humano revise cada linha.
Como Levar Dados de PO Extraídos para Softwares de Contabilidade Japoneses
O resultado de um trabalho de extração é uma planilha. O destino é o software de contabilidade ou compras onde a correspondência acontece. Veja como o pipeline se conecta às ferramentas que as empresas japonesas realmente usam.
Yayoi (弥生会計 / 弥生販売) — o líder de participação de mercado em contabilidade para PMEs japonesas. Os produtos desktop e em nuvem da Yayoi aceitam importação de CSV para lançamentos contábeis e dados do razão de compras. Os cabeçalhos de coluna da sua extração tornam-se o mapeamento de campos para a importação: Número do PO → 伝票番号, Data → 日付, Fornecedor → 仕入先, Valor → 金額. Yayoi Sales (弥生販売), o produto complementar para gestão de compras e estoque, importa dados de ordens de compra diretamente para seu módulo de compras — um pipeline dedicado que reduz a etapa de extração para importação a um upload de arquivo.
freee — a plataforma de contabilidade em nuvem usada por mais de 70.000 PMEs japonesas. A API e a importação de CSV do freee suportam o registro de transações de compra com geração automática de lançamentos contábeis (自動仕訳). Dados de PO extraídos com classificação do imposto sobre consumo por item alimentam diretamente o relatório de imposto sobre consumo do freee, que suporta os cálculos da alíquota padrão de 10% e da alíquota reduzida de 8% exigidos para conformidade com o Sistema de Fatura Qualificada.
MoneyForward Cloud Accounting (マネーフォワード クラウド会計) — o principal concorrente do freee, com o maior número de conexões de API com instituições financeiras no Japão (2.451+). O módulo de gestão de compras do MoneyForward aceita importação de CSV; dados de PO extraídos com nomes de fornecedores e valores preenchem o razão de compras diretamente. A conciliação bancária automática da plataforma corresponde registros de pagamento extraídos contra feeds bancários — fechando o ciclo da extração de PO à verificação de pagamento.
Kanjo Bugyo (勘定奉行) — o pacote contábil da OBC, dominante em empresas japonesas de médio porte (receita anual ¥500M–5B). O módulo de compras do Kanjo Bugyo suporta importação em lote de dados de PO, com especial destaque na alocação de custos por departamento (部門別原価管理) — se seus POs contêm códigos de departamento ou centros de custo, esses campos fluem automaticamente para relatórios segmentados de P&L.
O ponto em comum: toda plataforma contábil japonesa importante aceita importação de dados estruturados. O gargalo nunca foi a capacidade de importação — sempre foi obter os dados do PO em formato estruturado em primeiro lugar. Depois que você tem colunas limpas no Excel, a importação é um upload de arquivo ou um copiar-e-colar.
Perguntas Frequentes
É possível ler pedidos de compra manuscritos enviados por fax de fornecedores?
Sim. Fornecedores japoneses, especialmente pequenos fabricantes e empresas comerciais, frequentemente enviam por fax POs manuscritos ou parcialmente manuscritos — itens e quantidades escritos com caneta esferográfica e carimbados com o selo da empresa (社判). O modelo de IA lê caracteres japoneses manuscritos, incluindo kanji abreviados comuns em jargão de compras (㈱ para 株式会社, No. para 番号). Para faxes muito degradados — granulação do papel, inclinação, sangramento de tinta — a saída pode exigir verificação pontual de caracteres difíceis. Digitalizar a 300 dpi ou mais melhora a precisão para documentos originados de fax.
E se um único pedido de compra tiver várias páginas?
Carregue todas as páginas do PO em um único lote. O mecanismo de extração trata várias páginas do mesmo arquivo como um documento contínuo — os campos de cabeçalho (número do PO, fornecedor, data) são extraídos uma vez, e os itens de linha de todas as páginas são coletados no mesmo conjunto de linhas. Para POs de fax com várias páginas onde a página de continuação não tem cabeçalho — apenas uma tabela de itens de linha continuando da página anterior — a extração preserva a continuidade associando todos os itens ao número do PO identificado na primeira página.
Funciona se cada fornecedor usar um formato de PO diferente?
Sim — esta é a vantagem definitiva da extração semântica sobre o OCR baseado em modelo. Uma ferramenta baseada em modelo exige que você crie e mantenha um modelo de análise separado (definindo coordenadas de zona ou rótulos de campo) para cada formato de fornecedor. Quando um fornecedor altera o layout do PO — como acontece quando atualizam seu ERP ou redesenham seu papel timbrado — o modelo quebra e precisa ser reconstruído. A extração semântica lê o documento entendendo o que cada dado é, não onde ele aparece na página. Um número de PO é um número de PO, seja impresso no canto superior direito de um PO da Mitsubishi Chemical ou no centro inferior do fax manuscrito de um subcontratado local.
Como a extração lida com a divisão do imposto sobre consumo de 8% e 10%?
O sistema de alíquotas duplas do imposto sobre consumo do Japão exige que as faturas discriminem o imposto por categoria de alíquota. Para a extração de pedidos de compra, se você adicionar uma coluna que especifique a lógica de classificação do imposto — por exemplo, Alíquota de Imposto (opções: 8%, 10%, Isento) — classificar com base na descrição do item — a IA avalia cada item de linha e atribui a alíquota correta durante a extração. Itens alimentícios e jornais assinados recebem 8%; todo o resto recebe 10%; transações de exportação e itens explicitamente isentos recebem "Isento". Os dados extraídos chegam com as alíquotas já atribuídas, prontos para o cálculo total agrupado por alíquota que corresponde à discriminação do imposto na fatura. Esta é uma coluna inferida — a alíquota não está impressa no pedido de compra, mas é derivada da descrição do item pela IA durante a extração.
O mesmo fluxo de trabalho pode lidar com outros documentos de compras japoneses?
A abordagem do esquema de colunas se aplica a toda a cadeia de documentos de compras. Para cotações (見積書): extraia fornecedor, item, preço unitário e período de validade — compare com o pedido de compra para verificar se o preço pedido corresponde ao preço cotado. Para notas de entrega (納品書): extraia as quantidades entregues — compare com as quantidades do pedido de compra para identificar remessas com falta antes da chegada da fatura. Para faturas (請求書): extraia os valores cobrados e a discriminação do imposto — compare com os dados do pedido de compra para verificar antes da aprovação do pagamento. A mesma plataforma de extração lida com todos os quatro tipos de documento, e a mesma lógica de nomenclatura de colunas se aplica: defina os campos que você deseja, e a IA os localiza pelo significado. Abordamos fluxos de trabalho relacionados a documentos em nosso guia sobre extração de dados de cadernetas bancárias japonesas, o fluxo de trabalho de extração do BAS australiano e a extração de dados da declaração de GST/HST canadense.
De Pedidos de Compra em Papel a Lançamentos Conciliados
A cadeia de documentos de compras japonesa — cotação, pedido de compra, nota de entrega, fatura — foi projetada para um mundo onde cada documento era lido por um humano que entendia as convenções. O pedido de compra diz "20日締翌月末払い" e o humano sabe que isso significa pagamento até o final do mês seguinte ao dia 20 do mês de faturamento. A fatura abrevia o nome do item e o humano sabe que se refere ao mesmo produto no pedido de compra. A classificação do imposto está implícita na descrição do item e o humano a mapeia mentalmente. O atrito na digitalização de compras nunca foi a falta de estrutura desses documentos — eles são altamente estruturados — mas sim que a estrutura depende do contexto compartilhado entre leitores humanos, e uma máquina que não tem acesso a esse contexto interpreta mal a estrutura.
A extração de pedidos de compra que lê o significado do campo, em vez de sua posição, fecha essa lacuna. O número do pedido de compra se torna uma chave de consulta, em vez de um erro de OCR. As condições de pagamento se tornam duas colunas — dia de fechamento e prazo — em vez de uma única string distorcida. A classificação do imposto se torna uma coluna preenchida, em vez de uma dor de cabeça durante a revisão da fatura. A equipe de compras recupera o tempo que agora gasta redigitando, e o fluxo de trabalho de conciliação — o ponto de controle que protege o caixa da empresa — fica mais rápido e confiável.