6가지 인보이스 데이터 입력 실수: 재무팀이
생각보다 더 많은 비용을 초래합니다
AP 관리자에게 오류율을 물어보면 대부분 숫자를 말할 수 있습니다: 2%, 어쩌면 5%. 그 오류가 실제로 얼마나 비용을 초래하는지 물어보면 대답은 모호해집니다. $14,000 인보이스가 $14,400으로 입력되면 $400 차액보다 훨씬 더 많은 비용이 발생합니다. 수정, 전화, 취소, 조정 항목의 연쇄 반응을 일으켜 원래의 오타를 훨씬 넘어서는 비용이 누적되기 때문입니다. 재무팀이 저지르는 최악의 데이터 입력 실수는 다음 주에 발견하는 실수가 아닙니다. GL 코딩 오류와 세금 분류 실수는 감사관이 6개월 후에 발견할 때까지 장부에 조용히 남아 있습니다. 여기 가장 많은 비용을 초래하는 6가지 실수와 숨은 실수가 명백한 실수보다 더 아픈 이유가 있습니다.
주요 요점
- 오류율은 드러나는 것보다 더 많은 것을 숨깁니다. 눈에 보이는 전위 오류는 일주일 안에 ERP(전사적 자원 관리 시스템)에서 발견되지만, GL(총계정원장) 코딩 오류와 세금 분류 오류는 감사관이 6개월 후에 발견할 때까지 조용히 남아 있습니다.
- 교육만으로는 이 격차를 해소할 수 없습니다. 인보이스를 입력하는 AP(미지급금) 담당자는 올바른 코드를 선택할 세무 전문성이 부족하고, 세무 팀은 인보이스가 이미 장부에 반영될 때까지 볼 수 없습니다.
- ImageToTable.ai는 대부분의 오류를 유발하는 전사 단계를 제거합니다. 원하는 열 이름(인보이스 번호, GL 코드, 세금 처리)을 입력하면 AI가 문서를 읽어 각 행을 채우므로 담당자가 다시 입력하는 대신 값을 확인하기만 하면 되어 오류율이 3-5%에서 0.8% 미만으로 줄어듭니다.
대부분의 AP 팀은 오류율을 알고 있습니다. 그러나 그 비용이 얼마인지 아는 팀은 거의 없습니다.
전체 송장의 거의 절반(49.7%, Ardent Partners 데이터 기준)이 여전히 수동으로 처리되고 있습니다. 수동 입력의 오류율은 재무관리연구소(IOFM) 및 Vic.ai 연구에 따르면 대략 2~5%입니다. 즉, 월 2,500건의 송장을 처리하는 팀은 매달 50~125건의 오류를 발생시키고 있는 셈입니다.
대부분의 AP 팀이 저지르는 실수는 오류 자체를 측정하지만 복구 비용은 측정하지 않는다는 점입니다. 오류는 단순히 셀에 잘못된 숫자가 입력된 것 이상입니다. 누군가 불일치를 발견하는 순간 일련의 작업이 시작됩니다. 그리고 아무도 발견하지 못한 오류는 분기마다 누적되어 감사 지적, 세금 패널티 또는 재무 재작성으로 이어집니다.
업계는 이러한 방향성을 알고 있습니다. Stampli 및 Probolsky Research에 따르면 조직의 70%가 AP 오류율 5% 이상을 보고하며, 단일 송장 오류를 해결하는 데는 종단 간 대략 2시간이 소요됩니다. 연간 500건의 오류라면 1,000시간, 즉 정규 직원 1명의 절반에 해당하는 시간이 전적으로 발생하지 않았어야 할 오류를 수정하는 데 소비되는 것입니다.
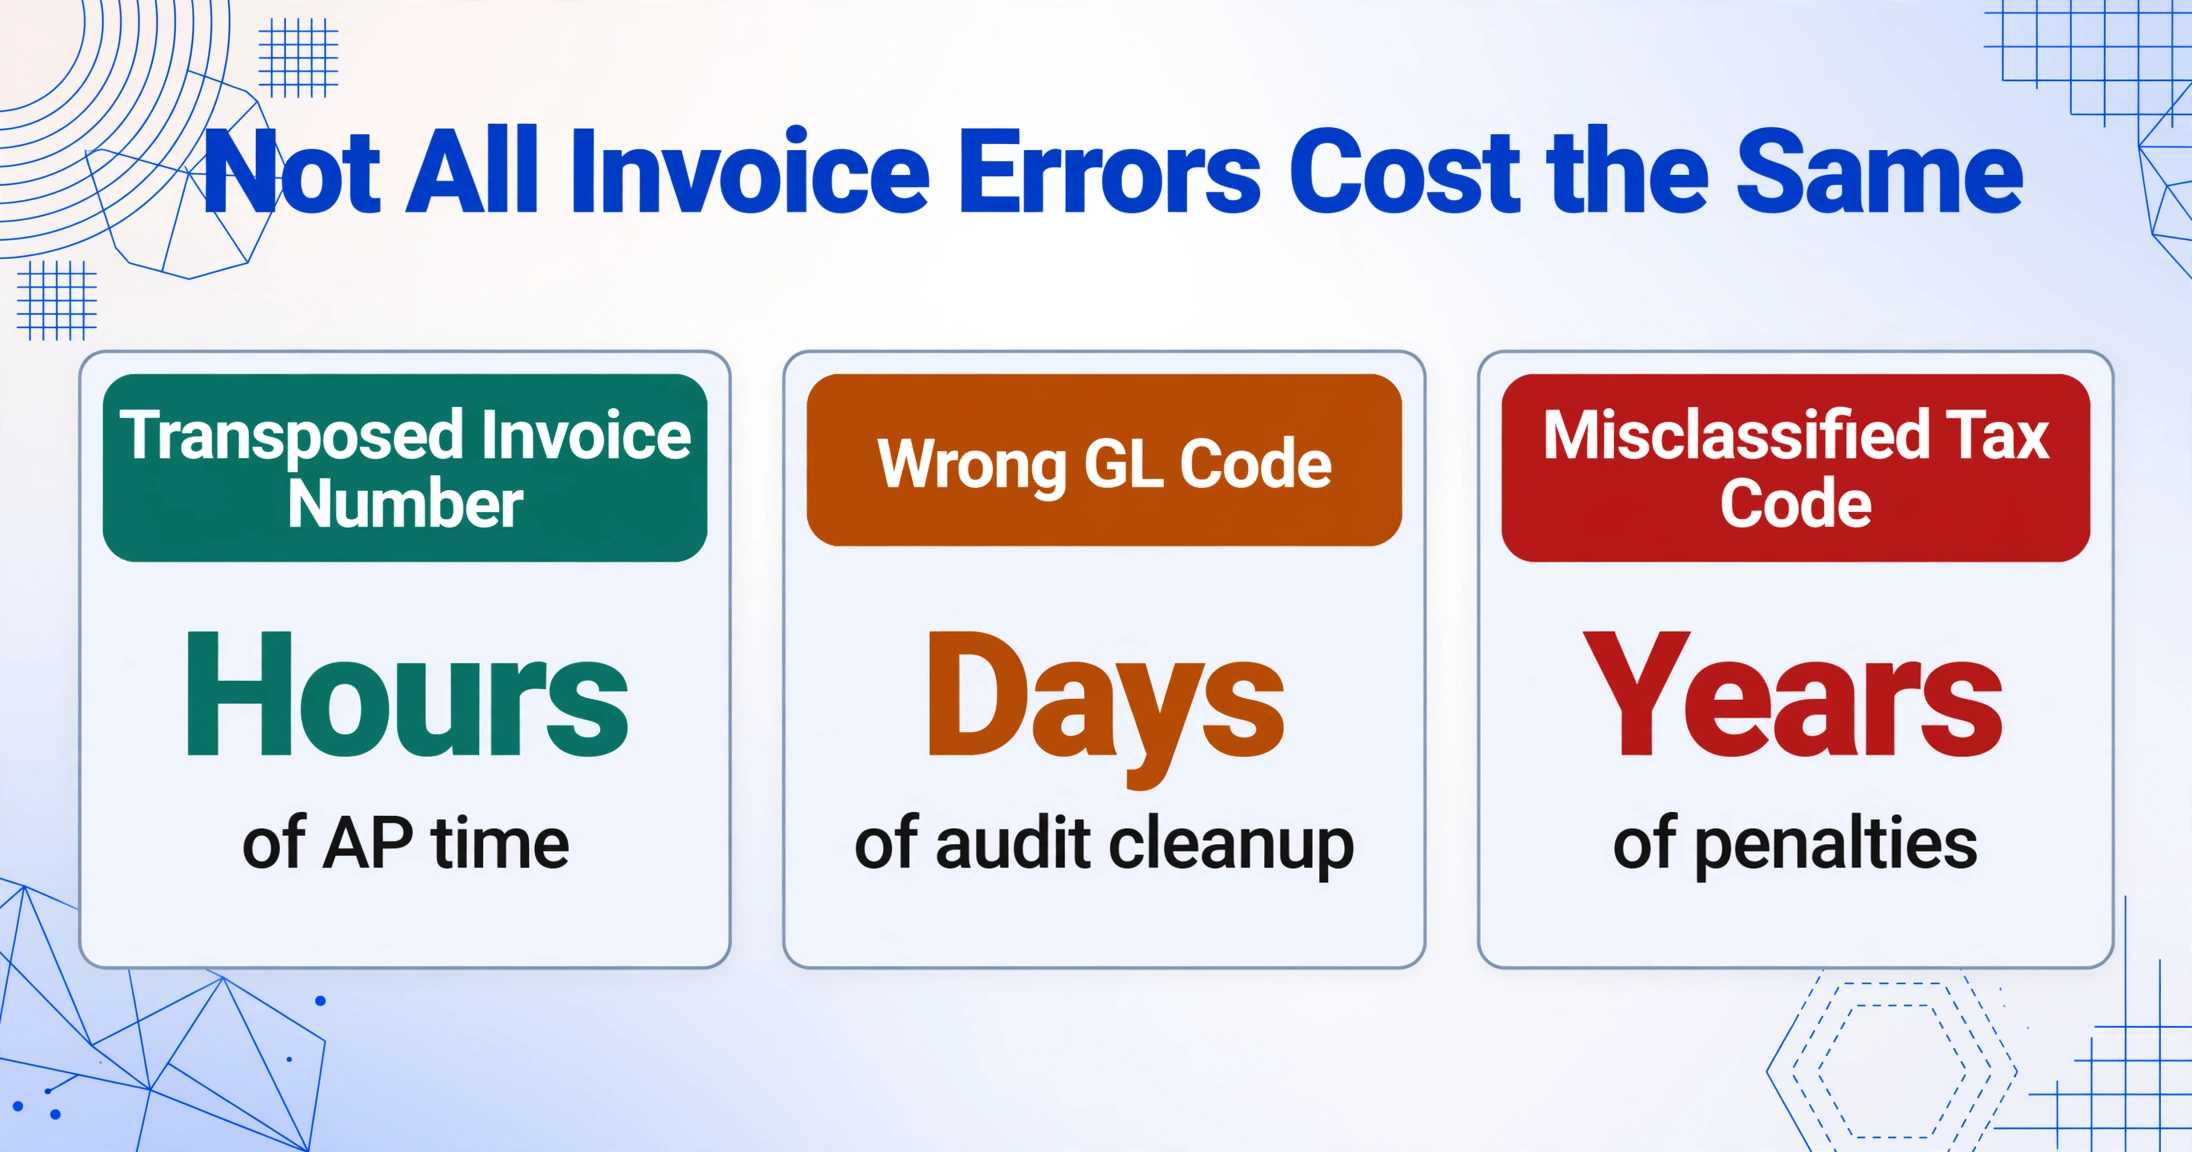
그러나 비용 구조는 일률적이지 않습니다. 오류 유형에 따라 후속 영향이 다릅니다. 송장 번호 전위 오류는 몇 시간이 소요됩니다. 잘못된 GL 코드는 며칠간의 감사 정리가 필요합니다. 잘못 분류된 세금 코드는 수년에 걸쳐 측정되는 패널티로 이어질 수 있습니다.
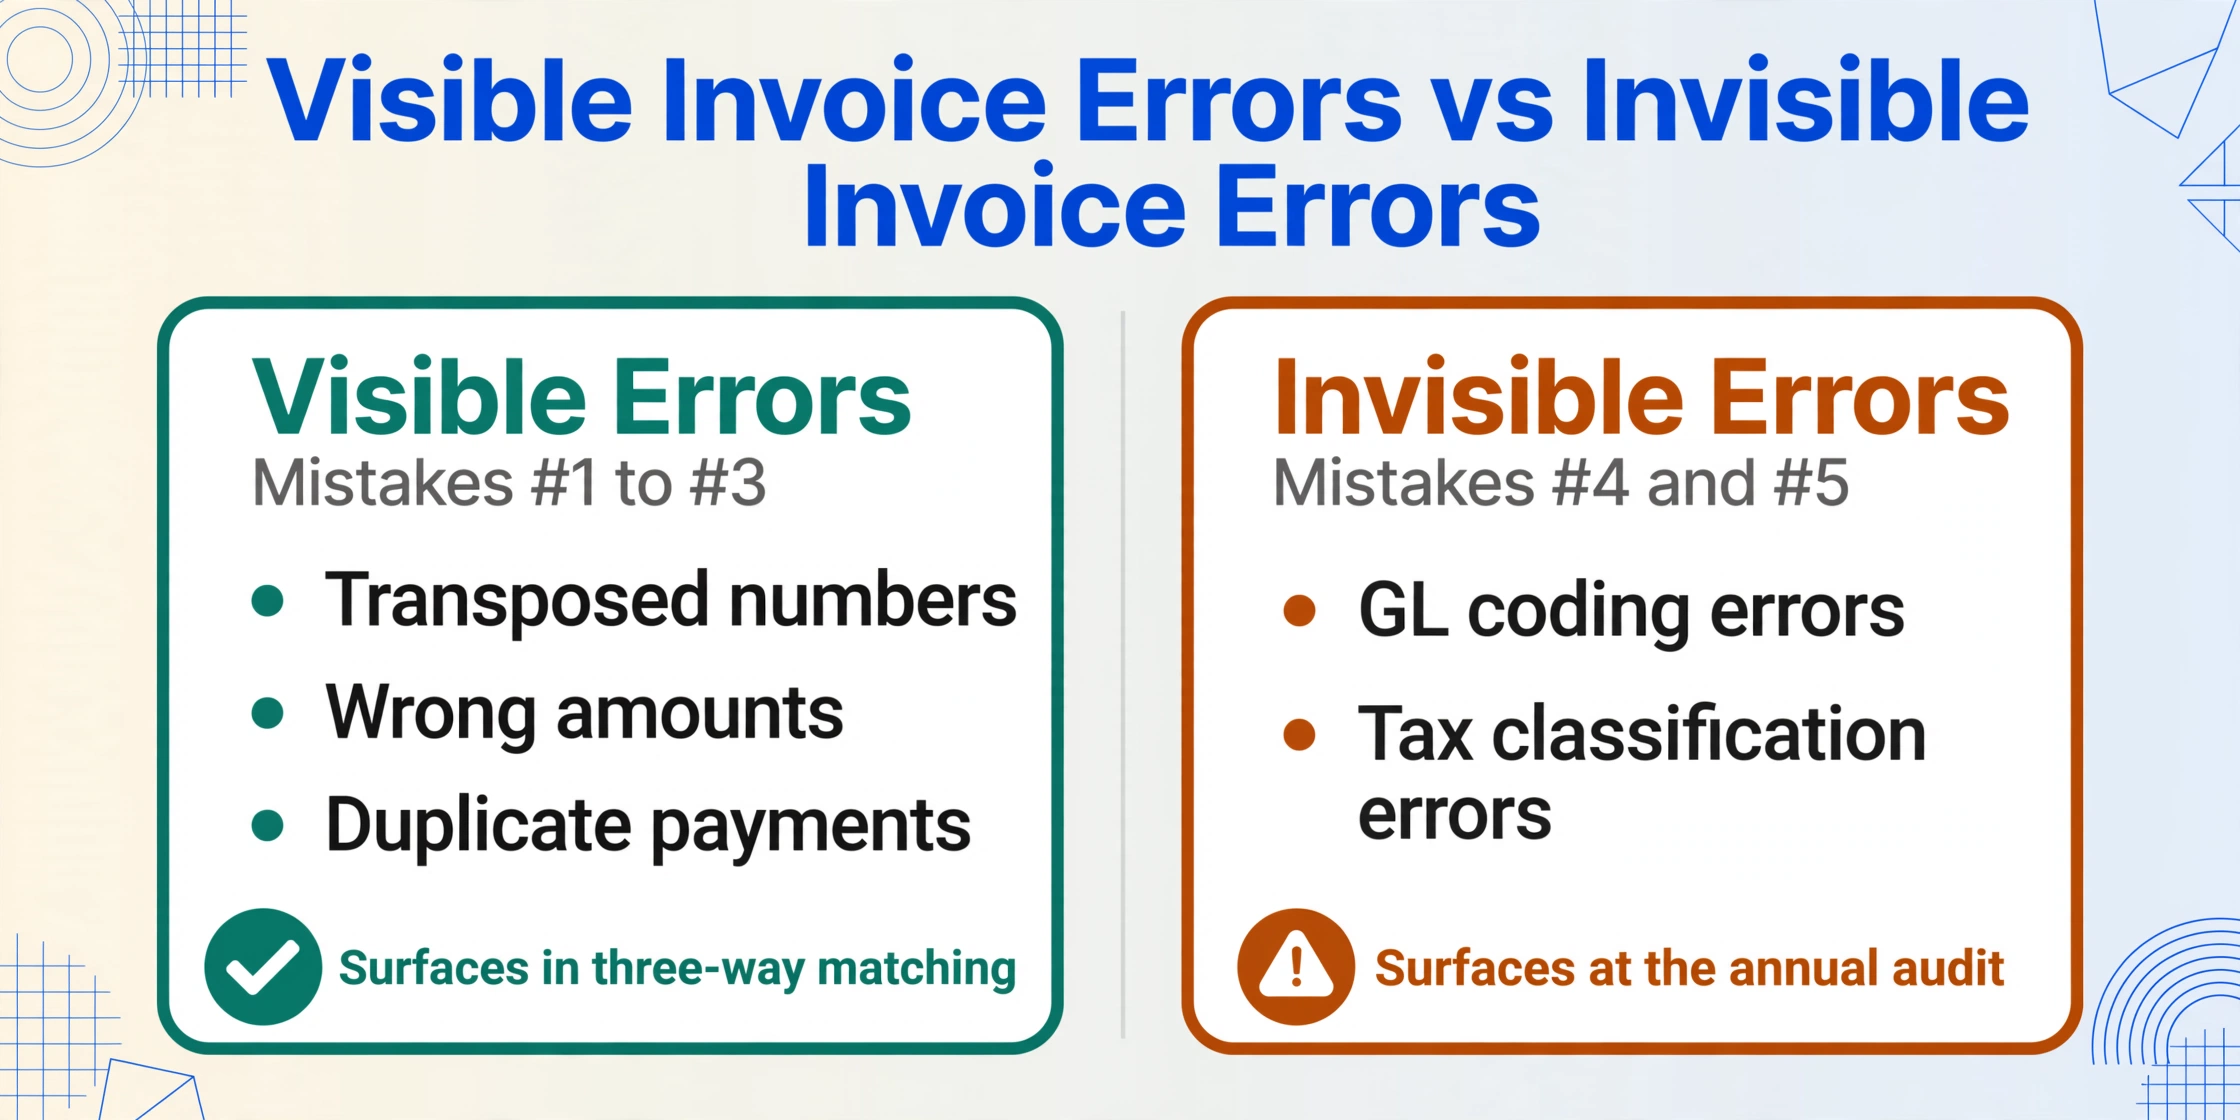
오류 #1–3: 눈에 보이는 오류 — 숫자 전위, 잘못된 금액, 중복 지급
이것들은 팀이 알고 있는 오류입니다. 3자 매칭, 지급 검토 또는 공급업체 문의 중에 표면화됩니다. 눈에 보이고, 발견 가능하며, 수정할 수 있지만 — 수정 비용 자체는 대부분의 팀이 계산하지 않는 방식으로 비쌉니다.
오류 #1: 숫자 전위 및 입력 오류
송장 번호 INV-2456이 INV-2465가 됩니다. $17,820이 $17,280이 됩니다. PO 번호에 숫자가 하나 추가되거나 빠집니다. 이러한 오류는 수동 입력에서 끊임없이 발생합니다 — SoftCo가 인용한 Gartner 설문조사에 따르면 회계사의 18%가 매일 오류를 범하고, 33%가 매주 여러 건의 오류를 범합니다. ERP에서 올바른 위치의 단일 키 입력 오류가 연쇄적으로 발생합니다:
- 발견 (15분) — 3자 매칭이 불일치를 표시하거나, 공급업체가 부족 지급에 대해 연락하거나, 배치 합계가 조정되지 않음
- 조사 (30분) — AP 담당자가 원본 송장 PDF를 꺼내 ERP 입력과 비교하고, 불일치를 단일 필드로 추적
- 수정 (10분) — 잘못된 금액을 취소하고 올바른 금액을 다시 입력하는 분개 입력
- 통보 (15분) — 지급이 이미 이루어진 경우, 공급업체에 대변 메모를 보내거나 상황을 설명하는 후속 전화
전위 오류당 총 복구 비용: AP 시간 약 70분, 여기에 공급업체와의 관계 손상이 추가됩니다. 완전 적재 기준 시간당 $30으로 계산하면 오류당 $35입니다. 월 25~50건의 오류로 곱하면, 단일 AP 담당자의 전위 오류만으로도 월 $875~$1,750의 비용이 발생합니다 — 오류가 잘못된 지급으로 이어진 경우의 후속 영향을 계산하기 전입니다.
오류 #2: 잘못된 금액 — 과소 지급 및 과다 지급
전위와 다릅니다 — 이는 송장 총액이 올바르게 입력되었지만 라인 항목이 잘못 분류되었거나, 잘못된 세율이 적용되었거나, 적용되었어야 할 할인이 누락된 경우입니다. AP 팀은 송장 금액은 정확히 알고 있지만 구성이 잘못된 것입니다.
이 오류는 발견하기 더 어렵기 때문에 비용 구조가 달라집니다. 3자 매칭이 통과할 수 있습니다 — PO 수량이 일치하고, 송장 총액이 일치하지만, 한 라인 항목이 계약된 단가 $12 대신 $14/단위로 책정되어 있습니다. 시스템 플래그가 발생하지 않습니다. 오류는 두 달 후 예산 담당자가 부서 지출을 검토하면서 1월 주문이 예상보다 17% 초과한 이유를 질문할 때만 표면화됩니다.
여기서 시간 지연 패널티가 작용합니다. 1주차에 발견된 오류는 수정에 70분이 소요됩니다. 3개월 차에 발견된 오류는 원래 70분에 더해 감사 추적 재구성 30분, 부서장에게 Q1 예산 차이 보고서가 잘못된 이유를 설명하는 20분, 그리고 초과 지급이 환불 대신 향후 송장에 대체 적용되어야 하는 경우 공급업체 협상까지 추가됩니다. $35의 전위 비용은 지연된 오분류 오류당 약 $60~$80이 됩니다 — 그리고 이것들이 모든 구매에서 조용히 마진을 잠식하는 오류입니다.
실수 #3: 중복 청구서와 이중 지불
모든 AP 관련 기사가 가장 먼저 다루는 실수이며, 그럴 만한 이유가 있습니다. 단순한 노동 시간이 아닌 실제 현금이 소요되기 때문입니다. 공급업체가 원본 청구서를 배송과 함께 보내고 이메일로 사본을 추가 발송합니다. 두 건 모두 약간 다른 참조 번호로 입력됩니다. 두 건 모두 지불됩니다. 회수하려면 공급업체에 연락해 대변 메모나 환불을 요청해야 하며, 일회성 공급업체의 경우 돈을 빨리 돌려줄 인센티브가 없는 업체를 상대해야 할 수도 있습니다.
Westgate Moore의 설문조사에 따르면 재무 전문가의 92%가 중복 지불과 초과 지불이 업계에서 여전히 흔하다고 답했습니다. 중복 지불된 금액의 평균 회수율은 완전하지 않습니다 — 공급업체와의 거래가 지속되는 경우 대변 메모는 그들의 장부에 남아 향후 청구서와 상계됩니다. AP 팀은 여전히 중복 건을 발견, 확인, 해결하는 데 시간을 소비했습니다. 그리고 공급업체와의 관계가 일회성이라면 현금은 영영 돌아오지 않을 수 있습니다.
구조적 원인이 실수 자체보다 더 중요합니다. 중복 지불이 발생하는 이유는 동일한 물리적 청구서가 여러 경로를 통해 처리 대기열에 들어가기 때문입니다 — 공급업체의 이메일, 공급업체의 우편, 요청 부서의 업로드 — 그리고 수동 조정은 참조 번호가 일치하지 않아 중복을 발견하지 못합니다. 해결책은 "더 주의하자"가 아닙니다. 동일한 청구서가 처리 대기열에 두 번 도달할 수 없도록 접수 경로를 통합하는 것입니다.
눈에 보이는 실수는 공통점이 하나 있습니다: 모두 결국 적발된다는 것입니다 — 매칭 시스템, 공급업체 불만, 또는 월말 조정을 통해서요. 비용은 수정 노동으로 측정됩니다. 다음 범주는 다릅니다. 이러한 실수는 스스로 드러나지 않습니다. 장부에 조용히 남아 있으며, 가장 먼저 발견하는 사람은 대개 감사 체크리스트를 들고 있는 사람입니다.
오류 #4–5: 눈에 보이지 않는 오류 — GL 코딩 및 세금 분류
오류 #4: 총계정원장(GL) 코딩 오류
모든 인보이스 라인 항목에는 GL 코드가 필요합니다. GL 코드는 계정과목표에서 비용을 올바른 계정에 매핑하는 영숫자 식별자입니다(예: "사무용품" 대 "IT 서비스" 대 "시설 유지보수"). AP 담당자가 코드를 수동으로 입력하거나 — 전월의 유사한 인보이스에서 코드를 복사하거나 — 잘못 입력하면, 그 오류는 지급 시스템에 보이지 않습니다. 인보이스는 지급됩니다. 금액은 정확합니다. 공급업체는 만족합니다. 하지만 비용은 잘못된 보고 항목에 기록됩니다.
비용은 월말 마감 때까지 드러나지 않습니다. 재무팀이 부서 예산을 조정할 때 IT 지출은 예산 미만, 시설 지출은 예산 초과임을 발견하지만 — 어느 쪽도 경보를 울릴 만큼 크지 않고, 둘 다 보고된 수치를 틀리게 만들 만큼 큽니다. 또는 더 나쁘게는 연간 감사 중에 외부 감사인이 비용 분류 표본을 검사하다 체계적인 오분류를 발견할 때 드러납니다. 오분류된 인보이스 하나는 재분류 분개입니다. 오분류된 인보이스 20개는 중요한 취약점 발견입니다. 여러 기간에 걸친 GL 코딩 오류 패턴은 감사 의견을 지연시키고 확장된 테스트를 촉발하는 종류의 발견입니다 — 회사는 이를 감사 시간으로 비용을 지불합니다.
GL 코딩 오류는 다중 법인 또는 다중 부서 조직에서 특히 위험합니다. 공유 서비스 인보이스 — 엔지니어링과 마케팅이 모두 사용하는 클라우드 호스팅, 또는 세 개의 다른 원가 중심부를 위한 사무용품 — 는 여러 GL 코드로 분할되어야 합니다. AP 담당자가 전체 인보이스를 잘못된 부서에 배정하면, 두 부서의 예산 보고서가 동시에 반대 방향으로 틀리게 됩니다. 각 부서는 자신의 차이만 볼 수 있고 어느 쪽도 플래그를 트리거할 만큼 크지 않기 때문에 아무도 알아차리지 못합니다.
월말에 발견된 GL 오분류의 수정 비용은 분개 작성에 약 15분입니다. 감사 중에 발견된 GL 오류의 수정 비용은 재분류 분개에 더해 감사인의 확장된 테스트 시간이며, 시간당 $150-$400로 청구됩니다. 담당자가 이전 입력을 복사하는 대신 AI가 라인 항목 설명에서 GL 코드를 지정하는 구조적 예방은 이 비용의 대부분을 차지하는 반복적인 오분류를 제거합니다.
오류 #5: 세금 코드 및 원천징수 오류
이는 거의 모든 AP 팀이 적극적으로 모니터링하지 않는 가장 비용이 많이 드는 오류 범주입니다. 비미국 공급업체의 인보이스는 IRC 섹션 1441에 따른 원천징수 의무를 발생시킵니다. 지급자는 송금 전에 올바른 비율을 공제하고, 양식 1042-S에 원천징수를 보고하고, 올바른 소득 코드로 지급을 분류해야 합니다. 잘못된 세금 코드 — 또는 더 나쁘게는, 원천징수가 필요한데 원천징수를 하지 않는 경우 — 회사가 IRS에 세금을 덜 납부했음을 의미합니다.
IRS는 섹션 1441 준수에 대해 3,000명 이상의 조사관을 특별히 교육했으며, Tipalti의 현재 IRS 집행 태세 분석에 따르면 원천징수 감사를 위한 전담 국가 팀을 만들었습니다. 벌칙은 "사소한 코딩 오류에도 급격히 증가"했습니다. 외국 계약자에 대한 단 한 건의 잘못된 분류 지급도 벌칙, 미납 원천징수에 대한 이자, 그리고 기존에 제출된 정보 보고서를 수정하는 비용을 초래할 수 있습니다 — 이 모든 것이 원래 세금 책임 위에 추가됩니다.
국내 세금 분류 오류는 덜 극적이지만 더 빈번합니다. 사용세가 적용되어야 하는 곳에 판매세가 적용되는 경우, EU 내 공급에 대한 VAT가 국내 세금으로 잘못 코딩되는 경우, 공급업체의 세금 ID에 숫자가 바뀌어 입력되어 IRS가 전자적으로 대조하는 1099에 잘못된 정보가 포함되는 경우가 있습니다. 금액이 정확하더라도 TIN 불일치는 IRS 통지서를 발생시키며, 해당 통지에 대응하는 것은 AP의 시간과 신뢰도를 소모합니다.
세금 코드의 구조적 문제는 GL 코드와 동일합니다: 인보이스를 입력하는 AP 담당자는 각 거래에 어떤 코드가 적용되는지 알 수 있는 세무 전문성이 없고, 세무 팀은 인보이스가 입력된 후에야 볼 수 있습니다. 데이터 입력과 세무 준수 사이의 정보 격차가 근본 원인입니다 — 부주의나 교육 부족이 아닙니다. 그 격차가 해소될 때까지, 세금 코드 오류는 수동 AP의 내장된 기능이지, 수정 가능한 버그가 아닙니다.
실수 #6: 정규화 함정 — 5% 오류율이 기준선이 되는 경우
이것은 데이터 입력 오류가 아닙니다. 다른 모든 오류의 비용을 시간이 지남에 따라 더 크게 만드는 메타 오류입니다. AP 팀의 오류율이 일정 수준에서 안정화되어 몇 달 동안 유지되면, 팀은 더 이상 이를 문제로 인식하지 않습니다. 95%의 정확도는 견고해 보입니다. 월말 마감이 10일 이내에 완료되며, 이는 작년보다 나은 수준입니다. 아무도 문제를 제기하지 않습니다.
하지만 월 2,500건의 송장에서 5%의 오류율은 매월 125건의 오류를 의미합니다. Stampli/Probolsky의 오류 해결당 2시간 추정치를 적용하면 250시간, 즉 약 1.5 FTE가 오류 수정에만 소비됩니다. 월 10,000건의 송장에서는 500건의 오류와 1,000시간이 소요됩니다. 이 규모에서 오류 수정은 더 이상 업무 수행 비용이 아니라 AP 부서에서 가장 큰 단일 활동입니다.
정규화 함정에는 두 번째 차원이 있습니다: 정규화에서 살아남는 오류 유형은 체계적으로 비용이 많이 드는 유형입니다. 전위 오류는 빠르게 발견됩니다. ERP가 즉시 표시하는 매칭 실패와 지급 불일치를 유발하기 때문입니다. GL 코딩 오류와 세금 분류 오류는 자동 플래그를 트리거하지 않습니다. 이들은 월말 마감과 분기 검토를 통과하고, 감사자가 분류 샘플을 테스트할 때만 표면화됩니다. 정규화된 오류율이 80%의 가시적 전위 오류와 20%의 비가시적 GL/세금 오류로 구성된 경우, 20%는 조용히 누적되는 동안 팀은 80%를 잡아낸 것에 대해 스스로를 축하합니다.
정규화 함정은 자기 강화적입니다. 높은 AP 이직률 — Vic.ai의 데이터에 따르면 AP 부서는 다른 재무 기능보다 23% 더 높은 이직률을 보입니다 — 은 신규 직원이 기존 오류 기준선을 "여기서 일하는 방식"으로 물려받게 만듭니다. 마지막 프로세스 재설계를 기억하는 사람이 모두 떠났기 때문에 아무도 오류율에 의문을 제기하지 않습니다. 오류는 예외가 아닌 프로세스가 됩니다.
이러한 오류가 교육, 체크리스트, 2차 검토를 통과해도 살아남는 이유
AP 오류에 대한 일반적인 대응은 "더 나은 교육"과 "검토 단계 추가"입니다. 두 번째 담당자가 첫 번째 담당자의 작업을 확인합니다. 누군가 전기 전에 GL 코드를 검증합니다. 이러한 통제는 합리적이지만 증상만 다룰 뿐 구조적 원인을 해결하지는 못합니다. 송장 데이터 입력 오류는 교육으로 해결할 수 없는 세 가지 조건 때문에 지속됩니다.
조건 1: PDF는 ERP의 기본 데이터가 아닙니다. 모든 송장은 사람이 읽도록 설계된 문서(PDF, 스캔 이미지, 이메일 첨부 파일)로 도착하며 ERP의 구조화된 필드로 옮겨 적어야 합니다. 이 입력 작업은 호환되지 않는 두 형식 간의 수동 변환 단계입니다. 사람이 그 다리 역할을 합니다. 다리는 끊어집니다.
조건 2: 물량이 검토 속도를 따라가지 못합니다. 월 500건의 송장에서는 2차 검토 시스템이 실현 가능합니다. 검토자가 의미 있는 표본을 무작위 점검할 수 있기 때문입니다. 그러나 월 5,000건이 되면 검토자는 거래의 2%만 표본으로 추출하게 됩니다. 그 표본에서 GL 코드 오류를 잡아낼 확률은 거의 0에 가깝습니다. 소규모에서 작동하던 검토 시스템은 대규모에서는 조용히 실패합니다.
조건 3: 데이터를 입력하는 사람에게는 올바르게 입력할 수 있는 맥락이 없습니다. AP 담당자는 "$8,400 — 컨설팅 서비스"라는 송장 라인 항목을 봅니다. IT 컨설팅인가요, 경영 컨설팅인가요? 올바른 GL 코드가 어느 부서가 요청했는지에 따라 달라지나요? 담당자는 알 수 없습니다. 그리고 실제로 아는 사람(예산 담당자)은 다음 달 실적 보고서가 나올 때까지 코딩을 보지 못합니다. 올바르게 코딩하는 데 필요한 정보는 조직 내에 존재하지만 코딩을 수행하는 사람에게 도달하지 못합니다.
이 세 가지 조건은 교육을 받고 신중한 직원을 둔 잘 운영되는 AP 부서에서도 중복 지급, 전위 오류, 코딩 실수가 발생하는 이유를 설명합니다. 이 프로세스는 인간이 잘하지 못하고 기계가 잘하는 일, 즉 비정형 문서를 정형 데이터로 변환하는 작업을 인간에게 요구하도록 설계되어 있습니다.
ERP를 교체하지 않고 오류율 80% 절감
대부분의 AP 오류의 기계적 원인은 ERP나 결제 시스템이 아니라, 송장 데이터가 문서에서 화면으로 이동하는 순간입니다. 바로 이 단계에서 숫자 전위, 잘못된 코드 입력, 중복 입력, 형식 불일치가 발생합니다. 수동 입력 단계를 제거하면 오류가 발생할 기회의 대부분이 사라집니다.
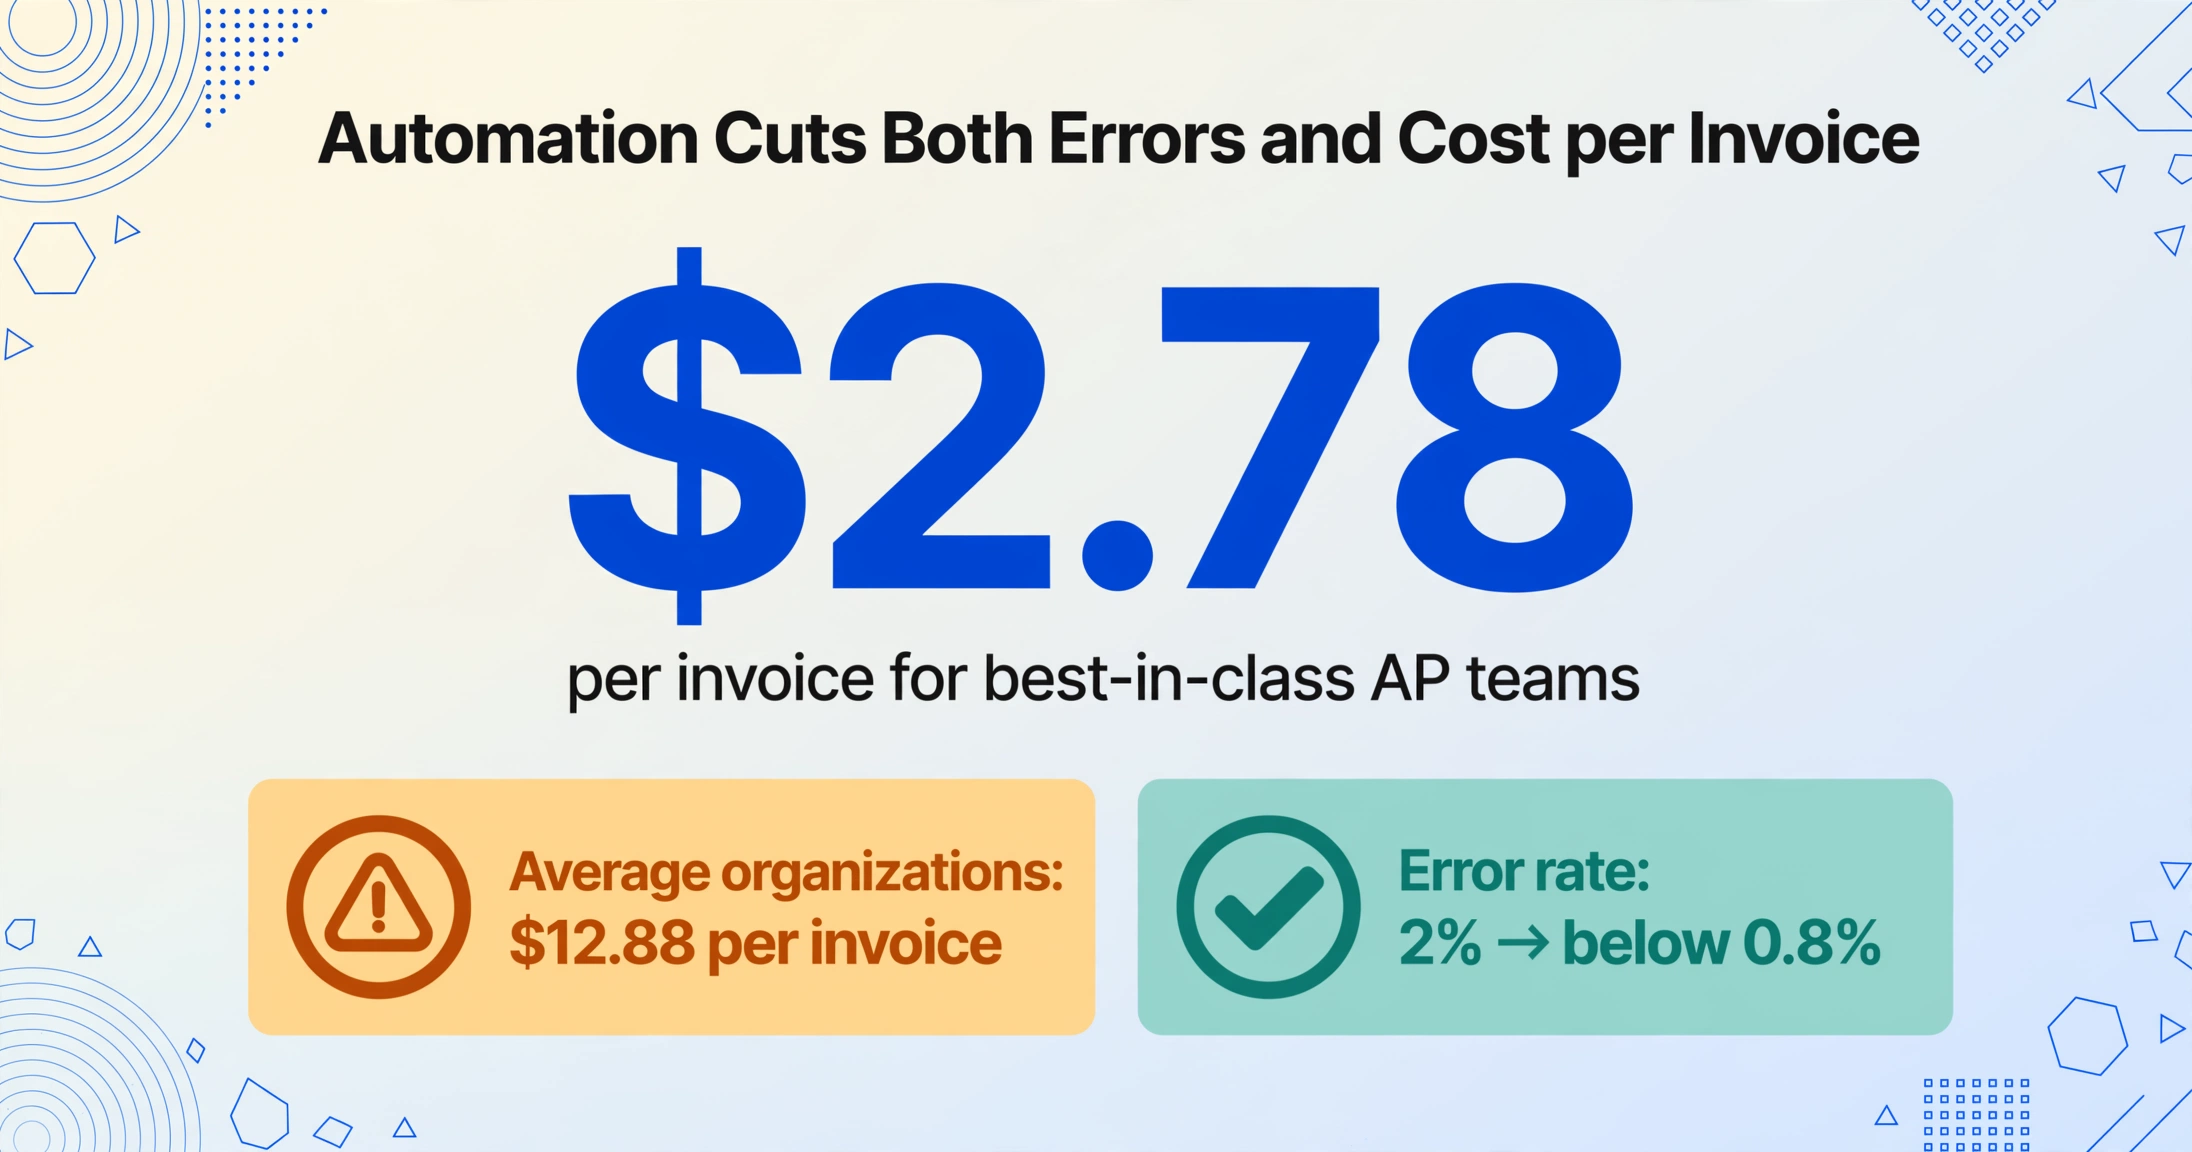
자동 추출은 오류의 원천에서 오류를 제거합니다. AP 담당자가 PDF 송장을 읽고 ERP에 필드를 직접 입력하는 대신, 원하는 열 이름(Invoice Number, Due Date, Line Total, Tax Amount)을 입력하기만 하면 됩니다. 이것이 사용자 지정 열 추출입니다. AI는 값이 페이지에서 어디에 있는지가 아니라 무엇을 의미하는지를 이해하여 각 값을 찾아내므로, 공급업체별 템플릿 없이도 모든 공급업체의 레이아웃에서 동일한 열 세트가 작동합니다. 결과물은 Excel 또는 CSV의 구조화된 행이며, 담당자는 값을 다시 입력하는 대신 추출된 값을 확인합니다. IOFM 벤치마크에 따르면 자동화를 도입한 조직은 오류율을 약 2%에서 0.8% 미만으로 낮춥니다. Quadient의 2025 AP 자동화 벤치마크에 따르면 최고 수준의 팀은 송장당 $2.78로 처리하는 반면, 평균 조직은 $12.88를 지출하며, 이러한 격차는 주로 수동 데이터 입력과 그로 인한 오류를 제거함으로써 발생합니다.
GL 코딩은 추측이 아닌 규칙이 됩니다. GL Code 열을 한 번 정의하고 계정과목표 옵션("Office Supplies", "IT Services", "Facilities Maintenance")을 나열하기만 하면 됩니다. AI는 각 송장의 품목 설명을 읽고 일치하는 코드를 자동으로 채우므로, 새로운 Acme Cloud Services 송장도 지난달과 동일한 코드로 분류되며 이전 항목을 복사할 필요가 없습니다. 이 방법이 모든 오분류를 제거하지는 않습니다. 명백히 모호한 품목은 여전히 사람의 판단이 필요하기 때문입니다. 그러나 반복적인 오분류의 대부분을 만드는 '지난 송장 복사' 습관은 제거합니다.
세금 처리는 기억이 아닌 확인하는 열이 됩니다. 공급업체에 적용되는 처리 방식(국내, EU 역방향 과세, IRC Section 1441 원천징수, 면세)을 Tax Treatment 열에 나열합니다. AI는 공급업체 국가, VAT ID, 송장에 인쇄된 세금 항목을 읽고 일치하는 처리를 지정하므로, 담당자는 200개 공급업체의 세금 상태를 기억하는 대신 제안된 값을 확인하기만 하면 됩니다.
파일 수집은 접수 분산을 제거합니다. 이메일, 우편, 포털, 부서 업로드를 통해 송장이 도착하는 대신, 수집 링크는 모든 공급업체에 단일 업로드 지점을 제공합니다. 파일은 하나의 처리 워크플로우로 하나의 큐에 도착하므로, 중복 지급을 유발하는 다중 접수 조건이 제거됩니다.
실질적인 결과: 월 2,500건의 송장을 3% 오류율로 처리하는 팀의 경우, 자동 추출은 75건의 오류 중 수기 입력 실수로 인한 약 50건을 제거합니다. 나머지 25건은 자동화가 줄여주지만 완전히 제거하지는 못하는 프로세스 오류(잘못된 승인 라우팅, PO 누락)입니다. 팀의 오류 수정 시간은 월 150시간에서 약 30~40시간으로 줄어들며, 이는 신규 채용이나 ERP 교체 없이 0.7 FTE를 회수하는 것과 같습니다.
수동 데이터 입력이 AP의 구조적 병목 현상이 된 이유와 수십 년간의 "더 나은 소프트웨어"에도 불구하고 여전히 지속되는 이유를 더 자세히 알아보려면 2025년에도 AP 팀이 여전히 인보이스 데이터를 수작업으로 입력하는 이유에 대한 분석을 참조하세요. 이러한 오류 감소를 가능하게 하는 추출 도구를 비교하는 방법은 금융 팀을 위한 AI 인보이스 추출 도구 비교를 참조하세요. 또한 AP 볼륨이 증가하고 채용과 자동화 사이에서 결정을 내려야 하는 경우 볼륨 증가에 직면한 AP 팀을 위한 확장 프레임워크를 참조하세요.