손으로 작성한
계산서를 디지털 대장으로 추출하는 방법
계산서는 손글씨가 여전히 기본 기록 방식으로 남아 있는 몇 안 되는 업무 문서 중 하나입니다. 곡물 엘리베이터, 채석장, 고철 야적장, 광산 현장에서 계량 담당자는 트럭이 계량대 위에 있는 동안 운전자 이름, 차량 번호판, 자재, 총중량을 손으로 적습니다. 카본 복사본은 창구를 통해 전달되고, 데이터는 결국 누군가 동료의 손글씨를 읽어내는 능력에 힘입어 스프레드시트에 도달합니다.
핵심 요약
- 손으로 작성한 계산서를 스프레드시트에 입력하는 데 하루 두 시간 — 수확철에는 다섯 시간이 걸립니다. 계량대를 통과하는 모든 트럭이 누군가 눈을 가늘게 뜨고 다시 입력해야 하는 카본 복사본을 만들어내기 때문입니다.
- 기존 OCR은 글자 모양을 읽을 뿐 손글씨는 읽지 못합니다. 계량 담당자가 쓴 “8”처럼 보이는 “6”은 적재량을 2,000 kg 바꿔 놓고, 세 번째 카본 복사본은 너무 흐려서 어떤 OCR 엔진도 쓸 만한 결과를 내지 못합니다.
- AI 추출은 모양이 아니라 의미로 읽습니다. 총중량 칸의 숫자가 총중량임을 알고, 손글씨 품질과 무관하게 값을 찾아내며, 순중량을 즉석에서 계산하여 매일 두 시간 걸리던 작업을 5분의 업로드로 바꿔 줍니다.
계산서 문제
회계나 조달 소프트웨어에서 생성되는 인보이스나 구매 주문서와 달리, 계산서는 보통 저울 표시기 옆의 종이 패드에서 시작됩니다. 계량 담당자가 입차 계량을 기록하고, 트럭이 하역장이나 적재 구역으로 이동한 뒤 출차 계량을 위해 돌아오면, 작업자가 수작업으로 순 적재량을 계산한 후 운전기사에게 계산서를 건넵니다.
계산서의 필기 비율은 대부분의 다른 업무 문서에 비해 매우 높습니다. Scale Manufacturers Association의 2025년 조사에 따르면, 미국의 독립 곡물 엘리베이터 약 60%와 골재 채석장 45%가 여전히 수기 계량표를 주요 계량 기록으로 발급하고 있습니다. 이유는 실용적입니다. 계량소는 종종 먼지와 날씨에 노출된 작은 부스이며, 디지털 발권 시스템은 프린터, 네트워크, 소프트웨어에 대한 투자가 필요해 소규모 사업체는 해마다 도입을 미루고 있습니다.
이로 인해 대부분의 계량 소프트웨어 공급업체가 언급하지 않는 후속 문제가 발생합니다. 종이 계산서가 쌓이는 것입니다. 하루 50대의 트럭을 처리하는 곡물 엘리베이터는 50장의 수기 계산서를 생성합니다. 누군가는 각 계산서를 읽고 계산서 번호, 날짜, 운전기사, 고객, 제품, 총중량, 공차 중량, 순중량 데이터를 스프레드시트나 회계 시스템에 입력해야 합니다. 그리고 그 누군가는 읽을 만한 것부터 거의 해독할 수 없는 것까지 다양한 필기를 처리해야 하며, 특히 카본 복사본인 고객용 사본에서 그렇습니다.
카본 복사본 문제: 수기 계산서는 일반적으로 3장짜리 무탄소 복사 양식입니다. 맨 위 용지(계량소 사본)는 인쇄 상태가 가장 선명합니다. 두 번째 용지(운전기사 사본)는 더 흐립니다. 세 번째 용지(사무실 사본 또는 고객 사본)는 종종 거의 읽을 수 없지만, 바로 이 사본이 디지털 로그로 전사되는 경우가 많습니다.
여전히 수기 계산서로 운영되는 계량 업무를 관리하고 있거나, 디지털화를 기다리는 수년치 종이 기록을 보유하고 있다면, 문제는 디지털 발권으로 전환할지 여부가 아닙니다. 그 결정은 나중에 내려도 됩니다. 문제는 지금 당장 이미 가지고 있는 계산서를 어떻게 처리할지입니다.
계산서에 기록되는 내용
추출을 살펴보기 전에, 일반적인 계산서에 어떤 내용이 담겨 있는지, 그리고 필드 구조가 왜 보기보다 중요한지 이해하는 것이 좋습니다.
표준 계산서에는 다음과 같은 필드가 기능별로 그룹화되어 포함됩니다.
| 필드 그룹 | 필드 | 중요한 이유 |
|---|---|---|
| 헤더 | 계산서 번호, 날짜, 시간(입차 계량 & 출차 계량) | 각 계산서에는 미리 인쇄된 고유 번호가 있습니다. 입차 계량과 출차 계량은 하나가 아닌 두 개의 별도 타임스탬프입니다. |
| 차량 & 운전자 | 차량 번호판, 운전자 이름(서명인 경우도 있음), 운송사 | 번호판은 화물을 차량과 연결합니다. 광산 작업에서는 차량 ID가 트럭별 적재량 추적에 사용됩니다. |
| 자재 & 고객 | 고객/공급업체 이름, 제품/자재 설명, 품목 코드(해당하는 경우) | 농업에서는 곡물 유형(옥수수, 밀, 대두)과 등급이 포함됩니다. 고철에서는 자재 카테고리입니다. |
| 중량 | 총중량(입차 계량), 공차중량(출차 계량 또는 알려진 공차), 순중량(총중량 − 공차) | 이것이 핵심 데이터입니다. 계량 담당자는 트럭이 적재된 상태로 들어올 때 총중량을, 빈 상태로 나갈 때 공차중량을 기록합니다. 적재 작업의 경우에는 반대입니다. |
| 인증 | 계량 담당자 서명 또는 이니셜, 저울 인증 정보 | Legal for Trade 계량은 담당자가 공식 기록으로서 계산서에 서명하거나 이니셜을 기입해야 합니다. |
순중량이 핵심 숫자이며, 보통 계산서를 작성할 때 계량 담당자가 직접 계산합니다. 부정확한 순중량은 단순히 잘못된 데이터를 의미하는 것이 아닙니다. 곡물 및 골재 판매에서는 잘못된 지급, 청구 분쟁, 월말 결산 시의 골칫거리를 의미합니다.
수동 워크플로(그리고 문제가 발생하는 지점)
실제 시나리오를 살펴보겠습니다. 중서부의 중규모 곡물 엘리베이터가 수확철에 하루 50대의 트럭을 받는다고 가정해 보십시오. 계량 담당자는 각 계산서를 손으로 작성합니다. 도착 시 계량, 출발 시 계량을 기록하고 운전기사에게 두 번째 사본을 건넵니다. 하루가 끝나면 사무실 책상 위에 50장의 카본 사본 계산서가 쌓입니다.
일일 마감 루틴은 다음과 같습니다.
- 사무실 관리자든, 파트타임 데이터 입력 담당자든, 누군가가 계산서 더미를 집어 듭니다.
- 각 계산서의 손글씨 필드를 읽고 Excel 스프레드시트나 회계 시스템에 입력합니다.
- 고객별, 곡물 종류별, 일별 입고량의 누계를 수동으로 계산합니다.
- 숫자가 이상해 보이면 — 트럭의 일반적인 적재량과 맞지 않는 순중량, 건너뛴 계산서 번호 등 — 실제 계산서를 찾아 확인해야 합니다.
하루 50장, 계산서당 약 2~3분(읽기, 입력, 확인)이라면 매일 약 두 시간의 데이터 입력이 필요합니다. 수확철에 트럭 물량이 하루 120대 이상으로 정점을 찍으면 데이터 입력에 4~5시간이 걸리거나, 계산서가 쌓여 며칠 늦게 입력되면서 재고 및 지급 추적에 지연이 생깁니다.
이 워크플로에서 일관되게 발생하는 세 가지 문제가 있습니다.
1. 읽기 어려운 필체. 계량 담당자는 먼지 많고 시끄러운 부스에서 교대당 50장 이상의 계산서를 작성합니다. 하루가 끝날 무렵에는 필체가 흐트러집니다. 카본 양식의 세 번째 사본은 첫 번째보다 눈에 띄게 흐립니다. 사무실 사본이 세 번째 사본인 경우 — 흔히 그렇습니다 — 데이터 입력 담당자는 가장 품질이 낮은 필체로 작업하게 됩니다.
2. 중량 값 입력 오류. “6”이 “8”처럼 보이면 적재량이 26,000kg에서 28,000kg으로 바뀝니다. 계산서 한 장에서는 눈에 띄지 않을 수 있습니다. 그러나 한 달 동안 누적되면 추적에 몇 시간이 걸리는 재고 불일치가 발생합니다.
3. 지연된 대사. 데이터 입력이 하루 끝에 몰아서 하는 작업이기 때문에, 계산서는 빠르면 다음 날이 되어야 납품과 대조 검증됩니다. 계량대에서 잡을 수 있었던 불일치 — 운전기사가 공차 중량에 의문을 제기하는 경우 — 는 며칠 후 서류 조사로 이어집니다.
Mettler Toledo, Rice Lake, Avery Weigh-Tronix가 판매하는 계량 티켓 소프트웨어는 앞으로의 문제를 해결합니다. 해당 하드웨어에서 생성된 새로운 계량 기록은 디지털 기록을 생성합니다. 그러나 이러한 시스템 중 어느 것도 이미 상자에 쌓여 있는 계산서나, 완전한 디지털 티켓팅 개조 예산이 없는 운영을 지원하지는 않습니다.
AI로 수기 계산서를 디지털화하는 방법
바로 이 지점에서 AI 기반 문서 추출이 등장합니다. 특히 기존 OCR이 한계를 보이는 계산서에서 이것이 왜 효과적인지 살펴보겠습니다.
기존 OCR은 인쇄된 글자의 모양을 인식하여 문자를 읽습니다. “5”의 윗획이 완전히 닫히지 않으면 OCR은 “6”으로 인식합니다. 수기 텍스트가 서로 붙어 있으면 OCR은 알아볼 수 없는 문자를 만들어냅니다. 수기 계산서, 특히 압력이 고르지 않은 카본 복사지의 경우는 기존 OCR을 혼란스럽게 만드는 대표적인 입력 유형입니다. (수기가 기존 OCR을 깨뜨리는 이유에 대한 자세한 내용은 OCR 수기 인식 실패 원인 분석을 참조하십시오.)
AI 기반 추출, 특히 시각적 대규모 언어 모델은 다르게 작동합니다. 사람이 읽는 방식으로 문서를 읽습니다. 즉, 레이아웃, 필드와 값의 관계, 각 숫자가 나타내는 의미를 이해합니다. 글자 모양을 폰트 데이터베이스와 대조하려 하지 않고, 문서 전체를 해석합니다.
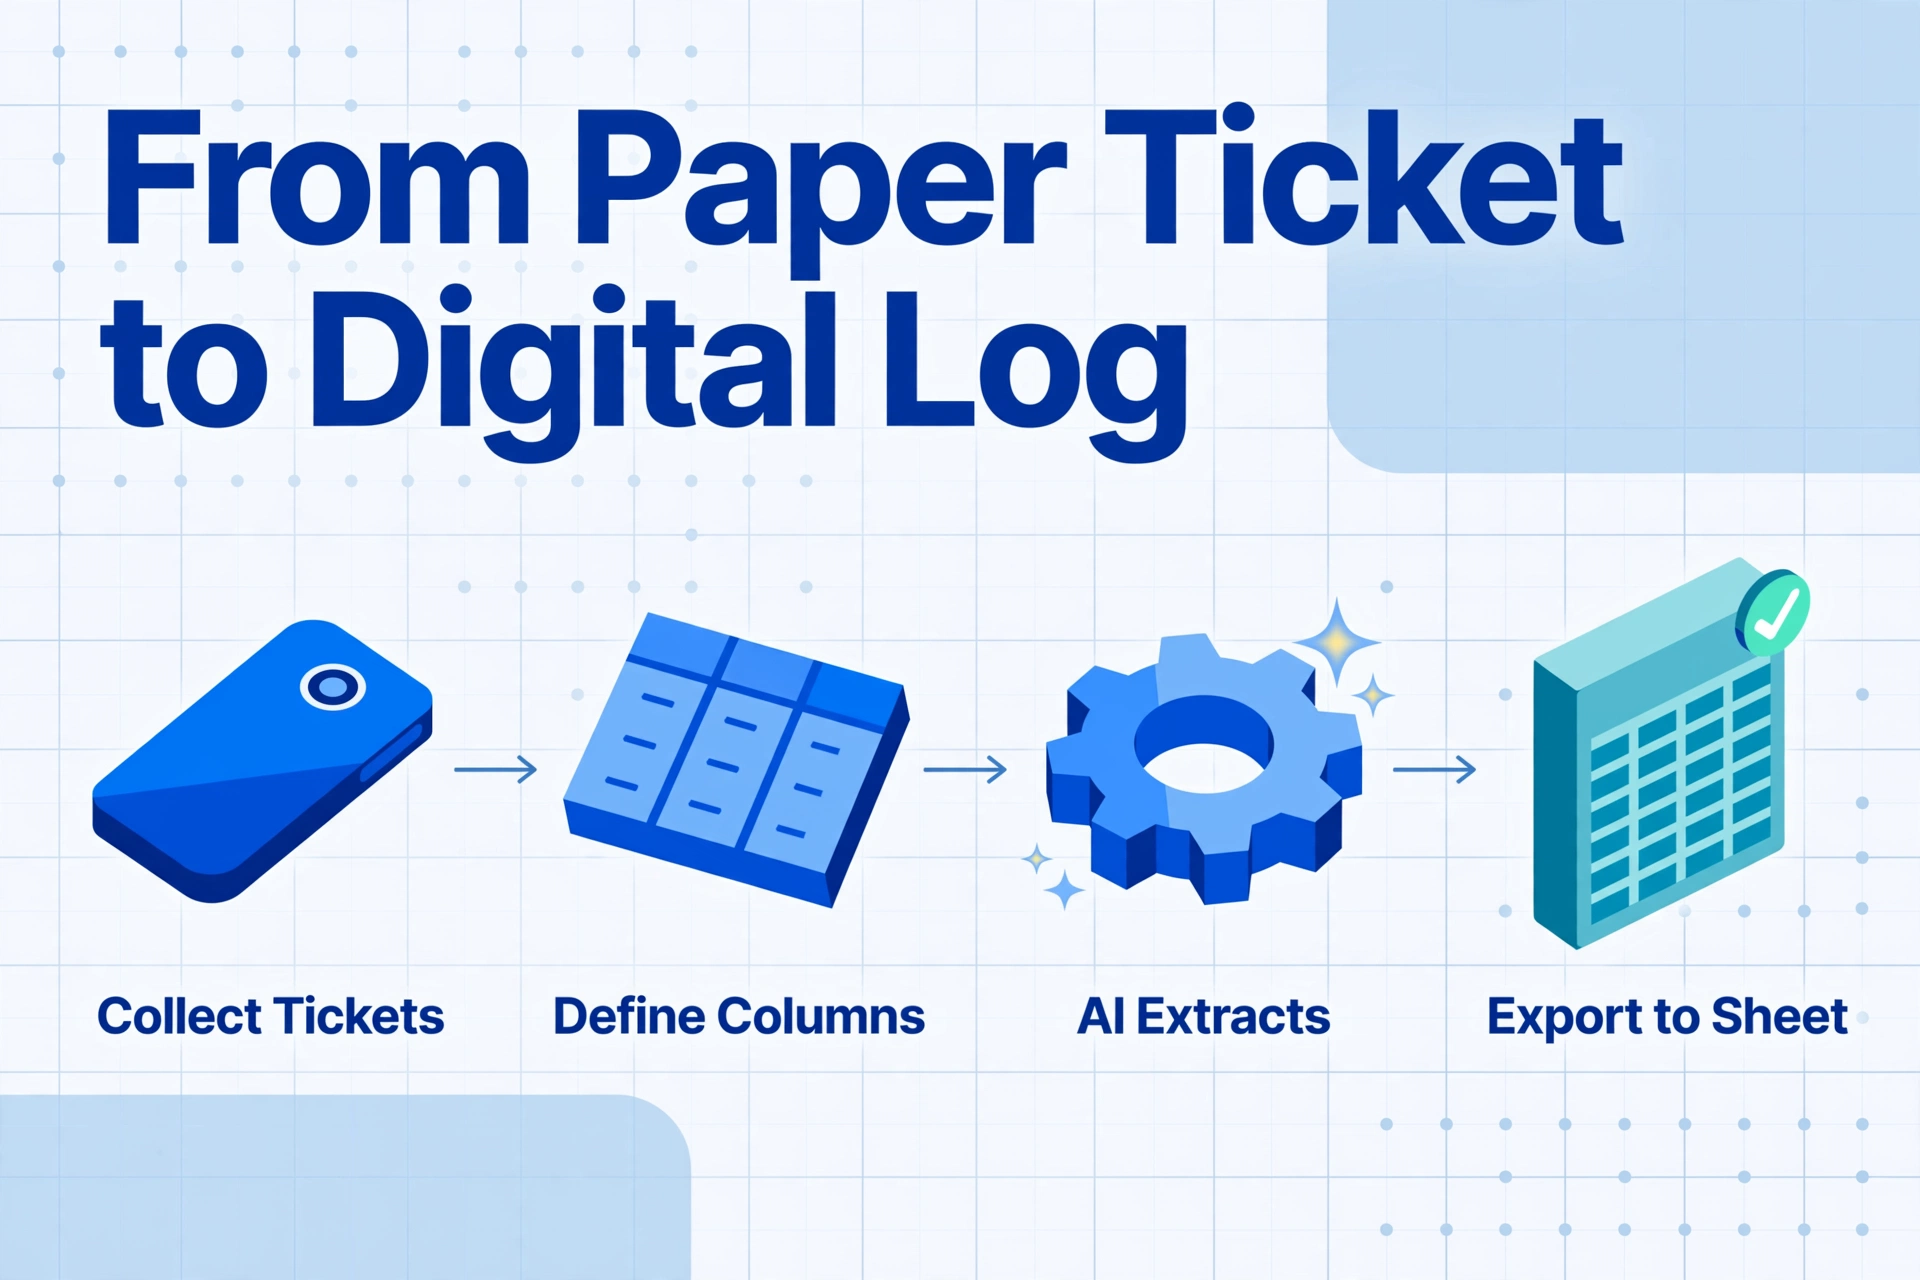
ImageToTable.ai를 사용하여 계산서 더미에 이를 적용하는 방법은 다음과 같습니다.
1단계: 계산서 수집
휴대폰으로 각 계산서를 촬영하거나 PDF 또는 JPG로 스캔하십시오. AI는 PDF, JPG, PNG, WebP 등 모든 일반적인 형식을 지원합니다. 카본 복사지 계산서에서 최상의 결과를 얻으려면 희미한 인쇄가 최대한 대비를 이루도록 균일한 조명 아래에서 촬영하십시오.
2단계: 열 정의하기
필드 주위에 상자를 그리거나 모델을 학습시키는 대신, 출력에 원하는 열 이름을 입력하십시오. 계산서의 경우 열은 다음과 같을 수 있습니다:
- 티켓 번호
- 날짜
- 입차 계량 시간
- 출차 계량 시간
- 차량 번호판
- 운전자 이름
- 고객
- 자재
- 총중량 (kg)
- 공차중량 (kg)
- 순중량 (kg)
- 작업자
이것이 바로 ImageToTable.ai가 맞춤 열 추출이라고 부르는 것입니다: 출력 구조를 정의하면 AI가 값의 위치가 아닌 의미를 이해하여 문서 어디에서든 각 값을 찾아냅니다.
파일은 안전하게 처리되며 저장되지 않습니다.
3단계: 모든 계산서 일괄 처리
모든 사진이나 스캔본을 한 번에 업로드하십시오. ImageToTable.ai가 이를 동시에 처리합니다 — 하루치 계산서 전체를 단일 배치로 처리하는 것입니다. 결과는 계산서당 한 행으로 하나의 테이블에 병합됩니다. 파일을 하나씩 처리할 필요가 없습니다.
4단계: Excel 또는 Google Sheets로 내보내기
출력은 정의하신 열로 구성된 구조화된 테이블입니다. Excel(XLSX), CSV로 내보내거나 — Google Sheets 부가 기능을 사용하신다면 — 아무것도 다운로드하지 않고 활성 스프레드시트에 직접 결과를 작성할 수 있습니다.
시간 차이는 중요합니다: 하루에 두 시간씩 걸리던 수동 데이터 입력이 약 5분의 업로드와 내보내기로 줄어듭니다. 정확도 향상도 마찬가지로 상당합니다. 오후 4시 30분의 지친 데이터 입력 담당자와 달리, AI는 탄소 사본을 읽지 못해 숫자를 바꿔 쓰거나 필드를 건너뛰지 않습니다. 동일한 배치에서 Excel로 이어지는 워크플로는 문서 유형 전반에 적용됩니다 — 문서가 계산서든 인보이스든 원리는 같습니다.
탄소 사본 정확도에 대한 솔직한 참고: 3장짜리 무탄소 양식의 세 번째 사본은 사람과 AI 모두에게 확실히 읽기 어렵습니다. 사무실 사본과 함께 최상단 사본(계량 사본)에 접근할 수 있다면, 더 선명한 버전을 스캔하면 추출 결과가 훨씬 좋아집니다. 희미한 세 번째 사본만 있는 경우 정확도는 떨어지지만, AI는 피로를 느끼지 않기 때문에 일반적으로 같은 출처에서의 수동 전사보다는 여전히 높습니다.
추출 중 순중량 계산 자동화
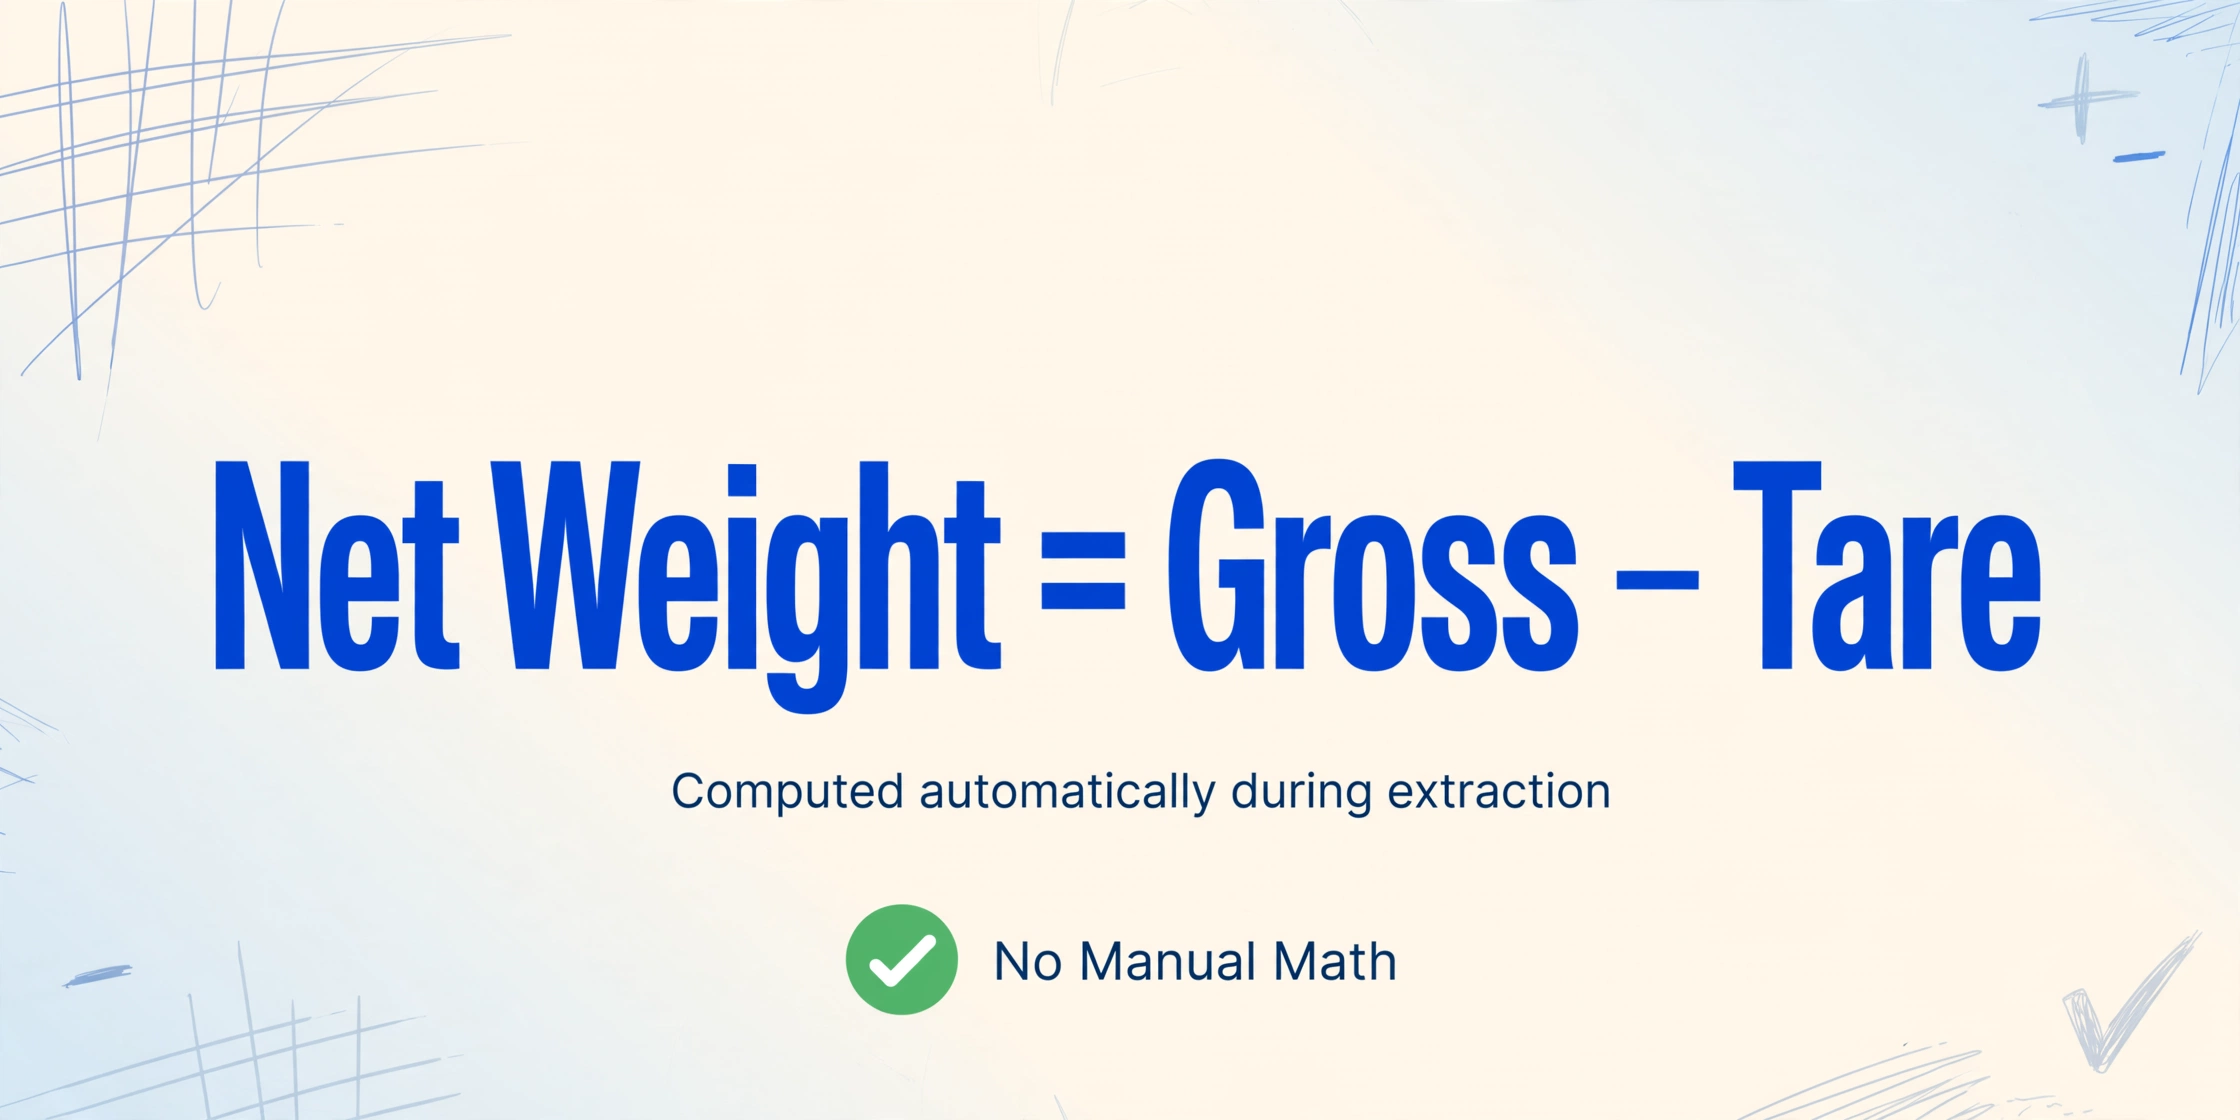
계산서 추출에 가장 유용한 기능 중 하나는 계산 열입니다 — 계산서에서 단순히 읽어내는 것이 아니라 추출 중에 AI가 순중량을 계산하도록 하는 것입니다.
이것이 중요한 이유는 다음과 같습니다: 일부 계산서에는 계량 담당자가 순중량을 미리 계산하여 기재해 둡니다. 다른 계산서에는 총중량과 용기 중량만 있어 나중에 순중량을 계산해야 합니다. 또 다른 계산서에는 무게가 다른 단위로 기록되어 있습니다 — 트럭이 미국 채석장에서 파운드로 계량되었지만 청구 시스템은 미터톤을 기대할 수 있습니다.
ImageToTable.ai의 계산 열을 사용하면 열 이름에 계산식을 정의할 수 있습니다. 예를 들어:
Net Weight (kg) = Gross - Tare— 각 계산서의 총중량에서 용기 중량을 자동으로 뺍니다.Net Weight (tons) = (Gross - Tare) / 2000— 추출 중에 단위 변환을 수행하여 파운드 대신 숏톤을 제공합니다.Gross Weight Check (Gross ≠ Tare + Written Net)— 계산이 맞지 않는 계산서를 표시하여 원본 필기에서의 전사 오류를 빠르게 잡아내는 방법입니다.
이 기능은 추출 워크플로를 바꿉니다: 원시 숫자를 추출한 후 Excel에서 계산하는 대신, 순중량 열에 이미 올바른 값이 들어 있는 바로 사용 가능한 테이블을 얻게 됩니다. 계산서의 총중량이 52,000 lb이고 용기 중량이 28,000 lb라면, 계산 열은 24,000 lb(또는 정의에 따라 12 숏톤)를 출력합니다.
업종별 계량소 티켓 디지털화
계량소 티켓은 업종에 따라 형태가 다르지만, 핵심 추출 워크플로는 동일합니다:
농업 — 곡물 엘리베이터
곡물 엘리베이터는 수확철에 수천 대의 트럭을 처리합니다. 티켓에는 곡물 종류(옥수수, 밀, 대두), 수분 함량, 때로는 등급 요인이 기록됩니다. 많은 엘리베이터는 순중량에 수분 조정을 적용하여 초과 수분의 무게를 지급 중량에서 공제합니다. 계산 열을 사용하면 이를 자동으로 처리할 수 있습니다: Payment Weight (bu) = Net Weight × (1 - Moisture Adjustment). 주요 곡물 취급 기업인 ADM, Cargill, CHS, Bunge는 모두 엘리베이터 네트워크를 운영하며, 특히 소규모 수매 지점에서는 여전히 수기 티켓에 의존하는 곳이 많습니다.
광업 및 채석
채석장과 노천 광산에서 계량소 티켓은 트럭별 광석 또는 골재 적재량을 기록합니다. 화강암 채석장의 덤프트럭은 한 번에 25숏톤을 운반하며, 하루 40회 운행할 수 있습니다. 티켓에는 채굴 구역 또는 계단의 출처, 자재 유형(“2급 쇄석” 또는 “발파 표토”), 그리고 목적지 적치장이 포함됩니다. 광업 운영은 지역에 따라 다른 단위 체계를 사용하는 경우가 많습니다 — 대부분의 국가에서는 미터톤, 미국에서는 숏톤, 일부 영연방 국가에서는 롱톤을 사용합니다. AI는 추출 시 혼합 단위를 처리하여 계량 담당자가 무엇을 기록했든 일관된 출력을 생성합니다.
건설 및 골재
건설 골재 공급업체(Vulcan Materials, Martin Marietta, LafargeHolcim, Cemex)는 각 공장에서 계량소를 운영합니다. 모래, 자갈 또는 아스팔트를 현장에 납품하는 트럭은 납품 영수증으로 계량소 티켓을 받습니다. 티켓의 고객 이름은 건설 프로젝트와 연결되고, 자재 코드는 가격을 결정합니다. 이 티켓을 디지털화하면 프로젝트 수준의 자재 추적이 가능해집니다 — “I-94 확장 프로젝트”와 “Oak Street 교량”에 각각 몇 톤의 “¼인치 세척 자갈”이 투입되었는지 수동 대조 없이 정확히 파악할 수 있습니다.
폐기물 관리 및 스크랩
매립지와 환적장에서는 입출입하는 모든 차량의 무게를 측정합니다. 고철 야적장에서는 철 및 비철 금속 각 적재분의 무게를 측정합니다. 이러한 계산서는 소규모 시설에서 거래량에 대한 유일한 기록인 경우가 많습니다. WM과 Republic Services는 대부분의 계량소를 디지털화했지만, 독립 고철 야적장과 지자체 환적장에서는 여전히 수기로 계산서를 작성하는 경우가 빈번합니다. 이 데이터를 추출하면 일일 처리량 보고서가 생성되며, 그렇지 않으면 하루 종료 시 수동으로 집계해야 합니다.
다른 유형의 문서를 디지털화한 경험이 있다면 — 예를 들어 ERP 시스템 없는 인보이스나 스캔 하드웨어 없는 문서 — 동일한 템플릿 불필요 접근 방식이 계산서에도 적용됩니다. AI는 위치가 아닌 의미로 읽기 때문에 계산서 형식별로 템플릿이 필요하지 않습니다.
FAQ
AI가 카본 복사 계산서에서 데이터를 추출할 수 있습니까?
예, 세 번째 카본 복사본보다 원본 상단 사본에서 더 나은 결과를 얻을 수 있습니다. AI는 계산서의 레이아웃, 라벨과 값의 관계 등 시각적 맥락을 활용하여 사람이 어려워할 수 있는 희미한 인쇄를 해석합니다. 최상의 결과를 얻으려면 직사광선이나 짙은 그늘보다 균일한 조명 아래에서 계산서를 스캔하거나 촬영하십시오.
AI가 동일한 계산서에서 계량 진입과 계량 진출을 모두 처리합니까?
예. 많은 계산서에는 두 개의 섹션이 있습니다. 하나는 최초 계량 진입(적재)용이고 다른 하나는 계량 진출(공차)용입니다. 또는 그 반대일 수도 있습니다. AI는 두 섹션을 모두 읽고 별도의 타임스탬프를 포함하여 두 값 세트를 모두 추출할 수 있습니다. 두 섹션이 서로 다른 계산서에 있지만 동일한 계산서 번호를 공유하는 경우, 추출은 해당 번호를 연결 식별자로 캡처합니다.
계산서에서 서로 다른 단위(lb, kg, 미터톤)를 사용하면 어떻게 됩니까?
AI는 계산서에 기재된 단위를 그대로 읽고 추출된 값에 포함합니다. 계산 열을 사용하여 추출 중에 단위를 변환할 수도 있습니다. 예를 들어 열을 Net Weight (metric tons) = (Gross - Tare) / 2204.62로 정의하여 파운드를 미터톤으로 자동 변환할 수 있습니다.
한 달치 계산서를 한 번에 처리할 수 있습니까?
예. ImageToTable.ai는 단일 배치에서 여러 파일을 동시에 처리합니다. 업로드한 파일 수에 관계없이 배치의 모든 계산서가 계산서당 한 행으로 하나의 출력 테이블에 병합됩니다. 이는 송장 및 기타 대량 문서에 사용되는 것과 동일한 배치 처리 방식입니다.
추출 결과가 청구에 사용할 만큼 정확합니까?
특히 수기 문서의 경우 결과를 청구에 직접 사용하기 전에 검증하는 것이 좋습니다. 추출 정확도 검증에 관한 이 가이드에 설명된 표본 점검 워크플로를 사용하십시오. 대량 처리를 하는 운영의 경우, 추출된 합계를 실제 계산서 샘플과 빠르게 대조하면 모든 행을 확인하지 않고도 신뢰를 얻을 수 있습니다.
계산서가 찢어지거나 얼룩지고 흐릿하게 훼손된 경우에는 어떻게 합니까?
AI는 문서를 전체적으로 읽어 주변 맥락을 활용해 손상된 텍스트를 추론하므로 기존 OCR보다 얼룩지거나 찢어진 계산서를 더 잘 처리합니다. 예를 들어 총중량 부분이 번져 있어도 용기 중량과 미리 계산된 순중량을 읽을 수 있다면 AI가 이를 상호 참조할 수 있습니다. 손상이 심한 계산서의 경우 추출된 값을 수동으로 확인하시는 것이 좋습니다.
계산서 디지털화 시작하기
계산서는 트럭이 계량대에 진입한 이래로 줄곧 수기 문서였습니다. 그렇다고 해서 종이 계산서가 계속 들어오는 한 수동 데이터 입력을 해야 한다는 의미는 아닙니다.
AI 추출은 숙련된 계량 담당자가 읽는 방식으로 각 계산서를 처리합니다 — “총중량” 칸의 숫자가 총중량이고, 운전자 이름 옆의 숫자가 차량 번호이며, 이 둘의 관계가 순 적재량을 산출한다는 것을 이해합니다. 추출은 한 번의 배치로 이루어지고, 결과는 스프레드시트에 저장되며, 예전에 계산서 데이터를 입력하는 데 두 시간을 썼던 사람은 그 시간을 되찾습니다.
이미 다른 현장 문서를 디지털화하고 있다면 — 예를 들어 Google Sheets 부가기능을 통한 계량기 판독 — 동일한 워크플로가 계산서에도 확장됩니다. AI는 오래된 문서 유형과 새로운 문서 유형을 구분하지 않습니다. 페이지에 있는 내용을 읽을 뿐입니다.
수기 계산서를 업로드하고 결과를 확인해 보십시오. 첫 계산서는 10초면 됩니다.