テレグラムの共同購入:
チャットのスクリーンショットから、各購入者の名前・商品・金額を抽出
共同購入の主催者はこう投稿します:「Nikeのランニングシューズを共同購入します—1足$45。サイズはS / M / L / XL。8 pm までに注文を返信してください。」 1時間もすると、50件の返信が並びます:「Lサイズ2足お願いします—後で支払います」「Mサイズ1足—送金済み」「Sサイズ3足—電話番号を送ってください」 1枚のスクリーンショットには、15人分の名前、商品、希望サイズ、数量、支払いメモが、チャットの吹き出しの縦スクロールの中に混ざって詰まっています。データはすべて揃っています。しかし、スプレッドシートにはまったく見えません。
重要なポイント
- 50件の返信が集まる共同購入では、主催者は10〜15分かけて転記します—名前を読み進め、数量を数え、支払いメモを整理し、1行ずつスプレッドシートに入力していきます。
- OCRはスクリーンショット全体を1つのブロックに平坦化します—「Lサイズ2足」「Mサイズ1足・送金」「XLサイズ3足」が、誰がどの注文を送ったのかのつながりがないまま、すべてつなぎ合わされます。
- Visual AIはチャットを会話として読み取ります—メッセージを送信者ごとにグループ化し、同じ人物からの複数の吹き出しにまたがる注文を結合して、購入者ごとに1行のデータを数秒で出力します。
1枚の共同購入スクリーンショットに含まれるもの
Telegramの共同購入スクリーンショットは、書類ではありません。フォームでも、請求書でも、テーブルでもありません。縦に並んだチャットの吹き出しのスレッドです。それぞれが異なる人物に属し、それぞれが注文の一部を担っています。共同購入のスレッドをスクリーンショットすると、同時進行する十数の会話を1つの静止画に収めることになります。
その1枚には、通常以下のものが含まれています。
| 情報レイヤー | 実際のスクリーンショットの例 |
|---|---|
| 主催者のお知らせ | 「Jaket bomber kulit — Rp 350k. Size M/L/XL. Transfer ke BCA 123456 a/n Sari.」 |
| メンバーの返信(10〜30件) | 「2 pcs size L — udah transfer ya」/「1 size M, ambil di tempat」/「3 size XL, bayar pas ambil」 |
| 送信者の身元 | 各吹き出しの上に表示名またはユーザー名 — @rudi_90、@sari_wati、Budi Santoso |
| 支払いメモ | 返信の中に散在 — 「transfer」「pay later」「ambil di tempat」(現地受け取り) |
情報はフィールド単位ではなく、人単位でスレッド化されています。各人の名前、商品の選択、数量、サイズ、支払い意思は、1つ以上のチャットの吹き出しに分散しています。左から右へ、上から下へテキストを読む従来のツールは、混ざり合った返信のブロックを出力するだけです。それが「2 pcs size L」が送信者本人のものであり、上や下の人のものではないことを知る術はありません。
チャットのテキストとスプレッドシートの行が異なる理由
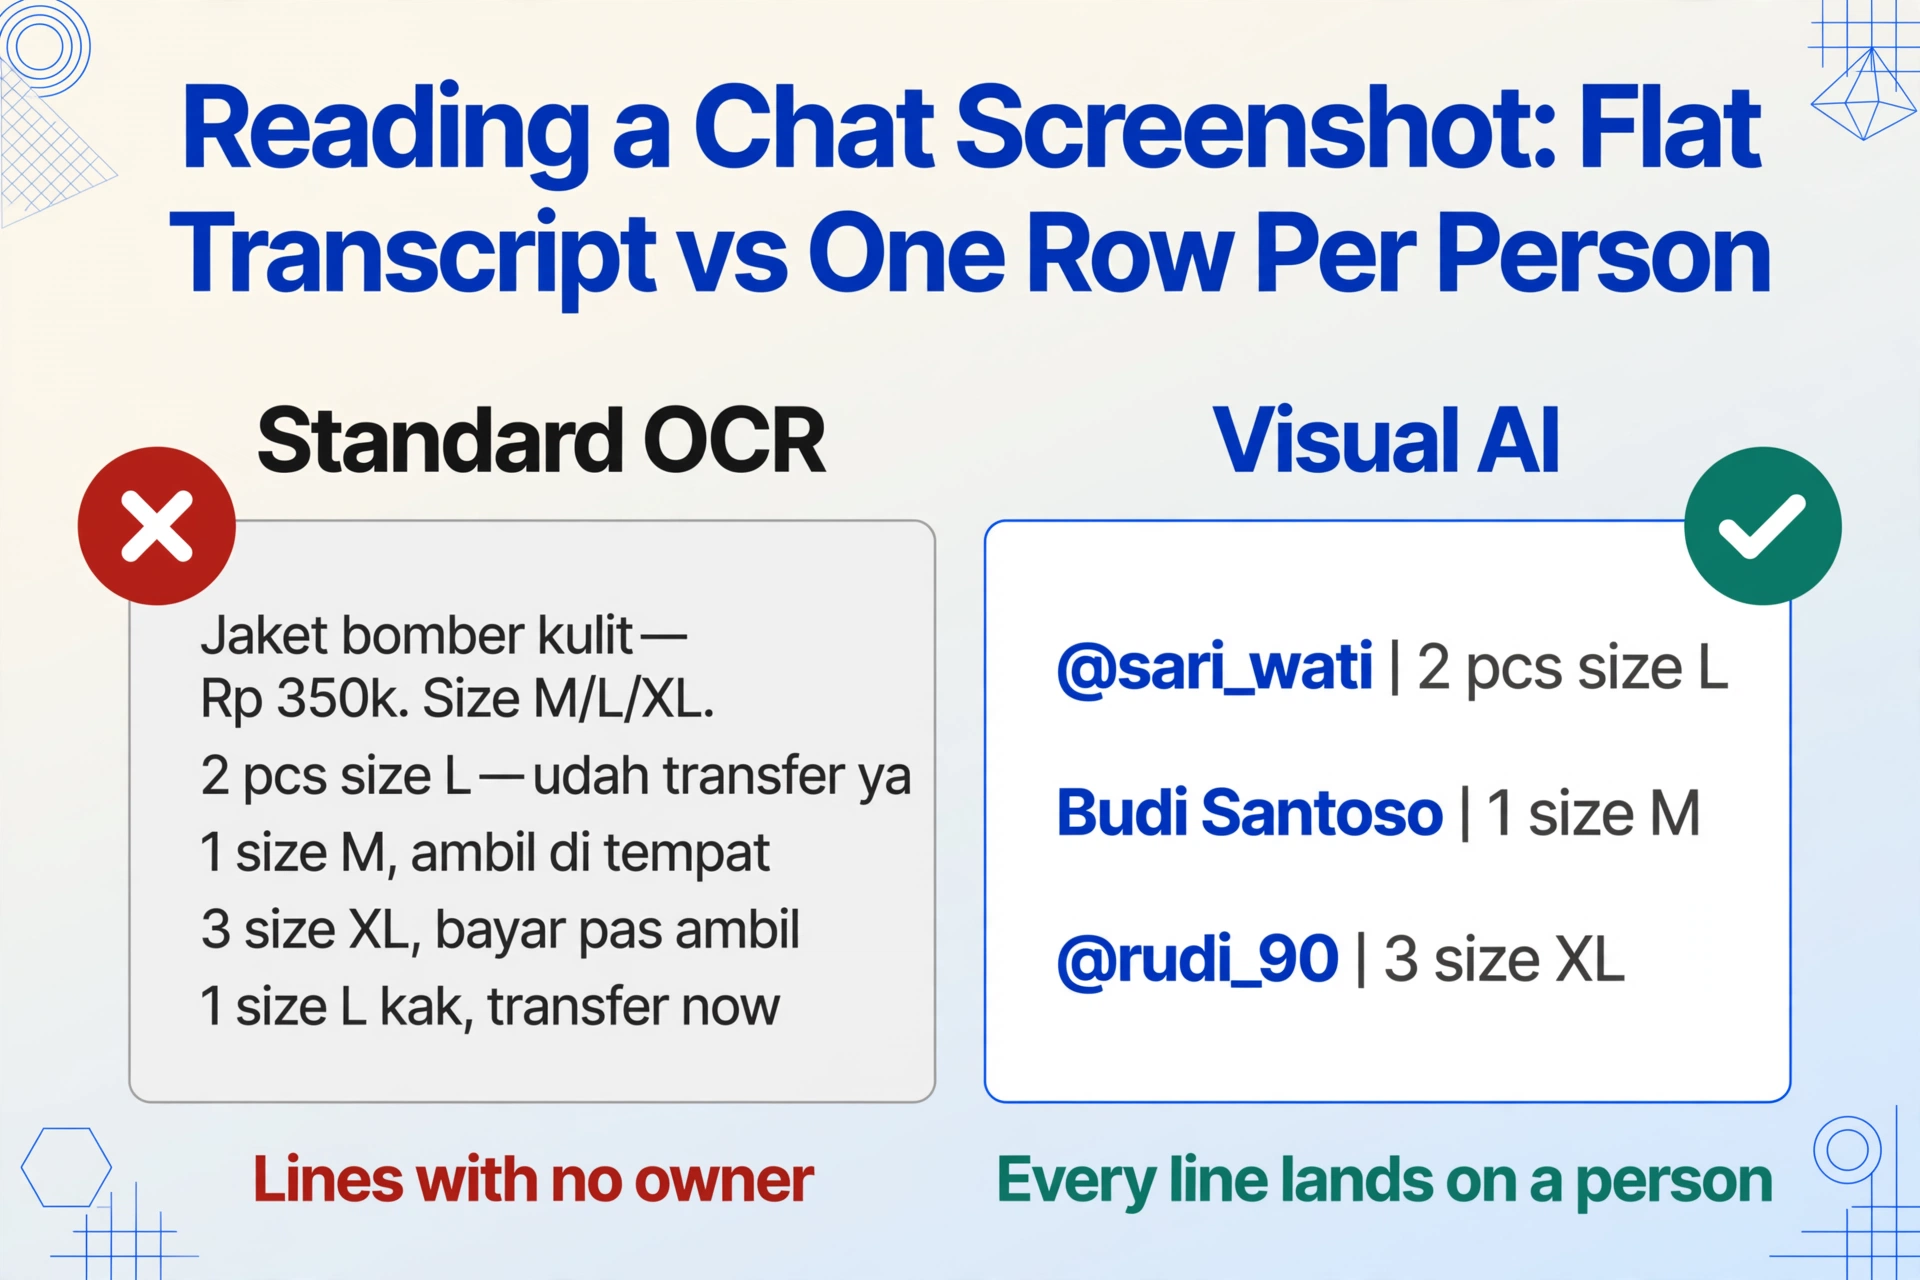
スクリーンショットに表示されている内容と主催者が必要とするもののギャップは、データの欠落ではなく、構造の問題です。スクリーンショットには注文を履行するために必要な情報がすべて含まれています。しかし、形式(縦のスレッド内のチャットの吹き出し)と出力形式(1人1行のスプレッドシート)は、まったく別物です。
標準的なOCRは、スクリーンショットを1ページのテキストとして扱います。各行を順番に読み取り、すべてをフラットな書き起こしに出力します。
// OCR出力 — フラット、構造なし
「Jaket bomber kulit — Rp 350k. Size M/L/XL. Transfer ke BCA 123456 a/n Sari.」
「2 pcs size L — udah transfer ya」
「1 size M, ambil di tempat」
「3 size XL, bayar pas ambil」
「1 size L kak, transfer sekarang」
「2 size M — udah ya」
このトランスクリプトは注文処理には役に立ちません。誰が何を注文したのかが分からないからです。主催者は元のスクリーンショットを読み、各返信を送信者に頭の中で対応付け、すべてを手動でスプレッドシートに打ち込む必要があります。ここが本当のボトルネックです。「言葉を読む」ことではなく、どの言葉が誰のものかを理解することにあります。
Visual AI — セマンティックベースの抽出の背後にある技術 — は、スクリーンショットへのアプローチが異なります。画像に複数の送信者領域(表示名付きの各吹き出し)が含まれていることを認識し、各吹き出し内のテキストを送信した人に関連付けます。スクリーンショットをテキストのページのように読むのではなく、会話として読み、各メッセージがその作者に属することを理解します。これは、AIが領収書ではない支払いスクリーンショットから構造化データを抽出できるようにするのと同じパラダイムシフトです。入力は文書ではありませんが、AIが何を見ているかを理解しているため、データは抽出可能です。
共同購入で重要なフィールド
チャットの書式を取り除くと、共同購入の注文には毎回同じコアフィールドがあります。これらがスプレッドシートで実際に必要な列です:
| フィールド | チャットでの見え方 | 重要な理由 |
|---|---|---|
| 名前 | 吹き出しの上に表示されるテレグラムの表示名または@ユーザー名 | 注文者 — 受け渡しと支払い済みの追跡に必要 |
| 商品 / バリエーション | 「Jaket bomber kulit」または単に「サイズL」(商品は上記のお知らせに記載済み) | どの商品とどのバリエーションか — 1つの共同購入で複数のカラーやサイズを扱うことが多い |
| 数量 | 「2 pcs」「3」「1サイズM」(サイズと同じフレーズに数量が含まれる) | ユニット数 — 在庫割り当てとサプライヤー発注に必要 |
| 金額 | 「Rp 350k」「udah transfer」「合計700」 — 明示的な場合も、数量×単価で暗黙的に示される場合もある | 支払い追跡 — 支払い済み、未払い、総回収額 |
| メモ | 「ambil di tempat」「pay later」「transfer sekarang」 | 支払い方法、受け取りの希望、特別な指示 |
従来のデータ入力にとって難しいのは、複数のフィールドが1つの文法的に緩い文に詰め込まれていることが多いことです:「2サイズM transfer ya」には、数量(2)、サイズ(M)、支払いメモ(transfer)が5語に含まれています。人間の主催者はこれを直感的に個別のデータポイントに分割します。従来のOCRにはそれができません。
1人の注文が複数のメッセージにまたがる場合
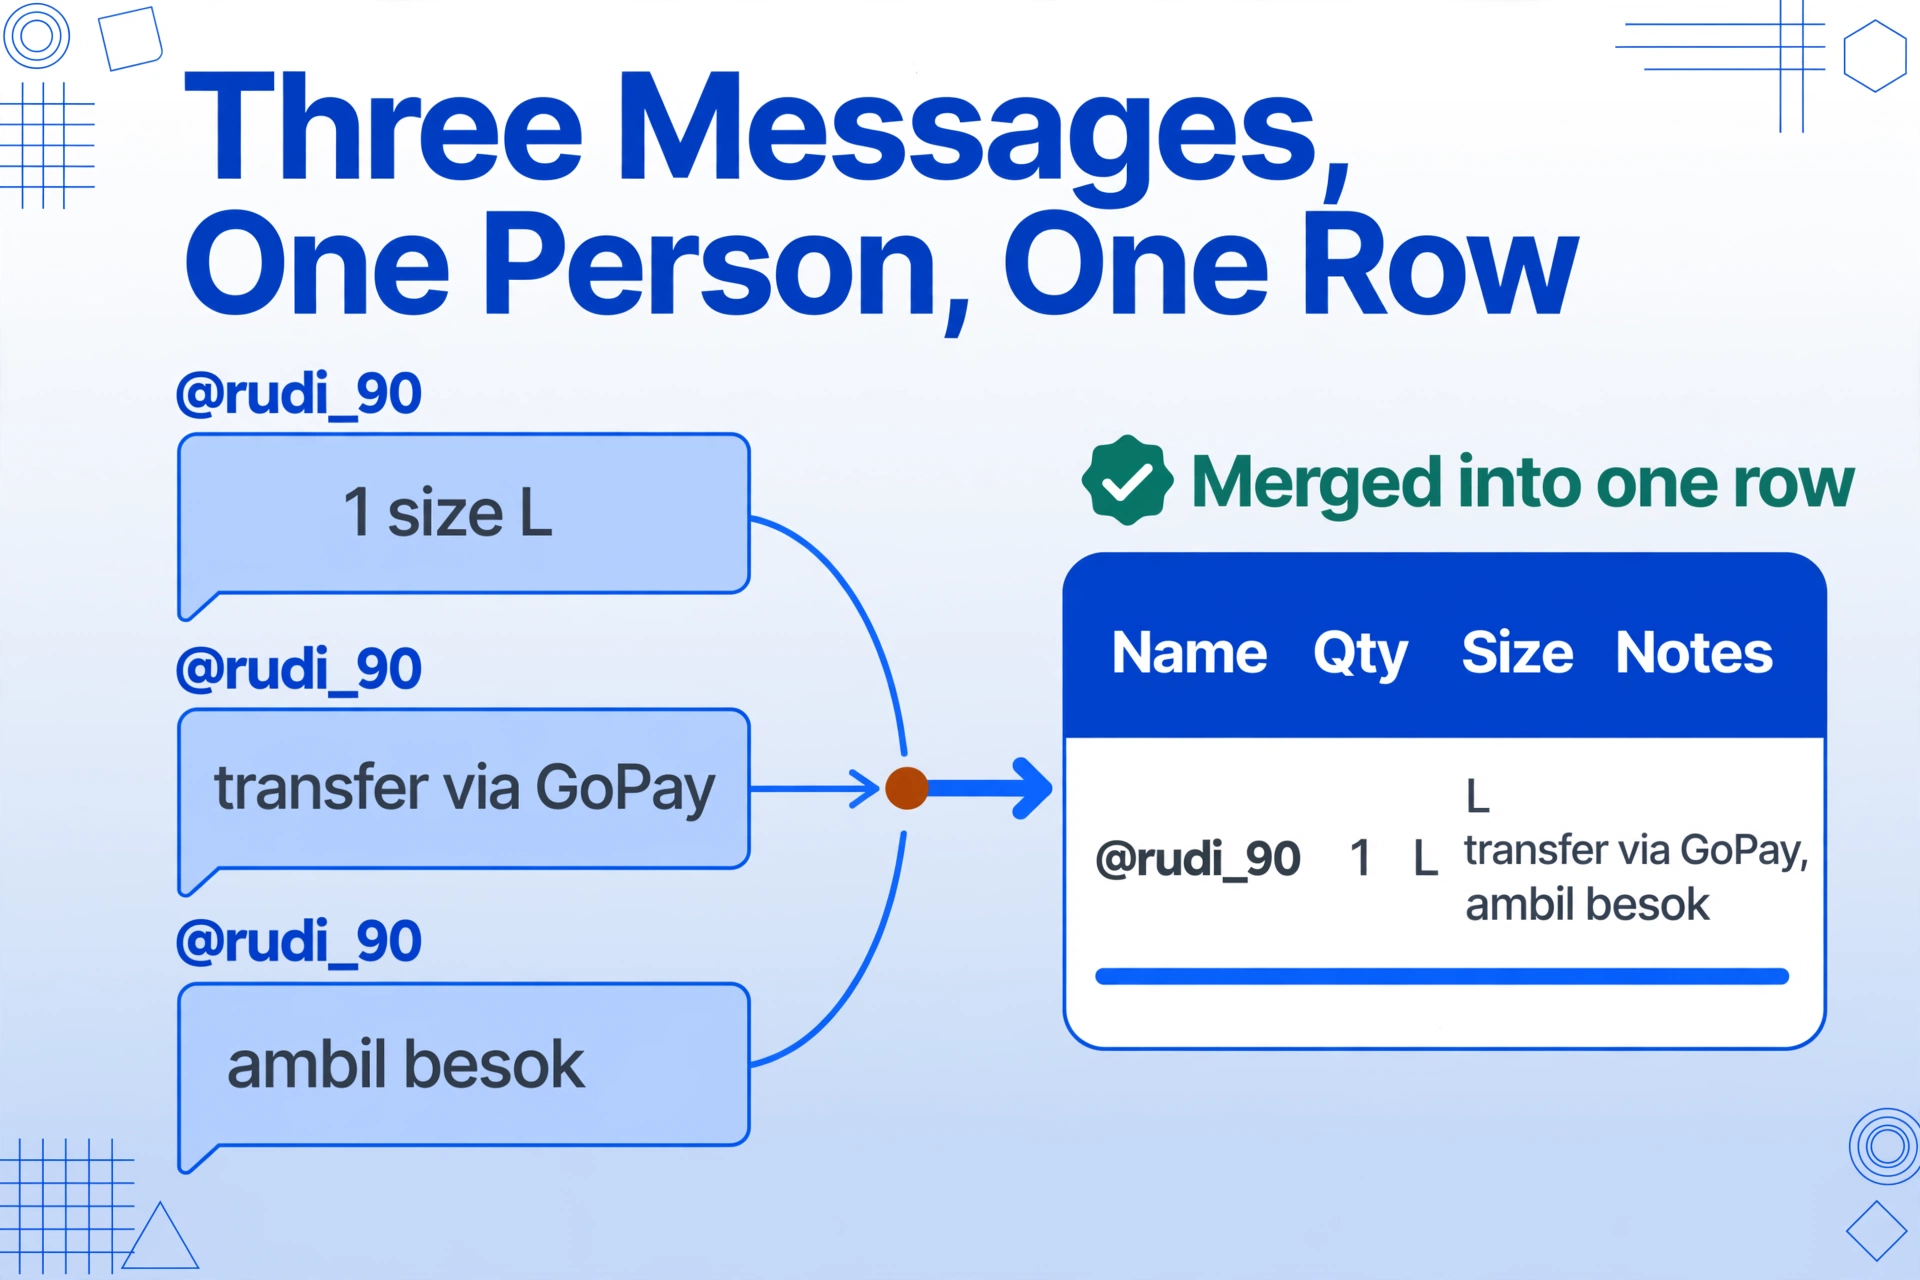
共同購入スレッドでよくあるパターンが、抽出をさらに難しくしています。同じ人が2〜3件の返信を続けて送るケースです。最初に"1 size L"と入力し、続けて"transfer via GoPay"、さらに"ambil besok"(明日受け取り)と追加することがあります。これら3つのメッセージはスクリーンショット上では別々の吹き出しとして表示されますが、すべて同じ人物に属し、まとめて1つの注文を構成します。
会話のグループ化を理解するVisual AIは、同じ送信者からの連続したメッセージを1つの注文エントリとして扱うことを認識します。テキストを結合し、フィールドを抽出して、1つの行として出力します。このレベルのグループ化は、テンプレートベースのOCRツールには絶対にできません。ページの組版構造だけでなく、会話の社会的構造を理解する必要があるからです。
1枚のスクリーンショットから、1人1行のスプレッドシートへ
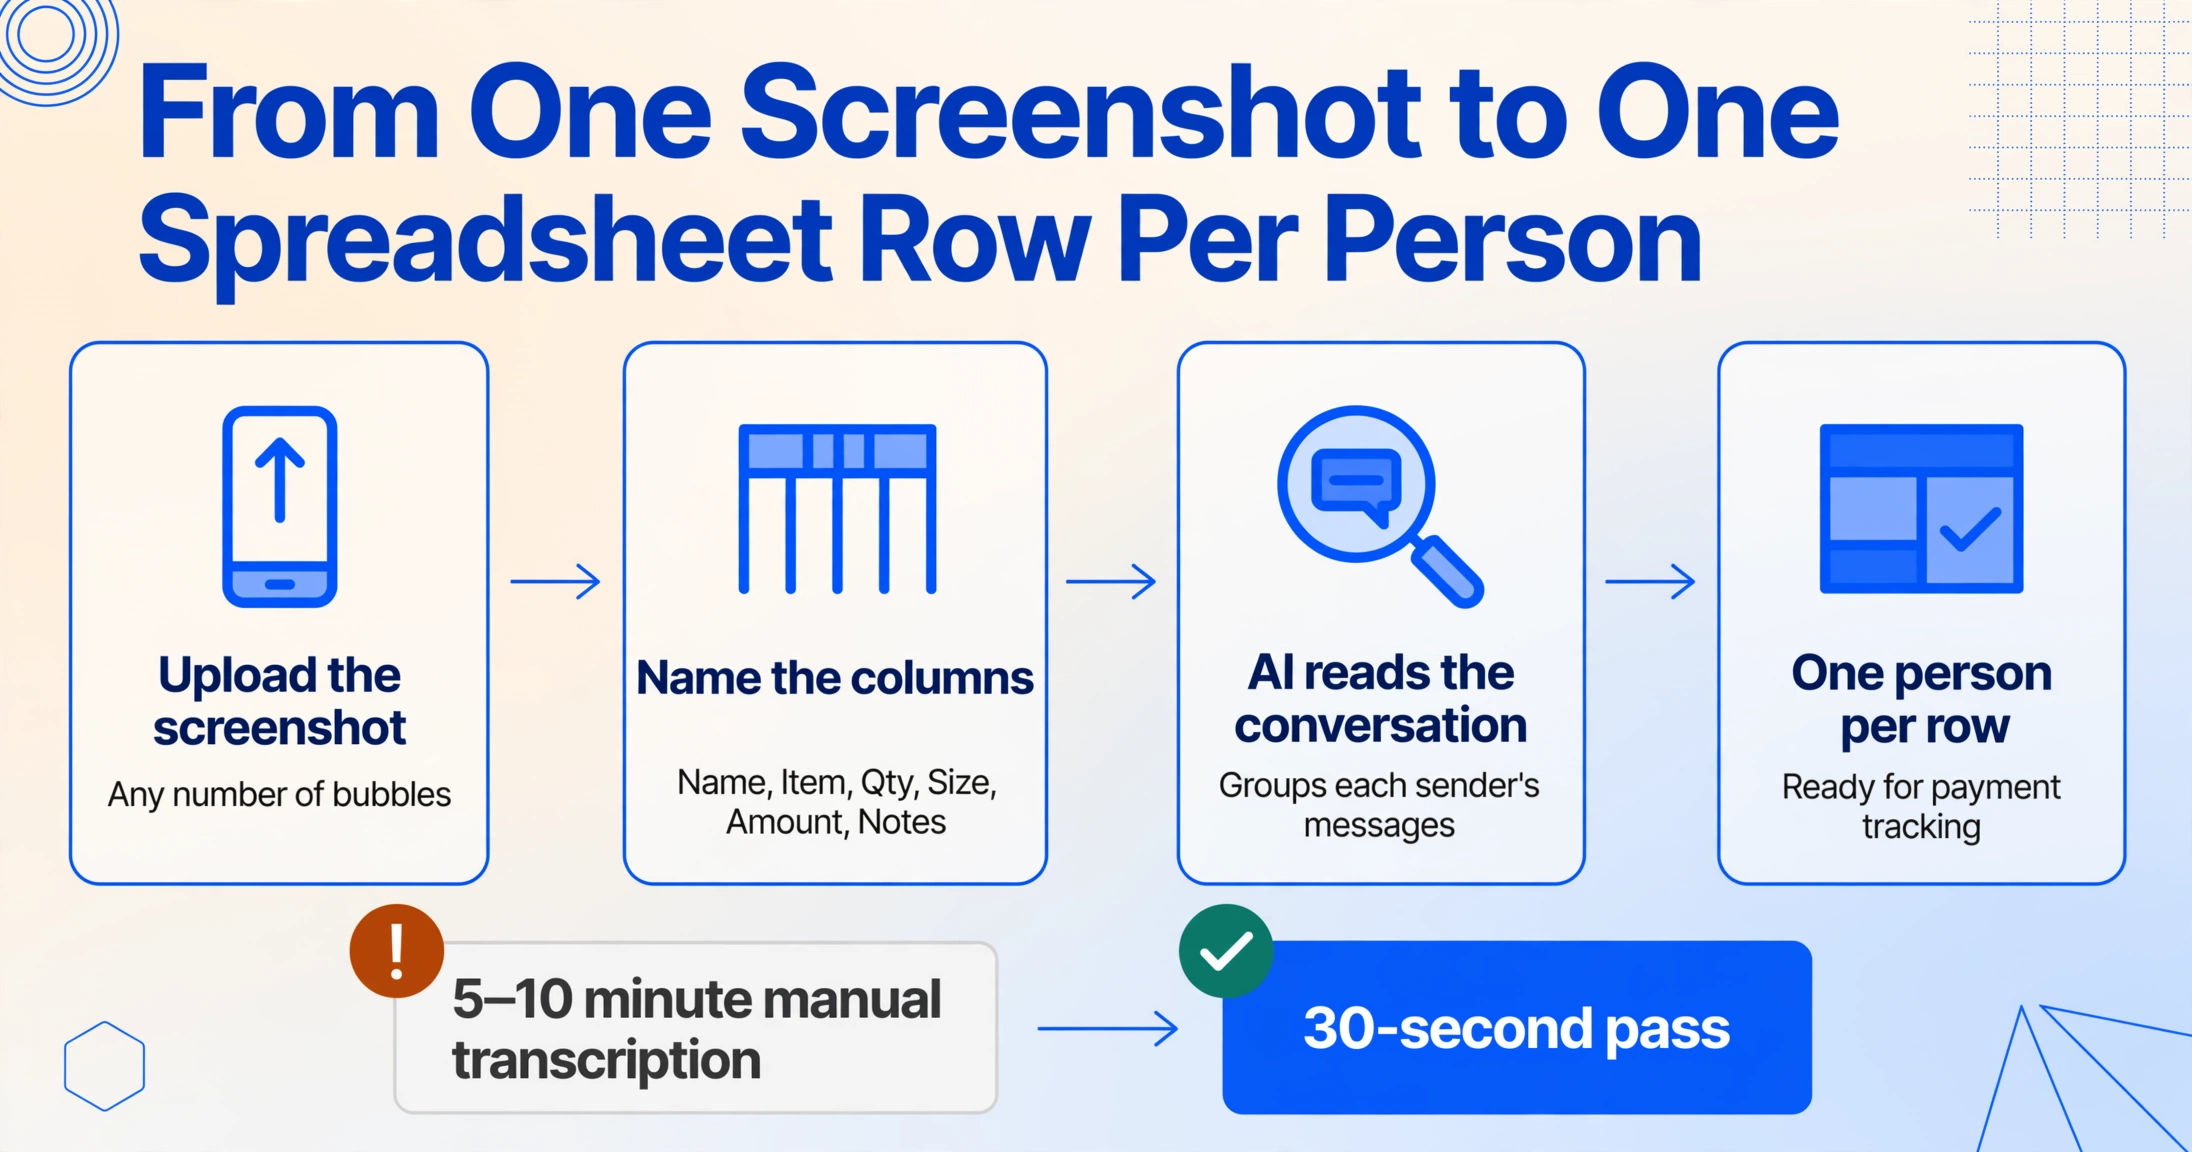
カスタム列抽出は、この混沌とした縦のスレッドをきれいなテーブルに変えます。必要な列(Name、Item、Qty、Size、Amount)を定義するだけで、あとはAIが処理します。
画像1枚で、吹き出しの数も人数も問いません。
Name、Item、Qty、Size、Amount、Notes — これらがスプレッドシートのヘッダーになります。テンプレートも設定も不要です。
各送信者を特定し、メッセージをグループ化して、注文詳細を解析します。「2 size L transfer」のような複合フレーズにも対応します。
発注、支払い管理、引き渡しにすぐ使えるクリーンな出力。手動での並べ替えは不要です。
この結果により、5〜10分かかっていた手動での転記作業が30秒で完了します。毎月複数の共同購入を運営している主催者にとって、ファッションの大量購入、食品の共同購入、電化製品の注文など、その節約効果はすぐに積み重なります。
注文スレッドが1枚のスクリーンショットに収まらない場合は?
人気のある共同購入では、200件以上の返信が発生することがあります。主催者はスレッド全体をカバーするために複数のスクリーンショットを撮ることがよくあります。それらを同じバッチにアップロードし、列を一度定義すれば、AIがすべての画像をまとめて処理します。出力は1つのスプレッドシートに統合され、各人の注文が正しく割り当てられます。バッチ処理により、スクリーンショット間での名前の表記ゆれや数量の入力ミスといったエラーが発生しやすい作業が、1回の操作で完了します。
スクリーンショットからはわからないこと
共同購入のスクリーンショットからは、注文管理システムが提供するすべての情報を得ることはできません。誰かの表示名が絵文字や1文字の場合、実際の名前へのマッピングを手動で行う必要があるかもしれません。チャットで地域特有のスラングが多用されている場合、標準的でない略語の精度はやや低下する可能性があります。しかし、大多数の共同購入スレッド(ユーザー名が読み取れ、注文が「2枚 Lサイズ」や「1 M 振込」のようなパターンに従っている場合)では、抽出により数秒で使用可能なデータが生成されます。目的は主催者の判断を置き換えることではなく、50件の返信を読んで1件ずつセルに入力するという機械的な作業を排除することです。
よくある質問
同じ共同購入のTelegramスクリーンショットを複数枚まとめて処理できますか?
はい。すべてのスクリーンショットを同じバッチにアップロードし、列を一度定義すれば、AIがすべての画像をまとめて処理します。メッセージが複数のスクリーンショットにまたがっていても、出力は1人1行の単一のスプレッドシートに統合されます。
スクリーンショット内で注文が2つの別々のメッセージに分かれている場合はどうなりますか?
AIは同じ送信者からの連続したメッセージをグループ化し、1つの注文の一部として扱います。誰かが「2個 Lサイズ」と入力し、続けて「GoPayで送金します」と追加した場合、両方のメッセージが1つの行に結合されます。
WhatsAppやLINEなどの他のチャットプラットフォームでも使えますか?
送信者の名前がメッセージの上または横に表示されているチャットスクリーンショットであれば、同じ方法が適用されます。Visual AIがチャットの構造を読み取るため、Telegram特有の吹き出しデザインに依存しません。LINEの共同購入には他のプラットフォームにはない点が1つあります。購入者が送金の証明として振込の末尾5桁(匯款末五碼)を投稿し、LINEの共同購入スクリーンショットにはそのコードが注文と同じスレッドに含まれます。プラットフォーム内の関連情報については、Telegramチャットで共有される暗号通貨ウォレットアドレスの処理方法、または領収書ではない支払いスクリーンショットに関する詳細をご覧ください。
注文にテキスト返信ではなく絵文字リアクションを使うチャットの場合はどうなりますか?
絵文字のみの返信(👍や❤️など、詳細を指定せず参加を示すもの)には、抽出可能な注文データが含まれていません。このような場合は、主催者が手動でフォローアップする必要があります。ただし、スクリーンショットに実際の注文情報を含む他の参加者からのテキスト返信も含まれている場合は、それらの人々は正しく抽出されます。
スクリーンショットは保存されたり、他の誰かに見られたりしますか?
いいえ。画像は一時的に処理され、サーバーには保存されません。抽出が完了し結果が配信されると、元のファイルは削除されます。プラットフォームを含め、他の誰もあなたの共同購入スクリーンショットや抽出されたデータにアクセスできません。
共同購入のスクリーンショットは、スプレッドシートではなく会話です。しかし、そこから必要な情報(各人の名前、商品、数量、金額)は十分に構造化されているため、Visual AI が一度の処理で抽出できます。
次に Telegram の共同購入スレッドが50件の返信に達し、誰が何を注文したかを確認するためにスクロールし直すことになったら、スクリーンショットを撮って抽出処理に整理させましょう。手作業が必要だったのは、データが欠けていたからではなく、形式がスプレッドシートと一致していなかったからです。フォーマット非依存の抽出がそのギャップを埋めます。