텔레그램 공동 구매:
채팅 스크린샷에서 각 구매자의 이름, 상품, 금액 추출하기
공동 구매 주최자가 게시합니다: "나이키 러닝화 공동 구매 — 개당 $45. 사이즈 S / M / L / XL. 8 pm까지 주문을 남겨주세요." 한 시간 안에 50개의 답글이 쌓입니다: "L 사이즈 2개 부탁해요 — 나중에 결제할게요," "M 사이즈 1개 — 송금했어요," "S 사이즈 3개 — 번호 보내주세요." 이제 한 장의 스크린샷에 열다섯 명의 이름, 상품, 선호 사이즈, 수량, 결제 메모가 모두 담겨 있습니다 — 말풍선의 세로 스크롤에 모두 섞여 있죠. 데이터는 모두 있습니다. 하지만 스프레드시트와는 전혀 닮지 않았습니다.
핵심 요점
- 답글이 50개인 공동 구매를 옮겨 적는 데 주최자는 10–15분이 걸립니다 — 이름을 훑어보고, 수량을 세고, 결제 메모를 풀어내고, 모든 행을 스프레드시트에 입력해야 하죠.
- OCR은 전체 스크린샷을 하나의 블록으로 평탄화합니다 — "L 사이즈 2개," "M 사이즈 1개 송금," "XL 사이즈 3개"가 누가 어떤 주문을 보냈는지 연결 없이 모두 이어 붙여집니다.
- 비주얼 AI는 채팅을 대화로 읽습니다 — 발신자별로 메시지를 그룹화하고, 같은 사람의 여러 말풍선 주문을 병합하며, 몇 초 만에 구매자당 한 행을 출력합니다.
단일 공동 구매 스크린샷에 포함된 내용
텔레그램 공동 구매 스크린샷은 문서가 아닙니다. 양식, 청구서, 표도 아닙니다. 서로 다른 사람이 보낸 말풍선이 세로로 이어진 대화입니다. 각 말풍선에는 주문 정보의 일부가 담겨 있습니다. 공동 구매 대화를 스크린샷으로 찍으면, 수십 개의 동시 대화가 하나의 정지된 프레임에 담깁니다.
일반적으로 이 프레임에는 다음이 포함됩니다:
| 정보 계층 | 실제 스크린샷 예시 |
|---|---|
| 주최자 공지 | "Jaket bomber kulit — Rp 350k. Size M/L/XL. Transfer ke BCA 123456 a/n Sari." |
| 멤버 답글 (10–30개 메시지) | "2 pcs size L — udah transfer ya" / "1 size M, ambil di tempat" / "3 size XL, bayar pas ambil" |
| 발신자 신원 | 각 말풍선 위에 표시 이름 또는 사용자 이름 — @rudi_90, @sari_wati, Budi Santoso |
| 결제 메모 | 답글에 분산되어 있음 — "transfer," "pay later," "ambil di tempat" (현장 수령) |
정보는 필드가 아닌 사람을 기준으로 연결됩니다. 각 사람의 이름, 상품 선택, 수량, 사이즈, 결제 의향은 하나 이상의 말풍선에 분산되어 있습니다. 왼쪽에서 오른쪽, 위에서 아래로 텍스트를 읽는 기존 도구는 뒤섞인 답변 블록을 출력할 뿐입니다. "2 pcs size L"이 위아래가 아닌 해당 메시지를 보낸 사람의 것임을 알 방법이 없습니다.
채팅 텍스트와 스프레드시트 행이 다른 이유
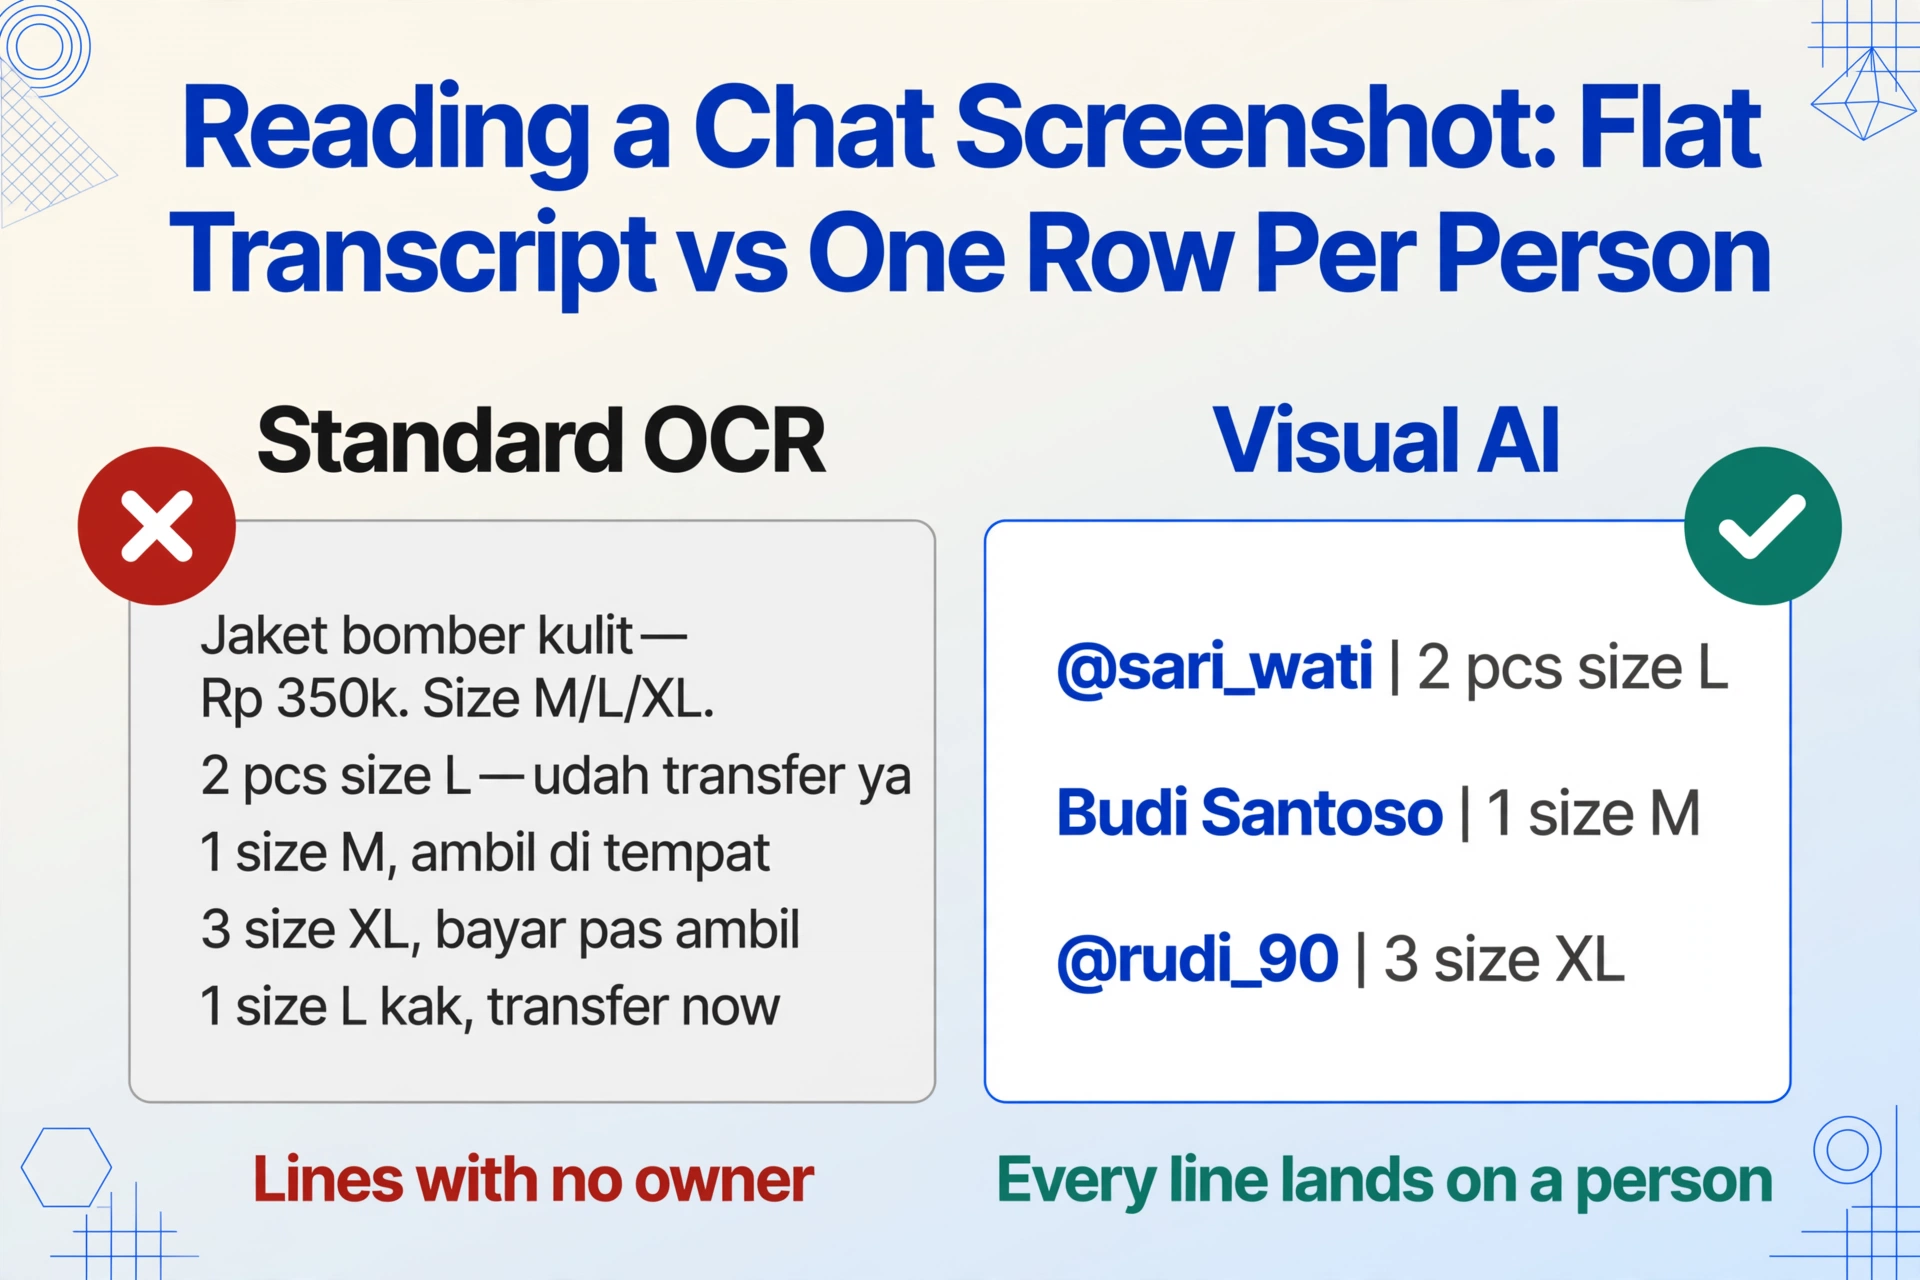
스크린샷에 표시된 내용과 주최자가 필요한 것 사이의 차이는 데이터 누락이 아니라 구조에 관한 것입니다. 스크린샷에는 주문을 처리하는 데 필요한 모든 정보가 있습니다. 그러나 형식(세로 대화의 말풍선)과 출력 형식(사람별 스프레드시트 행)은 완전히 다른 것입니다.
표준 OCR은 스크린샷을 단일 텍스트 페이지로 취급합니다. 각 줄을 순서대로 읽고 모든 것을 평면 전사본으로 덤프합니다:
// OCR 출력 — 평면, 구조 없음
"Jaket bomber kulit — Rp 350k. Size M/L/XL. Transfer ke BCA 123456 a/n Sari."
"2 pcs size L — udah transfer ya"
"1 size M, ambil di tempat"
"3 size XL, bayar pas ambil"
"1 size L kak, transfer sekarang"
"2 size M — udah ya"
이 대화 내용은 주문 처리에 전혀 쓸모가 없습니다. 누가 무엇을 주문했는지 알려주지 않기 때문입니다. 주최자는 여전히 원본 스크린샷을 읽고, 각 답글을 보낸 사람과 일일이 대응시킨 다음, 모든 내용을 수동으로 스프레드시트에 다시 입력해야 합니다. 이것이 진짜 병목 지점입니다. "단어를 읽는 것"이 아니라, 어떤 단어가 어떤 사람의 것인지 이해하는 것이 문제입니다.
비주얼 AI — 의미 기반 추출의 기반 기술 — 은 스크린샷을 다르게 접근합니다. 이미지에 여러 발신자 영역(표시 이름이 있는 각 말풍선)이 포함되어 있음을 인식하고, 각 말풍선 안의 텍스트를 보낸 사람과 연결합니다. 스크린샷을 텍스트 페이지처럼 읽지 않고, 대화처럼 읽어 각 메시지가 작성자에게 속한다는 것을 이해합니다. 이는 AI가 영수증이 아닌 결제 스크린샷에서 구조화된 데이터를 추출할 수 있게 하는 것과 동일한 패러다임 전환입니다. 입력은 문서가 아니지만, AI가 무엇을 보고 있는지 이해하기 때문에 데이터는 여전히 추출 가능합니다.
공동 구매에 중요한 필드
채팅 형식을 걷어내면 공동 구매 주문에는 항상 동일한 핵심 필드가 있습니다. 이것이 스프레드시트에 실제로 필요한 열입니다:
| 필드 | 채팅에서 보이는 형태 | 중요한 이유 |
|---|---|---|
| 이름 | 말풍선 위에 표시되는 텔레그램 표시 이름 또는 @사용자 이름 | 주문한 사람 — 전달 및 결제 여부 추적에 필요 |
| 상품 / 옵션 | "Jaket bomber kulit" 또는 "size L" (상품은 위 공지에 이미 있음) | 어떤 제품과 어떤 옵션인지 — 공동 구매는 종종 여러 색상이나 사이즈를 포함합니다 |
| 수량 | "2 pcs," "3," 또는 "1 size M" (사이즈와 같은 문구에 수량이 포함됨) | 몇 개인지 — 재고 배분 및 공급업체 주문에 필요 |
| 금액 | "Rp 350k," "udah transfer," "total 700" — 명시적인 경우도 있고, 수량 × 단가로 암시되는 경우도 있음 | 결제 추적 — 누가 결제했는지, 누가 미납인지, 총 수금액 |
| 메모 | "ambil di tempat," "pay later," "transfer sekarang" | 결제 방법, 수령 선호 사항, 특별 지시 사항 |
전통적인 데이터 입력을 어렵게 만드는 것은 여러 필드가 문법적으로 느슨한 단일 문장에 자주 압축되어 있다는 점입니다: "2 size M transfer ya"에는 수량(2), 사이즈(M), 결제 메모(transfer)가 다섯 단어에 포함되어 있습니다. 인간 주최자는 이를 본능적으로 분리된 데이터 포인트로 나눕니다. 전통적인 OCR은 그렇게 할 수 없습니다.
한 사람의 주문이 여러 메시지에 걸쳐 있을 때
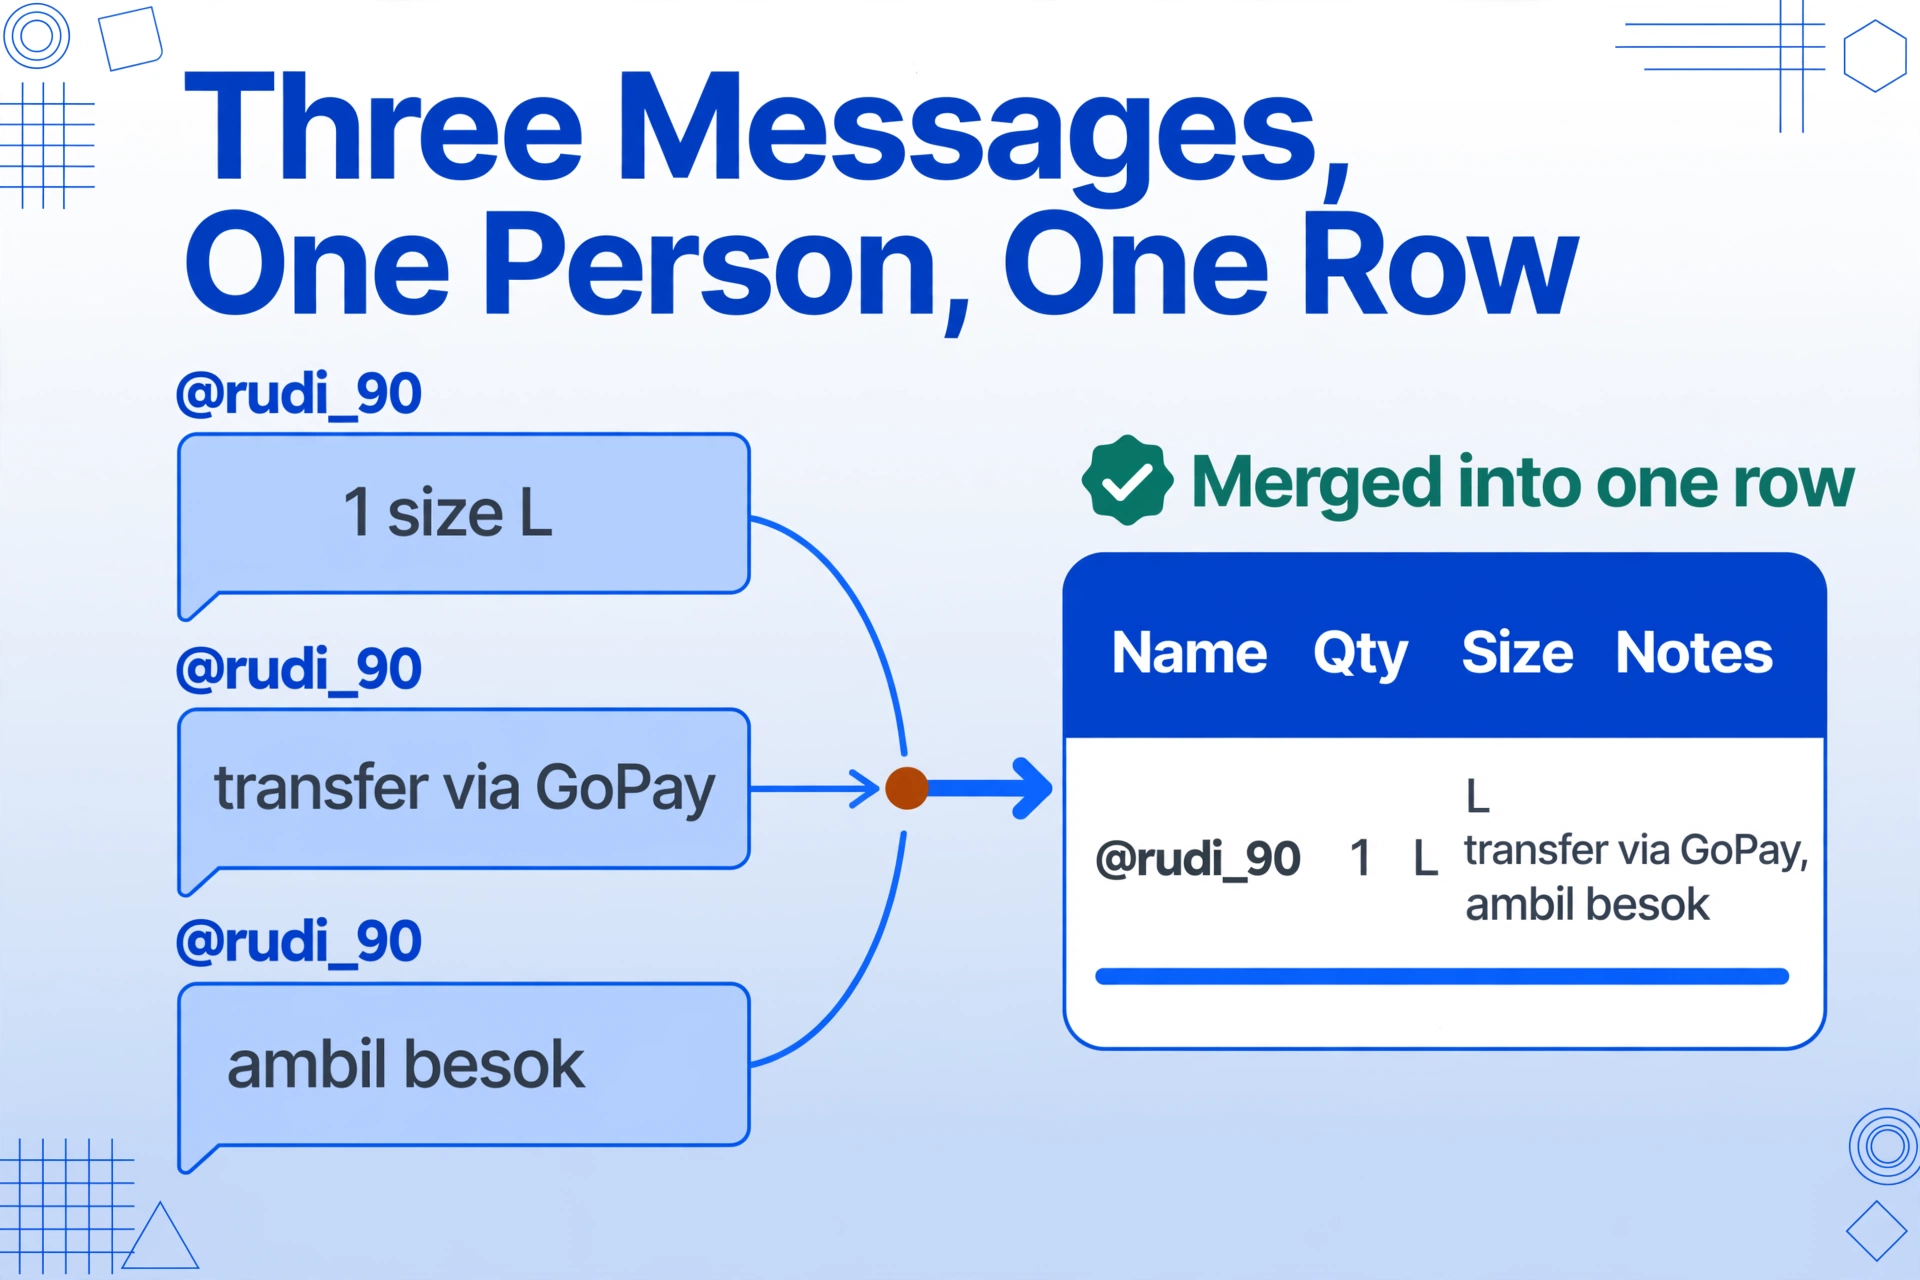
공동 구매 스레드에서 자주 나타나는 패턴 때문에 추출이 더 까다로워집니다. 같은 사람이 답글을 두세 개 연속으로 보내는 경우입니다. 먼저 "1 size L"이라고 입력하고, 바로 이어서 "transfer via GoPay"를 추가하고, 그다음 "ambil besok"(내일 수령)이라고 보낼 수 있습니다. 이 세 메시지는 스크린샷에서 별도의 말풍선으로 보이지만, 모두 같은 사람의 것이며 합쳐서 하나의 주문을 이룹니다.
대화의 그룹화를 이해하는 비주얼 AI는 같은 발신자의 연속 메시지를 하나의 주문 항목으로 처리해야 한다는 것을 인식합니다. 텍스트를 결합하고, 필드를 추출하고, 단일 행으로 출력합니다. 이러한 수준의 그룹화는 템플릿 기반 OCR 도구로는 할 수 없는 일입니다. 페이지의 활자 구조가 아니라 대화의 사회적 구조를 이해해야 하기 때문입니다.
스크린샷 하나에서 사람별 스프레드시트 행 하나로
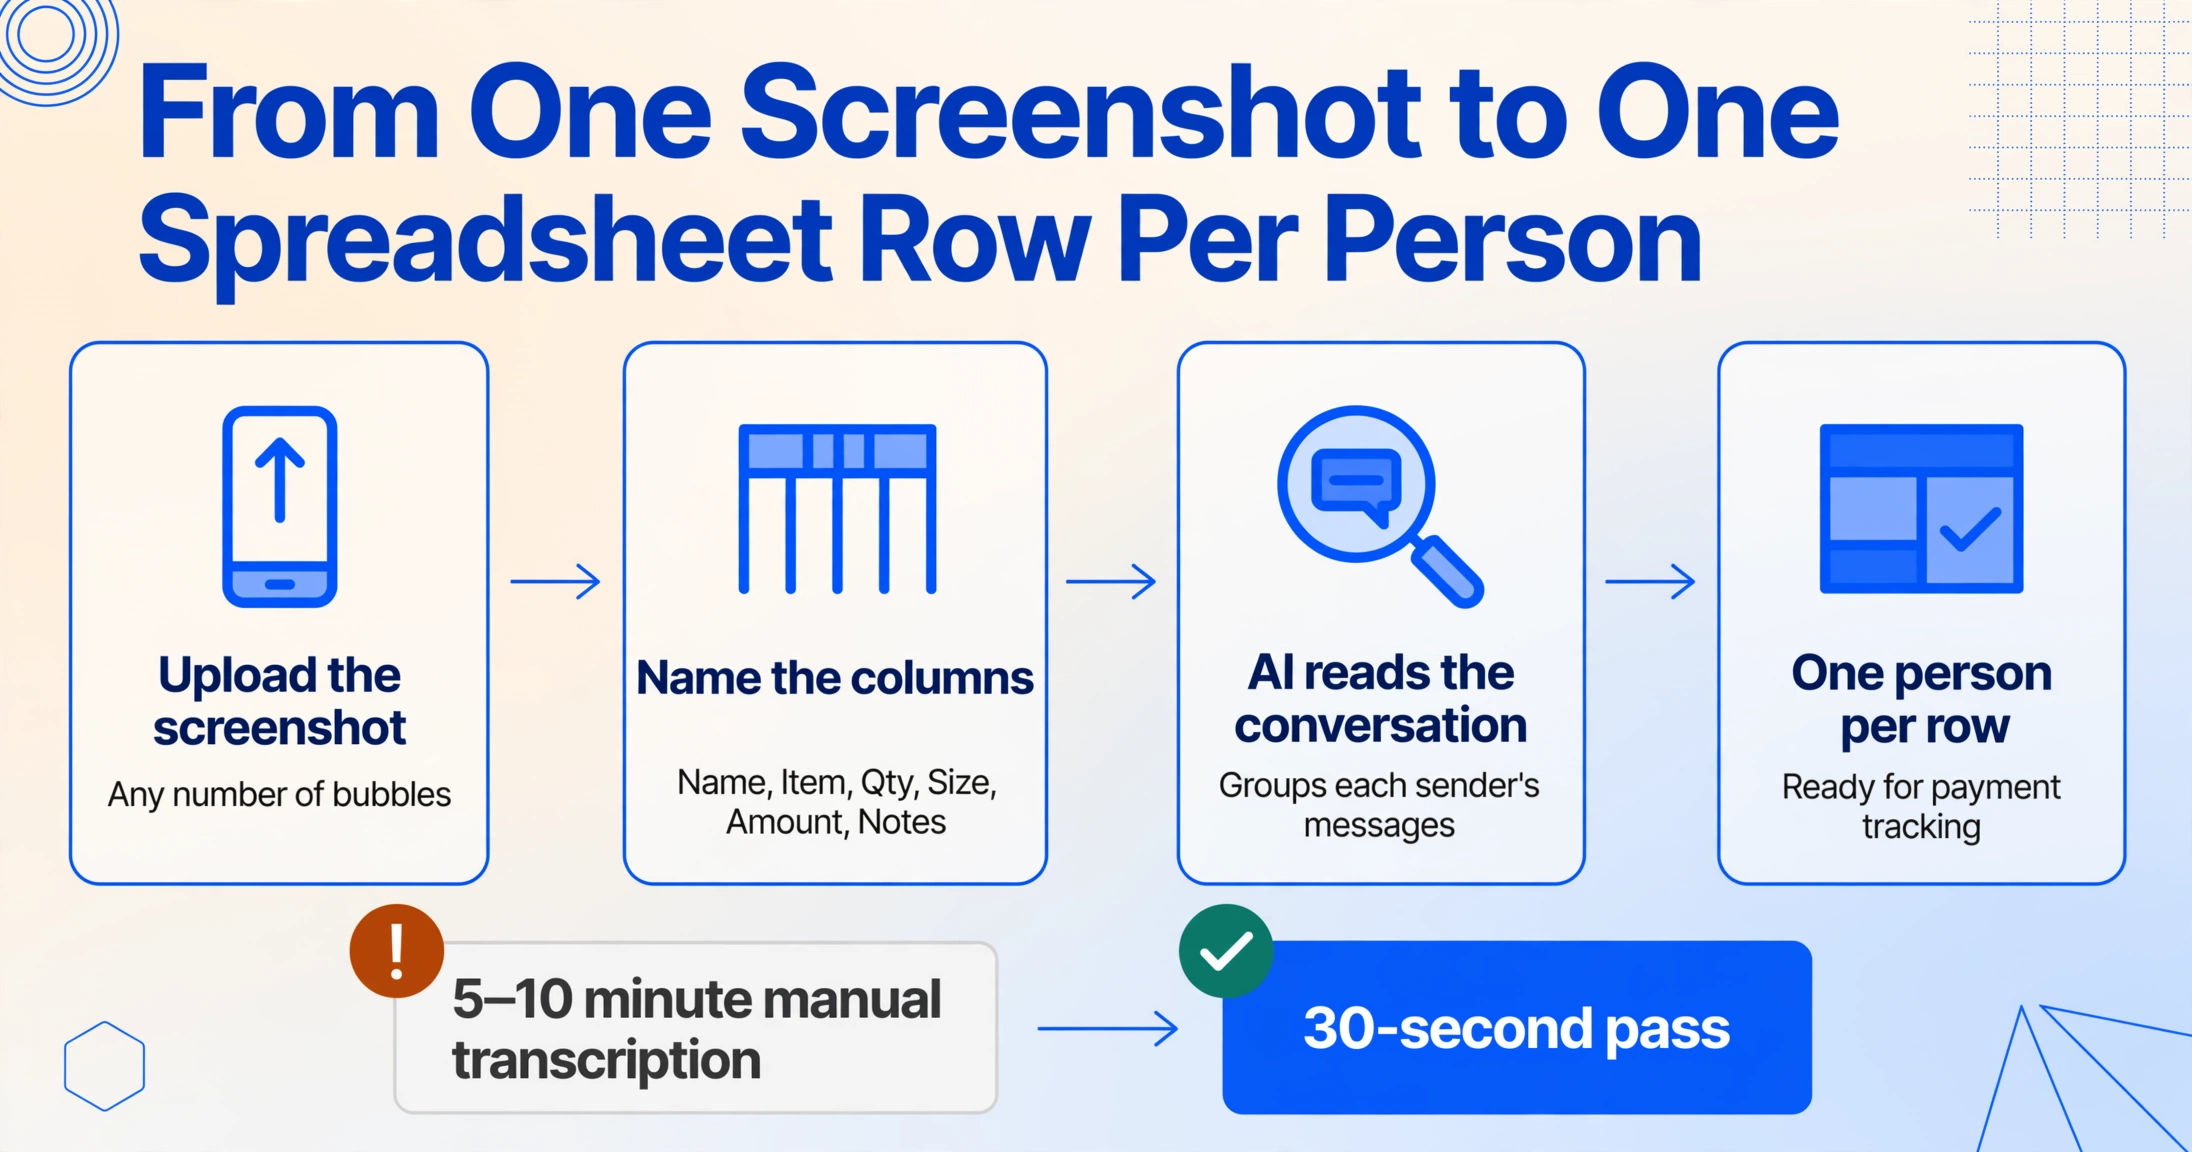
맞춤 열 추출은 이렇게 복잡한 세로형 스레드를 깔끔한 테이블로 바꿔 줍니다. 필요한 열(이름, 품목, 수량, 사이즈, 금액)을 정의하기만 하면 AI가 나머지를 처리합니다.
이미지 하나면 충분합니다. 말풍선 수, 인원 수는 상관없습니다.
이름, 품목, 수량, 사이즈, 금액, 메모 — 이 이름들이 스프레드시트의 머리글이 됩니다. 템플릿도, 설정도 필요 없습니다.
각 발신자를 식별하고, 메시지를 그룹화하며, "2 size L transfer" 같은 복합 문구를 포함한 주문 세부 정보를 분석합니다.
구매, 결제 추적, 인수인계에 바로 사용할 수 있는 깔끔한 결과물이 생성됩니다. 수동 정렬은 필요 없습니다.
그 결과, 5~10분이 걸리던 수동 입력 작업이 30초로 단축됩니다. 한 달에 여러 번 공동 구매를 진행하는 주최자라면 — 패션 공동 구매, 식품 공동 구매, 전자제품 주문 등 — 이 절약 효과는 빠르게 누적됩니다.
주문 스레드가 한 장의 스크린샷을 넘어가면 어떻게 하나요?
인기 있는 공동 구매는 200개 이상의 댓글이 달릴 수 있습니다. 주최자는 전체 스레드를 담기 위해 여러 장의 스크린샷을 찍는 경우가 많습니다. 같은 배치에 업로드하고 열을 한 번만 정의하면 AI가 모든 이미지를 함께 처리합니다. 출력은 각 사람의 주문이 올바르게 귀속된 단일 스프레드시트로 병합됩니다. 일괄 처리는 오류가 발생하기 쉬운 작업 — 스크린샷마다 다르게 표기된 이름, 잘못 입력된 수량 — 을 한 번의 작업으로 바꿔줍니다.
스크린샷이 알려주지 못하는 것
공동 구매 스크린샷은 주문 관리 시스템이 제공하는 모든 정보를 알려줄 수는 없습니다. 누군가의 표시 이름이 이모지나 한 글자라면 실제 이름으로 수동 매핑해야 할 수 있습니다. 채팅에 지역 슬랭이 많이 사용되면 비표준 약어의 정확도가 다소 낮아질 수 있습니다. 그러나 대부분의 공동 구매 스레드 — 사용자 이름을 읽을 수 있고 주문이 "2 pcs size L" 또는 "1 M transfer" 같은 패턴을 따르는 경우 — 추출은 몇 초 만에 바로 사용할 수 있는 데이터를 생성합니다. 목표는 주최자의 판단을 대체하는 것이 아니라 50개의 댓글을 읽고 각각을 셀에 입력하는 기계적인 작업을 없애는 것입니다.
자주 묻는 질문
같은 공동 구매의 여러 텔레그램 스크린샷을 한 번에 처리할 수 있나요?
네. 모든 스크린샷을 같은 배치에 업로드하고 열을 한 번만 정의하면 AI가 모든 이미지를 함께 처리합니다. 여러 스크린샷에 메시지가 나뉘어 있어도 출력은 한 사람당 한 행씩 하나의 스프레드시트로 병합됩니다.
스크린샷에서 누군가의 주문이 두 개의 다른 메시지로 나뉘어 있으면 어떻게 하나요?
AI는 같은 발신자의 연속된 메시지를 그룹화하여 하나의 주문으로 처리합니다. 누군가 "2개 L사이즈"라고 입력한 후 바로 "GoPay로 송금합니다"를 추가하면 두 메시지가 모두 하나의 행으로 결합됩니다.
WhatsApp이나 LINE과 같은 다른 채팅 플랫폼에서도 작동하나요?
발신자의 이름이 메시지 위나 옆에 보이는 모든 채팅 스크린샷에 동일한 방식이 적용됩니다. 비주얼 AI가 채팅 구조를 읽기 때문에 텔레그램의 특정 말풍선 디자인에 제한되지 않습니다. LINE 공동 구매에는 다른 플랫폼에는 없는 추가 요소가 있습니다. 구매자가 송금 증빙으로 송금액 마지막 5자리(匯款末五碼)를 게시하며, LINE 공동 구매 스크린샷에는 주문과 같은 스레드에 해당 코드가 포함됩니다. 플랫폼 내 참조로는 텔레그램 채팅에서 공유된 암호화폐 지갑 주소 처리 방법과 영수증이 아닌 결제 스크린샷에 대한 종합적인 설명을 확인하세요.
채팅에서 주문을 위해 텍스트 답변 대신 이모지 반응을 사용하면 어떻게 하나요?
이모지만 사용한 응답(예: 👍 또는 ❤️로 세부 정보 없이 참여 의사를 표시하는 경우)에는 추출 가능한 주문 데이터가 포함되지 않습니다. 이러한 경우 주최자가 수동으로 후속 조치해야 합니다. 그러나 스크린샷에 실제 주문 정보가 포함된 다른 참가자의 텍스트 답변도 함께 있다면 해당 참가자들은 올바르게 추출됩니다.
스크린샷이 저장되거나 다른 사람에게 보이나요?
아니요. 이미지는 임시로 처리되며 서버에 저장되지 않습니다. 추출이 완료되고 결과가 전달되면 원본 파일은 삭제됩니다. 플랫폼을 포함한 어떤 다른 사람도 귀하의 공동 구매 스크린샷이나 추출된 데이터에 접근할 수 없습니다.
공동 구매 스크린샷은 대화이지 스프레드시트가 아닙니다. 하지만 그 안에서 필요한 정보 — 각 사람의 이름, 상품, 수량, 금액 — 은 충분히 구조화되어 있어 비주얼 AI가 한 번에 추출할 수 있습니다.
다음에 텔레그램 공동 구매 대화가 50개 답글에 도달했을 때, 누가 무엇을 주문했는지 확인하려고 스크롤을 올리게 된다면, 스크린샷을 찍고 추출 기능이 정리하도록 맡기세요. 수작업의 문제는 데이터가 없다는 것이 아니라 형식이 스프레드시트와 맞지 않는다는 것이었습니다. 형식 독립적 추출이 그 차이를 메워 줍니다.