製造調達のスケーリング:
200件のPOが2,000件になるとき
調達における最も危険な数字は、チームが処理しているPO件数ではない。チームが実際に処理している件数と、何かが破綻する前に処理できると信じている件数とのギャップこそが危険なのだ。そのギャップは、ほとんどのKPIダッシュボードには見えない。月次レポートにも表れない。そして誰かが気づいたときには、すでに3つのシステムが連鎖的に故障し始めており、残業をどれだけ重ねても取り返しがつかない状態になっている。
重要なポイント
- 調達の破綻を示す最も信頼できる警告信号—48時間以上未処理のPO—は、標準的なKPIダッシュボードには見えない。なぜなら、ほとんどが件数ではなく滞留期間を追跡していないからだ。
- トップクラスの調達チームが1人あたり11倍のPOを処理できるのは、より働いているからではない。仕事のどの部分を機械に任せ、どの部分に人間の判断が必要かを再設計したからだ。
- 手作業によるデータ入力の罠—いまだに70%のメーカーが陥っている—から抜け出すのに、18か月のERP導入は必要ない。ワークフローの最前線に自動抽出を置き、購買担当者がタイピングではなく例外対応に一日を費やせるようにすればいいのだ。
壊れる3つのシステム — そして、なぜ誰もそれに気づかないのか
購買発注書の処理は、単一の業務ではありません。それぞれに破綻のポイントを持つ、3つの相互依存するシステムが積み重なったものです。チームが月に100〜200件のPOを処理している間は、通常、3つのシステムすべてが機能します。非公式な回避策(モニターに貼った付箋、納期の遅れているサプライヤーに関する頭の中のメモ、経理への素早いSlackメッセージ)で、隙間を埋めることができます。しかし、これらの各システムには処理量の閾値があり、それを超えると回避策は機能しなくなり、しかもすべてが同時に壊れるわけではありません。
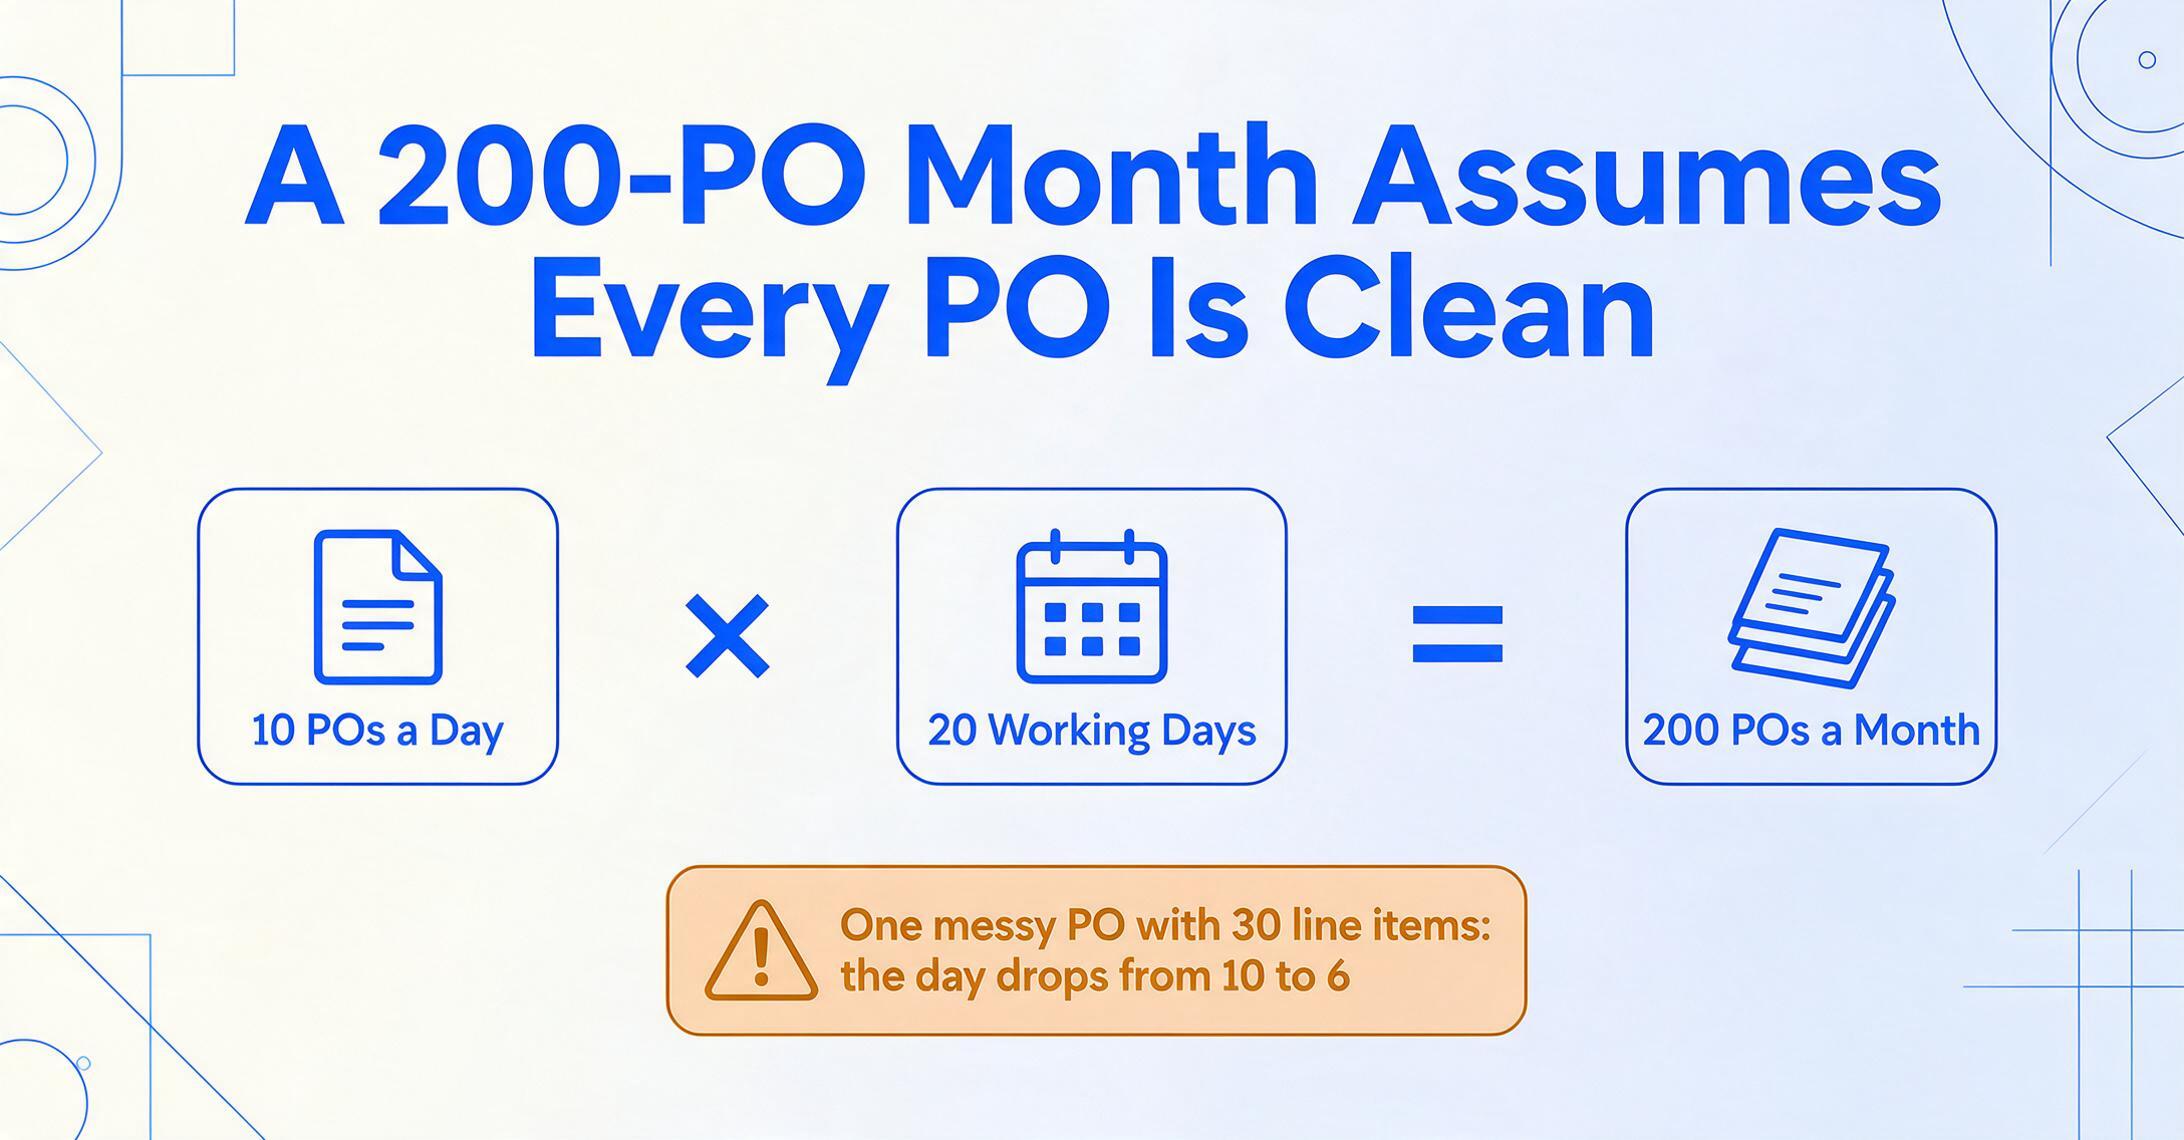
最初に機能不全に陥るのはデータ入力の処理能力です。これは、サプライヤーのPO形式を社内システムで使用できる形式に変換するパイプラインです。月200件のPOの場合、フルタイムの購買担当者1名は、各POにデータ入力、フォローアップ、ファイリングに約30分かかるとすると、1日あたり約10件を処理できます。計算はタイトですが管理可能です:10件×20営業日=200件。しかし、この計算は、すべてのPOがクリーンで、すべてのサプライヤーが当日中にメールに返信し、例外処理に追加の時間を要さないことを前提としています。実際には、スキャンされたPDFの2ページにまたがる30行の明細を含むPOが1件だけで1時間を消費することもあり、その日の担当者の処理能力は10件から6件に落ちます。
2番目に壊れるのは追跡とコミュニケーションです。ある購買担当者がr/procurementに投稿したように、「1日に何百通ものメールが関わります。延々と続く既読/未読メールから、現在作業中のPO、ベンダーからの返答を待っているPOまで。」月間処理量がおよそ300件を超えると、非公式な頭の中の追跡システムは崩壊します。「改訂中」や「サプライヤー確認待ち」だったPOが、宙に浮いた状態になり始めます。生産ラインが3日前に発送されるはずだった資材を待っている状態になるまで、誰も気づきません。
3番目のシステム、そしてほとんどの購買マネージャーが予期していないものは、例外処理です。どのPOのバッチにも外れ値が含まれます:サプライヤーがPO形式を変更した、新しいベンダーが手書きの注文確認書を送ってきた、明細の説明がERPの製品コードと一致しない、などです。月200件のPOの場合、これらの例外は全体の10〜15%、つまり20〜30件で、経験豊富な担当者がその場で解決できます。月500件のPOになると、例外は依然として10〜15%ですが、それは50〜75件になります。それぞれに、人間の判断、電話、または手動での照会が必要です。例外に対する自動化の特効薬はありません。しかし、累積的な判断負荷が、チームがエラーや遅延なしに処理できる限界を超えるポイントは存在します。
連鎖は次のように進行します:データ入力のボトルネックがバックログを生む→バックログが追跡システムを圧倒する→追跡されていないPOがより多くの例外を生む→例外がデータ入力に充てるべき時間を消費する。各システムの障害が次の障害を助長します。そして、組織的な対応である「皆、ただ一生懸命働け」は、それを支えていた人々を疲弊させ、サイクルを加速させます。
限界点に達する前に、その計算方法を知る
スムーズに拡大するチームと壁にぶつかるチームの違いは、使用するツールではなく、壁が来る18ヶ月前にその兆候を認識していたかどうかです。
APQCのオープンスタンダードベンチマークデータが基準を示しています。組織は1件の購買発注書を処理するのに14ドルから54ドル以上を費やしています。完全負荷の人件費、システム間接費、エラー修正を考慮すると、中央値はおよそ50ドルから100ドルです。しかし、より参考になるのはパフォーマンスのばらつきです。上位の組織は、下位25%の組織と比較して、調達FTEあたりのPO処理件数が11倍以上です。この11倍の差は、より優秀な人材によるものではなく、プロセス設計とツールによるものです。
ここでは、組織が拡大曲線上のどこに位置するかを特定するための診断フレームワークを紹介します。1ヶ月間、次の4つの指標を追跡してください。
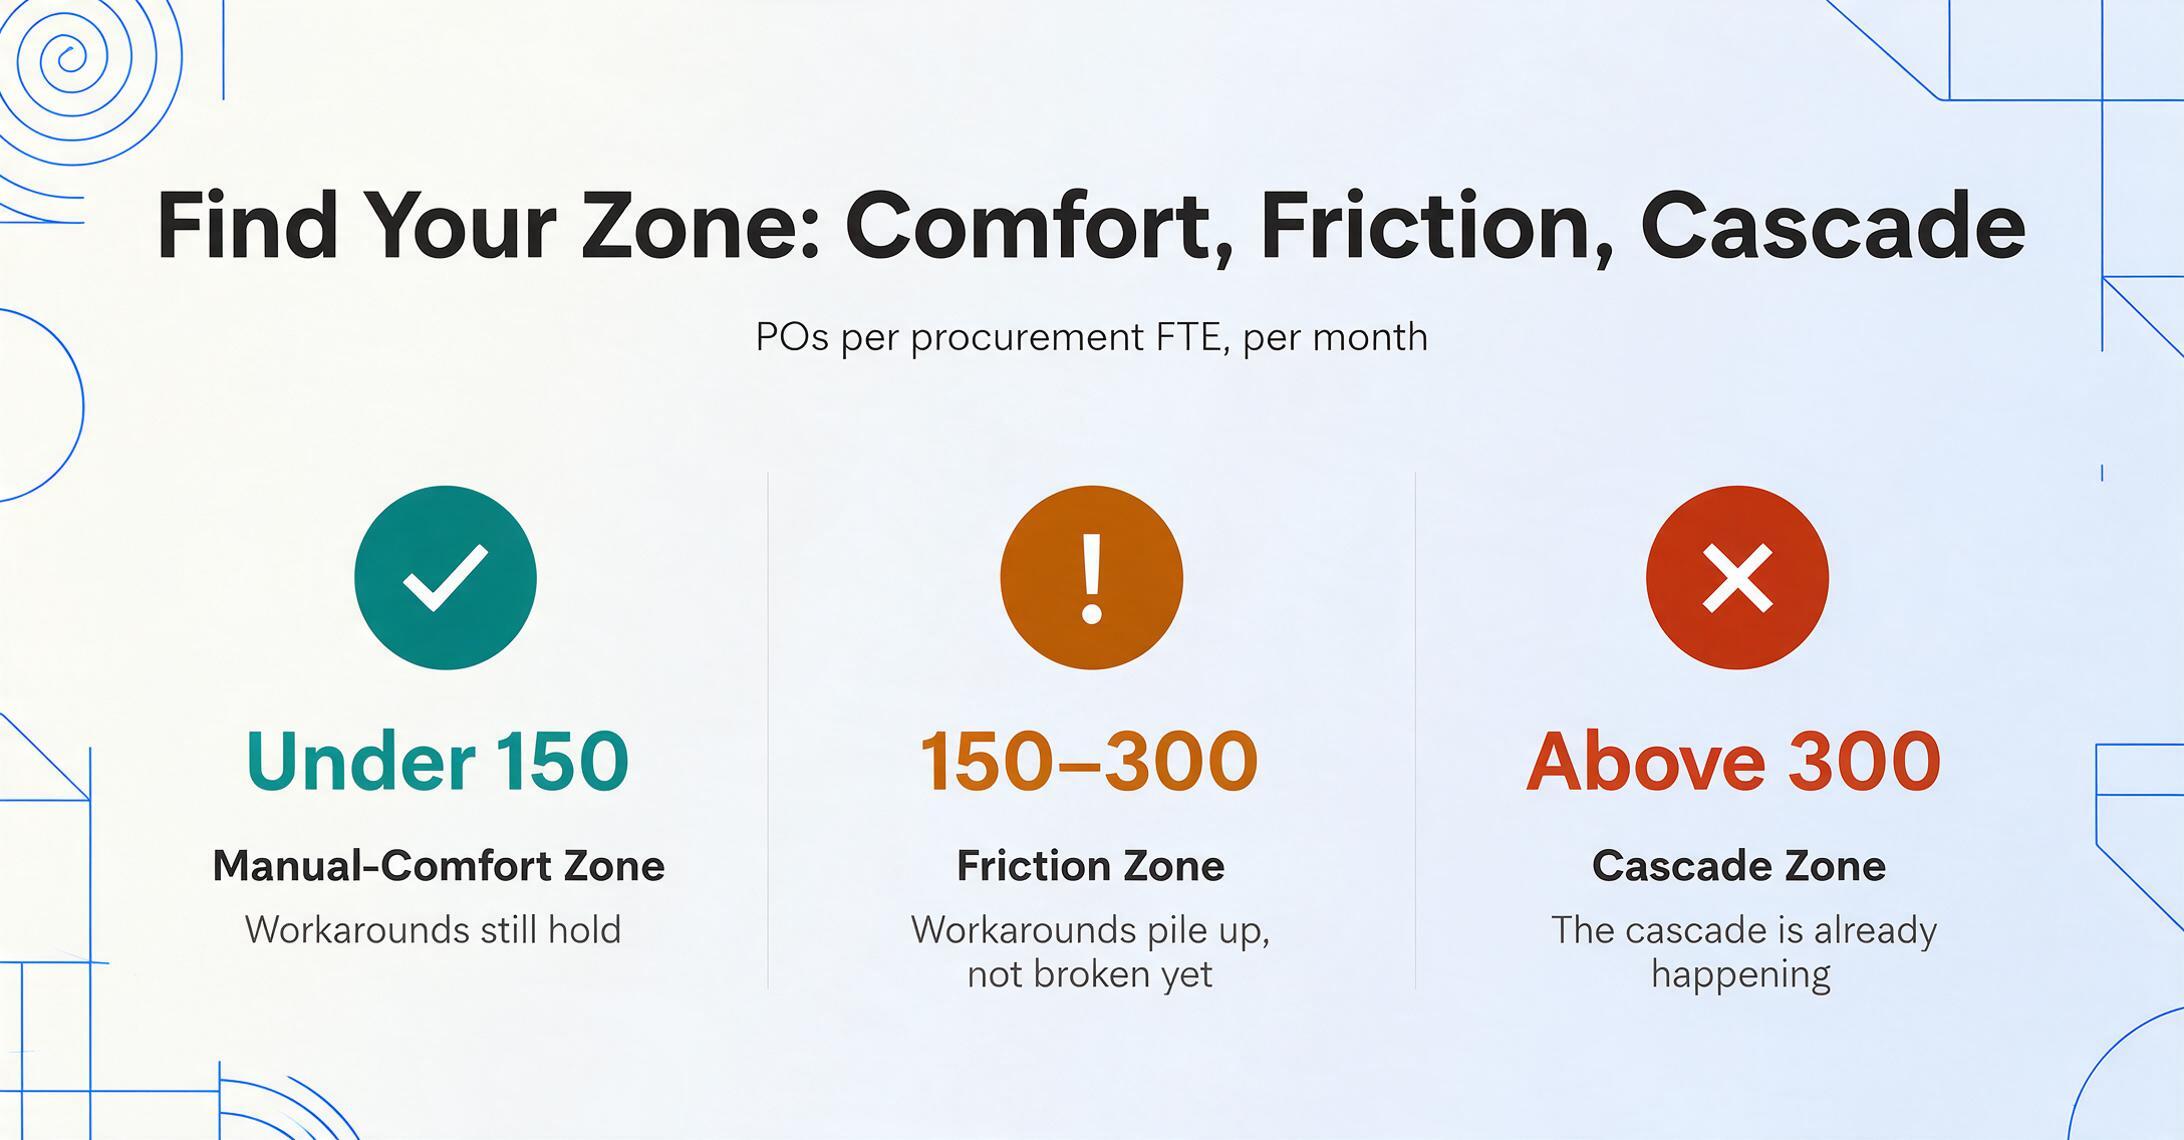
- 調達FTE1人あたりの月間PO処理件数。総PO件数を、PO処理を主業務とするFTEの数で割ります。150件未満の場合は、手動処理の快適ゾーンにいます。150〜300件の間は摩擦ゾーンです。回避策が蓄積されていますが、まだ破綻はしていません。300件を超えると、前述の連鎖反応がすでに発生しているか、差し迫っています。
- 例外率。標準的なデータ入力フロー以外の手動介入を必要とするPO(形式の問題、フィールド欠落、サプライヤーへの確認、承認ルートの変更など)を数えます。これが20%を超える場合、データ入力パイプラインのボトルネックは量ではなく、形式の不整合です。人員を増やしても解決しません。入力を標準化することで解決します。
- 受領から入力までのサイクルタイム。POが届いてから(メールのタイムスタンプ、アップロード時間)、そのデータがシステムに完全に入力されるまでの時間を測定します。75パーセンタイルが8時間を超える場合(APQCの上位組織の中央値サイクルタイム)、量が増えるたびに増幅されるスループットの問題があります。
- 見えないバックログ。48時間以上経過しても、入力・確認・エスカレーションされていないPOを数えます。これは、ほとんどのチームが追跡しておらず、差し迫った破綻を最も確実に予測する指標です。
この診断の結果は、業界ベンチマークと比較するための数値ではありません。それは、限界点がどこに現れ、それが来るまでにどれだけの時間があるかを示す地図です。FTEあたり月間180件のPOで例外率12%のチームには、計画を立てる余裕があります。260件で例外率25%のチームは、すでに連鎖反応の中にいます。ただ、それが体系的な問題であることにまだ気づいていないだけです。
CAPS Researchの業界横断データによると、調達スタッフは全社従業員数の平均1.90%を占め、調達支出は売上高の平均55.64%です。これらの比率は構造的なもので、量が急増しても柔軟に増えることはありません。つまり、PO量の増加に比例して調達人員が増えることはほとんどないということです。
人員を増やしてもスケールしない理由
調達チームが処理能力の限界に達したとき、直感的な対応はバイヤーをもう一人雇うことです。しかしそれは誤った対応でもあります——APQCのデータがその理由を示しています。
人員を増やすことで問題が解決するのであれば、上位の組織と下位4分位の組織との間のPO(購買発注書)処理件数(FTEあたり)の差は、個人の生産性の違いを反映した2倍〜3倍程度の小さなものになるはずです。実際の差は11倍です。上位と下位を分けるのは人員数ではありません。上位の組織は、人間の判断を必要としない調達プロセスの部分をシステム化し、担当者が判断を要する部分に時間を費やせるようにしているのです。
月間300件のPOを処理するチームにバイヤーをもう一人追加しても、処理能力は2倍になりません。むしろ、人員が増えるごとに複合的に膨らむ調整コストが発生します。どのサプライヤーを誰が担当するのか、バックログは誰のものか、どの例外を誰にエスカレーションするのか。担当者が3人になれば調達マネージャーが必要になり、5人になれば文書化されたプロセスが必要になり、8人になれば、主たる活動が自己管理となった部門ができあがります——そして当初の問題(POデータの処理が十分に速くないこと)は、3人のときよりも悪化しているのです。
ここには組織の物理法則が働いています。製造業リーダーシップ協議会(NAMのデジタル変革部門)による有名な調査結果によれば、製造業の70%がいまだに手作業でデータを入力しています。自動化ツールが利用可能であるにもかかわらず、この数字は長年にわたり大きく変わっていません。なぜなら、量のプレッシャーに対する組織の標準的な対応は「人員とプロセスを追加する」ことであり、「システムを再設計する」ことではないからです。この70%という数字はテクノロジー導入の統計ではなく、組織の慣性を示す統計なのです。
手作業によるPOデータ入力が、数十年にわたってテクノロジーが利用可能であったにもかかわらず構造的な問題として存続し続ける理由をより深く知りたい方は、購買発注書のデータ入力問題——そしてそれを支え続ける要因に関する分析をご覧ください。
破綻直前の準備フレームワーク
4つの診断指標でチームを評価し、摩擦ゾーンに該当する場合、またはその傾向がある場合は、以下の4段階の準備シーケンスにより、ERP導入や人員増加を必要とせずに時間とキャパシティを確保できます。このシーケンスには順序に意味があります。各段階が、次の段階が依存する能力を構築するからです。
ステージ1:受付を標準化する。 ツールが役立つ前に、まず入り口での形式の混乱を排除する必要があります。これはすべてのサプライヤーに自社の形式への準拠を求めるという意味ではありません。彼らは従いません。意味するところは、あらゆる形式(PDF、スキャン画像、メール添付、サプライヤーのERPからのExcelエクスポート)を受け付け、同じ処理パイプラインに一貫して送り込む単一の受付チャネルを実装することです。コレクションリンク — ファイルを処理キューに直接ルーティングする共有可能なアップロードURL — は、サプライヤーの協力を必要とせずに受付の問題を解決します。サプライヤーはこれまでどおり、手持ちのものを送信するだけです。違いは、すべてが受信トレイに散在するのではなく、1か所に集まることです。
ステージ2:プロセス全体ではなく、抽出を自動化する。 ここが、ほとんどの調達デジタル化プロジェクトが失敗するポイントです。彼らは、調達から支払いまでの全サイクル(要求、承認、PO作成、受領、請求書照合、支払い)を単一のイニシアチブで自動化しようと試みます。その結果は、解決する問題よりもコストがかかる18か月の実装です。SAP Ariba、Coupa、Jaggaerなどのエンタープライズ調達スイートは強力ですが、その実装期間と価格帯は、20名以上の調達チームを持つ組織向けに設計されています。ミッドマーケットのメーカー(売上高1,000万ドルから1億ドルの企業)はギャップに陥ります。エンタープライズツールは高価で複雑すぎ、一方、エントリーレベルの購買ソフトウェアは承認は処理できますが、抽出は処理できません。
最もレバレッジの高い単一ステップは、受信したPOからのデータ抽出を自動化することです。つまり、PDF上のフィールドをスプレッドシートの構造化された行に変換することです。この1つのステップにより、PO処理の最大の変動コスト要素である入力時間が排除されます。列名抽出 — 必要なフィールド(PO番号、サプライヤー名、ライン項目の説明、数量、単価)を指定し、AIがページ上の位置ではなく意味を理解してそれらを特定する方法 — は、サプライヤーごとのテンプレートなしで、あらゆるPO形式で機能します。このアプローチのステップバイステップガイドについては、AI列名抽出を使用して特定の購買発注書フィールドをExcelに抽出する方法に関する記事をご覧ください。
ステージ3:単一POからバッチ処理へ移行する。 文書ごとの抽出が自動化されたら、次のスケーリングのレバーは複数のPOを同時に処理することです。1つのPOをアップロードし、抽出を待ち、レビューし、繰り返す代わりに、バッチ処理では複数のサプライヤーからのPOフォルダーをアップロードし、統合された単一のスプレッドシートを受け取ることができます。抽出パイプラインは、すべての文書に同じ列定義を適用します。出力はレビューする50件の個別抽出ではなく、POごとに1行、合計50行の1つのテーブルです。これにより、レビューステップが「50ファイルを個別に確認する」から「1つのスプレッドシートを異常についてスキャンする」に変わります。運用上の詳細については、異なるベンダーからの購買発注書を1つの統合スプレッドシートにバッチ処理する方法に関するガイドをご覧ください。
ステージ4:出力を下流システムに接続する。抽出が自動化されバッチ処理されて初めて、統合を検討する価値が生まれます。抽出出力(構造化されたExcelまたはCSVファイル)は、そのままERP、会計システム、または受注管理プラットフォームにインポートできます。重要な洞察は、このステージではERPの仕組みを変更する必要がないということです。抽出レイヤーは下流システムが期待する形式でデータを生成し、統合はファイルインポートであって、システム再構築ではありません。アップロードから抽出、ERP対応出力までの完全なワークフローについては、ERPなしで購買発注書データ入力を自動化するに関する記事をご覧ください。
ステージ1と2(コレクションリンクによる受付の標準化、抽出の自動化)を完了した中堅メーカーは、調達担当者を増やすことなく、通常PO量の3〜4倍を処理できます。ステージ3と4では、さらに8〜10倍に拡大します。APQCの上位企業と下位企業の間にある11倍の差は、魔法というより算数のように見えてきます。
AI文書抽出が適している領域と、適していない領域
あらゆるスケーリングフレームワークには、その限界を正直に説明する必要があります。AI文書抽出(購買発注書PDFを読み取り、構造化データをスプレッドシートに出力する種類のもの)は、データ入力のボトルネックに対処し、間接的には文書あたりの認知負荷を減らすことで例外処理のボトルネックにも対処します。しかし、サプライヤー関係管理、戦略的調達、契約交渉、コンプライアンス監査には対応しません。
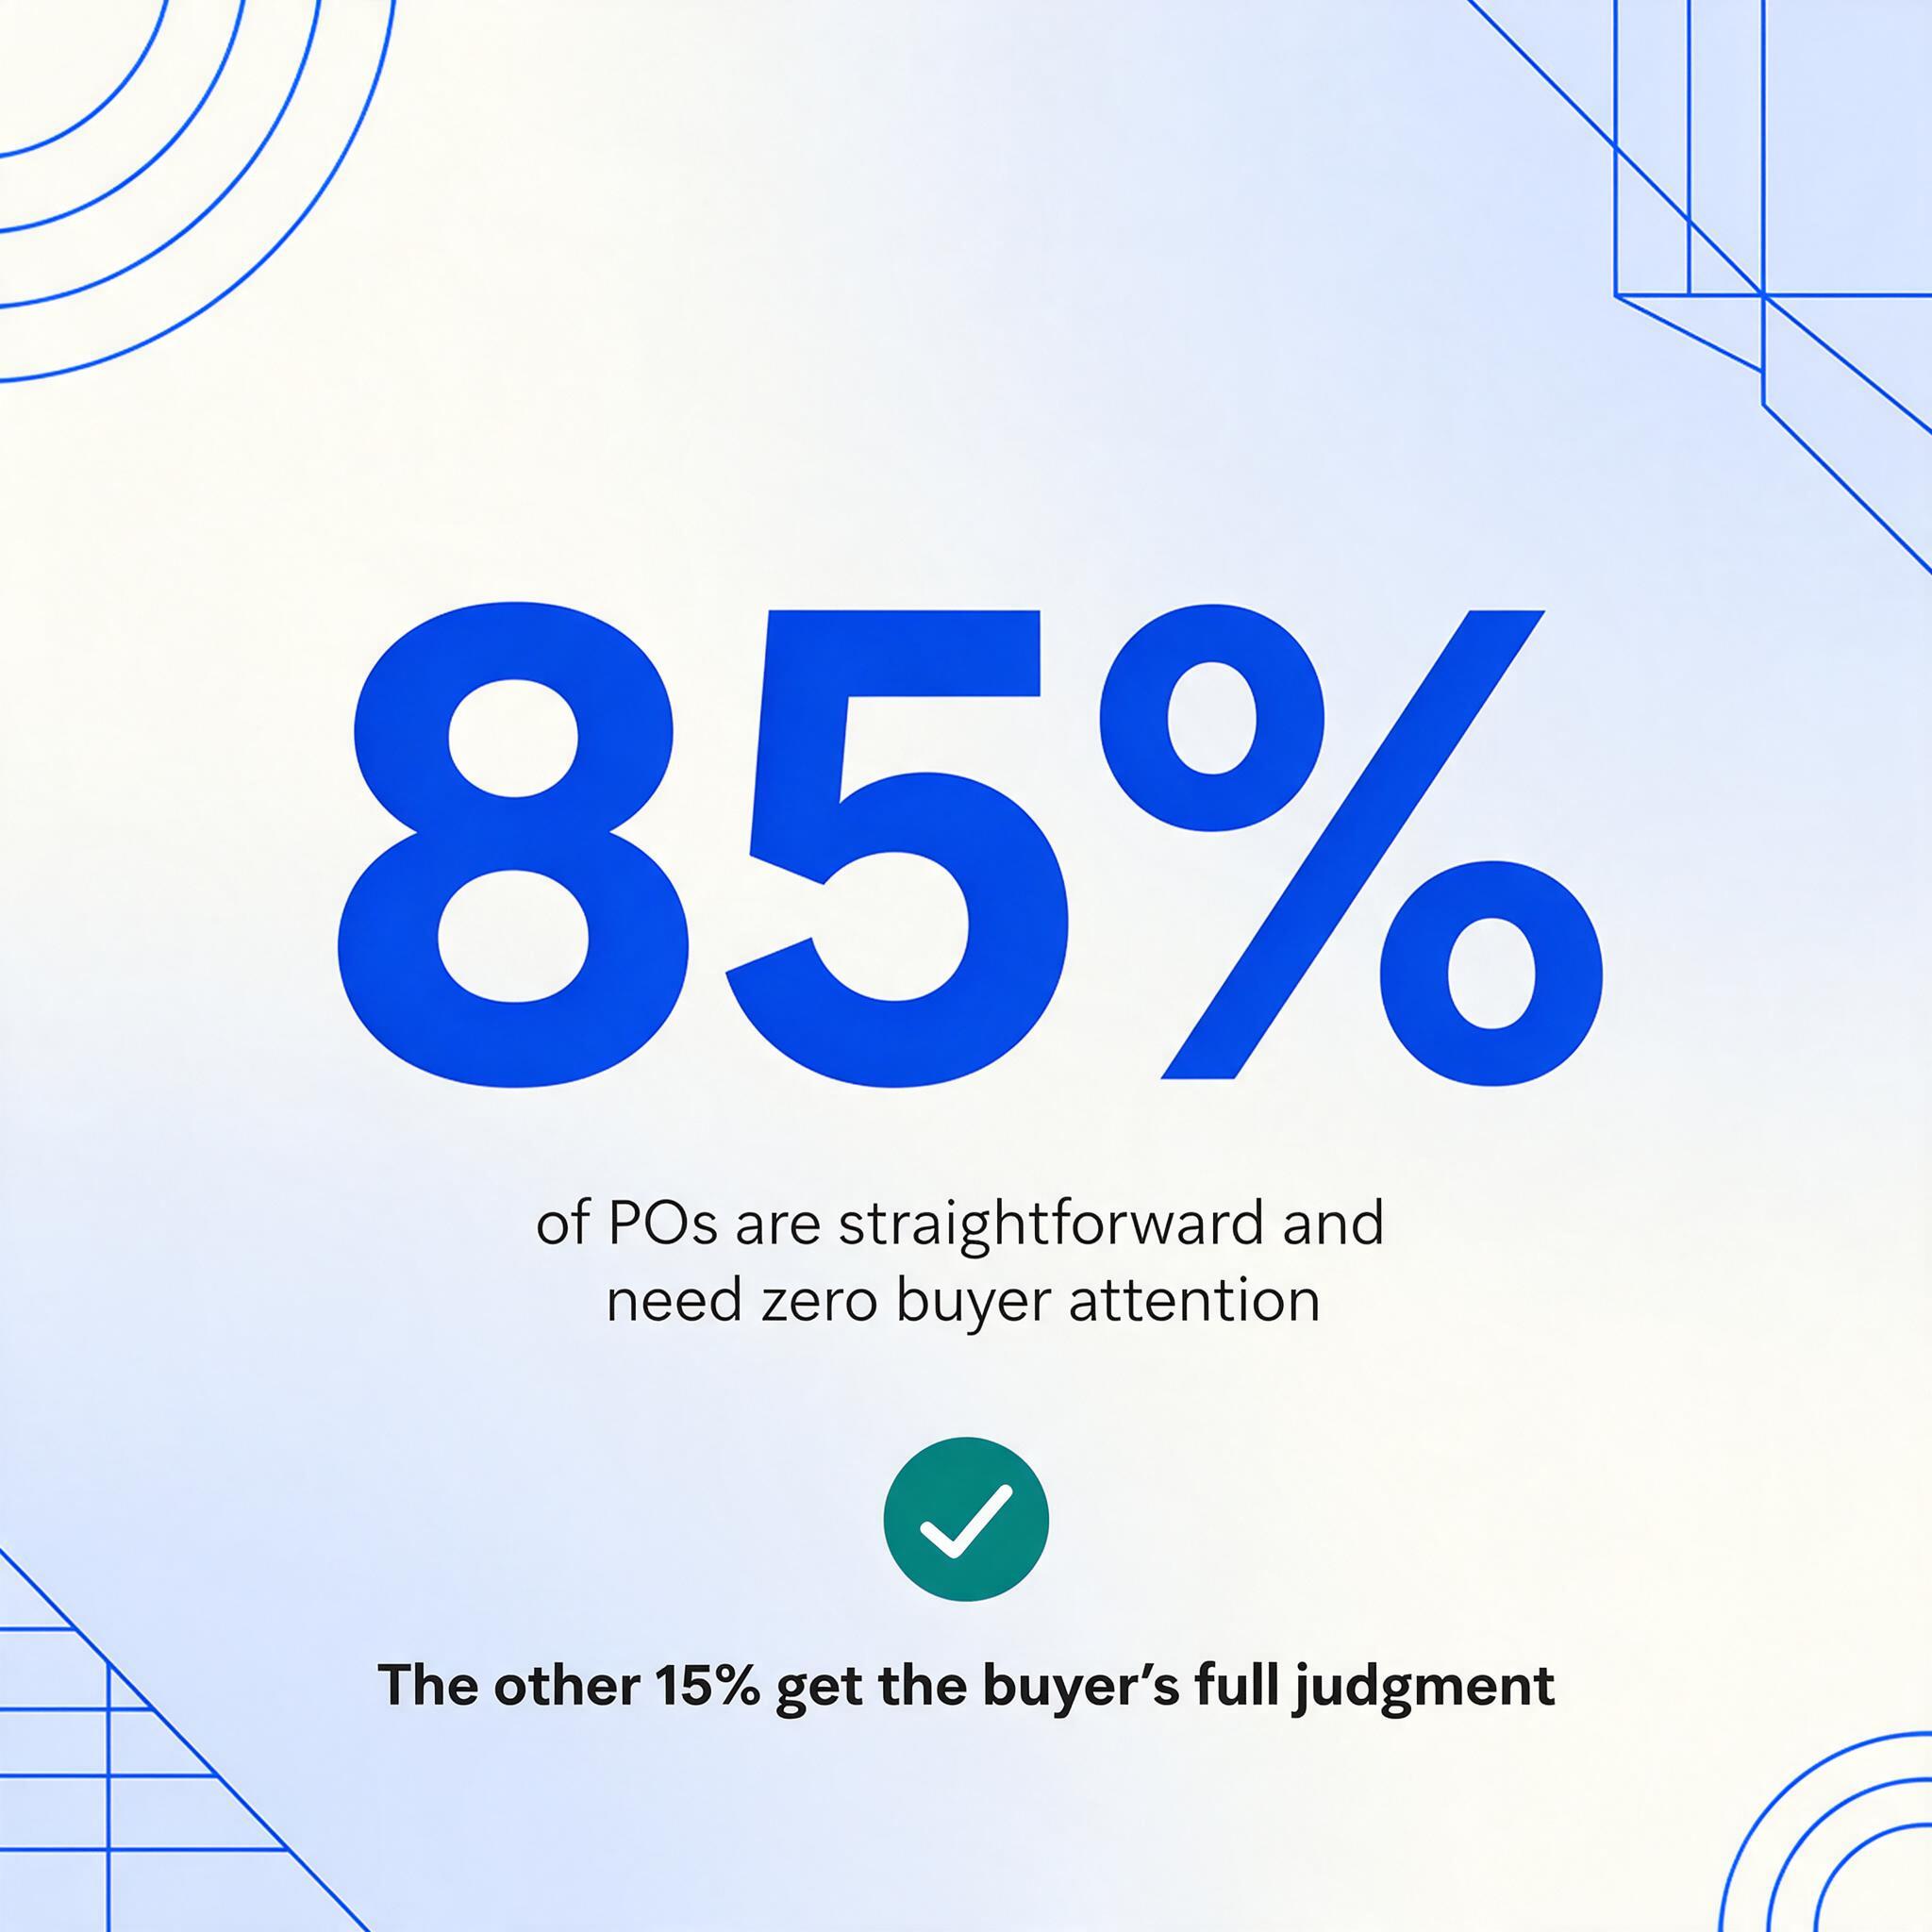
この技術が置き換えるのは、調達ワークフローで最もコストのかかる1分間、つまり誰かがPDFからフィールドを読み取ってセルに入力する時間です。ツールベースの抽出は、1ページを5〜10秒で処理し、印刷テキストでは最大99%の精度を実現します。同じデータの手動入力と比較して約18倍高速です。しかし、スケーリングにとって重要な数字はページあたりの速度ではありません。重要なのは、データ入力をしなくなったときの購入者の認知帯域幅に何が起こるかです。入力から解放された購入者は、はるかに多くのPOの例外レビューを処理できます。なぜなら、単純な85%のPOはまったく注意を消費しないからです。人間の判断が必要な15%にのみ集中すればよいのです。
これがこのフレームワークが依存するスケーリングの原則です:自動化は人間の判断の必要性を排除しません。価値を生む場所にそれを集中させるのです。
ISO規格はこのバランスを強調しています。ISO 9001セクション8.4は、組織が購入製品が指定された要件に適合していることを検証することを要求しており、これはPO量に比例して拡大するコンプライアンス義務です。ISO 20400は、環境的・社会的基準を考慮したサプライヤー評価を要求する持続可能な調達の側面を追加します。どちらの規格も、すべてのPOを手動でシステムに入力することを要求していません。しかし、両方とも、誰かがどこかでデータが正しく、サプライヤーが適格であることを検証することを要求しています。AI抽出はデータの移動を処理し、購入者は検証を処理します。労力のペナルティなしに規格は満たされます。
POアップロードから好みの形式の構造化データへの直接的な経路については、購買発注書からExcelへの変換ツールをお試しください。ヘッダーフィールドと複数行のラインアイテムの両方を、あらゆるPOレイアウトから処理し、サプライヤーごとのテンプレート設定は不要です。
FAQ
1人で処理するPOは月に何件までが限界ですか?
普遍的な数字はありませんが、APQCのベンチマークデータが参考になります。中央値では、調達部門は業界や複雑さに応じて、FTEあたり月に100〜300件のPOを処理しています。製造業のPOは、複数行のラインアイテム、部品番号、納品スケジュールを含む傾向があり、下限に近くなります。より有用な質問は「何件か」ではなく、「例外率とサイクルタイムはどうか」です。月に150件のクリーンなPOを処理するバイヤーは、100件のPOのうち30%に手動介入が必要なバイヤーよりも負担が少ないのです。
SAP AribaやCoupaのような本格的な調達スイートは必要ですか?
主なボトルネックがデータ入力であれば、必要ありません。エンタープライズ調達スイートは、支出の可視化、承認ワークフロー、サプライヤーライフサイクル管理、契約コンプライアンスといった、別の課題を解決するものです。導入には6〜7桁のコストと12〜18ヶ月の期間がかかります。チームの課題が「POデータをシステムに十分な速さで入力できない」ことなら、抽出自動化から始めてください。数ヶ月ではなく数時間で導入でき、コストもエンタープライズスイートの数分の一です。エンタープライズスイートは後からでも構いませんし、成長の軌道によっては不要な場合もあります。
AI抽出は手書きの購買発注書でも機能しますか?
はい、ただし条件付きです。ImageToTable.aiのビジョンモデルは筆記体を含む手書き文字を読むことができますが、特に小さな手書き文字が密集したフォームでは、印字されたテキストよりも精度が低くなります。手書きが例外であるPO(サプライヤーが印刷されたフォームにメモを書き込む場合)では、ツールはうまく処理します。完全に手書きのPOの場合は、抽出されたデータをより注意深く確認する必要があります。仕様に記載されている99%の精度は印刷された表データに適用されるもので、手書きの精度は読みやすさと密度に依存します。
自動化が経済的に意味を持つ最小のPO量はどのくらいですか?
おおよそ月100件のPO(1営業日あたり約5件)で、自動抽出による時間節約がツールのコストを上回り始めます。この閾値を下回ると、抽出列の設定や出力の確認に費やす時間が、データを手入力する時間を上回る可能性があります。しかし、この記事のフレームワークはスケーリングに関するものです。現在月100件のPOを処理していて会社が成長しているなら、問題は「今すぐ自動化が必要か」ではなく、「どの量で必要になるか、そして展開にどれだけのリードタイムが必要か」です。この記事の診断指標は、量自体が答えを強制する数ヶ月前に、その質問に答えるのに役立つように設計されています。
サプライヤーはPOを直接処理キューにアップロードできますか?
はい。コレクションリンク(生成してサプライヤーに送信する共有可能なURL)を使用すると、サプライヤーはアカウントやログインを必要とせずに、POを直接処理パイプラインにアップロードできます。サプライヤーはリンクを開き、短いコードで確認してからファイルをアップロードします。ファイルは抽出のためにキューに届きます。これにより、メール添付のやり取りが不要になり、すべてのPOが同じ標準化されたチャネルを通って入力されるため、診断フレームワークで説明されているスループット指標が直接改善されます。
調達自動化への投資は、導入した時点では回収されません。回収されるのは、導入しなければ破綻していたであろうボリュームに達した時点です。この記事のフレームワークは、その瞬間の前に導入するために役立ちます。なぜなら、導入が後になると、バックログを処理しながらチームを再構築することになるからです。