Escalando o Procurement na Manufatura:
Quando 200 POs Viram 2.000
O número mais perigoso no procurement não é o volume de POs que sua equipe está processando. É a diferença entre quantas POs eles estão lidando e quantas eles acreditam que conseguem lidar — antes de algo quebrar. Essa diferença é invisível para a maioria dos dashboards de KPI. Ela não aparece nos relatórios mensais. E quando alguém percebe, três sistemas separados já começaram a falhar em uma sequência que nenhuma quantidade de horas extras consegue reverter.
Principais Conclusões
- O sinal de alerta mais confiável de uma falha no procurement — POs intocadas por mais de 48 horas — é invisível para dashboards de KPI padrão porque quase nenhum deles rastreia a idade do backlog em vez do volume.
- As melhores equipes de procurement não processam 11 vezes mais POs por pessoa trabalhando mais — elas processam mais porque redesenharam quais partes do trabalho passam por uma máquina e quais precisam de uma decisão humana.
- Sair da armadilha da entrada manual de dados — na qual 70% dos fabricantes ainda estão presos — não exige uma implementação de ERP de 18 meses; exige colocar a extração automatizada na frente do fluxo de trabalho para que os compradores gastem o dia com exceções, não digitando.
Os três sistemas que falham — e por que ninguém os vê chegar
O processamento de pedidos de compra não é uma atividade única. São três sistemas interdependentes empilhados uns sobre os outros, cada um com seu próprio ponto de ruptura. Quando uma equipe manusea de 100 a 200 POs por mês, os três sistemas geralmente se sustentam. Soluções informais — uma nota adesiva no monitor, uma anotação mental sobre um fornecedor atrasado, uma mensagem rápida no Slack para contabilidade — são suficientes para preencher as lacunas. Mas cada um desses sistemas tem um limite de volume a partir do qual as soluções param de funcionar, e nem todos falham ao mesmo tempo.
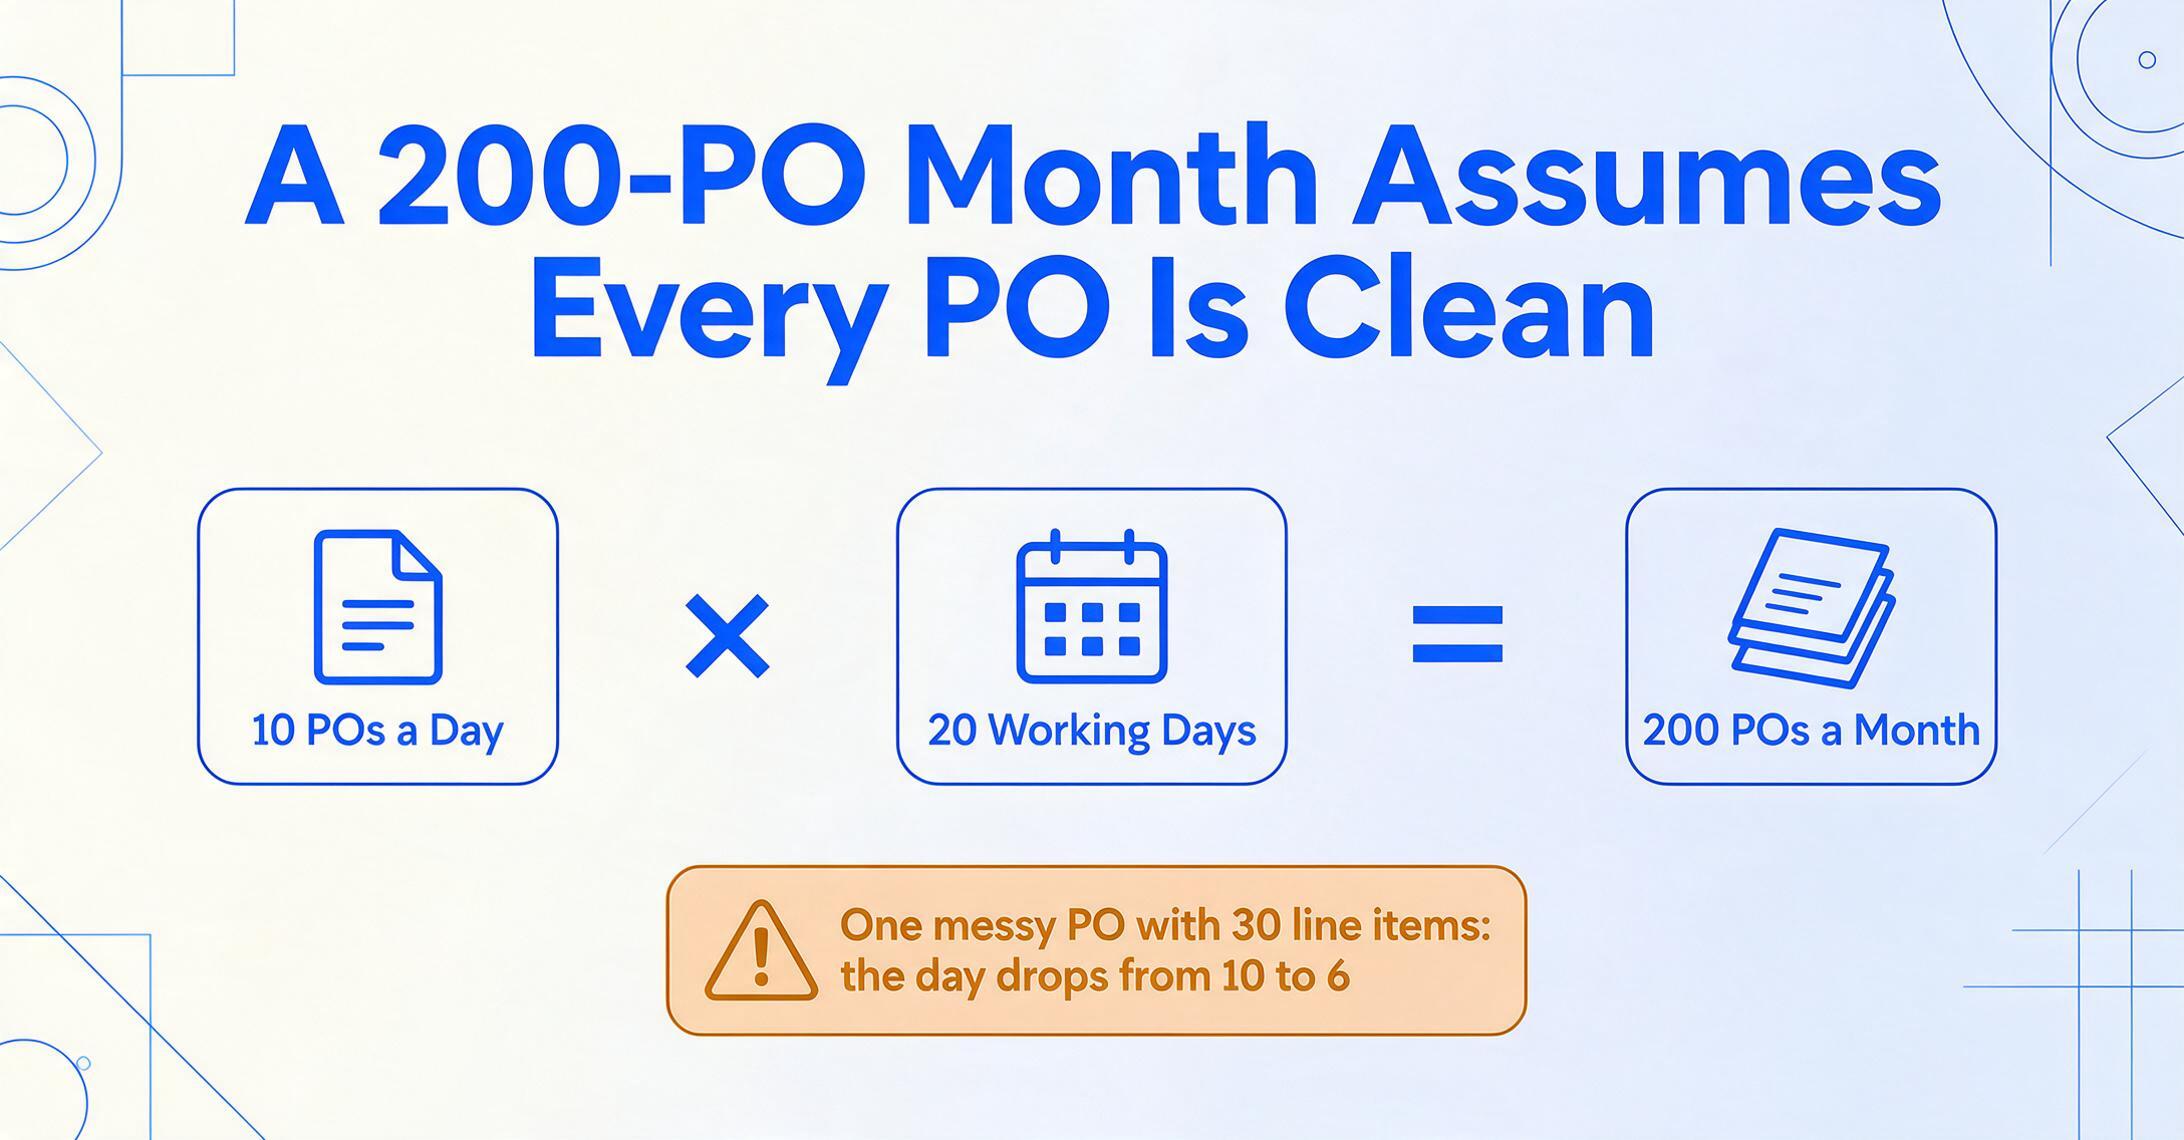
O primeiro sistema a falhar é a capacidade de entrada de dados — o pipeline que converte o formato de PO de um fornecedor em algo que seus sistemas internos possam usar. A 200 POs por mês, um comprador em tempo integral pode processar aproximadamente 10 POs por dia, se cada um leva cerca de 30 minutos de entrada de dados, acompanhamento e arquivamento. A matemática é justa, mas administrable: 10 POs × 20 dias úteis = 200. Mas essa matemática assume que cada PO está limpo, que cada fornecedor responde ao e-mail no mesmo dia e que nenhuma excepção exige tempo extra. Na prática, um único PO com 30 itens de linha em duas páginas de um PDF escaneado pode consumir uma hora por si só — e a capacidade desse comprador para o dia cae de 10 a 6.
O segundo sistema a quebrar é o rastreamento e a comunicação. Como um comprador de procurement publicou no r/procurement: "Centenas de e-mails podem estar envolvidos por dia, desde os interminables e-mails de Leído/No leído, até POs em que você está trabalhando atualmente, até POs em que você está esperando uma resposta do fornecedor." Quando o volume passa de aproximadamente 300 POs por mês, o sistema informal de rastreamento mental colapsa. POs que estavam "em revisão" ou "esperando confirmação do fornecedor" começam a cair no limbo. Ninguém nota até que uma linha de produção esteja esperando material que deveria ter sido enviado há três dias.
O terceiro sistema — e o que a maioria dos gerentes de procurement não veem chegar — é o manejo de exceções. Cada lote de POs contém valores atípicos: um fornecedor mudou seu formato de PO, um novo vendedor enviou uma confirmação de pedido manuscrita, uma descrição de item de linha não corresponde ao código de produto em seu ERP. A 200 POs por mês, essas exceções são talvez 10–15% do total — 20 a 30 itens que um comprador experiente pode resolver ad hoc. A 500 POs por mês, as exceções ainda são 10–15% — mas agora são 50 a 75 itens. Cada uma requer uma decisão humana, uma chamada telefónica ou uma consulta manual. Não há cura de automação para exceções — mas há um ponto em que a carga de decisão acumulada excede o que uma equipe pode processar sem erros, atrasos ou ambos.
A cascada funciona assim: os gargalos de entrada de dados crian um acúmulo → o acúmulo sobrecarrega o sistema de rastreamento → POs não rastreados geran mais exceções → as exceções consomem o tempo que deveria ter sido dedicado à entrada de dados. Cada falha do sistema alimenta a seguinte. E a resposta organizacional — "todos simplesmente trabalhem mais" — acelera o ciclo ao esgotar as pessoas que estavam mantendo tudo unido.
Como Calcular Seu Punto de Ruptura Antes de Chegar a Ele
A diferença entre uma equipe que escala suavemente e uma que bate contra uma parede não são as ferramentas que usam — é se reconheceram que a parede se aproximava 18 meses antes de alcanzá-la.
Os dados de benchmarking Open Standards da APQC fornecem a âncora: as organizações gastam de $14 a mais de $54 para processar uma única ordem de compra. A mediana é de aproximadamente $50 a $100 quando se contabiliza os custos laborales completos, a sobrecarga dos sistemas e a correção de erros. Mas o número mais instrutivo é a dispersão de desempeño. Os de melhor desempeño processam mais de 11 vezes o número de POs por FTE de procurement que as organizações do quartil inferior. Essa brecha de 11x não é explicada por pessoas mais inteligentes — é explicada pelo design do processo e pelas ferramentas.
Aquí está uma estrutura de diagnóstico para localizar sua organização na curva de escalamento. Rastree estas quatro métricas durante um mês:
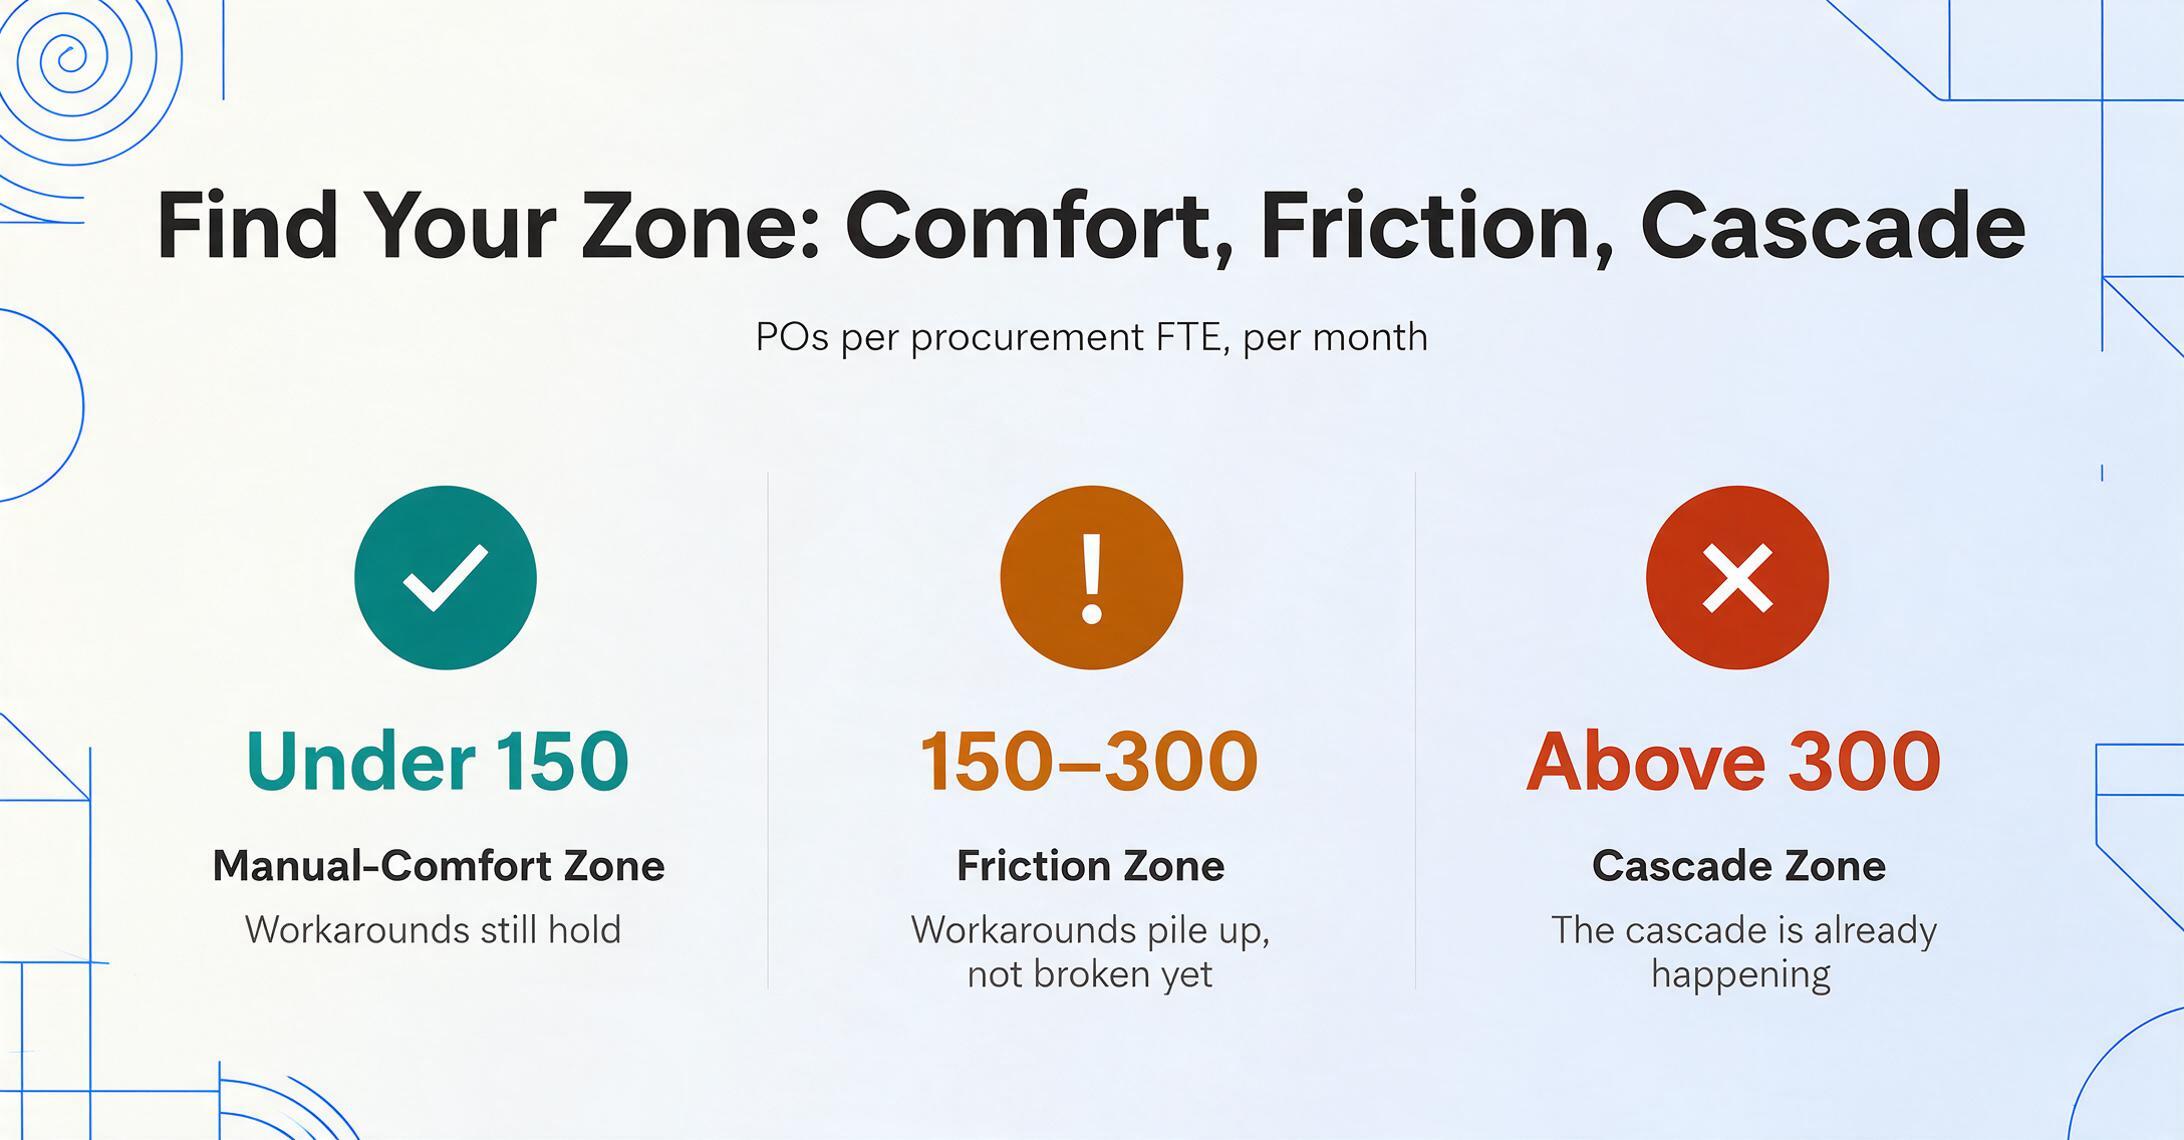
- POs por FTE de procurement por mês. Divida o total de POs pelo número de FTEs cuja função principal é o processamento de POs. Se o número é inferior a 150, você está na zona de confort manual. Entre 150 e 300, você está na zona de fricção — os workarounds estão se acumulando, mas ainda não quebraram. Acima de 300, a cascada descrita acima já está ocorrendo ou é iminente.
- Taxa de excepção. Conte os POs que requerem uma intervenção manual além do fluxo padrão de entrada de dados — problemas de formato, campos faltantes, clarificação do fornecedor, re-roteo de aprobación. Se isso excede 20%, seu pipeline de entrada de dados está obstruido não pelo volume, mas pela inconsistência de formato. Adicionar pessoas não resolverá isso; estandarizar a entrada o fará.
- Tempo de ciclo desde a recepción até a entrada. Mida as horas entre quando um PO chega (timestamp do email, hora de upload) e quando seus dados são completamente inseridos em seu sistema. Se o percentil 75 excede 8 horas — o tempo de ciclo mediano para os de melhor desempeño da APQC — você tem um problema de throughput que se amplificará com cada aumento de volume.
- Backlog invisível. Conte os POs com mais de 48 horas que não foram inseridos, reconhecidos ou escalados. Esta é a métrica que a maioria das equipes não rastrea e que predice de forma mais confiable uma ruptura iminente.
O resultado deste diagnóstico não é um número para comparar com um benchmark da indústria. É um mapa de onde seu punto de ruptura aparecerá e quanto tempo você tem antes que chegue. Uma equipe com 180 POs por FTE por mês com uma taxa de excepção de 12% tem espaço para planificar. Uma equipe com 260 e uma taxa de excepção de 25% já está na cascada — simplesmente ainda não se deron conta de que é sistemática.
Os dados inter-industriais da CAPS Research mostram que o pessoal de procurement representa uma média de 1,90% do headcount total da empresa, com o gasto de procurement promediando 55,64% da receita. Estas proporções são estruturais — não se flexibilizan para arriba quando o volume aumenta. O que significa que o crescimento no volume de POs quase nunca vem com um crescimento proporcional no headcount de procurement.
Por que Adicionar Pessoal Também Não Escala
A resposta intuitiva para uma equipe de compras no limite da capacidade é contratar outro comprador. Também é a resposta errada — e os dados da APQC mostram o porquê.
Se a contratação resolvesse o problema, a diferença entre os melhores desempenhos e as organizações do quartil inferior em POs por FTE seria pequena — talvez 2x ou 3x, refletindo diferenças de produtividade individual. A diferença real é de 11x. O que separa o topo da base não é o número de funcionários. É que os melhores desempenhos sistematizaram as partes do processo de compras que não exigem julgamento humano, para que suas equipes gastem tempo nas partes que exigem.
Adicionar um segundo comprador a uma equipe que processa 300 POs por mês não dobra a produtividade. Isso cria uma sobrecarga de coordenação que aumenta a cada pessoa adicionada: quem cuida de quais fornecedores, de quem é o backlog de quem, quais exceções são escaladas para quem. Com três compradores, você precisa de um gerente de compras. Com cinco, você precisa de processos documentados. Com oito, você construiu um departamento cuja atividade principal é gerenciar a si mesmo — e o problema original (dados de PO não fluindo rápido o suficiente) está pior do que quando você tinha três pessoas.
Há uma física organizacional em jogo aqui. Uma observação famosa do Manufacturing Leadership Council — o braço de transformação digital da NAM — é que 70% dos fabricantes ainda coletam dados manualmente. Esse número não mudou significativamente em anos, apesar da disponibilidade de ferramentas de automação, porque a resposta organizacional padrão à pressão de volume é "adicionar pessoal e adicionar processo", não "redesenhar o sistema". O número de 70% não é uma estatística de adoção de tecnologia — é uma estatística de inércia organizacional.
Para uma análise mais aprofundada de por que a entrada manual de dados de PO persiste como um problema estrutural apesar de décadas de tecnologia disponível, veja nossa análise sobre o problema da entrada de dados de pedidos de compra — e o que o mantém.
A Estrutura de Preparação Antes do Ponto de Ruptura
Se você avaliar sua equipe usando as quatro métricas de diagnóstico e se encontrar na zona de atrito — ou tendendo a ela — a seguinte sequência de preparação em quatro estágios lhe dá tempo e capacidade sem exigir uma implementação de ERP ou aumento de pessoal. A sequência é importante: cada estágio desenvolve uma capacidade da qual o próximo depende.
Estágio 1: Padronize o recebimento. Antes que qualquer ferramenta possa ajudar, você precisa eliminar o caos de formatos no ponto de entrada. Isso não significa pedir que cada fornecedor siga seu formato — eles não vão. Significa implementar um único canal de recebimento que aceite qualquer formato (PDF, imagem escaneada, anexo de e-mail, exportação em Excel do ERP do fornecedor) e o alimente consistentemente no mesmo pipeline de processamento. Um Link de Coleta — uma URL de upload compartilhável que direciona arquivos diretamente para uma fila de processamento — resolve o problema de recebimento sem exigir cooperação do fornecedor. Os fornecedores enviam o que têm, da mesma forma que sempre enviaram; a diferença é que tudo chega em um só lugar, em vez de ficar espalhado pelas caixas de entrada.
Estágio 2: Automatize a extração, não o processo inteiro. É aqui que a maioria dos projetos de digitalização de compras dá errado. Eles tentam automatizar todo o ciclo de source-to-pay — requisição, aprovação, criação de PO, recebimento, conciliação de faturas, pagamento — em uma única iniciativa. O resultado é uma implementação de 18 meses que custa mais do que o problema que resolve. Suítes empresariais de compras como SAP Ariba, Coupa e Jaggaer são poderosas, mas trazem prazos de implementação e preços projetados para organizações com equipes de compras de 20 pessoas ou mais. Fabricantes de médio porte — empresas com receita de US$ 10 milhões a US$ 100 milhões — caem em uma lacuna: as ferramentas empresariais são caras e complexas demais, enquanto o software de compras de nível básico lida com aprovações, mas não com extração.
O passo único de maior alavancagem é automatizar a extração de dados de POs recebidos — convertendo os campos de um PDF em linhas estruturadas em uma planilha. Esse único passo elimina o maior componente de custo variável do processamento de PO: o tempo gasto digitando. A extração por nome de coluna — em que você especifica os campos desejados (Número do PO, Nome do Fornecedor, Descrição do Item, Quantidade, Preço Unitário) e a IA os localiza entendendo o que significam, não onde estão na página — funciona em qualquer formato de PO, sem modelos por fornecedor. Para um guia passo a passo dessa abordagem, consulte nosso artigo sobre extração de campos específicos de pedidos de compra para Excel usando extração por nome de coluna com IA.
Estágio 3: Passe do processamento de PO único para o processamento em lote. Uma vez que a extração é automatizada por documento, a próxima alavanca de escala é processar vários POs simultaneamente. Em vez de enviar um PO, aguardar a extração, revisar e repetir — o processamento em lote permite que você envie uma pasta de POs de vários fornecedores e receba uma única planilha consolidada. O pipeline de extração aplica as mesmas definições de coluna em todos os documentos. A saída não são 50 extrações separadas para revisar — é uma tabela com 50 linhas, uma por PO. Isso muda a etapa de revisão de "verificar 50 arquivos individualmente" para "examinar uma planilha em busca de anomalias". Para os detalhes operacionais, consulte nosso guia sobre processamento em lote de pedidos de compra de diferentes fornecedores em uma planilha consolidada.
Etapa 4: Conecte a saída aos sistemas downstream. Somente depois que a extração é automatizada e processada em lote faz sentido pensar na integração. A saída da extração — um arquivo Excel ou CSV estruturado — pode ser importada diretamente no seu ERP, sistema contable ou plataforma de gestão de pedidos. O insight crítico é que esta etapa não exige modificar o funcionamento do seu ERP. A camada de extração produz dados no formato que o sistema downstream espera; a integração é uma importação de arquivo, não uma reconstrução do sistema. Para o fluxo de trabalho completo — do upload à extração até a saída pronta para ERP — consulte nosso artigo sobre automatização da entrada de dados de pedidos de compra sem ERP.
Um fabricante de mercado médio que completa as etapas 1 e 2 — padronizar a entrada através de um link de coleta, automatizar a extração — normalmente consegue lidar com um aumento de 3–4x no volume de POs sem adicionar pessoal de procurement. As etapas 3 e 4 estendem isso a 8–10x. A diferença de 11x entre os performers superiores e inferiores da APQC começa a parecer menos magia e mais aritmética.
Onde a Extração de Documentos com IA se Encaixa — e Onde Não
Todo framework de escalabilidade precisa de uma contabilização honesta de seus limites. A extração de documentos com IA — o tipo que lê um PDF de pedido de compra e gera dados estruturados em uma planilha — aborda o gargalo de entrada de dados e, indiretamente, o gargalo de manuseo de exceções ao reduzir a carga cognitiva por documento. Não aborda a gestão de relacionamento com fornecedores, sourcing estratégico, negociação de contratos ou auditoria de conformidade.
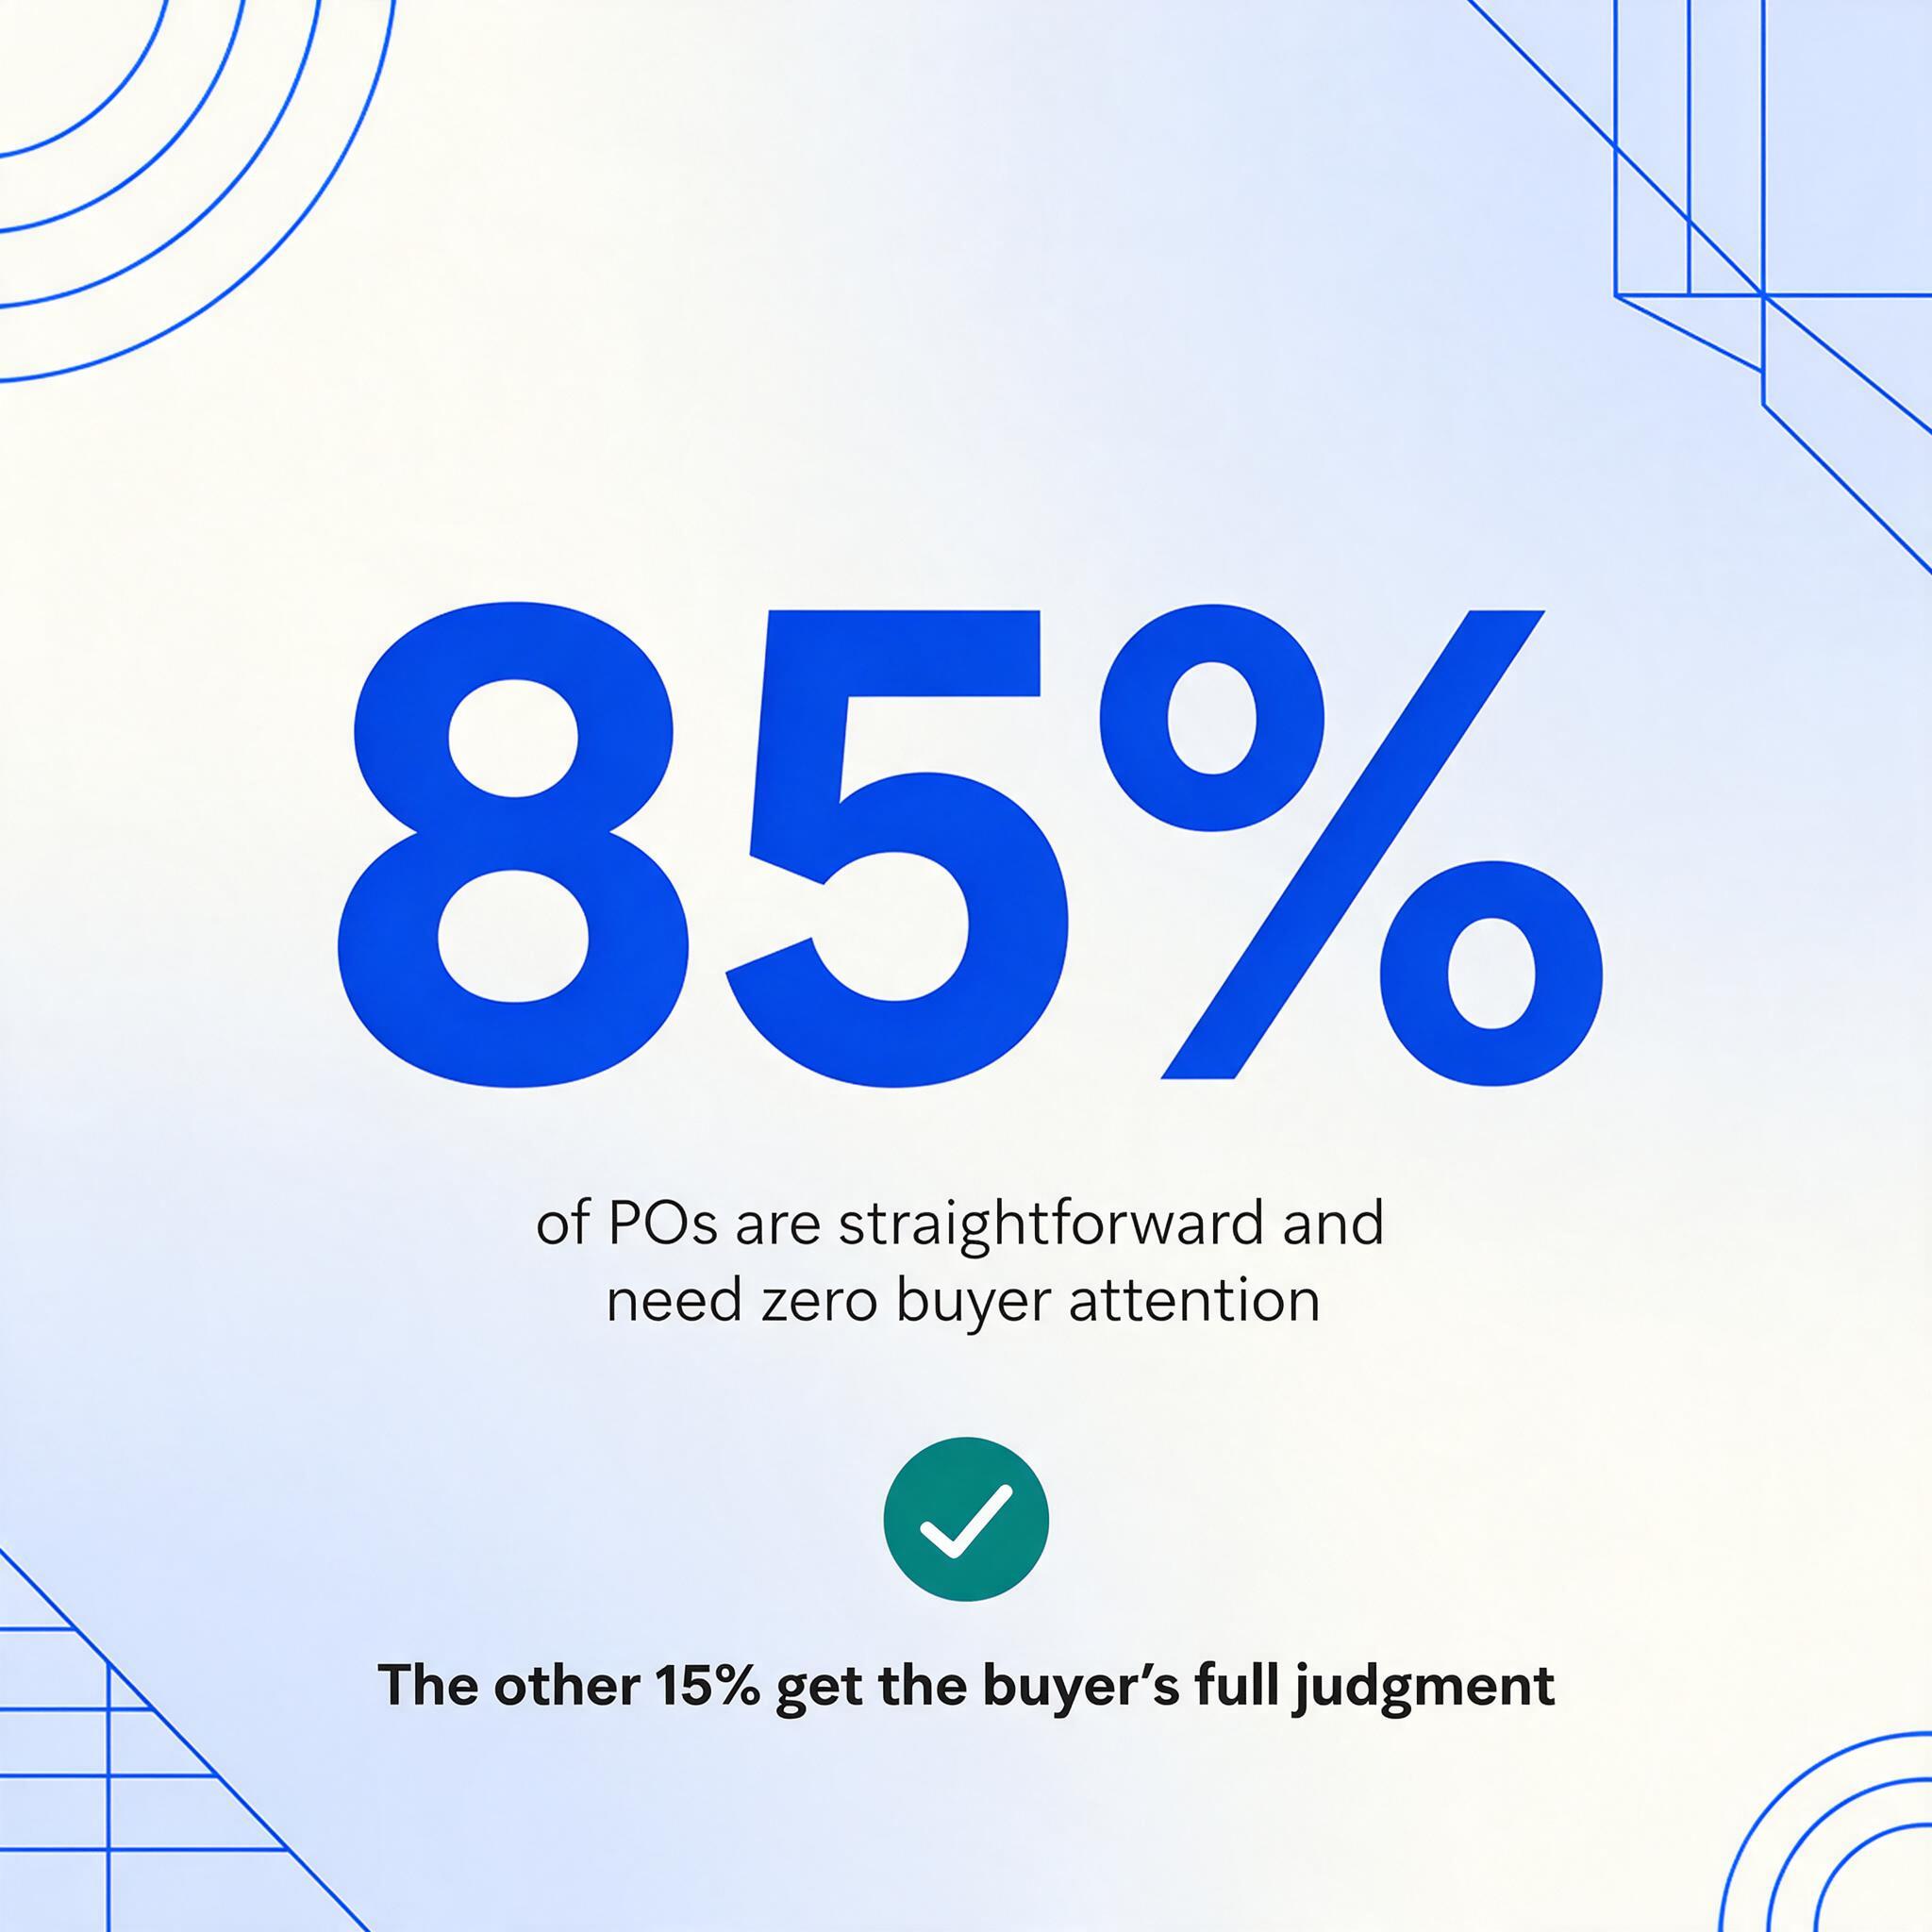
O que faz é substituir o minuto mais caro no fluxo de trabalho de procurement: o minuto que alguien gasta lendo um campo de um PDF e digitando em uma célula. A extração baseada em ferramentas processa uma página em 5 a 10 segundos com até 99% de precisão para texto impresso — aproximadamente 18 vezes mais rápido que a entrada manual para os mesmos dados. Mas o número que importa para escalar não é a velocidade por página. É o que acontece com a largura de banda cognitiva do comprador quando não está mais fazendo entrada de dados. Um comprador liberado de digitar pode lidar com a revisão de exceções para um volume muito maior de POs — porque os 85% de POs que são diretos não consomem sua atenção. Eles só precisam focar nos 15% que requerem uma decisão humana.
Este é o princípio de escalabilidade do qual o framework depende: a automação não elimina a necessidade de julgamento humano. Ele o concentra onde agrega valor.
As normas ISO sublinham este equilíbrio. ISO 9001 Seção 8.4 exige que as organizações verifiquem que os produtos comprados estejam em conformidade com os requisitos especificados — uma obrigação de conformidade que escala linearmente com o volume de POs. ISO 20400 adiciona a dimensão de procurement sustentável, exigendo avaliações de fornecedores que considerem critérios ambientais e sociais. Nenhuna norma exige que cada PO seja digitado manualmente em um sistema — mas ambas exigem que alguien, em algum lugar, tenha verificado que os dados estão corretos e que o fornecedor está qualificado. A extração com IA maneja o movimento de dados; o comprador maneja a verificação. A norma é cumprida sem a penalidade de trabalho.
Para um caminho direto do upload de PO a dados estruturados no formato de sua preferência, experimente nosso conversor de pedido de compra para Excel — ele maneja tanto campos de cabeçalho como itens de linha de múltiplas filas de qualquer layout de PO, sem modelos a configurar por fornecedor.
FAQ
Quantos pedidos de compra (PO) por mês são demais para uma pessoa?
Não existe um número universal, mas os dados de benchmarking do APQC fornecem uma referência útil. Na mediana, as organizações de procurement processam de 100 a 300 POs por equivalente a tempo integral (FTE) por mês, dependendo do setor e da complexidade. Os POs de manufatura — que tendem a incluir itens de linha com várias filas, números de peça e cronogramas de entrega — ficam na parte inferior da escala. A questão mais útil não é "quantos", mas "qual é a taxa de exceção e o tempo de ciclo". Um comprador que processa 150 POs limpos por mês está sob menos pressão do que alguém que processa 100 POs onde 30% exigem intervenção manual.
Preciso de uma suíte completa de procurement como SAP Ariba ou Coupa?
Não, se seu principal gargalo é a entrada de dados. As suítes empresariales de procurement resolven um conjunto diferente de problemas — visibilidade de gastos, fluxos de aprobación, gestión del ciclo de vida de proveedores, cumplimiento de contratos. Cuestan seis a siete cifras y toman de 12 a 18 meses para implementar. Si el punto de dolor de su equipo es "no podemos ingresar los datos de PO en nuestro sistema lo suficientemente rápido", comience con la automatización de extracción. Se implementa en horas, no en meses, y cuesta una fracción de una suite empresarial. La suite empresarial puede venir después — o no venir en absoluto, dependiendo de su trayectoria de crecimiento.
¿La extracción con IA funciona con órdenes de compra escritas a mano?
Sí, con calificaciones. El modelo de visión de ImageToTable.ai puede leer escritura a mano — incluida la cursiva — pero la precisión es menor que para texto impreso, especialmente en formularios densos con escritura pequeña. Para POs donde la escritura a mano es la excepción más que la regla (un proveedor anota una nota en un formulario impreso), la herramienta lo maneja bien. Para POs completamente escritos a mano, espere revisar los datos extraídos con más cuidado. La precisión del 99% citada en nuestras especificaciones se aplica a datos de tablas impresas; la precisión de la escritura a mano depende de la legibilidad y la densidad.
¿Cuál es el volumen mínimo de POs donde la automatización tiene sentido financiero?
Aproximadamente a 100 POs por mes — alrededor de 5 por día hábil — el ahorro de tiempo de la extracción automatizada comienza a superar el costo de la herramienta. Por debajo de ese umbral, el tiempo dedicado a configurar las columnas de extracción y revisar la salida puede no superar el tiempo dedicado a simplemente escribir los datos. Pero el marco de este artículo trata sobre escalar: si está en 100 POs por mes hoy y su empresa está creciendo, la pregunta no es "¿necesito automatización ahora?" sino "¿a qué volumen la necesitaré y cuánto tiempo de anticipación necesito para implementarla?". Las métricas de diagnóstico en este artículo están diseñadas para ayudarle a responder esa pregunta meses antes de que el volumen mismo fuerce la respuesta.
Os fornecedores podem enviar POs diretamente para minha fila de processamento?
Sim. Um Link de Coleta — uma URL compartilhável que você gera e envia aos fornecedores — permite que eles enviem POs diretamente para seu pipeline de processamento, sem precisar de conta ou login. Eles abrem o link, verificam com um código curto e enviam o arquivo. Ele chega na sua fila para extração. Isso elimina o vai e vem de anexos por e-mail e garante que cada PO entre pelo mesmo canal padronizado, o que melhora diretamente as métricas de throughput descritas no framework de diagnóstico.
O investimento em automação de compras não se paga quando você o implementa. Ele se paga quando seu volume atinge o ponto em que você teria quebrado sem ele. O framework deste artigo existe para ajudá-lo a implementar antes desse momento — porque implementar depois significa reconstruir uma equipe enquanto ela ainda processa o backlog.