Skalierung der Fertigungsbeschaffung:
Wenn aus 200 Bestellungen 2.000 werden
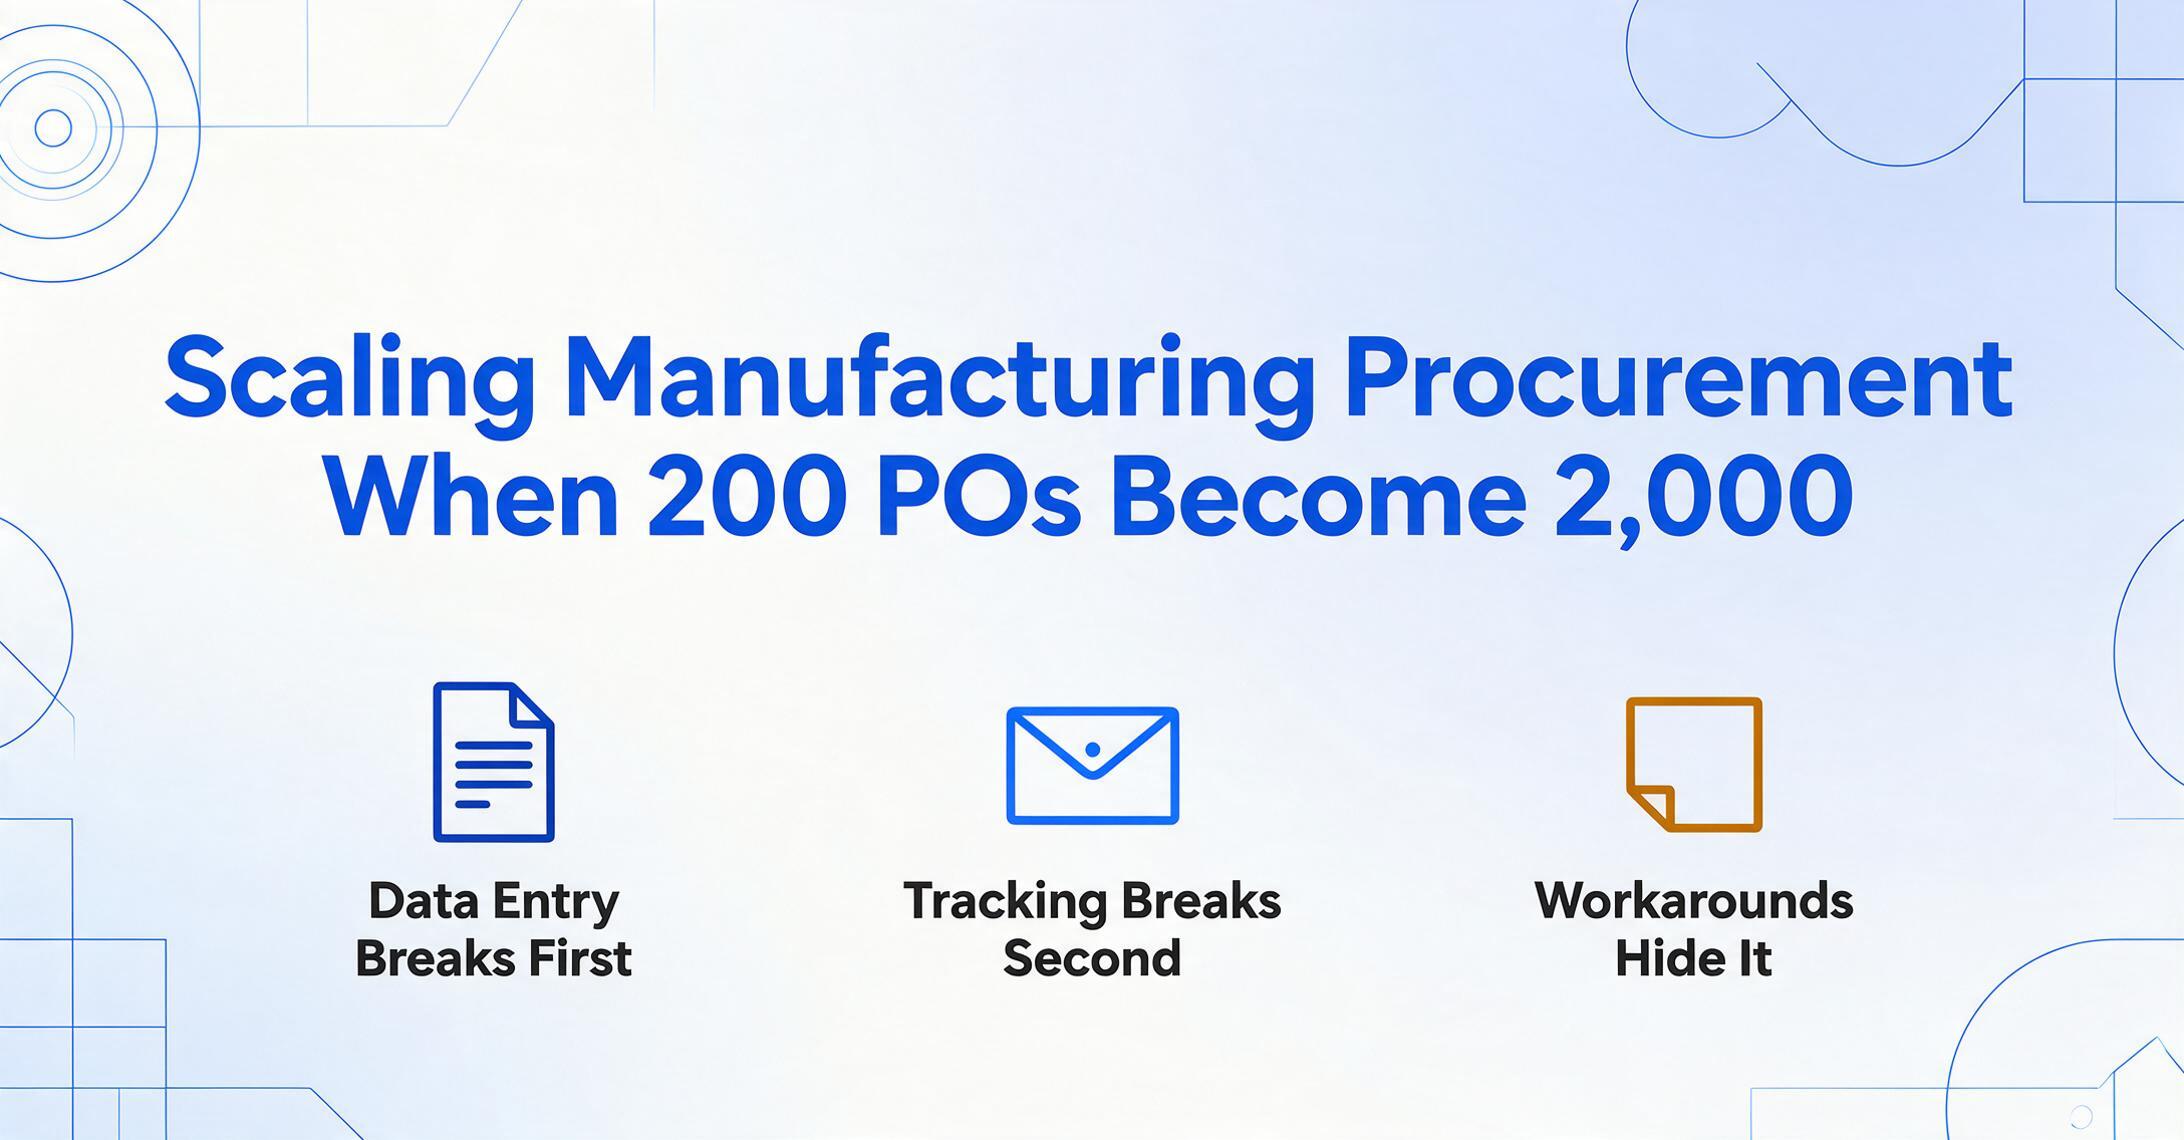
Die gefährlichste Kennzahl im Einkauf ist nicht das Bestellvolumen, das Ihr Team verarbeitet. Es ist die Lücke zwischen der Anzahl der Bestellungen, die Ihr Team bewältigt, und der Anzahl, die es glaubt bewältigen zu können – bevor etwas zusammenbricht. Diese Lücke ist für die meisten KPI-Dashboards unsichtbar. Sie taucht in Monatsberichten nicht auf. Und bis jemand sie bemerkt, haben bereits drei verschiedene Systeme in einer Abfolge zu versagen begonnen, die kein noch so großer Überstundeneinsatz rückgängig machen kann.
Die wichtigsten Erkenntnisse
- Das zuverlässigste Warnsignal für einen Zusammenbruch der Beschaffung – Bestellungen, die länger als 48 Stunden unbearbeitet bleiben – ist für Standard-KPI-Dashboards unsichtbar, weil fast keines das Alter des Rückstands statt des Volumens verfolgt.
- Top-Beschaffungsteams verarbeiten nicht 11-mal mehr Bestellungen pro Person, indem sie härter arbeiten – sie verarbeiten mehr, weil sie neu gestaltet haben, welche Teile der Arbeit durch eine Maschine laufen und welche Teile eine menschliche Entscheidung erfordern.
- Der Ausweg aus der Falle der manuellen Dateneingabe – in der 70 % der Hersteller noch stecken – erfordert keinen 18-monatigen ERP-Rollout; er erfordert, die automatisierte Extraktion an den Anfang des Workflows zu stellen, damit Einkäufer ihren Tag mit Ausnahmen verbringen, nicht mit Tippen.
Die drei Systeme, die versagen – und warum niemand es kommen sieht
Die Verarbeitung von Bestellungen ist keine einzelne Tätigkeit. Sie besteht aus drei voneinander abhängigen Systemen, die übereinander gestapelt sind und jeweils ihren eigenen Bruchpunkt haben. Wenn ein Team 100 bis 200 Bestellungen pro Monat bearbeitet, halten normalerweise alle drei Systeme. Informelle Workarounds – ein Haftnotizzettel am Monitor, eine mentale Notiz über einen säumigen Lieferanten, eine kurze Slack-Nachricht an die Buchhaltung – reichen aus, um die Lücken zu überbrücken. Doch jedes dieser Systeme hat eine Mengenschwelle, ab der die Workarounds nicht mehr funktionieren, und sie brechen nicht alle gleichzeitig.
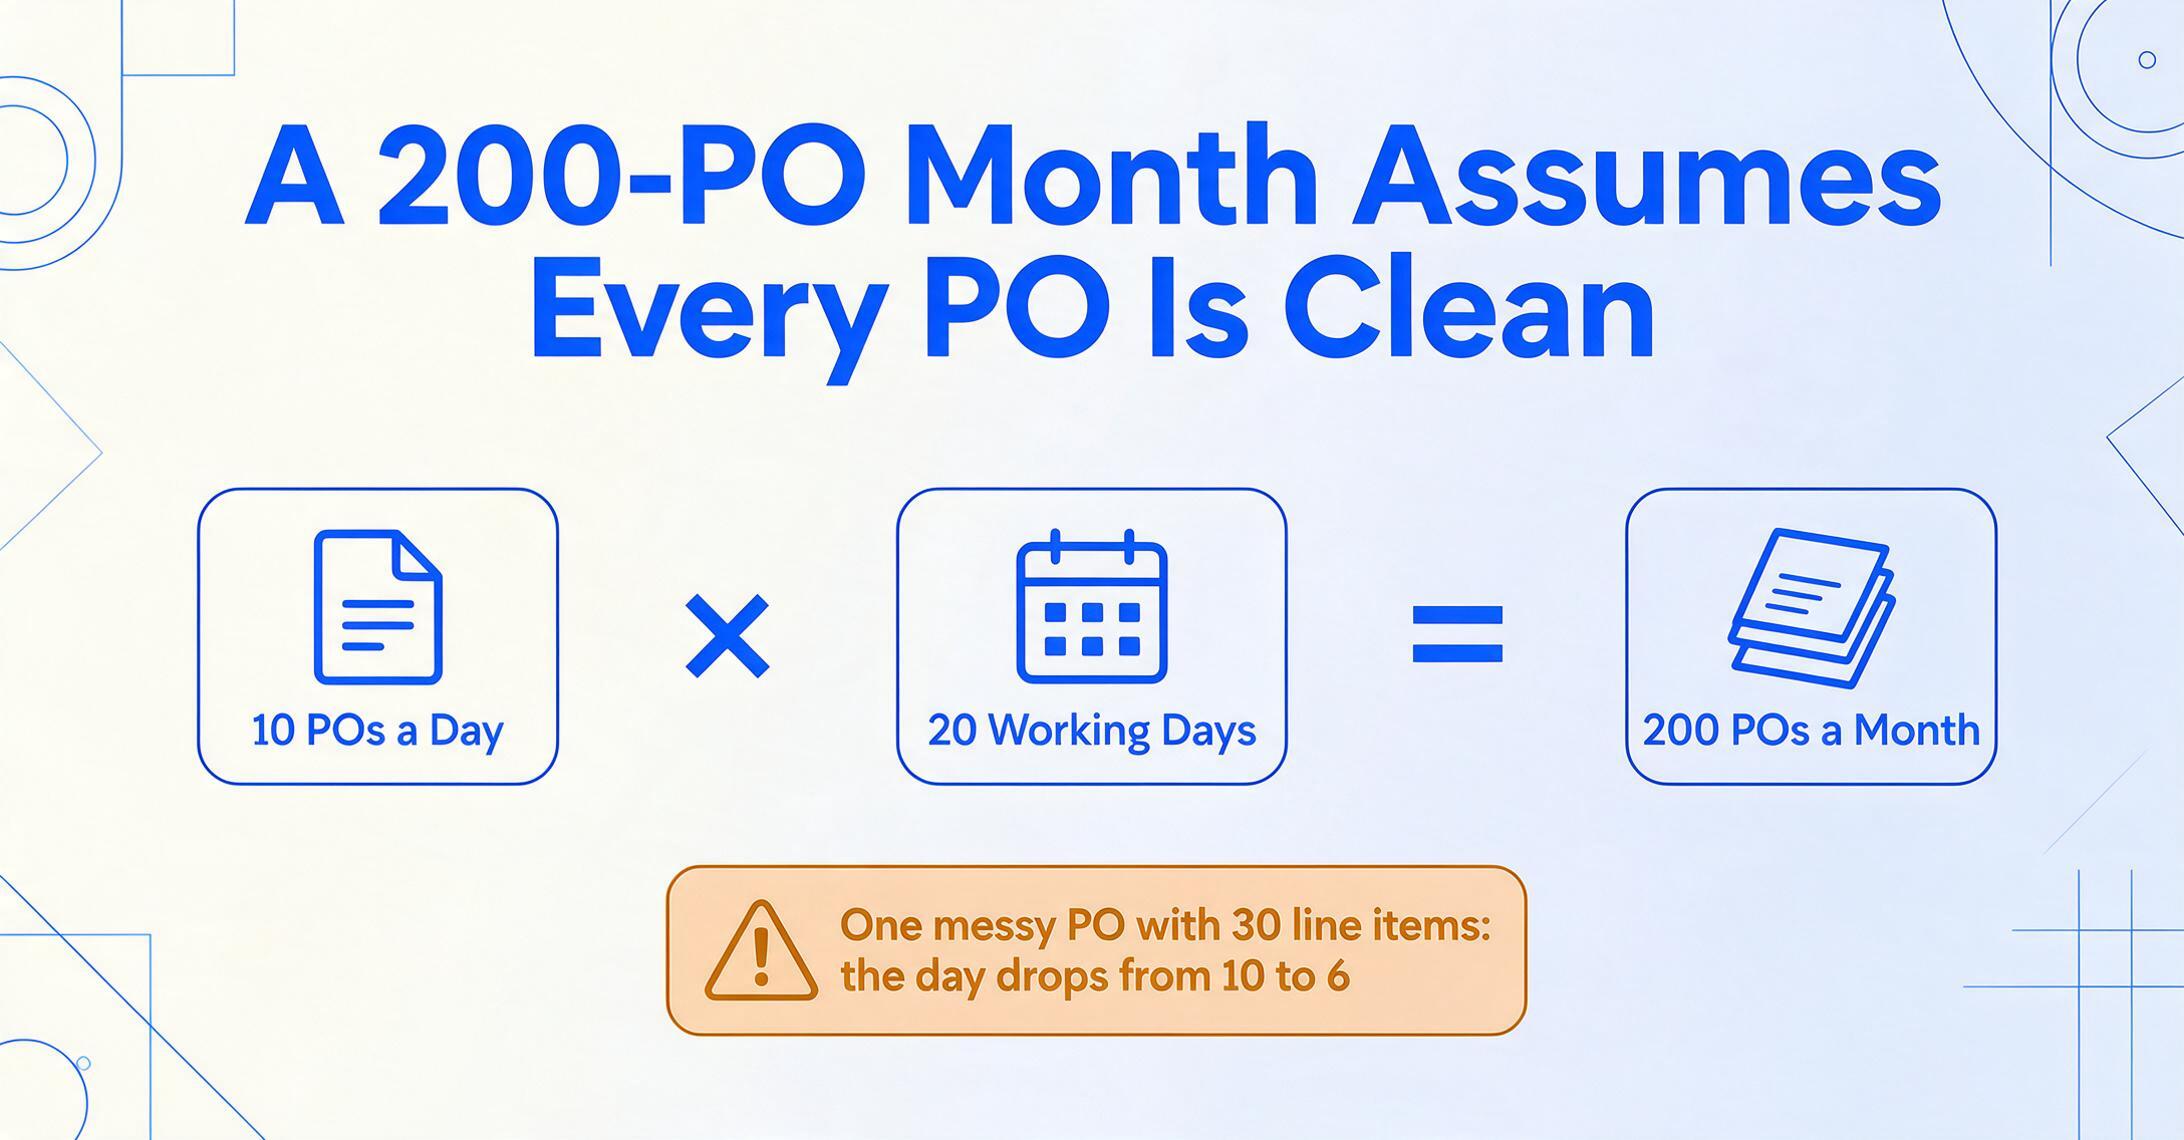
Das erste System, das versagt, ist der Datenerfassungsdurchsatz – die Pipeline, die das Bestellformat eines Lieferanten in etwas umwandelt, das Ihre internen Systeme nutzen können. Bei 200 Bestellungen pro Monat kann ein Vollzeitkäufer etwa 10 Bestellungen pro Tag verarbeiten, wenn jede etwa 30 Minuten für Datenerfassung, Nachverfolgung und Ablage benötigt. Die Rechnung ist knapp, aber machbar: 10 Bestellungen × 20 Arbeitstage = 200. Diese Rechnung setzt jedoch voraus, dass jede Bestellung sauber ist, jeder Lieferant noch am selben Tag auf E-Mails antwortet und keine Ausnahmen zusätzliche Zeit erfordern. In der Praxis kann eine einzige Bestellung mit 30 Positionen über zwei Seiten eines gescannten PDFs für sich genommen eine Stunde beanspruchen – und der Tagesdurchsatz dieses Käufers sinkt von 10 auf 6.
Das zweite System, das bricht, ist Nachverfolgung und Kommunikation. Wie ein Einkäufer auf r/procurement schrieb: „Hunderte von E-Mails können pro Tag anfallen, von den endlosen Gelesen/Nicht-gelesen-E-Mails über Bestellungen, an denen Sie gerade arbeiten, bis hin zu Bestellungen, auf deren Antwort vom Lieferanten Sie warten." Wenn das Volumen etwa 300 Bestellungen pro Monat überschreitet, bricht das informelle mentale Nachverfolgungssystem zusammen. Bestellungen, die „in Überarbeitung" oder „wartend auf Lieferantenbestätigung" waren, beginnen in der Schwebe zu verschwinden. Niemand bemerkt es, bis eine Produktionslinie auf Material wartet, das vor drei Tagen hätte versandt werden sollen.
Das dritte System – und das, mit dem die meisten Einkaufsleiter nicht rechnen – ist die Ausnahmebehandlung. Jede Bestellcharge enthält Ausreißer: Ein Lieferant hat sein Bestellformat geändert, ein neuer Anbieter hat eine handschriftliche Auftragsbestätigung gesendet, eine Positionsbeschreibung stimmt nicht mit dem Produktcode in Ihrem ERP überein. Bei 200 Bestellungen pro Monat machen diese Ausnahmen vielleicht 10–15 % der Gesamtmenge aus – 20 bis 30 Positionen, die ein erfahrener Käufer ad hoc lösen kann. Bei 500 Bestellungen pro Monat liegen die Ausnahmen immer noch bei 10–15 % – aber das sind jetzt 50 bis 75 Positionen. Jede erfordert eine menschliche Entscheidung, einen Anruf oder eine manuelle Recherche. Es gibt keine Automatisierungslösung für Ausnahmen – aber es gibt einen Punkt, an dem die kumulative Entscheidungslast das übersteigt, was ein Team ohne Fehler, Verzögerungen oder beides verarbeiten kann.
Die Kaskade funktioniert so: Datenerfassungsengpässe erzeugen einen Rückstand → der Rückstand überfordert das Nachverfolgungssystem → nicht nachverfolgte Bestellungen erzeugen mehr Ausnahmen → Ausnahmen verbrauchen die Zeit, die für die Datenerfassung vorgesehen war. Jeder Systemausfall speist den nächsten. Und die organisatorische Reaktion – „alle müssen einfach härter arbeiten" – beschleunigt den Kreislauf, indem sie die Menschen ausbrennt, die das Ganze zusammengehalten haben.
So berechnen Sie Ihren Kipppunkt, bevor Sie ihn erreichen
Der Unterschied zwischen einem Team, das reibungslos skaliert, und einem, das gegen eine Wand läuft, liegt nicht in den verwendeten Tools – sondern darin, ob es erkannt hat, dass die Wand kam, 18 Monate bevor es sie erreichte.
Die Open Standards Benchmarking-Daten von APQC liefern den Anker: Organisationen geben zwischen 14 und über 54 $ aus, um eine einzige Bestellung zu verarbeiten. Der Median liegt bei etwa 50 bis 100 $, wenn man vollständige Arbeitskosten, System-Overhead und Fehlerkorrektur berücksichtigt. Aber die aufschlussreichere Zahl ist die Leistungsspanne. Top-Performer verarbeiten mehr als 11-mal so viele Bestellungen pro Vollzeitäquivalent im Einkauf wie Organisationen im untersten Quartil. Diese 11-fache Lücke ist nicht durch klügere Mitarbeiter zu erklären – sondern durch Prozessdesign und Tooling.
Hier ist ein Diagnose-Framework, um Ihre Organisation auf der Skalierungskurve zu verorten. Verfolgen Sie diese vier Kennzahlen einen Monat lang:
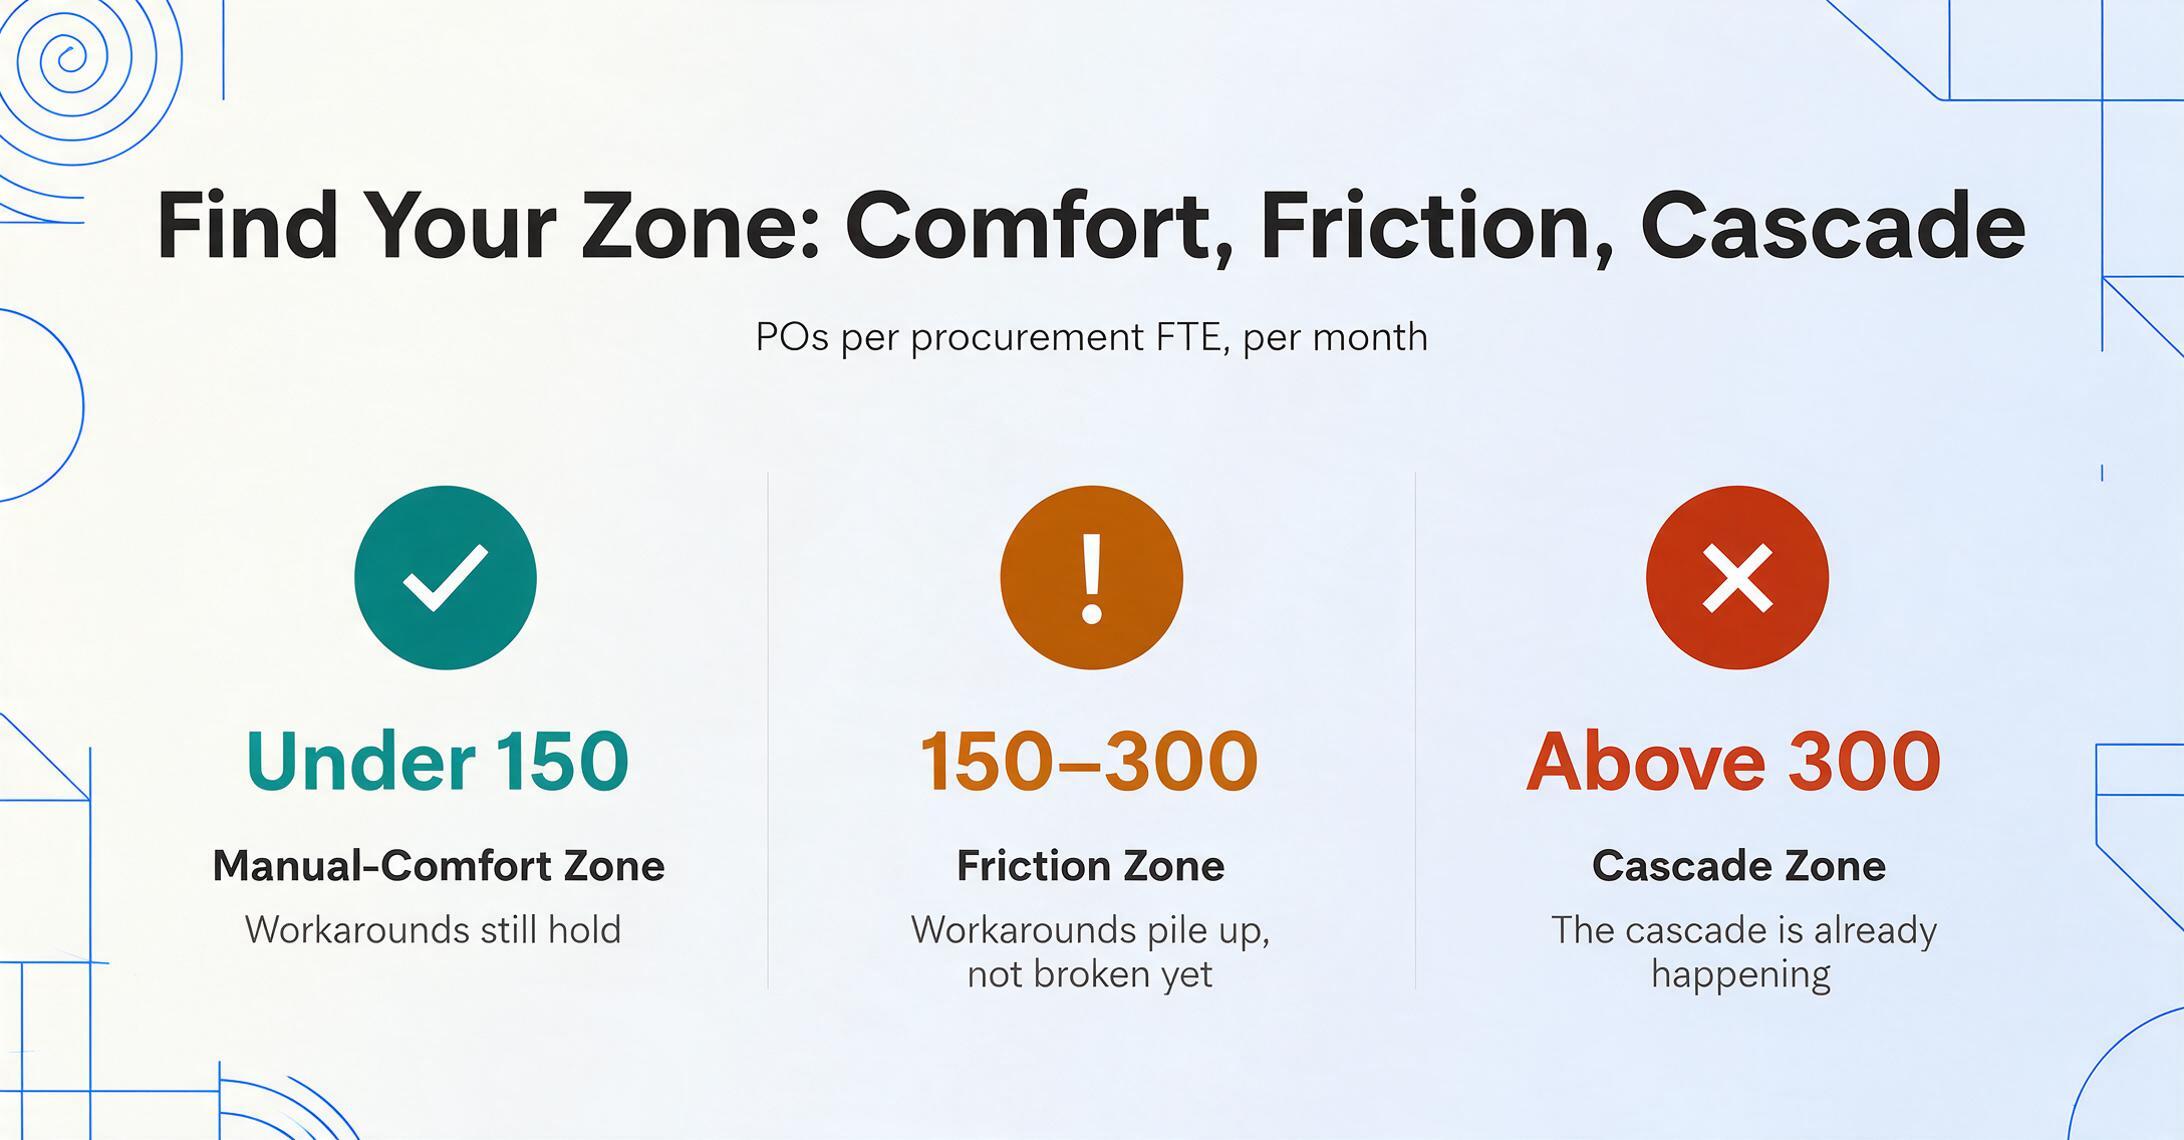
- Bestellungen pro Vollzeitäquivalent im Einkauf pro Monat. Teilen Sie die Gesamtzahl der Bestellungen durch die Anzahl der Vollzeitäquivalente, deren Hauptaufgabe die Bestellverarbeitung ist. Liegt die Zahl unter 150, befinden Sie sich in der manuellen Komfortzone. Zwischen 150 und 300 befinden Sie sich in der Reibungszone – Workarounds häufen sich, sind aber noch nicht zusammengebrochen. Über 300 ist die oben beschriebene Kaskade entweder bereits im Gange oder unmittelbar bevorstehend.
- Ausnahmerate. Zählen Sie Bestellungen, die einen manuellen Eingriff über den Standard-Dateneingabeablauf hinaus erfordern – Formatprobleme, fehlende Felder, Lieferantenklärung, Genehmigungsumleitung. Überschreitet dies 20 %, ist Ihre Dateneingabepipeline nicht durch das Volumen, sondern durch Formatinkonsistenz zum Engpass geworden. Mehr Personal wird das nicht beheben; die Standardisierung der Erfassung schon.
- Durchlaufzeit vom Eingang bis zur Erfassung. Messen Sie die Stunden zwischen dem Eintreffen einer Bestellung (E-Mail-Zeitstempel, Upload-Zeit) und der vollständigen Erfassung ihrer Daten in Ihrem System. Wenn das 75. Perzentil 8 Stunden überschreitet – die mediane Durchlaufzeit der Top-Performer von APQC – haben Sie ein Durchsatzproblem, das sich mit jedem Volumenanstieg verstärkt.
- Unsichtbarer Rückstau. Zählen Sie Bestellungen, die älter als 48 Stunden sind und weder erfasst, bestätigt noch eskaliert wurden. Dies ist die Kennzahl, die die meisten Teams nicht verfolgen und die am zuverlässigsten einen bevorstehenden Zusammenbruch vorhersagt.
Das Ergebnis dieser Diagnose ist keine Zahl, die Sie mit einem Branchen-Benchmark vergleichen sollten. Es ist eine Karte, die zeigt, wo Ihr Kipppunkt erscheinen wird und wie viel Zeit Sie haben, bevor er eintritt. Ein Team mit 180 Bestellungen pro Vollzeitäquivalent pro Monat und einer Ausnahmerate von 12 % hat Spielraum für die Planung. Ein Team mit 260 und einer Ausnahmerate von 25 % befindet sich bereits in der Kaskade – es hat nur noch nicht erkannt, dass sie systematisch ist.
Die branchenübergreifenden Daten von CAPS Research zeigen, dass Einkaufspersonal durchschnittlich 1,90 % der gesamten Unternehmensbelegschaft ausmacht, wobei die Einkaufsausgaben durchschnittlich 55,64 % des Umsatzes betragen. Diese Verhältnisse sind strukturell – sie dehnen sich nicht nach oben aus, wenn das Volumen steigt. Das bedeutet, dass ein Wachstum des Bestellvolumens fast nie mit einem proportionalen Wachstum der Einkaufsbelegschaft einhergeht.
Warum mehr Personal auch nicht skaliert
Die intuitive Reaktion auf ein ausgelastetes Beschaffungsteam ist, einen weiteren Einkäufer einzustellen. Das ist auch die falsche – und die APQC-Daten zeigen, warum.
Wenn Einstellungen das Problem lösen würden, wäre die Lücke zwischen Top-Performern und Organisationen im untersten Quartil bei Bestellungen pro Vollzeitäquivalent gering – vielleicht 2x oder 3x, was individuelle Produktivitätsunterschiede widerspiegelt. Die tatsächliche Lücke beträgt 11x. Was die Spitze vom Boden trennt, ist nicht die Personalstärke. Es ist die Tatsache, dass Top-Performer die Teile der Beschaffung systematisiert haben, die kein menschliches Urteilsvermögen erfordern, sodass ihre Mitarbeiter ihre Zeit mit den Teilen verbringen, die es erfordern.
Das Hinzufügen eines zweiten Einkäufers zu einem Team, das 300 Bestellungen pro Monat verarbeitet, verdoppelt nicht den Durchsatz. Es entsteht ein Koordinationsaufwand, der mit jeder weiteren Person wächst: Wer betreut welche Lieferanten, wessen Rückstand gehört wem, welche Ausnahmen werden an wen eskaliert. Bei drei Einkäufern benötigen Sie einen Beschaffungsleiter. Bei fünf benötigen Sie dokumentierte Prozesse. Bei acht haben Sie eine Abteilung aufgebaut, deren Hauptaktivität darin besteht, sich selbst zu verwalten – und das ursprüngliche Problem (Bestelldaten bewegen sich nicht schnell genug) ist schlimmer als bei drei Personen.
Hier wirkt eine organisatorische Physik. Eine bekannte Beobachtung des Manufacturing Leadership Council – der Digitalisierungsabteilung der NAM – ist, dass 70 % der Hersteller Daten immer noch manuell erfassen. Diese Zahl hat sich trotz der Verfügbarkeit von Automatisierungswerkzeugen seit Jahren nicht wesentlich verändert, weil die Standardreaktion von Organisationen auf Volumendruck „mehr Personal und mehr Prozesse" lautet, nicht „das System neu gestalten". Die 70-%-Zahl ist keine Technologieeinführungsstatistik – sie ist eine Statistik über organisatorische Trägheit.
Für einen tieferen Einblick, warum die manuelle Bestelldatenerfassung trotz jahrzehntelang verfügbarer Technologie ein strukturelles Problem bleibt, lesen Sie unsere Analyse zu dem Problem der Bestelldatenerfassung – und was es aufrechterhält.
Das Vorbereitungs-Framework vor dem Bruchpunkt
Wenn Sie Ihr Team anhand der vier Diagnosekennzahlen bewerten und feststellen, dass Sie sich in der Reibungszone befinden – oder sich dorthin bewegen –, verschafft Ihnen die folgende vierteilige Vorbereitungssequenz Zeit und Kapazität, ohne eine ERP-Implementierung oder eine Erhöhung der Personalstärke zu erfordern. Die Reihenfolge ist wichtig: Jede Stufe baut Fähigkeiten auf, von denen die nächste Stufe abhängt.
Stufe 1: Erfassung standardisieren. Bevor ein Tool helfen kann, müssen Sie das Format-Chaos am Eingangspunkt beseitigen. Das bedeutet nicht, jeden Lieferanten zu bitten, sich Ihrem Format anzupassen – das werden sie nicht tun. Es bedeutet, einen einzigen Erfassungskanal zu implementieren, der jedes Format akzeptiert (PDF, gescanntes Bild, E-Mail-Anhang, Excel-Export aus dem ERP des Lieferanten) und ihn konsistent in dieselbe Verarbeitungspipeline einspeist. Ein Sammellink – eine teilbare Upload-URL, die Dateien direkt in eine Verarbeitungswarteschlange leitet – löst das Erfassungsproblem, ohne die Zusammenarbeit der Lieferanten zu erfordern. Lieferanten senden, was sie haben, so wie sie es immer getan haben; der Unterschied besteht darin, dass alles an einem Ort landet, statt über Posteingänge verstreut zu sein.
Stufe 2: Extraktion automatisieren, nicht den gesamten Prozess. Hier scheitern die meisten Digitalisierungsprojekte im Beschaffungswesen. Sie versuchen, den gesamten Source-to-Pay-Zyklus – Anforderung, Genehmigung, Bestellungserstellung, Wareneingang, Rechnungsabgleich, Zahlung – in einer einzigen Initiative zu automatisieren. Das Ergebnis ist eine 18-monatige Implementierung, die mehr kostet als das Problem, das sie löst. Enterprise-Beschaffungssuiten wie SAP Ariba, Coupa und Jaggaer sind leistungsstark, bringen aber Implementierungszeitpläne und Preisschilder mit sich, die für Organisationen mit Beschaffungsteams von 20 oder mehr Personen konzipiert sind. Mittelständische Hersteller – Unternehmen mit einem Umsatz von 10 bis 100 Millionen US-Dollar – fallen in eine Lücke: Enterprise-Tools sind zu teuer und zu komplex, während Einstiegssoftware für den Einkauf zwar Genehmigungen, aber keine Extraktion abdeckt.
Der Schritt mit der höchsten Hebelwirkung ist die Automatisierung der Datenextraktion aus eingehenden Bestellungen – die Umwandlung der Felder auf einem PDF in strukturierte Zeilen in einer Tabelle. Dieser eine Schritt eliminiert die größte variable Kostenkomponente der Bestellungsverarbeitung: die Zeit, die mit dem Abtippen verbracht wird. Die Extraktion per Spaltenname – bei der Sie die gewünschten Felder angeben (Bestellnummer, Lieferantenname, Positionsbeschreibung, Menge, Einzelpreis) und die KI sie anhand ihrer Bedeutung lokalisiert, nicht anhand ihrer Position auf der Seite – funktioniert mit jedem Bestellungsformat ohne lieferantenspezifische Vorlagen. Eine Schritt-für-Schritt-Anleitung zu diesem Ansatz finden Sie in unserem Artikel über das Extrahieren bestimmter Bestellfelder nach Excel mithilfe der KI-Spaltennamenextraktion.
Stufe 3: Von der Einzelbestellung zur Stapelverarbeitung übergehen. Sobald die Extraktion pro Dokument automatisiert ist, ist der nächste Skalierungshebel die gleichzeitige Verarbeitung mehrerer Bestellungen. Anstatt eine Bestellung hochzuladen, auf die Extraktion zu warten, zu prüfen und zu wiederholen, ermöglicht die Stapelverarbeitung das Hochladen eines Ordners mit Bestellungen von mehreren Lieferanten und die Rückgabe einer einzigen konsolidierten Tabelle. Die Extraktionspipeline wendet dieselben Spaltendefinitionen auf jedes Dokument an. Das Ergebnis sind nicht 50 separate Extraktionen, die zu prüfen sind – es ist eine Tabelle mit 50 Zeilen, eine pro Bestellung. Dies ändert den Prüfschritt von „50 Dateien einzeln prüfen“ zu „eine Tabelle auf Anomalien scannen“. Die operativen Details finden Sie in unserem Leitfaden zum Stapelverarbeiten von Bestellungen verschiedener Lieferanten in einer konsolidierten Tabelle.
Stufe 4: Ausgabe an nachgelagerte Systeme anbinden. Erst nachdem die Extraktion automatisiert und in Stapeln verarbeitet wird, ist es sinnvoll, über die Integration nachzudenken. Das Extraktionsergebnis – eine strukturierte Excel- oder CSV-Datei – kann unverändert in Ihr ERP, Buchhaltungssystem oder Ihre Auftragsverwaltungsplattform importiert werden. Die entscheidende Erkenntnis ist, dass diese Stufe keine Änderung der Funktionsweise Ihres ERP erfordert. Die Extraktionsebene erzeugt Daten in dem Format, das Ihr nachgelagertes System erwartet; die Integration ist ein Dateiimport, kein Systemumbau. Für den vollständigen Workflow – vom Upload über die Extraktion bis zur ERP-fähigen Ausgabe – lesen Sie unseren Artikel zum Thema Automatisierung der Bestelldatenerfassung ohne ERP.
Ein mittelständischer Hersteller, der die Stufen 1 und 2 abschließt – Standardisierung des Eingangs über einen Sammellink, Automatisierung der Extraktion – kann in der Regel eine 3–4-fache Steigerung des Bestellvolumens bewältigen, ohne zusätzliches Personal im Einkauf einzustellen. Die Stufen 3 und 4 erweitern dies auf das 8–10-fache. Die 11-fache Lücke zwischen den besten und schlechtesten Performern von APQC wirkt dann weniger wie Magie und mehr wie Arithmetik.
Wo KI-Dokumentenextraktion passt – und wo nicht
Jedes Skalierungsframework braucht eine ehrliche Einschätzung seiner Grenzen. Die KI-Dokumentenextraktion – die Art, die eine Bestell-PDF liest und strukturierte Daten in eine Tabelle ausgibt – adressiert den Engpass der Dateneingabe und indirekt den Engpass der Ausnahmebehandlung, indem sie die kognitive Belastung pro Dokument reduziert. Sie adressiert nicht das Lieferantenbeziehungsmanagement, die strategische Beschaffung, die Vertragsverhandlung oder die Compliance-Prüfung.
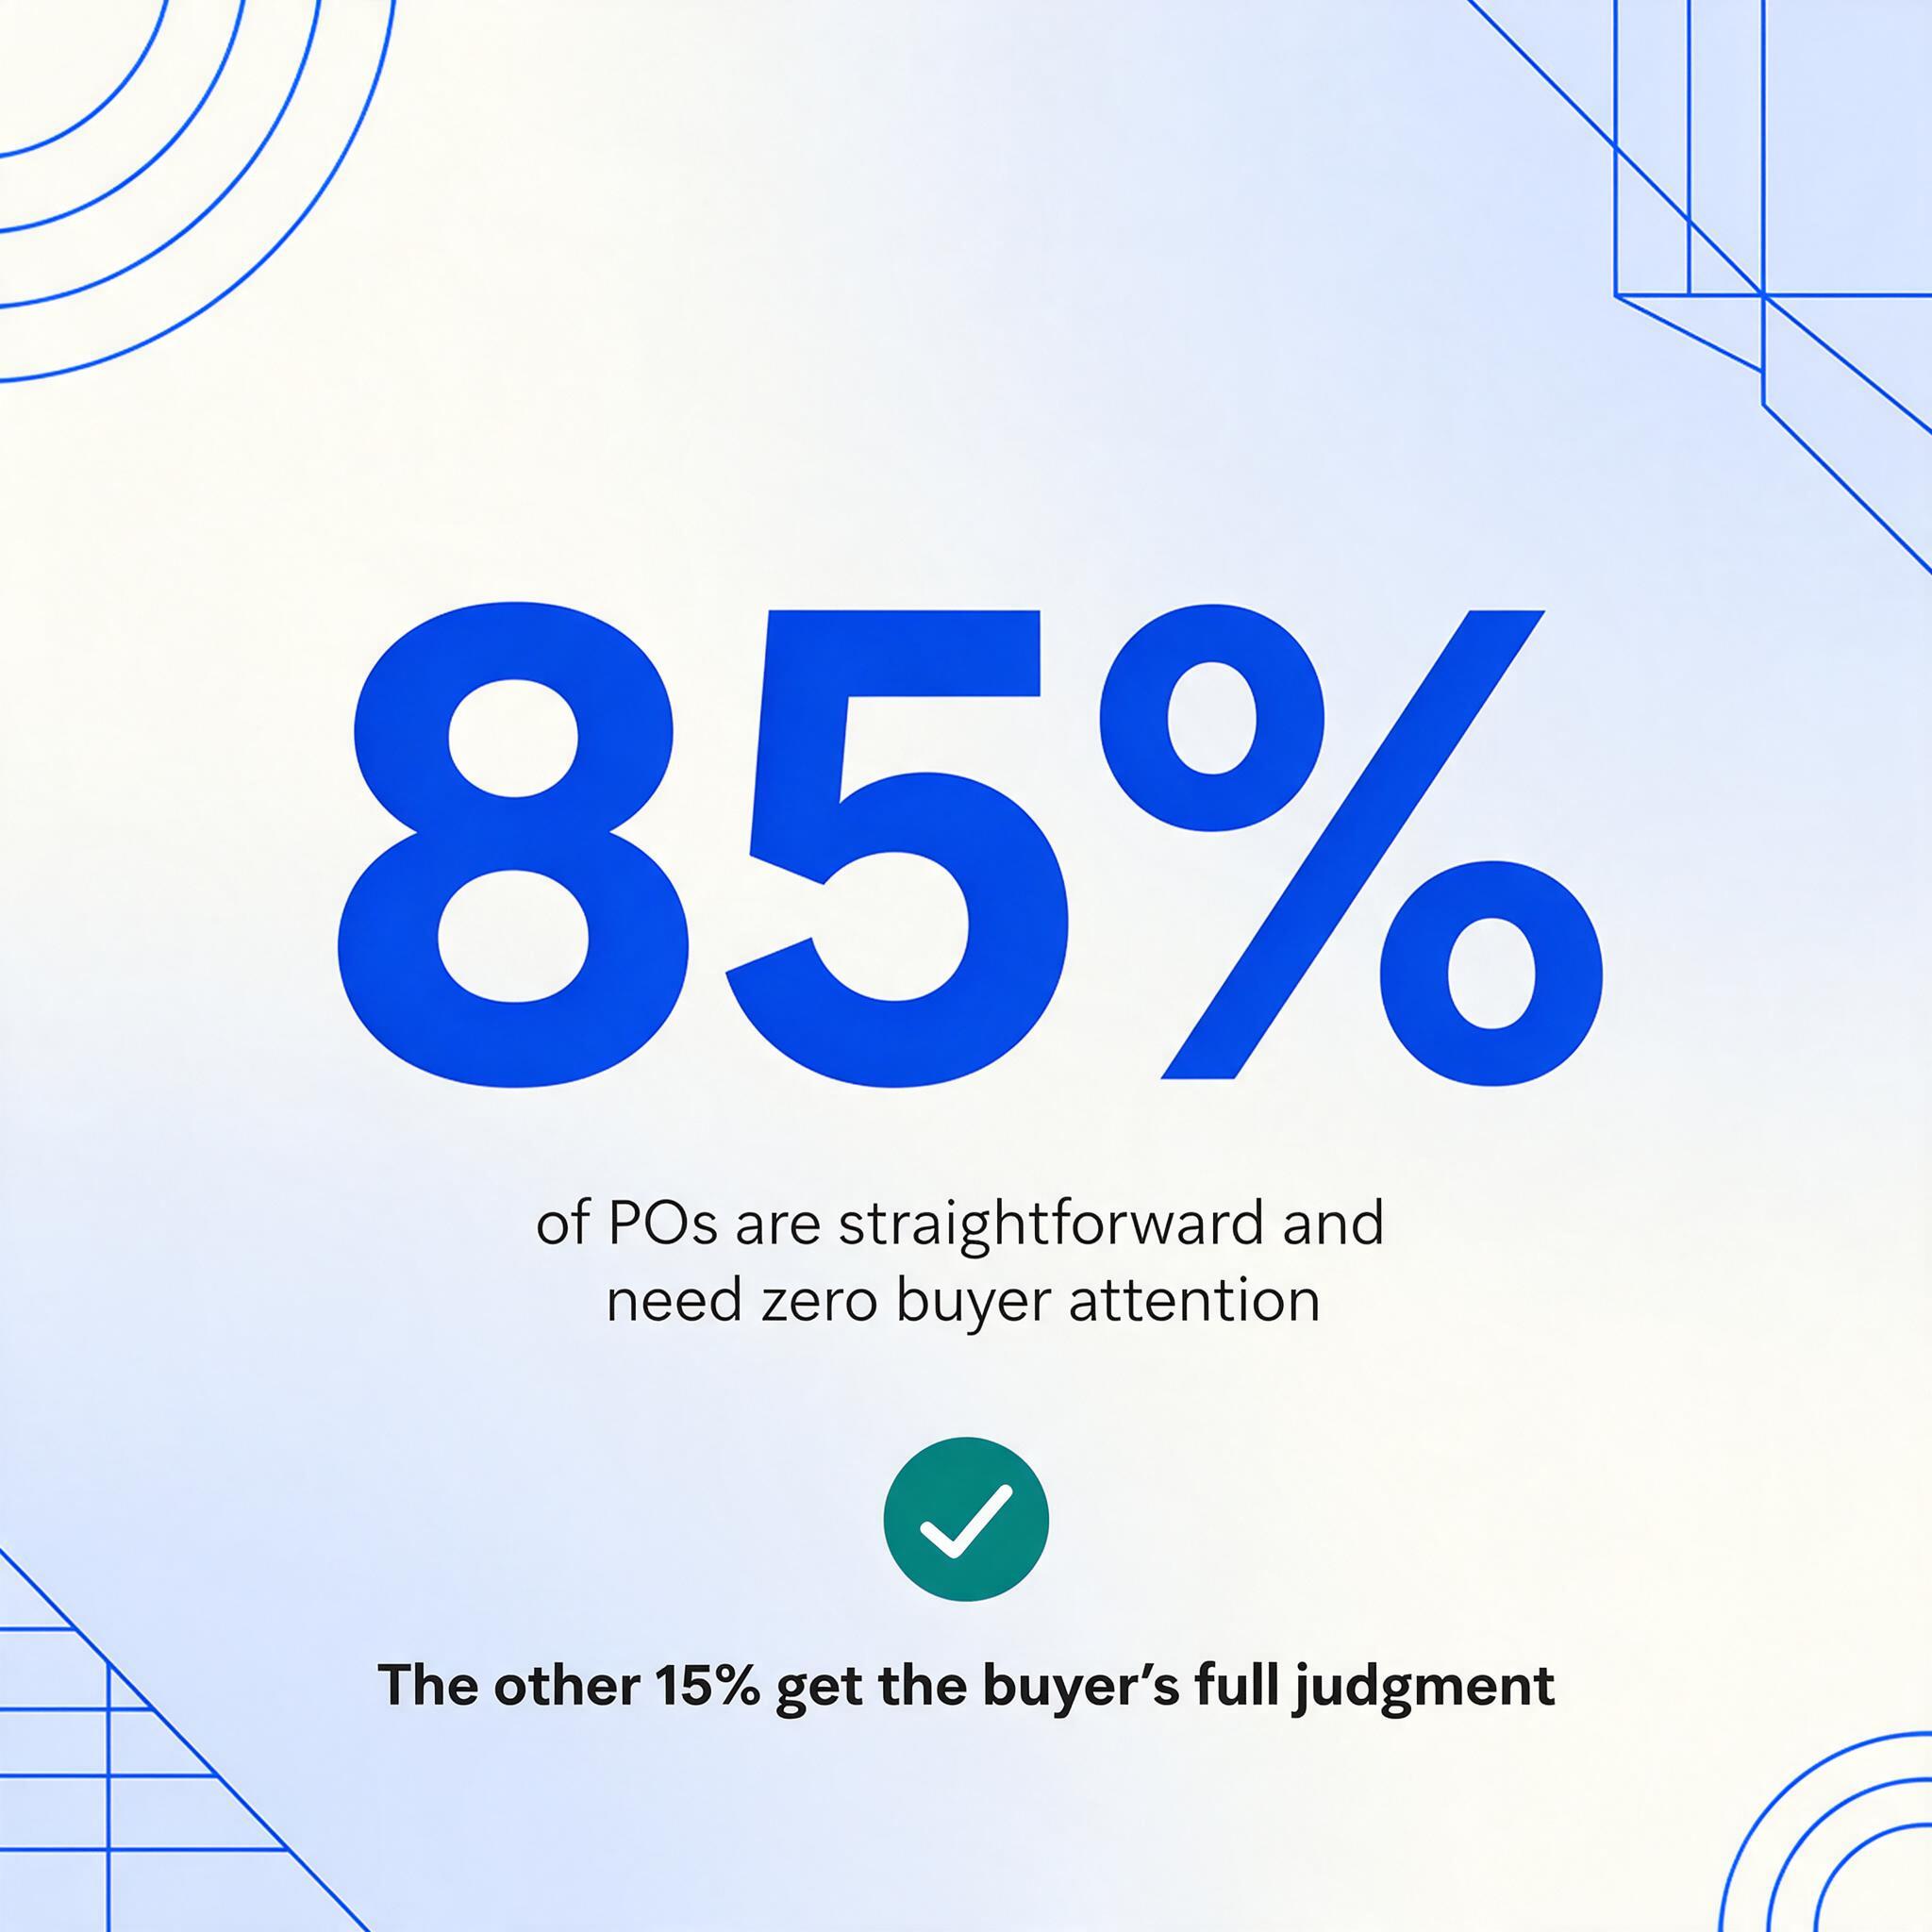
Was sie tut, ist, die teuerste Minute im Beschaffungsworkflow zu ersetzen: die Minute, die jemand damit verbringt, ein Feld von einer PDF abzulesen und in eine Zelle zu tippen. Die toolbasierte Extraktion verarbeitet eine Seite in 5 bis 10 Sekunden mit bis zu 99% Genauigkeit bei gedrucktem Text – etwa 18-mal schneller als die manuelle Eingabe derselben Daten. Aber die Zahl, die für die Skalierung zählt, ist nicht die Geschwindigkeit pro Seite. Es ist das, was mit der kognitiven Bandbreite des Käufers passiert, wenn er keine Dateneingabe mehr durchführt. Ein Käufer, der vom Tippen befreit ist, kann die Ausnahmeprüfung für ein viel höheres Bestellvolumen übernehmen – weil die 85% der Bestellungen, die unkompliziert sind, seine Aufmerksamkeit gar nicht erst beanspruchen. Er muss sich nur auf die 15% konzentrieren, die eine menschliche Entscheidung erfordern.
Dies ist das Skalierungsprinzip, auf dem das Framework basiert: Automatisierung eliminiert nicht die Notwendigkeit menschlichen Urteilsvermögens. Sie konzentriert es dort, wo es einen Mehrwert schafft.
ISO-Normen unterstreichen dieses Gleichgewicht. ISO 9001 Abschnitt 8.4 verlangt, dass Organisationen verifizieren, dass gekaufte Produkte den festgelegten Anforderungen entsprechen – eine Compliance-Verpflichtung, die linear mit dem Bestellvolumen skaliert. ISO 20400 fügt die Dimension der nachhaltigen Beschaffung hinzu und verlangt Lieferantenbewertungen, die ökologische und soziale Kriterien berücksichtigen. Keine der Normen verlangt, dass jede Bestellung manuell in ein System eingegeben wird – aber beide verlangen, dass jemand, irgendwo, verifiziert hat, dass die Daten korrekt und der Lieferant qualifiziert ist. Die KI-Extraktion übernimmt den Datentransfer; der Käufer übernimmt die Verifizierung. Die Norm wird ohne den Arbeitsaufwand erfüllt.
Für einen direkten Weg vom Bestell-Upload zu strukturierten Daten in Ihrem bevorzugten Format, probieren Sie unseren Bestellung-zu-Excel-Konverter – er verarbeitet sowohl Kopffelder als auch mehrzeilige Positionsartikel aus jedem Bestelllayout, ohne dass Sie Vorlagen pro Lieferant konfigurieren müssen.
FAQ
Wie viele Bestellungen pro Monat sind für eine Person zu viele?
Es gibt keine universelle Zahl, aber Benchmarking-Daten von APQC bieten eine nützliche Referenz. Im Median verarbeiten Beschaffungsorganisationen je nach Branche und Komplexität zwischen 100 und 300 Bestellungen pro Vollzeitäquivalent und Monat. Bestellungen aus der Fertigung – die tendenziell mehrzeilige Positionen, Teilenummern und Lieferpläne umfassen – liegen am unteren Ende des Spektrums. Die relevantere Frage ist nicht „wie viele“, sondern „wie hoch ist die Ausnahmerate und die Durchlaufzeit“. Ein Einkäufer, der 150 fehlerfreie Bestellungen pro Monat verarbeitet, ist weniger belastet als einer, der 100 Bestellungen verarbeitet, bei denen 30 % manuelle Eingriffe erfordern.
Benötige ich eine vollständige Beschaffungssuite wie SAP Ariba oder Coupa?
Nicht, wenn Ihr Hauptengpass die Dateneingabe ist. Unternehmensweite Beschaffungssuiten lösen eine andere Reihe von Problemen – Ausgabentransparenz, Genehmigungsworkflows, Lieferantenlebenszyklusmanagement, Vertragskonformität. Sie kosten sechs- bis siebenstellige Beträge und benötigen 12 bis 18 Monate für die Implementierung. Wenn der Schmerzpunkt Ihres Teams darin besteht, dass Sie Bestelldaten nicht schnell genug in Ihr System bekommen, beginnen Sie mit der Automatisierung der Extraktion. Sie ist in Stunden einsatzbereit, nicht in Monaten, und kostet einen Bruchteil einer Unternehmenssuite. Die Unternehmenssuite kann später kommen – oder auch gar nicht, je nach Ihrer Wachstumsentwicklung.
Funktioniert die KI-Extraktion mit handschriftlichen Bestellungen?
Ja, mit Einschränkungen. Das Vision-Modell von ImageToTable.ai kann Handschrift lesen – einschließlich Schreibschrift –, aber die Genauigkeit ist geringer als bei gedrucktem Text, insbesondere bei dichten Formularen mit kleiner Handschrift. Bei Bestellungen, bei denen Handschrift die Ausnahme und nicht die Regel ist (ein Lieferant notiert etwas auf einem gedruckten Formular), funktioniert das Tool gut. Bei vollständig handschriftlichen Bestellungen sollten Sie die extrahierten Daten sorgfältiger prüfen. Die in unseren Spezifikationen angegebene Genauigkeit von 99 % bezieht sich auf gedruckte Tabellendaten; die Genauigkeit bei Handschrift hängt von Lesbarkeit und Dichte ab.
Ab welchem Mindestvolumen an Bestellungen ist die Automatisierung wirtschaftlich sinnvoll?
Bei etwa 100 Bestellungen pro Monat – etwa 5 pro Arbeitstag – übersteigt der Zeitgewinn durch automatisierte Extraktion die Kosten des Tools. Unterhalb dieser Schwelle überwiegt möglicherweise der Zeitaufwand für die Einrichtung von Extraktionsspalten und die Prüfung der Ergebnisse nicht den Zeitaufwand für die manuelle Eingabe der Daten. Aber der Rahmen dieses Artikels dreht sich um Skalierung: Wenn Sie heute bei 100 Bestellungen pro Monat liegen und Ihr Unternehmen wächst, lautet die Frage nicht „Brauche ich jetzt Automatisierung“, sondern „Ab welchem Volumen werde ich sie benötigen und wie viel Vorlaufzeit brauche ich für die Bereitstellung“. Die diagnostischen Kennzahlen in diesem Artikel sollen Ihnen helfen, diese Frage Monate zu beantworten, bevor das Volumen selbst die Antwort erzwingt.
Können Lieferanten Bestellungen direkt in meine Verarbeitungswarteschlange hochladen?
Ja. Ein Sammellink – eine freigebbare URL, die Sie generieren und an Lieferanten senden – ermöglicht es ihnen, Bestellungen direkt in Ihre Verarbeitungspipeline hochzuladen, ohne dass ein Konto oder eine Anmeldung erforderlich ist. Sie öffnen den Link, verifizieren sich mit einem kurzen Code und laden die Datei hoch. Sie landet in Ihrer Warteschlange zur Extraktion. Das eliminiert das Hin und Her mit E-Mail-Anhängen und stellt sicher, dass jede Bestellung über denselben standardisierten Kanal eingeht, was direkt die im Diagnose-Framework beschriebenen Durchsatzmetriken verbessert.
Die Investition in die Beschaffungsautomatisierung zahlt sich nicht aus, wenn Sie sie implementieren. Sie zahlt sich aus, wenn Ihr Volumen den Punkt erreicht, an dem Sie ohne sie zusammengebrochen wären. Das Framework in diesem Artikel soll Ihnen helfen, vor diesem Moment zu deployen – denn ein Deployment danach bedeutet, ein Team wieder aufzubauen, während es noch den Rückstand verarbeitet.