注文書データ入力の問題
— そして、それを根付かせているもの
APQCのオープンスタンダードベンチマークデータによると、組織は注文書1件の処理に14ドルから54ドル以上を費やしています。年間5,000件のPOを発行する中規模メーカーの場合、上位と下位のパフォーマーの差は、年間処理コストで70,000ドルと270,000ドルの違いになります。CAPS Researchは、最新の調査で業界平均をさらに高い527ドル/POとしています。このデータは何年も前から存在しています。EDI 850 — 電子注文書のANSI X12標準 — は何十年も前から存在しています。それでもなお、AutoQuotesの業界調査によると、注文書の75%は今もメールやFAXで送信され、受信トレイに届いた添付ファイルを誰かが開いて入力を始めています。これはテクノロジーのギャップではありません。ほとんどの自動化ツールが対応するように設計されたことのない構造的な問題なのです。
重要なポイント
- 月200件の注文書を1件120ドルで処理すると、手動データ入力に年間288,000ドルを費やすことになります — このコストは購買担当者の給与に完全に吸収されているため、「手動PO処理」という項目を承認したCFOはこれまで一人もいません。
- テンプレートベースの抽出ツールは手動のPO作業をなくしませんでした — 数字を入力する作業が、40個の個別テンプレートを構築・維持する作業に移っただけで、そこで発生する失敗は静かに進行し、注文が誤って出荷された後に初めて発覚します。
- POのフィールドを「どこにあるか」ではなく「何を意味するか」で読み取る抽出は、すべての顧客の注文書フォーマットで同じように機能します — 1つの列定義で全てをカバーでき、構築も破損もするテンプレートはゼロです。
誰も語らない217ドルの問題
購買マネージャーに注文書の処理コストを尋ねると、たいてい曖昧な返答が返ってきます。コストに関心がないからではありません——関心はあります。しかし、手作業によるPOデータ入力のコストは日常業務に均等に分散しているため、背景に溶け込んで見えなくなっているのです。誰の予算にも項目として載っていません。ただ「私たちの仕事」なのです。
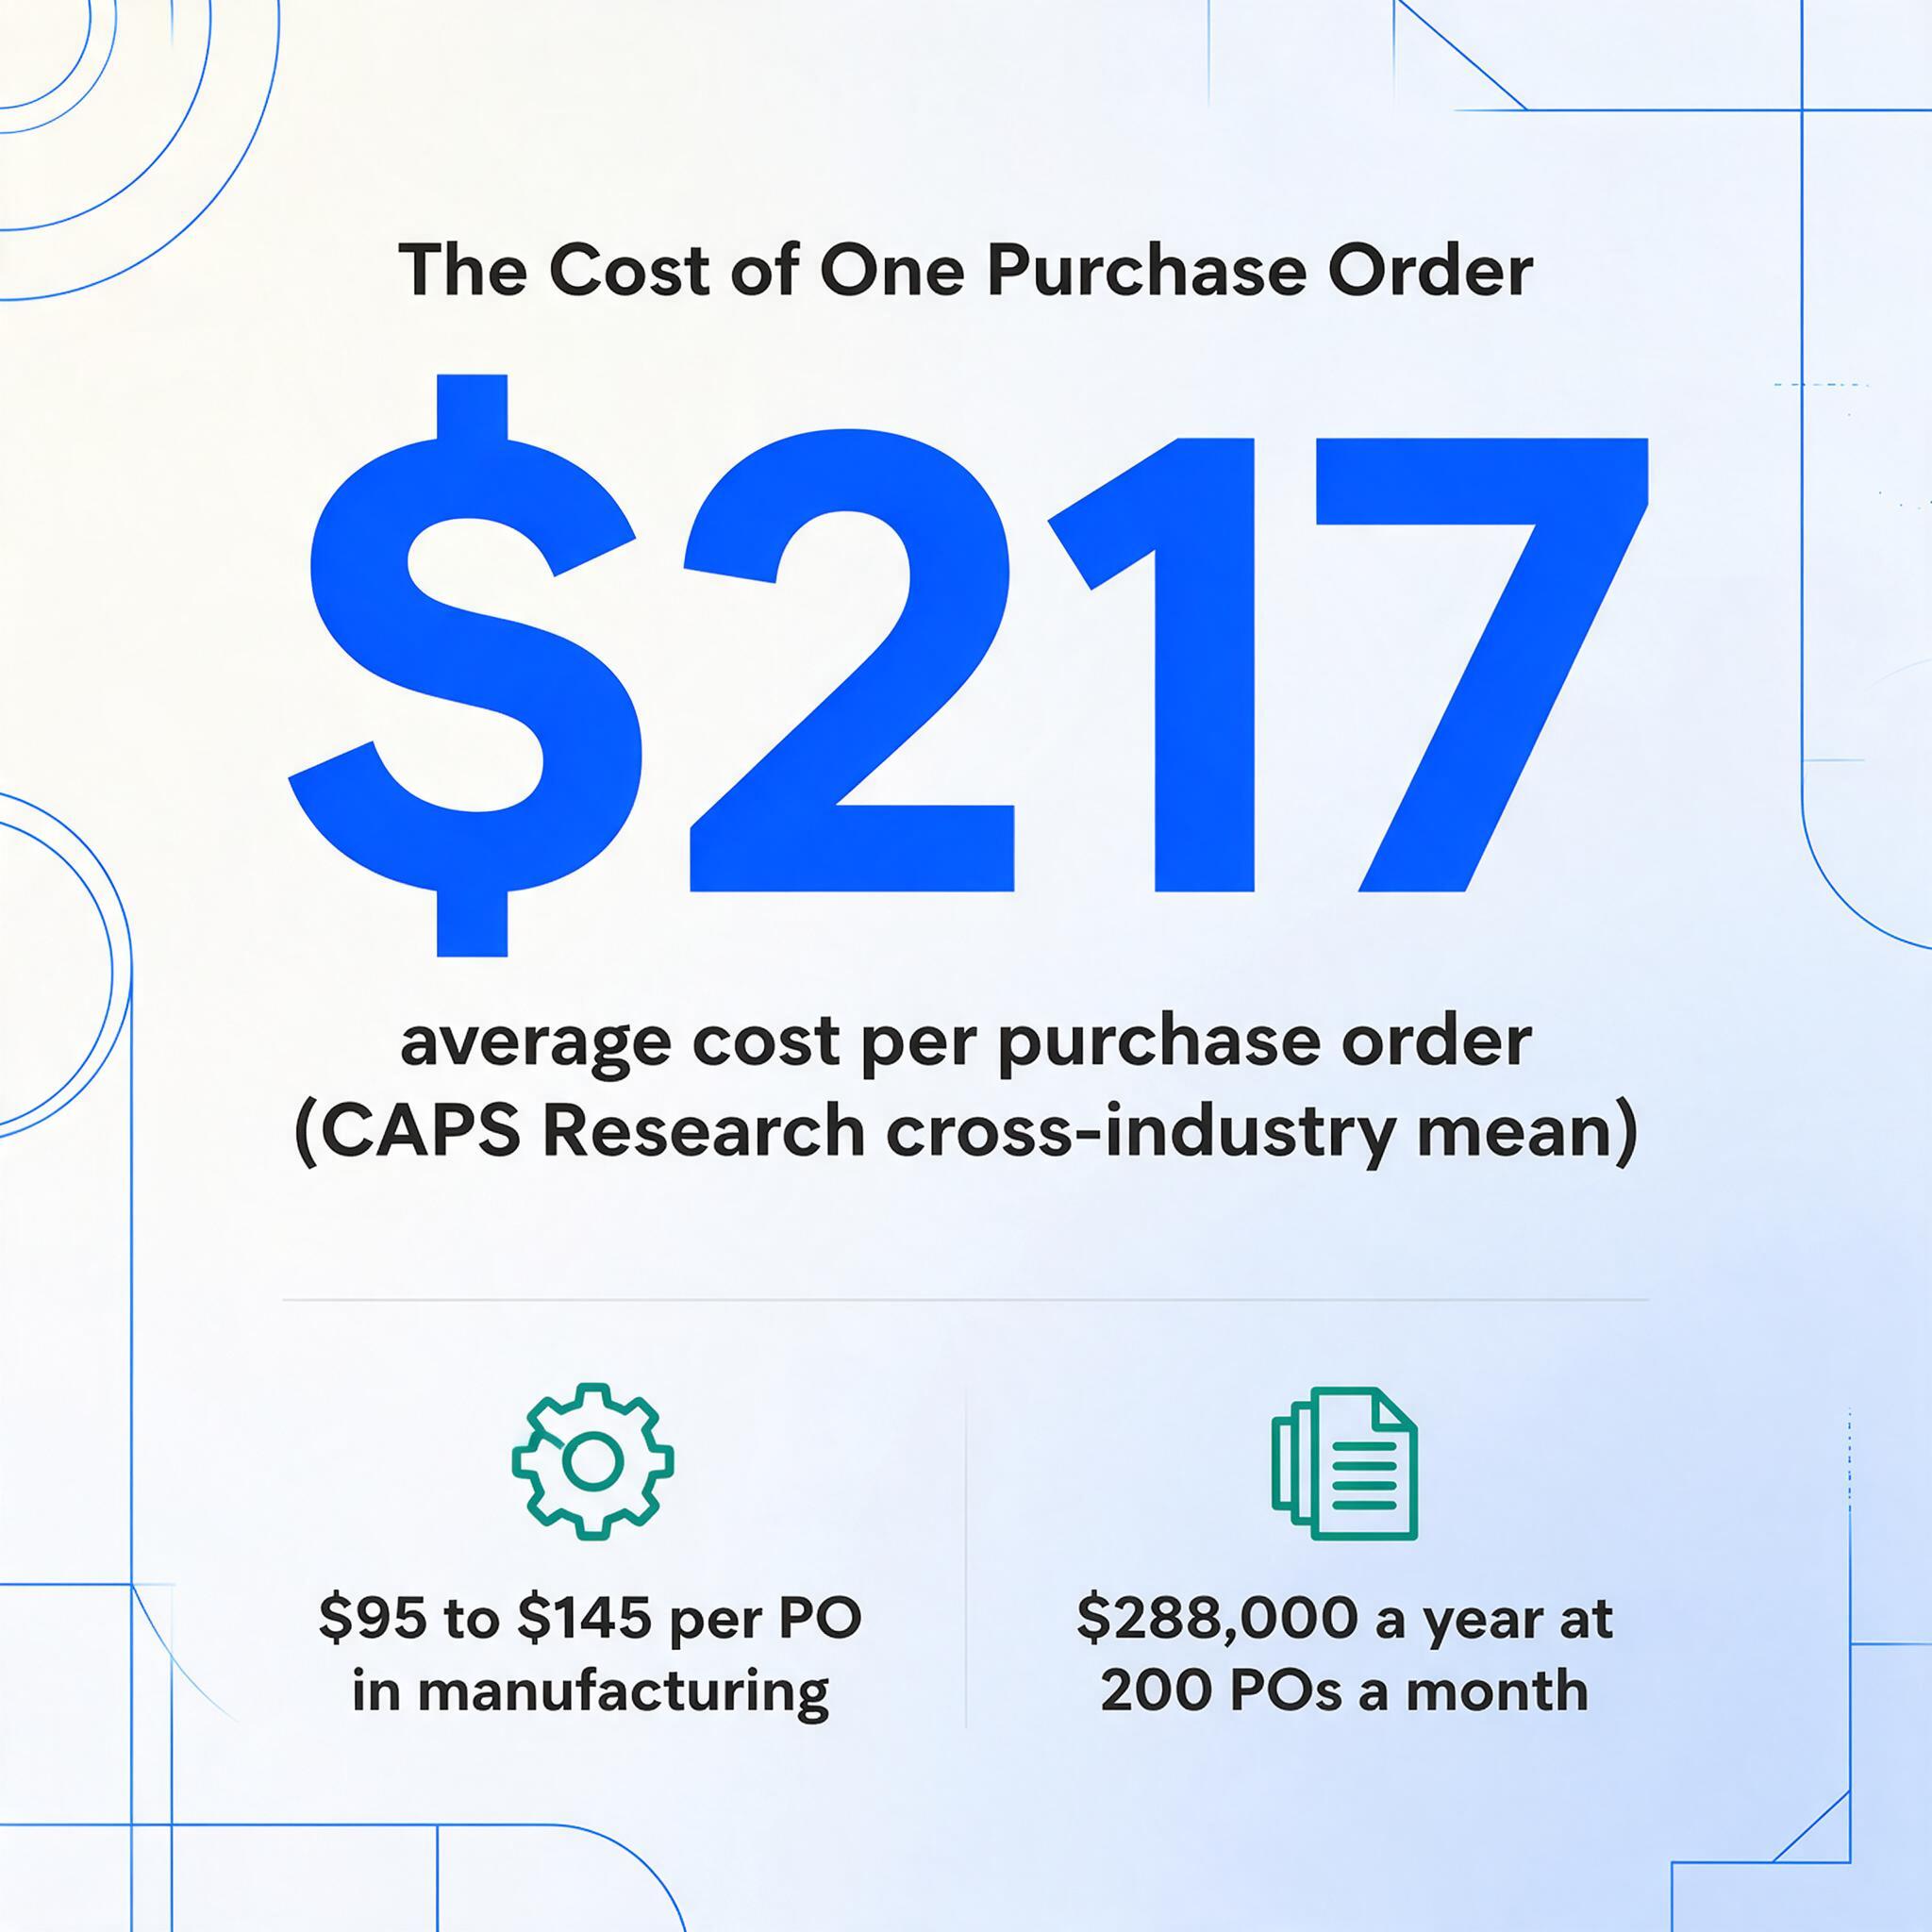
Center for Advanced Procurement Strategy(CAPS Research)は、長年にわたりPO処理コストを測定してきました。彼らの業界横断データによると、注文書1件あたりの平均コストは業界によって約$50から$1,000超まで幅があり、平均は約$217です。製造業に特化した複数の調査結果は、注文書1件あたり$95〜$145に収束しています。この数字には、データ入力という目に見える労働だけでなく、メールでのフォローアップ、ステータス確認、エラー修正、重複注文の解決、そして注文書の記載内容とサプライヤーが実際に出荷した内容の不一致を調整する時間も含まれています。
月200件の注文書を1件あたり$120で処理している企業は、注文データをある文書から別の文書へ移す管理的コストだけで年間$288,000を費やしています。しかもこれは中央値のケースです。高額なケース——50行の明細テーブルと複数レベルの承認を伴う複雑な製造業のPO——では、注文書1件あたりのコストが$500を超えることもあります。
数字そのものが重要なのではありません。重要なのは、これらのコストが10年以上にわたり独立した調査機関によって測定・公表・ベンチマークされてきたことです。すべての購買リーダーがこのデータにアクセスできます。これらのコストを削減できる自動化ツールも存在します。それでもなお、「数字を知っている」ことと「数字を変える」ことの隔たりは、中堅の製造業・流通企業の大半で解消されていません。問うべきは「コストはいくらか」ではなく——解決策が謎ではないのに、なぜ年々同じコストがかかり続けるのか、なのです。
一つの問題ではない。三層が積み重なった問題だ。
ソフトウェアベンダーに手作業のPO処理の問題点を尋ねると、一言でこう答えるだろう。「データ入力は遅く、エラーが発生しやすい」と。その答えは技術的には正しい。しかし、診断としては役に立たない。本当の問題は、調達チームがクリックできるのにタイピングしていることではない。本当の問題は、現在の業界状況下でタイピングを事実上避けられなくしている三層構造にある。
第一層: フォーマットの断片化。 顧客ごとに発注書のレイアウトが異なる。ある企業はPO番号を右上隅に配置し、別の企業は左側のヘッダーブロックに置き、さらに別の企業は2ページ目のバーコードに埋め込む。明細テーブルは5行、50行、300行の場合があり、列数も6列から14列までさまざまだ。品目コードが1列目にあることもあれば4列目にあることもある。納期が明細ごとに記載される場合も、ヘッダーの単一フィールドとして記載される場合もある。r/manufacturingのRedditユーザーが言うように、「最大の問題は、顧客の発注書が同じ形式で届かないことだ。フィールド名に至るまで、全員が異なるPO形式を使っている」。
これは新しい指摘ではない。調達のプロは誰でも知っている。あまり理解されていないのは、フォーマットの断片化はバグではなく、システムの均衡状態であるということだ。各社のPO形式は、自社の内部データ構造に合わせて設定されたERPによって生成され、そのデータ構造は長年の事業固有の決定を経て進化してきた。80社の顧客にPO形式の標準化を求めるのは、調達の依頼ではない。80社にERP出力の再設定を求めることであり、彼らから見ればROIゼロの作業だ。
第二層: サプライヤーへのインセンティブの非対称性。 顧客からPOを受け取るメーカーであれば、データ入力を自動化する強い動機がある。タイピングで節約した1分は、生産計画、在庫管理、サプライヤー交渉に戻せるからだ。しかし、POを送る顧客側には、サプライヤーの負担を軽減するために形式を変更するインセンティブはまったくない。POはこれまで通り、ERPで生成され、PDFをメールに添付して送信される。サプライヤーのデータ入力負担は顧客からは見えない。この非対称性は根本的なものだ。形式を管理する側には標準化する動機がなく、標準化を必要とする側にはそれを要求する交渉力がない。
第三層: ツールのミスマッチ。 過去20年間の文書データ抽出の主流アプローチはテンプレートベースだった。サンプル文書のフィールドに枠を描き、ラベルを付け、同じレイアウトに一致する後続の文書からデータを抽出する。これは単一ベンダーの請求書には機能する。しかし、40社の異なる顧客からのPOには崩壊する。顧客ごとに個別のテンプレートが必要で、各テンプレートの構築に時間がかかる。そして顧客がERPをアップグレードしたり、POレイアウトを変更したりすると(システム移行、買収、リブランディングの際に発生する)、テンプレートは静かに壊れ、破損したデータか何も出力しない。排除しようとしていた作業(手動データ入力)は、別の種類の手動作業(テンプレート保守)に置き換えられただけだ。
この3つの層は互いに増幅し合います。フォーマットの断片化は基本となる現実です。サプライヤーのインセンティブが、それが自然に解決するのを妨げています。テンプレートベースのツールはそれをスケーラビリティの天井に変えます — 5社の顧客向けに注文書データ入力を自動化できても、50社にはできません。その結果、調達リーダーの57%が依然として注文書の手動データ入力に依存している調達環境が生まれています。彼らが自動化を聞いたことがないからではなく、試した自動化が実際のサプライヤーベースのフォーマット多様性に対応できなかったからです。
EDIは世界最大の企業向けにこれを解決した。他のすべての企業にとっては、天井を生み出した。
調達に数年携わっていれば、EDIの提案を聞いたことがあるでしょう。EDI 850 — 電子注文書のANSI X12標準 — は、機械間での注文書交換のための構造化フォーマットを定義しています。両者がEDIを使用する場合、注文書は買い手のERPからサプライヤーの受注管理システムへ、人間の介入なしに流れます。PDFも、タイピングも、フォーマットのばらつきもありません。両者が同じトランザクションセットに準拠しているからです。
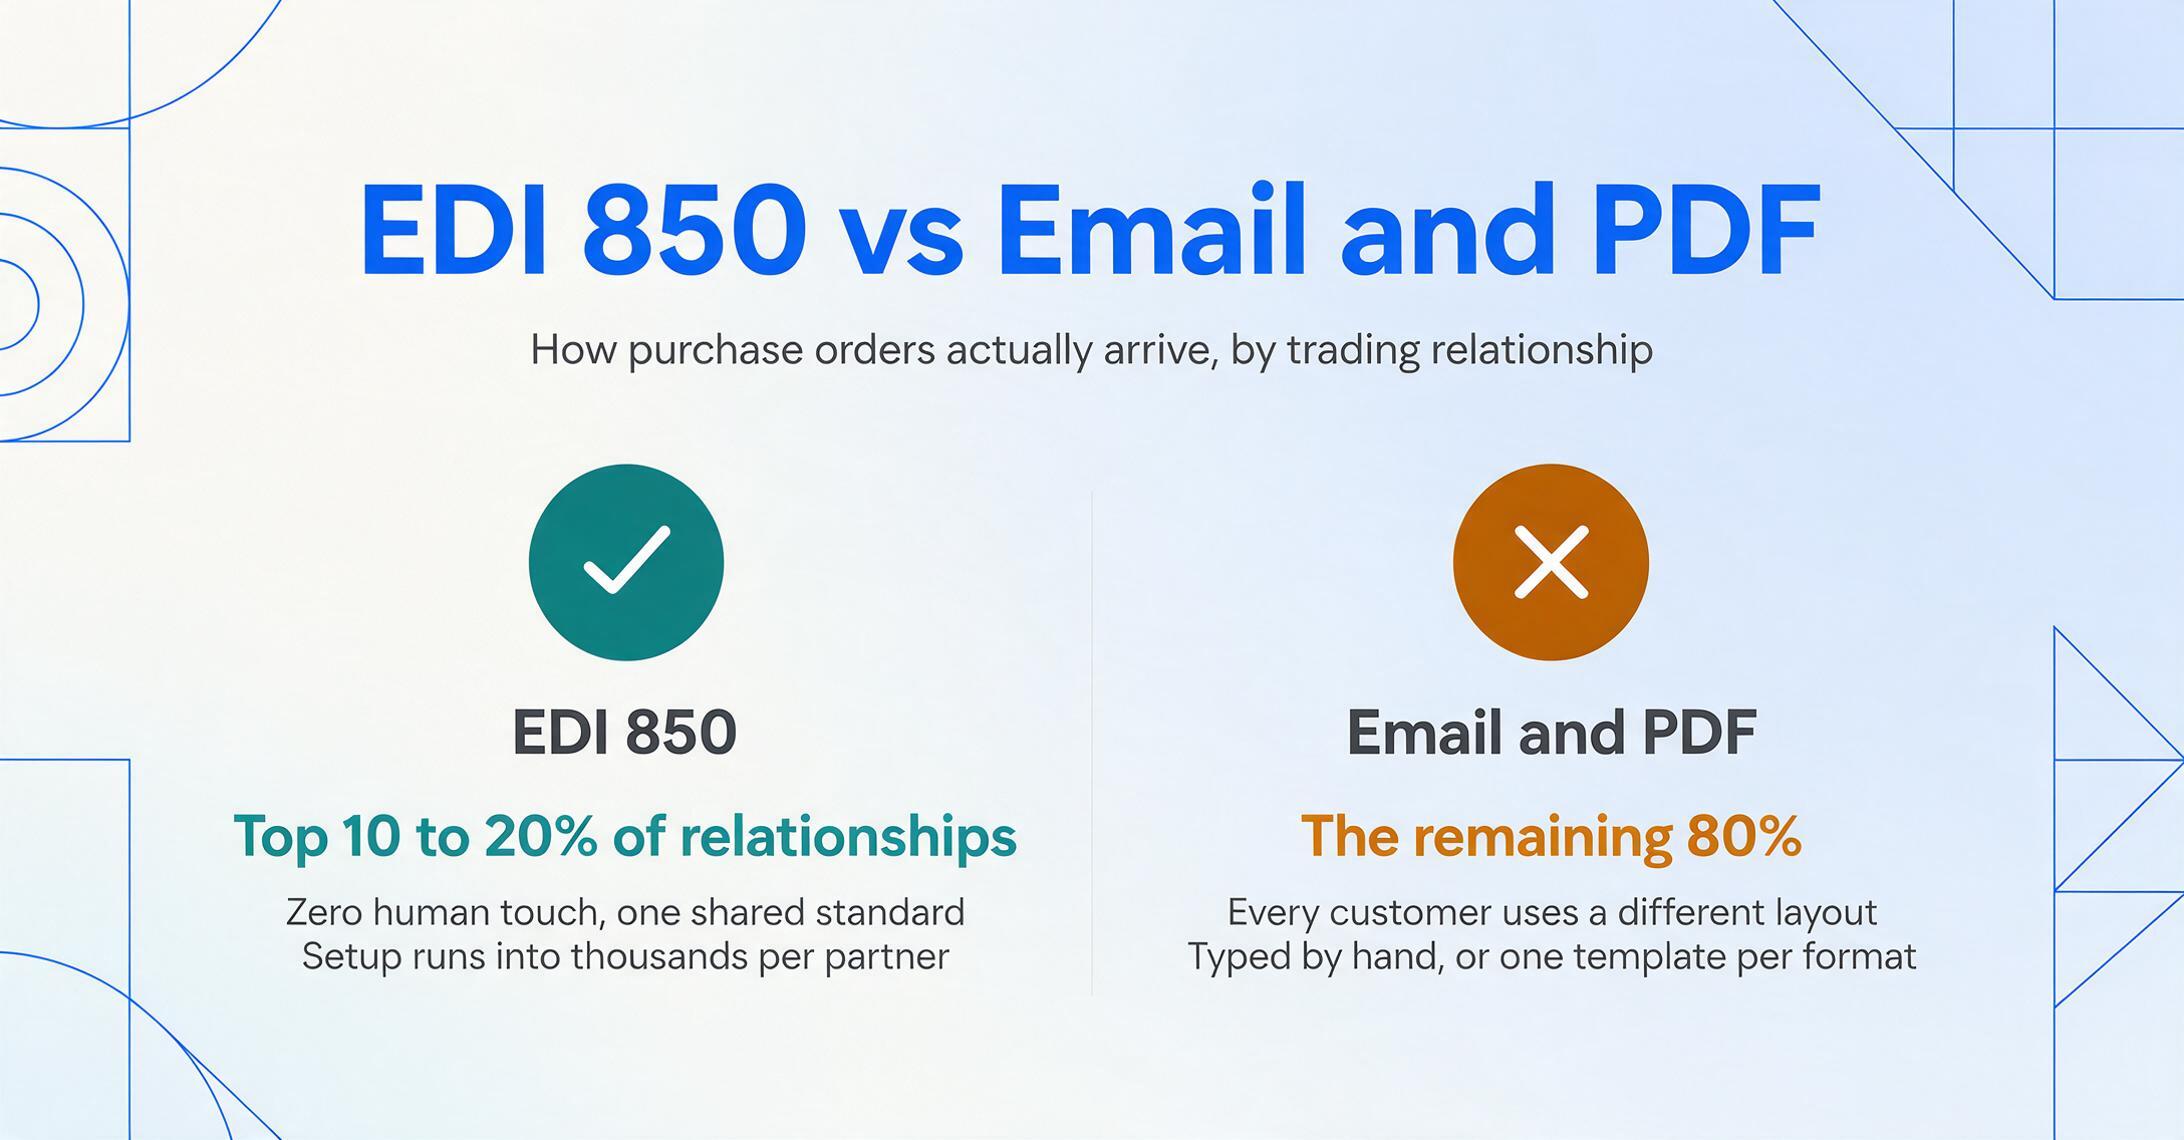
それは見事に機能します — 導入されている関係性においては。大手自動車メーカー、大手小売業者、航空宇宙のプライム企業は、何十年もティア1サプライヤーとEDIを運用してきました。ウォルマートのサプライチェーンは、それがなければ崩壊するでしょう。
問題は、EDIの採用曲線に硬い天井があることです。EDIの導入には、両端に技術インフラが必要です — EDI変換ソフトウェア、通信プロトコル(AS2、VAN)、そしてEDI 850セグメント(BEG、N1、PO1、PID、CTT)と各当事者の内部データ構造を変換するマッピングロジック。セットアップコストは取引先1社あたり数千ドルに達します。高頻度の関係性 — 毎週数百万ドル相当の注文を出すメーカー — では、ROIは即座に成立します。四半期ごとまたは散発的に注文する顧客のロングテール — これはほとんどのミッドマーケットB2B関係に当てはまります — では、決して成立しません。
その結果、2層構造の調達現実が生まれています。取引関係の上位10〜20%はEDIで運用されています。残りの80%はメールとPDFで運用されています。2番目のグループに手動データ入力が存在します — そして、自動化オプションがこれらの関係が経済的に支えられないフォーマット標準化を要求する限り、そこに存在し続けるでしょう。
CAPS Researchは、サプライチェーンリーダーの31%が時代遅れの調達ソフトウェアが実行を妨げていると述べ、37%がデータアクセスの問題を最大の障壁として挙げていることを発見しました。これらの数字は、自動化に気づいていない企業を表しているのではありません。評価した結果、サプライヤーポートフォリオの大部分にとって経済性が成り立たないと判断した企業を表しているのです。
テンプレートの罠:新たな手作業を生み出す自動化
理論上、テンプレートベースの抽出は合理的なアプローチです。ツールにサンプル文書を見せ、各フィールドの位置を指定すると、ツールはその抽出パターンを将来の文書にも適用します。これは、エンタープライズIDPプラットフォームから軽量なSaaS製品まで、OCRの初期からほとんどの文書自動化ツールが採用してきた方法です。
実際には、テンプレートベースの抽出には致命的なスケーリング特性があります。必要なテンプレートの数は、受け取る文書フォーマットの種類に比例して増加します。40社の顧客がそれぞれ異なるPOレイアウトを使用している場合、40個のテンプレートが必要です。新規顧客ごとに、フィールドの特定、領域の描画、抽出精度の検証を含むテンプレート設定セッション(通常10〜15分)が必要になります。41社目の顧客が加わると、誰かが手を止めてテンプレート#41を構築しなければなりません。
これにより、自動化の約束が逆転します。ツールは反復的な手作業を排除するはずでした。その代わりに、テンプレートのメンテナンスという、目立ちにくいものの同様に時間のかかる新しい反復作業のクラスを生み出しました。しかも、データ入力と異なり、テンプレートの障害は静かに発生します。顧客がPOフォーマットを変更した場合(新しいERP、新しいブランディング、合併によるフォーマット統合)、テンプレートはエラーを出しません。誤ったデータや欠落したデータを抽出し、その問題は後工程で発覚します。注文が間違っていたり、出荷先が誤っていたり、請求書が一致しなかったりする時です。
コスト構造は陰湿です。手動データ入力エラー(数量の打ち間違いや部品番号の桁違い)は、通常、同じワークフロー内で、同じ担当者か下流の検証によって発見されます。テンプレートの障害は系統的なエラーを生み出します。顧客XからのすべてのPOで納期フィールドが欠落し、倉庫から配送先を問い合わせるまで誰も気づきません。1件あたりのエラーコストは高く、検出までの遅延も長くなります。
複数のERPエコシステム(SAP、NetSuite、Microsoft Dynamics、Epicor、Sage、Infor)にまたがる20〜80社の異なる顧客からPOを処理する中規模メーカーにとって、テンプレートアプローチは作業を減らしません。データ入力デスクからテンプレート設定画面へと移すだけです。そして、専任の自動化エンジニアがいない調達チームにとって、その移行は問題を改善するどころか悪化させます。
調達チームが実際に日々行っていること
コストベンチマークや構造分析の背後には、製造業の調達部門で毎日何千回も繰り返される実際のワークフローがあります。それを率直に説明する価値があります — 作り話ではなく、調達の専門家がRedditや業界フォーラムで語る内容を総合したものです。
受信トレイには顧客からの新しいメッセージが届いています。それぞれが注文書の添付ファイルで、通常はPDFです。一部は顧客ポータル経由、ほとんどはメール経由です。調達コーディネーターが最初の注文書を開きます。NetSuiteを利用している顧客からのもので、PO番号はヘッダーに、ベンダーコードは参照フィールドに、明細項目は9列のテーブルにあります。彼らはスプレッドシートやERPを開き、入力を始めます:PO番号、日付、顧客名、送付先住所。次に明細項目を1行ずつ:品目コード、説明、数量、単位、単価、金額。POに15の明細項目があれば、90個の個別データポイントを手動で転記することになり、数字を間違えたり行を飛ばしたりしないようにしなければなりません。
2通目のPOはSAPを利用している顧客からのものです。レイアウトはまったく異なります。PO番号は右上にあります。顧客名は別の位置にあります。明細テーブルは9列ではなく12列で、倉庫の場所や納期などの追加フィールドが各行にあります。フィールド名も異なります — SAPでは「Material」と呼び、NetSuiteでは「Item Code」と呼びます。
3通目のPOはERPをまったく使っていない顧客からのものです — Word文書をPDFに変換したもので、明細項目はテーブルではなく箇条書きでフォーマットされています。テンプレートベースの抽出ツールはこれに即座に対応できません。人間なら読めますが、1時間に何度も3つのまったく異なる文書構造を切り替える認知的負荷が本当の生産性低下の原因です — タイピング速度ではありません。
r/procurementのRedditユーザーが述べたように:「私たちは文字通りサプライヤーからPDFを受け取り、スプレッドシートに値をコピーし、各行をPOと照合し、不一致についてサプライヤーにメールし、これらのシステムが互いに連携しないためすべてをERPに貼り付けていました。仕事の半分はサプライヤー管理を装った管理業務です。」
この説明で印象的なのは非効率さではなく、正確さです。システムは本当に互いに連携していません。PDFは行き止まりのフォーマットです:視覚的なレイアウトは保持しますが、データ構造は破壊します。受け取る側のERPは構造化されたフィールドマッピング済みの入力を期待しています。この2つのフォーマットの間には、POが顧客のシステムを離れたときに失われたデータ構造を手動で再構築する人間がいます。その人間は価値を付加していません。彼らはフォーマット変換を行っているのです — ソフトウェアが処理すべきタスクですが、フォーマットが変わり続けるためソフトウェアでは処理できません。
手作業入力を当たり前とする組織の慣性
手作業による注文書データ入力のコストが測定可能で、それを削減するツールが存在するのに、なぜ市場はこの問題を解決しないのでしょうか。その答えはテクノロジーを超えたところにあります——組織の行動とベンダーのインセンティブに組み込まれているのです。
そのコストは意思決定者には見えません。手作業による注文書データ入力は、個別の費用として表面化しません。それは購買担当者やコーディネーターの時間が週を通じて分散して費やされるもので、「データ入力労働」ではなく「運用経費」に分類されます。CFOが「手作業による注文書処理——$288,000」という項目を承認することはありません。コストは現実のものですが、それがなくても存在する給与に吸収されています。この会計上の不可視性により、修正のための予算所有者が自然には存在しません。ITは調達効率を管轄せず、調達部門はソフトウェア評価を管轄せず、財務部門にはその項目が見えません。問題は部門間の隙間に落ちてしまうのです。
自動化の失敗は、手作業の単調さよりも目に見えます。手作業のデータ入力でエラーが発生した場合、修正は簡単です。間違いを見つけ、訂正し、更新された注文を送るだけです。面倒ですが日常的です。自動化ツールでエラーが発生した場合、失敗はより大きく、より目に見え、診断も難しくなります。壊れたフィールドマッピングで50件の注文書を自動処理すると、50件の誤った注文が発生する可能性があります——それはマネージャーの机に届く危機です。自動化を推進した調達担当者が非難を受けます。ほとんどの組織が一度の自動化の失敗から学ぶ教訓は、「当社の文書はツールが扱うには複雑すぎる」であり、「フォーマットの多様性に対して間違った種類のツールを使った」ではありません。このリスクの非対称性——自動化の失敗は手作業の失敗よりも組織的なコストが高い——は、現状維持への強力なバイアスを生み出します。
ERPベンダーには誤ったインセンティブがあります。注文書データ入力を解決する最適な立場にある企業——SAP、Oracle、Microsoft、NetSuite、Epicor——は、それを解決するインセンティブが最も少ない企業です。彼らの調達モジュールは構造化された入力を前提としています。彼らの営業活動はフルスイート導入を中心に構築されており、ポイントソリューションの抽出ではありません。顧客が「顧客の注文書データをどうやって御社のシステムに入れればいいですか」と尋ねると、典型的な答えは「顧客に当社のポータルを使ってもらう」「EDIを設定する」「手動で入力する」のいずれかです。3つの答えすべてが、フォーマットの問題をソリューションの外部にあるものとして受け入れています。ERPベンダーのビジネスモデルは、あなたが彼らのエンドツーエンドのプラットフォームを採用することに依存しており、あなたのシステムと顧客のシステムの境界に位置する抽出ステップを解決することには依存していません。
この問題は、何世代もの調達プロフェッショナルの間で正常化されてきました。調達に15年間携わってきた人々は、注文書データ入力が手作業ではなかった時代を覚えていません。彼らはその周りにワークフローを構築してきました。Excelのショートカット、マクロ、そして手作業入力を耐えられるものにするメンタルモデルを持っています。自動化を提案することは、効率改善のように聞こえません——それは、欠点はあるものの何年も確実に注文を出し続けてきたシステムを脅かすように聞こえます。変化の運用コスト——新しいツールを学び、その出力を信頼し、失敗時のエッジケースに対処すること——は、計算上はそうでなくても、現状維持の運用コストよりも大きく感じられます。
これらの要因はいずれも技術的な能力の問題ではありません。インセンティブ構造、リスク認識、組織的な習慣の問題です。POデータ入力を自動化するツールは存在します。広く採用されていない理由は、機能しないからではなく、最も広く利用可能なツール(テンプレートベースの抽出、フルスイートERPモジュール、EDI)が、フォーマットの標準化、サプライヤーごとの設定、統合のオーバーヘッドといった要件を課すため、調達関係の大半において導入コストがROIを上回るからです。
状況を実際に変えるもの
根本的な問題がフォーマットの断片化、つまり同じ論理情報(PO番号、明細項目、数量、価格)を無制限の物理レイアウトで配置した文書であるなら、解決策は各レイアウトを個別に考慮する必要があるツールではありえません。レイアウトが何であれ気にしないツールでなければならないのです。
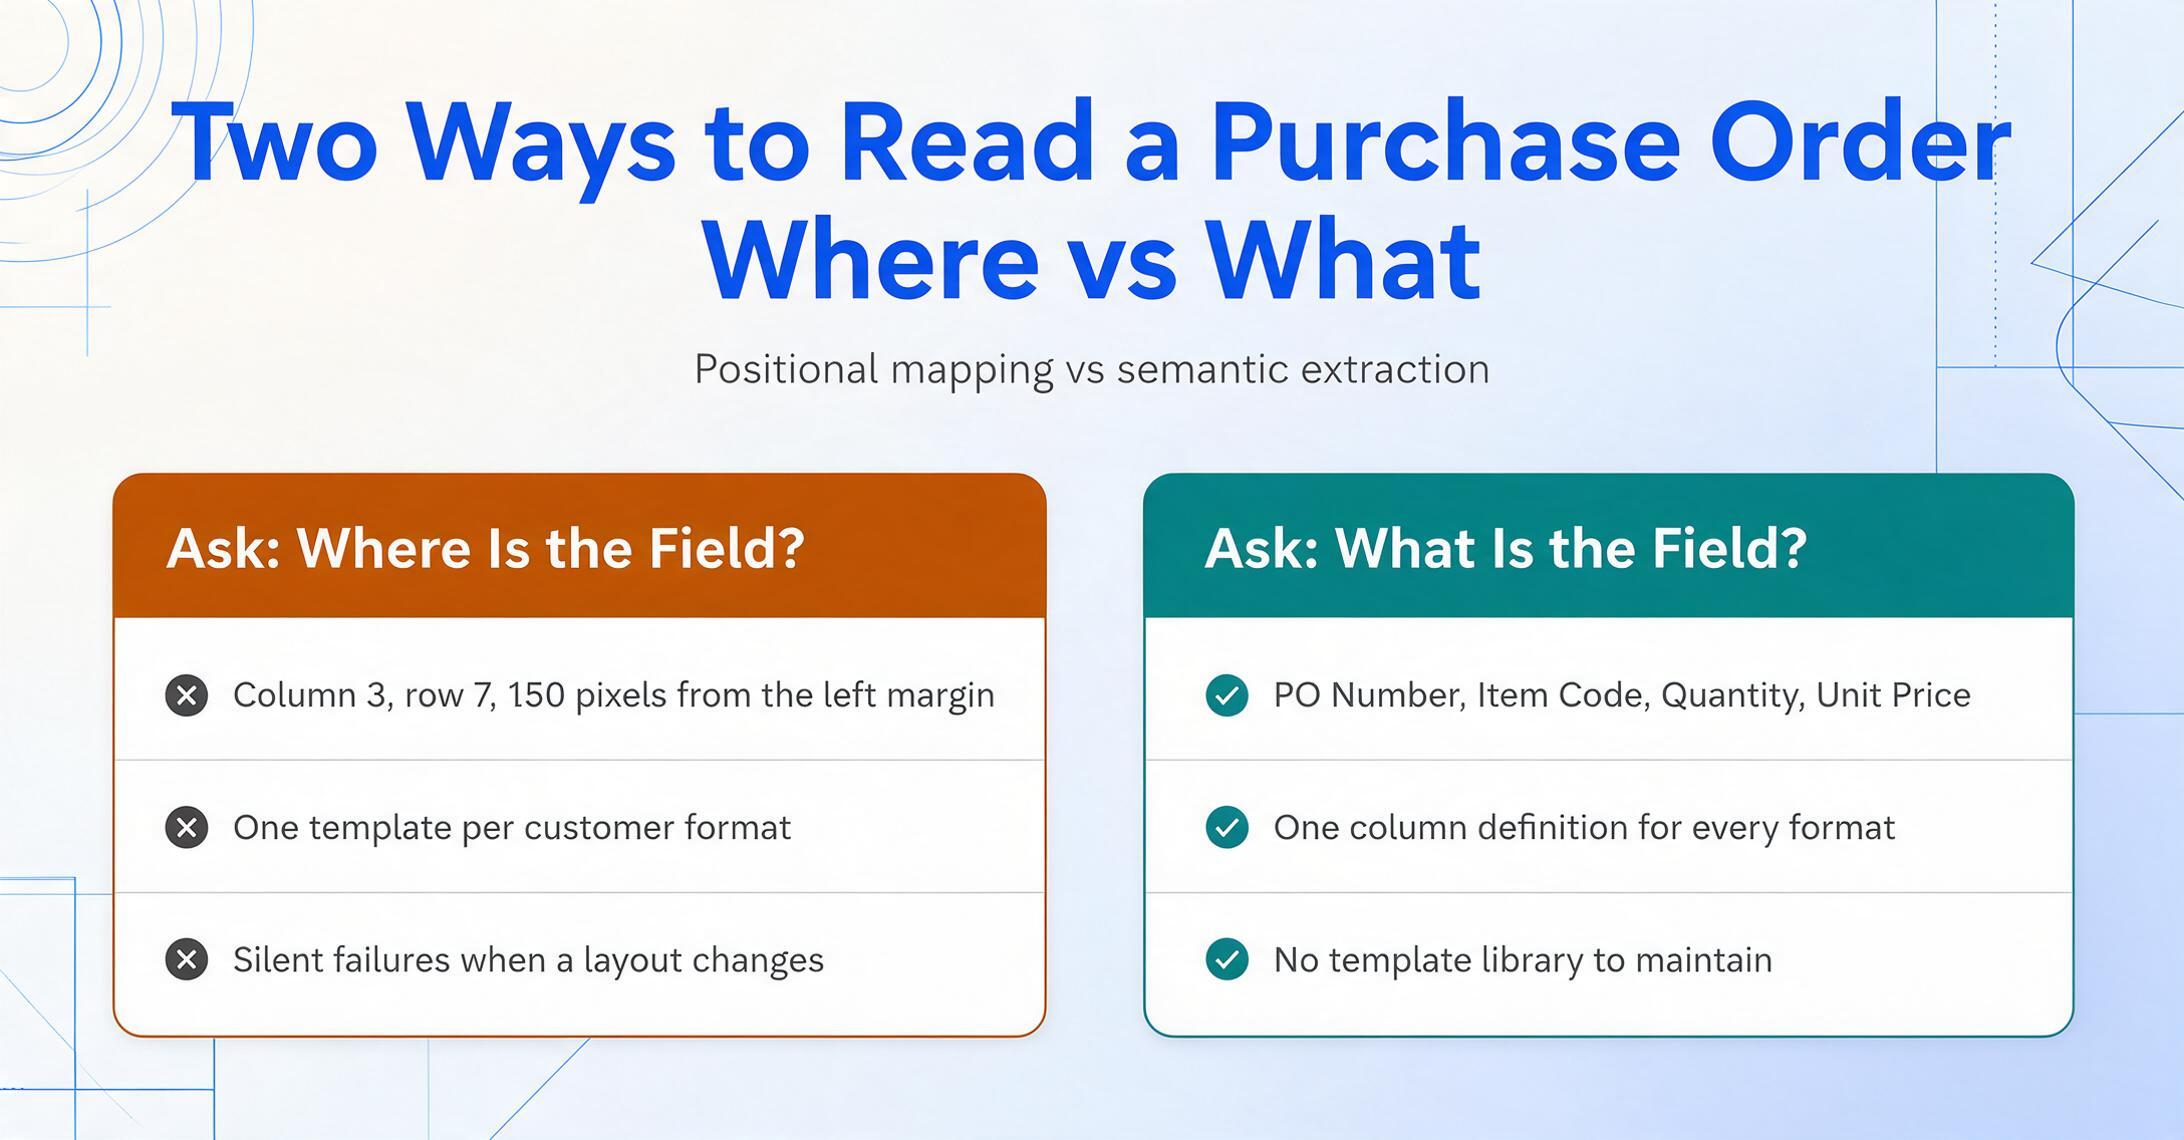
これがテンプレートベースの抽出と意味ベースの抽出の違いです。テンプレートは「フィールドはどこにあるか」を問います。3列目、7行目、左マージンから150ピクセル。意味ベースのアプローチは「フィールドは何か」を問います。「PO番号」という意味的役割に一致するテキスト、つまり文書上部付近にある一意の識別子で、通常は英数字で、「PO #」「注文番号」「注文書番号」などのバリエーションでラベル付けされているものを探し、ページ上のどこにあっても値を抽出します。
これが列名抽出の仕組みです。「PO番号」「サプライヤー名」「品目コード」「数量」「単価」「行合計」など、必要な列を定義すると、AIは値がどこにあるかではなく、何を意味するかを理解して各値を特定します。入力した列名が出力テーブルのヘッダーになります。抽出ロジックが意味ベースであり位置ベースではないため、1つの列定義がすべての顧客のPOフォーマットで機能します。
構造的な影響は大きいものです:
- テンプレート不要の運用。顧客ごとの設定不要。保守するテンプレートライブラリも不要。顧客がPOレイアウトを変更したときの静かな失敗もありません。抽出は各文書の構造に自動的に適応します。
- 明細項目の処理。注文書の主要なペイロードは明細項目テーブルであり、さまざまな列構成で数十行に及ぶことがあります。列名抽出は各行を完全なレコードとして読み取り、正しい数量、説明、価格を各明細にマッピングします。複数ページにまたがるテーブルも含まれます。
- マルチフォーマット入力。同じ列定義がPDF、スキャン文書、さらにはメールのスクリーンショットでも機能します。抽出ロジックはSAPで生成されたPOとWord文書に入力されたPOを区別しません。コンテンツを読み取るのであって、フォーマットを読み取るのではないからです。
実際の動作をより詳しく確認したい場合は、PO抽出のフィールド別ガイドを含む記事「テンプレートなしで注文書からExcelへ特定フィールドを抽出する方法」をご覧ください。バッチ処理(数十社の異なる顧客からのPOに対して、同じ列定義を1回の操作で実行する方法)については、「あらゆるサプライヤー形式の注文書を1つのスプレッドシートにバッチ処理する方法」のガイドをご参照ください。また、抽出結果を既存の注文管理システムに接続する方法を含む、エンドツーエンドの自動化ワークフローについては、「ERPなしで注文書データ入力を自動化する方法」の記事をご覧ください。
ファイルは安全に処理され、保存されることはありません。
よくある質問
なぜ全顧客に当社のPO形式の使用を義務付けられないのですか?
試すことは可能です。購買力の強い大企業は、主要サプライヤーに対して成功することもあります。しかし、ほとんどのミッドマーケット企業では、力関係は逆です。顧客のビジネスが必要であり、顧客がPO出力を標準化する必要性よりも、その関係が重要です。たとえ顧客が同意しても、変更を実施するには、顧客のITチームがERP出力を再構成し、テストし、展開する必要があります。これは実際のコストがかかり、彼らにとって直接的な利益はゼロです。多くの調達チームは、形式標準化を強制する労力が、形式の多様性に対処する労力を上回ると考えています。
当社のERPはすでにPOデータ入力を処理しているのではありませんか?
ほとんどのERP調達モジュールは、POの作成(サプライヤーへの注文書の生成)を処理しますが、POの受領(顧客からの注文書の取り込み)にははるかに弱いです。ERPは構造化された入力(EDI、CSVインポート、または直接データ入力)を期待し、非構造化PDFから構造化データを抽出する組み込みのメカニズムを提供しません。顧客がPOをPDF添付ファイルとして送信する場合、ERPは添付ファイルとして保存できますが、追加の抽出ツールや手動入力なしでは読み取ることができません。
複雑な明細行テーブルを含む注文書に対するAIベースの抽出の精度はどの程度ですか?
印刷されたテーブルデータは、ビジュアルAIモデルを使用して最大99%の精度で認識できます。最も難しいケースは長いテーブルではなく(AIは反復構造をうまく処理します)、明細行が行ではなく物語テキストとしてフォーマットされている文書(サービスベースのPOで一般的)、または印刷されたテーブルに手書きの注釈が追加されている文書です。これらのエッジケースでは、抽出は手動作業を完全に排除するのではなく、80〜90%削減する最初のパスとして扱うべきです。結果は、ERPまたは注文管理システムにコミットする前に常にレビューする必要があります。
顧客が手書きの変更や注釈付きのPOを送信した場合はどうなりますか?
列名抽出は、印刷文書への注釈を含む手書きを処理できます。AIは手書きテキストを文書のコンテンツの一部として読み取り、意味に基づいて適切なフィールドにマッピングします。手書きの精度は印刷テキストよりも低く、特に筆記体や薄い鉛筆の注釈では、手書きのPOはきれいな印刷物よりも慎重にレビューする必要があります。
これは、すでに支払っているERPに加えて、もう一つのソフトウェアサブスクリプションを追加するだけのことですか?
これは、ほとんどのERPがカバーしていない特定のギャップ、つまりPDFの注文書を受け取ってから構造化されたデータを扱うまでの抽出ステップに対応するものです。現在、そのステップにバイヤーやコーディネーターの時間を費やしている場合(そしてコストベンチマークによれば、中規模メーカーの多くが注文書1件あたり95〜145ドルを費やしているとされています)、比較対象は「ソフトウェア vs. ソフトウェアなし」ではなく、「ソフトウェア vs. 人件費」です。毎月200件の注文書を処理するメーカーでは、控えめに見積もっても年間の手動処理コストは20万ドルを超えます。重要なのは、抽出ツールがそのコストを、ツール自体のコスト以上に削減できるかどうかであり、それは注文書の量と複雑さに依存するのであって、ツールが既存のERP予算カテゴリに収まるかどうかではありません。
問題が実際に存在する場所
注文書データ入力の問題が何十年もの自動化技術を生き延びてきたのには理由があります。調達チームがテクノフォビアだったり情報不足だったりするからではありません。問題の構造、つまり無限のフォーマットのバリエーション、買い手と供給者の間のインセンティブの不一致、多様なフォーマットに対応できないテンプレートベースのアプローチが支配的なツール環境が、明白な解決策(自動化ソフトウェアの購入)を大多数の調達関係にとって非効率にしているのです。
EDI 850は、セットアップコストを正当化できる高ボリュームのパートナーシップにとってはこの問題を解決しました。テンプレートベースの抽出は、フォーマットの安定性が保証されているケースでは解決しました。しかし、この2つの解決策の間には、現実の調達の大部分を含むギャップがあります。それは、それぞれが独自の注文書フォーマットを持つ数十の顧客であり、その誰もがあなたのために標準化することは決してないでしょう。そのギャップこそが手動データ入力が存在する場所であり、調達チームがフォーマットの標準化を必要としないツールを採用するまで、そこに存在し続けるでしょう。
テンプレートベースの抽出から意味ベースの抽出への移行、つまり「フィールドはどこにあるか」から「フィールドは何か」への問いの転換は、問題の経済性を構造的な根源から変えます。抽出精度が位置のマッピングではなく意味の理解に依存するようになると、フォーマットの多様性は障壁ではなくなり、無関係になります。自動化のコストは「サプライヤーごとに1つのテンプレート」から「全サプライヤーに対して1つの列定義」へと低下します。採用の障壁は技術的な能力ではなく、前世代の自動化ツールが文書フォーマットが安定している世界向けに設計されており、調達の現実はその逆であることを認識することです。
列名抽出が実際の注文書をどのように処理するかを確認してください。テンプレートなしで、あらゆる顧客フォーマットに対応します。
今すぐ試す →