El problema de la entrada de datos en las órdenes de compra
— y qué lo mantiene vigente
Los datos de evaluación comparativa de estándares abiertos de APQC revelan que las organizaciones gastan entre $14 y más de $54 para procesar una sola orden de compra. Para un fabricante mediano que emite 5,000 PO al año, la brecha entre los de mejor y peor desempeño es la diferencia entre $70,000 y $270,000 en costos anuales de procesamiento. CAPS Research sitúa el promedio entre industrias aún más alto, en $527 por PO en su encuesta más reciente. Los datos han estado disponibles durante años. El EDI 850 — el estándar ANSI X12 para órdenes de compra electrónicas — existe desde hace décadas. Y sin embargo, el 75% de las órdenes de compra aún se envían por correo electrónico o fax, según una encuesta de la industria de AutoQuotes, llegando a bandejas de entrada donde alguien abre el adjunto y comienza a escribir. Esto no es una brecha tecnológica. Es un problema estructural que la mayoría de las herramientas de automatización nunca fueron diseñadas para abordar.
Conclusiones clave
- Doscientas órdenes de compra al mes a $120 cada una queman $288,000 al año en entrada de datos manual — un costo absorbido en los salarios de los compradores tan por completo que ningún CFO ha aprobado jamás una partida llamada “Procesamiento manual de PO.”
- Las herramientas de extracción basadas en plantillas no eliminaron el trabajo manual de PO — lo reubicaron de escribir números a construir y mantener cuarenta plantillas separadas, donde los fallos son silenciosos y se descubren solo después de que los pedidos se envían incorrectamente.
- La extracción que lee un campo de PO por lo que significa en lugar de dónde se encuentra funciona de manera idéntica en el formato de orden de compra de cada cliente — una definición de columna los cubre todos, con cero plantillas que construir o romper.
El problema de $217 del que nadie habla
Pregúntele a un gerente de adquisiciones cuánto cuesta procesar una orden de compra y normalmente recibirá una mirada en blanco. No porque no le importen los costos — sí le importan. Sino porque el costo de la captura manual de datos de PO está tan distribuido en las operaciones diarias que desaparece en el fondo. No es una partida en el presupuesto de nadie. Es simplemente "lo que hacemos".
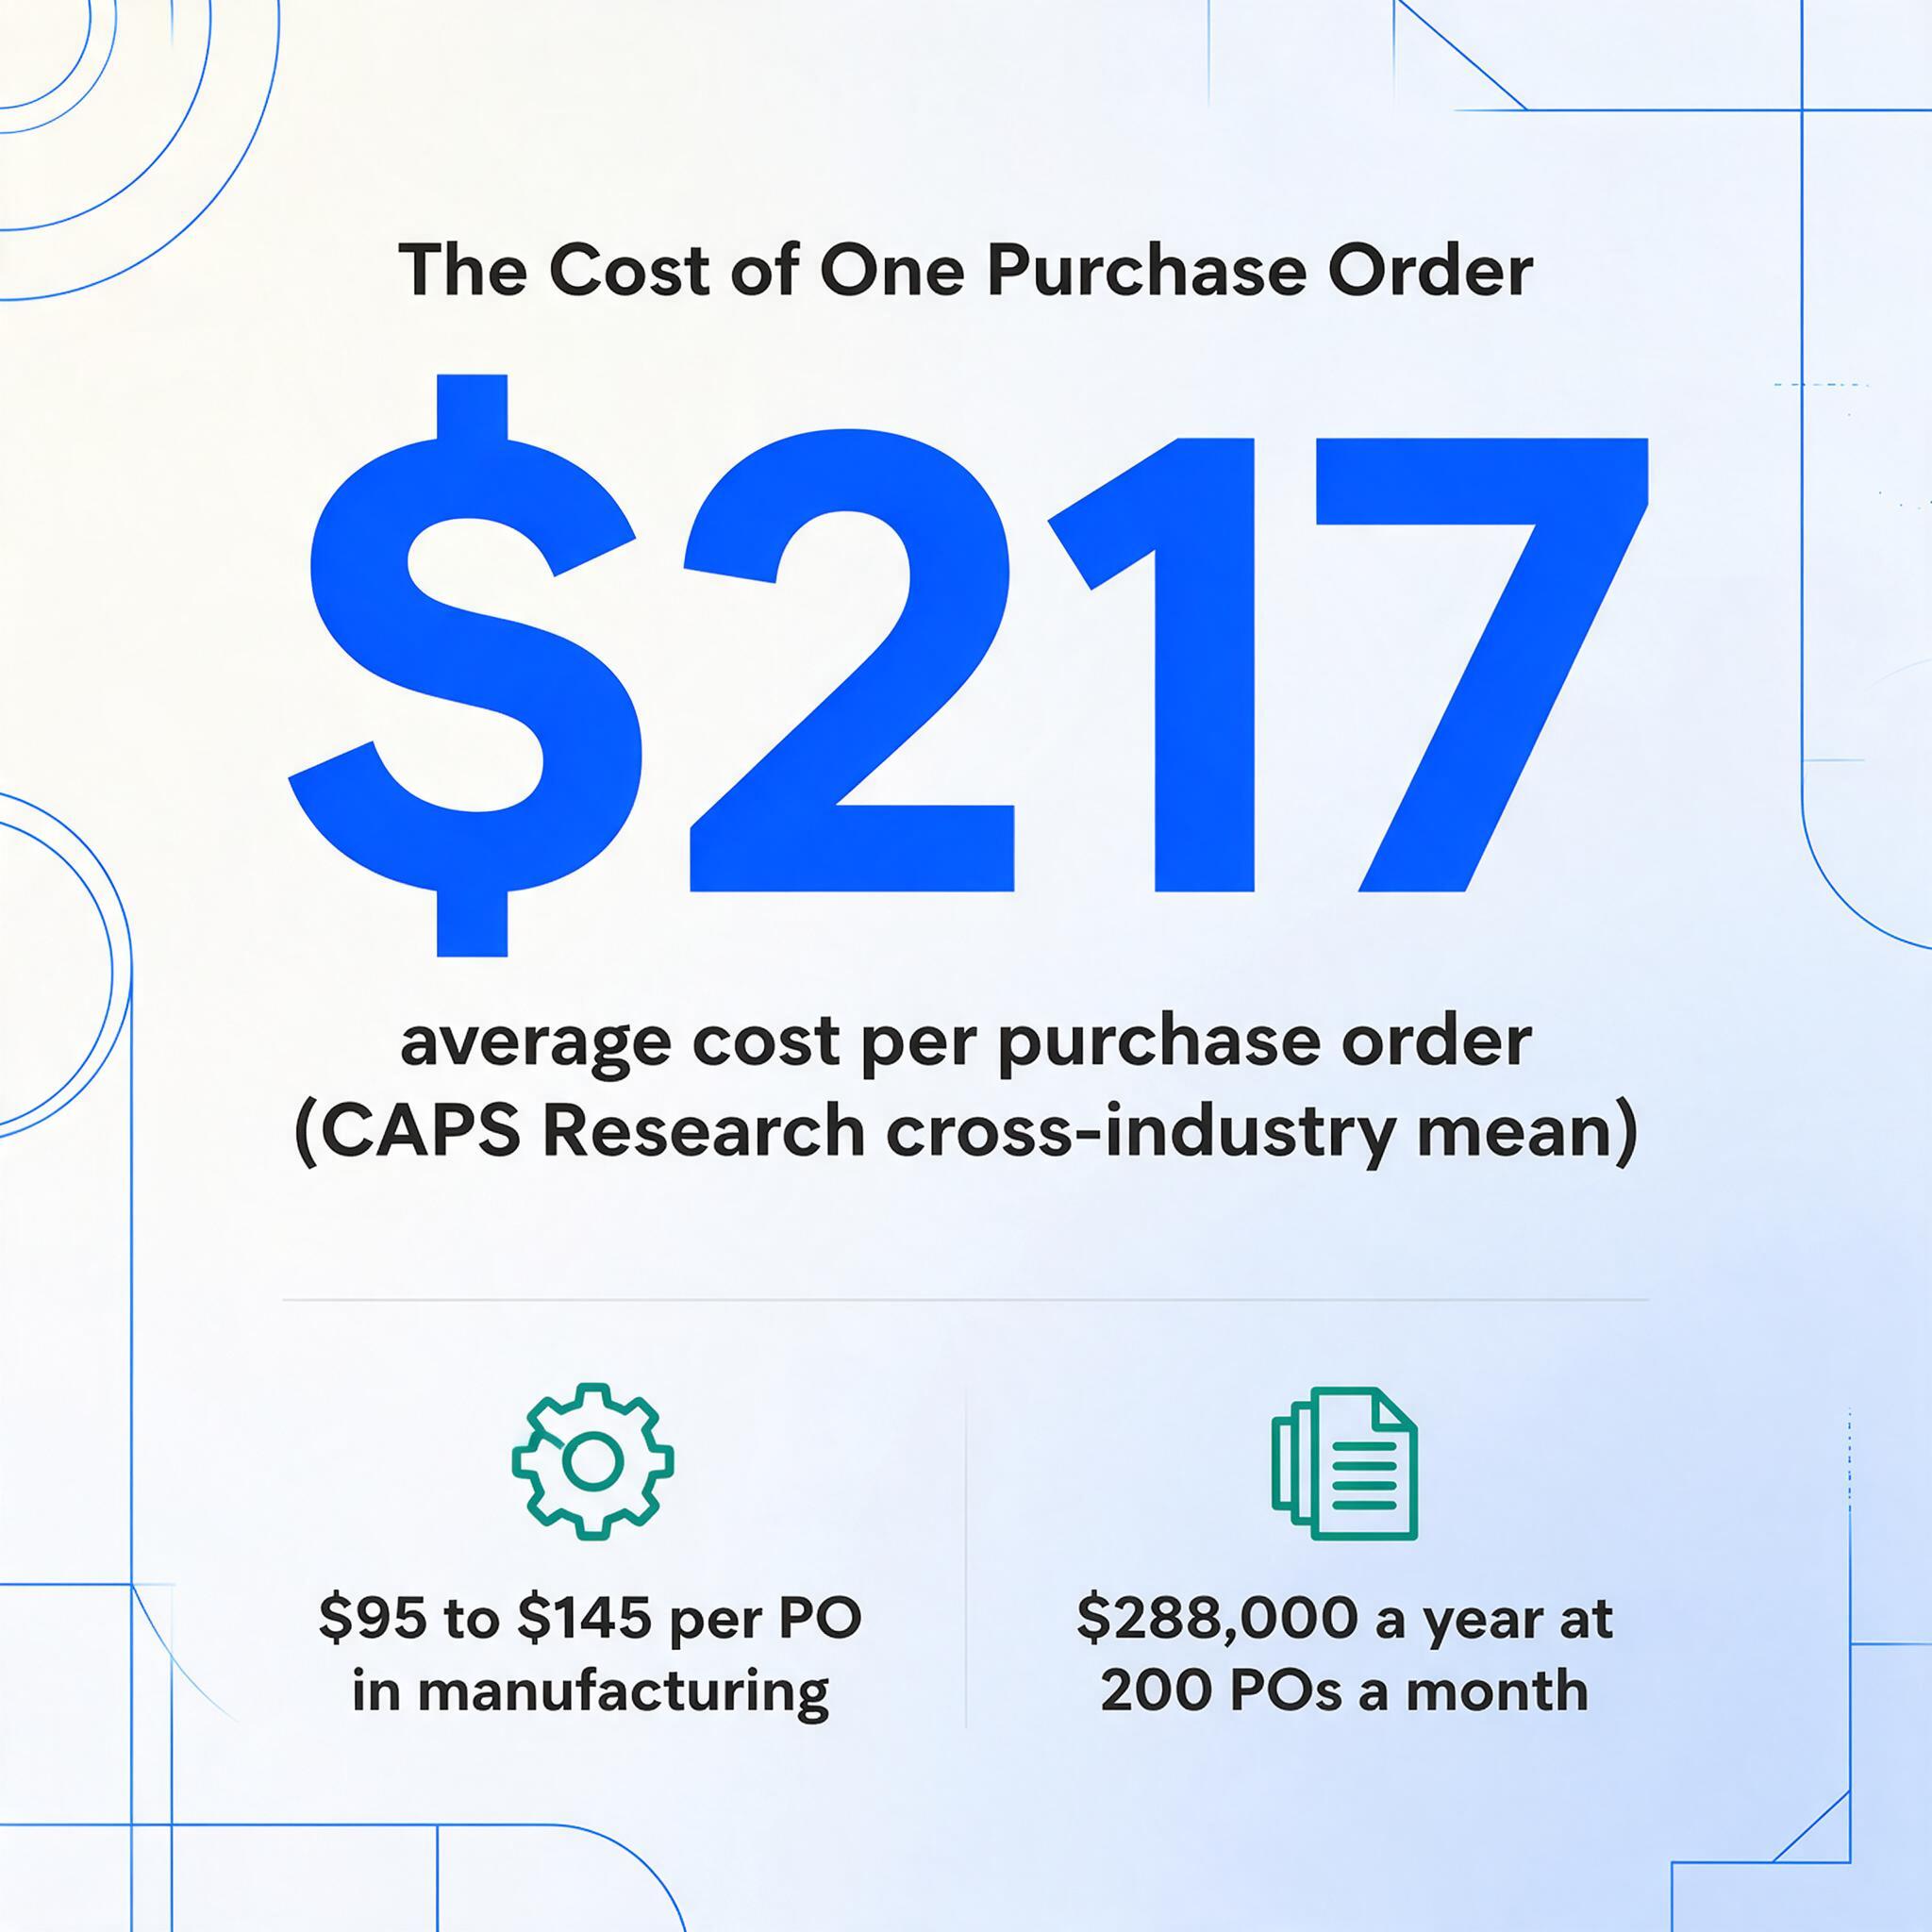
El Center for Advanced Procurement Strategy (CAPS Research) ha medido los costos de procesamiento de PO durante años. Sus datos intersectoriales muestran un costo promedio por PO que va desde aproximadamente $50 hasta más de $1,000, según la industria, con una media de alrededor de $217. Las estimaciones específicas de manufactura de múltiples fuentes convergen en $95–$145 por PO. Ese número incluye no solo la mano de obra visible de teclear datos — incluye correos de seguimiento, verificaciones de estado, correcciones de errores, resolución de órdenes duplicadas y el tiempo dedicado a conciliar inconsistencias entre lo que dice la PO y lo que el proveedor realmente envió.
Una empresa que procesa 200 PO al mes a $120 cada una gasta $288,000 al año solo en el costo administrativo de mover datos de órdenes de un documento a otro. Y ese es el caso mediano. En el extremo superior — PO de manufactura complejas con tablas de 50 líneas y aprobaciones de múltiples niveles — el costo puede superar los $500 por PO.
El número en sí no es el punto. El punto es que estos costos han sido medidos, publicados y comparados por organizaciones de investigación independientes durante más de una década. Todo líder de adquisiciones tiene acceso a estos datos. Las herramientas de automatización que podrían reducir estos costos existen. Y sin embargo, la brecha entre "conocer el número" y "cambiar el número" persiste en la mayoría de las empresas medianas de manufactura y distribución. La pregunta que vale la pena hacer no es "cuánto cuesta" — es ¿por qué sigue costando tanto, año tras año, cuando la solución no es un misterio?
No es un solo problema. Es una pila de tres.
Pregúntele a un proveedor de software qué falla en el procesamiento manual de órdenes de compra y le dará una respuesta de una sola frase: la entrada de datos es lenta y propensa a errores. Esa respuesta es técnicamente cierta. También es inútil como diagnóstico. El problema real no es que los equipos de adquisiciones estén escribiendo cuando podrían estar haciendo clic. El problema real es una estructura de tres capas que hace que la escritura sea funcionalmente inevitable en las condiciones actuales de la industria.
Capa uno: fragmentación de formatos. Cada orden de compra de cada cliente está diseñada de manera diferente. Uno coloca el número de PO en la esquina superior derecha. Otro lo coloca en un bloque de encabezado a la izquierda. Un tercero lo incrusta en un código de barras en la página dos. La tabla de partidas — que puede tener 5, 50 o 300 filas de profundidad — podría tener seis columnas de ancho, o catorce. Los códigos de artículo podrían estar en la columna uno o en la columna cuatro. Las fechas de entrega podrían aparecer por partida o como un solo campo en el encabezado. Como dijo un usuario de Reddit en r/manufacturing: "El mayor problema para nosotros es que las órdenes de compra de los clientes no vienen en el mismo formato. Todos usan un formato de PO diferente, incluso hasta los nombres de los campos."
Esta no es una observación nueva. Todo profesional de adquisiciones lo sabe. Lo que se entiende menos es que la fragmentación de formatos no es un error — es el estado de equilibrio del sistema. El formato de PO de cada empresa es generado por su ERP, que fue configurado para coincidir con sus estructuras de datos internas, que evolucionaron a lo largo de años de decisiones específicas del negocio. Pedir a 80 clientes que estandaricen sus formatos de PO no es una solicitud de adquisiciones. Es pedir a 80 empresas que reconfiguran sus salidas de ERP — una tarea con cero retorno de inversión desde su perspectiva.
Capa dos: la desalineación de incentivos del proveedor. Si usted es un fabricante que recibe PO de clientes, tiene fuertes incentivos para automatizar la entrada de datos. Cada minuto ahorrado en escribir es un minuto devuelto a la planificación de producción, la gestión de inventario o la negociación con proveedores. Pero si usted es el cliente que envía el PO, tiene exactamente cero incentivos para cambiar su formato para facilitar la vida del proveedor. El PO sale de la misma manera que siempre — generado por su ERP, adjunto en PDF a un correo electrónico — y la carga de entrada de datos del proveedor es invisible para usted. Esta asimetría es fundamental. La parte que controla el formato no tiene incentivos para estandarizarlo, y la parte que necesita la estandarización no tiene influencia para exigirla.
Capa tres: desajuste de herramientas. El enfoque dominante para la extracción de datos de documentos durante las últimas dos décadas ha sido la extracción basada en plantillas: usted dibuja cuadros alrededor de los campos en un documento de muestra, los etiqueta, y la herramienta extrae datos de cualquier documento posterior que coincida con el mismo diseño. Esto funciona para facturas de un solo proveedor. Se colapsa para PO de 40 clientes diferentes. Cada cliente necesita una plantilla separada. Cada plantilla toma tiempo de construir. Y cuando un cliente actualiza su ERP o cambia su diseño de PO — lo que sucede durante migraciones de sistemas, adquisiciones o cambios de marca — la plantilla se rompe silenciosamente, produciendo datos confusos o nada en absoluto. El trabajo que usted intentaba eliminar (entrada manual de datos) ha sido reemplazado por un tipo diferente de trabajo manual (mantenimiento de plantillas).
Estas tres capas se refuerzan entre sí. La fragmentación de formatos es la realidad de base. Los incentivos de los proveedores impiden que se resuelva por sí sola. Las herramientas basadas en plantillas la convierten en un techo de escalabilidad: puede automatizar la entrada de datos de órdenes de compra para cinco clientes, pero no para cincuenta. El resultado es un panorama de adquisiciones donde el 57% de los líderes de adquisiciones aún dependen de la entrada manual de datos para las órdenes de compra, no porque no hayan oído hablar de la automatización, sino porque la automatización que probaron no pudo manejar la diversidad de formatos de su base real de proveedores.
EDI Resolvió Esto para las Empresas Más Grandes del Mundo. Para Todos los Demás, Creó un Techo.
Si ha estado en adquisiciones por más de unos pocos años, ha escuchado el discurso de EDI. EDI 850 — el estándar ANSI X12 para órdenes de compra electrónicas — define un formato estructurado para el intercambio de PO de máquina a máquina. Cuando ambas partes usan EDI, las órdenes de compra fluyen del ERP del comprador directamente al sistema de gestión de pedidos del proveedor con cero intervención humana. Sin PDF. Sin escritura. Sin variación de formato, porque ambos lados se ajustan al mismo conjunto de transacciones.
Funciona maravillosamente — para las relaciones donde está implementado. Los grandes fabricantes de automóviles, los minoristas de gran superficie y los contratistas principales aeroespaciales han estado usando EDI con sus proveedores de primer nivel durante décadas. La cadena de suministro de Walmart colapsaría sin él.
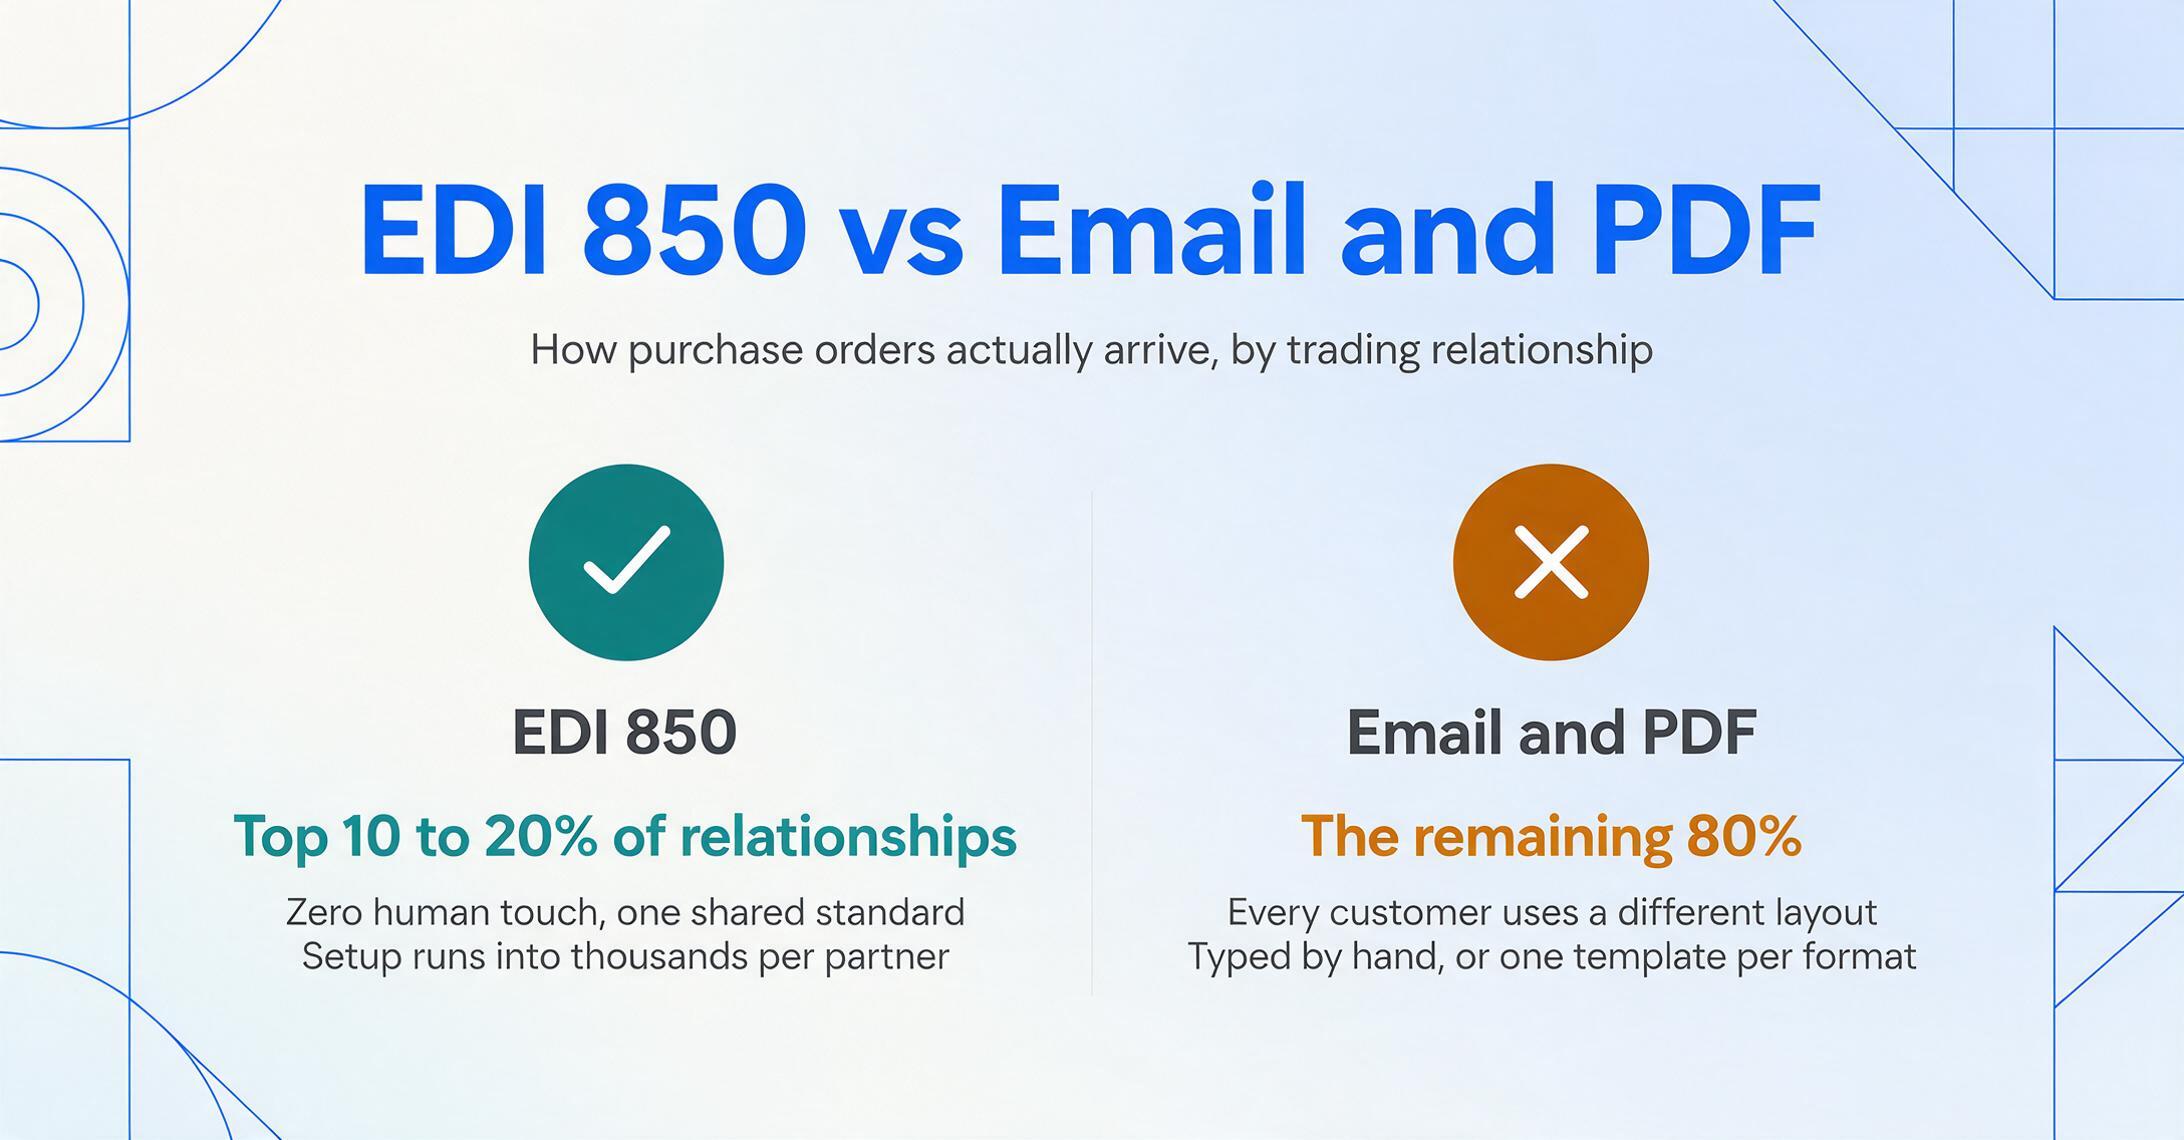
El problema es que la curva de adopción de EDI tiene un techo duro. Implementar EDI requiere infraestructura técnica en ambos extremos: software de traducción EDI, protocolos de comunicación (AS2, VAN) y lógica de mapeo para traducir entre los segmentos EDI 850 (BEG, N1, PO1, PID, CTT) y las estructuras de datos internas de cada parte. El costo de configuración asciende a miles de dólares por socio comercial. Para relaciones de alto volumen — un fabricante que realiza pedidos semanales por valor de millones — el ROI se cierra instantáneamente. Para la larga cola de clientes que piden trimestral o esporádicamente — que describe a la mayoría de las relaciones B2B de mercado medio — nunca se cierra.
El resultado es una realidad de adquisiciones de dos niveles. El 10–20% superior de las relaciones comerciales funciona con EDI. El 80% restante funciona con correo electrónico y PDF. El segundo grupo es donde vive la entrada manual de datos — y donde continuará viviendo mientras las opciones de automatización requieran una estandarización de formatos que estas relaciones no pueden soportar económicamente.
CAPS Research encontró que el 31% de los líderes de la cadena de suministro dicen que el software de adquisiciones obsoleto bloquea la ejecución, y el 37% cita problemas de acceso a datos como una barrera principal. Estos números no describen empresas que desconocen la automatización. Describen empresas que la han evaluado y han encontrado que la economía no funciona para la mayoría de su cartera de proveedores.
La trampa de las plantillas: automatización que crea nuevo trabajo manual
En teoría, la extracción basada en plantillas es un enfoque razonable. Le muestra a la herramienta un documento de muestra, marca dónde se encuentra cada campo, y la herramienta replica ese patrón de extracción en documentos futuros. Así es como la mayoría de las herramientas de automatización de documentos — desde plataformas IDP empresariales hasta productos SaaS más ligeros — han funcionado desde los primeros días del OCR.
En la práctica, la extracción basada en plantillas tiene una propiedad de escalamiento fatal: el número de plantillas que necesita escala linealmente con el número de formatos de documentos distintos que recibe. Si tiene 40 clientes y cada uno usa un diseño de orden de compra diferente, necesita 40 plantillas. Cada nuevo cliente requiere una sesión de configuración de plantilla nueva — típicamente de 10 a 15 minutos para identificar campos, dibujar regiones y verificar la precisión de la extracción. Cuando llega el cliente #41, alguien tiene que detener lo que está haciendo y crear la plantilla #41.
Esto crea una inversión de la promesa de automatización. Se suponía que la herramienta eliminaría el trabajo manual repetitivo. En cambio, ha creado una nueva clase de trabajo manual repetitivo — el mantenimiento de plantillas — que es menos visible pero igualmente consume tiempo. Y a diferencia de la entrada de datos, las fallas de plantilla son silenciosas. Cuando un cliente cambia silenciosamente su formato de orden de compra (nuevo ERP, nueva marca, consolidación de formatos por fusión), la plantilla no arroja un error. Extrae datos incorrectos, o datos faltantes, que descubre más adelante — cuando el pedido está mal, el envío está mal dirigido, o la factura no coincide.
La estructura de costos es insidiosa. Un error manual de entrada de datos — una cantidad mal escrita o un número de pieza transpuesto — generalmente se detecta dentro del mismo flujo de trabajo, por la misma persona, o por validación posterior. Una falla de plantilla produce errores sistemáticos: cada orden de compra del Cliente X ahora carece del campo de fecha de entrega, y nadie lo sabe hasta que el almacén llama preguntando a dónde enviar. El costo del error por incidente es mayor, y la latencia de detección es más larga.
Para un fabricante mediano que procesa órdenes de compra de 20 a 80 clientes diferentes en múltiples ecosistemas ERP — SAP, NetSuite, Microsoft Dynamics, Epicor, Sage, Infor — el enfoque de plantillas no reduce el trabajo. Lo reubica del escritorio de entrada de datos a la pantalla de configuración de plantillas. Y para los equipos de adquisiciones que no tienen ingenieros de automatización dedicados, esa reubicación empeora el problema, no lo mejora.
Qué Hacen Realmente los Equipos de Adquisiciones Todos los Días
Detrás de los puntos de referencia de costos y el análisis estructural, hay un flujo de trabajo real que se repite miles de veces al día en los departamentos de adquisiciones de manufactura. Vale la pena describirlo claramente — no como una escena inventada, sino como un compuesto de lo que los profesionales de adquisiciones describen en Reddit y en foros de la industria.
La bandeja de entrada tiene nuevos mensajes de clientes. Cada uno es un adjunto de orden de compra, generalmente un PDF. Algunos llegan a través de un portal del cliente; la mayoría llegan por correo electrónico. El coordinador de adquisiciones abre el primero. Es de un cliente que usa NetSuite — el número de PO está en el encabezado, el código de proveedor está en un campo de referencia, los artículos de línea están en una tabla de 9 columnas. Abren su hoja de cálculo o ERP y comienzan a escribir: número de PO, fecha, nombre del cliente, dirección de envío. Luego los artículos de línea, una fila a la vez: código de artículo, descripción, cantidad, unidad de medida, precio unitario, precio extendido. Si el PO tiene 15 artículos de línea, son 90 puntos de datos individuales para transferir, manualmente, sin transponer un dígito ni omitir una fila.
El segundo PO es de un cliente que usa SAP. El diseño es completamente diferente. El número de PO está en la esquina superior derecha. El nombre del cliente está en una posición diferente. La tabla de artículos de línea tiene 12 columnas en lugar de 9, con campos adicionales para la ubicación del almacén y la fecha de entrega por línea. Los nombres de los campos son diferentes — SAP lo llama "Material" donde NetSuite dice "Código de Artículo".
El tercer PO es de un cliente sin ERP en absoluto — es un documento de Word convertido a PDF, con artículos de línea formateados como una lista con viñetas en lugar de una tabla. Una herramienta de extracción basada en plantillas se atragantaría inmediatamente con esto. Una persona puede leerlo, pero la fricción cognitiva de cambiar entre tres estructuras de documento completamente diferentes varias veces por hora es la verdadera pérdida de productividad — no la velocidad de escritura.
Como lo describió un usuario de Reddit en r/procurement: "Literalmente estábamos tomando PDFs de proveedores, copiando valores en hojas de cálculo, verificando cada línea contra el PO, enviando correos a los proveedores sobre discrepancias, pegando todo en el ERP porque ninguno de estos sistemas se comunica entre sí. La mitad del trabajo es administración disfrazada de gestión de proveedores."
Lo que llama la atención de esta descripción no es la ineficiencia — es la precisión. Los sistemas genuinamente no se comunican entre sí. El PDF es un formato sin salida: preserva el diseño visual pero destruye la estructura de datos. El ERP en el extremo receptor espera una entrada estructurada y mapeada por campos. Entre esos dos formatos hay un ser humano, reconstruyendo manualmente la estructura de datos que se perdió cuando el PO salió del sistema del cliente. Ese ser humano no está agregando valor. Está realizando traducción de formato — una tarea que el software debería manejar, pero no puede, porque los formatos siguen cambiando.
La Inercia Organizacional que Normaliza la Entrada Manual
Si el costo de la entrada manual de datos de órdenes de compra es medible y las herramientas para reducirlo existen, ¿por qué el mercado no lo ha solucionado? La respuesta va más allá de la tecnología: está arraigada en el comportamiento organizacional y en los incentivos de los proveedores.
El costo es invisible para los tomadores de decisiones. La entrada manual de datos de PO no aparece como un gasto discreto. Son horas de tiempo de compradores y coordinadores distribuidas a lo largo de la semana laboral, clasificadas bajo "gastos operativos" en lugar de "mano de obra de entrada de datos". Ningún CFO aprueba una partida llamada "Procesamiento Manual de PO — $288,000". El costo es real, pero se absorbe en salarios que existirían de todos modos. Esta invisibilidad contable significa que no hay un dueño natural del presupuesto para la solución. TI no es dueño de la eficiencia de adquisiciones. Adquisiciones no es dueño de la evaluación de software. Finanzas no ve la partida. El problema cae en los vacíos entre departamentos.
Los fallos de automatización son más visibles que el trabajo manual tedioso. Cuando la entrada manual de datos produce un error, la solución es sencilla: encontrar el error, corregirlo, enviar una orden actualizada. Es molesto pero rutinario. Cuando una herramienta de automatización produce un error, el fallo es mayor, más visible y más difícil de diagnosticar. Un lote de 50 POs procesadas automáticamente con un mapeo de campos defectuoso puede crear 50 órdenes incorrectas: una crisis que llega al escritorio de un gerente. El profesional de adquisiciones que impulsó la automatización recibe la culpa. La lección que la mayoría de las organizaciones extrae de una mala experiencia de automatización es "nuestros documentos son demasiado complejos para que las herramientas los manejen" en lugar de "usamos el tipo incorrecto de herramienta para nuestra diversidad de formatos". Esta asimetría de riesgo — los fallos automatizados conllevan un costo organizacional mayor que los manuales — crea un fuerte sesgo hacia el statu quo.
Los proveedores de ERP tienen los incentivos equivocados. Las empresas mejor posicionadas para resolver la entrada de datos de PO — SAP, Oracle, Microsoft, NetSuite, Epicor — son las que tienen menos incentivos para hacerlo. Sus módulos de adquisiciones asumen entrada estructurada. Su movimiento de ventas se basa en la adopción de la suite completa, no en la extracción de soluciones puntuales. Cuando un cliente pregunta "¿cómo obtengo los datos de PO de mis clientes en su sistema?", la respuesta típica es "haga que sus clientes usen nuestro portal", o "configure EDI", o "ingréselo manualmente". Las tres respuestas aceptan el problema de formato como externo a la solución. El modelo de negocio del proveedor de ERP depende de que usted adopte su plataforma integral, no de resolver el paso de extracción que se encuentra en el límite entre su sistema y los sistemas de sus clientes.
El problema se ha normalizado a través de generaciones de profesionales de adquisiciones. Las personas que han estado en adquisiciones durante 15 años no recuerdan una época en la que la entrada de datos de PO no fuera manual. Han construido su flujo de trabajo en torno a ello. Tienen atajos de Excel, macros y modelos mentales que hacen tolerable la entrada manual. Sugerir automatización no suena como una mejora de eficiencia; suena como amenazar un sistema que, con todos sus defectos, ha estado enviando órdenes de manera confiable durante años. El costo operativo del cambio — aprender una nueva herramienta, confiar en su resultado, manejar los casos límite cuando falla — parece mayor que el costo operativo del statu quo, incluso cuando las matemáticas dicen lo contrario.
Ninguno de estos factores tiene que ver con la capacidad tecnológica. Se trata de estructuras de incentivos, percepción de riesgo y hábitos organizativos. Las herramientas para automatizar la entrada de datos de órdenes de compra existen. La razón por la que no se han adoptado ampliamente no es que no funcionen — es que las herramientas más disponibles (extracción basada en plantillas, módulos ERP de suite completa, EDI) imponen requisitos — estandarización de formatos, configuración por proveedor, sobrecarga de integración — que hacen que su costo de adopción supere su ROI para la mayoría de las relaciones de adquisición.
Qué Cambiaría Realmente la Ecuación
Si el problema raíz es la fragmentación de formatos — documentos que contienen la misma información lógica (número de PO, partidas, cantidades, precios) dispuestos en diseños físicos ilimitados — entonces la solución no puede ser una herramienta que requiera que usted contemple cada diseño individualmente. Tiene que ser una herramienta a la que no le importe cuál es el diseño.
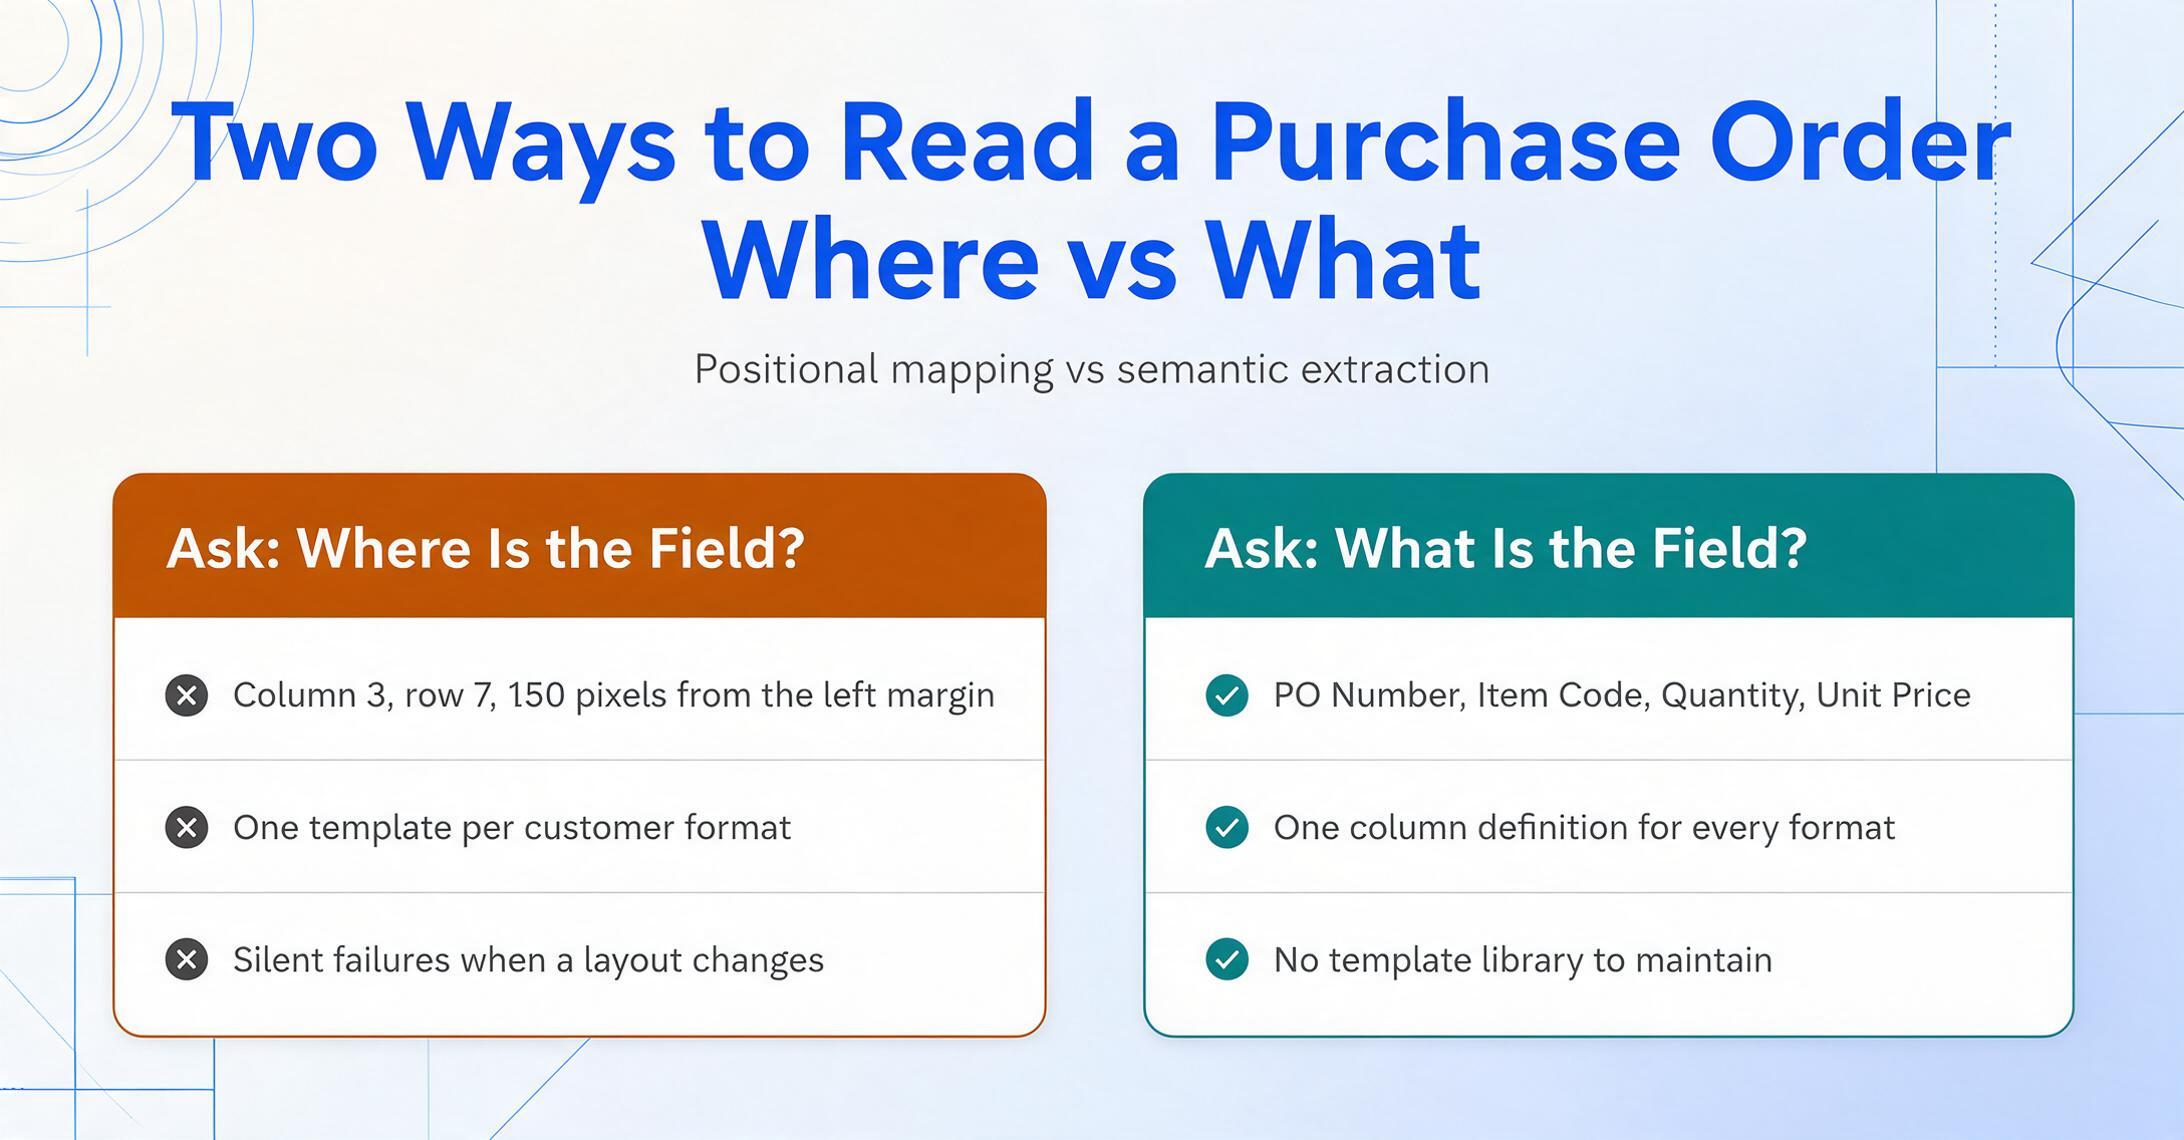
Esta es la diferencia entre la extracción basada en plantillas y la extracción basada en el significado. Una plantilla pregunta: ¿dónde está el campo? Columna 3, fila 7, 150 píxeles desde el margen izquierdo. Un enfoque basado en el significado pregunta: ¿qué es el campo? Busca texto que coincida con el rol semántico de "Número de PO" — un identificador único cerca de la parte superior del documento, típicamente alfanumérico, a menudo etiquetado con una variación de "PO #" u "Número de Orden" o "No. de Orden de Compra" — y extrae el valor sin importar dónde se encuentre en la página.
Esto es lo que hace la extracción por nombre de columna: usted define las columnas que desea — "Número de PO," "Nombre del Proveedor," "Código de Artículo," "Cantidad," "Precio Unitario," "Total de Línea" — y la IA localiza cada valor comprendiendo lo que significa, no dónde se encuentra. Los nombres de columna que usted ingresa se convierten en los encabezados de la tabla de salida. Una definición de columna funciona en todos los formatos de PO de cada cliente, porque la lógica de extracción es semántica, no posicional.
Las implicaciones estructurales son significativas:
- Operación sin plantilla. Sin configuración por cliente. Sin biblioteca de plantillas que mantener. Sin fallos silenciosos cuando un cliente cambia su diseño de PO. La extracción se adapta automáticamente a la estructura de cada documento.
- Manejo de partidas. La carga principal de una orden de compra es su tabla de partidas, que puede abarcar docenas de filas con configuraciones de columnas variables. La extracción por nombre de columna lee cada fila como un registro completo, asignando la cantidad, descripción y precio correctos a cada línea — incluyendo tablas divididas en varias páginas.
- Entradas de múltiples formatos. La misma definición de columna funciona en PDF, documentos escaneados e incluso capturas de pantalla de correos electrónicos. La lógica de extracción no distingue entre un PO generado por SAP y uno escrito en un documento de Word — lee el contenido, no el formato.
Para un análisis más detallado de cómo funciona esto en la práctica, incluida una guía campo por campo para la extracción de órdenes de compra, consulte nuestro artículo sobre extracción de campos específicos de órdenes de compra a Excel sin plantillas. Para el procesamiento por lotes (ejecutar la misma definición de columna en PO de docenas de clientes diferentes en una sola operación), consulte nuestra guía sobre procesamiento por lotes de órdenes de compra de cualquier formato de proveedor en una sola hoja de cálculo. Y para el flujo de trabajo de automatización de extremo a extremo, incluida la forma de conectar la salida de extracción a su sistema de gestión de pedidos existente, consulte nuestro artículo sobre automatización del ingreso de datos de órdenes de compra sin un ERP.
Los archivos se procesan de forma segura y no se almacenan.
Preguntas Frecuentes
¿Por qué no podemos simplemente exigir a todos nuestros clientes que usen nuestro formato de orden de compra?
Puede intentarlo — y las grandes empresas con un poder de compra significativo a veces lo logran con sus proveedores más importantes. Pero para la mayoría de las empresas de mercado medio, el poder fluye en la otra dirección: usted necesita el negocio de sus clientes más de lo que ellos necesitan estandarizar su formato de PO. Incluso si un cliente acepta, implementar el cambio significa que su equipo de TI reconfigura una salida de ERP, la prueba y la despliega — un proyecto con costo real y cero beneficio directo para ellos. La mayoría de los equipos de adquisiciones descubren que el esfuerzo requerido para imponer la estandarización del formato supera el esfuerzo de lidiar con la diversidad de formatos.
¿Mi ERP no maneja ya la entrada de datos de PO?
La mayoría de los módulos de adquisiciones de ERP manejan la creación de PO — generando órdenes de compra para sus proveedores — pero son mucho más débiles en la recepción de PO — ingiriendo órdenes de compra de sus clientes. Los ERP esperan entrada estructurada (EDI, importaciones CSV o entrada directa de datos) y no proporcionan ningún mecanismo integrado para extraer datos estructurados de PDF no estructurados. Si sus clientes le envían PO como archivos adjuntos PDF, su ERP puede almacenarlos como adjuntos pero no puede leerlos sin herramientas de extracción adicionales o entrada manual.
¿Qué tan precisa es la extracción basada en IA para órdenes de compra con tablas complejas de partidas?
Los datos de tablas impresas pueden reconocerse con hasta un 99% de precisión usando modelos de IA visual. Los casos más difíciles no son las tablas largas — la IA maneja bien la estructura repetitiva — sino documentos donde las partidas se formatean como texto narrativo en lugar de filas (común en PO basadas en servicios), o donde se han añadido anotaciones manuscritas a tablas impresas. Para estos casos límite, la extracción debe tratarse como un primer paso que reduce el trabajo manual en un 80–90% en lugar de eliminarlo por completo. Los resultados siempre deben revisarse antes de comprometerse a un ERP o sistema de gestión de pedidos.
¿Qué pasa si mis clientes envían PO con cambios o anotaciones manuscritas?
La extracción de nombres de columnas puede manejar escritura a mano, incluidas anotaciones en documentos impresos. La IA lee el texto manuscrito como parte del contenido del documento y lo asigna a los campos apropiados según el significado. La precisión para la escritura a mano es menor que para el texto impreso — particularmente para cursiva o anotaciones en lápiz claro — por lo que los PO manuscritos deben revisarse con más cuidado que los impresos limpios.
¿Es esto solo otra suscripción de software además del ERP que ya pagamos?
Aborda una brecha específica que la mayoría de los ERP no cubren: el paso de extracción entre recibir una orden de compra en PDF y tener datos estructurados con los que trabajar. Si actualmente está pagando por ese paso con el tiempo de compradores y coordinadores — y los puntos de referencia de costos sugieren que la mayoría de los fabricantes de mercado medio lo hacen, a $95–$145 por orden de compra — la comparación no es "software vs. sin software". Es "software vs. costo laboral". Para un fabricante que procesa 200 órdenes de compra al mes, incluso una estimación conservadora sitúa el costo anual de procesamiento manual por encima de $200,000. La pregunta relevante es si una herramienta de extracción reduce esa cifra más de lo que cuesta — un cálculo que depende del volumen y la complejidad de sus órdenes de compra, no de si la herramienta encaja en la categoría presupuestaria de su ERP existente.
Dónde Vive Realmente el Problema
El problema de la entrada de datos de órdenes de compra ha sobrevivido décadas de tecnología de automatización por una razón. No es que los equipos de adquisiciones sean tecnofóbicos o estén desinformados. Es que la estructura del problema — variación infinita de formatos, incentivos desalineados entre compradores y proveedores, un panorama de herramientas dominado por enfoques basados en plantillas que no pueden escalar entre formatos diversos — hace que la solución obvia (comprar software de automatización) sea ineficaz para la mayoría de las relaciones de adquisición.
EDI 850 lo resolvió para las asociaciones de alto volumen que pueden justificar el costo de configuración. La extracción basada en plantillas lo resolvió para los casos donde la estabilidad del formato está garantizada. Pero entre esas dos soluciones hay una brecha que contiene la mayoría de las adquisiciones del mundo real: docenas de clientes, cada uno con su propio formato de orden de compra, ninguno de los cuales estandarizará jamás para su beneficio. Esa brecha es donde vive la entrada manual de datos, y seguirá viviendo allí hasta que los equipos de adquisiciones adopten herramientas que no necesiten estandarización de formatos para funcionar.
El cambio de la extracción basada en plantillas a la extracción basada en el significado — de preguntar "dónde está el campo" a preguntar "qué es el campo" — cambia la economía del problema en su raíz estructural. Cuando la precisión de la extracción depende de la comprensión semántica en lugar del mapeo posicional, la diversidad de formatos deja de ser una barrera y comienza a ser irrelevante. El costo de la automatización baja de "una plantilla por proveedor" a "una definición de columna para todos los proveedores". La barrera de adopción no es la capacidad técnica — es reconocer que la generación anterior de herramientas de automatización fue diseñada para un mundo donde los formatos de documentos eran estables, y la realidad de las adquisiciones es lo contrario.
Vea cómo la extracción por nombres de columna maneja sus órdenes de compra reales — en todos los formatos de clientes, sin plantillas.
Pruébelo Ahora →