Das Problem der Bestelldatenerfassung
— und was es aufrechterhält
Die Open Standards Benchmarking-Daten von APQC zeigen, dass Unternehmen zwischen 14 und über 54 US-Dollar für die Verarbeitung einer einzigen Bestellung ausgeben. Für einen mittelständischen Hersteller mit 5.000 Bestellungen pro Jahr macht der Unterschied zwischen Spitzen- und Schlusslichtern eine Differenz von 70.000 bis 270.000 US-Dollar an jährlichen Verarbeitungskosten aus. CAPS Research beziffert den branchenübergreifenden Durchschnitt in ihrer jüngsten Umfrage sogar noch höher, auf 527 US-Dollar pro Bestellung. Die Daten sind seit Jahren verfügbar. EDI 850 — der ANSI-X12-Standard für elektronische Bestellungen — existiert seit Jahrzehnten. Und dennoch werden laut einer Branchenumfrage von AutoQuotes 75 % der Bestellungen weiterhin per E-Mail oder Fax versendet und landen in Postfächern, wo jemand den Anhang öffnet und mit dem Abtippen beginnt. Dies ist keine Technologielücke. Es ist ein strukturelles Problem, das die meisten Automatisierungswerkzeuge nie dafür ausgelegt waren, zu lösen.
Wichtigste Erkenntnisse
- Zweihundert Bestellungen pro Monat zu je 120 US-Dollar verursachen 288.000 US-Dollar pro Jahr an manueller Dateneingabe — Kosten, die so vollständig in den Gehältern der Einkäufer aufgehen, dass noch nie ein CFO eine Position namens „Manuelle Bestellverarbeitung“ genehmigt hat.
- Vorlagenbasierte Extraktionstools haben die manuelle Bestellarbeit nicht beseitigt — sie haben sie vom Abtippen von Zahlen hin zum Erstellen und Pflegen von vierzig separaten Vorlagen verlagert, wobei Fehler still auftreten und erst entdeckt werden, nachdem Bestellungen falsch versendet wurden.
- Eine Extraktion, die ein Bestellfeld danach liest, was es bedeutet, statt wo es steht, funktioniert identisch über jedes Bestellformat jedes Kunden hinweg — eine Spaltendefinition deckt alle ab, ohne Vorlagen, die erstellt werden oder brechen könnten.
Das 217-Dollar-Problem, über das niemand spricht
Fragen Sie einen Einkaufsleiter, was die Bearbeitung einer Bestellung kostet, und Sie ernten meist einen ratlosen Blick. Nicht, weil Kosten ihnen egal wären – das sind sie nicht. Sondern weil die Kosten der manuellen Bestelldatenerfassung so gleichmäßig über den täglichen Betrieb verteilt sind, dass sie im Hintergrund verschwinden. Sie tauchen in keinem Budget als eigener Posten auf. Es ist einfach „das, was wir tun“.
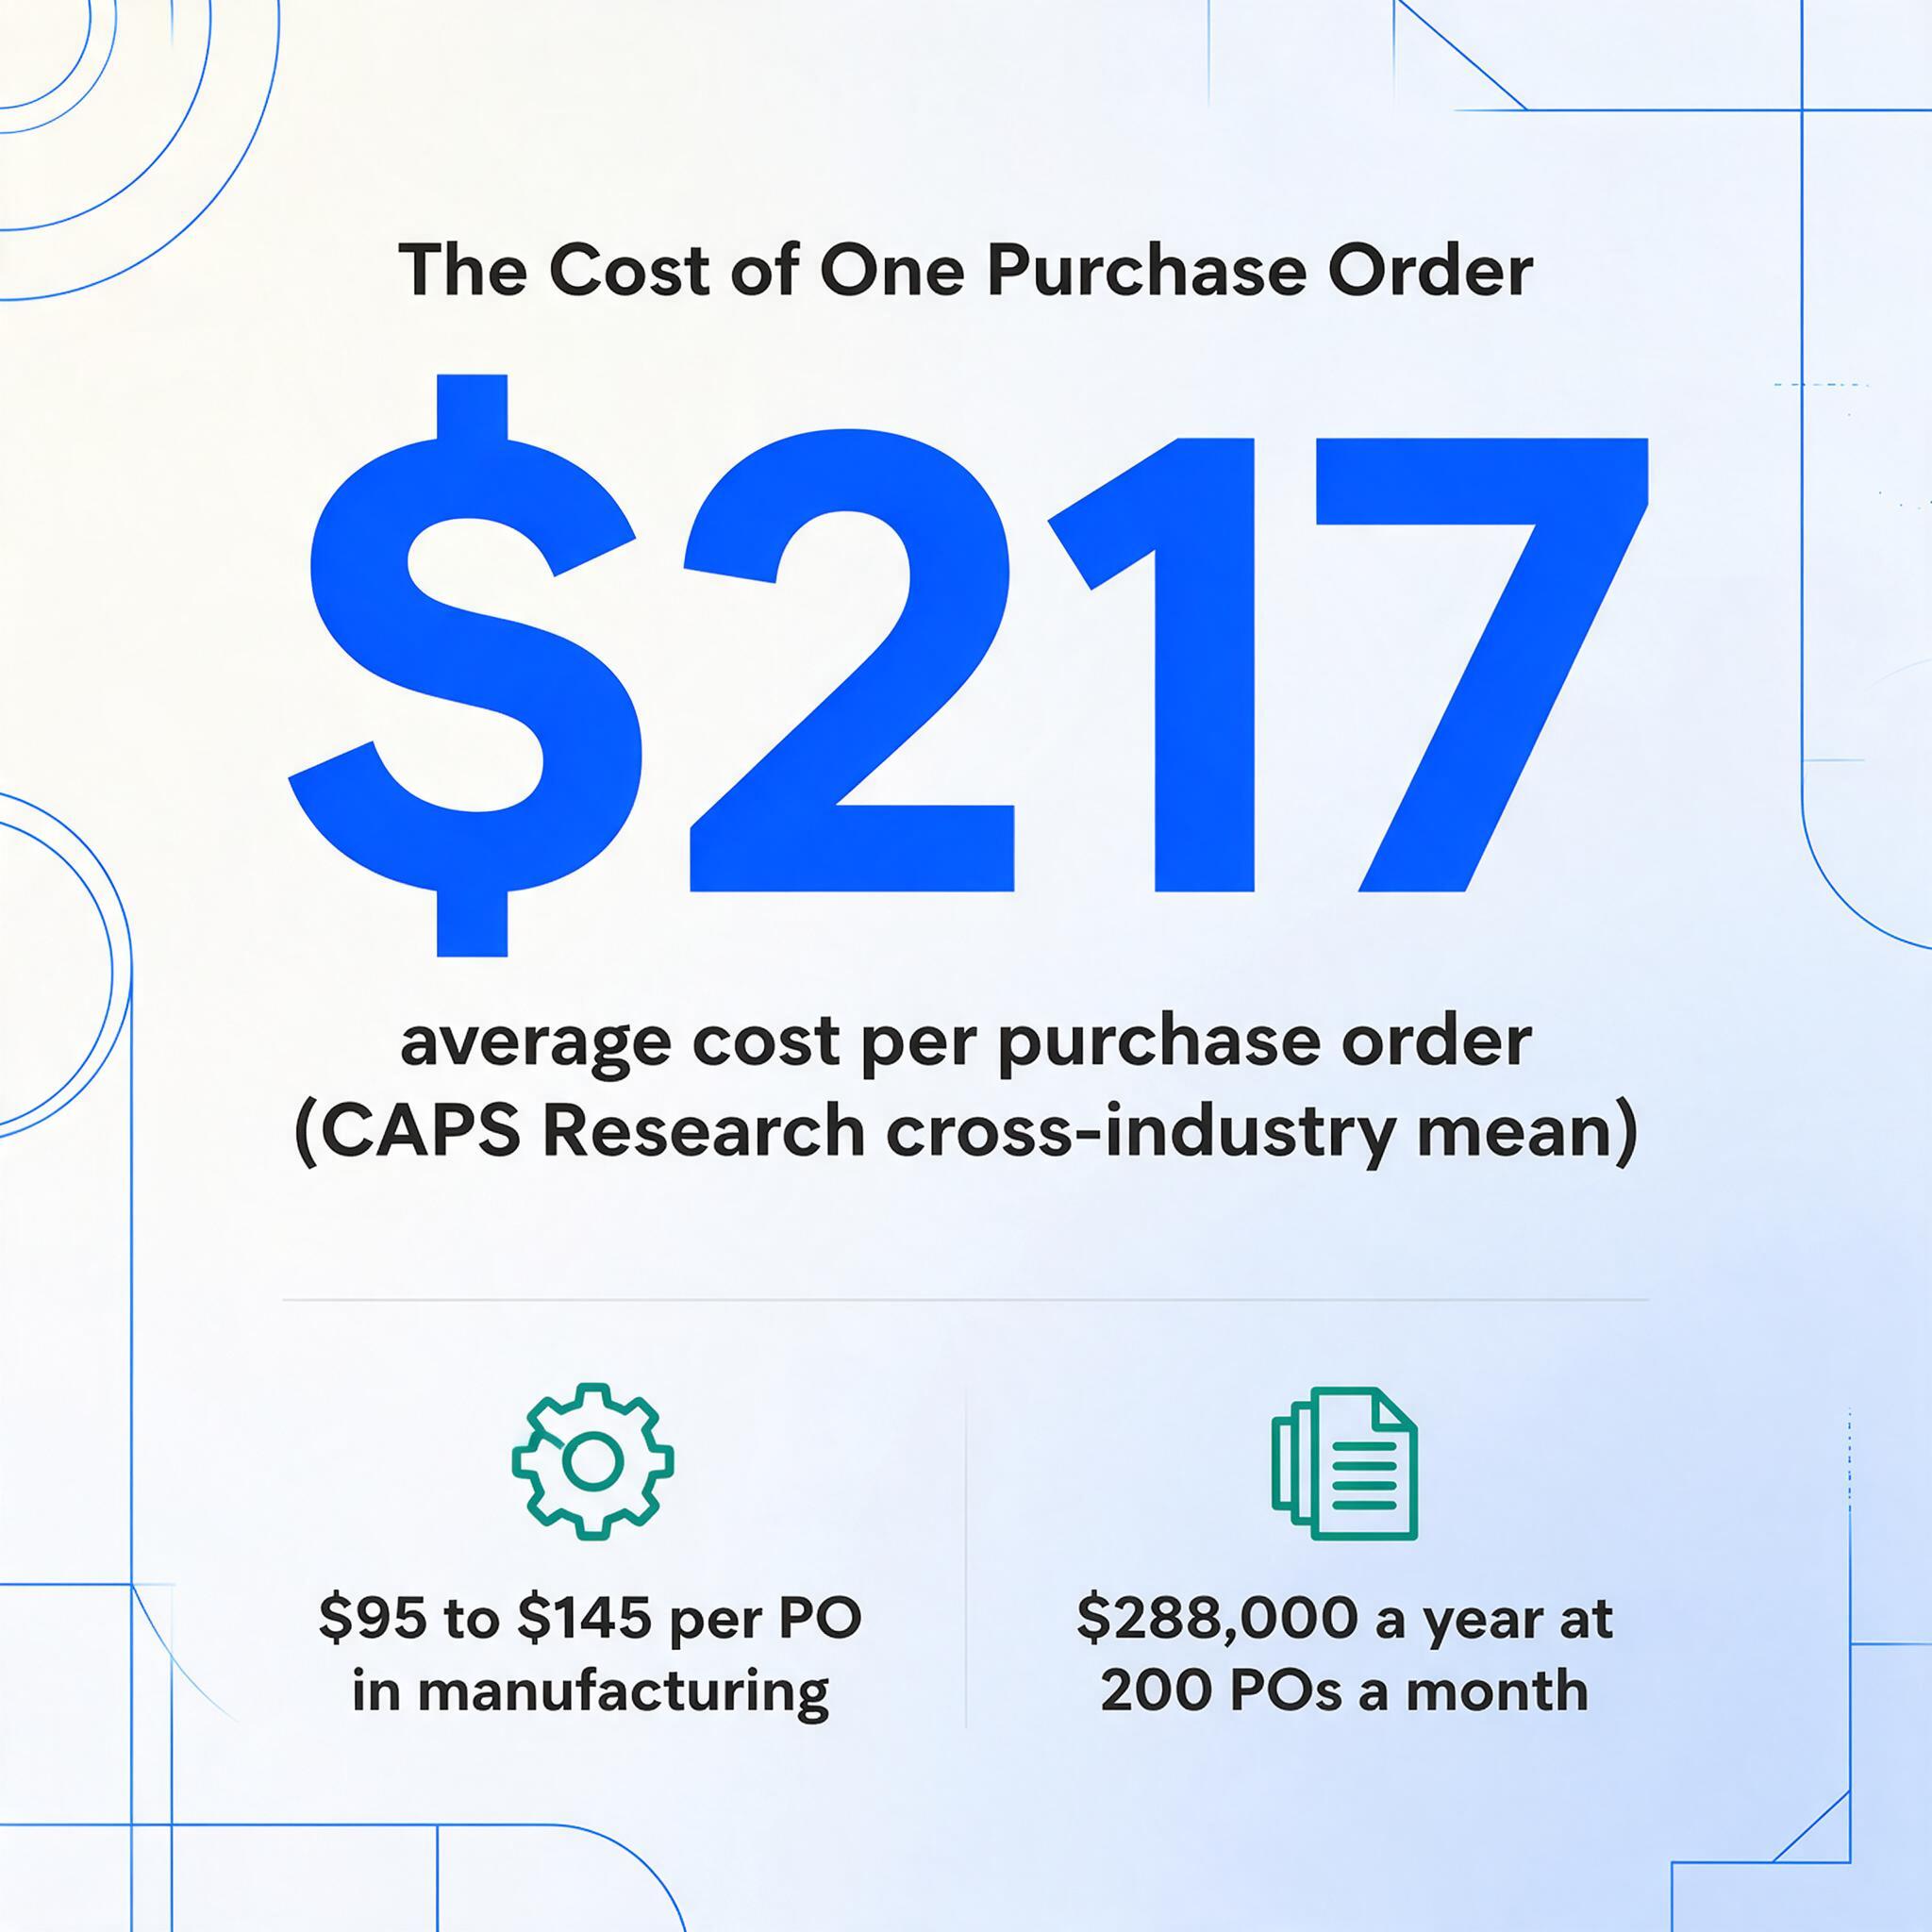
Das Center for Advanced Procurement Strategy (CAPS Research) misst die Bearbeitungskosten von Bestellungen seit Jahren. Die branchenübergreifenden Daten zeigen durchschnittliche Kosten pro Bestellung von grob $50 bis über $1.000, je nach Branche, mit einem Mittelwert von etwa $217. Schätzungen speziell für die Fertigung aus mehreren Quellen konvergieren bei $95–$145 pro Bestellung. Diese Zahl umfasst nicht nur die sichtbare Arbeit des Dateneintippens – sie umfasst E-Mail-Nachfassungen, Statusprüfungen, Fehlerkorrekturen, die Lösung doppelter Bestellungen und die Zeit, die für den Abgleich von Unstimmigkeiten zwischen dem, was die Bestellung aussagt, und dem, was der Lieferant tatsächlich geliefert hat, aufgewendet wird.
Ein Unternehmen, das 200 Bestellungen pro Monat zu je $120 verarbeitet, gibt $288.000 pro Jahr allein für die administrativen Kosten aus, um Bestelldaten von einem Dokument ins andere zu übertragen. Und das ist der Durchschnittsfall. Am oberen Ende – komplexe Fertigungsbestellungen mit 50 Positionen umfassenden Tabellen und mehrstufigen Genehmigungen – können die Kosten $500 pro Bestellung übersteigen.
Die Zahl selbst ist nicht der Punkt. Der Punkt ist, dass diese Kosten seit über einem Jahrzehnt von unabhängigen Forschungsorganisationen gemessen, veröffentlicht und als Benchmarks festgelegt wurden. Jeder Einkaufsleiter hat Zugang zu diesen Daten. Die Automatisierungswerkzeuge, die diese Kosten senken könnten, existieren. Und doch klafft die Lücke zwischen „die Zahl kennen“ und „die Zahl ändern“ bei der Mehrheit der mittelständischen Fertigungs- und Vertriebsunternehmen weiterhin. Die Frage, die sich lohnt, ist nicht „wie viel kostet es“ – sondern warum kostet es Jahr für Jahr weiterhin so viel, wenn die Lösung kein Geheimnis ist?
Es ist nicht ein Problem. Es ist ein Stapel aus dreien.
Fragen Sie einen Softwareanbieter, was mit der manuellen Bestellverarbeitung nicht stimmt, und Sie erhalten eine Ein-Satz-Antwort: Die Dateneingabe ist langsam und fehleranfällig. Diese Antwort ist technisch gesehen richtig. Als Diagnose ist sie jedoch nutzlos. Das eigentliche Problem ist nicht, dass Einkaufsteams tippen, wenn sie klicken könnten. Das eigentliche Problem ist eine dreischichtige Struktur, die das Tippen unter den aktuellen Branchenbedingungen praktisch unvermeidbar macht.
Schicht eins: Formatfragmentierung. Jede Kundenbestellung ist anders aufgebaut. Der eine platziert die PO-Nummer in der oberen rechten Ecke. Ein anderer setzt sie in einen Kopfblock auf der linken Seite. Ein dritter bettet sie in einen Barcode auf Seite zwei ein. Die Positionstabelle – die 5, 50 oder 300 Zeilen tief sein kann – könnte sechs Spalten breit sein oder vierzehn. Artikelschlüssel könnten in Spalte eins oder Spalte vier stehen. Liefertermine könnten pro Position oder als einzelnes Feld im Kopf erscheinen. Wie ein Reddit-Nutzer in r/manufacturing es ausdrückte: „Das größte Problem für uns ist, dass Kundenbestellungen nicht im gleichen Format eingehen. Jeder verwendet ein anderes PO-Format, bis hin zu den Feldnamen."
Das ist keine neue Beobachtung. Jeder Einkaufsprofi weiß das. Weniger verstanden ist, dass Formatfragmentierung kein Fehler ist – sie ist der Gleichgewichtszustand des Systems. Das PO-Format jedes Unternehmens wird von seinem ERP generiert, das so konfiguriert wurde, dass es zu den internen Datenstrukturen passt, die sich über Jahre geschäftsspezifischer Entscheidungen entwickelt haben. 80 Kunden zu bitten, ihre PO-Formate zu standardisieren, ist keine Beschaffungsanfrage. Es bedeutet, 80 Unternehmen zu bitten, ihre ERP-Ausgaben neu zu konfigurieren – eine Aufgabe ohne ROI aus ihrer Sicht.
Schicht zwei: die Fehlausrichtung der Lieferantenanreize. Wenn Sie ein Hersteller sind, der Bestellungen von Kunden erhält, haben Sie starke Anreize, die Dateneingabe zu automatisieren. Jede gesparte Minute beim Tippen ist eine Minute, die in die Produktionsplanung, Bestandsverwaltung oder Lieferantenverhandlung zurückfließt. Aber wenn Sie der Kunde sind, der die Bestellung sendet, haben Sie keinerlei Anreiz, Ihr Format zu ändern, um dem Lieferanten das Leben zu erleichtern. Die Bestellung geht so raus, wie sie immer rausging – von Ihrem ERP generiert, als PDF an eine E-Mail angehängt – und die Dateneingabelast des Lieferanten ist für Sie unsichtbar. Diese Asymmetrie ist grundlegend. Die Partei, die das Format kontrolliert, hat keinen Anreiz, es zu standardisieren, und die Partei, die Standardisierung benötigt, hat keine Hebel, um sie zu fordern.
Schicht drei: Werkzeug-Diskrepanz. Der dominante Ansatz zur Dokumentdatenextraktion in den letzten zwei Jahrzehnten war vorlagenbasiert: Sie zeichnen Kästchen um Felder auf einem Beispieldokument, beschriften sie, und das Werkzeug extrahiert Daten aus jedem nachfolgenden Dokument, das dem gleichen Layout entspricht. Das funktioniert für Rechnungen eines einzelnen Anbieters. Es scheitert bei Bestellungen von 40 verschiedenen Kunden. Jeder Kunde benötigt eine separate Vorlage. Jede Vorlage braucht Zeit zum Erstellen. Und wenn ein Kunde sein ERP aufrüstet oder sein PO-Layout ändert – was bei Systemmigrationen, Übernahmen oder Umbenennungen passiert – bricht die Vorlage stillschweigend zusammen und produziert entweder verstümmelte Daten oder gar nichts. Die Arbeit, die Sie eliminieren wollten (manuelle Dateneingabe), wurde durch eine andere Art manueller Arbeit ersetzt (Vorlagenwartung).
Diese drei Ebenen verstärken sich gegenseitig. Die Formatfragmentierung ist die grundlegende Realität. Lieferantenanreize verhindern, dass sie sich von selbst auflöst. Vorlagenbasierte Tools machen daraus eine Skalierungsgrenze – Sie können die Dateneingabe von Bestellungen für fünf Kunden automatisieren, aber nicht für fünfzig. Das Ergebnis ist eine Beschaffungslandschaft, in der 57 % der Beschaffungsleiter immer noch auf manuelle Dateneingabe für Bestellungen angewiesen sind, nicht weil sie nichts von Automatisierung gehört haben, sondern weil die Automatisierung, die sie ausprobiert haben, die Formatvielfalt ihrer tatsächlichen Lieferantenbasis nicht bewältigen konnte.
EDI hat das für die größten Unternehmen der Welt gelöst. Für alle anderen hat es eine Obergrenze geschaffen.
Wenn Sie seit mehr als ein paar Jahren im Einkauf tätig sind, haben Sie das EDI-Angebot gehört. EDI 850 – der ANSI-X12-Standard für elektronische Bestellungen – definiert ein strukturiertes Format für den maschinenbasierten PO-Austausch. Wenn beide Parteien EDI verwenden, fließen Bestellungen direkt vom ERP des Käufers in das Auftragsverwaltungssystem des Lieferanten, ohne menschliches Eingreifen. Keine PDFs. Kein Tippen. Keine Formatvariation, da beide Seiten denselben Transaktionssatz verwenden.
Es funktioniert wunderbar – für die Beziehungen, in denen es implementiert ist. Große Automobilhersteller, große Einzelhändler und Luft- und Raumfahrtunternehmen nutzen EDI seit Jahrzehnten mit ihren Tier-1-Lieferanten. Die Lieferkette von Walmart würde ohne EDI zusammenbrechen.
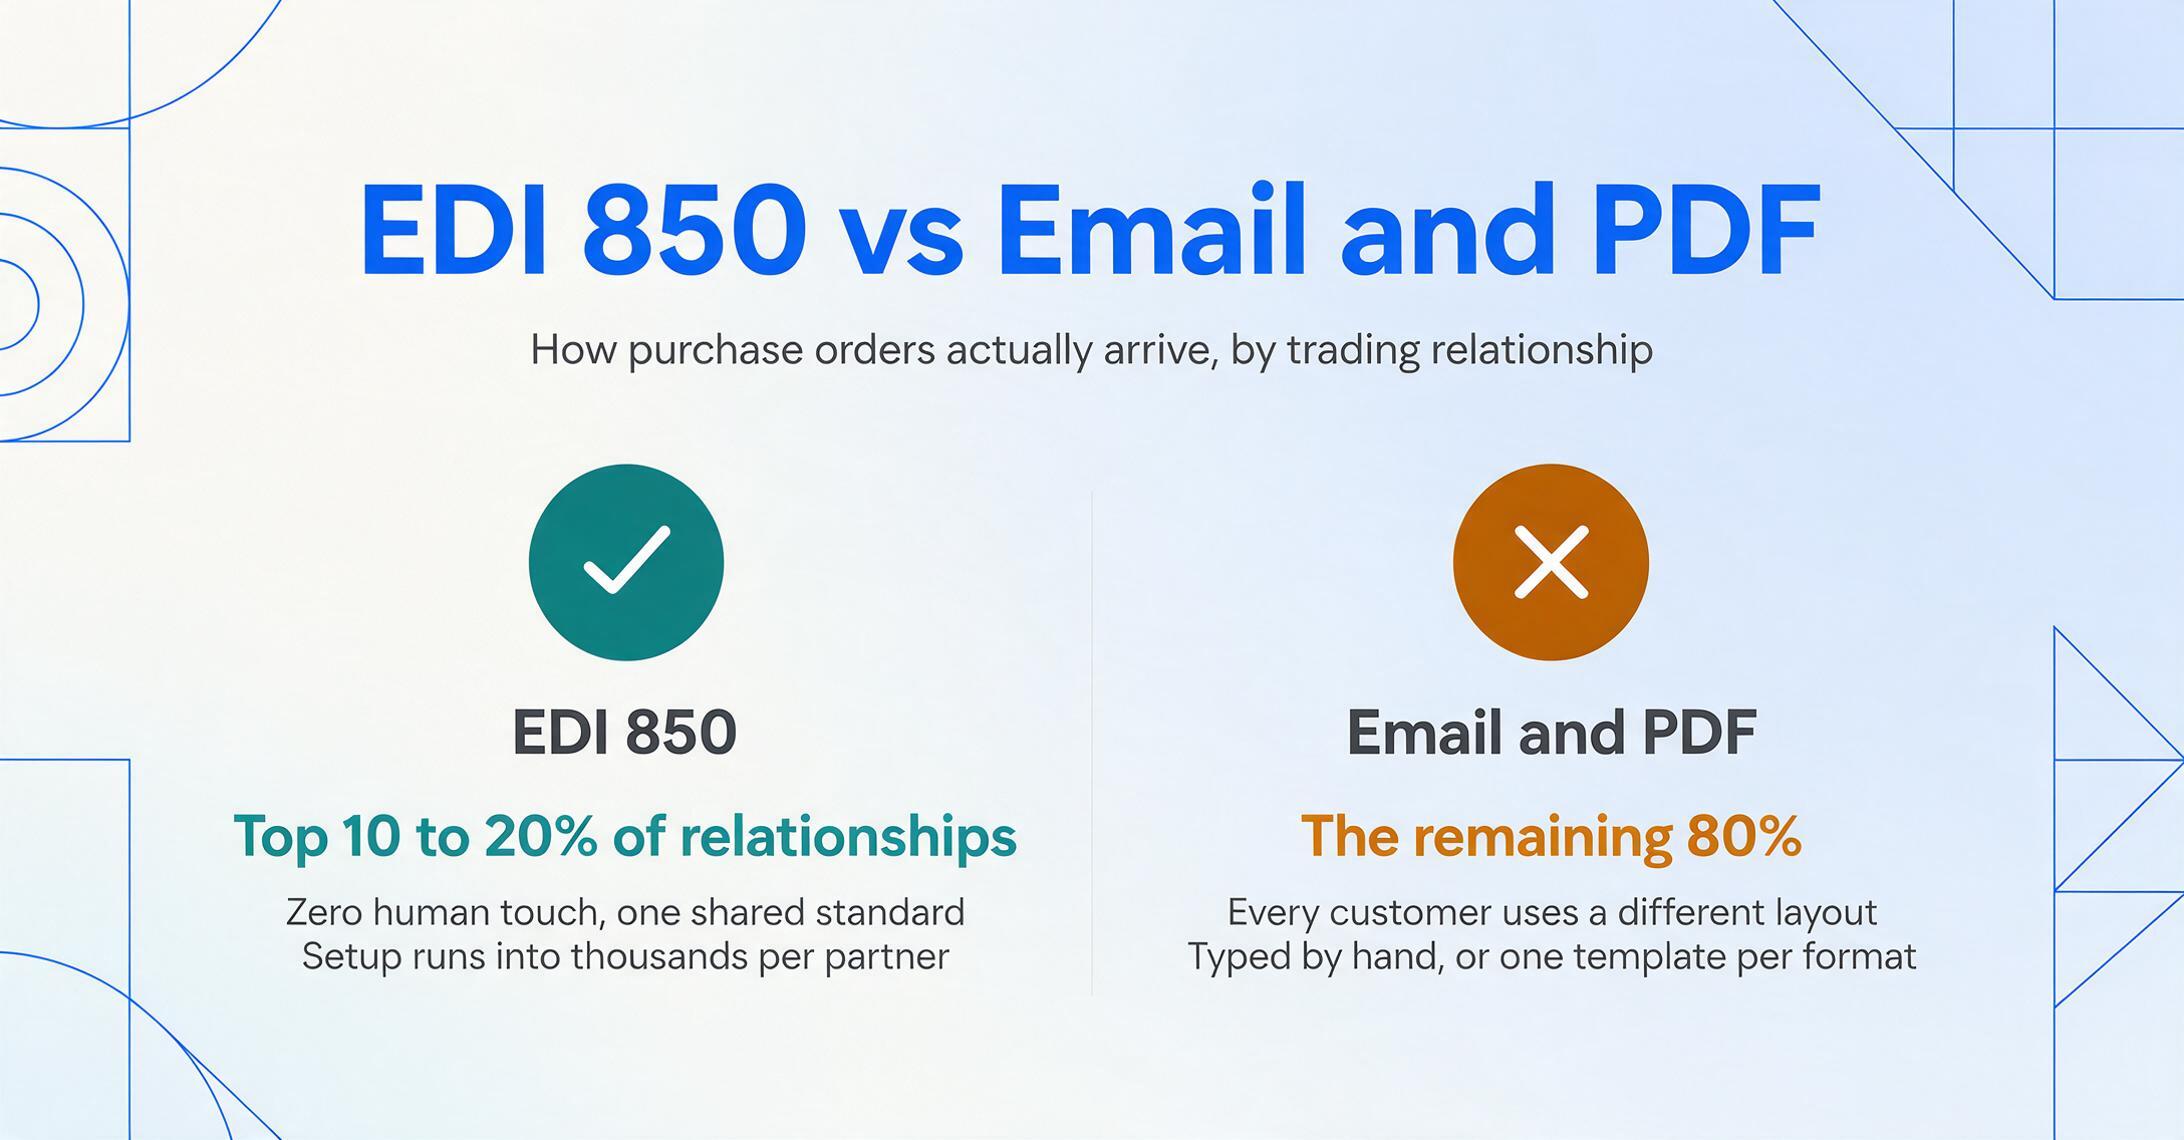
Das Problem ist, dass die Einführungskurve von EDI eine harte Obergrenze hat. Die Implementierung von EDI erfordert technische Infrastruktur auf beiden Seiten – EDI-Übersetzungssoftware, Kommunikationsprotokolle (AS2, VAN) und Mapping-Logik, um zwischen den EDI-850-Segmenten (BEG, N1, PO1, PID, CTT) und den internen Datenstrukturen jeder Partei zu übersetzen. Die Einrichtungskosten belaufen sich auf Tausende von Dollar pro Handelspartner. Für Beziehungen mit hohem Volumen – ein Hersteller, der wöchentlich Bestellungen im Wert von Millionen aufgibt – amortisiert sich der ROI sofort. Für den langen Schwanz von Kunden, die vierteljährlich oder sporadisch bestellen – was die meisten B2B-Beziehungen im mittleren Marktsegment beschreibt – schließt er sich nie.
Das Ergebnis ist eine zweistufige Beschaffungsrealität. Die obersten 10–20 % der Handelsbeziehungen laufen über EDI. Die restlichen 80 % laufen über E-Mail und PDF. In der zweiten Gruppe lebt die manuelle Dateneingabe – und dort wird sie auch weiterhin leben, solange die Automatisierungsoptionen eine Formatstandardisierung erfordern, die diese Beziehungen wirtschaftlich nicht unterstützen können.
CAPS Research hat herausgefunden, dass 31 % der Supply-Chain-Verantwortlichen sagen, dass veraltete Beschaffungssoftware die Umsetzung blockiert, und 37 % nennen Datenzugriffsprobleme als größtes Hindernis. Diese Zahlen beschreiben keine Unternehmen, die sich der Automatisierung nicht bewusst sind. Sie beschreiben Unternehmen, die sie evaluiert haben und festgestellt haben, dass die Wirtschaftlichkeit für den Großteil ihres Lieferantenportfolios nicht funktioniert.
Die Vorlagenfalle: Automatisierung, die neue manuelle Arbeit schafft
Theoretisch ist die vorlagenbasierte Extraktion ein vernünftiger Ansatz. Sie zeigen dem Tool ein Beispieldokument, markieren, wo sich jedes Feld befindet, und das Tool repliziert dieses Extraktionsmuster auf zukünftige Dokumente. So funktionieren die meisten Dokumentautomatisierungstools – von Enterprise-IDP-Plattformen bis hin zu leichteren SaaS-Produkten – seit den Anfängen der OCR.
In der Praxis hat die vorlagenbasierte Extraktion eine fatale Skalierungseigenschaft: Die Anzahl der benötigten Vorlagen skaliert linear mit der Anzahl der unterschiedlichen Dokumentformate, die Sie erhalten. Wenn Sie 40 Kunden haben und jeder ein anderes Bestelllayout verwendet, benötigen Sie 40 Vorlagen. Jeder neue Kunde erfordert eine neue Vorlagenkonfigurationssitzung – in der Regel 10 bis 15 Minuten zum Identifizieren von Feldern, Zeichnen von Bereichen und Überprüfen der Extraktionsgenauigkeit. Wenn Kunde #41 an Bord kommt, muss jemand seine Arbeit unterbrechen und Vorlage #41 erstellen.
Dies führt zu einer Umkehrung des Automatisierungsversprechens. Das Tool sollte repetitive manuelle Arbeit eliminieren. Stattdessen hat es eine neue Klasse repetitiver manueller Arbeit geschaffen – die Vorlagenwartung – die weniger sichtbar, aber ebenso zeitaufwendig ist. Und anders als bei der Dateneingabe sind Vorlagenfehler still. Wenn ein Kunde sein Bestellformat leise ändert (neues ERP, neues Branding, Formatkonsolidierung durch Fusion), wirft die Vorlage keinen Fehler aus. Sie extrahiert falsche oder fehlende Daten, die Sie erst später entdecken – wenn die Bestellung falsch ist, der Versand falsch geleitet wird oder die Rechnung nicht übereinstimmt.
Die Kostenstruktur ist tückisch. Ein manueller Dateneingabefehler – eine falsch getippte Menge oder eine vertauschte Teilenummer – wird in der Regel im selben Workflow erkannt, von derselben Person oder durch nachgelagerte Validierung. Ein Vorlagenfehler erzeugt systematische Fehler: Jeder Bestellung von Kunde X fehlt nun das Lieferdatumfeld, und niemand weiß es, bis das Lager anruft und fragt, wohin geliefert werden soll. Die Fehlerkosten pro Vorfall sind höher und die Erkennungslatenz ist länger.
Für einen mittelgroßen Hersteller, der Bestellungen von 20–80 verschiedenen Kunden über mehrere ERP-Ökosysteme verarbeitet – SAP, NetSuite, Microsoft Dynamics, Epicor, Sage, Infor – reduziert der Vorlagenansatz die Arbeit nicht. Er verlagert sie vom Dateneingabeschreibtisch auf den Vorlagenkonfigurationsbildschirm. Und für Einkaufsteams ohne dedizierte Automatisierungsingenieure macht diese Verlagerung das Problem schlimmer, nicht besser.
Was Beschaffungsteams tatsächlich jeden Tag tun
Hinter den Kostenbenchmarks und der Strukturanalyse steckt ein realer Arbeitsablauf, der sich tausende Male am Tag in Fertigungsbeschaffungsabteilungen abspielt. Es lohnt sich, ihn klar zu beschreiben – nicht als erfundene Szene, sondern als Zusammensetzung dessen, was Beschaffungsprofis auf Reddit und in Branchenforen schildern.
Der Posteingang hat neue Nachrichten von Kunden. Jede ist ein Bestellungsanhang, meist ein PDF. Einige kommen über ein Kundenportal; die meisten per E-Mail. Der Beschaffungskoordinator öffnet die erste. Sie stammt von einem Kunden, der NetSuite nutzt – die PO-Nummer steht im Kopf, der Lieferantencode in einem Referenzfeld, die Positionen in einer Tabelle mit 9 Spalten. Sie öffnen ihre Tabellenkalkulation oder ihr ERP und beginnen zu tippen: PO-Nummer, Datum, Kundenname, Lieferadresse. Dann die Positionen, Zeile für Zeile: Artikelcode, Beschreibung, Menge, Maßeinheit, Einzelpreis, Gesamtpreis. Wenn die Bestellung 15 Positionen hat, sind das 90 einzelne Datenpunkte, die manuell übertragen werden müssen, ohne eine Ziffer zu vertauschen oder eine Zeile zu überspringen.
Die zweite Bestellung stammt von einem Kunden, der SAP nutzt. Das Layout ist völlig anders. Die PO-Nummer steht oben rechts. Der Kundenname an einer anderen Stelle. Die Positionstabelle hat 12 Spalten statt 9, mit zusätzlichen Feldern für Lagerort und Lieferdatum pro Zeile. Die Feldnamen sind anders – SAP nennt es „Material", während NetSuite „Artikelcode" sagt.
Die dritte Bestellung stammt von einem Kunden ohne ERP – es ist ein in PDF konvertiertes Word-Dokument, mit Positionen als Aufzählungsliste statt Tabelle. Ein vorlagenbasiertes Extraktionstool würde hier sofort scheitern. Ein Mensch kann es lesen, aber die kognitive Reibung beim Wechsel zwischen drei völlig unterschiedlichen Dokumentstrukturen mehrmals pro Stunde ist der eigentliche Produktivitätsverlust – nicht die Tippgeschwindigkeit.
Wie ein Reddit-Nutzer in r/procurement es beschrieb: „Wir haben buchstäblich PDFs von Lieferanten genommen, Werte in Tabellenkalkulationen kopiert, jede Zeile gegen die Bestellung geprüft, Lieferanten wegen Abweichungen angemailt und alles in ERP eingefügt, weil keines dieser Systeme miteinander kommuniziert. Die halbe Arbeit ist Verwaltung, getarnt als Lieferantenmanagement."
Das Auffällige an dieser Beschreibung ist nicht die Ineffizienz – sondern die Genauigkeit. Die Systeme kommunizieren tatsächlich nicht miteinander. Das PDF ist ein Endformat: Es bewahrt das visuelle Layout, zerstört aber die Datenstruktur. Das ERP auf der Empfängerseite erwartet strukturierte, feldzugeordnete Eingaben. Zwischen diesen beiden Formaten steht ein Mensch, der die Datenstruktur manuell rekonstruiert, die verloren ging, als die Bestellung das Kundensystem verließ. Dieser Mensch schafft keinen Mehrwert. Er führt eine Formatübersetzung durch – eine Aufgabe, die Software übernehmen sollte, aber nicht kann, weil sich die Formate ständig ändern.
Die organisatorische Trägheit, die manuelle Eingaben normalisiert
Wenn die Kosten für manuelle PO-Dateneingabe messbar sind und die Werkzeuge zu deren Reduzierung existieren, warum hat der Markt das nicht behoben? Die Antwort geht über Technologie hinaus – sie ist in organisatorischem Verhalten und Anreizen der Anbieter verankert.
Die Kosten sind für Entscheidungsträger unsichtbar. Manuelle PO-Dateneingabe erscheint nicht als eigenständige Ausgabe. Es sind Stunden der Einkäufer- und Koordinatorenzeit, verteilt über die Arbeitswoche, kategorisiert unter „betrieblichem Aufwand" statt „Dateneingabe-Arbeit". Kein CFO genehmigt eine Position namens „Manuelle PO-Verarbeitung – 288.000 $". Die Kosten sind real, aber sie werden in Gehältern absorbiert, die ohnehin existieren würden. Diese buchhalterische Unsichtbarkeit bedeutet, dass es keinen natürlichen Budgetverantwortlichen für die Lösung gibt. Die IT ist nicht für die Effizienz der Beschaffung zuständig. Die Beschaffung ist nicht für die Softwarebewertung zuständig. Die Finanzabteilung sieht die Position nicht. Das Problem fällt in die Lücken zwischen den Abteilungen.
Automatisierungsfehler sind sichtbarer als manuelle Plackerei. Wenn manuelle Dateneingabe einen Fehler produziert, ist die Lösung unkompliziert: den Fehler finden, korrigieren, eine aktualisierte Bestellung senden. Es ist ärgerlich, aber Routine. Wenn ein Automatisierungswerkzeug einen Fehler produziert, ist der Fehler größer, sichtbarer und schwerer zu diagnostizieren. Eine Charge von 50 automatisch verarbeiteten Bestellungen mit einer defekten Feldzuordnung kann 50 falsche Bestellungen erzeugen – eine Krise, die auf dem Schreibtisch eines Managers landet. Der Beschaffungsprofi, der die Automatisierung befürwortet hat, bekommt die Schuld. Die Lektion, die die meisten Organisationen aus einer schlechten Automatisierungserfahrung ziehen, ist „unsere Dokumente sind zu komplex für Werkzeuge" statt „wir haben die falsche Art von Werkzeug für unsere Formatvielfalt verwendet". Diese Risikoasymmetrie – automatisierte Fehler tragen höhere organisatorische Kosten als manuelle – schafft eine starke Voreingenommenheit gegenüber dem Status quo.
ERP-Anbieter haben die falschen Anreize. Die Unternehmen, die am besten positioniert sind, um die PO-Dateneingabe zu lösen – SAP, Oracle, Microsoft, NetSuite, Epicor – sind die Unternehmen mit dem geringsten Anreiz, dies zu tun. Ihre Beschaffungsmodule setzen strukturierte Eingaben voraus. Ihr Vertriebsansatz ist auf die Einführung der gesamten Suite ausgerichtet, nicht auf die Extraktion von Einzellösungen. Wenn ein Kunde fragt: „Wie bekomme ich die PO-Daten meiner Kunden in Ihr System?", lautet die Antwort typischerweise „Lassen Sie Ihre Kunden unser Portal nutzen", oder „Richten Sie EDI ein", oder „Geben Sie es manuell ein". Alle drei Antworten akzeptieren das Formatproblem als extern zur Lösung. Das Geschäftsmodell des ERP-Anbieters hängt davon ab, dass Sie seine End-to-End-Plattform übernehmen – nicht davon, den Extraktionsschritt zu lösen, der an der Grenze zwischen Ihrem System und den Systemen Ihrer Kunden liegt.
Das Problem wurde über Generationen von Beschaffungsprofis normalisiert. Menschen, die seit 15 Jahren in der Beschaffung tätig sind, erinnern sich nicht an eine Zeit, in der die PO-Dateneingabe nicht manuell war. Sie haben ihren Arbeitsablauf darum herum aufgebaut. Sie haben Excel-Verknüpfungen, Makros und mentale Modelle, die die manuelle Eingabe erträglich machen. Automatisierung vorzuschlagen klingt nicht nach Effizienzverbesserung – es klingt nach einer Bedrohung eines Systems, das trotz aller Mängel seit Jahren zuverlässig Bestellungen hinausbringt. Die betrieblichen Kosten der Veränderung – ein neues Werkzeug zu lernen, seiner Ausgabe zu vertrauen, die Randfälle zu bewältigen, wenn es versagt – fühlen sich größer an als die betrieblichen Kosten des Status quo, selbst wenn die Mathematik etwas anderes sagt.
Keiner dieser Faktoren betrifft die technologische Leistungsfähigkeit. Es geht um Anreizstrukturen, Risikowahrnehmung und organisatorische Gewohnheiten. Die Werkzeuge zur Automatisierung der Bestell-Dateneingabe existieren. Der Grund, warum sie nicht breit eingesetzt werden, ist nicht, dass sie nicht funktionieren – sondern dass die am weitesten verbreiteten Werkzeuge (vorlagenbasierte Extraktion, ERP-Komplettmodule, EDI) Anforderungen stellen – Formatstandardisierung, Einrichtung pro Lieferant, Integrationsaufwand – die ihre Einführungskosten für die Mehrheit der Beschaffungsbeziehungen die Rentabilität übersteigen lassen.
Was die Gleichung tatsächlich verändern würde
Wenn das Kernproblem die Formatfragmentierung ist – Dokumente, die dieselben logischen Informationen (PO-Nummer, Positionszeilen, Mengen, Preise) in unbegrenzten physischen Layouts enthalten – dann kann die Lösung kein Werkzeug sein, das Sie dazu zwingt, jedes Layout einzeln zu berücksichtigen. Es muss ein Werkzeug sein, dem das Layout egal ist.
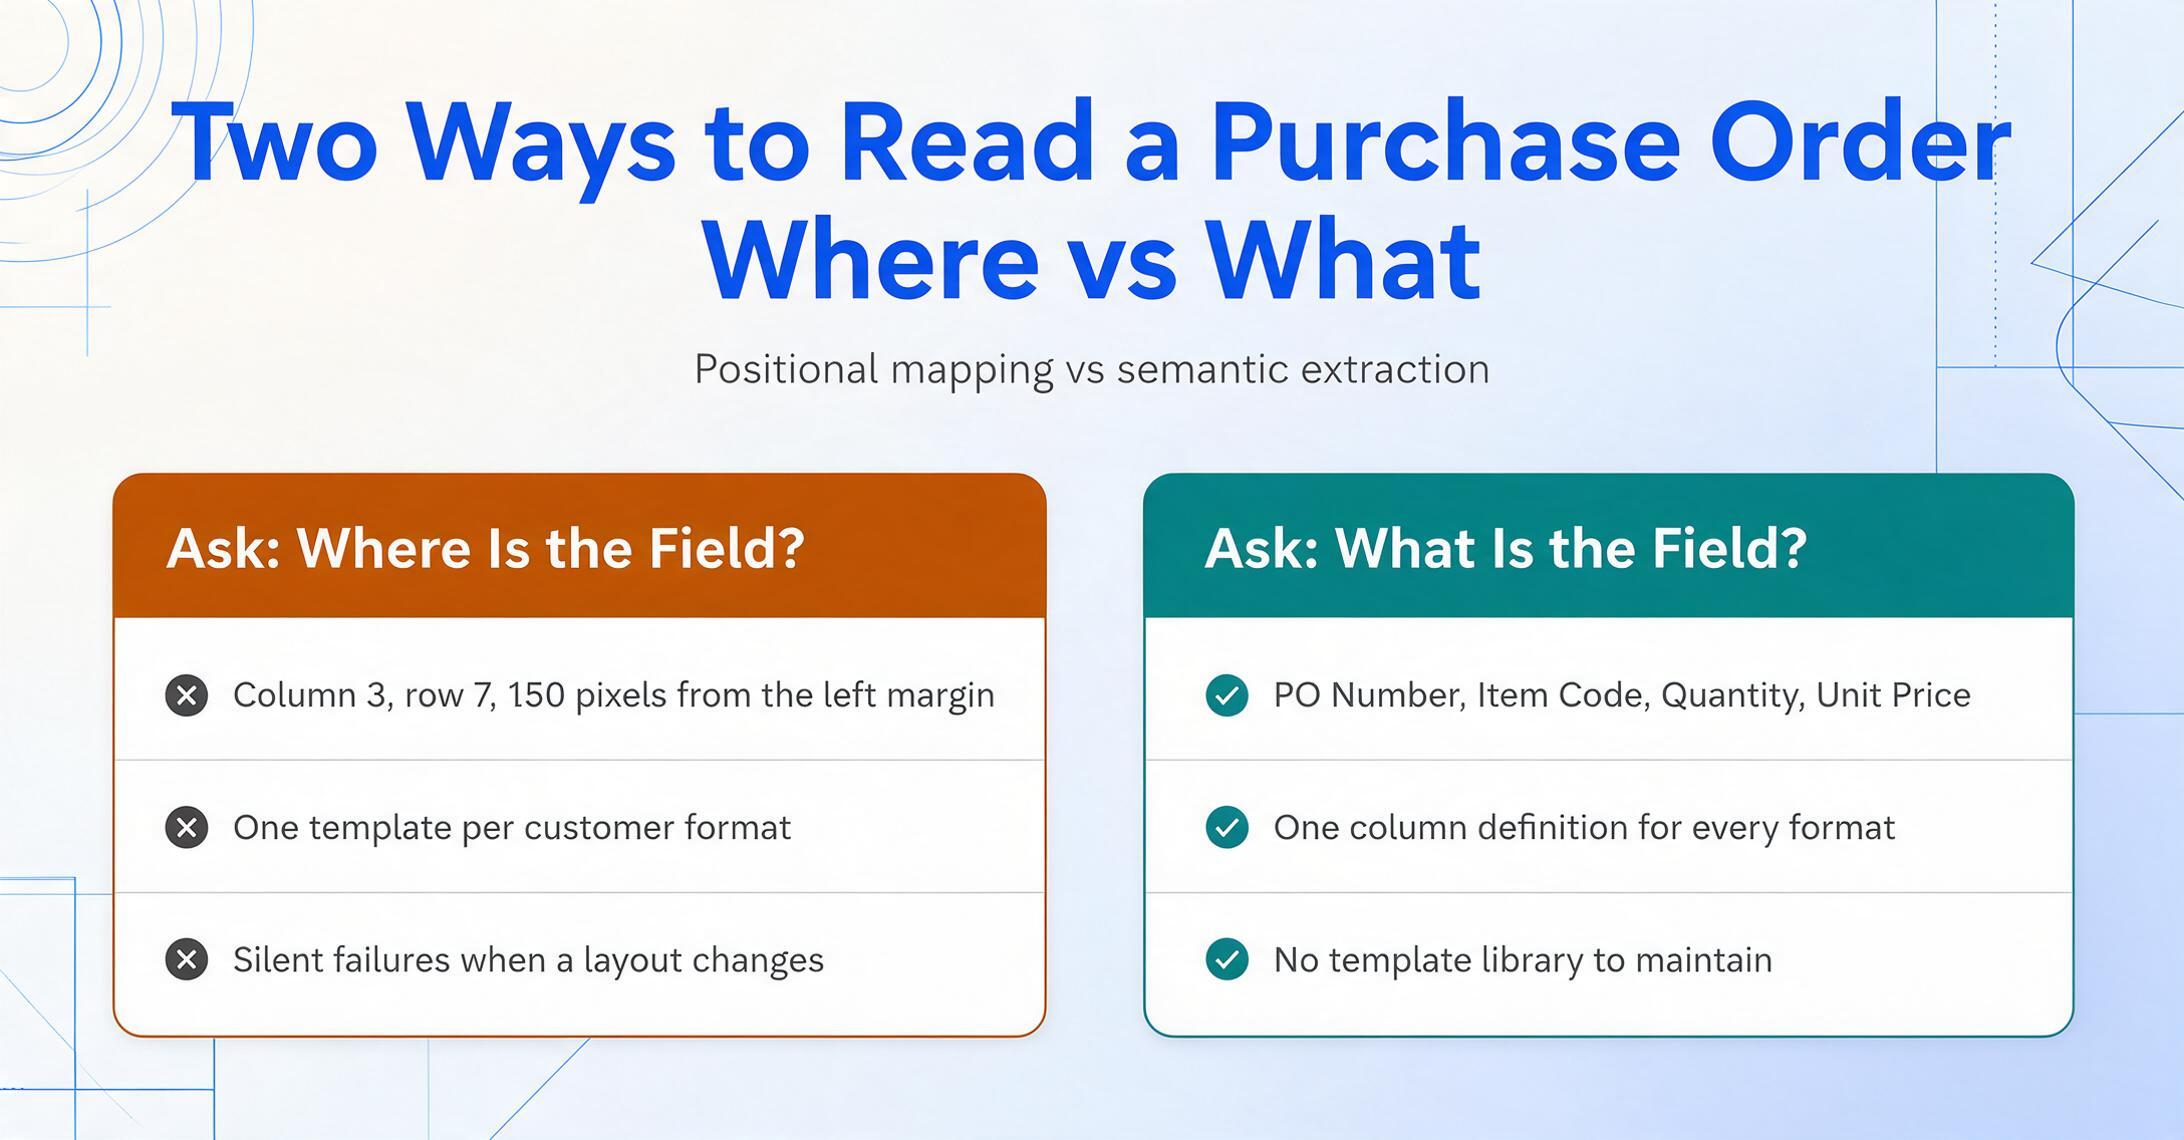
Dies ist der Unterschied zwischen vorlagenbasierter Extraktion und bedeutungsbasierter Extraktion. Eine Vorlage fragt: wo ist das Feld? Spalte 3, Zeile 7, 150 Pixel vom linken Rand. Ein bedeutungsbasierter Ansatz fragt: was ist das Feld? Er sucht nach Text, der der semantischen Rolle der „PO-Nummer" entspricht – eine eindeutige Kennung nahe dem oberen Dokumentrand, typischerweise alphanumerisch, oft mit einer Variante von „PO #" oder „Bestellnummer" oder „Purchase Order No." beschriftet – und extrahiert den Wert unabhängig davon, wo er auf der Seite steht.
Das ist es, was die Extraktion nach Spaltennamen tut: Sie definieren die gewünschten Spalten – „PO-Nummer", „Lieferantenname", „Artikelcode", „Menge", „Einzelpreis", „Positionssumme" – und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet, nicht wo er steht. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen der Ausgabetabelle. Eine Spaltendefinition funktioniert für jedes PO-Format jedes Kunden, weil die Extraktionslogik semantisch und nicht positionsbasiert ist.
Die strukturellen Auswirkungen sind erheblich:
- Betrieb ohne Vorlage. Keine Einrichtung pro Kunde. Keine Vorlagenbibliothek zu pflegen. Keine stillen Fehlschläge, wenn ein Kunde sein PO-Layout ändert. Die Extraktion passt sich automatisch an die Struktur jedes Dokuments an.
- Behandlung von Positionszeilen. Die Hauptlast einer Bestellung ist ihre Positionstabelle, die sich über Dutzende von Zeilen mit unterschiedlichen Spaltenkonfigurationen erstrecken kann. Die Extraktion nach Spaltennamen liest jede Zeile als vollständigen Datensatz und ordnet jeder Zeile die korrekte Menge, Beschreibung und den korrekten Preis zu – einschließlich Tabellen, die sich über mehrere Seiten erstrecken.
- Multi-Format-Eingaben. Dieselbe Spaltendefinition funktioniert für PDFs, gescannte Dokumente und sogar E-Mail-Screenshots. Die Extraktionslogik unterscheidet nicht zwischen einer von SAP generierten Bestellung und einer in ein Word-Dokument getippten – sie liest den Inhalt, nicht das Format.
Eine ausführlichere Erläuterung der praktischen Anwendung, einschließlich einer feldweisen Anleitung zur Bestellungsextraktion, finden Sie in unserem Artikel zum Extrahieren bestimmter Felder aus Bestellungen in Excel ohne Vorlagen. Für die Stapelverarbeitung – die Ausführung derselben Spaltendefinition über Bestellungen von Dutzenden verschiedener Kunden in einem einzigen Vorgang – lesen Sie unseren Leitfaden zur Stapelverarbeitung von Bestellungen aus jedem Lieferantenformat in eine einzige Tabelle. Und für den vollständigen Automatisierungsworkflow, einschließlich der Anbindung der Extraktionsergebnisse an Ihr bestehendes Auftragsverwaltungssystem, finden Sie in unserem Artikel zur Automatisierung der Bestellungsdatenerfassung ohne ERP.
Dateien werden sicher verarbeitet und nicht gespeichert.
Häufig gestellte Fragen
Warum können wir nicht einfach von allen Kunden verlangen, unser Bestellformat zu verwenden?
Das können Sie versuchen – und große Unternehmen mit erheblicher Einkaufsmacht haben bei ihren größten Lieferanten manchmal Erfolg damit. Doch für die meisten mittelständischen Unternehmen fließt die Macht in die andere Richtung: Sie brauchen das Geschäft Ihrer Kunden mehr, als diese ihre Bestellausgabe standardisieren müssen. Selbst wenn ein Kunde zustimmt, bedeutet die Umsetzung, dass seine IT-Abteilung einen ERP-Export neu konfiguriert, testet und bereitstellt – ein Projekt mit echten Kosten und ohne direkten Nutzen für ihn. Die meisten Einkaufsteams stellen fest, dass der Aufwand zur Durchsetzung einer Formatstandardisierung den Aufwand für den Umgang mit Formatvielfalt übersteigt.
Übernimmt mein ERP nicht bereits die Bestell-Datenerfassung?
Die meisten ERP-Beschaffungsmodule übernehmen die Bestell-Erstellung – das Generieren von Bestellungen an Ihre Lieferanten – sind aber bei Bestell-Eingängen weitaus schwächer – also beim Erfassen von Bestellungen Ihrer Kunden. ERPs erwarten strukturierte Eingaben (EDI, CSV-Importe oder direkte Dateneingabe) und bieten keinen integrierten Mechanismus zum Extrahieren strukturierter Daten aus unstrukturierten PDFs. Wenn Ihre Kunden Ihnen Bestellungen als PDF-Anhänge senden, kann Ihr ERP diese als Anhänge speichern, aber ohne zusätzliche Extraktionstools oder manuelle Eingabe nicht lesen.
Wie genau ist die KI-basierte Extraktion bei Bestellungen mit komplexen Positionszeilentabellen?
Gedruckte Tabellendaten können mit visuellen KI-Modellen mit bis zu 99 % Genauigkeit erkannt werden. Die schwierigsten Fälle sind nicht die langen Tabellen – KI kommt gut mit repetitiven Strukturen zurecht –, sondern Dokumente, in denen Positionen als Fließtext statt als Zeilen formatiert sind (häufig bei dienstleistungsbasierten Bestellungen), oder Dokumente, bei denen handschriftliche Anmerkungen zu gedruckten Tabellen hinzugefügt wurden. Für diese Randfälle sollte die Extraktion als erster Durchlauf betrachtet werden, der die manuelle Arbeit um 80–90 % reduziert, statt sie vollständig zu eliminieren. Ergebnisse sollten immer überprüft werden, bevor sie in ein ERP- oder Auftragsverwaltungssystem übernommen werden.
Was ist, wenn meine Kunden Bestellungen mit handschriftlichen Änderungen oder Anmerkungen senden?
Die Spaltennamensextraktion kann Handschrift verarbeiten, einschließlich Anmerkungen auf gedruckten Dokumenten. Die KI liest den handschriftlichen Text als Teil des Dokumentinhalts und ordnet ihn basierend auf der Bedeutung den entsprechenden Feldern zu. Die Genauigkeit bei Handschrift ist geringer als bei gedrucktem Text – insbesondere bei Schreibschrift oder hellen Bleistiftanmerkungen –, daher sollten handschriftliche Bestellungen sorgfältiger geprüft werden als saubere gedruckte.
Ist das nur ein weiteres Software-Abonnement zusätzlich zu unserem ERP, das wir bereits bezahlen?
Es schließt eine spezifische Lücke, die die meisten ERPs nicht abdecken: den Extraktionsschritt zwischen dem Erhalt einer PDF-Bestellung und der Verfügbarkeit strukturierter Daten. Wenn Sie diesen Schritt derzeit mit der Zeit von Einkäufern und Koordinatoren bezahlen – und die Kostenbenchmarks deuten darauf hin, dass die meisten mittelständischen Hersteller dies tun, mit $95–$145 pro Bestellung –, dann lautet der Vergleich nicht „Software vs. keine Software", sondern „Software vs. Arbeitskosten". Für einen Hersteller, der 200 Bestellungen pro Monat verarbeitet, übersteigen die jährlichen manuellen Verarbeitungskosten selbst bei konservativer Schätzung $200.000. Die relevante Frage ist, ob ein Extraktionstool diesen Betrag stärker reduziert, als es kostet – eine Berechnung, die von Ihrem Bestellvolumen und der Komplexität abhängt, nicht davon, ob das Tool in Ihre bestehende ERP-Budgetkategorie passt.
Wo das Problem tatsächlich liegt
Das Problem der manuellen Erfassung von Bestelldaten hat Jahrzehnte der Automatisierungstechnologie aus einem bestimmten Grund überlebt. Es liegt nicht daran, dass Einkaufsteams technikfeindlich oder uninformiert sind. Es liegt an der Struktur des Problems – unendliche Formatvielfalt, falsche Anreize zwischen Käufern und Lieferanten, eine Tool-Landschaft, die von vorlagenbasierten Ansätzen dominiert wird, die sich nicht über verschiedene Formate skalieren lassen –, die die naheliegende Lösung (Automatisierungssoftware kaufen) für die Mehrheit der Beschaffungsbeziehungen wirkungslos macht.
EDI 850 hat das Problem für die Partnerschaften mit hohem Volumen gelöst, die die Einrichtungskosten rechtfertigen können. Vorlagenbasierte Extraktion hat es für die Fälle gelöst, in denen Formatstabilität garantiert ist. Aber zwischen diesen beiden Lösungen klafft eine Lücke, die die Mehrheit der realen Beschaffung enthält: Dutzende von Kunden, jeder mit seinem eigenen Bestellformat, von denen keiner jemals zu Ihrem Vorteil standardisieren wird. In dieser Lücke lebt die manuelle Dateneingabe, und sie wird dort weiterleben, bis Einkaufsteams Tools einsetzen, die keine Formatstandardisierung benötigen, um zu funktionieren.
Der Wandel von der vorlagenbasierten zur bedeutungsbasierten Extraktion – von der Frage „Wo ist das Feld?" zur Frage „Was ist das Feld?" – verändert die Ökonomie des Problems an seiner strukturellen Wurzel. Wenn die Extraktionsgenauigkeit eher auf semantischem Verständnis als auf positionsbasiertem Mapping beruht, hört die Formatvielfalt auf, ein Hindernis zu sein, und wird irrelevant. Die Kosten der Automatisierung sinken von „eine Vorlage pro Lieferant" auf „eine Spaltendefinition für alle Lieferanten". Die Einführungshürde ist keine technische Fähigkeit – es ist die Erkenntnis, dass die vorherige Generation von Automatisierungstools für eine Welt mit stabilen Dokumentformaten entwickelt wurde, während die Beschaffungsrealität das Gegenteil ist.
Sehen Sie, wie die Spaltennamensextraktion Ihre tatsächlichen Bestellungen verarbeitet – über jedes Kundenformat hinweg, ohne Vorlagen.
Jetzt testen →