Le problème de la saisie manuelle des bons de commande
— et ce qui le perpétue
Les données d'APQC's Open Standards Benchmarking révèlent que les organisations dépensent entre 14 $ et plus de 54 $ pour traiter un seul bon de commande. Pour un fabricant de taille moyenne émettant 5 000 bons de commande par an, l'écart entre les meilleurs et les moins performants représente une différence de 70 000 $ à 270 000 $ en coûts de traitement annuels. CAPS Research situe la moyenne intersectorielle encore plus haut, à 527 $ par bon de commande dans leur enquête la plus récente. Les données sont disponibles depuis des années. L'EDI 850 — la norme ANSI X12 pour les bons de commande électroniques — existe depuis des décennies. Et pourtant, 75 % des bons de commande sont encore envoyés par e-mail ou par fax, selon une enquête sectorielle d'AutoQuotes, atterrissant dans des boîtes de réception où quelqu'un ouvre la pièce jointe et commence à taper. Ce n'est pas un problème technologique. C'est un problème structurel que la plupart des outils d'automatisation n'ont jamais été conçus pour résoudre.
Points clés à retenir
- Deux cents bons de commande par mois à 120 $ chacun brûlent 288 000 $ par an en saisie manuelle de données — un coût absorbé si complètement dans les salaires des acheteurs qu'aucun directeur financier n'a jamais approuvé une ligne budgétaire intitulée « Traitement manuel des bons de commande ».
- Les outils d'extraction basée sur des modèles n'ont pas éliminé le travail manuel sur les bons de commande — ils l'ont déplacé de la saisie de chiffres vers la création et la maintenance de quarante modèles distincts, où les défaillances sont silencieuses et ne sont découvertes qu'après que les commandes sont expédiées de manière incorrecte.
- L'extraction qui lit un champ de bon de commande selon ce qu'il signifie plutôt que selon sa position fonctionne de manière identique sur tous les formats de bons de commande de chaque client — une seule définition de colonne les couvre tous, sans aucun modèle à créer ou à casser.
Le problème à 217 $ dont personne ne parle
Demandez à un responsable des achats combien coûte le traitement d'un bon de commande et vous obtiendrez généralement un regard vide. Non pas parce qu'ils ne se soucient pas des coûts — c'est le cas. Mais parce que le coût de la saisie manuelle des données de bon de commande est si uniformément réparti dans les opérations quotidiennes qu'il disparaît en arrière-plan. Ce n'est pas un poste budgétaire. C'est juste « ce que nous faisons ».
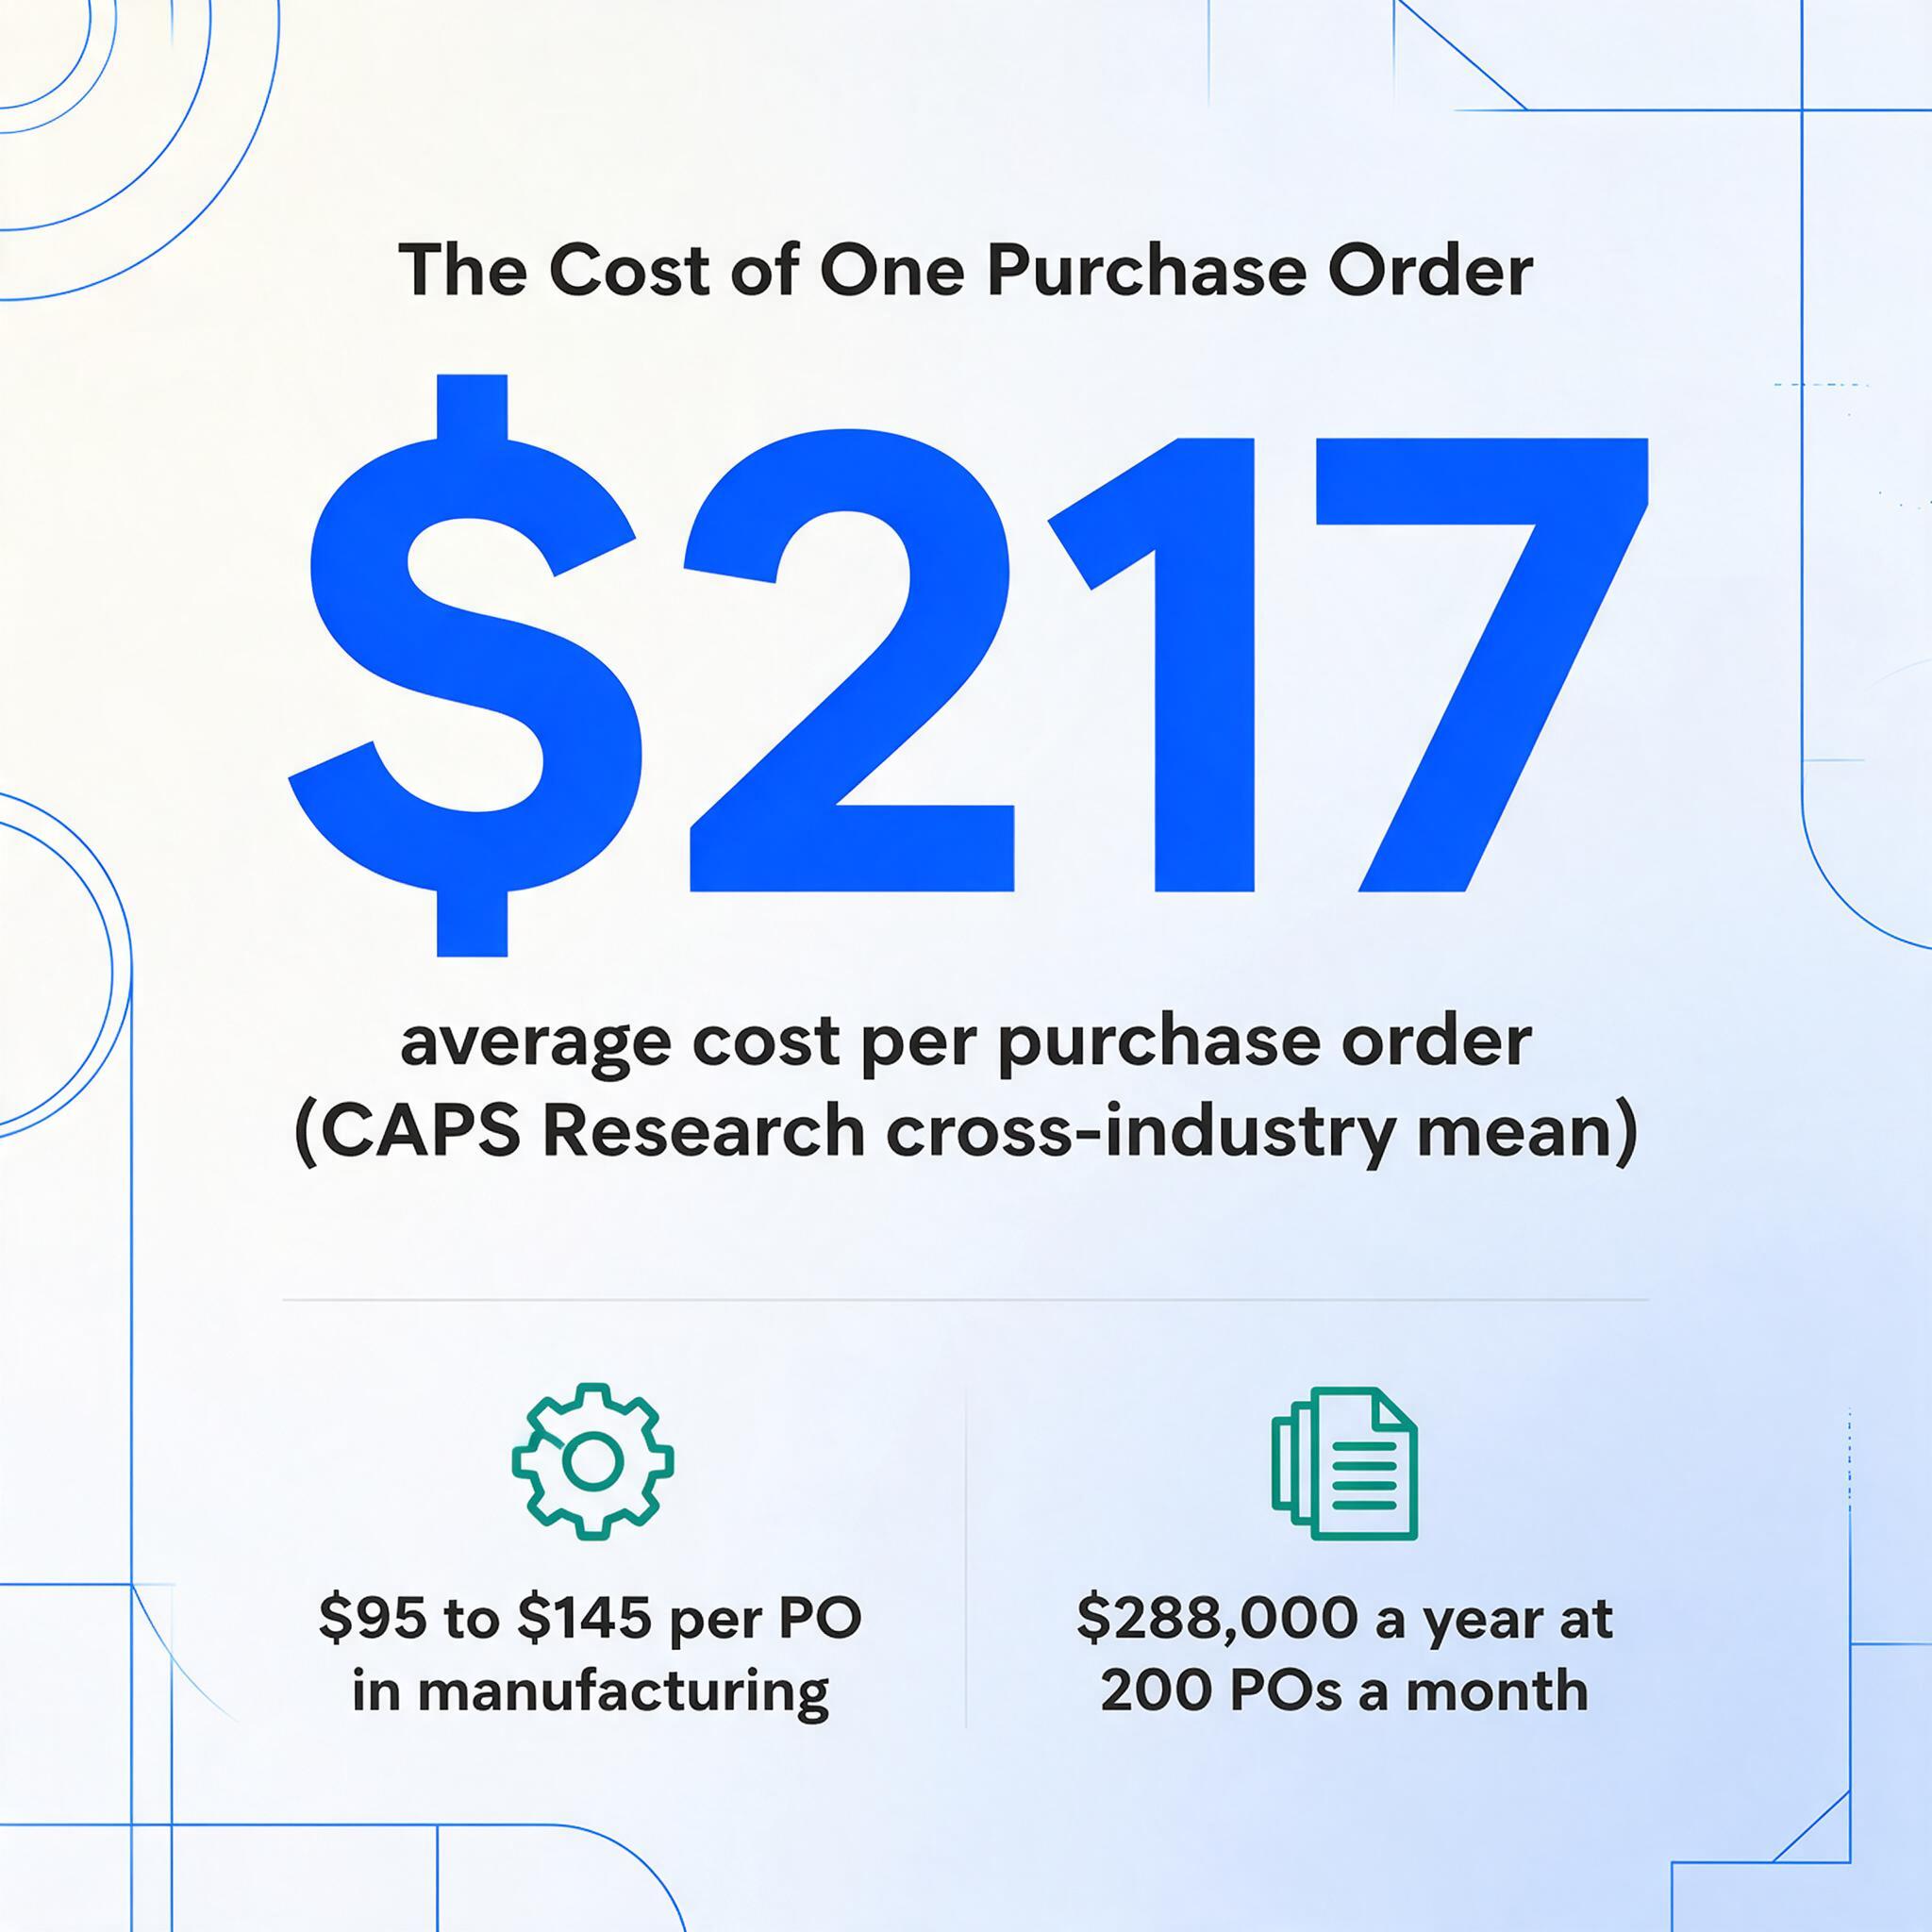
Le Center for Advanced Procurement Strategy (CAPS Research) mesure les coûts de traitement des bons de commande depuis des années. Leurs données intersectorielles montrent un coût moyen par bon de commande allant d'environ 50 $ à plus de 1 000 $, selon le secteur, avec une moyenne autour de 217 $. Les estimations spécifiques au secteur manufacturier provenant de multiples sources convergent vers 95 $ à 145 $ par bon de commande. Ce chiffre inclut non seulement le travail visible de saisie des données — il inclut les relances par e-mail, les vérifications de statut, les corrections d'erreurs, la résolution des commandes en double et le temps passé à réconcilier les incohérences entre ce que dit le bon de commande et ce que le fournisseur a réellement expédié.
Une entreprise traitant 200 bons de commande par mois à 120 $ chacun dépense 288 000 $ par an uniquement pour le coût administratif de transférer les données de commande d'un document à un autre. Et c'est le cas médian. À l'extrémité supérieure — les bons de commande manufacturiers complexes avec des tableaux de 50 lignes et des approbations à plusieurs niveaux — le coût peut dépasser 500 $ par bon de commande.
Le chiffre lui-même n'est pas le sujet. Le sujet est que ces coûts ont été mesurés, publiés et comparés par des organismes de recherche indépendants depuis plus d'une décennie. Chaque responsable des achats a accès à ces données. Les outils d'automatisation qui pourraient réduire ces coûts existent. Et pourtant, l'écart entre « connaître le chiffre » et « changer le chiffre » persiste dans la majorité des entreprises manufacturières et de distribution de taille moyenne. La question qui vaut la peine d'être posée n'est pas « combien ça coûte » — c'est pourquoi cela continue-t-il de coûter autant, année après année, alors que la solution n'est pas un mystère ?
Ce n'est pas un problème. C'est une pile de trois.
Demandez à un éditeur de logiciels ce qui ne va pas avec le traitement manuel des bons de commande et il vous donnera une réponse en une phrase : la saisie de données est lente et sujette aux erreurs. Cette réponse est techniquement vraie. Elle est aussi inutile comme diagnostic. Le vrai problème n'est pas que les équipes d'approvisionnement tapent au lieu de cliquer. Le vrai problème est une structure à trois niveaux qui rend la saisie fonctionnellement inévitable dans les conditions actuelles du secteur.
Niveau un : la fragmentation des formats. Chaque bon de commande client est présenté différemment. L'un place le numéro de PO en haut à droite. Un autre le place dans un bloc d'en-tête à gauche. Un troisième l'intègre dans un code-barres en page deux. Le tableau des lignes d'article — qui peut avoir 5, 50 ou 300 lignes de profondeur — peut être large de six colonnes, ou de quatorze. Les codes article peuvent être dans la colonne un ou la colonne quatre. Les dates de livraison peuvent apparaître par ligne d'article ou comme un champ unique dans l'en-tête. Comme l'a dit un utilisateur de Reddit dans r/manufacturing : « Le plus gros problème pour nous est que les bons de commande clients n'arrivent pas dans le même format. Tout le monde utilise un format de PO différent, même pour les noms de champs. »
Ce n'est pas une observation nouvelle. Chaque professionnel des achats le sait. Ce qui est moins compris, c'est que la fragmentation des formats n'est pas un bug — c'est l'état d'équilibre du système. Le format de PO de chaque entreprise est généré par son ERP, qui a été configuré pour correspondre à ses structures de données internes, qui ont évolué au fil d'années de décisions spécifiques à l'entreprise. Demander à 80 clients de normaliser leurs formats de PO n'est pas une demande d'approvisionnement. C'est demander à 80 entreprises de reconfigurer leurs sorties ERP — une tâche sans aucun retour sur investissement de leur point de vue.
Niveau deux : le désalignement des incitations du fournisseur. Si vous êtes un fabricant recevant des PO de clients, vous avez de fortes incitations à automatiser la saisie de données. Chaque minute gagnée à taper est une minute rendue à la planification de la production, à la gestion des stocks ou à la négociation avec les fournisseurs. Mais si vous êtes le client qui envoie le PO, vous avez exactement zéro incitation à changer votre format pour faciliter la vie du fournisseur. Le PO sort de la même manière qu'il a toujours fait — généré par votre ERP, joint en PDF à un e-mail — et la charge de saisie de données du fournisseur vous est invisible. Cette asymétrie est fondamentale. La partie qui contrôle le format n'a aucune incitation à le normaliser, et la partie qui a besoin de normalisation n'a aucun levier pour l'exiger.
Niveau trois : l'inadéquation des outils. L'approche dominante de l'extraction de données documentaires depuis deux décennies a été basée sur des modèles : vous dessinez des cadres autour des champs sur un document échantillon, vous les étiquetez, et l'outil extrait les données de tout document ultérieur qui correspond à la même mise en page. Cela fonctionne pour les factures d'un seul fournisseur. Cela s'effondre pour les PO de 40 clients différents. Chaque client a besoin d'un modèle séparé. Chaque modèle prend du temps à construire. Et lorsqu'un client met à niveau son ERP ou modifie sa mise en page de PO — ce qui se produit lors de migrations système, d'acquisitions ou de changements de marque — le modèle casse silencieusement, produisant soit des données brouillées, soit rien du tout. Le travail que vous essayiez d'éliminer (la saisie manuelle de données) a été remplacé par un autre type de travail manuel (la maintenance des modèles).
Ces trois niveaux se cumulent. La fragmentation des formats est la réalité de base. Les incitations des fournisseurs empêchent qu'elle se résolve d'elle-même. Les outils basés sur des modèles la transforment en plafond d'évolutivité — vous pouvez automatiser la saisie des données des bons de commande pour cinq clients, mais pas pour cinquante. Le résultat est un paysage d'approvisionnement où 57 % des responsables des achats s'appuient encore sur la saisie manuelle des données pour les bons de commande, non pas parce qu'ils n'ont pas entendu parler de l'automatisation, mais parce que l'automatisation qu'ils ont essayée n'a pas pu gérer la diversité des formats de leur base de fournisseurs réelle.
L'EDI a résolu ce problème pour les plus grandes entreprises du monde. Pour tous les autres, il a créé un plafond.
Si vous travaillez dans les achats depuis plus de quelques années, vous avez entendu le discours sur l'EDI. L'EDI 850 — la norme ANSI X12 pour les bons de commande électroniques — définit un format structuré pour l'échange de PO de machine à machine. Lorsque les deux parties utilisent l'EDI, les bons de commande circulent directement du système ERP de l'acheteur vers le système de gestion des commandes du fournisseur, sans intervention humaine. Pas de PDF. Pas de saisie. Pas de variation de format, car les deux parties se conforment au même ensemble de transactions.
Cela fonctionne à merveille — pour les relations où c'est mis en œuvre. Les grands constructeurs automobiles, les grandes surfaces et les maîtres d'œuvre aérospatiaux utilisent l'EDI avec leurs fournisseurs de premier rang depuis des décennies. La chaîne d'approvisionnement de Walmart s'effondrerait sans lui.
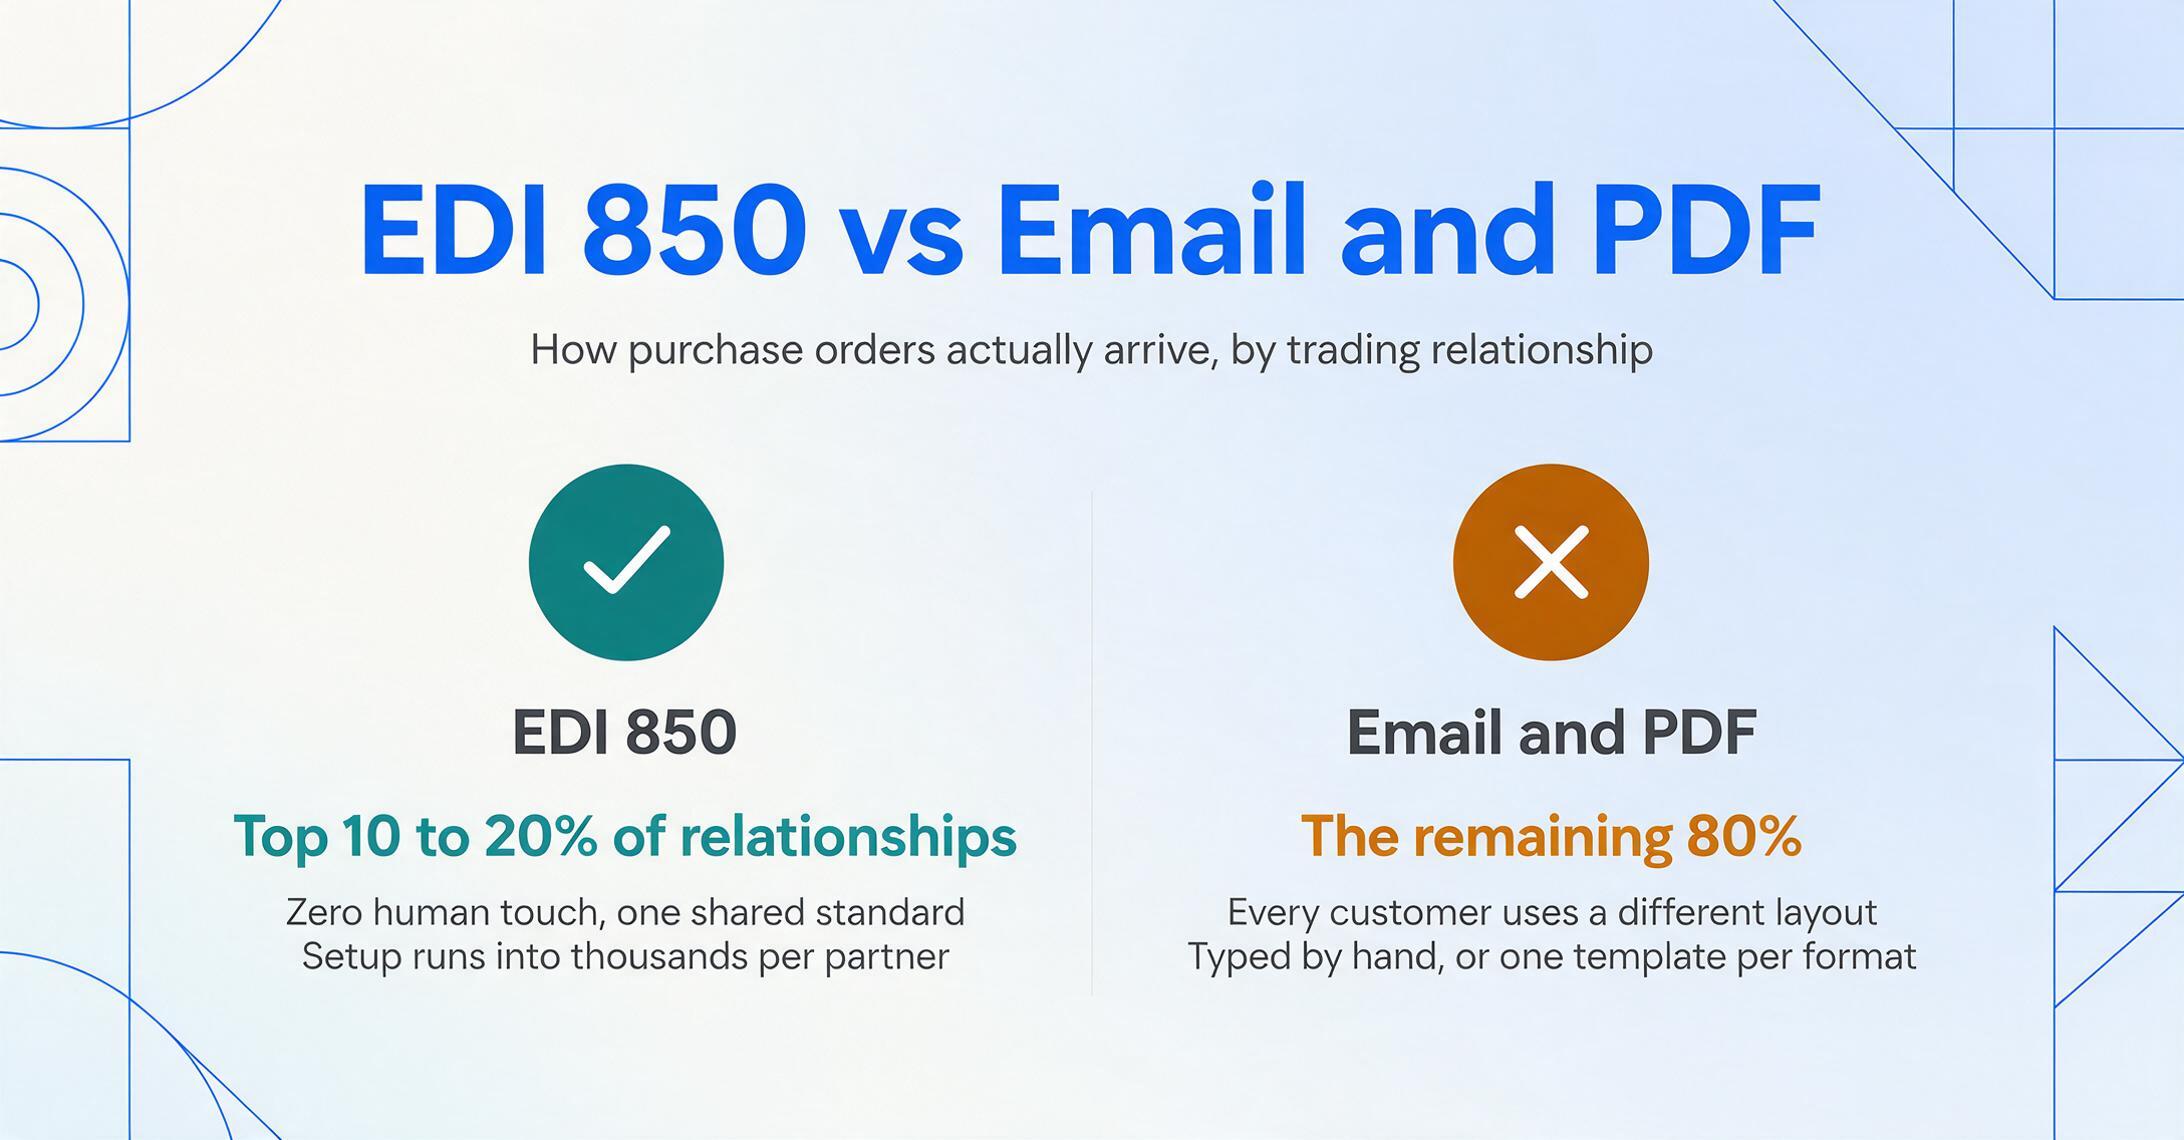
Le problème est que la courbe d'adoption de l'EDI a un plafond dur. La mise en œuvre de l'EDI nécessite une infrastructure technique aux deux extrémités — logiciel de traduction EDI, protocoles de communication (AS2, VAN) et logique de mappage pour traduire entre les segments EDI 850 (BEG, N1, PO1, PID, CTT) et les structures de données internes de chaque partie. Le coût de configuration s'élève à des milliers de dollars par partenaire commercial. Pour les relations à volume élevé — un fabricant passant des commandes hebdomadaires valant des millions — le retour sur investissement se ferme instantanément. Pour la longue traîne de clients qui commandent trimestriellement ou sporadiquement — ce qui décrit la plupart des relations B2B de milieu de marché — il ne se ferme jamais.
Le résultat est une réalité d'approvisionnement à deux vitesses. Les 10 à 20 % supérieurs des relations commerciales fonctionnent sur l'EDI. Les 80 % restants fonctionnent sur l'e-mail et le PDF. Le deuxième groupe est là où vit la saisie manuelle des données — et où elle continuera de vivre tant que les options d'automatisation exigeront une normalisation des formats que ces relations ne peuvent pas supporter économiquement.
CAPS Research a constaté que 31 % des responsables de la chaîne d'approvisionnement disent que les logiciels d'approvisionnement obsolètes bloquent l'exécution, et 37 % citent les problèmes d'accès aux données comme un obstacle majeur. Ces chiffres ne décrivent pas des entreprises qui ignorent l'automatisation. Ils décrivent des entreprises qui l'ont évaluée et ont constaté que l'économie ne fonctionne pas pour la majorité de leur portefeuille de fournisseurs.
Le piège des modèles : une automatisation qui crée de nouvelles tâches manuelles
En théorie, l'extraction basée sur des modèles est une approche raisonnable. Vous montrez à l'outil un document exemple, vous marquez l'emplacement de chaque champ, et l'outil reproduit ce schéma d'extraction sur les documents futurs. C'est ainsi que fonctionnent la plupart des outils d'automatisation documentaire — des plateformes IDP d'entreprise aux produits SaaS plus légers — depuis les débuts de l'OCR.
En pratique, l'extraction basée sur des modèles a une propriété d'évolutivité fatale : le nombre de modèles dont vous avez besoin augmente de manière linéaire avec le nombre de formats de documents distincts que vous recevez. Si vous avez 40 clients et que chacun utilise une mise en page de bon de commande différente, vous avez besoin de 40 modèles. Chaque nouveau client nécessite une session de configuration de modèle — généralement 10 à 15 minutes pour identifier les champs, dessiner les zones et vérifier la précision de l'extraction. Lorsque le client n°41 arrive, quelqu'un doit interrompre son travail pour créer le modèle n°41.
Cela crée une inversion de la promesse d'automatisation. L'outil était censé éliminer le travail manuel répétitif. Au lieu de cela, il a créé une nouvelle catégorie de travail manuel répétitif — la maintenance des modèles — moins visible mais tout aussi chronophage. Et contrairement à la saisie de données, les défaillances de modèles sont silencieuses. Lorsqu'un client modifie discrètement le format de son bon de commande (nouvel ERP, nouveau branding, consolidation de formats due à une fusion), le modèle ne génère pas d'erreur. Il extrait des données incorrectes ou manquantes, que vous découvrez en aval — lorsque la commande est erronée, que l'expédition est mal acheminée ou que la facture ne correspond pas.
La structure des coûts est insidieuse. Une erreur de saisie manuelle — une quantité mal saisie ou un numéro de pièce transposé — est généralement détectée dans le même flux de travail, par la même personne ou par une validation en aval. Une défaillance de modèle produit des erreurs systématiques : chaque bon de commande du client X est désormais privé du champ date de livraison, et personne ne le sait jusqu'à ce que l'entrepôt appelle pour demander où expédier. Le coût par incident est plus élevé et la latence de détection est plus longue.
Pour un fabricant de taille moyenne traitant des bons de commande de 20 à 80 clients différents dans plusieurs écosystèmes ERP — SAP, NetSuite, Microsoft Dynamics, Epicor, Sage, Infor — l'approche par modèles ne réduit pas le travail. Elle le déplace du poste de saisie de données vers l'écran de configuration des modèles. Et pour les équipes d'approvisionnement qui ne disposent pas d'ingénieurs d'automatisation dédiés, ce déplacement aggrave le problème au lieu de l'améliorer.
Ce que font réellement les équipes d'approvisionnement chaque jour
Derrière les références de coûts et l'analyse structurelle, il y a un flux de travail réel qui se joue des milliers de fois par jour dans les services d'approvisionnement en fabrication. Il vaut la peine de le décrire clairement — non pas comme une scène inventée, mais comme un composite de ce que les professionnels de l'approvisionnement décrivent sur Reddit et dans les forums de l'industrie.
La boîte de réception contient de nouveaux messages de clients. Chacun est une pièce jointe de bon de commande, généralement un PDF. Certains arrivent via un portail client ; la plupart arrivent par e-mail. Le coordonnateur d'approvisionnement ouvre le premier. Il provient d'un client utilisant NetSuite — le numéro de PO est dans l'en-tête, le code fournisseur est dans un champ de référence, les lignes de commande sont dans un tableau à 9 colonnes. Ils ouvrent leur feuille de calcul ou ERP et commencent à saisir : numéro de PO, date, nom du client, adresse de livraison. Puis les lignes de commande, une par une : code d'article, description, quantité, unité de mesure, prix unitaire, prix total. Si le PO a 15 lignes de commande, cela représente 90 points de données individuels à transférer, manuellement, sans transposer un chiffre ni sauter une ligne.
Le deuxième PO provient d'un client utilisant SAP. La mise en page est complètement différente. Le numéro de PO est dans le coin supérieur droit. Le nom du client est à une position différente. Le tableau des lignes de commande a 12 colonnes au lieu de 9, avec des champs supplémentaires pour l'emplacement de l'entrepôt et la date de livraison par ligne. Les noms de champs sont différents — SAP l'appelle « Matériau » là où NetSuite dit « Code d'article ».
Le troisième PO provient d'un client sans ERP du tout — c'est un document Word converti en PDF, avec des lignes de commande formatées en liste à puces plutôt qu'en tableau. Un outil d'extraction basée sur des modèles échouerait immédiatement sur ce document. Une personne peut le lire, mais la friction cognitive de passer entre trois structures de documents complètement différentes plusieurs fois par heure est le véritable drain de productivité — pas la vitesse de frappe.
Comme l'a décrit un utilisateur de Reddit dans r/procurement : « Nous prenions littéralement des PDF de fournisseurs, copiions les valeurs dans des feuilles de calcul, vérifiions chaque ligne contre le PO, envoyions des e-mails aux fournisseurs sur les écarts, collions tout dans l'ERP parce qu'aucun de ces systèmes ne communique entre eux. La moitié du travail est de l'administration déguisée en gestion des fournisseurs. »
Ce qui frappe dans cette description, ce n'est pas l'inefficacité — c'est la précision. Les systèmes ne communiquent vraiment pas entre eux. Le PDF est un format sans issue : il préserve la mise en page visuelle mais détruit la structure des données. L'ERP à la réception attend une entrée structurée et mappée par champ. Entre ces deux formats se trouve un être humain, reconstruisant manuellement la structure de données perdue lorsque le PO a quitté le système du client. Cet être humain n'ajoute pas de valeur. Il effectue une traduction de format — une tâche que le logiciel devrait gérer, mais ne peut pas, parce que les formats changent constamment.
L'inertie organisationnelle qui normalise la saisie manuelle
Si le coût de la saisie manuelle des données de bons de commande est mesurable et que les outils pour le réduire existent, pourquoi le marché n'a-t-il pas résolu ce problème ? La réponse dépasse la technologie — elle est ancrée dans le comportement organisationnel et les incitations des fournisseurs.
Le coût est invisible pour les décideurs. La saisie manuelle des données de bons de commande n'apparaît pas comme une dépense distincte. Ce sont des heures de temps d'acheteurs et de coordinateurs réparties sur la semaine de travail, classées sous « frais généraux opérationnels » plutôt que « main-d'œuvre de saisie de données ». Aucun directeur financier n'approuve une ligne budgétaire intitulée « Traitement manuel des bons de commande — 288 000 $ ». Le coût est réel, mais il est absorbé dans des salaires qui existeraient de toute façon. Cette invisibilité comptable signifie qu'il n'y a pas de propriétaire budgétaire naturel pour la correction. L'informatique ne possède pas l'efficacité des achats. Les achats ne possèdent pas l'évaluation des logiciels. Les finances ne voient pas la ligne budgétaire. Le problème tombe dans les interstices entre les départements.
Les échecs d'automatisation sont plus visibles que le travail manuel pénible. Lorsque la saisie manuelle des données produit une erreur, la correction est simple : trouver l'erreur, la corriger, envoyer une commande mise à jour. C'est ennuyeux mais routinier. Lorsqu'un outil d'automatisation produit une erreur, l'échec est plus important, plus visible et plus difficile à diagnostiquer. Un lot de 50 bons de commande traités automatiquement avec un mappage de champs cassé peut créer 50 commandes incorrectes — une crise qui atterrit sur le bureau d'un gestionnaire. Le professionnel des achats qui a défendu l'automatisation reçoit le blâme. La leçon que la plupart des organisations tirent d'une mauvaise expérience d'automatisation est « nos documents sont trop complexes pour que les outils les gèrent » plutôt que « nous avons utilisé le mauvais type d'outil pour notre diversité de formats ». Cette asymétrie de risque — les échecs automatisés entraînent un coût organisationnel plus élevé que les échecs manuels — crée un puissant biais en faveur du statu quo.
Les fournisseurs d'ERP ont les mauvaises incitations. Les entreprises les mieux positionnées pour résoudre la saisie des données de bons de commande — SAP, Oracle, Microsoft, NetSuite, Epicor — sont celles qui ont le moins d'incitation à le faire. Leurs modules d'achat supposent une saisie structurée. Leur mouvement de vente est construit autour de l'adoption de la suite complète, pas de l'extraction de solutions ponctuelles. Lorsqu'un client demande « comment puis-je obtenir les données de bons de commande de mes clients dans votre système », la réponse est typiquement « demandez à vos clients d'utiliser notre portail », ou « configurez l'EDI », ou « saisissez-les manuellement ». Ces trois réponses acceptent le problème de format comme externe à la solution. Le modèle économique du fournisseur d'ERP dépend de votre adoption de leur plateforme de bout en bout — pas de la résolution de l'étape d'extraction qui se situe à la frontière entre votre système et ceux de vos clients.
Le problème a été normalisé à travers des générations de professionnels des achats. Les personnes qui travaillent dans les achats depuis 15 ans ne se souviennent pas d'une époque où la saisie des données de bons de commande n'était pas manuelle. Ils ont construit leur flux de travail autour de cela. Ils ont des raccourcis Excel, des macros et des modèles mentaux qui rendent la saisie manuelle tolérable. Suggérer l'automatisation ne ressemble pas à une amélioration de l'efficacité — cela ressemble à une menace pour un système qui, malgré tous ses défauts, a fièrement fait sortir les commandes depuis des années. Le coût opérationnel du changement — apprendre un nouvel outil, faire confiance à ses résultats, gérer les cas limites lorsqu'il échoue — semble plus important que le coût opérationnel du statu quo, même lorsque les calculs disent le contraire.
Aucun de ces facteurs ne relève de la capacité technologique. Ils concernent les structures d'incitation, la perception du risque et les habitudes organisationnelles. Les outils pour automatiser la saisie des données des bons de commande existent. La raison pour laquelle ils n'ont pas été largement adoptés n'est pas qu'ils ne fonctionnent pas — c'est que les outils les plus largement disponibles (extraction basée sur des modèles, modules ERP complets, EDI) imposent des exigences — standardisation du format, configuration par fournisseur, frais d'intégration — qui font que leur coût d'adoption dépasse leur ROI pour la majorité des relations d'approvisionnement.
Ce qui changerait réellement la donne
Si le problème fondamental est la fragmentation des formats — des documents qui contiennent les mêmes informations logiques (n° de PO, lignes d'article, quantités, prix) disposées dans des mises en page physiques illimitées — alors la solution ne peut pas être un outil qui vous oblige à tenir compte de chaque mise en page individuellement. Il faut un outil qui ne se soucie pas de la mise en page.
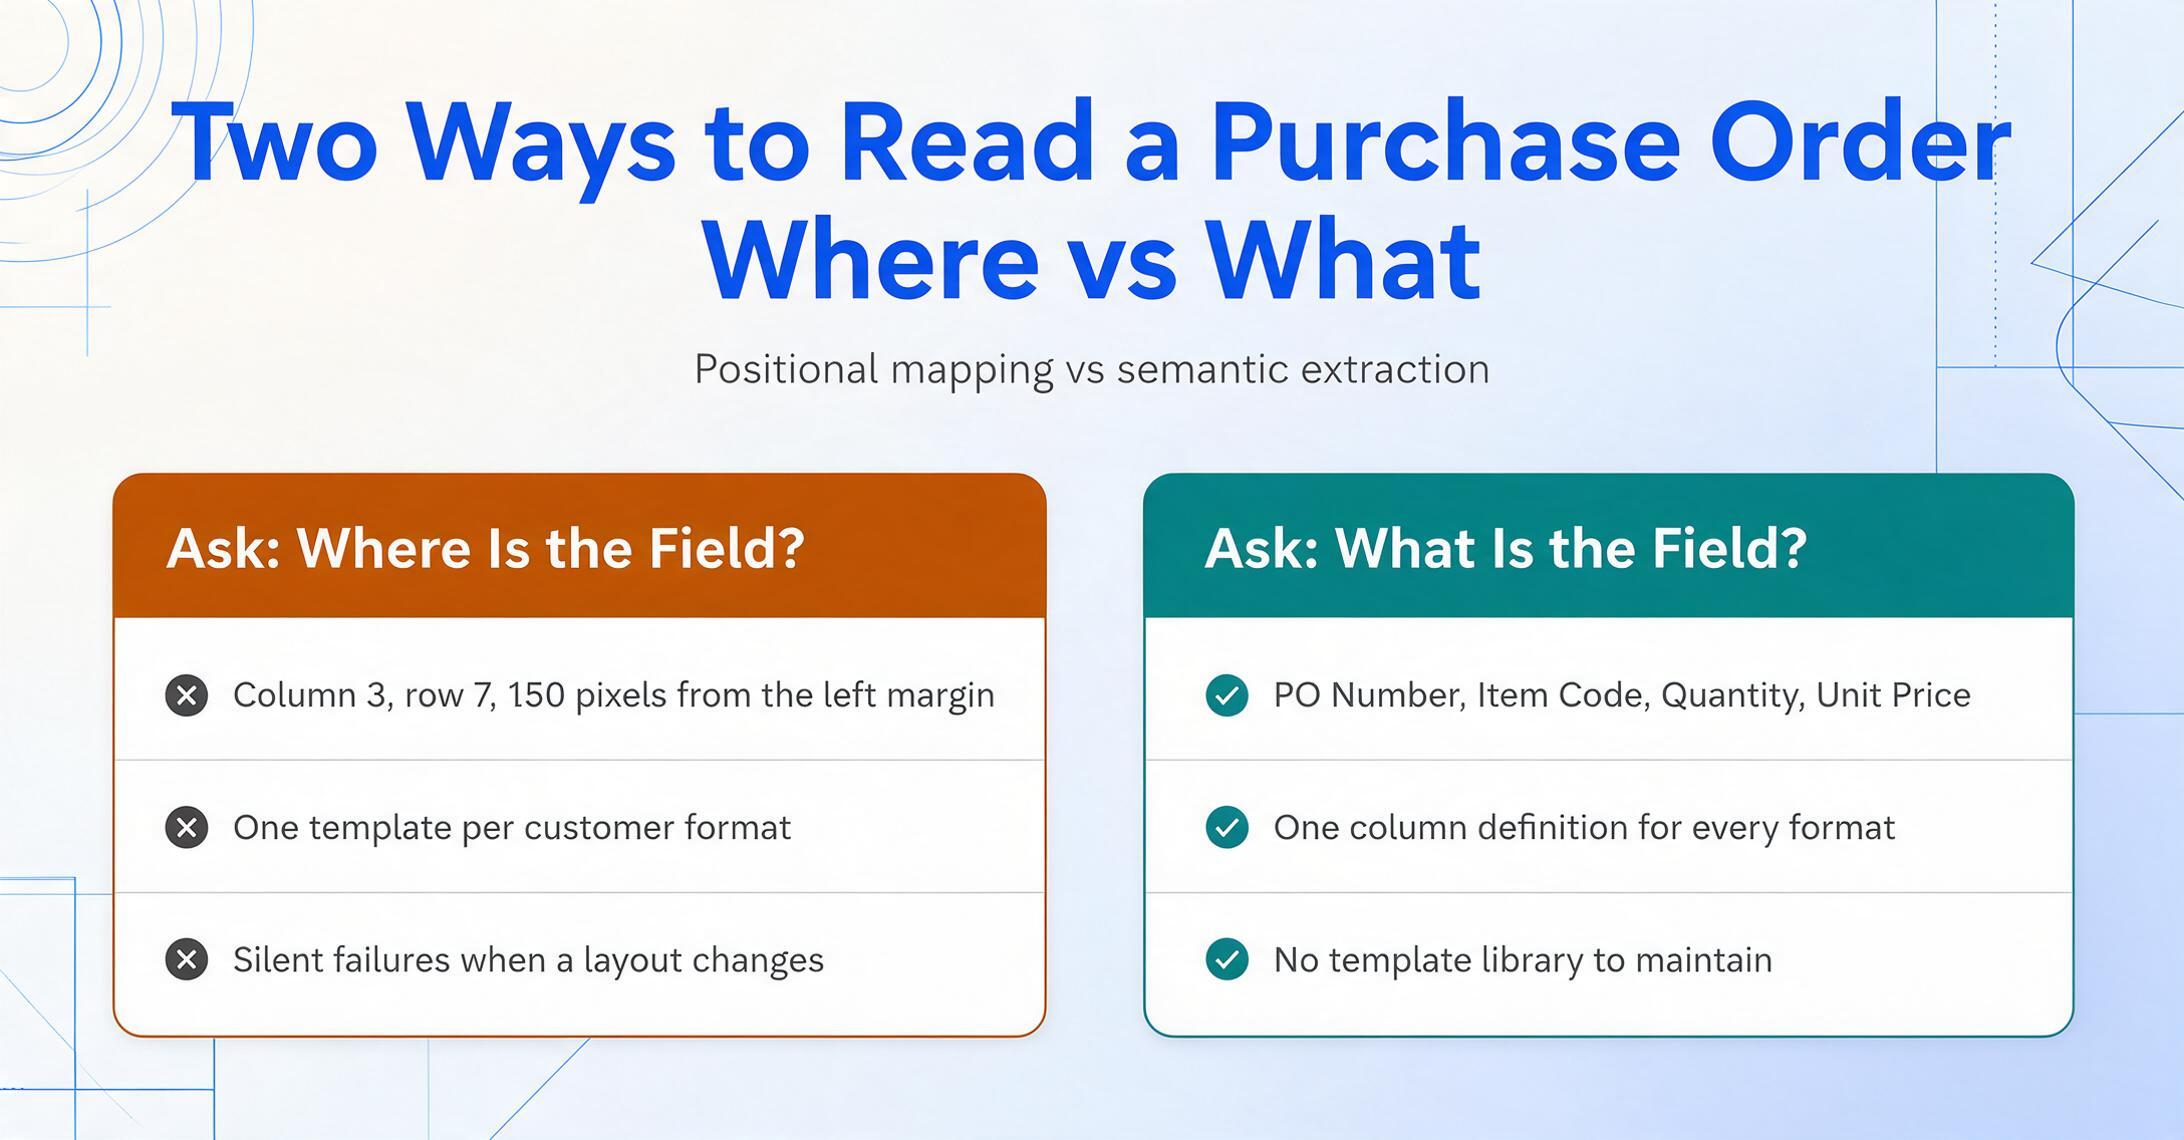
C'est la différence entre l'extraction basée sur des modèles et l'extraction basée sur le sens. Un modèle demande : où se trouve le champ ? Colonne 3, ligne 7, 150 pixels de la marge gauche. Une approche basée sur le sens demande : qu'est-ce que le champ ? Elle recherche un texte correspondant au rôle sémantique de « N° de PO » — un identifiant unique près du haut du document, généralement alphanumérique, souvent étiqueté avec une variante de « PO # » ou « Numéro de commande » ou « N° de bon de commande » — et extrait la valeur, peu importe où elle se trouve sur la page.
C'est ce que fait l'extraction par noms de colonnes : vous définissez les colonnes souhaitées — « N° de PO », « Nom du fournisseur », « Code article », « Quantité », « Prix unitaire », « Total ligne » — et l'IA localise chaque valeur en comprenant ce qu'elle signifie, et non où elle se trouve. Les noms de colonnes que vous saisissez deviennent les en-têtes du tableau de sortie. Une définition de colonne fonctionne pour le format de PO de chaque client, car la logique d'extraction est sémantique, et non positionnelle.
Les implications structurelles sont significatives :
- Fonctionnement sans modèle. Aucune configuration par client. Aucune bibliothèque de modèles à maintenir. Aucune défaillance silencieuse lorsqu'un client modifie la mise en page de son PO. L'extraction s'adapte automatiquement à la structure de chaque document.
- Gestion des lignes d'article. La charge principale d'un bon de commande est son tableau de lignes d'article, qui peut s'étendre sur des dizaines de lignes avec des configurations de colonnes variables. L'extraction par noms de colonnes lit chaque ligne comme un enregistrement complet, en associant la bonne quantité, la bonne description et le bon prix à chaque ligne — y compris les tableaux répartis sur plusieurs pages.
- Entrées multi-formats. La même définition de colonne fonctionne sur les PDF, les documents numérisés et même les captures d'écran d'e-mails. La logique d'extraction ne fait pas de distinction entre un PO généré par SAP et un autre saisi dans un document Word — elle lit le contenu, pas le format.
Pour une présentation plus détaillée de son fonctionnement en pratique, avec un guide champ par champ de l'extraction des bons de commande, consultez notre article sur l'extraction de champs spécifiques des bons de commande vers Excel sans modèles. Pour le traitement par lots — appliquer la même définition de colonne à des bons de commande de dizaines de clients différents en une seule opération — consultez notre guide sur le traitement par lots des bons de commande de tous les formats fournisseurs vers une seule feuille de calcul. Et pour le flux de travail d'automatisation de bout en bout, y compris la connexion des résultats d'extraction à votre système de gestion des commandes existant, consultez notre article sur l'automatisation de la saisie des données des bons de commande sans ERP.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Questions fréquentes
Pourquoi ne pouvons-nous pas simplement exiger que tous nos clients utilisent notre format de bon de commande ?
Vous pouvez essayer — et les grandes entreprises disposant d'un pouvoir de négociation important y parviennent parfois avec leurs plus gros fournisseurs. Mais pour la plupart des entreprises de taille moyenne, le rapport de force va dans l'autre sens : vous avez plus besoin de l'activité de vos clients qu'ils n'ont besoin de normaliser leur format de bon de commande. Même si un client accepte, mettre en œuvre le changement implique que son équipe informatique reconfigure une sortie ERP, la teste et la déploie — un projet avec un coût réel et aucun bénéfice direct pour eux. La plupart des équipes d'approvisionnement constatent que l'effort requis pour imposer la normalisation du format dépasse l'effort de gestion de la diversité des formats.
Mon ERP ne gère-t-il pas déjà la saisie des bons de commande ?
La plupart des modules d'approvisionnement des ERP gèrent la création des bons de commande — générer des commandes vers vos fournisseurs — mais sont bien moins performants pour la réception des bons de commande — ingérer les commandes de vos clients. Les ERP attendent des entrées structurées (EDI, importations CSV ou saisie directe) et ne fournissent aucun mécanisme intégré pour extraire des données structurées de PDF non structurés. Si vos clients vous envoient des bons de commande en pièces jointes PDF, votre ERP peut les stocker comme pièces jointes mais ne peut pas les lire sans outils d'extraction supplémentaires ou saisie manuelle.
Quelle est la précision de l'extraction basée sur l'IA pour les bons de commande avec des tableaux de lignes complexes ?
Les données de tableaux imprimés peuvent être reconnues avec une précision allant jusqu'à 99 % grâce aux modèles d'IA visuelle. Les cas les plus difficiles ne sont pas les longs tableaux — l'IA gère bien les structures répétitives — mais les documents où les lignes sont formatées en texte narratif plutôt qu'en lignes (courant dans les bons de commande de services), ou lorsque des annotations manuscrites ont été ajoutées aux tableaux imprimés. Pour ces cas particuliers, l'extraction doit être considérée comme une première passe qui réduit le travail manuel de 80 à 90 % plutôt que de l'éliminer entièrement. Les résultats doivent toujours être vérifiés avant d'être intégrés à un ERP ou à un système de gestion des commandes.
Et si mes clients envoient des bons de commande avec des modifications ou annotations manuscrites ?
L'extraction des noms de colonnes peut gérer l'écriture manuscrite, y compris les annotations sur les documents imprimés. L'IA lit le texte manuscrit comme faisant partie du contenu du document et le mappe aux champs appropriés en fonction du sens. La précision de l'écriture manuscrite est inférieure à celle du texte imprimé — en particulier pour l'écriture cursive ou les annotations au crayon léger — les bons de commande manuscrits doivent donc être vérifiés plus attentivement que les documents imprimés propres.
S'agit-il simplement d'un autre abonnement logiciel qui s'ajoute à l'ERP que nous payons déjà ?
Il répond à un besoin précis que la plupart des ERP ne couvrent pas : l'étape d'extraction entre la réception d'un bon de commande PDF et l'obtention de données structurées à traiter. Si vous payez actuellement pour cette étape avec le temps des acheteurs et des coordinateurs — et les références de coûts suggèrent que la plupart des fabricants de taille moyenne le font, à 95–145 $ par bon de commande — la comparaison n'est pas « logiciel contre absence de logiciel ». C'est « logiciel contre coût de main-d'œuvre ». Pour un fabricant traitant 200 bons de commande par mois, même une estimation prudente place le coût annuel de traitement manuel au-dessus de 200 000 $. La question pertinente est de savoir si un outil d'extraction réduit ce montant de plus que son coût — un calcul qui dépend de votre volume et de la complexité de vos bons de commande, et non du fait que l'outil s'intègre dans votre catégorie budgétaire ERP existante.
Là où le problème se situe réellement
Le problème de la saisie manuelle des données des bons de commande a survécu à des décennies de technologie d'automatisation pour une raison. Ce n'est pas que les équipes d'approvisionnement sont technophobes ou mal informées. C'est que la structure du problème — une variation infinie des formats, des incitations mal alignées entre acheteurs et fournisseurs, un paysage d'outils dominé par des approches basées sur des modèles qui ne peuvent pas s'adapter à divers formats — rend la solution évidente (acheter un logiciel d'automatisation) inefficace pour la majorité des relations d'approvisionnement.
L'EDI 850 a résolu ce problème pour les partenariats à fort volume qui peuvent justifier le coût de mise en place. L'extraction basée sur des modèles l'a résolu pour les cas où la stabilité du format est garantie. Mais entre ces deux solutions se trouve un vide qui contient la majorité de l'approvisionnement réel : des dizaines de clients, chacun avec son propre format de bon de commande, dont aucun ne se standardisera jamais à votre avantage. C'est dans ce vide que vit la saisie manuelle des données, et elle continuera d'y vivre jusqu'à ce que les équipes d'approvisionnement adoptent des outils qui n'ont pas besoin de standardisation des formats pour fonctionner.
Le passage de l'extraction basée sur des modèles à l'extraction basée sur le sens — de la question « où se trouve le champ » à « qu'est-ce que ce champ » — change l'économie du problème à sa racine structurelle. Lorsque la précision de l'extraction dépend de la compréhension sémantique plutôt que du mappage positionnel, la diversité des formats cesse d'être un obstacle et devient sans importance. Le coût de l'automatisation passe de « un modèle par fournisseur » à « une définition de colonne pour tous les fournisseurs ». La barrière à l'adoption n'est pas la capacité technique — c'est de reconnaître que la génération précédente d'outils d'automatisation a été conçue pour un monde où les formats de documents étaient stables, alors que la réalité de l'approvisionnement est tout le contraire.
Découvrez comment l'extraction par nom de colonne gère vos bons de commande réels — pour chaque format client, sans modèles.
Essayez maintenant →