O Problema da Inserção Manual de Dados de Ordens de Compra
— e o Que o Mantiene
Os dados do Open Standards Benchmarking da APQC revelam que as organizações gastam de $14 a mais de $54 para processar uma única ordem de compra. Para um fabricante de tamanho médio que emite 5.000 POs por ano, a diferença entre os de melhor e os de peor desempeño é a diferença entre $70.000 e $270.000 em custo anual de processamento. A pesquisa CAPS Research coloca a média intersetorial ainda mais alta, em $527 por PO em seu estudo mais recente. Os dados estão disponíveis há anos. O EDI 850 — o padrão ANSI X12 para ordens de compra eletrónicas — existe há décadas. E, no entanto, 75% das ordens de compra ainda são enviadas por e-mail ou fax, segundo uma pesquisa do setor da AutoQuotes, chegando a caixas de entrada onde alguien abre o anexo e começa a digitar. Isso não é uma brecha tecnológica. É um problema estrutural que a maioria das ferramentas de automatização nunca foi projetada para resolver.
Puntos Clave
- Doscientas órdenes de compra al mes a $120 cada una queman $288.000 al año en inserción manual de datos — un costo absorbido por los salarios de los compradores tan por completo que ningún CFO ha aprobado jamás una partida llamada 'Procesamiento Manual de PO'.
- Las herramientas de extracción basadas en plantillas no eliminaron el trabajo manual de PO — lo reubicaron de teclear números a construir y mantener cuarenta plantillas separadas, donde los fallos son silenciosos y se descubren solo después de que los pedidos se envían incorrectamente.
- La extracción que lee un campo de PO por lo que significa en lugar de por dónde se encuentra funciona de manera idéntica en todos los formatos de órdenes de compra de cada cliente — una definición de columna los cubre todos, con cero plantillas que construir o romper.
O Problema de $217 Que Ninguém Comenta
Pergunte a um gerente de compras quanto custa processar uma ordem de compra e você geralmente receberá um olhar vazio. Não porque eles não se importam com custos — eles se importam. Mas porque o custo da entrada manual de dados de PO está distribuído de forma tão uniforme nas operações diárias que desaparece no cenário. Não é um item de linha no orçamento de ninguém. É apenas "o que fazemos".
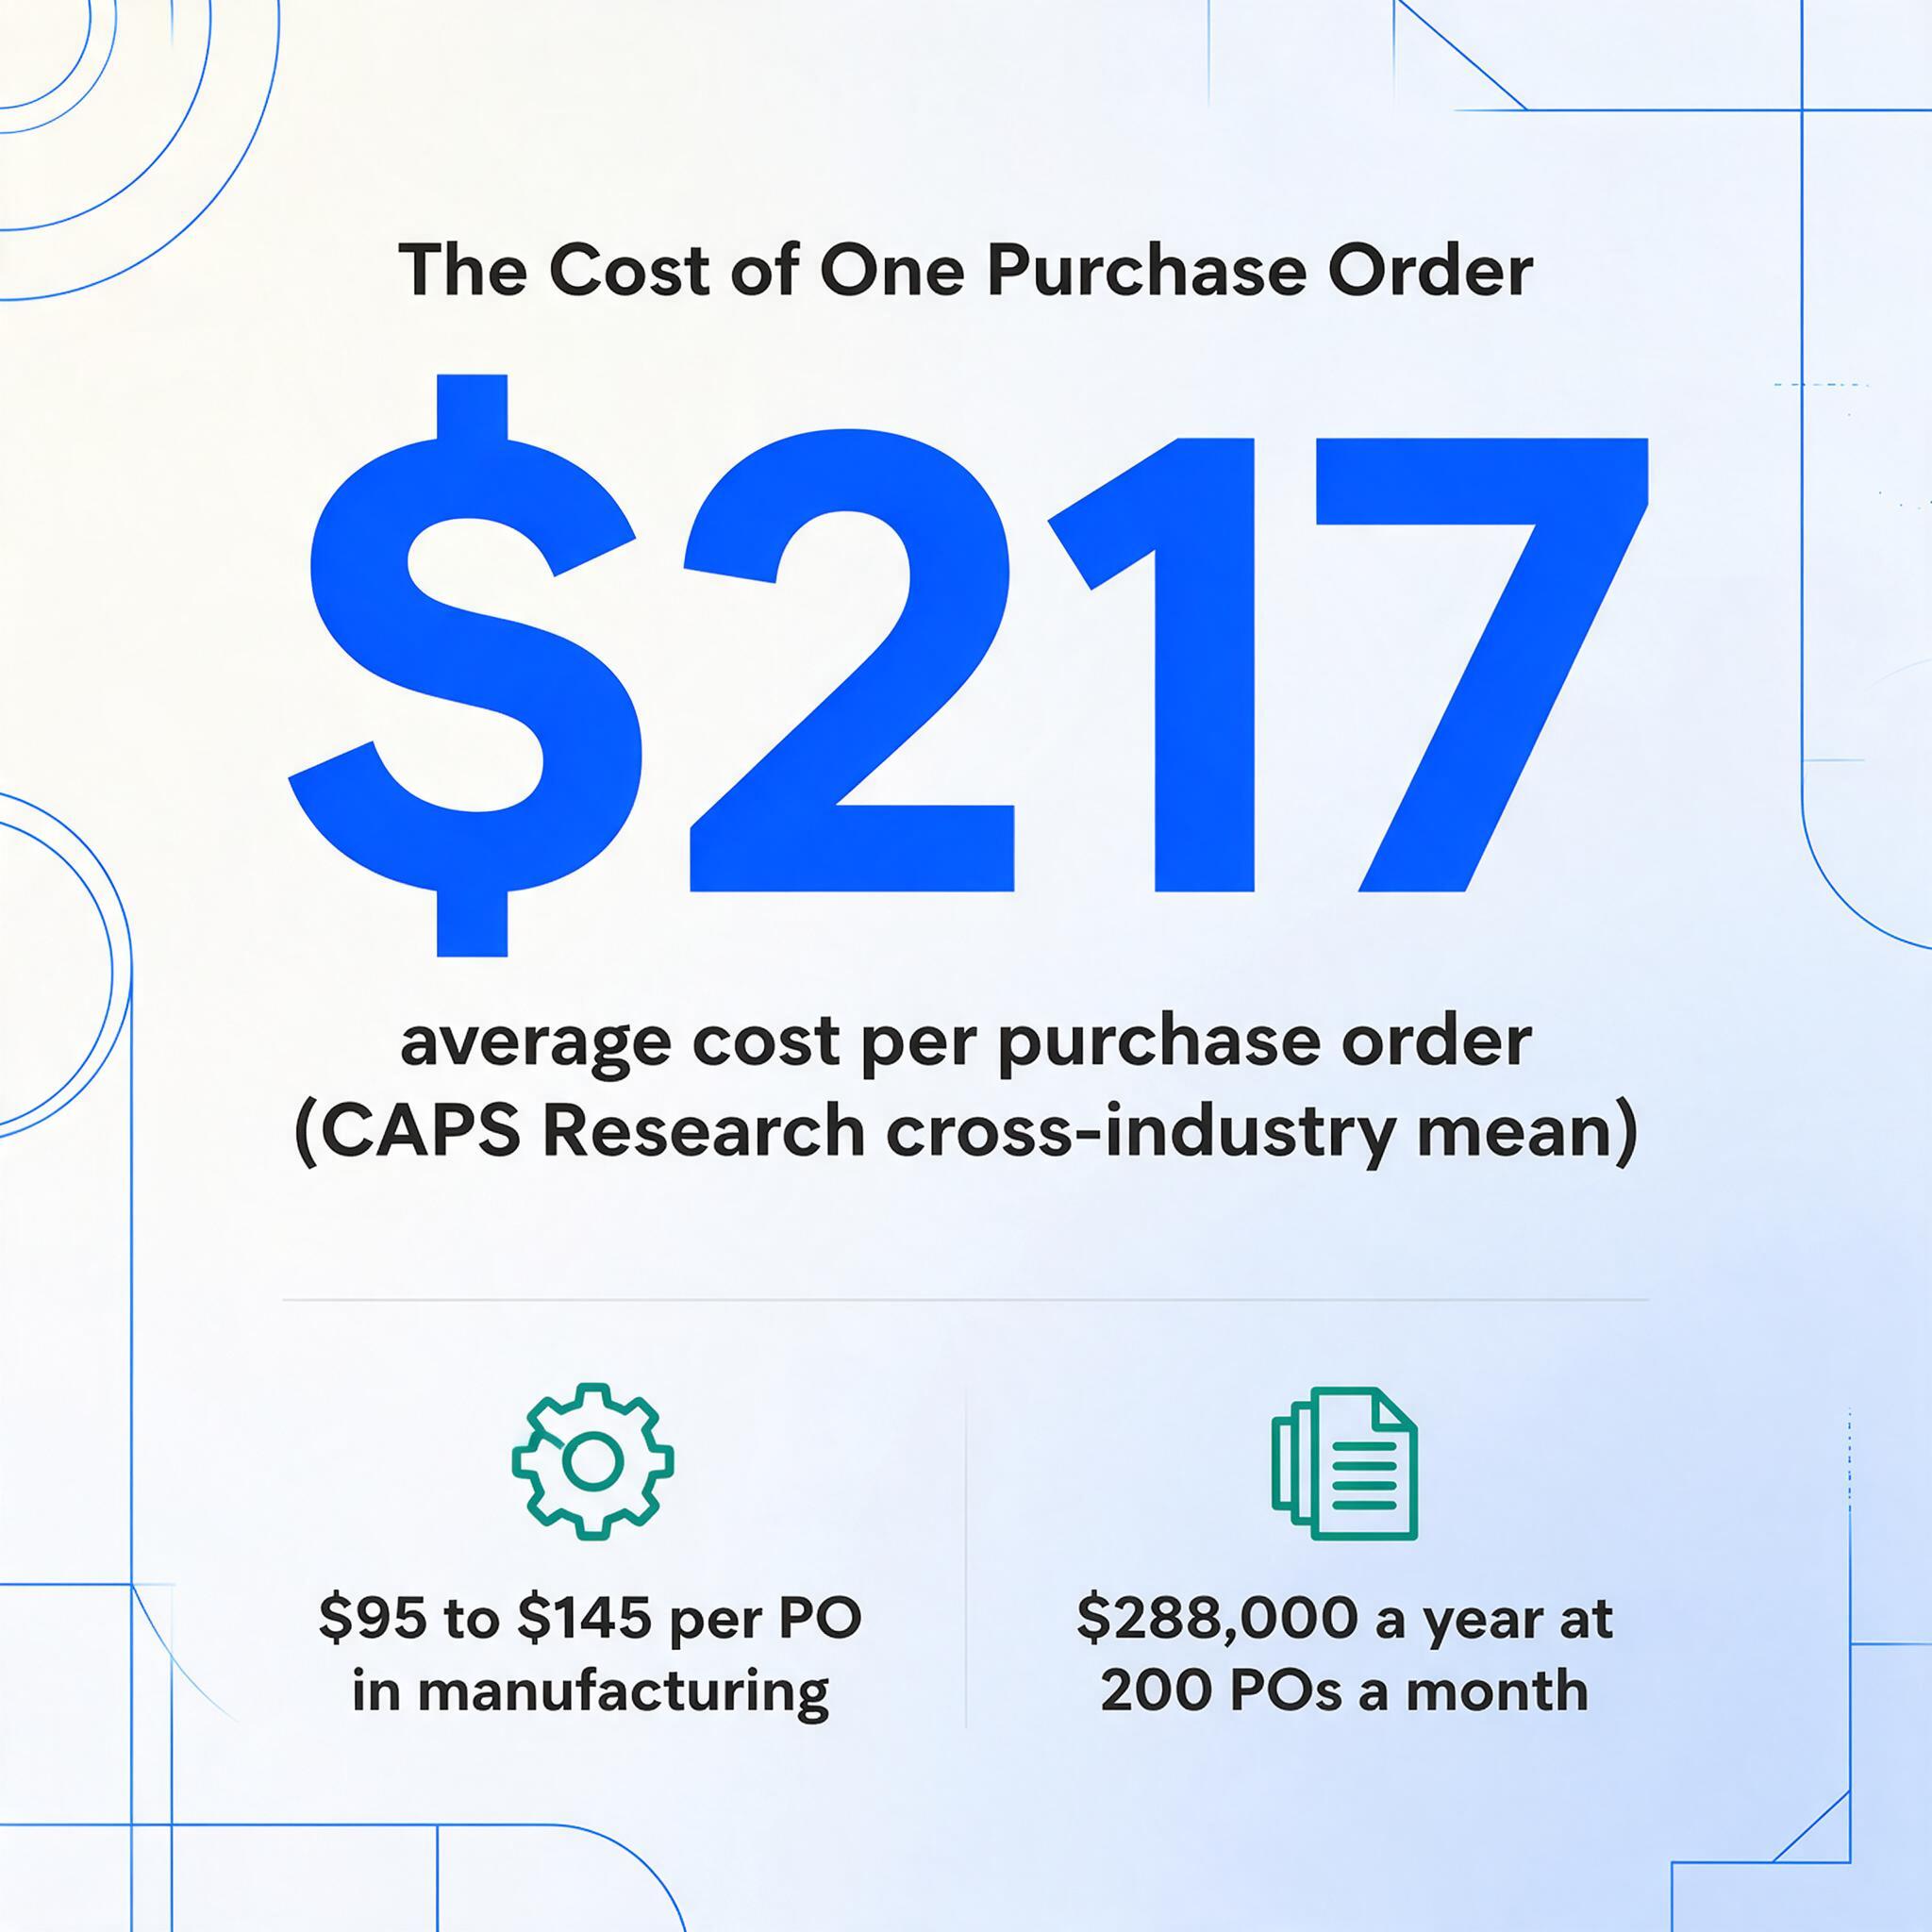
O Center for Advanced Procurement Strategy (CAPS Research) mede os custos de processamento de PO há anos. Seus dados entre setores mostram um custo médio por PO variando de cerca de $50 a mais de $1.000, dependendo do setor, com uma média em torno de $217. Estimativas específicas de manufatura de múltiplas fontes convergem em $95–$145 por PO. Esse número inclui não apenas o trabalho visível de digitar dados — inclui acompanhamentos por e-mail, verificações de status, correções de erros, resolução de pedidos duplicados e o tempo gasto reconciliando inconsistências entre o que o PO diz e o que o fornecedor realmente enviou.
Uma empresa que processa 200 POs por mês a $120 cada está gastando $288.000 por ano apenas no custo administrativo de mover dados de pedidos de um documento para outro. E esse é o caso mediano. No extremo superior — POs complexos de manufatura com tabelas de 50 itens de linha e aprovações em vários níveis — o custo pode exceder $500 por PO.
O número em si não é o ponto. O ponto é que esses custos foram medidos, publicados e comparados por organizações de pesquisa independentes por mais de uma década. Todo líder de compras tem acesso a esses dados. As ferramentas de automação que poderiam reduzir esses custos existem. E ainda assim a lacuna entre "conhecer o número" e "mudar o número" persiste na maioria das empresas de manufatura e distribuição de médio porte. A pergunta que vale a pena fazer não é "quanto custa" — é por que continua custando tanto, ano após ano, quando a solução não é um mistério?
Não é um problema. É uma pilha de três.
Pergunte a um fornecedor de software o que há de errado com o processamento manual de ordens de compra e ele dará uma resposta de uma frase: a entrada de dados é lenta e propensa a erros. Essa resposta é tecnicamente verdadeira. Também é inútil como diagnóstico. O problema real não é que as equipes de compras estão digitando quando poderiam estar clicando. O problema real é uma estrutura de três camadas que torna a digitação funcionalmente inevitável nas condições atuais do setor.
Camada um: fragmentação de formato. A ordem de compra de cada cliente é organizada de forma diferente. Um coloca o número da PO no canto superior direito. Outro o coloca em um bloco de cabeçalho à esquerda. Um terceiro o incorpora em um código de barras na página dois. A tabela de itens — que pode ter 5, 50 ou 300 linhas de profundidade — pode ter seis colunas de largura, ou catorze. Os códigos de item podem estar na coluna um ou na coluna quatro. As datas de entrega podem aparecer por item ou como um único campo no cabeçalho. Como um usuário do Reddit em r/manufacturing disse: "O maior problema para nós é que as ordens de compra dos clientes não vêm no mesmo formato. Cada um usa um formato de PO diferente, até mesmo nos nomes dos campos."
Esta não é uma observação nova. Todo profissional de compras sabe disso. O que é menos compreendido é que a fragmentação de formato não é um bug — é o estado de equilíbrio do sistema. O formato de PO de cada empresa é gerado pelo seu ERP, que foi configurado para corresponder às suas estruturas de dados internas, que evoluíram ao longo de anos de decisões específicas do negócio. Pedir a 80 clientes que padronizem seus formatos de PO não é uma solicitação de compras. É pedir a 80 empresas que reconfigurassem suas saídas de ERP — uma tarefa com ROI zero da perspectiva delas.
Camada dois: desalinhamento de incentivos do fornecedor. Se você é um fabricante que recebe POs de clientes, você tem fortes incentivos para automatizar a entrada de dados. Cada minuto economizado na digitação é um minuto devolvido ao planejamento da produção, à gestão de estoque ou à negociação com fornecedores. Mas se você é o cliente que envia a PO, você tem exatamente zero incentivo para mudar seu formato para facilitar a vida do fornecedor. A PO sai do mesmo jeito que sempre saiu — gerada pelo seu ERP, anexada em PDF a um e-mail — e o fardo da entrada de dados do fornecedor é invisível para você. Essa assimetria é fundamental. A parte que controla o formato não tem incentivo para padronizá-lo, e a parte que precisa da padronização não tem influência para exigi-la.
Camada três: incompatibilidade de ferramentas. A abordagem dominante para extração de dados de documentos nas últimas duas décadas tem sido baseada em modelos: você desenha caixas ao redor dos campos em um documento de amostra, rotula-os, e a ferramenta extrai dados de qualquer documento subsequente que corresponda ao mesmo layout. Isso funciona para faturas de um único fornecedor. Colapsa para POs de 40 clientes diferentes. Cada cliente precisa de um modelo separado. Cada modelo leva tempo para ser construído. E quando um cliente atualiza seu ERP ou muda o layout da PO — o que acontece durante migrações de sistemas, aquisições ou rebranding — o modelo quebra silenciosamente, produzindo dados distorcidos ou nada. O trabalho que você estava tentando eliminar (entrada manual de dados) foi substituído por um tipo diferente de trabalho manual (manutenção de modelos).
Essas três camadas se potencializam mutuamente. A fragmentação de formatos é a realidade de base. Os incentivos dos fornecedores impedem que ela se resolva sozinha. Ferramentas baseadas em modelos a transformam em um teto de escalabilidade — você pode automatizar a entrada de dados de ordens de compra para cinco clientes, mas não para cinquenta. O resultado é um cenário de compras em que 57% dos líderes de procurement ainda dependem de entrada manual de dados para ordens de compra, não porque não ouviram falar de automação, mas porque a automação que experimentaram não conseguiu lidar com a diversidade de formatos da sua base real de fornecedores.
A EDI Resolveu Isso para as Maiores Empresas do Mundo. Para Todos os Outros, Ela Criou um Teto.
Se você trabalha com procurement há mais de alguns anos, já ouviu o discurso da EDI. A EDI 850 — o padrão ANSI X12 para ordens de compra eletrônicas — define um formato estruturado para a troca de POs entre máquinas. Quando ambas as partes usam EDI, as ordens de compra fluem do ERP do comprador diretamente para o sistema de gerenciamento de pedidos do fornecedor, sem intervenção humana. Sem PDFs. Sem digitação. Sem variação de formato, porque ambos os lados estão em conformidade com o mesmo conjunto de transações.
Funciona perfeitamente — para os relacionamentos em que é implementada. Grandes fabricantes automotivos, grandes varejistas e empresas aeroespaciais de primeira linha usam EDI com seus fornecedores de nível um há décadas. A cadeia de suprimentos do Walmart entraria em colapso sem ela.
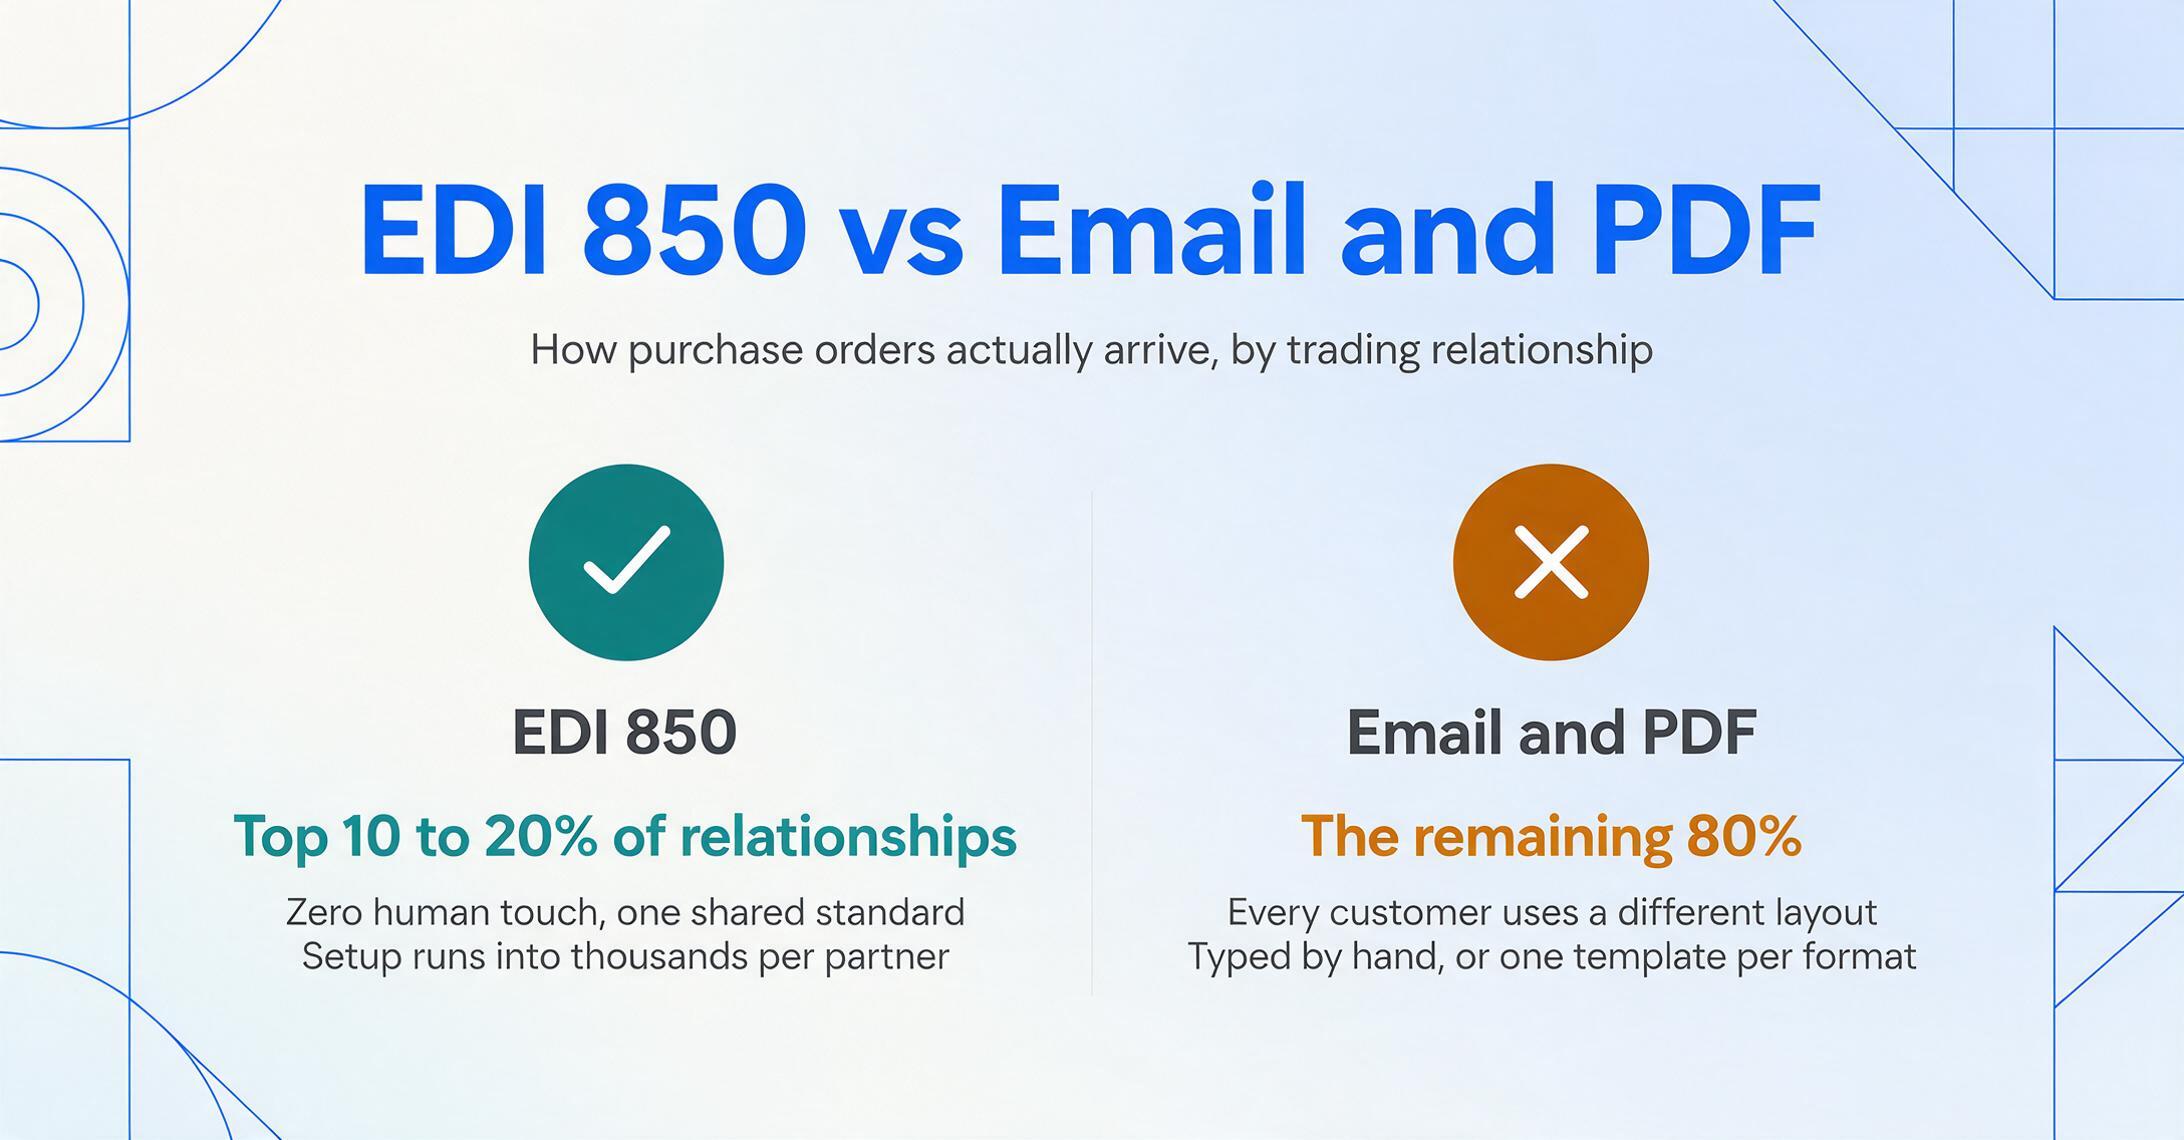
O problema é que a curva de adoção da EDI tem um teto rígido. Implementar EDI exige infraestrutura técnica em ambos os lados — software de tradução EDI, protocolos de comunicação (AS2, VAN) e lógica de mapeamento para traduzir entre os segmentos da EDI 850 (BEG, N1, PO1, PID, CTT) e as estruturas de dados internas de cada parte. O custo de configuração chega a milhares de dólares por parceiro comercial. Para relacionamentos de alto volume — um fabricante que faz pedidos semanais no valor de milhões — o ROI se paga instantaneamente. Para a longa cauda de clientes que fazem pedidos trimestralmente ou esporadicamente — o que descreve a maioria dos relacionamentos B2B de médio porte — ele nunca se paga.
O resultado é uma realidade de procurement em dois níveis. Os 10–20% principais dos relacionamentos comerciais operam com EDI. Os 80% restantes operam por e-mail e PDF. O segundo grupo é onde vive a entrada manual de dados — e onde continuará vivendo enquanto as opções de automação exigirem padronização de formato que esses relacionamentos não podem suportar economicamente.
A CAPS Research descobriu que 31% dos líderes de cadeia de suprimentos dizem que softwares de procurement desatualizados bloqueiam a execução, e 37% citam problemas de acesso a dados como uma das principais barreiras. Esses números não descrevem empresas que desconhecem a automação. Descrevem empresas que a avaliaram e descobriram que a economia não funciona para a maioria do seu portfólio de fornecedores.
A Armadilha do Modelo: Automação Que Cria Novo Trabalho Manual
Em teoria, a extração baseada em modelos é uma abordagem razoável. Você mostra à ferramenta um documento de exemplo, marca onde cada campo está e a ferramenta replica esse padrão de extração em documentos futuros. É assim que a maioria das ferramentas de automação de documentos — de plataformas empresariais de IDP a produtos SaaS mais leves — funciona desde os primórdios do OCR.
Na prática, a extração baseada em modelos tem uma propriedade de escalabilidade fatal: o número de modelos necessários cresce linearmente com o número de formatos distintos de documentos que você recebe. Se você tem 40 clientes e cada um usa um layout de PO diferente, você precisa de 40 modelos. Cada novo cliente exige uma nova sessão de configuração de modelo — normalmente de 10 a 15 minutos para identificar campos, desenhar regiões e verificar a precisão da extração. Quando o cliente nº 41 chega, alguém precisa parar o que está fazendo e criar o modelo nº 41.
Isso cria uma inversão da promessa da automação. A ferramenta deveria eliminar o trabalho manual repetitivo. Em vez disso, ela criou uma nova classe de trabalho manual repetitivo — a manutenção de modelos — que é menos visível, mas igualmente demorada. E, ao contrário da entrada de dados, as falhas de modelo são silenciosas. Quando um cliente altera silenciosamente o formato do PO (novo ERP, nova identidade visual, consolidação de formato por fusão), o modelo não gera um erro. Ele extrai dados incorretos ou dados ausentes, que você descobre mais adiante — quando o pedido está errado, a remessa é desviada ou a fatura não confere.
A estrutura de custos é insidiosa. Um erro manual de entrada de dados — uma quantidade digitada errada ou um número de peça invertido — geralmente é detectado no mesmo fluxo de trabalho, pela mesma pessoa ou pela validação downstream. Uma falha de modelo produz erros sistemáticos: todo PO do Cliente X agora está sem o campo de data de entrega, e ninguém sabe até o armazém ligar perguntando para onde enviar. O custo do erro por incidente é maior e a latência de detecção é mais longa.
Para um fabricante de médio porte que processa POs de 20 a 80 clientes diferentes em vários ecossistemas de ERP — SAP, NetSuite, Microsoft Dynamics, Epicor, Sage, Infor — a abordagem de modelo não reduz o trabalho. Ela o realoca da mesa de entrada de dados para a tela de configuração de modelos. E, para equipes de compras que não têm engenheiros de automação dedicados, essa realocação piora o problema, em vez de melhorá-lo.
O Que as Equipes de Compras Realmente Fazem Todos os Dias
Por trás dos benchmarks de custo e da análise estrutural, há um fluxo de trabalho real que se repete milhares de vezes por dia nos departamentos de compras da indústria. Vale a pena descrevê-lo claramente — não como uma cena inventada, mas como um retrato do que profissionais de compras descrevem no Reddit e em fóruns do setor.
A caixa de entrada tem novas mensagens de clientes. Cada uma é um anexo de ordem de compra, geralmente um PDF. Algumas chegam por um portal do cliente; a maioria chega por e-mail. O coordenador de compras abre a primeira. É de um cliente que usa NetSuite — o número da PO está no cabeçalho, o código do fornecedor está em um campo de referência, os itens estão em uma tabela de 9 colunas. Ele abre sua planilha ou ERP e começa a digitar: número da PO, data, nome do cliente, endereço de entrega. Depois os itens, uma linha por vez: código do item, descrição, quantidade, unidade de medida, preço unitário, preço total. Se a PO tem 15 itens, são 90 pontos de dados individuais para transferir, manualmente, sem trocar um dígito ou pular uma linha.
A segunda PO é de um cliente que usa SAP. O layout é completamente diferente. O número da PO está no canto superior direito. O nome do cliente está em outra posição. A tabela de itens tem 12 colunas em vez de 9, com campos adicionais para localização do armazém e data de entrega por linha. Os nomes dos campos são diferentes — a SAP chama de "Material" enquanto a NetSuite diz "Código do Item".
A terceira PO é de um cliente sem ERP algum — é um documento do Word convertido em PDF, com os itens formatados como uma lista com marcadores em vez de uma tabela. Uma ferramenta de extração baseada em modelos falharia imediatamente. Uma pessoa consegue ler, mas o atrito cognitivo de alternar entre três estruturas de documento completamente diferentes várias vezes por hora é o verdadeiro dreno de produtividade — não a velocidade de digitação.
Como um usuário do Reddit em r/procurement descreveu: "Estávamos literalmente pegando PDFs de fornecedores, copiando valores para planilhas, conferindo cada linha contra a PO, enviando e-mails para fornecedores sobre divergências, colando tudo no ERP porque nenhum desses sistemas conversa entre si. Metade do trabalho é tarefa administrativa disfarçada de gestão de fornecedores."
O que impressiona nessa descrição não é a ineficiência — é a precisão. Os sistemas realmente não conversam entre si. O PDF é um formato sem saída: ele preserva o layout visual, mas destrói a estrutura dos dados. O ERP no lado receptor espera uma entrada estruturada e mapeada por campos. Entre esses dois formatos está um ser humano, reconstruindo manualmente a estrutura de dados que foi perdida quando a PO saiu do sistema do cliente. Esse ser humano não está agregando valor. Ele está realizando tradução de formato — uma tarefa que o software deveria lidar, mas não consegue, porque os formatos continuam mudando.
A Inércia Organizacional que Normaliza a Entrada Manual
Se o custo da entrada manual de dados de PO é mensurável e as ferramentas para reduzi-lo existem, por que o mercado não resolveu isso? A resposta vai além da tecnologia — está enraizada no comportamento organizacional e nos incentivos dos fornecedores.
O custo é invisível para os tomadores de decisão. A entrada manual de dados de PO não aparece como uma despesa discreta. São horas de tempo de compradores e coordenadores distribuídas ao longo da semana de trabalho, categorizadas como "despesas operacionais" em vez de "mão de obra de entrada de dados". Nenhum CFO aprova um item de linha chamado "Processamento Manual de PO — $288.000". O custo é real, mas é absorvido em salários que existiriam de qualquer forma. Essa invisibilidade contábil significa que não há um dono natural de orçamento para a correção. TI não é dona da eficiência de compras. Compras não é dona da avaliação de software. Finanças não vê o item de linha. O problema cai nas lacunas entre departamentos.
Falhas de automação são mais visíveis do que o trabalho manual árduo. Quando a entrada manual de dados produz um erro, a correção é direta: encontrar o erro, corrigi-lo, enviar um pedido atualizado. É irritante, mas rotineiro. Quando uma ferramenta de automação produz um erro, a falha é maior, mais visível e mais difícil de diagnosticar. Um lote de 50 POs processados automaticamente com um mapeamento de campos quebrado pode criar 50 pedidos incorretos — uma crise que cai na mesa de um gerente. O profissional de compras que defendeu a automação recebe a culpa. A lição que a maioria das organizações tira de uma experiência ruim com automação é "nossos documentos são complexos demais para ferramentas lidarem" em vez de "usamos o tipo errado de ferramenta para nossa diversidade de formatos". Essa assimetria de risco — falhas automatizadas têm custo organizacional maior do que as manuais — cria um forte viés em direção ao status quo.
Fornecedores de ERP têm os incentivos errados. As empresas mais bem posicionadas para resolver a entrada de dados de PO — SAP, Oracle, Microsoft, NetSuite, Epicor — são as empresas com menos incentivo para fazê-lo. Seus módulos de compras assumem entrada estruturada. Sua abordagem de vendas é construída em torno da adoção do pacote completo, não da extração de soluções pontuais. Quando um cliente pergunta "como faço para inserir os dados de PO dos meus clientes no seu sistema", a resposta típica é "faça seus clientes usarem nosso portal", ou "configure EDI", ou "insira manualmente". Todas as três respostas aceitam o problema de formato como externo à solução. O modelo de negócios do fornecedor de ERP depende de você adotar sua plataforma de ponta a ponta — não de resolver a etapa de extração que fica na fronteira entre seu sistema e os sistemas dos seus clientes.
O problema foi normalizado através de gerações de profissionais de compras. Pessoas que estão em compras há 15 anos não lembram de uma época em que a entrada de dados de PO não era manual. Elas construíram seu fluxo de trabalho em torno disso. Têm atalhos de Excel, macros e modelos mentais que tornam a entrada manual tolerável. Sugerir automação não soa como melhoria de eficiência — soa como ameaçar um sistema que, apesar de todas as suas falhas, tem enviado pedidos de forma confiável por anos. O custo operacional da mudança — aprender uma nova ferramenta, confiar em sua saída, lidar com os casos extremos quando ela falha — parece maior do que o custo operacional do status quo, mesmo quando a matemática diz o contrário.
Nenhum desses fatores é sobre capacidade tecnológica. Eles são sobre estruturas de incentivo, percepção de risco e hábito organizacional. As ferramentas para automatizar a entrada de dados de PO existem. A razão pela qual não foram amplamente adotadas não é que não funcionam — é que as ferramentas mais disponíveis (extração baseada em modelos, módulos ERP completos, EDI) impõem requisitos — padronização de formato, configuração por fornecedor, sobrecarga de integração — que fazem o custo de adoção exceder o ROI para a maioria dos relacionamentos de compras.
O Que Realmente Mudaria a Equação
Se o problema raiz é a fragmentação de formatos — documentos que carregam a mesma informação lógica (número do PO, itens de linha, quantidades, preços) organizados em layouts físicos ilimitados — então a solução não pode ser uma ferramenta que exige que você considere cada layout individualmente. Tem que ser uma ferramenta que não se importa com o layout.
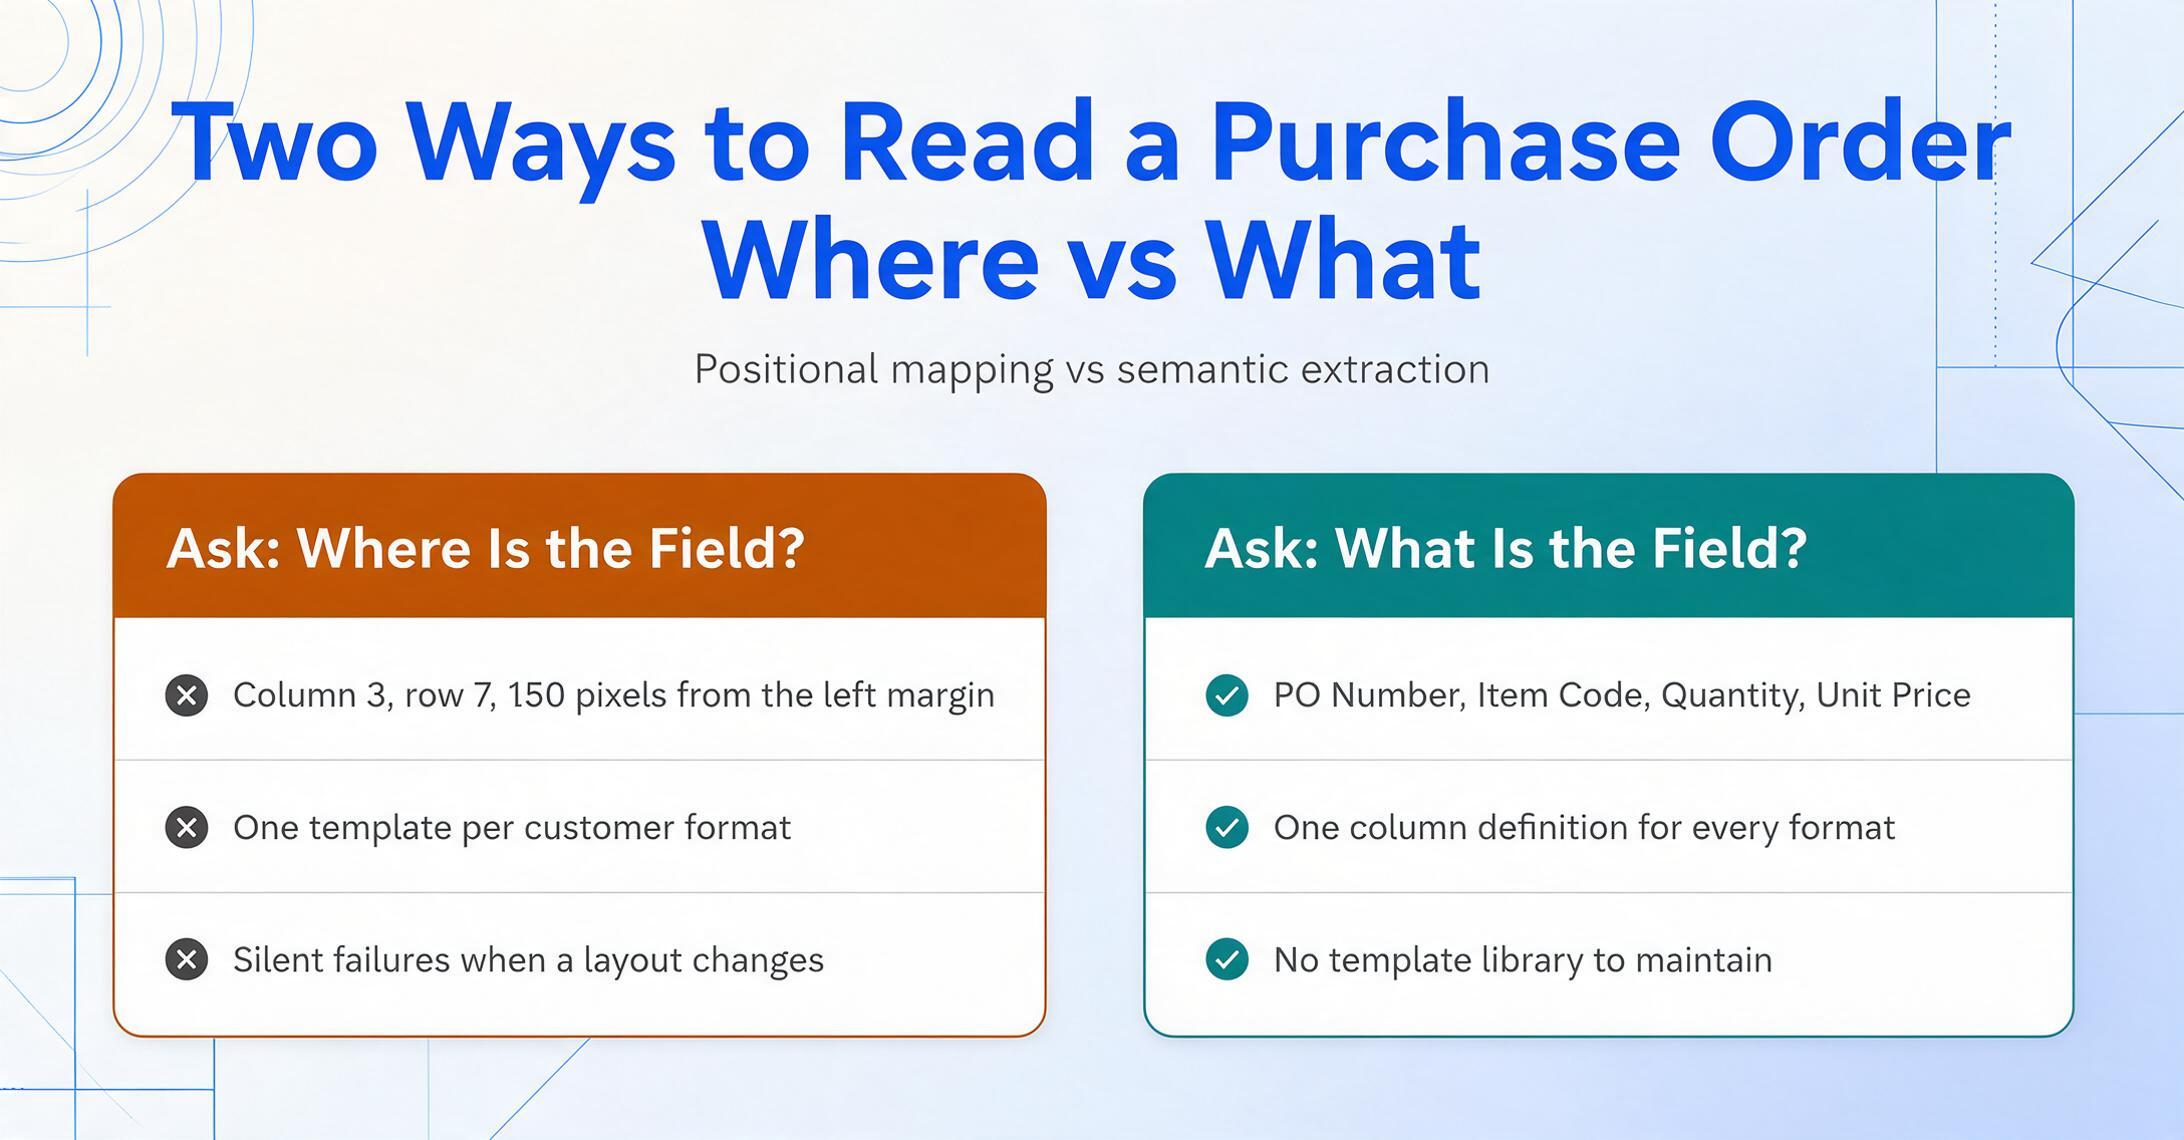
Esta é a diferença entre extração baseada em modelos e extração baseada no significado. Um modelo pergunta: onde está o campo? Coluna 3, linha 7, 150 pixels da margem esquerda. Uma abordagem baseada no significado pergunta: o que é o campo? Ela procura texto que corresponda ao papel semântico de "Número do PO" — um identificador único perto do topo do documento, tipicamente alfanumérico, frequentemente rotulado com uma variação de "PO #" ou "Número do Pedido" ou "Nº da Ordem de Compra" — e extrai o valor independentemente de onde ele está na página.
É isso que a extração por nome de coluna faz: você define as colunas que deseja — "Número do PO," "Nome do Fornecedor," "Código do Item," "Quantidade," "Preço Unitário," "Total da Linha" — e a IA localiza cada valor entendendo o que significa, não onde está. Os nomes de coluna que você insere se tornam os cabeçalhos da tabela de saída. Uma definição de coluna funciona em todos os formatos de PO dos clientes, porque a lógica de extração é semântica, não posicional.
As implicações estruturais são significativas:
- Operação sem modelo. Sem configuração por cliente. Sem biblioteca de modelos para manter. Sem falhas silenciosas quando um cliente muda o layout do PO. A extração se adapta automaticamente à estrutura de cada documento.
- Manipulação de itens de linha. A carga principal de uma ordem de compra é sua tabela de itens de linha, que pode abranger dezenas de linhas com configurações de coluna variadas. A extração por nome de coluna lê cada linha como um registro completo, mapeando a quantidade, descrição e preço corretos para cada linha — incluindo tabelas divididas em várias páginas.
- Entradas multi-formato. A mesma definição de coluna funciona em PDFs, documentos digitalizados e até capturas de tela de e-mail. A lógica de extração não distingue entre um PO gerado pelo SAP e um digitado em um documento do Word — ela lê o conteúdo, não o formato.
Para um passo a passo mais detalhado de como isso funciona na prática, incluindo um guia campo a campo para extração de ordens de compra, consulte nosso artigo sobre extração de campos específicos de ordens de compra para Excel sem modelos. Para processamento em lote — executar a mesma definição de coluna em ordens de compra de dezenas de clientes diferentes em uma única operação — consulte nosso guia sobre processamento em lote de ordens de compra de todos os formatos de fornecedores em uma única planilha. E para o fluxo de trabalho de automação de ponta a ponta, incluindo como conectar a saída da extração ao seu sistema de gerenciamento de pedidos existente, consulte nosso artigo sobre automação da entrada de dados de ordens de compra sem ERP.
Os arquivos são processados com segurança e não são armazenados.
Perguntas Frequentes
Por que não podemos simplesmente exigir que todos os nossos clientes usem nosso formato de ordem de compra?
Você pode tentar — e grandes empresas com poder de compra significativo às vezes conseguem com seus maiores fornecedores. Mas para a maioria das empresas de médio porte, o poder flui na direção oposta: você precisa dos negócios dos seus clientes mais do que eles precisam padronizar a emissão de suas ordens de compra. Mesmo que um cliente concorde, implementar a mudança significa que o time de TI deles reconfigura uma saída de ERP, testa e implanta — um projeto com custo real e zero benefício direto para eles. A maioria das equipes de compras descobre que o esforço necessário para impor a padronização de formato excede o esforço de lidar com a diversidade de formatos.
Meu ERP já não lida com a entrada de dados de ordens de compra?
A maioria dos módulos de compras de ERP lida com a criação de ordens de compra — gerando ordens de compra para seus fornecedores — mas é muito mais fraca no recebimento de ordens de compra — ingerindo ordens de compra dos seus clientes. ERPs esperam entrada estruturada (EDI, importações CSV ou entrada direta de dados) e não fornecem mecanismo embutido para extrair dados estruturados de PDFs não estruturados. Se seus clientes enviam ordens de compra como anexos em PDF, seu ERP pode armazená-los como anexos, mas não pode lê-los sem ferramentas adicionais de extração ou entrada manual.
Qual é a precisão da extração baseada em IA para ordens de compra com tabelas complexas de itens de linha?
Dados de tabelas impressas podem ser reconhecidos com até 99% de precisão usando modelos de IA visual. Os casos mais difíceis não são as tabelas longas — a IA lida bem com estruturas repetitivas — mas documentos onde os itens de linha são formatados como texto narrativo em vez de linhas (comum em ordens de compra baseadas em serviços), ou onde anotações manuscritas foram adicionadas a tabelas impressas. Para esses casos extremos, a extração deve ser tratada como uma primeira passada que reduz o trabalho manual em 80–90% em vez de eliminá-lo completamente. Os resultados devem sempre ser revisados antes de serem comprometidos em um ERP ou sistema de gerenciamento de pedidos.
E se meus clientes enviarem ordens de compra com alterações ou anotações manuscritas?
A extração de nomes de colunas pode lidar com manuscritos, incluindo anotações em documentos impressos. A IA lê o texto manuscrito como parte do conteúdo do documento e o mapeia para os campos apropriados com base no significado. A precisão para manuscritos é menor do que para texto impresso — particularmente para anotações cursivas ou a lápis claro — então ordens de compra manuscritas devem ser revisadas com mais cuidado do que as impressas limpas.
Isso é apenas mais uma assinatura de software por cima do ERP que já pagamos?
Ele resolve uma lacuna específica que a maioria dos ERPs não cobre: a etapa de extração entre receber um PDF de ordem de compra e ter dados estruturados para trabalhar. Se você atualmente paga por essa etapa com o tempo de compradores e coordenadores — e os benchmarks de custo sugerem que a maioria dos fabricantes de médio porte paga, entre US$ 95 e US$ 145 por PO — a comparação não é "software vs. sem software". É "software vs. custo de mão de obra". Para um fabricante que processa 200 POs por mês, mesmo uma estimativa conservadora coloca o custo anual de processamento manual acima de US$ 200.000. A pergunta relevante é se uma ferramenta de extração reduz esse número mais do que custa — um cálculo que depende do volume e da complexidade das suas POs, não de a ferramenta caber ou não na sua categoria de orçamento de ERP existente.
Onde o Problema Realmente Está
O problema de entrada de dados de ordens de compra sobreviveu a décadas de tecnologia de automação por um motivo. Não é que as equipes de compras sejam tecnofóbicas ou desinformadas. É que a estrutura do problema — variação infinita de formatos, incentivos desalinhados entre compradores e fornecedores, um cenário de ferramentas dominado por abordagens baseadas em modelos que não escalam entre formatos diversos — torna a solução óbvia (comprar software de automação) ineficaz para a maioria dos relacionamentos de compras.
O EDI 850 resolveu isso para as parcerias de alto volume que podem justificar o custo de configuração. A extração baseada em modelos resolveu isso para os casos em que a estabilidade do formato é garantida. Mas entre essas duas soluções existe uma lacuna que contém a maioria das compras do mundo real: dezenas de clientes, cada um com seu próprio formato de PO, nenhum dos quais jamais padronizará em seu benefício. Essa lacuna é onde vive a entrada manual de dados, e continuará vivendo lá até que as equipes de compras adotem ferramentas que não precisem de padronização de formato para funcionar.
A mudança da extração baseada em modelos para a extração baseada no significado — de perguntar "onde está o campo" para perguntar "o que é o campo" — muda a economia do problema em sua raiz estrutural. Quando a precisão da extração depende da compreensão semântica em vez do mapeamento posicional, a diversidade de formatos deixa de ser uma barreira e passa a ser irrelevante. O custo da automação cai de "um modelo por fornecedor" para "uma definição de coluna para todos os fornecedores". A barreira de adoção não é a capacidade técnica — é reconhecer que a geração anterior de ferramentas de automação foi projetada para um mundo onde os formatos de documentos eram estáveis, e a realidade das compras é o oposto.
Veja como a extração por nome de coluna lida com suas POs reais — em todos os formatos de clientes, sem modelos.
Experimente Agora →