請求書の明細行の計算が
抽出後に間違っている理由
請求書抽出ツールが仕入先名、請求書番号、合計金額は正しく取得しました。しかし明細行を確認すると、何かがおかしいことに気づきます。3行目はQty 4、Unit Price $150.00、Line Total $300.00 — $300不足しています。それなのに、各フィールドはきれいに見えます。AIは何も読み間違えていません。何かを誤って対応付けたのです。
重要なポイント
- AI請求書抽出ツールがフィールド信頼度99%と報告しても、Qty × Priceの計算が依然として間違っていることがあります。フィールドごとの信頼度スコアは読み取りやすさを測るものであり、単価が2行目に属するか3行目に属するかを判定するものではないからです。
- Qty × Priceの不一致は4つのパターンに分類されます。乖離の大きさと方向から、AIが行をクロス対応付けしたのか、単位の乗数を逃したのか、割引前と割引後の金額を混同したのかがわかります。
- 1つの計算式列 — =ROUND(Qty×UnitPrice,2) — で4つのパターンすべてを検出できます。追加に5分かかるこの列は、どの信頼度スコアよりも抽出品質を正確に示します。
これはAIによる請求書抽出において最も静かな障害モードです。AIは個々のフィールドで98%以上の精度を達成します。数量、単価、行合計を単独の値として正しく読み取ります。しかし、フィールド間の整合性は根本的に異なる課題です。「$150.00」を高い信頼度でページから読み取れるビジョンモデルでも、その$150.00が2行目の単価なのか、3行目の行合計なのか、セクション小計なのかを自動的に判断することはできません。これらの関係が崩れると、明細行の計算が合わなくなり、そのエラーはフィールドごとの信頼度スコアでは見えません。
2025年のDoclingとLlamaExtractorに関する研究がこのギャップを裏付けています:整合性チェック(明細行 + 税 = 合計)は請求書の20%で失敗しました — そのほとんどは複雑な複数税率シナリオや非標準的なフォーマットのものでした(arXiv 2510.15727v1)。出力で数量×価格の不一致が見られる場合、請求書はおそらく4つの明確なパターンのいずれかに該当します。
原因1:AIが1行目のQtyと2行目のPriceをペアリングした
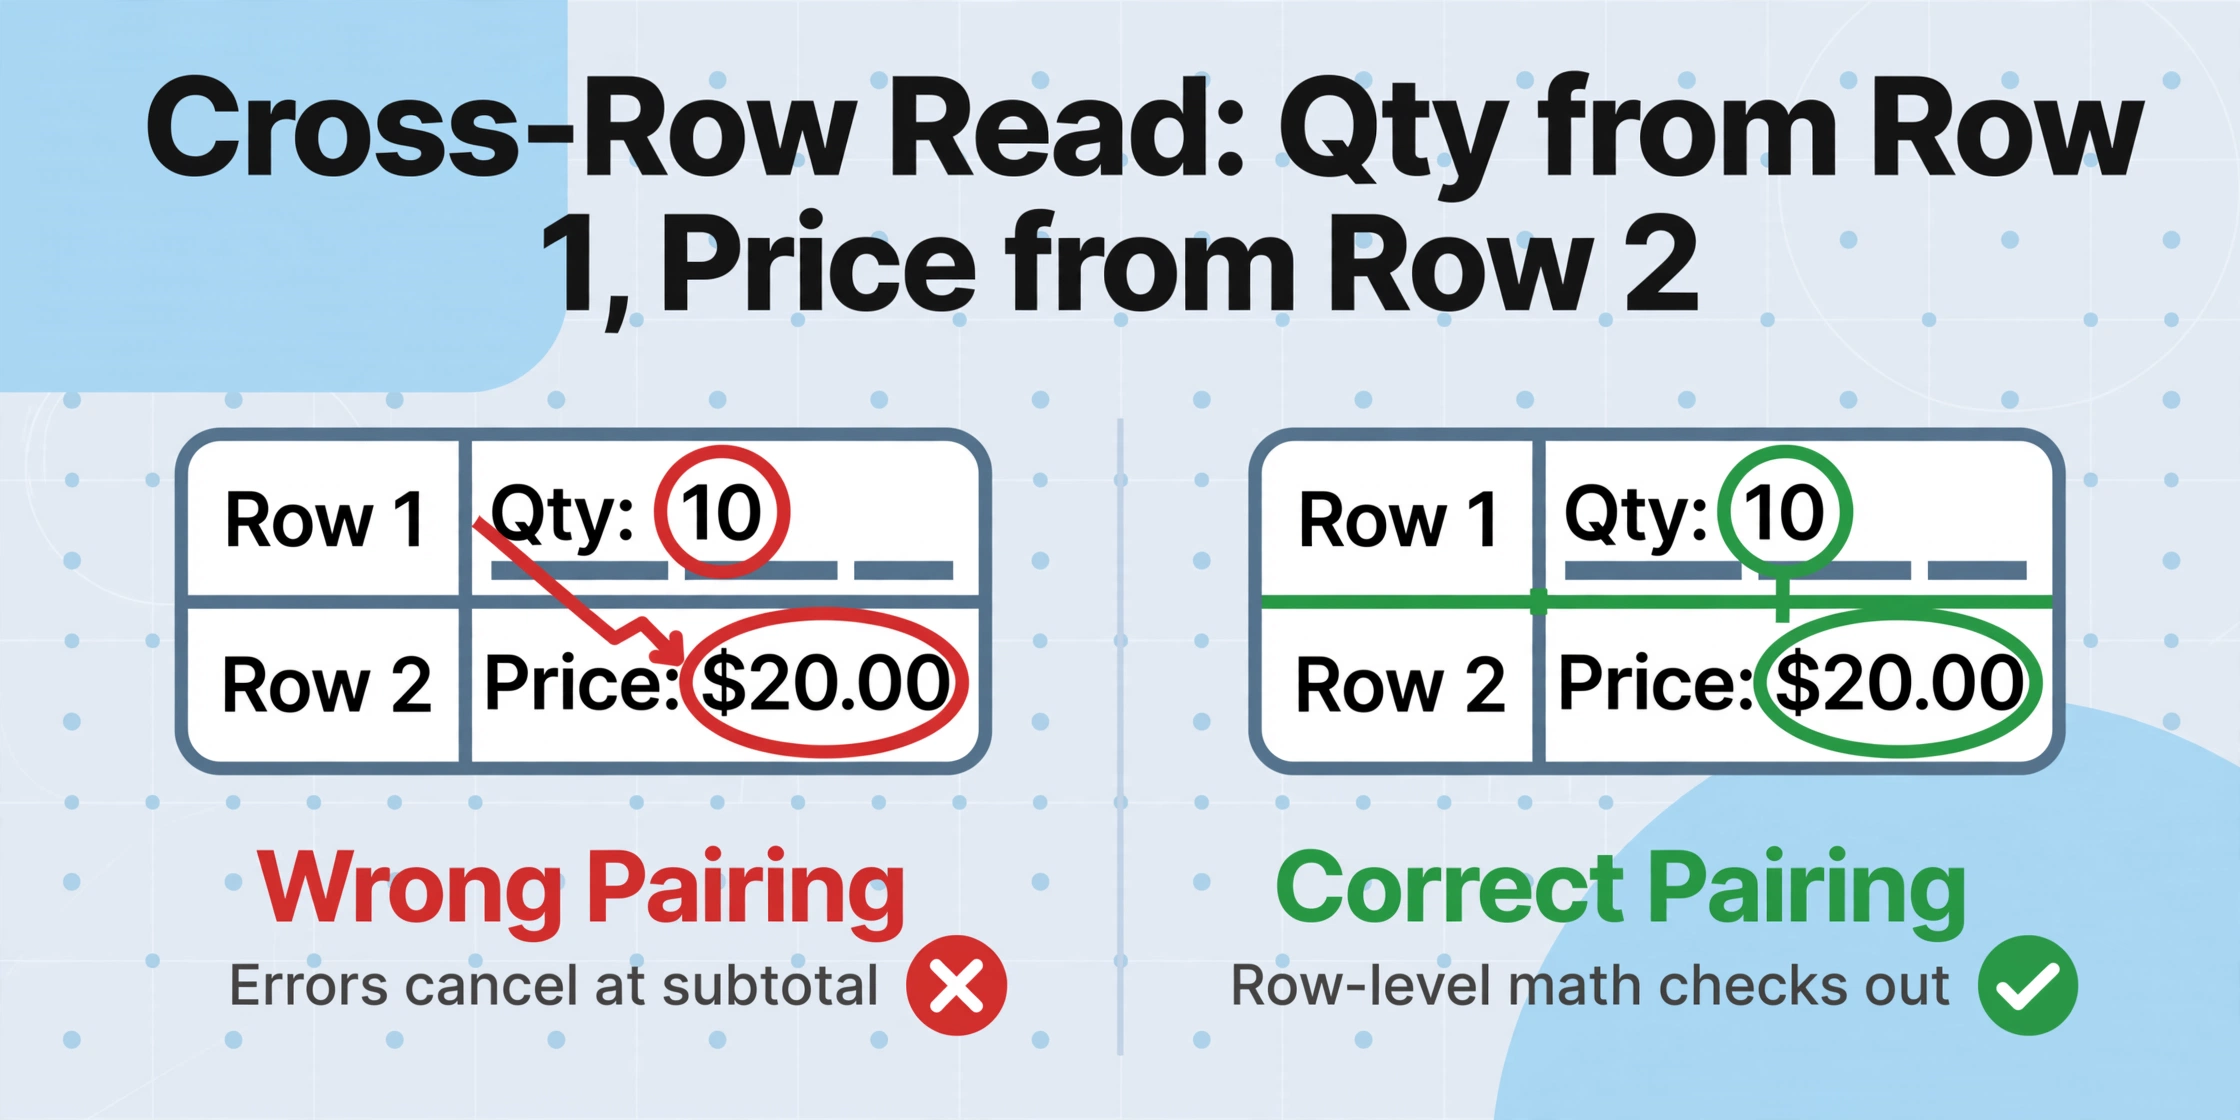
密度の高い明細行テーブルは、行間ペアリングエラーの最も一般的な原因です。請求書に15行以上の明細があり、行区切りが見えない場合 — 単に積み重なったテキスト行だけの場合 — AIの空間推論は、ある行がどこで終わり次の行がどこで始まるかを正確に判断する必要があります。数ピクセルのずれで、モデルが行Nの数量を行N+1の単価と関連付けてしまう可能性があります。
症状:個々の明細行の計算が誤っているが、すべてのQty × Price計算の合計は請求書の小計と一致します。これは値がすべて正しいことを示しています — ただ隣接する行と誤ってペアリングされているだけです。
行間の読み取りは、次の3つのシナリオで最も頻繁に発生します:
- 行ボーダーが見えない:空白のみで行を区切っている請求書。AIは境界線の位置を推測し、時々誤ります。
- 複数行の説明文:商品説明が2行に折り返されると、後続の行が下に押し下げられます。AIは継続テキストを新しい行として認識し、以降のすべてのペアリングがずれる可能性があります。
- テーブルヘッダーの結合セル:結合された列ラベルがあるヘッダー行は、AIの列数検出を混乱させ、テーブル構造全体を最初から誤って整列させる可能性があります。詳細は結合セルがテーブル抽出を壊す仕組みをご覧ください。
検出方法:行レベルの検証式を実行します(以下のフレームワークセクションで詳述)。行間の読み取りは特徴的な指紋を生成します — 一部の行は合計を過大評価し、一部は過小評価し、エラーは小計レベルで相殺されます。
原因2:単位の混乱 — 「12」は必ずしも12個ではない
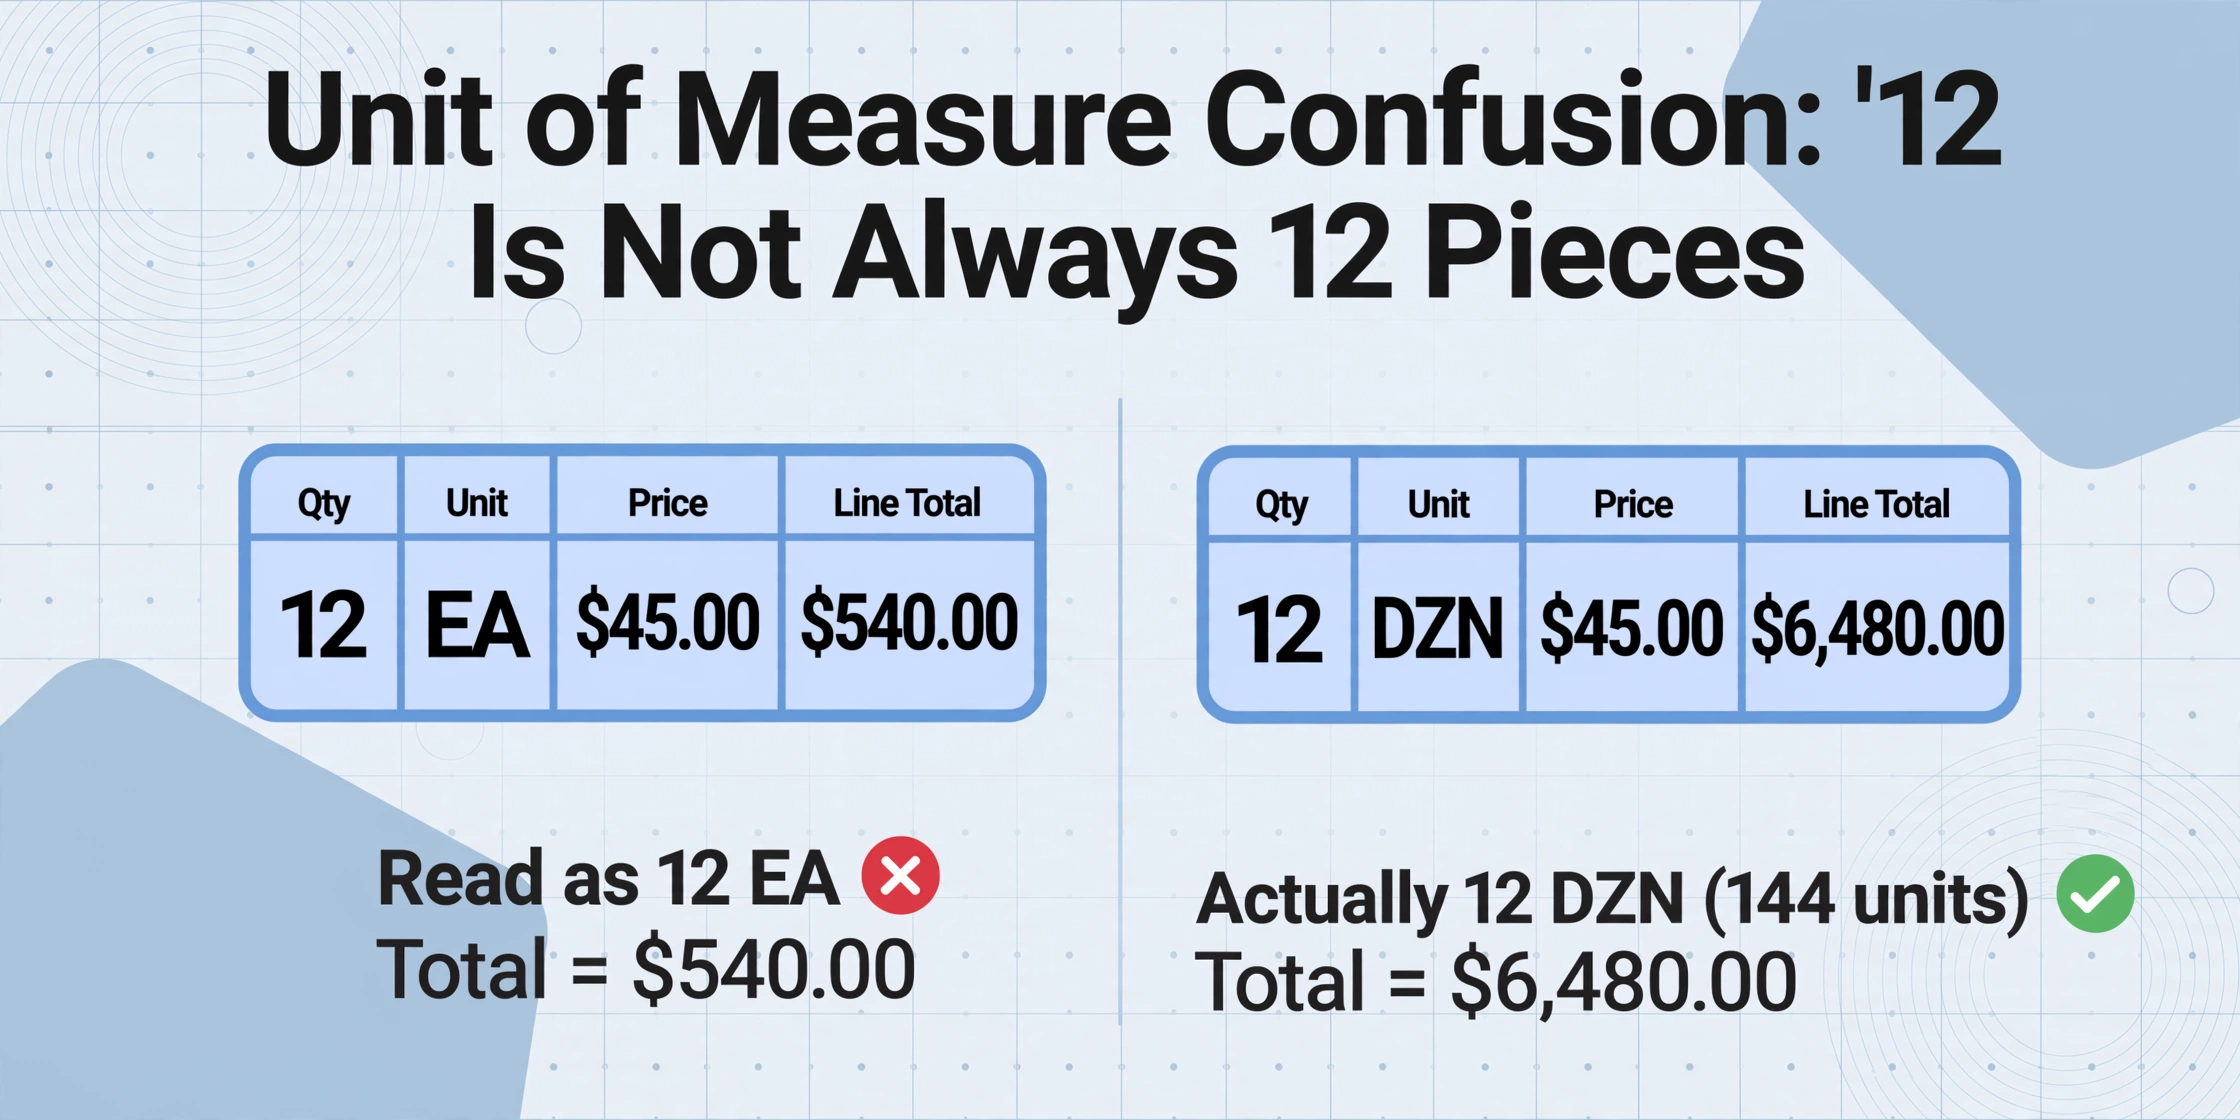
請求書明細の「12」という数量は、その単位が不明であれば曖昧です。12個でしょうか?12ダース(144ユニット)でしょうか?12キログラムでしょうか?1フィートあたり$3.75の12リニアフィートでしょうか?数字自体は明確ですが、AIは「12」が何を表すのかを知らなければ、12に単価を掛けることはできません。
単位(UOM)の混乱は、2つの異なるエラーパターンを生み出します:
- UOMが別の列にある場合:一部の請求書では、数量と単価フィールドの間に「UOM」列(EA、DZN、KG、FT)があります。AIがこの列を読み取れない、または関連付けられない場合、「12 DZN」(144ユニット×価格)を「12 EA」(12ユニット×価格)として扱い、本来の1/12の明細合計を生成します。
- UOMが説明文に埋め込まれている場合:多くの請求書では、説明フィールドに「12 × CASE」または「12 @ CASE PRICE」と記載されています。AIは「12」を数量列に読み取りますが、この「12」が「6ユニット入りケースが12個」を意味することを理解する仕組みがありません。結果として、Qty × 価格の合計はケース倍率分だけずれてしまいます。
このエラーは、数字が内部的に整合しているように見えるため、見破りにくいものです。Qty = 12、Unit Price = $45.00、Line Total = $540.00 — 計算は成立します。しかし、請求書が実際には「1ダースあたり$45.00で12ダース」と記載しており、AIが12個として読み取った場合、合計は12倍ずれます。AIは、たまたまビジネス上の現実チェックに失敗する、もっともらしい数字を抽出したのです。
単位関連の抽出問題は、元の文書に小数点の欠落や曖昧な通貨記号があるとさらに複雑になります — 単価の小数点欠落は、UOMのずれをさらに拡大させます。
検出方法:同じ品目の価格表または過去の平均と照らし合わせて明細合計をクロスチェックします。過去に1ユニットあたり$7.50で推移している品目に対して単価$45.00は危険信号です — AIがUOMを実際には「BOX(6 EA)」だったのに「EA」として読み取った可能性があります。過去データがない請求書の場合は、Qty × Unit Priceが予想価格帯から逸脱したきりの良い数字になる明細にフラグを立ててください。
原因3:割引前と割引後の明細金額の混同
請求書では、明細行の合計金額の表示方法についていくつかの慣例があります。割引前(総額)を明細行に表示し、割引は請求書のフッターで適用するものもあります。また、割引後(純額)を明細行で直接計算し、「割引合計」を別途集計するものもあります。AI抽出モデルは、特に列ヘッダーが単に「金額」とだけ記載されている場合、特定の請求書がどの慣例を使用しているかを判別できないことがよくあります。
例:明細行に「Qty 10、Unit Price $50.00、Amount $475.00」と表示されているとします。計算は10 × $47.50で一致しますが、Unit Priceは$50.00と表示されています。何が起こったのでしょうか。請求書は5%の明細レベル割引(1ユニットあたり$2.50)を適用し、総額のUnit Priceを表示しながら、明細行には純額を表示しています。AIは両方の値を正しく抽出しましたが、それらは割引計算の異なる段階に属しているだけです。
割引に関する3つの慣例が、定期的な抽出エラーの原因となるほど一般的です。
- 明細レベル割引、明細行は総額を表示:明細行にはQty × 定価が表示されます。割引は請求書のフッターで適用されます。AIは明細合計をそのまま抽出し、Qty × 価格は一致します。ここでは不一致は発生しませんが、割引額は明細レベルでは見えません。
- 明細レベル割引、明細行は純額を表示:明細行にはQty ×(定価 − 割引)が表示されます。Unit Price列には依然として$50.00と表示されますが、明細金額は割引後の値を反映しています。Qty × $50.00 ≠ Line Totalとなり、すべてのフィールドが正しく読み取られているにもかかわらず、不一致が発生します。
- 同じ請求書内での混在:一部の明細行には割引が適用され、一部には適用されません。AIはすべての行に一律の解釈を適用するため、一部は一致し、一部は失敗します。
検出方法:このエラーの特徴は、Qty × Unit Priceが複数の明細行にわたって一定の割合でLine Totalを一貫して上回ることです。割引のある明細行で「Amount = Qty × Price × 0.95」というパターンが見られ、割引のない明細行が一致する場合、請求書は明細行に純額を表示しています。これらにフラグを立て、抽出エラーを想定するのではなく、ベンダーの割引条件を確認してください。
原因4:税込金額と税抜金額が1枚の請求書に混在している
VAT/GST適用地域の請求書では、同じ文書に税込価格と税抜価格が混在することがよくあります。一部の明細行は表示金額に税が含まれています(消費者向け商品やB2C販売で一般的)。他の明細行は税抜金額を表示し、フッターでVATが計算されます(B2Bで標準的)。すべての明細行に単一の解釈を適用するAIモデルは、混在タイプの行で不一致を生じさせます。
多くの請求書は個々の明細行に「税込」や「税抜」のラベルを付けていません。その区別は、顧客タイプ、商品カテゴリ、または管轄区域によって暗黙的に示されます。これは、XeroやAutoEntryのような会計ソフトウェアでさえ、専用のトグルスイッチで処理している微妙な点であり、それだけに簡単ではないのです。
このエラーを引き起こす実際のシナリオは3つあります:
- 混合供給の請求書:例えばホテルからの1枚の請求書に、宿泊料金(標準税率のVAT対象)とサービス料(VAT免税)と駐車場(軽減税率)が記載されています。各明細行は、供給元の会計システムに応じて税込または税抜で表示され、一貫性のない抽出対象となります。
- 国際的な請求書:米国の供給元が英国の顧客に請求します。請求書にはUSD建ての明細金額(VATなし)が表示されますが、フッターにはリバースチャージのVAT注記が適用されます。主に国内の請求書パターンで学習したAIは、税抜の明細金額を異なる方法で解釈する可能性があります。
- クレジットノートと調整:元の税込・税抜金額を参照する修正行は、AIがすべての行に一貫した税解釈を適用すると、不一致を生じさせます。
arXivの請求書抽出調査では、一貫性の失敗は「複雑な複数税シナリオを含む請求書に集中している」ことが判明しました。これらはまさに、個々のフィールドが間違っていなくてもQty × Price ≠ Line Totalとなる、税込・税抜混在の文書です。
検出方法:同じ請求書内で、不一致率が特定の税コードや商品カテゴリと相関しているか確認してください。VATコード「S」(標準税率)の行がすべて一致する一方で、コード「Z」(ゼロ税率)の行がVAT率と正確に一致する一貫した偏差を示す場合、AIはゼロ税率の品目に誤った税込・税抜の前提を適用しています。
解決策:明細行の整合性を検証する3層フレームワーク
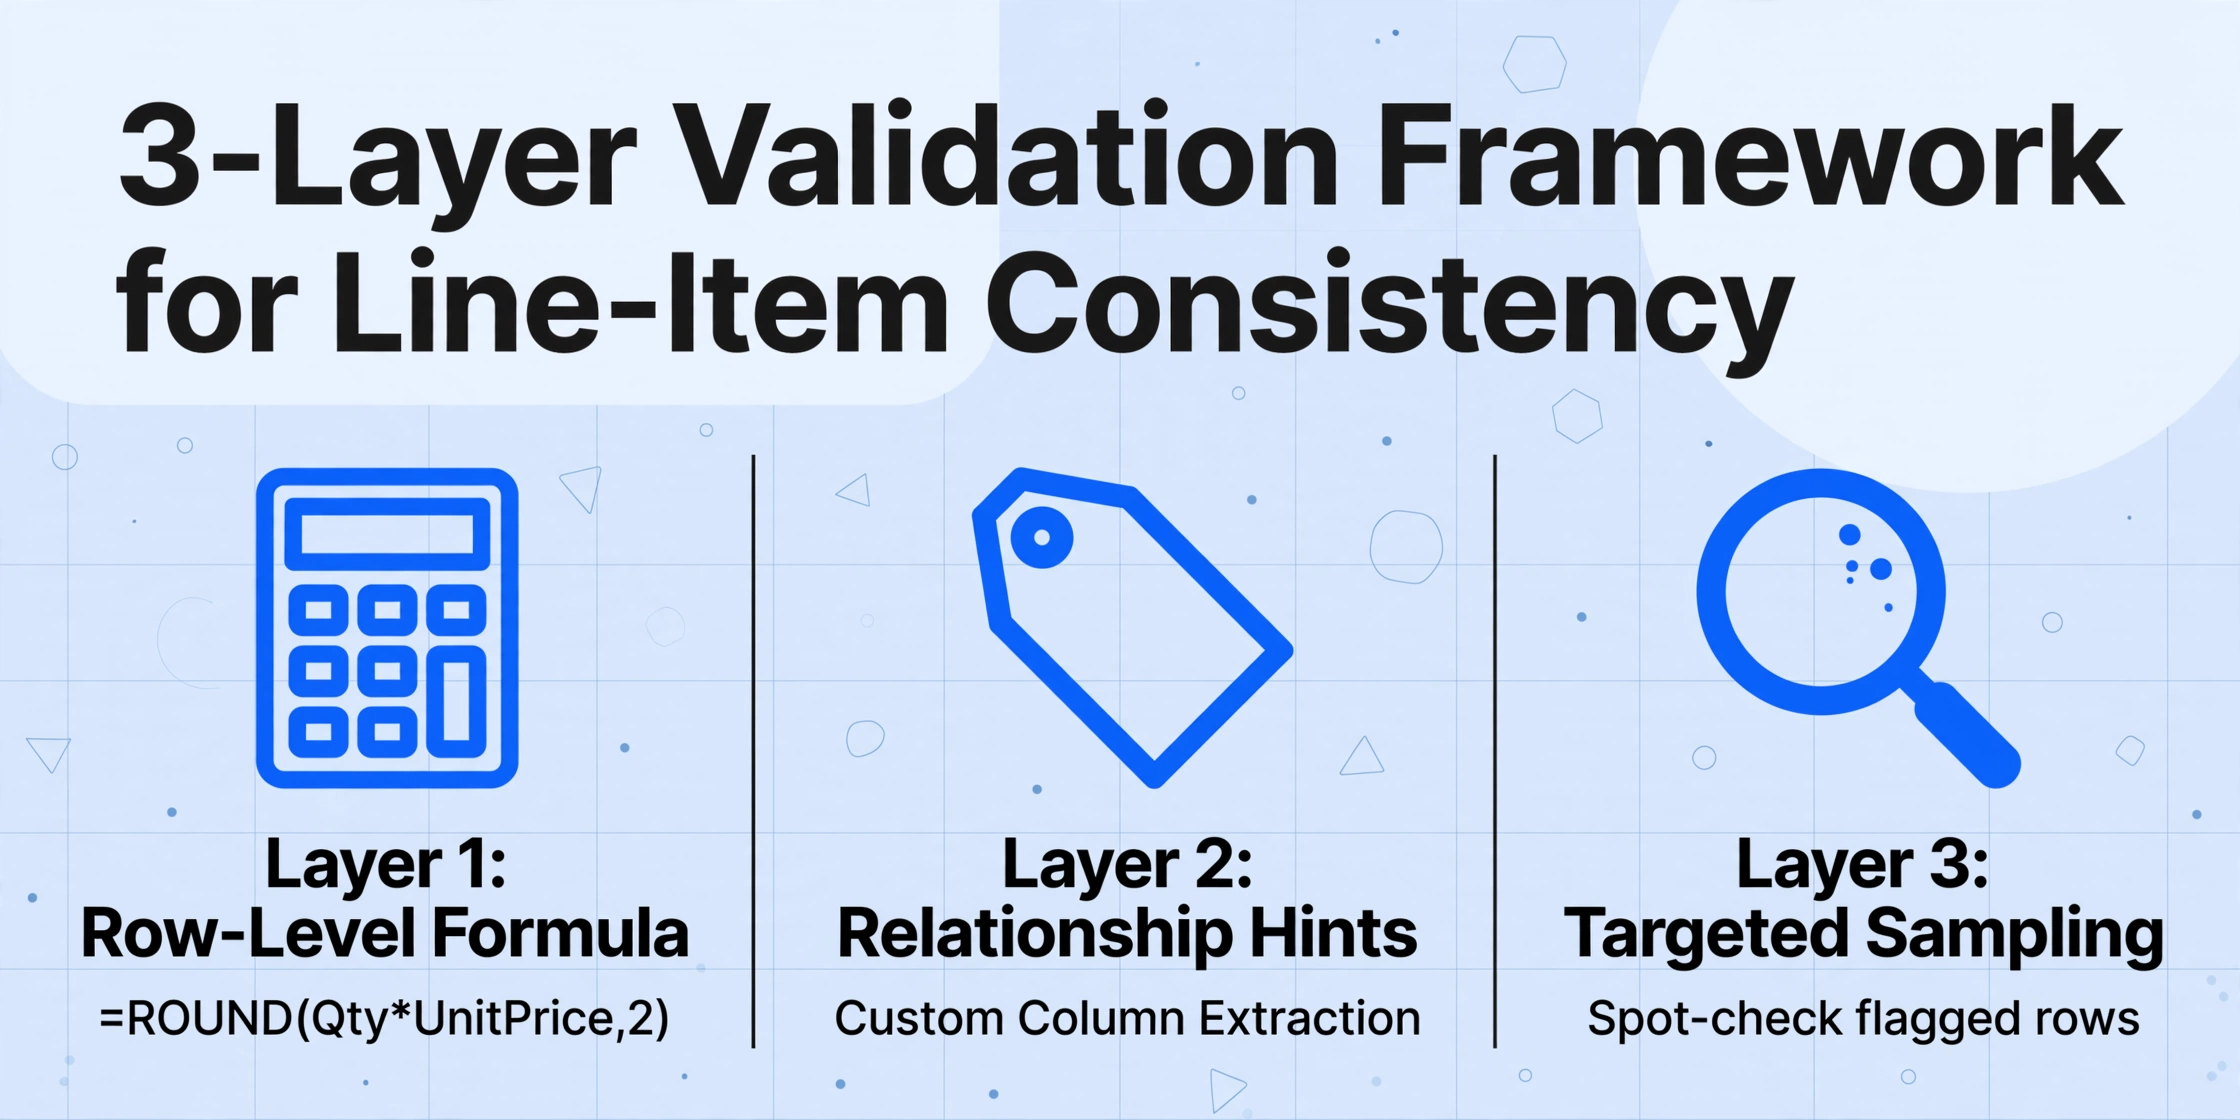
上記の4つの原因はそれぞれ、抽出データに異なる特徴として現れます。体系的な検証フレームワークを用いれば、そのすべてを検出できます。これは、フィールド単位の信頼度スコアでは可視化できないものです。
レイヤー1:行レベルの検証数式
最も迅速な包括チェックは、数式列を使用することです。
=ROUND(Qty*UnitPrice,2)これを抽出されたLine Totalと比較します。差が$0.01を超える行にフラグを立て、条件付き書式を使用します。
=ABS(ROUND(A2*B2,2)-C2)>0.01偏差の方向と大きさから、どの原因かを判断できます。
- 行間で誤差が相殺される → 原因1(行をまたぐ読み取り)。値はすべて存在するが、対応付けが誤っている。
- 一定の係数で偏差が出る(例:常に0.5、6、または12ずれる) → 原因2(UOMの混同)。その係数が単位の乗数です。
- 一定の割合で偏差が出る → 原因3(割引の混同)。その割合が割引率と一致します。
- 特定の税コードに紐づく偏差 → 原因4(税込み・税別の混同)。その偏差率が該当するVAT/GST率と一致します。
レイヤー2:AIへのフィールド関係のヒント
抽出を設定する際、何が一緒に属するかを明確に指定することで、AIがフィールド間の関係を理解できるようにします。ImageToTable.aiのカスタム列抽出は意味的に動作します。つまり、必要な列を指定すると、AIがその意味を理解して各値を特定します。フィールド間の対応付けを改善するには、次のようにします。
- 説明的な列名を使用する:「Unit Price(1個あたり)」や「Line Total(Qty × Unit Price)」のような名前は、AIが1個あたりの値と1行あたりの値を区別するのに役立ちます。
- 計算列をクロスチェックとして定義する:
Line Total検証(Qty × Unit Price)を作成します。AIが値を抽出して計算を実行し、エクスポート後ではなく抽出中に不一致を表面化させます。 - 数値フィールドの形式ルールを設定する:数量は、小数点が存在しない限り整数であり、Unit Priceは常に小数点以下2桁であることを指定します。これにより、曖昧な解釈が制限されます。
レイヤー3: 対象を絞ったスポットチェック抽出
数式チェックを行っても、一部のエラーはすり抜けます。特に、Qty × Price が偶然にもっともらしいが誤った Line Total と一致する場合です。対象を絞ったスポットチェック抽出がこのギャップを埋めます。各バッチについて、手動で以下を検証してください: レイヤー1でフラグが付いたすべての行、合格した行の10%(偶然の一致を検出するため)、およびベンダーごとに1件の請求書(体系的なフォーマットの癖を検出するため)。これにより、数値の不一致の95%以上を検出しつつ、データの15%未満の手動レビューで済みます。
エスカレーションのタイミング: 5%のしきい値
検証フレームワークがバッチ内の明細項目の5%以上にフラグを付けた場合、問題はおそらく体系的なものです。つまり、検証数式をいくら調整しても明細レベルでは修正できない、フィールド間の一貫した不一致パターンが存在します。
エスカレーションが必要な3つのシナリオ:
- 単一ベンダーへの集中: フラグが付いた行の70%以上が1つのベンダーからのものです。そのベンダーのレイアウトは現在のアプローチと互換性がありません。これらの請求書を事前処理するか、別のパイプラインにルーティングしてください。
- 複数税率の複雑さ: 3つ以上の税率、または包含・除外金額が混在する請求書。最良のモデルでも、これらの20%は失敗します(arXivの研究による)。抽出の修正を試みるのではなく、税務専門のAP担当者による手動レビュー用にフラグを立ててください。
- 低品質のソース文書: 4つのパターンすべてに同時にフラグが現れる場合、根本原因はフィールド間の関係の混乱ではなく、OCRの品質不良です。まずソース品質に対処してください — 小数および通貨抽出の修正を参照してください。
このしきい値は、チームを終わりのないチューニングサイクルから守ります。抽出が独立フィールドで98%以上、フィールド間の一貫性で95%以上を達成していれば、ほとんどのAPワークフローで実用的です。残りの5%は、完全に排除するよりも、例外ルーティングで処理する方がコストが低くなります。
よくある質問
Qty × 価格の不一致は常に抽出エラーを意味しますか?
いいえ。一部の請求書では、明細金額がQty × Unit Priceと一致しないことがあります。これは、明細レベルで適用される数量割引、プロモーション価格、または明細の単価が平均値であるパッケージ取引などが原因です。不一致を抽出エラーとして扱う前に、必ず元の請求書と照合してください。
明細項目に計算の不一致がある場合、合計金額を信頼できますか?
自動的には信頼できません。原因1(行をまたぐ読み取り)が関係している場合、エラーが相殺され、合計金額が正しい可能性があります。しかし、原因2〜4の場合、明細金額が小計や合計の計算に反映されるため、合計金額はおそらく誤っています。支払いに抽出された合計を使用する前に、必ず明細レベルの不一致を解決してください。
AIツールが誤ってペアリングされたフィールドに対して99%の信頼度を報告するのはなぜですか?
信頼度スコアは個々のフィールドの読み取り可能性を測定するものであり、フィールド間の論理的な整合性を測定するものではないからです。ビジョンモデルは、ページ上の特定の位置に「$150.00」が表示されていることに99%の自信を持つことができます。そして、その自信は、$150.00がUnit PriceであるかLine Totalであるかによって変わることはありません。フィールド間の検証は、信頼度スコアでは代替できない別のステップです。
異なるベンダー間でのUOMの混乱にはどう対処すればよいですか?
抽出テンプレートに別の「UOM」列を追加して、抽出出力を標準化してください。明確な形式の指示を含めてください:「同じ行から単位(EA、DZN、KG、FT、CASE、BOX)を抽出し、別の列として出力してください。」これにより、UOMが出力に表示され、AIが単位を自動的に解釈するのに頼るのではなく、スプレッドシートに変換ルールを構築できます。
明細項目はAPにおける真実の単位
ヘッダーレベルの抽出(ベンダー名、請求書番号、合計金額)は、コモディティレベルの精度に達しています。品質が依然として有意に変動するフロンティアは明細項目レベルであり、フィールドの関係性がフィールドの値と同じくらい重要です。AIは個々の数値を正しく読み取りますが、正しい列と行への割り当ては、モデルがドキュメントのセマンティクスを理解することに依存しています。そのセマンティックな理解は急速に向上していますが、フィールド間の検証を省略できるレベルにはまだ達していません。このフレームワーク(計算列+関係性のヒント+対象を絞ったサンプリング)は、支払いや照合に供給される抽出ワークフローに適したプロセスです。
次のバッチで計算列を設定してください。=ROUND(Qty*UnitPrice,2)と条件付き書式を追加するのに要する5分間で、抽出品質について信頼度スコアよりも多くのことがわかります。