Pourquoi le calcul de vos lignes de facture
est erroné après l'extraction
Votre extracteur de factures a correctement identifié le nom du fournisseur, le numéro de facture et le total général. Mais lors de la vérification des lignes, quelque chose cloche : la ligne 3 affiche Qty 4, Unit Price 150,00 $, Line Total 300,00 $ — soit 300 $ de moins. Pourtant, chaque champ individuel semble correct. L'IA n'a rien mal lu. Elle a mal apparié quelque chose.
Points clés à retenir
- Votre extracteur de factures IA affiche une confiance de 99 % sur les champs et le calcul Qty × Prix reste pourtant erroné — car les scores de confiance par champ mesurent la lisibilité, pas l'appartenance d'un prix unitaire à la ligne 2 ou à la ligne 3.
- Les écarts Qty × Prix suivent seulement quatre schémas — et l'ampleur et le sens de l'écart révèlent si l'IA a croisé des lignes, manqué un multiplicateur d'unité de mesure, ou confondu les montants avant et après remise.
- Une seule colonne de formule — =ROUND(Qty×UnitPrice,2) — détecte les quatre schémas, et les cinq minutes nécessaires pour l'ajouter vous en apprennent plus sur la qualité de l'extraction que n'importe quel score de confiance.
C'est le mode de défaillance le plus silencieux de l'extraction de factures par IA. L'IA atteint une précision de 98%+ sur les champs individuels — elle lit les quantités, les prix unitaires et les totaux de ligne correctement en tant que valeurs autonomes. Mais la cohérence inter-champs est un défi fondamentalement différent. Un modèle de vision capable de lire « 150,00 $ » sur une page avec une grande confiance ne peut pas savoir automatiquement si ces 150,00 $ appartiennent au prix unitaire de la ligne 2, au total de la ligne 3, ou au sous-total de la section. Lorsque ces relations se brisent, le calcul des lignes cesse de s'additionner, et l'erreur est invisible pour les scores de confiance par champ.
Une étude de 2025 sur Docling et LlamaExtractor confirme l'écart : les contrôles de cohérence (lignes + taxes = total) ont échoué sur 20 % des factures — principalement celles présentant des scénarios multi-taxes complexes ou un format non standard (arXiv 2510.15727v1). Si vous constatez des incohérences quantité × prix dans vos résultats, vos factures relèvent probablement de l'un des quatre schémas distincts.
Cause 1 : L'IA a associé la Qty de la ligne 1 au prix de la ligne 2
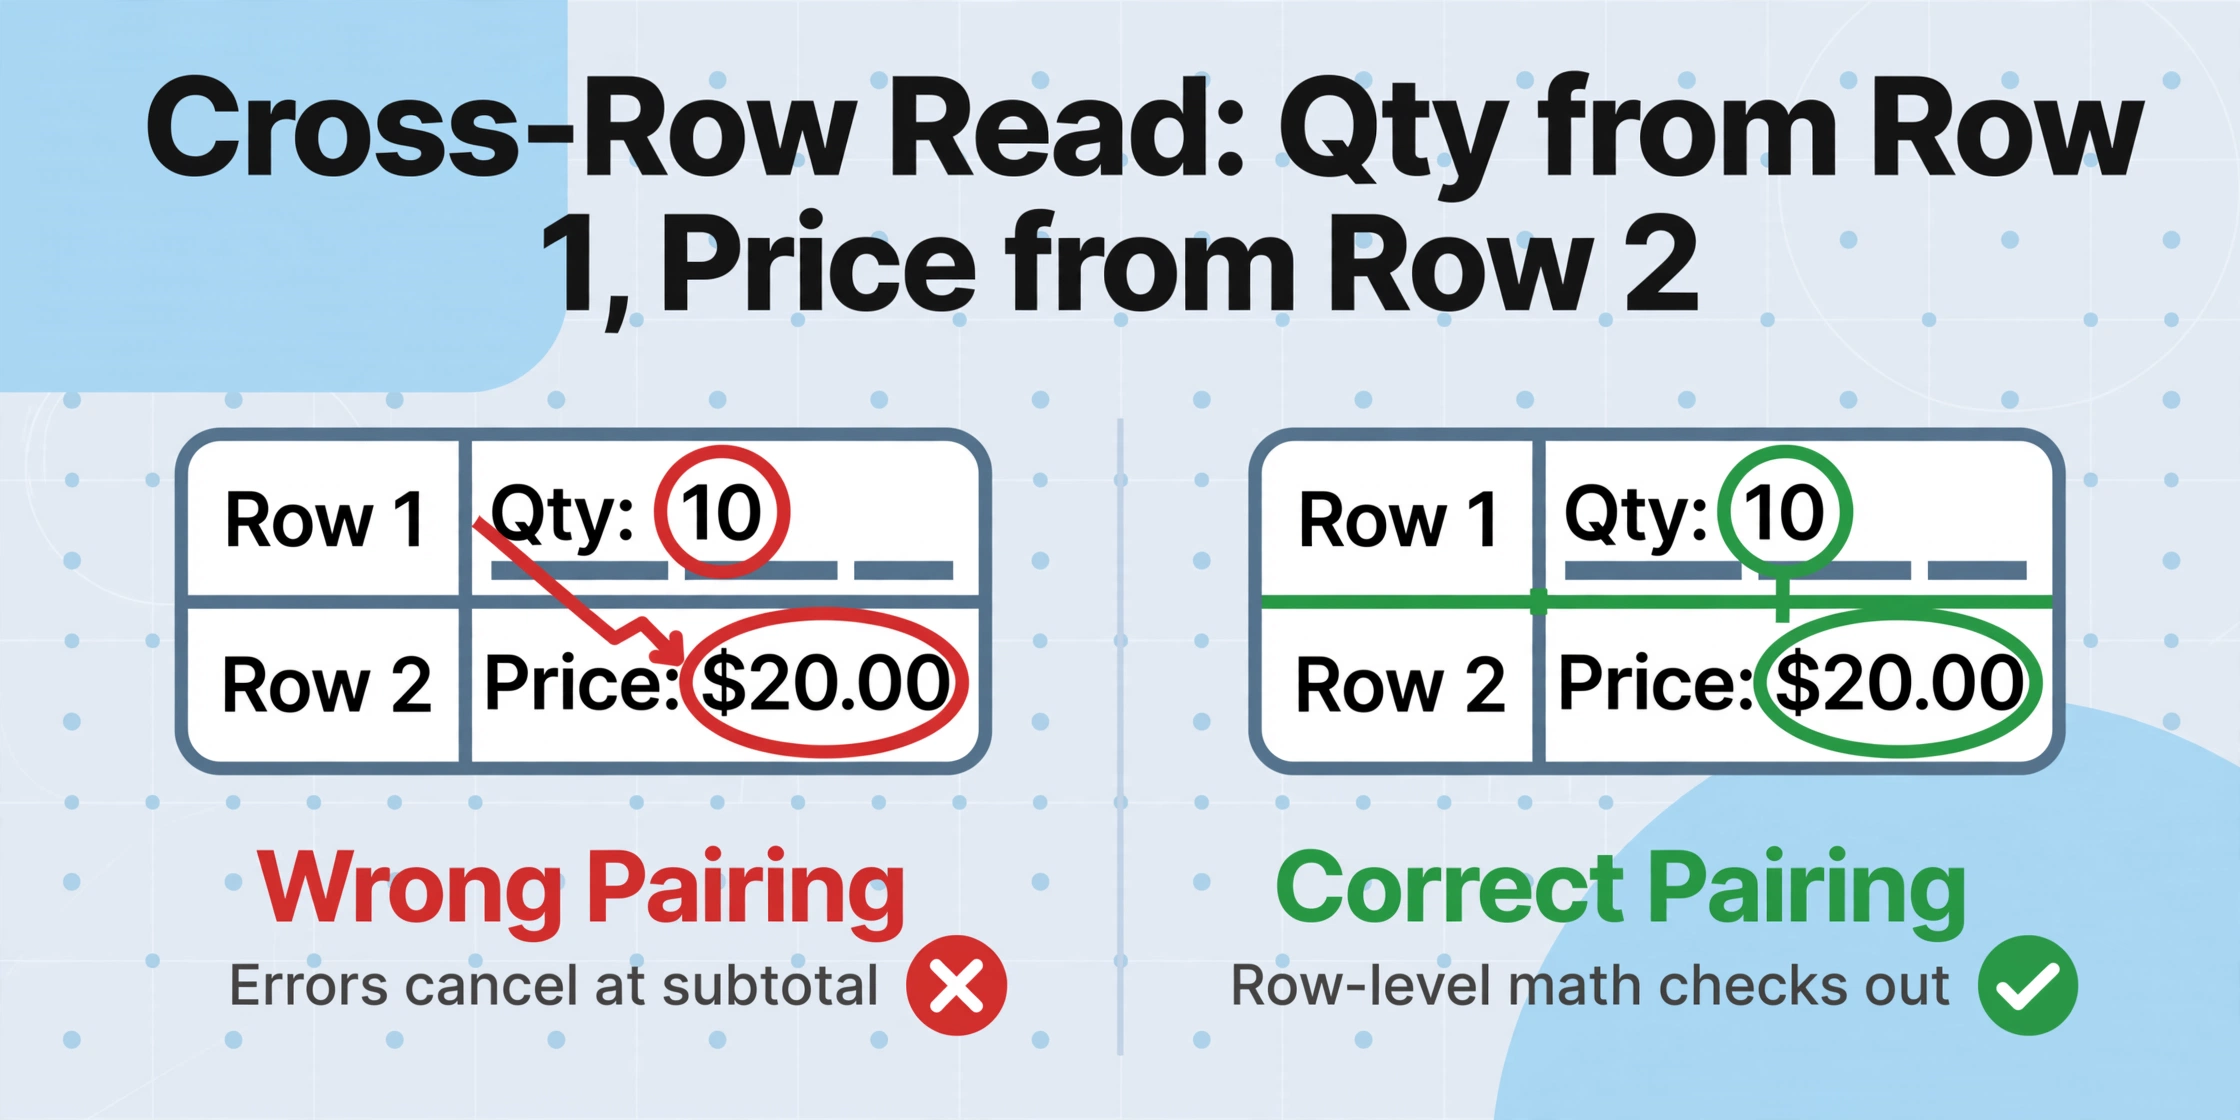
Les tableaux de lignes denses sont la source la plus courante d'erreurs d'appariement inter-lignes. Lorsqu'une facture comporte 15+ lignes sans séparateurs de lignes visibles — simplement des rangées de texte empilées — le raisonnement spatial de l'IA doit décider précisément où une ligne se termine et où la suivante commence. Un décalage de quelques pixels peut amener le modèle à associer la quantité de la ligne N au prix unitaire de la ligne N+1.
Symptôme : Les lignes individuelles présentent des calculs incorrects, mais la somme de tous les calculs Qty × Price est égale au sous-total de la facture. Cela indique que toutes les valeurs sont correctes — elles sont simplement appariées aux mauvais voisins.
Les lectures inter-lignes se produisent le plus souvent dans trois scénarios :
- Absence de bordures de lignes visibles : Les factures qui utilisent uniquement des espaces blancs pour séparer les lignes. L'IA devine où se trouvent les limites et se trompe parfois.
- Descriptions multi-lignes : Une description de produit qui s'étend sur deux lignes pousse les lignes suivantes vers le bas. L'IA peut interpréter le texte de continuation comme une nouvelle ligne, décalant ainsi toutes les paires suivantes.
- Cellules fusionnées dans l'en-tête du tableau : Une ligne d'en-tête avec des étiquettes de colonnes fusionnées peut perturber la détection du nombre de colonnes par l'IA, provoquant un désalignement de toute la structure du tableau dès le départ. Voir comment les cellules fusionnées brisent l'extraction de tableaux pour une analyse plus approfondie.
Comment le détecter : Exécutez une formule de validation au niveau de la ligne (détaillée dans la section framework ci-dessous). Les lectures inter-lignes produisent une empreinte distinctive — certaines lignes surestiment le total, d'autres le sous-estiment, et les erreurs s'annulent au niveau du sous-total.
Cause 2 : Confusion d'unité de mesure — « 12 » ne signifie pas toujours 12 pièces
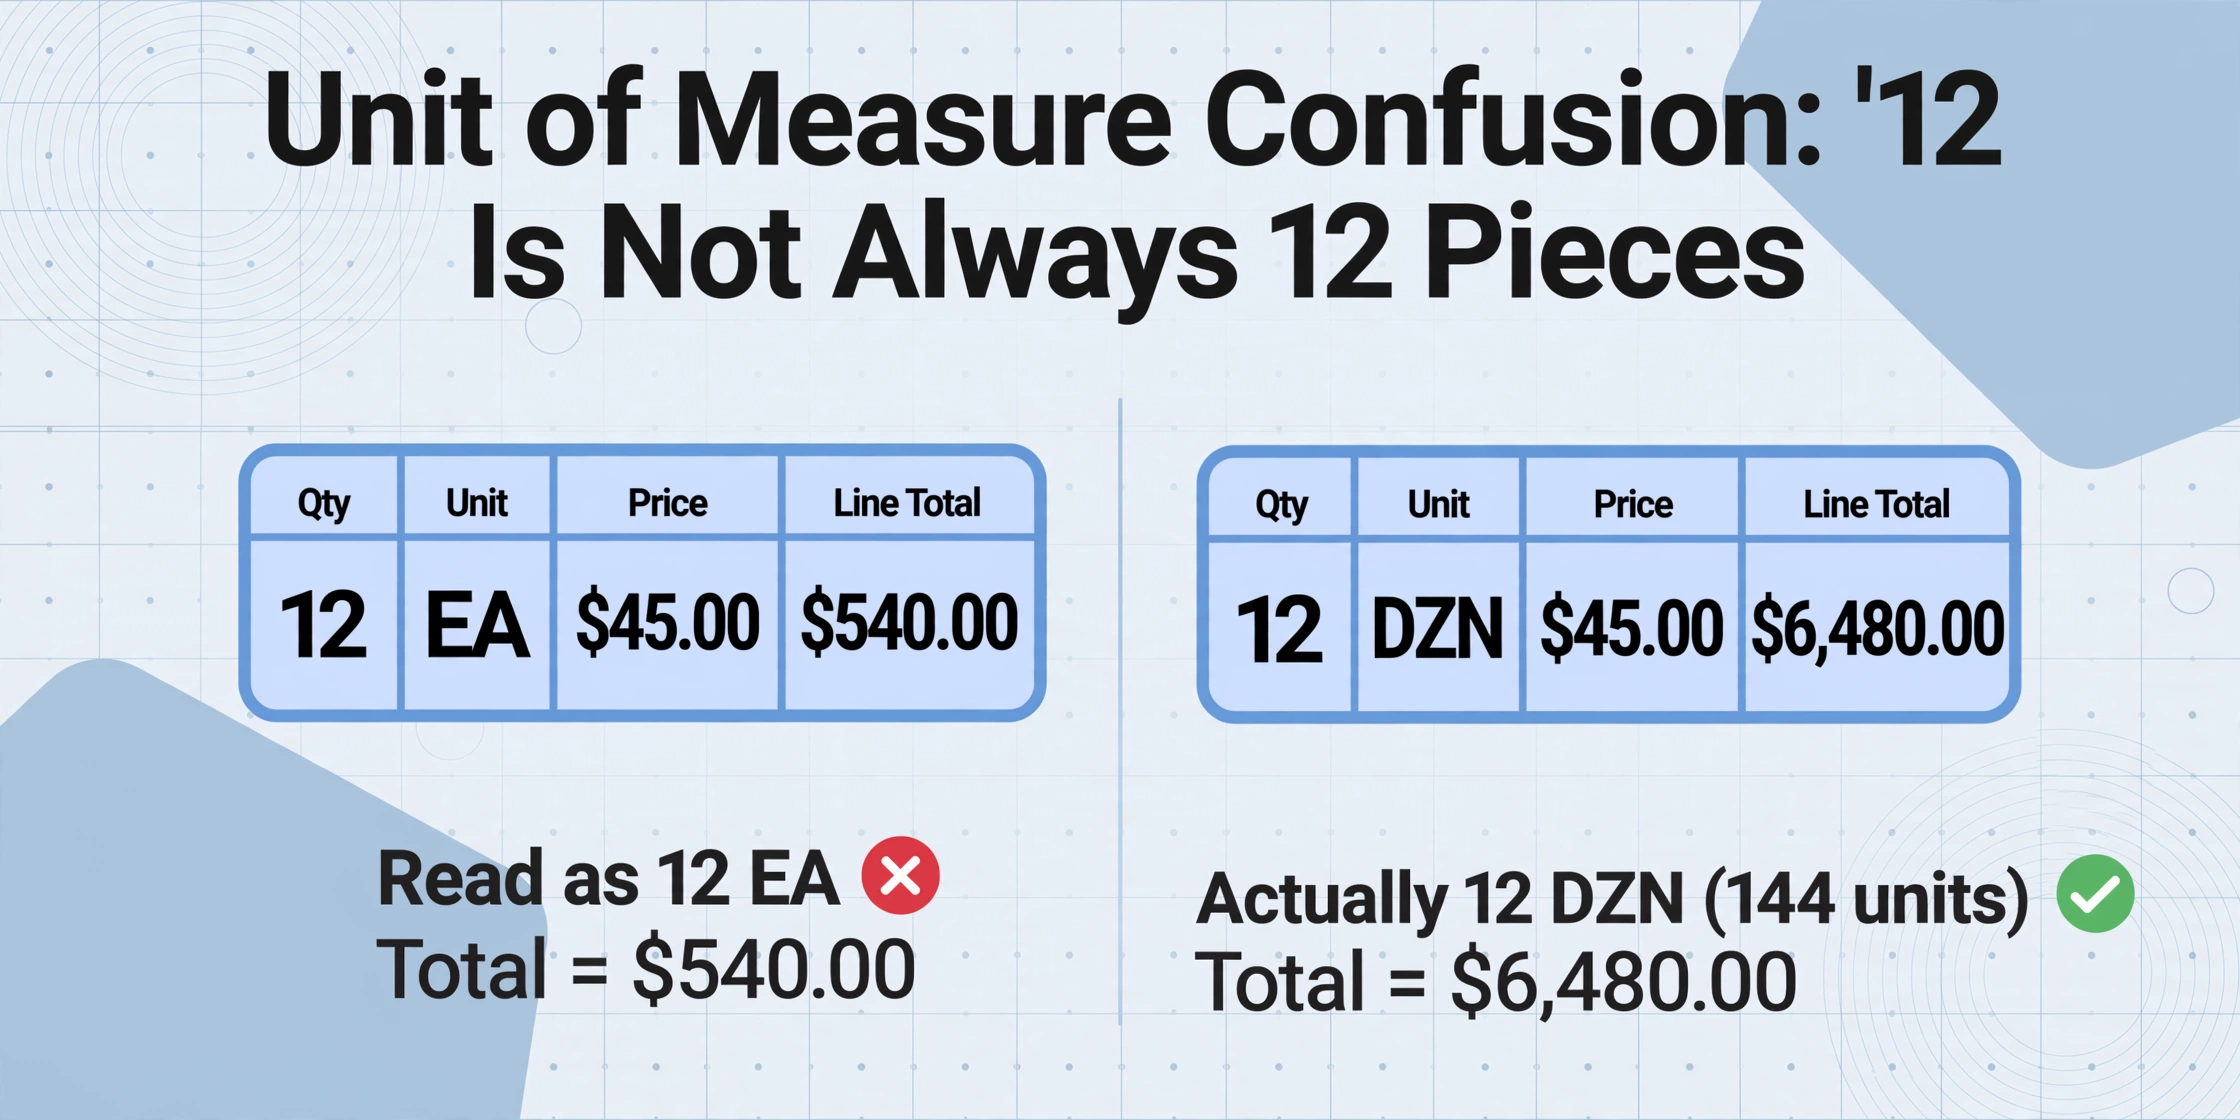
Une quantité de « 12 » sur une ligne de facture est ambiguë sans son unité de mesure. S'agit-il de 12 pièces ? 12 douzaines (144 unités) ? 12 kilogrammes ? 12 pieds linéaires à 3,75 $ le pied ? Le nombre en lui-même est clair, mais l'IA ne peut pas multiplier 12 par un prix unitaire sans savoir ce que « 12 » représente.
La confusion d'unité de mesure (UOM) produit deux types d'erreurs distincts :
- UOM dans une colonne séparée : Certaines factures comportent une colonne « UOM » (EA, DZN, KG, FT) entre les champs de quantité et de prix unitaire. Si l'IA ne parvient pas à lire ou à associer cette colonne, elle traite « 12 DZN » (144 unités × prix) comme « 12 EA » (12 unités × prix), produisant un total de ligne qui représente 1/12 de ce qu'il devrait être.
- UOM intégrée à la description : De nombreuses factures indiquent « 12 × CASE » ou « 12 @ CASE PRICE » dans le champ de description. L'IA lit « 12 » dans la colonne de quantité mais n'a aucun mécanisme pour comprendre que ce « 12 » signifie « 12 cartons de 6 unités chacun ». Le total Qty × Prix qui en résulte sera faussé par le multiplicateur du carton.
Cette erreur est trompeuse car les chiffres semblent cohérents en interne. Qty = 12, Prix unitaire = 45,00 $, Total de ligne = 540,00 $ — le calcul fonctionne. Mais si la facture indique en réalité « 12 douzaines à 45,00 $ la douzaine » et que l'IA l'a lu comme 12 pièces, le total est faux d'un facteur 12. L'IA a extrait des chiffres plausibles qui ne correspondent pas à la réalité commerciale.
Les problèmes d'extraction liés aux unités s'aggravent lorsque le document source contient des points décimaux manquants ou des symboles de devise ambigus — un point décimal manquant dans le prix unitaire amplifie tout désalignement d'UOM.
Comment le détecter : Recoupez le total de ligne avec un catalogue de prix ou une moyenne historique pour le même article. Un prix unitaire de 45,00 $ sur un article qui coûte historiquement 7,50 $ l'unité est un signal d'alarme — l'IA a peut-être lu l'UOM comme « EA » alors qu'il s'agissait en réalité de « BOX (6 EA) ». Pour les factures sans données historiques, signalez toute ligne où Qty × Prix unitaire produit un nombre rond qui s'écarte des fourchettes de prix attendues.
Cause 3 : Confusion entre montant de ligne avant et après remise
Les factures utilisent plusieurs conventions pour afficher les totaux de ligne. Certaines indiquent le montant brut (avant remise) sur la ligne et appliquent les remises au bas de la facture. D'autres calculent le montant net (après remise) directement sur la ligne et récapitulent séparément un total des remises. Les modèles d'extraction IA ne parviennent souvent pas à déterminer quelle convention une facture donnée utilise, surtout lorsque l'en-tête de colonne indique simplement « Amount ».
Exemple : La ligne indique « Qty 10, Unit Price 50,00 $, Amount 475,00 $ ». Le calcul est cohérent avec 10 × 47,50 $, mais le prix unitaire affiché est de 50,00 $. Que s'est-il passé ? La facture applique une remise de 5 % au niveau de la ligne (2,50 $/unité) et affiche le montant net sur la ligne tout en indiquant le prix unitaire brut. L'IA a extrait les deux valeurs correctement — elles correspondent simplement à des étapes différentes du calcul de la remise.
Trois conventions de remise sont suffisamment courantes pour provoquer régulièrement des confusions lors de l'extraction :
- Remise au niveau de la ligne, ligne affichant le montant brut : La ligne affiche Qty × Prix plein. La remise est appliquée au bas de la facture. L'IA extrait le total de ligne tel quel, et Qty × Prix correspond. Aucune divergence ici — mais le montant de la remise est invisible au niveau de la ligne.
- Remise au niveau de la ligne, ligne affichant le montant net : La ligne affiche Qty × (Prix plein − Remise). La colonne du prix unitaire indique toujours 50,00 $, mais le montant de la ligne reflète la valeur actualisée. Qty × 50,00 $ ≠ Line Total, même si chaque champ est correctement lu.
- Convention mixte sur la même facture : Certaines lignes bénéficient de remises, d'autres non. L'IA applique une interprétation uniforme à toutes les lignes, ce qui fait que certaines correspondent et d'autres échouent.
Comment la détecter : La signature de cette erreur est que Qty × Unit Price surestime systématiquement le Line Total d'un pourcentage fixe sur plusieurs lignes. Si vous observez le motif « Amount = Qty × Price × 0,95 » sur les lignes avec remise tandis que les lignes sans remise correspondent, la facture utilise l'affichage net sur la ligne. Signalez ces cas et confirmez avec les conditions de remise du fournisseur plutôt que de supposer une erreur d'extraction.
Cause 4 : Montants de lignes TTC et HT mélangés dans une même facture
Les factures dans les juridictions soumises à la TVA ou à la GST mélangent souvent des prix TTC et HT sur un même document. Certaines lignes incluent la taxe dans le montant affiché (courant pour les biens de consommation ou les ventes B2C). D'autres affichent le montant hors taxe avec la TVA calculée en bas de page (standard pour le B2B). Un modèle d'IA qui applique une interprétation unique à toutes les lignes produira une incohérence sur les lignes de type mixte.
De nombreuses factures ne précisent pas si chaque ligne est « TTC » ou « HT ». La distinction est implicite selon le type de client, la catégorie de produit ou la juridiction — une nuance que même les logiciels comptables comme Xero et AutoEntry gèrent avec des interrupteurs dédiés, précisément parce qu'elle n'est pas triviale.
Trois scénarios réels sont à l'origine de cette erreur :
- Factures à fournitures mixtes : Une facture unique d'un hôtel, par exemple, liste les frais de chambre (soumis à la TVA au taux standard) ainsi que des frais de service (exonérés de TVA) et le parking (taux réduit). Chaque ligne peut être affichée TTC ou HT selon le système comptable du fournisseur, créant une cible d'extraction incohérente.
- Factures internationales : Un fournisseur américain facture un client britannique. La facture affiche les montants en USD (sans TVA), mais le pied de page applique une mention de TVA intracommunautaire (reverse charge). L'IA formée principalement sur des modèles de factures nationales peut interpréter différemment les montants hors taxe.
- Avoirs et ajustements : Les lignes de correction qui référencent des montants TTC/HT d'origine créent une incohérence lorsque l'IA applique une interprétation fiscale uniforme à toutes les lignes.
L'étude d'extraction de factures arXiv a constaté que les échecs de cohérence étaient « concentrés dans les factures présentant des scénarios multi-taux complexes » — ce sont précisément les documents mixtes TTC/HT qui produisent Qty × Unit Price ≠ Line Total sans qu'aucun champ individuel ne soit erroné.
Comment le détecter : Vérifiez si le taux d'incohérence est corrélé à des codes de taxe ou des catégories de produits spécifiques sur la même facture. Si les lignes avec le code TVA « S » (taux standard) sont toutes correctes mais que les lignes avec le code « Z » (taux zéro) présentent un écart constant équivalent exactement au pourcentage de TVA, l'IA applique la mauvaise hypothèse d'inclusivité aux articles à taux zéro.
La solution : un cadre de validation à 3 niveaux pour la cohérence des lignes
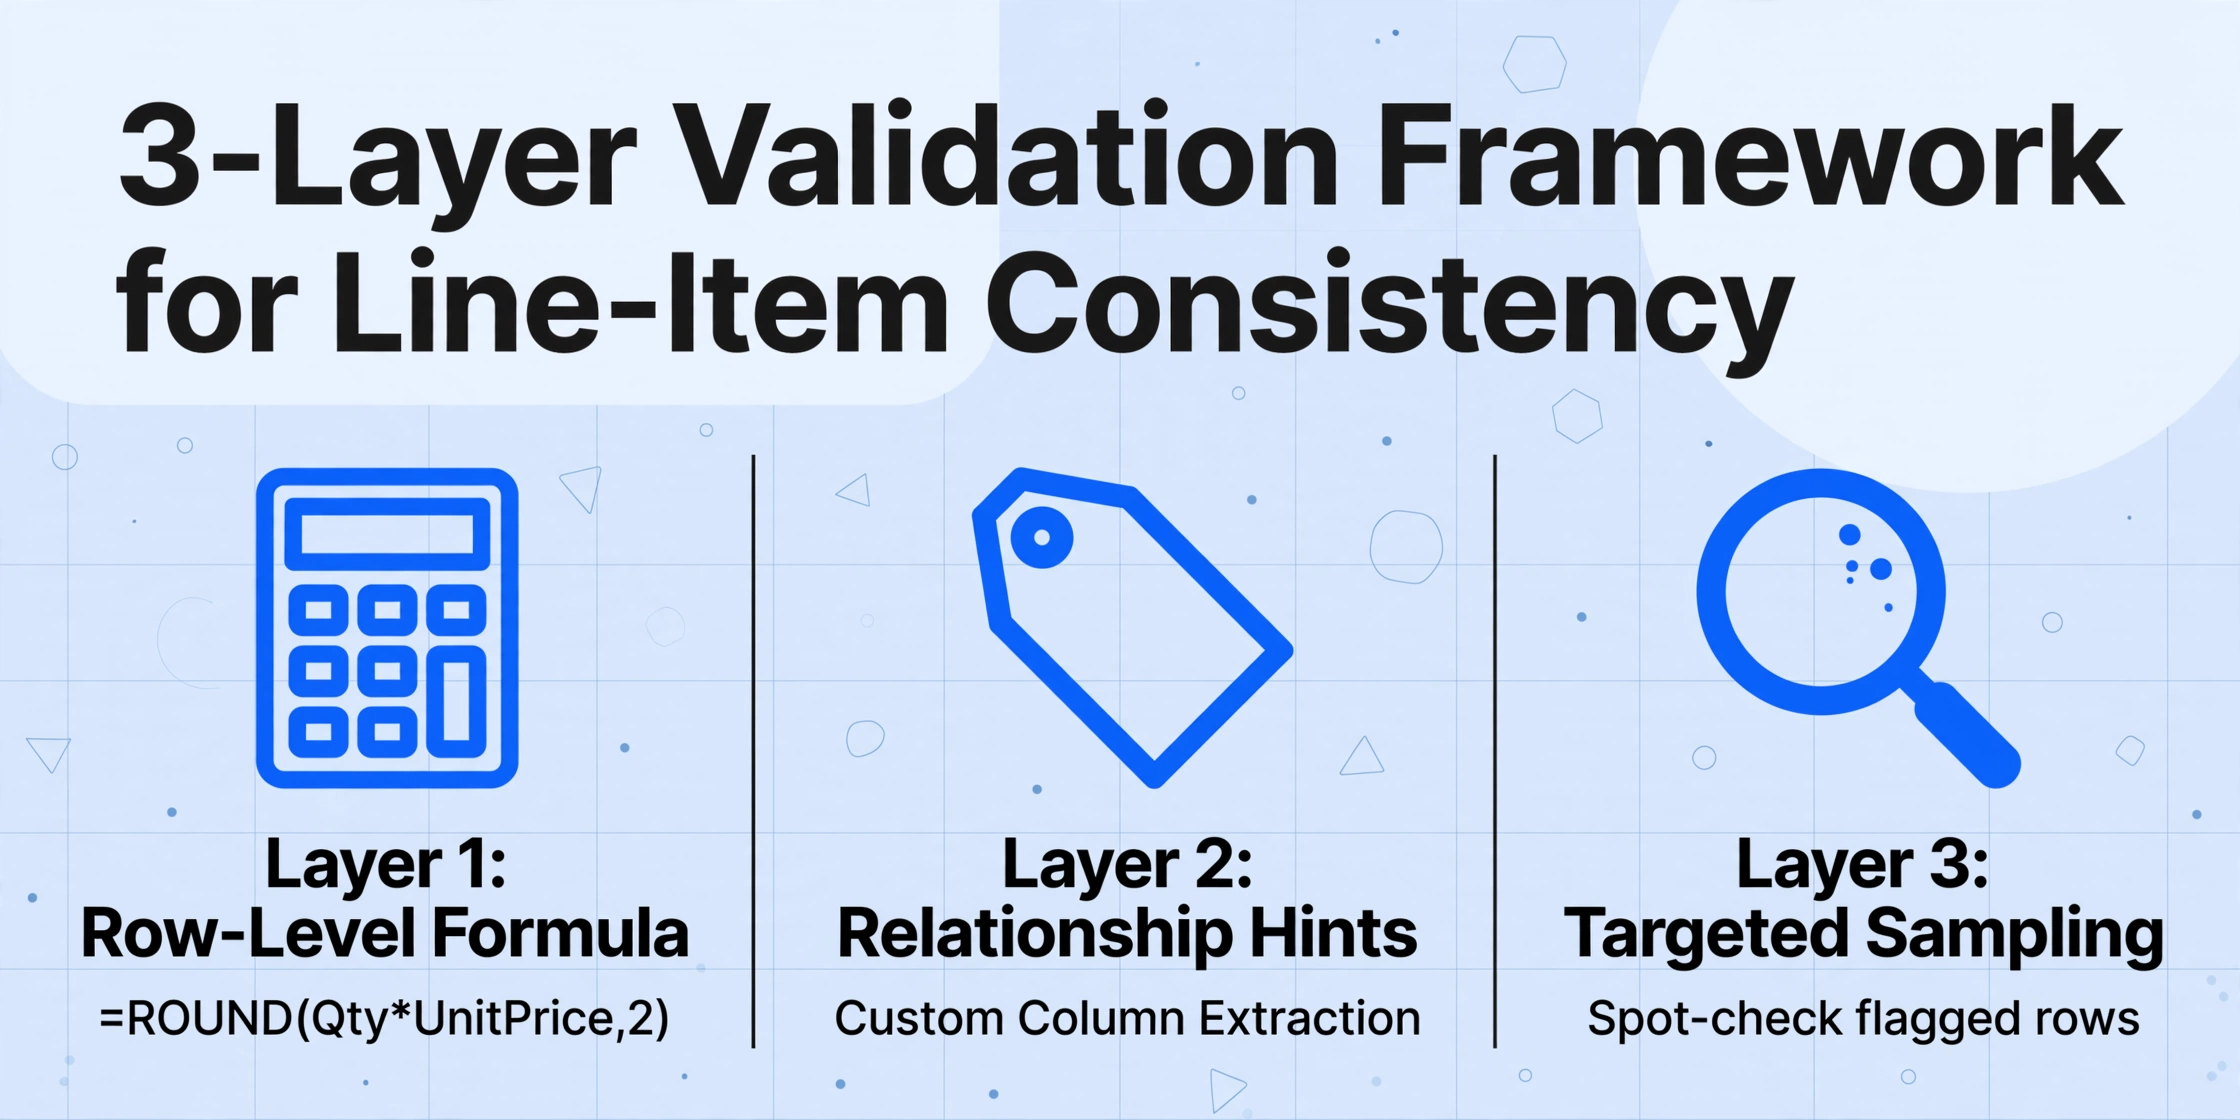
Chacune des quatre causes ci-dessus produit une signature différente dans les données extraites. Un cadre de validation systématique les détecte toutes — et rend visible ce que les scores de confiance par champ ne peuvent pas montrer.
Niveau 1 : Formule de validation au niveau de la ligne
Le moyen le plus rapide de tout détecter est une colonne de formule :
=ROUND(Qty*UnitPrice,2)Comparez avec le Line Total extrait. Signalez les lignes où l'écart dépasse $0.01, à l'aide d'un format conditionnel :
=ABS(ROUND(A2*B2,2)-C2)>0.01La direction et l'ampleur de l'écart vous indiquent quelle cause est en jeu :
- Les erreurs s'annulent entre les lignes → Cause 1 (lecture transversale). Toutes les valeurs sont présentes, simplement mal appariées.
- Écart constant par un facteur (par ex., toujours décalé de 0,5, 6 ou 12) → Cause 2 (confusion d'UOM). Le facteur est le multiplicateur d'unité de mesure.
- Écart constant en pourcentage → Cause 3 (confusion de remise). Le pourcentage correspond au taux de remise.
- Écarts liés à des codes de taxe spécifiques → Cause 4 (confusion d'inclusivité de la taxe). Le pourcentage d'écart correspond au taux de TVA/TPS applicable.
Niveau 2 : Indices de relation entre champs pour l'IA
Lors de la configuration de l'extraction, aidez l'IA à comprendre les relations entre les champs en étant explicite sur ce qui va ensemble. L'Extraction de colonnes personnalisées d'ImageToTable.ai fonctionne de manière sémantique — vous lui indiquez les colonnes souhaitées, et l'IA localise chaque valeur en comprenant sa signification. Pour améliorer l'appariement entre champs :
- Utilisez des noms de colonnes descriptifs : « Unit Price (per item) » et « Line Total (Qty × Unit Price) » aident l'IA à distinguer les valeurs unitaires des valeurs par ligne.
- Définissez une colonne calculée comme recoupement : Créez
Line Total Validation (Qty × Unit Price)— l'IA extrait les valeurs et effectue le calcul, révélant les incohérences pendant l'extraction plutôt qu'après l'export. - Définissez des formats de règle pour les champs numériques : Précisez que les quantités sont des nombres entiers sauf si une décimale est présente, et que les prix unitaires ont toujours deux décimales. Cela limite les interprétations ambiguës.
Niveau 3 : Échantillonnage ciblé par vérification ponctuelle
Même avec les contrôles de formule, certaines erreurs passent au travers — en particulier lorsque Qty × Price donne par coïncidence un Line Total plausible mais incorrect. L'échantillonnage ciblé par vérification ponctuelle comble cette lacune. Pour chaque lot, vérifiez manuellement : toutes les lignes signalées par le niveau 1, 10 % des lignes validées (pour détecter les totaux corrects par coïncidence) et une facture par fournisseur (particularités systémiques de mise en page). Cela détecte plus de 95 % des écarts de calcul tout en exigeant une vérification manuelle de moins de 15 % des données.
Quand remonter le problème : le seuil de 5 %
Si votre cadre de validation signale plus de 5 % des lignes d'un lot, le problème est probablement systémique — un schéma cohérent d'incohérences entre champs qu'aucun ajustement de formule de validation ne corrigera au niveau des lignes.
Trois scénarios justifient une remontée :
- Concentration chez un seul fournisseur : 70 % ou plus des lignes signalées proviennent d'un même fournisseur. Sa mise en page est incompatible avec votre approche actuelle. Prétraitez ces factures ou acheminez-les vers un pipeline différent.
- Complexité multi-taxes : Factures avec 3 taux de taxe ou plus, ou montants mixtes TTC/HT. Même les meilleurs modèles échouent sur ces cas 20 % du temps (selon l'étude arXiv). Signalez-les pour vérification manuelle par un commis AP spécialisé en fiscalité plutôt que de tenter de corriger l'extraction.
- Documents sources de mauvaise qualité : Si les signalements apparaissent simultanément dans les quatre schémas, la cause racine est une mauvaise OCR plutôt qu'une confusion relationnelle. Traitez d'abord la qualité de la source — voir les correctifs d'extraction des décimales et des devises.
Le seuil protège votre équipe d'un cycle d'ajustement sans fin. Si l'extraction atteint 98 % ou plus sur les champs indépendants et 95 % ou plus sur la cohérence inter-champs, cela est fonctionnel pour la plupart des flux de travail AP — les 5 % restants sont moins coûteux à gérer par routage d'exception qu'à éliminer entièrement.
FAQ
Un écart entre Qty et Price indique-t-il toujours une erreur d'extraction ?
Non. Certaines factures affichent légitimement des montants de ligne qui ne correspondent pas à Qty × Unit Price — en raison de remises sur volume appliquées au niveau de la ligne, de tarifs promotionnels ou d'offres groupées où le prix unitaire de la ligne est une moyenne, et non le prix par article. Vérifiez toujours le document original avant de considérer un écart comme une erreur d'extraction.
Puis-je me fier au total général si les lignes présentent des écarts de calcul ?
Pas automatiquement. Si la cause 1 (lecture inter-lignes) est en jeu, les erreurs s'annulent et le total général peut rester correct. Mais pour les causes 2 à 4, le total général est probablement erroné, car les montants de ligne alimentent les calculs de sous-total et de total. Résolvez toujours les écarts au niveau des lignes avant d'utiliser les totaux extraits pour le paiement.
Pourquoi mon outil d'IA affiche-t-il une confiance de 99 % sur des champs mal appariés ?
Parce que les scores de confiance mesurent la lisibilité individuelle des champs, et non la cohérence logique inter-champs. Un modèle de vision peut être confiant à 99 % que « 150,00 $ » apparaît à une certaine position sur la page — et cette confiance ne change pas selon que les 150,00 $ correspondent à un prix unitaire ou à un total de ligne. La validation inter-champs est une étape distincte qu'aucun score de confiance ne remplace.
Comment gérer la confusion des UOM entre différents fournisseurs ?
Standardisez votre sortie d'extraction en ajoutant une colonne « UOM » distincte à votre modèle d'extraction. Incluez une instruction de format claire : « Extrayez l'unité de mesure (EA, DZN, KG, FT, CASE, BOX) de la même ligne et affichez-la dans une colonne distincte. » Cela rend l'UOM visible dans votre sortie, afin que vous puissiez créer des règles de conversion dans votre feuille de calcul plutôt que de compter sur l'IA pour interpréter les unités automatiquement.
La ligne de détail est l'unité de vérité en AP
L'extraction au niveau de l'en-tête — nom du fournisseur, numéro de facture, total général — est devenue d'une précision courante. La frontière où la qualité varie encore de manière significative se situe au niveau des lignes de détail, où les relations entre champs comptent autant que les valeurs des champs. L'IA lit correctement les nombres individuels, mais l'affectation aux bonnes colonnes et lignes dépend de la compréhension de la sémantique du document par le modèle. Cette compréhension sémantique s'améliore rapidement, mais elle n'est pas encore au niveau où la validation inter-champs peut être omise. Le cadre — colonne de formule + indices de relations + échantillonnage ciblé — est le processus approprié pour tout flux d'extraction qui alimente le paiement ou le rapprochement.
Configurez la colonne de formule sur votre prochain lot. Les cinq minutes nécessaires pour ajouter =ROUND(Qty*UnitPrice,2) et un format conditionnel vous en apprendront plus sur la qualité de votre extraction que n'importe quel score de confiance.