Warum Ihre Rechnungszeilen-Mathematik
nach der Extraktion falsch ist
Ihr Rechnungsextraktor hat Lieferantenname, Rechnungsnummer und Gesamtsumme korrekt erfasst. Aber bei der Stichprobenprüfung der Zeilen stimmt etwas nicht: Zeile 3 zeigt Qty 4, Unit Price $150.00, Line Total $300.00 — $300 zu wenig. Doch jedes einzelne Feld sieht sauber aus. Die KI hat nichts falsch gelesen. Sie hat etwas falsch zugeordnet.
Wichtigste Erkenntnisse
- Ihr KI-Rechnungsextraktor meldet 99% Feldkonfidenz und die Qty × Preis-Mathematik ist trotzdem falsch — weil feldbezogene Konfidenzwerte die Lesbarkeit messen, nicht ob ein Unit Price zu Zeile 2 oder Zeile 3 gehört.
- Qty × Preis-Abweichungen folgen nur vier Mustern — und die Größe und Richtung der Abweichung zeigt, ob die KI Zeilen falsch zugeordnet, einen Einheiten-Multiplikator übersehen oder Vor-Rabatt- mit Nach-Rabatt-Beträgen verwechselt hat.
- Eine Formelspalte — =ROUND(Qty×UnitPrice,2) — erkennt alle vier Muster, und die fünf Minuten, die Sie für deren Hinzufügung benötigen, sagen Ihnen mehr über die Extraktionsqualität als jeder Konfidenzwert.
Dies ist der unauffälligste Fehlermodus bei der KI-gestützten Rechnungsdatenextraktion. Die KI erreicht bei einzelnen Feldern eine Genauigkeit von über 98 % – sie liest Mengen, Einzelpreise und Positionssummen als eigenständige Werte korrekt. Aber die Konsistenz zwischen Feldern ist eine grundlegend andere Herausforderung. Ein Vision-Modell, das „$150.00" von einer Seite mit hoher Sicherheit lesen kann, weiß nicht automatisch, ob diese $150.00 zum Einzelpreis von Zeile 2, zur Positionssumme von Zeile 3 oder zur Zwischensumme des Abschnitts gehören. Wenn diese Beziehungen brechen, stimmt die Mathematik der Positionspositionen nicht mehr, und der Fehler bleibt für feldbezogene Konfidenzwerte unsichtbar.
Eine Studie aus dem Jahr 2025 zu Docling und LlamaExtractor bestätigt diese Lücke: Konsistenzprüfungen (Positionen + Steuer = Gesamtsumme) scheiterten bei 20 % der Rechnungen – hauptsächlich bei solchen mit komplexen Mehrsteuerszenarien oder nicht standardmäßiger Formatierung (arXiv 2510.15727v1). Wenn Sie in Ihrer Ausgabe Abweichungen bei Menge × Preis feststellen, fallen Ihre Rechnungen wahrscheinlich in eines von vier unterschiedlichen Mustern.
Ursache 1: Die KI hat Qty aus Zeile 1 mit dem Preis aus Zeile 2 gepaart
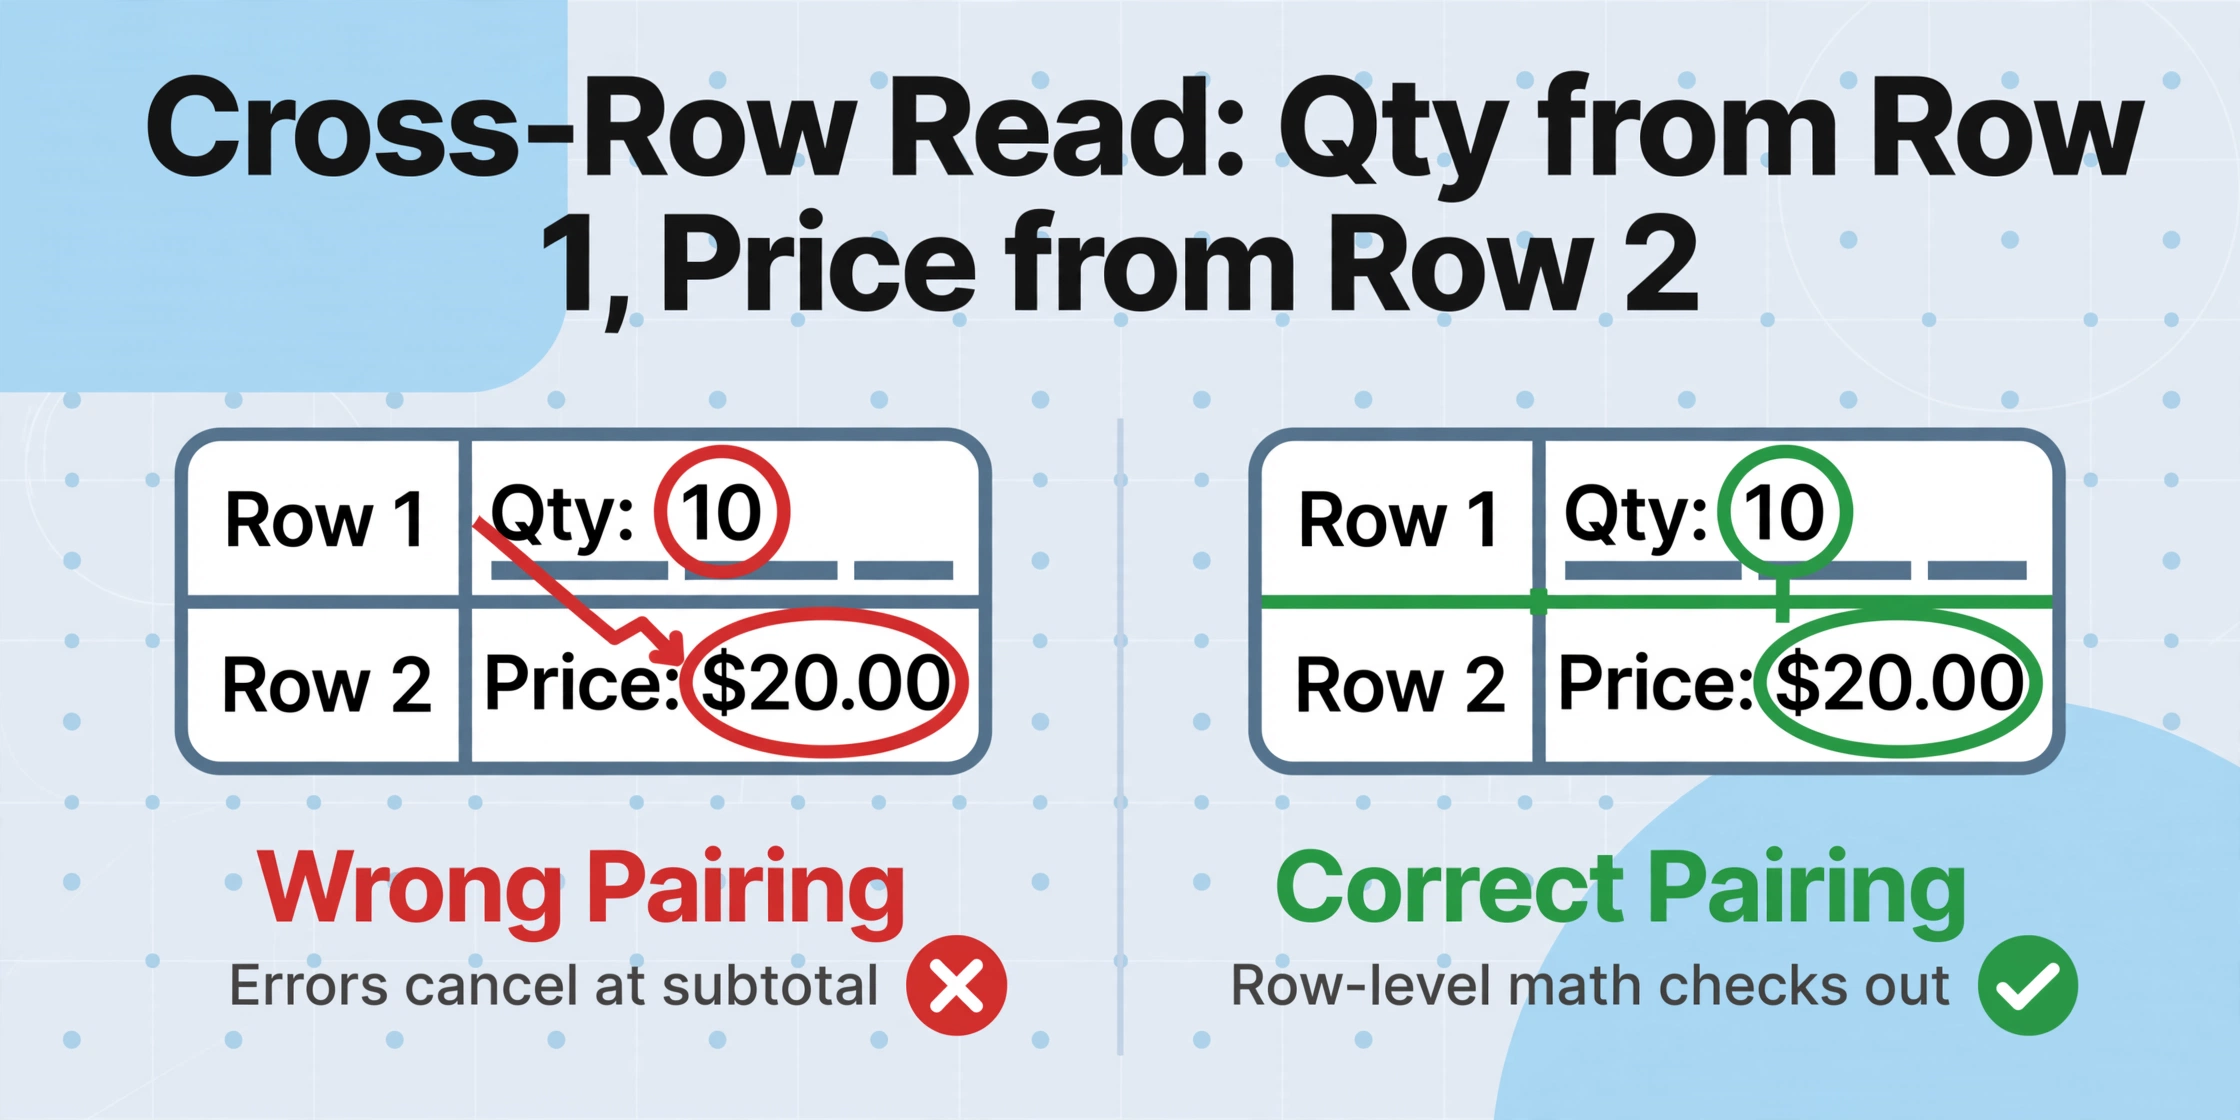
Dichte Positionstabellen sind die häufigste Quelle für zeilenübergreifende Zuordnungsfehler. Wenn eine Rechnung 15+ Positionen ohne sichtbare Zeilentrenner enthält – nur gestapelte Textzeilen – muss das räumliche Denken der KI genau entscheiden, wo eine Zeile endet und die nächste beginnt. Eine Verschiebung von wenigen Pixeln kann dazu führen, dass das Modell die Menge von Zeile N mit dem Einzelpreis von Zeile N+1 verknüpft.
Symptom: Einzelne Positionen haben falsche Berechnungen, aber die Summe aller Qty × Preis-Berechnungen entspricht der Rechnungszwischensumme. Das zeigt Ihnen, dass alle Werte korrekt sind – sie sind nur den falschen Nachbarn zugeordnet.
Zeilenübergreifende Ablesungen treten am häufigsten in drei Szenarien auf:
- Keine sichtbaren Zeilenränder: Rechnungen, die nur Leerraum zur Zeilentrennung verwenden. Die KI rät, wo die Grenzen liegen, und rät manchmal falsch.
- Mehrzeilige Beschreibungen: Eine Produktbeschreibung, die auf zwei Zeilen umbricht, verschiebt nachfolgende Zeilen nach unten. Die KI kann den Fortsetzungstext als neue Zeile interpretieren und verschiebt dadurch alle folgenden Paare.
- Verbundene Zellen in der Tabellenkopfzeile: Eine Kopfzeile mit verbundenen Spaltenbeschriftungen kann die Spaltenanzahl-Erkennung der KI verwirren und die gesamte Tabellenstruktur von Anfang an falsch ausrichten. Siehe wie verbundene Zellen die Tabellenextraktion stören für eine detailliertere Aufschlüsselung.
So erkennen Sie es: Führen Sie eine zeilenweise Validierungsformel durch (im Framework-Abschnitt unten detailliert beschrieben). Zeilenübergreifende Ablesungen erzeugen einen charakteristischen Fingerabdruck – einige Zeilen überschätzen die Summe, andere unterschätzen sie, und die Fehler heben sich auf Zwischensummenebene gegenseitig auf.
Ursache 2: Verwechslung der Maßeinheit – „12“ ist nicht immer 12 Stück
Eine Menge von „12“ auf einer Rechnungszeile ist ohne ihre Maßeinheit mehrdeutig. Sind es 12 Stück? 12 Dutzend (144 Einheiten)? 12 Kilogramm? 12 laufende Fuß bei $3,75 pro Fuß? Die Zahl selbst ist klar, aber die KI kann 12 nicht mit einem Unit Price multiplizieren, wenn sie nicht weiß, was „12“ darstellt.
Verwechslungen der Maßeinheit (UOM) erzeugen zwei unterschiedliche Fehlermuster:
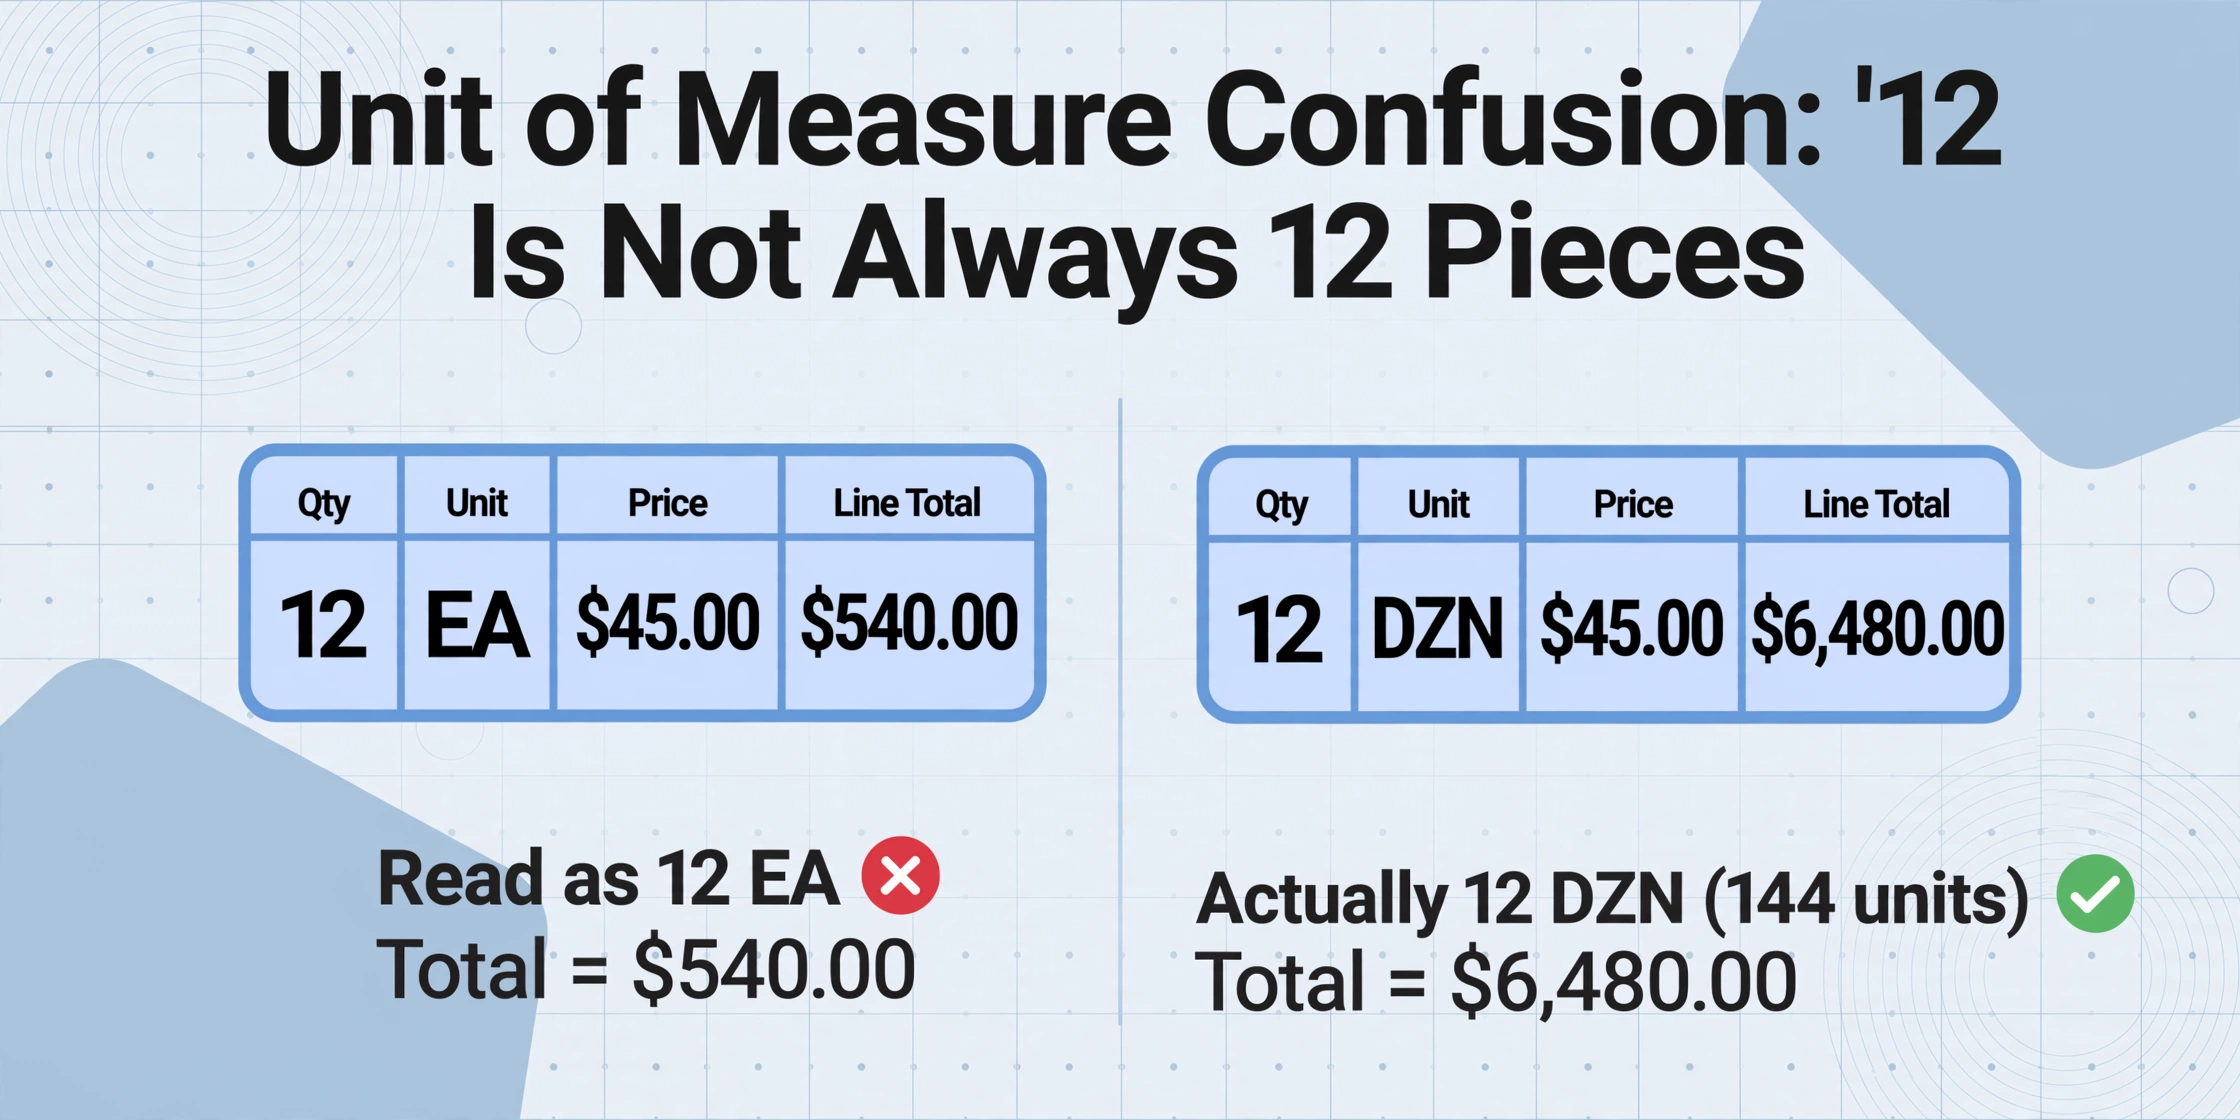
- UOM in einer separaten Spalte: Manche Rechnungen haben eine „UOM“-Spalte (EA, DZN, KG, FT) zwischen den Feldern für Menge und Unit Price. Wenn die KI diese Spalte nicht liest oder zuordnet, behandelt sie „12 DZN“ (144 Einheiten × Preis) als „12 EA“ (12 Einheiten × Preis), was eine Line Total ergibt, die 1/12 des korrekten Werts beträgt.
- UOM in der Beschreibung eingebettet: Viele Rechnungen schreiben „12 × CASE“ oder „12 @ CASE PRICE“ in das Beschreibungsfeld. Die KI liest „12“ in die Mengenspalte, hat aber keinen Mechanismus, um zu verstehen, dass dieses „12“ „12 Kartons mit je 6 Einheiten“ bedeutet. Die resultierende Summe aus Qty × Preis weicht um den Karton-Multiplikator ab.
Dieser Fehler ist trügerisch, weil die Zahlen intern konsistent aussehen. Qty = 12, Unit Price = $45,00, Line Total = $540,00 – die Rechnung stimmt. Aber wenn die Rechnung tatsächlich „12 Dutzend zu $45,00 pro Dutzend“ besagt und die KI es als 12 Stück gelesen hat, weicht die Summe um den Faktor 12 ab. Die KI hat plausible Zahlen extrahiert, die zufällig den betriebswirtschaftlichen Realitätscheck nicht bestehen.
Einheitenbezogene Extraktionsprobleme verstärken sich, wenn das Quelldokument fehlende Dezimalpunkte oder mehrdeutige Währungssymbole aufweist – ein fehlender Dezimalpunkt beim Unit Price vergrößert jede UOM-Fehlausrichtung.
So erkennen Sie es: Gleichen Sie die Line Total mit einem Preisbuch oder historischen Durchschnittswerten für denselben Artikel ab. Ein Unit Price von $45,00 für einen Artikel, der historisch $7,50 pro Einheit kostet, ist eine Warnung – die KI hat möglicherweise die UOM als „EA“ gelesen, obwohl es „BOX (6 EA)“ war. Bei Rechnungen ohne historische Daten markieren Sie jede Zeile, in der Qty × Unit Price eine runde Zahl ergibt, die von den erwarteten Preisspannen abweicht.
Ursache 3: Verwechslung von Zeilenbeträgen vor und nach Rabatt
Rechnungen verwenden verschiedene Konventionen zur Darstellung von Positionssummen. Einige zeigen den Bruttobetrag (vor Rabatt) in der Zeile und wenden Rabatte in der Rechnungsfußzeile an. Andere berechnen den Nettobetrag (nach Rabatt) direkt in der Zeile und fassen einen „Gesamtrabatt“-Betrag separat zusammen. KI-Extraktionsmodelle können oft nicht erkennen, welche Konvention eine bestimmte Rechnung verwendet, insbesondere wenn die Spaltenüberschrift einfach „Amount“ lautet.
Beispiel: Die Position zeigt „Qty 10, Unit Price $50.00, Amount $475.00.“ Die Rechnung stimmt bei 10 × $47.50, aber der Unit Price lautet $50.00. Was ist passiert? Die Rechnung wendet einen Rabatt auf Zeilenebene von 5 % an ($2.50/Einheit) und zeigt den Nettobetrag in der Zeile, während der Brutto-Unit Price angezeigt wird. Die KI hat beide Werte korrekt extrahiert – sie gehören nur zu verschiedenen Stufen der Rabattberechnung.
Drei Rabattkonventionen sind häufig genug, um regelmäßig für Verwirrung bei der Extraktion zu sorgen:
- Rabatt auf Zeilenebene, Zeile zeigt Bruttobetrag: Die Zeile zeigt Qty × Vollpreis. Der Rabatt wird in der Rechnungsfußzeile angewendet. Die KI extrahiert den Positionsbetrag unverändert, und Qty × Preis stimmt überein. Keine Diskrepanz hier – aber der Rabattbetrag ist auf Zeilenebene unsichtbar.
- Rabatt auf Zeilenebene, Zeile zeigt Nettobetrag: Die Zeile zeigt Qty × (Vollpreis − Rabatt). Die Unit Price-Spalte zeigt weiterhin $50.00, aber der Positionsbetrag spiegelt den rabattierten Wert wider. Qty × $50.00 ≠ Line Total, obwohl jedes Feld korrekt gelesen wird.
- Gemischte Konvention auf derselben Rechnung: Einige Positionen haben Rabatte, andere nicht. Die KI wendet eine einheitliche Interpretation auf alle Zeilen an, wodurch einige übereinstimmen und andere fehlschlagen.
So erkennen Sie es: Das Kennzeichen dieses Fehlers ist, dass Qty × Unit Price den Line Total über mehrere Zeilen hinweg konsistent um einen festen Prozentsatz übersteigt. Wenn Sie „Amount = Qty × Price × 0.95“ als Muster bei rabattierten Zeilen sehen, während nicht rabattierte Zeilen übereinstimmen, verwendet die Rechnung die Netto-Anzeige in der Zeile. Kennzeichnen Sie diese und bestätigen Sie die Rabattbedingungen des Anbieters, anstatt einen Extraktionsfehler anzunehmen.
Ursache 4: Inklusive und exklusive Positionsbeträge in einer Rechnung vermischt
Rechnungen in MwSt./GST-Ländern mischen häufig inklusive und exklusive Preisangaben auf demselben Dokument. Einige Positionen enthalten die Steuer im angezeigten Betrag (üblich bei Konsumgütern oder B2C-Verkäufen). Andere zeigen den Betrag ohne Steuer, wobei die MwSt. in der Fußzeile berechnet wird (Standard für B2B). Ein KI-Modell, das eine einzige Interpretation auf alle Positionen anwendet, erzeugt bei den gemischten Zeilen eine Diskrepanz.
Viele Rechnungen kennzeichnen einzelne Zeilen nicht als „inkl. MwSt.“ oder „exkl. MwSt.“. Die Unterscheidung ergibt sich aus Kundentyp, Produktkategorie oder Rechtsraum – eine Nuance, die selbst Buchhaltungssoftware wie Xero und AutoEntry mit eigenen Umschaltern behandelt, gerade weil sie nicht trivial ist.
Drei reale Szenarien führen zu diesem Fehler:
- Rechnungen mit gemischten Leistungen: Eine einzelne Hotelrechnung listet beispielsweise Zimmerkosten (MwSt.-pflichtig zum Standardsatz) neben Servicegebühren (MwSt.-befreit) und Parken (ermäßigter Satz). Je nach Buchhaltungssystem des Lieferanten kann jede Zeile inklusiv oder exklusiv angezeigt werden, was ein inkonsistentes Extraktionsziel schafft.
- Internationale Rechnungen: Ein US-Lieferant stellt einem britischen Kunden eine Rechnung. Die Rechnung zeigt Positionsbeträge in USD (ohne MwSt.), aber die Fußzeile enthält einen Hinweis auf die Reverse-Charge-MwSt. Die KI, die hauptsächlich mit inländischen Rechnungsmustern trainiert wurde, könnte die steuerfreien Positionsbeträge unterschiedlich interpretieren.
- Gutschriften und Korrekturen: Korrekturzeilen, die sich auf ursprüngliche inklusive/exklusive Beträge beziehen, erzeugen eine Diskrepanz, wenn die KI eine einheitliche Steuerinterpretation auf alle Zeilen anwendet.
Die arXiv-Studie zur Rechnungsextraktion ergab, dass Konsistenzfehler „konzentriert in Rechnungen mit komplexen Mehrsteuerszenarien“ auftraten – genau diese gemischt inklusiven/exklusiven Dokumente erzeugen Qty × Price ≠ Line Total, ohne dass ein einzelnes Feld falsch ist.
So erkennen Sie es: Prüfen Sie, ob die Abweichungsrate mit bestimmten Steuercodes oder Produktkategorien auf derselben Rechnung korreliert. Wenn Zeilen mit MwSt.-Code „S“ (Standardsatz) alle stimmen, aber Zeilen mit Code „Z“ (nullsteuerpflichtig) eine konsistente Abweichung in Höhe des MwSt.-Prozentsatzes zeigen, wendet die KI die falsche Inklusivitätsannahme auf die nullsteuerpflichtigen Positionen an.
Die Lösung: Ein 3-Ebenen-Validierungsframework für Positionskonsistenz
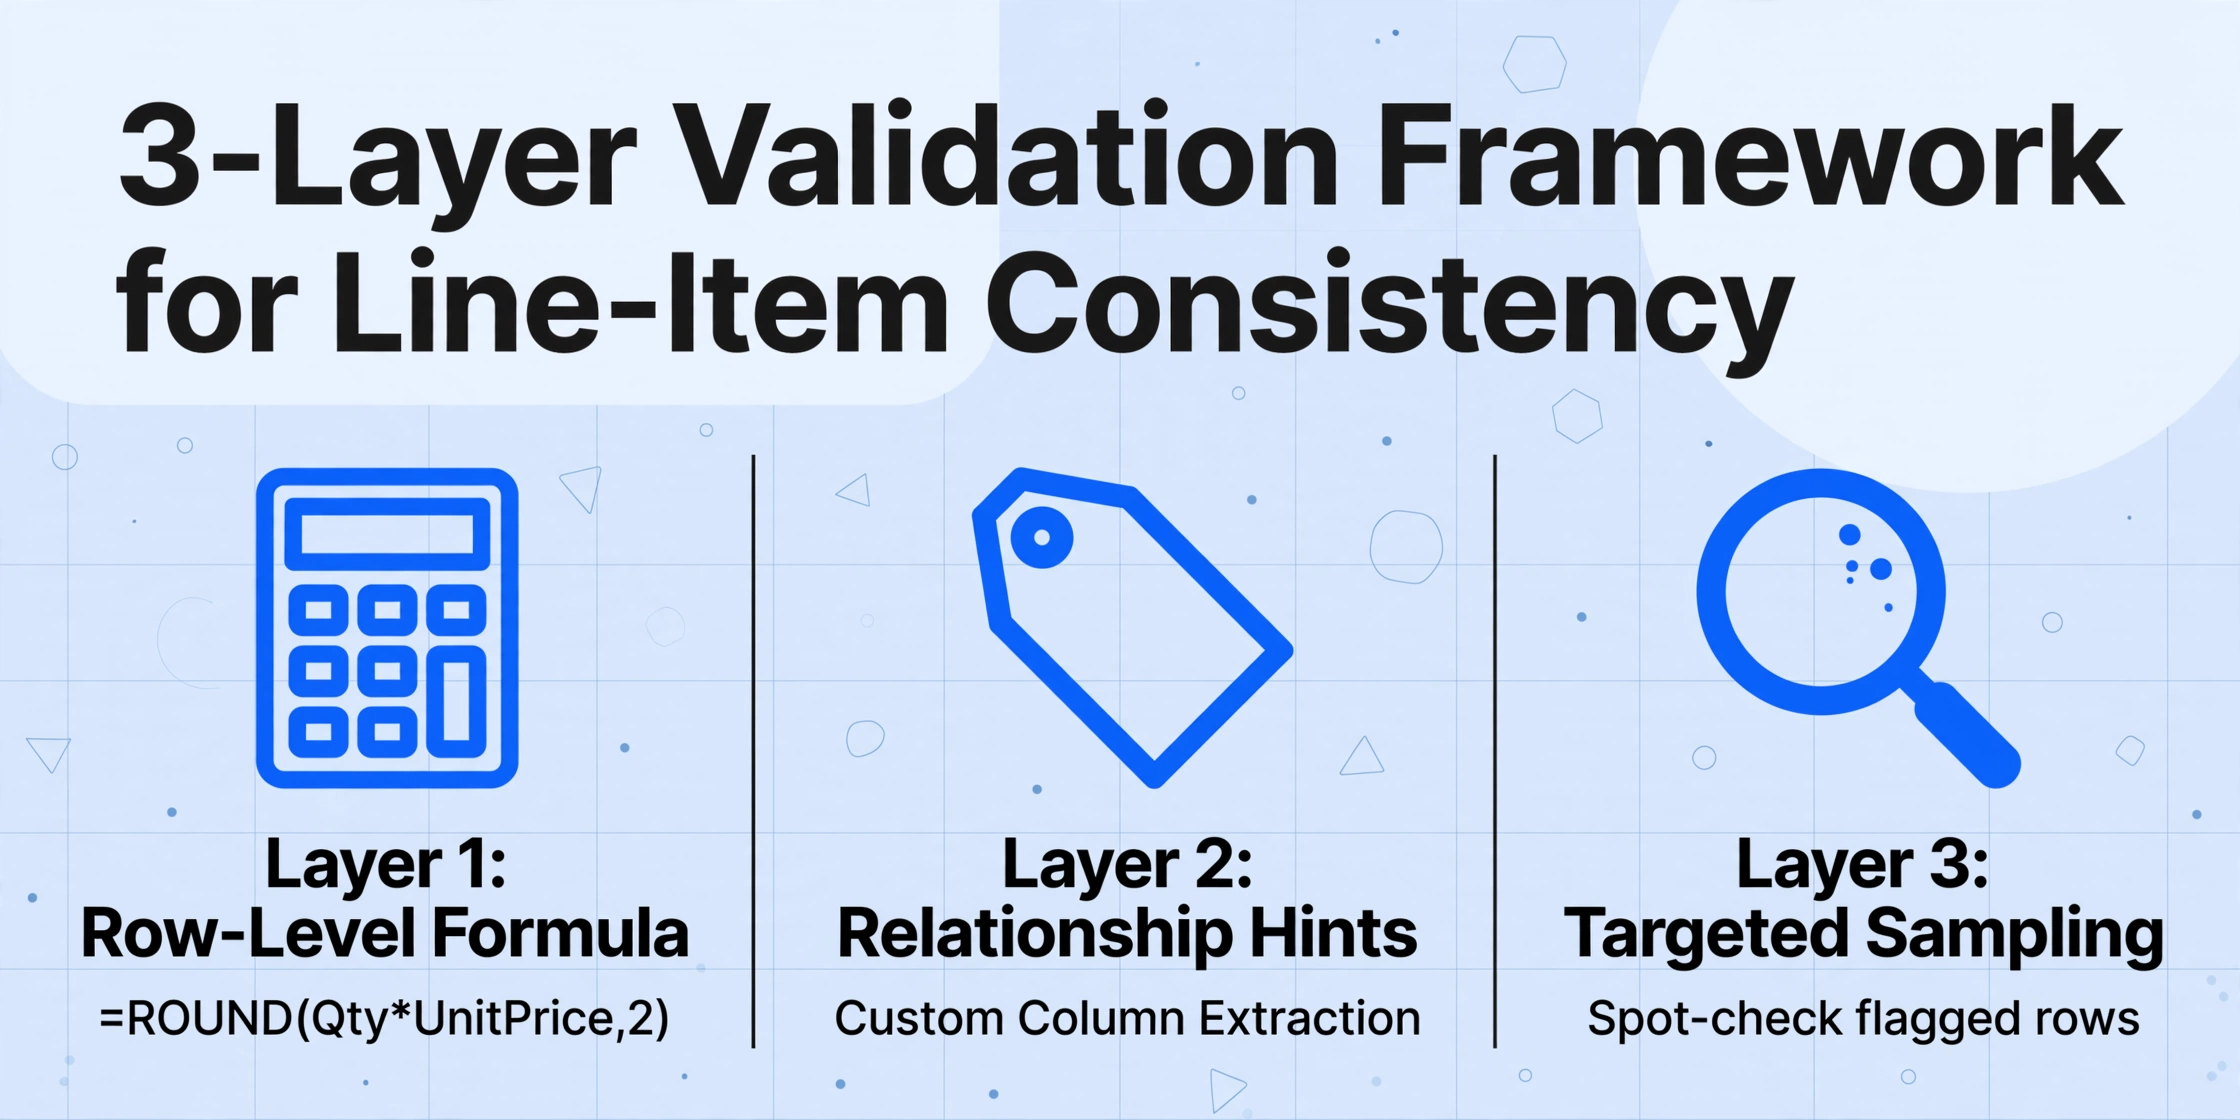
Jede der vier oben genannten Ursachen erzeugt ein anderes Muster in den extrahierten Daten. Ein systematisches Validierungsframework erfasst alle — und macht sichtbar, was feldbezogene Konfidenzwerte nicht können.
Ebene 1: Zeilenbezogene Validierungsformel
Der schnellste Allrounder ist eine Formelspalte:
=ROUND(Qty*UnitPrice,2)Vergleichen Sie mit dem extrahierten Line Total. Markieren Sie Zeilen, bei denen die Abweichung $0.01 übersteigt, mit einer bedingten Formatierung:
=ABS(ROUND(A2*B2,2)-C2)>0.01Richtung und Ausmaß der Abweichung zeigen Ihnen, welche Ursache vorliegt:
- Fehler heben sich über Zeilen hinweg auf → Ursache 1 (zeilenübergreifendes Lesen). Alle Werte sind vorhanden, nur falsch zugeordnet.
- Konsistente Faktorabweichung (z. B. immer um 0,5, 6 oder 12 daneben) → Ursache 2 (UOM-Verwechslung). Der Faktor ist der Mengeneinheits-Multiplikator.
- Konsistente prozentuale Abweichung → Ursache 3 (Rabattverwechslung). Der Prozentsatz entspricht dem Rabattsatz.
- Abweichungen, die an bestimmte Steuercodes gebunden sind → Ursache 4 (Verwechslung der Steuerinklusivität). Der Abweichungsprozentsatz entspricht dem geltenden VAT/GST-Satz.
Ebene 2: Feldbeziehungshinweise für die KI
Unterstützen Sie die KI bei der Konfiguration der Extraktion, indem Sie Feldbeziehungen explizit klarmachen — sagen Sie klar, was zusammengehört. Die Benutzerdefinierte Spaltenextraktion von ImageToTable.ai arbeitet semantisch — Sie geben die gewünschten Spalten an, und die KI findet jeden Wert, indem sie dessen Bedeutung versteht. So verbessern Sie die feldübergreifende Zuordnung:
- Verwenden Sie beschreibende Spaltennamen: „Unit Price (per item)" und „Line Total (Qty × Unit Price)" helfen der KI, Einzelpreis- von Positionswerten zu unterscheiden.
- Definieren Sie eine berechnete Spalte als Gegenprüfung: Erstellen Sie
Line Total Validation (Qty × Unit Price)— die KI extrahiert die Werte und führt die Berechnung aus, wodurch Abweichungen bereits während der Extraktion sichtbar werden, nicht erst nach dem Export. - Legen Sie Formatregeln für Zahlenfelder fest: Geben Sie an, dass Mengen ganze Zahlen sind, sofern keine Dezimalzahl vorliegt, und dass Unit Price immer zwei Dezimalstellen hat. Das schränkt mehrdeutige Interpretationen ein.
Ebene 3: Gezielte Stichprobenprüfung
Selbst mit Formelprüfungen entgehen einige Fehler der Erkennung — insbesondere wenn Qty × Price zufällig einem plausiblen, aber falschen Line Total entspricht. Gezielte Stichprobenprüfung schließt diese Lücke. Prüfen Sie bei jedem Batch manuell: alle von Ebene 1 markierten Zeilen, 10 % der bestandenen Zeilen (um zufällig korrekte Summen zu erkennen) sowie eine Rechnung pro Lieferant (systemische Formatierungseigenheiten). Dadurch werden über 95 % der Rechenfehler erkannt, während weniger als 15 % der Daten manuell geprüft werden müssen.
Wann eskaliert werden sollte: Die 5-%-Schwelle
Wenn Ihr Validierungsframework mehr als 5 % der Positionen in einem Batch markiert, liegt das Problem wahrscheinlich systemisch vor — ein konsistentes Muster von feldübergreifenden Abweichungen, das keine noch so große Anpassung der Validierungsformeln auf Positionsebene beheben wird.
Drei Szenarien rechtfertigen eine Eskalation:
- Konzentration auf einen Lieferanten: Über 70 % der markierten Zeilen stammen von einem Lieferanten. Dessen Layout ist mit Ihrem aktuellen Ansatz nicht kompatibel. Verarbeiten Sie diese Rechnungen vorab oder leiten Sie sie an eine andere Pipeline weiter.
- Komplexe Mehrfachsteuern: Rechnungen mit 3+ Steuersätzen oder gemischten inklusiven/exklusiven Beträgen. Selbst die besten Modelle scheitern bei diesen in 20 % der Fälle (laut arXiv-Studie). Markieren Sie diese zur manuellen Prüfung durch einen steuerspezialisierten AP-Sachbearbeiter, anstatt die Extraktion zu korrigieren.
- Schlechte Quelldokumente: Wenn Markierungen gleichzeitig in allen vier Mustern auftreten, liegt die Ursache in schlechter OCR-Qualität und nicht in Beziehungsverwechslungen. Beheben Sie zuerst die Quellqualität — siehe Korrekturen bei Dezimal- und Währungsextraktion.
Die Schwelle schützt Ihr Team vor einer endlosen Optimierungsschleife. Wenn die Extraktion bei unabhängigen Feldern über 98 % und bei feldübergreifender Konsistenz über 95 % erreicht, ist das für die meisten AP-Workflows funktional — die verbleibenden 5 % lassen sich kostengünstiger über Ausnahmerouting abwickeln, als sie vollständig zu eliminieren.
FAQ
Bedeutet eine Abweichung zwischen Qty und Preis immer einen Extraktionsfehler?
Nein. Einige Rechnungen zeigen tatsächlich Positionsbeträge, die nicht Qty × Unit Price entsprechen — wegen Mengenrabatten auf Positionsebene, Aktionspreisen oder Paketangeboten, bei denen der Unit Price in der Position ein Durchschnittswert ist und nicht der Einzelpreis. Prüfen Sie immer die Originalrechnung, bevor Sie eine Abweichung als Extraktionsfehler behandeln.
Kann ich der Gesamtsumme vertrauen, wenn Positionen mathematische Abweichungen aufweisen?
Nicht automatisch. Wenn Ursache 1 (zeilenübergreifendes Lesen) vorliegt, heben sich die Fehler auf und die Gesamtsumme kann trotzdem korrekt sein. Bei den Ursachen 2–4 ist die Gesamtsumme jedoch wahrscheinlich falsch, da die zugrunde liegenden Positionsbeträge in die Zwischensummen- und Gesamtberechnungen einfließen. Lösen Sie immer zuerst die Abweichungen auf Positionsebene, bevor Sie die extrahierten Summen für Zahlungen verwenden.
Warum meldet mein KI-Tool 99 % Konfidenz bei Feldern, die falsch zugeordnet sind?
Weil Konfidenzwerte die Lesbarkeit einzelner Felder messen, nicht die logische Konsistenz zwischen Feldern. Ein Vision-Modell kann zu 99 % sicher sein, dass „$150.00" an einer bestimmten Position auf der Seite erscheint — und diese Sicherheit ändert sich nicht, ob die $150.00 ein Unit Price oder ein Line Total sind. Die feldübergreifende Validierung ist ein separater Schritt, den kein Konfidenzwert ersetzt.
Wie gehe ich mit UOM-Verwechslungen bei verschiedenen Lieferanten um?
Standardisieren Sie Ihre Extraktionsausgabe, indem Sie eine separate Spalte „UOM" zu Ihrer Extraktionsvorlage hinzufügen. Fügen Sie eine klare Formatanweisung hinzu: „Extrahieren Sie die Maßeinheit (EA, DZN, KG, FT, CASE, BOX) aus derselben Zeile und geben Sie sie als separate Spalte aus." Dadurch wird die UOM in Ihrer Ausgabe sichtbar, sodass Sie Umrechnungsregeln in Ihrer Tabellenkalkulation aufbauen können, statt sich darauf zu verlassen, dass die KI Einheiten automatisch interpretiert.
Die Position ist die Wahrheitseinheit in der AP
Die Extraktion auf Kopfebene — Lieferantenname, Rechnungsnummer, Gesamtsumme — ist inzwischen standardmäßig genau. Die Grenze, an der die Qualität noch deutlich variiert, liegt auf Positionsebene, wo Feldbeziehungen genauso wichtig sind wie Feldwerte. Die KI liest einzelne Zahlen korrekt, aber die Zuordnung zu den richtigen Spalten und Zeilen hängt davon ab, dass das Modell die Dokument-Semantik versteht. Dieses semantische Verständnis verbessert sich schnell, ist aber noch nicht auf dem Niveau, auf dem die feldübergreifende Validierung übersprungen werden kann. Das Framework — Formelspalte + Beziehungshinweise + gezielte Stichproben — ist der geeignete Prozess für jeden Extraktionsworkflow, der Zahlungen oder Abstimmungen speist.
Richten Sie die Formelspalte bei Ihrem nächsten Batch ein. Die fünf Minuten, die das Hinzufügen von =ROUND(Qty*UnitPrice,2) und einer bedingten Formatierung dauert, verraten Ihnen mehr über Ihre Extraktionsqualität als jeder Konfidenzwert.