EHRスクリーンショットから臨床データを抽出する方法
EHRスクリーンショット — テンプレート不要の意味的抽出
中規模医療システムの臨床データアブストラクターがEpicを開き、患者のカルテに移動して確認を始めます。バイタル。薬剤。検査パネル。問題リスト。各データポイントは目の前の画面に表示されています — 完全にデジタルで、完全に判読可能です — しかし、それをレジストリ提出ツール、脳卒中レジストリデータベース、または品質指標スプレッドシートに入力するには、読み取って再入力する必要があります。フィールドごとに。患者ごとに。これは彼らだけの問題ではありません。2024年のCarta Healthcareによる臨床データアブストラクター調査では、回答者の半数以上が勤務時間の大半を手動データ入力と抽出に費やしていることが判明し、70%が手動抽出によるエラーや不一致に遭遇したと報告しており、20%はそれが「非常に頻繁に」発生すると回答しました。皮肉なことに、データはすでにデジタル化され、EHR内のリレーショナルデータベースに保存されていますが、スクリーンショット、印刷レポート、またはエクスポートされたPDFとして表示された瞬間、再び非構造化データになります。人間が転記しなければならないものになるのです。
スクリーンショットのパラドックス:デジタル記録がデータ抽出を保証しない理由
電子カルテはデータの可搬性問題を解決するはずだった。しかし、新たな問題を生み出した。すなわち、臨床データ交換の事実上の単位としてのスクリーンショットである。
これは誇張ではない。Redditのr/healthITで、ある病院の請求担当者は臨床データワークフローの日常をこう述べている:"システム間のデータ交換は非常に面倒で、通常は必要なフィールドを一つずつコピー&ペーストして別のシステムに移すしかない。" r/clinicalresearchの臨床研究スレッドでは、EMRからEDCへのデータ入力がなぜ手作業で面倒なのかが問われた。最も支持された回答:"各病院のプライバシーとセキュリティ上の懸念。すべての施設が異なり、ほぼすべての施設がPHIに対して極度の信頼問題を抱えている。"
根本原因は構造的なものだ。EHRシステム(Epic、Cerner(現Oracle Health)、Meditech)は、抽出ではなくトランザクション処理向けに設計された独自のリレーショナルデータベースにデータを格納する。Epicは、Chroniclesトランザクションシステムから臨床データをミラーリングするClarityというレポート用データベースを使用する。CernerはMillenniumに依存しており、ベンダー固有のスキーマを持つ数百のテーブルにわたってレコードを整理する。データベースへの直接アクセスには、ほとんどの臨床チームが持っていないSQLの専門知識が必要であり、ほとんどの医療システムはそれを許可していない。
これがスクリーンショットのパラドックスを生み出す。データはEHR内でデジタル化されているが、別のシステム(臨床レジストリ、研究データベース、品質報告用スプレッドシート)に移す唯一の方法は画面を介することだ。誰かがログインし、適切な患者、適切な診療、適切なタブに移動し、必要な値を読み取る。そして、それらを別の場所に入力する。これが実際の臨床データ抽象化である。患者の医療記録から重要な情報を抽出、レビュー、検証する体系的なプロセスだ。そして「体系的」という言葉に反して、圧倒的に手作業である。『Journal of AHIMA』に掲載された研究によると、医療機関の58%が手動抽象化を主要な方法として使用しており、自然言語処理を使用しているのはわずか18%、単純なデータベースクエリを使用しているのは12%である(PMC研究、2021年)。
臨床データが標準フォームより抽出しにくい理由
標準的な請求書には、日付、金額、ベンダー名、明細項目など十数個のフィールドがあり、その意味はフォーマットを問わず明確です。しかし臨床記録は異なります。同じデータ型でも、EHRモジュール、レポートのレイアウト、さらには同じ医療システム内のどの病院が生成したかによって、表現が大きく異なります。ここでは、従来の抽出アプローチを困難にする4つのデータカテゴリとその理由を説明します。
バイタルサイン:単なる数字以上のもの
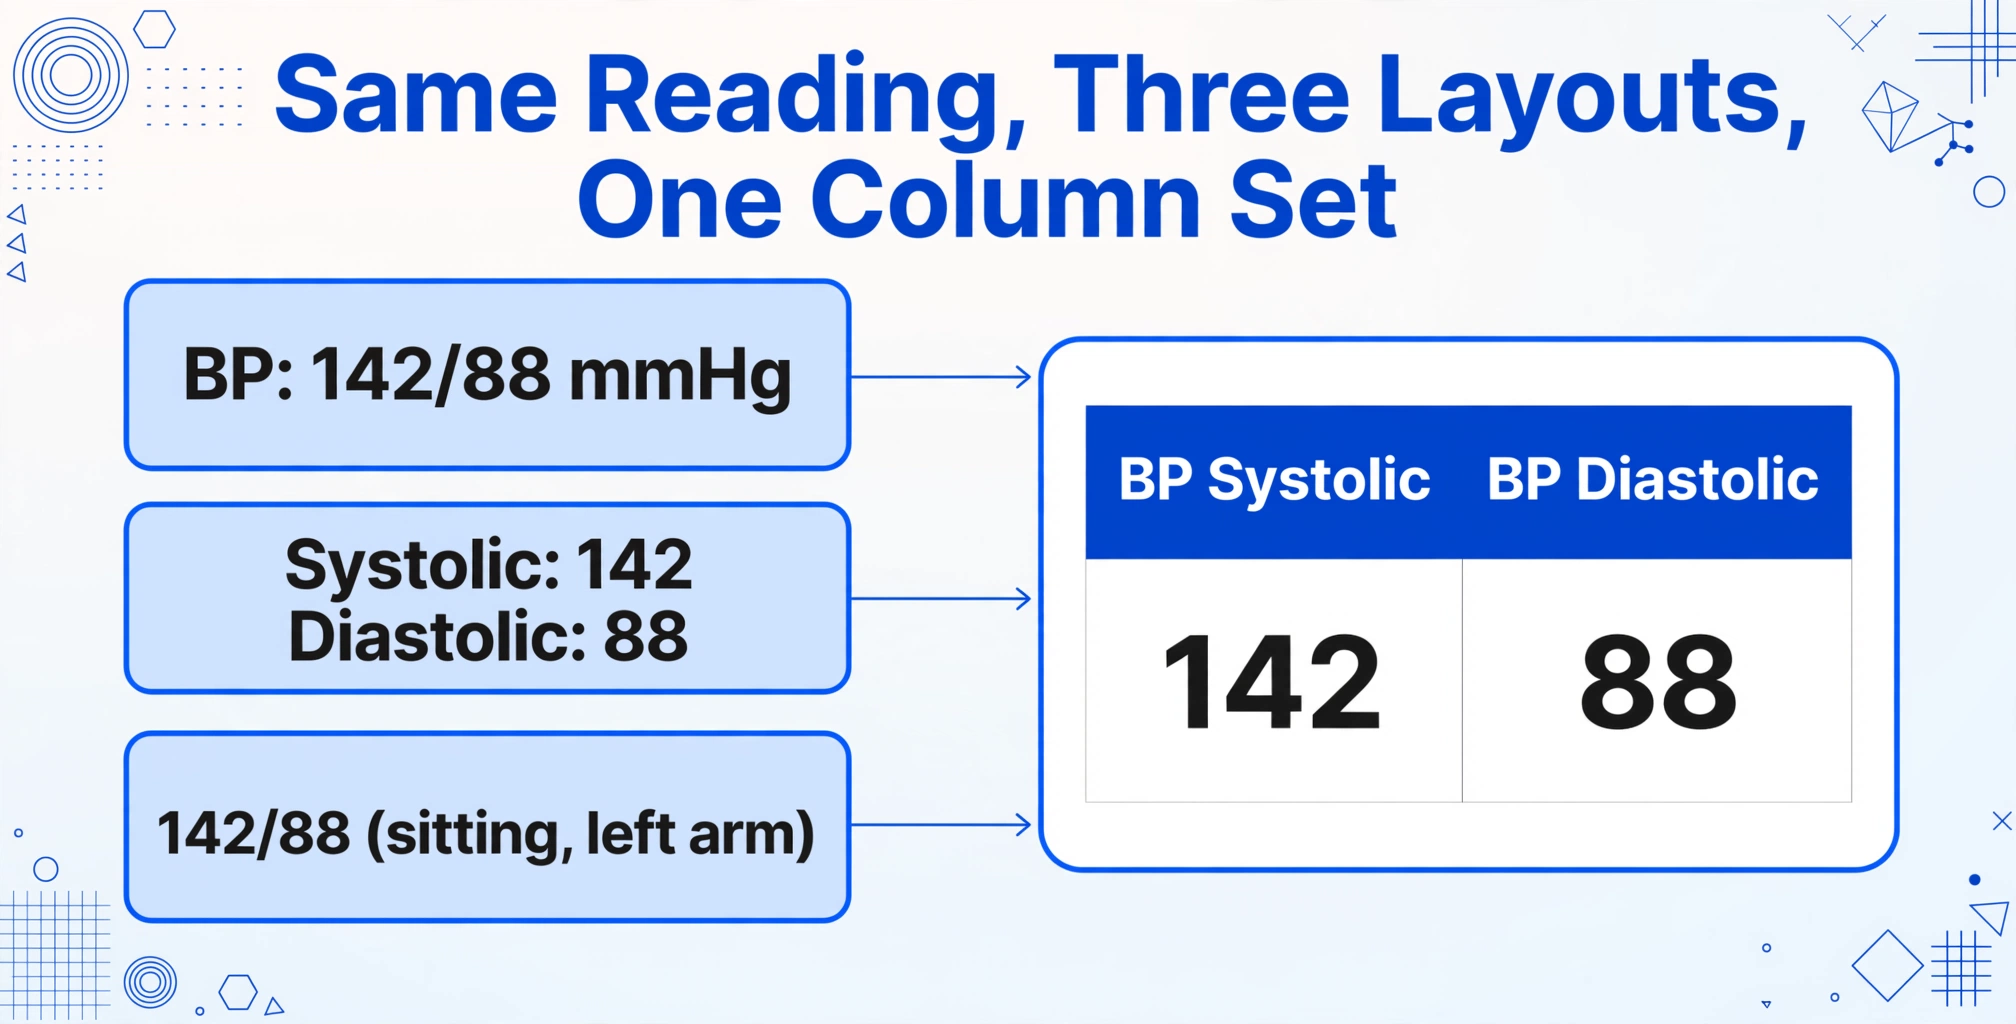
「142/88」という血圧測定値は、ある画面ではBP: 142/88 mmHg、別の画面では「収縮期:142」「拡張期:88」という2行のテーブル、さらに別の画面では「142/88(座位、左腕)」のように体位の情報が付加されて表示されることがあります。固定ピクセル座標で値を探したり、既知のラベル形式にパターンマッチングしたりするテンプレートベースの抽出ツールは、最初のバリエーションで破綻します。レイアウトごとに個別のテンプレートが必要になるからです。一方、意味的抽出モデルは、「142/88」「収縮期142/拡張期88」「BP 142/88」がすべて同じ臨床概念を表していることを、フォーマットに関係なく認識します。位置ではなく意味で読み取るからです。
バイタルサインには、患者の年齢、性別、臨床的状況によって変化する基準範囲も付随します。心拍数110bpmは新生児では正常ですが、安静時の成人では注意が必要です。抽出ツールがその臨床的判断を行う必要はありません(行うのはアブストラクターです)。ただし、値とその単位、記録されたタイムスタンプを正確に保持し、アブストラクターが後続のレビューに必要な完全な情報を得られるようにする必要があります。
同じ測定値はEHRの外にも現れます。在宅介護スタッフが訪問を記録する際、血圧計、血糖値計、パルスオキシメーターの表示を撮影し、後で各数値をケアログに入力します。この在宅介護スタッフのバイタル写真も同じ抽出問題です。訪問ごとに1行、収縮期、拡張期、脈拍、SpO2を列として持つものです。
投薬リスト:フリーテキストにおける複数フィールドの解析
電子カルテ画面上の投薬データが、きれいな表形式になっていることはまれです。薬剤名、用量、投与経路、頻度、最終投与時刻の列を持つ継続的投薬記録(MAR)として表示されることもあれば、「メトホルミン1000 mg PO BID、リシノプリル20 mg PO 毎日、アトルバスタチン40 mg PO QHS」といった文章形式の投薬照合メモとして表示されることもあります。前者は表形式、後者は文章形式です。テンプレートベースのOCRツールは、両方の形式からテキストを取得することはできても、「メトホルミン1000 mg PO BID」を[薬剤: メトホルミン、用量: 1000 mg、経路: 経口、頻度: 1日2回]という構造化フィールドに解析するには、考えられるすべての薬剤名の略語に対する手書きのルールが必要になります。意味的AIアプローチは、文章を読み取り、各薬剤名とそれに関連する用量、経路、頻度の関係を、薬剤師が投薬リストを一目見て頭の中で整理するのと同じように理解します。
検査パネル:1つの値、多数のラベル
血清グルコースの結果は、Quest Diagnosticsのレポートでは「Glucose: 102 mg/dL」、Cernerのラボフローシートでは「GLU 102」、EpicのResults Review画面では「Glucose, Serum — 102 mg/dL (Ref: 70-99)」と表示されることがあります。これらはすべて、空腹時グルコース102という同じ臨床的観察結果を表しています。テンプレートベースのアプローチでは、各ラベルのバリエーションを個別に学習させる必要があります。意味的モデルは、「Glucose」「GLU」「Glucose, Serum」が同じ分析対象を指す3つのラベルであることを認識します。これは、テキスト文字列だけでなく臨床用語を理解しているからです。
この違いは、実際の現場では非常に重要です。外部のラボPDF、内部の電子カルテのスクリーンショット、FAXで送られてきた結果など、さまざまな形式のデータから200人の患者のラボ値を抽出する臨床研究コーディネーターは、200個の抽出テンプレートを作成することはできません。すべての形式に対応する1回の抽出処理が必要です。値がどこに位置しているかではなく、何を意味しているかによって値を識別する意味的抽出は、これを可能にするメカニズムです。
問題リスト:コードと記述を並べて表示
Epicの問題リストのエントリは、例えば「E11.9 — 2型糖尿病、合併症を伴わないもの」のように表示されます。ICD-10コード「E11.9」はそのテキスト説明の隣に表示されます。一部のレポートではコードのみ、一部では説明のみ、一部ではその両方を表示します。単純な抽出ツールでは、「E11.9」を一つのフィールドに取り込み、説明を落としたり、説明を取り込んでコードを失ったりする可能性があります。アブストラクター(抽象化担当者)は、レジストリ提出用のコードと臨床コンテキスト用の説明の両方を必要とします。診断コードとそれに関連するテキスト説明の関係を理解する意味的抽出アプローチは、このペアを確実に捕捉し、完全な臨床像を保持することができます。
FHIRとHL7がスクリーンショット問題を解決しない理由
ここで当然の疑問が浮かびます:なぜAPIを使わないのか?FHIR(Fast Healthcare Interoperability Resources)は、まさにこの目的のために設計されたHL7標準規格です。つまり、システム間の構造化された臨床データ交換です。EpicはSMART on FHIRをサポートしています。CernerはFHIR R4のIgnite APIを提供しています。MeditechのExpanseプラットフォームはFHIR R4エンドポイントを公開しています。では、なぜ人々は今もスクリーンショットからコピー&ペーストしているのでしょうか?
それは、FHIR APIがカバーするデータ要素とユーザーが限られているからです。EpicのFHIR APIは、患者の人口統計情報、予約、アレルギー、一部の臨床文書を提供しますが、品質指標、詳細な請求データ、診療所が紹介状、事前承認、レジストリ固有の変数を追跡するために追加するカスタムフィールドは公開していません。SkyvernによるEHR自動化の分析(2026年3月)が文書化しているように、最良のFHIR実装でも、プログラムでアクセス可能なものには大きなギャップが残っています。
さらに根本的には、APIアクセスには、ほとんどの臨床チームが管理していないITインフラストラクチャが必要です。ACCのCathPCI Registry用にデータを抽象化する品質改善看護師や、Get With The Guidelinesに提出する脳卒中コーディネーターは、FHIR統合を構築するための資格情報、APIキー、技術サポートを持っていません。彼らがアクセスできるのはEHRのフロントエンドです。ログインして患者のカルテを表示し、スクリーンショットを撮ることができます。それが彼らのデータ抽出パイプラインであり、臨床データアブストラクション作業の大部分にとって、それが利用可能な唯一のパイプラインです。
心血管レジストリ向けのAI駆動型アブストラクションツールを構築するHealth Elementsチームは、中規模の医療システムが全サービスラインにわたる臨床データアブストラクションに年間1500万ドル以上を費やしていると推定しています(Health Elementsの分析)。同じ分析では、AI駆動型アブストラクションにより、アブストラクション時間を最大90%削減し、総アブストラクションコストを50%以上削減できることが判明しました。これらの削減は、より優れたAPIからではなく、人間のアブストラクターと同じように画面上の情報を読み取ることができるツールからもたらされます。ただ、より速く、より一貫性があります。
意味的抽出とテンプレートベースOCR:重要な違い
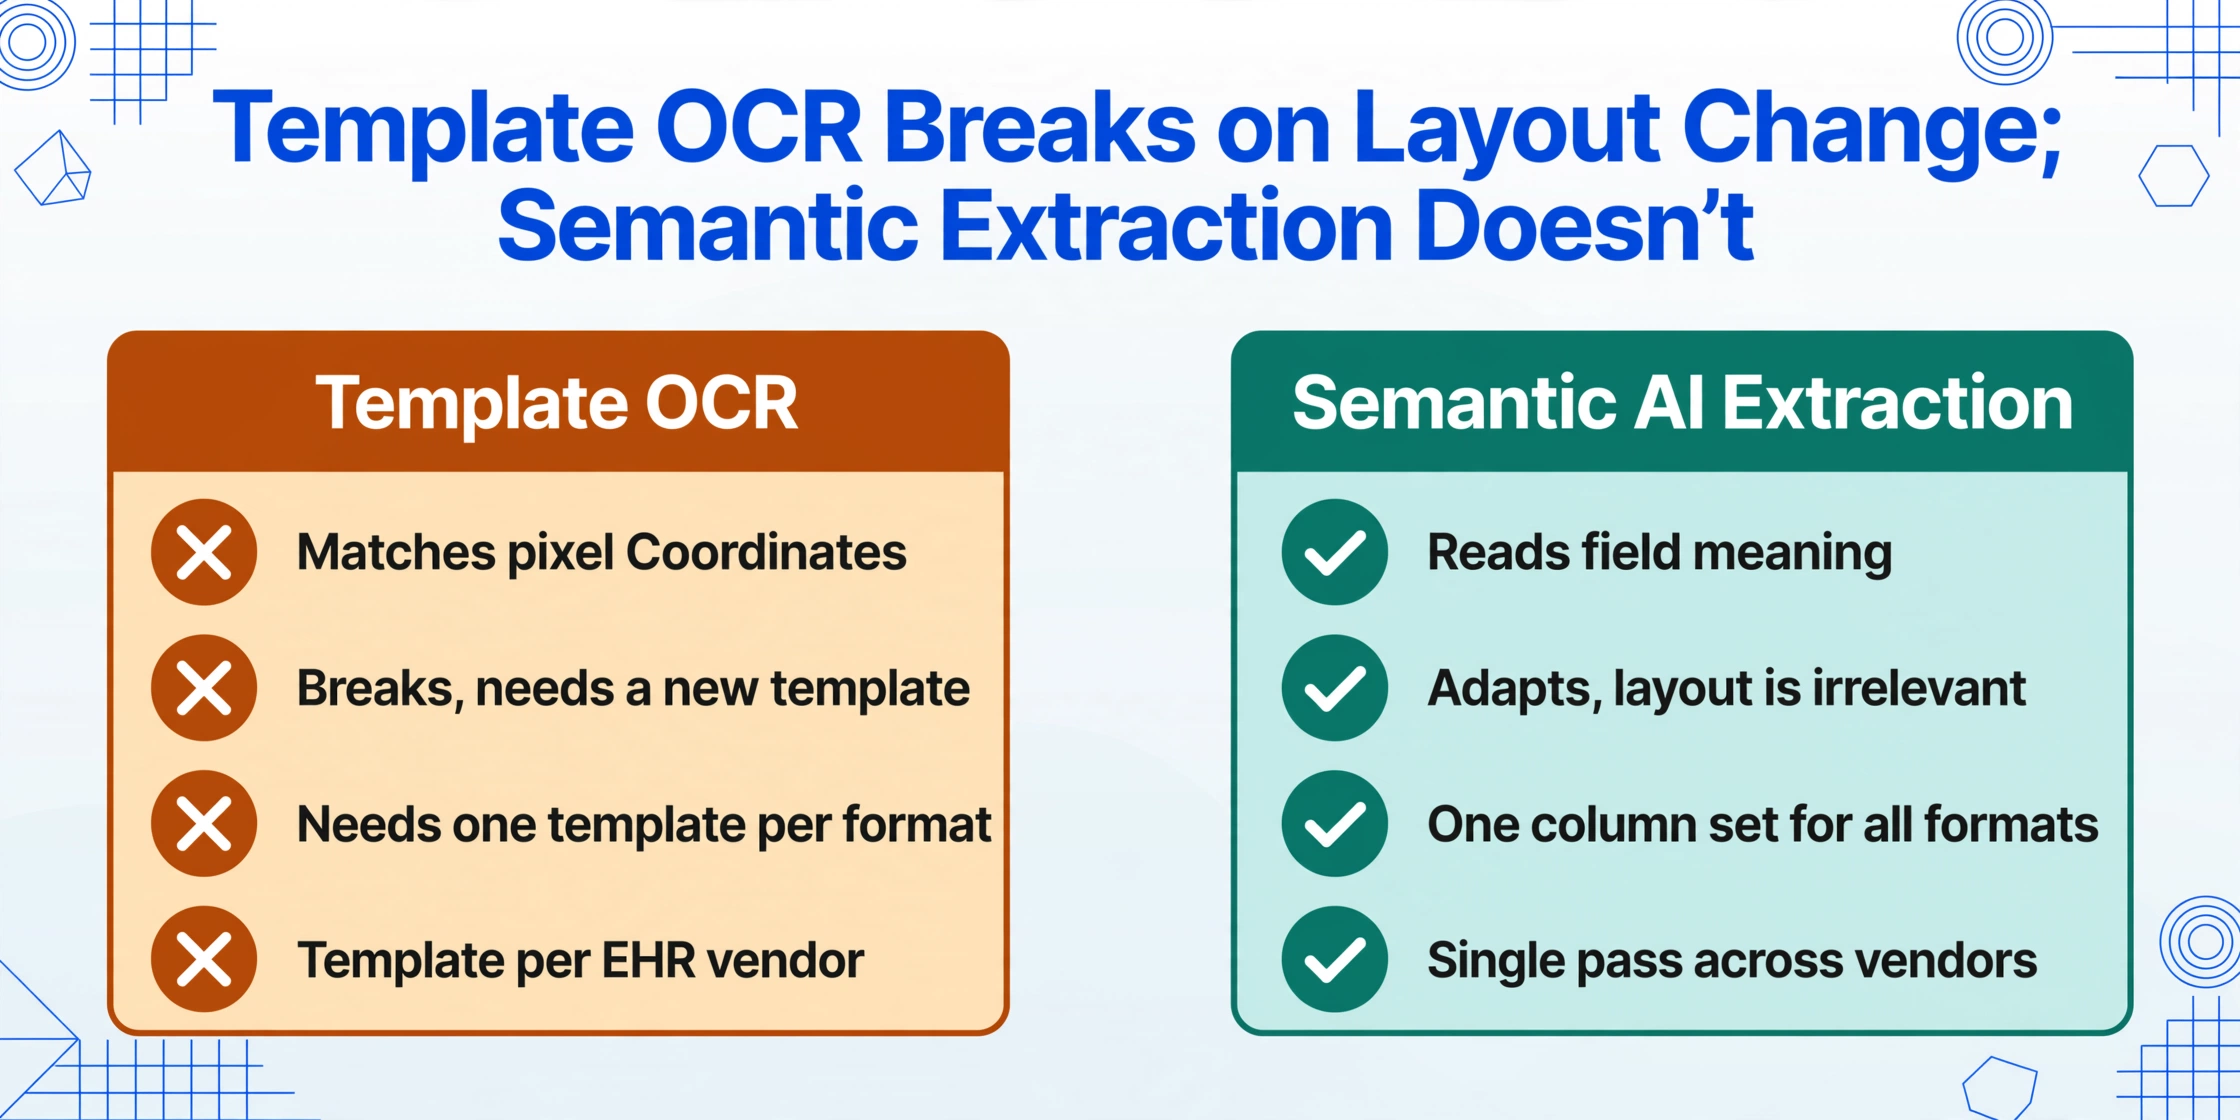
AI抽出の仕組みはすべて同じではありません。臨床データにとって重要な違いは、位置ベースの抽出(テンプレートOCR)と意味ベースの抽出(意味によって読み取るAI)の違いです。
| テンプレートベースOCR | Semantic AI Extraction | |
|---|---|---|
| データの見つけ方 | ピクセル座標やラベルパターンを照合 | 各フィールドの意味を理解 |
| レイアウトが変わった場合 | 機能しなくなる — 新しいテンプレートが必要 | 自動的に適応 — レイアウトは無関係 |
| レポート形式ごとの設定 | 形式ごとに1つのテンプレート | 全形式に対応する1セットの列名 |
| 「GLU」と表示された「Glucose」への対応 | 不可 — 別のルールが必要 | 可能 — 両方を同じ検体として認識 |
| Epic、Cerner、Meditechでの動作 | EHRベンダーごとに個別のテンプレート | 単一の抽出パスで全ベンダーに対応 |
この違いはパラダイムシフトです。テンプレートベースOCRは「このページのグルコース値はどこにあるか?」と問います。Semantic AI Extractionは「このページのどの値がグルコースを意味するか?」と問います。前者は幾何学の問題です。後者は読解の問題です。臨床データ — 同じ観察結果が、異なるEHR、検査ベンダー、レポートレイアウトにわたって十数種類の異なるラベルで表示される可能性がある場合 — 読解アプローチこそがスケールする方法です。
これが実際のCustom Column Extractionの意味です:バウンディングボックスを定義したり、特定のEHR画面レイアウトでテンプレートをトレーニングしたりする代わりに、必要な列ヘッダー(「Patient MRN」「BP Systolic」「BP Diastolic」「Heart Rate」「Hemoglobin A1c」「LDL Cholesterol」)を入力するだけで、AIがその臨床的意味を理解してドキュメント上のどこからでも各値を特定します。出力を定義するのはあなたです。入力を理解するのはAIです。
このアプローチはバッチ処理も可能にします:複数のスクリーンショット、PDF、スキャンしたレポートを一度にアップロードし、患者ごとに1行、すべての列が入力された単一の結合スプレッドシートを受け取ります。異なる時点で撮影された異なるEHRモジュールのスクリーンショットを含む200件の患者カルテからデータを抽出する臨床研究コーディネーターにとって、バッチ処理は数週間かかる手作業を数分で完了するタスクに変え、人間のレビュアーの役割はデータ入力からデータ検証へと移行します。
紙の登録フォームも本質的には同じです — 患者情報フォームからExcelへの変換 では、定義したヘッダーリストを使用してスキャンしたページからデータを入力するため、紙のカルテもスクリーンショットと同じテーブルに統合されます。
実践的なチュートリアル: EHRスクリーンショットから構造化スプレッドシートへ
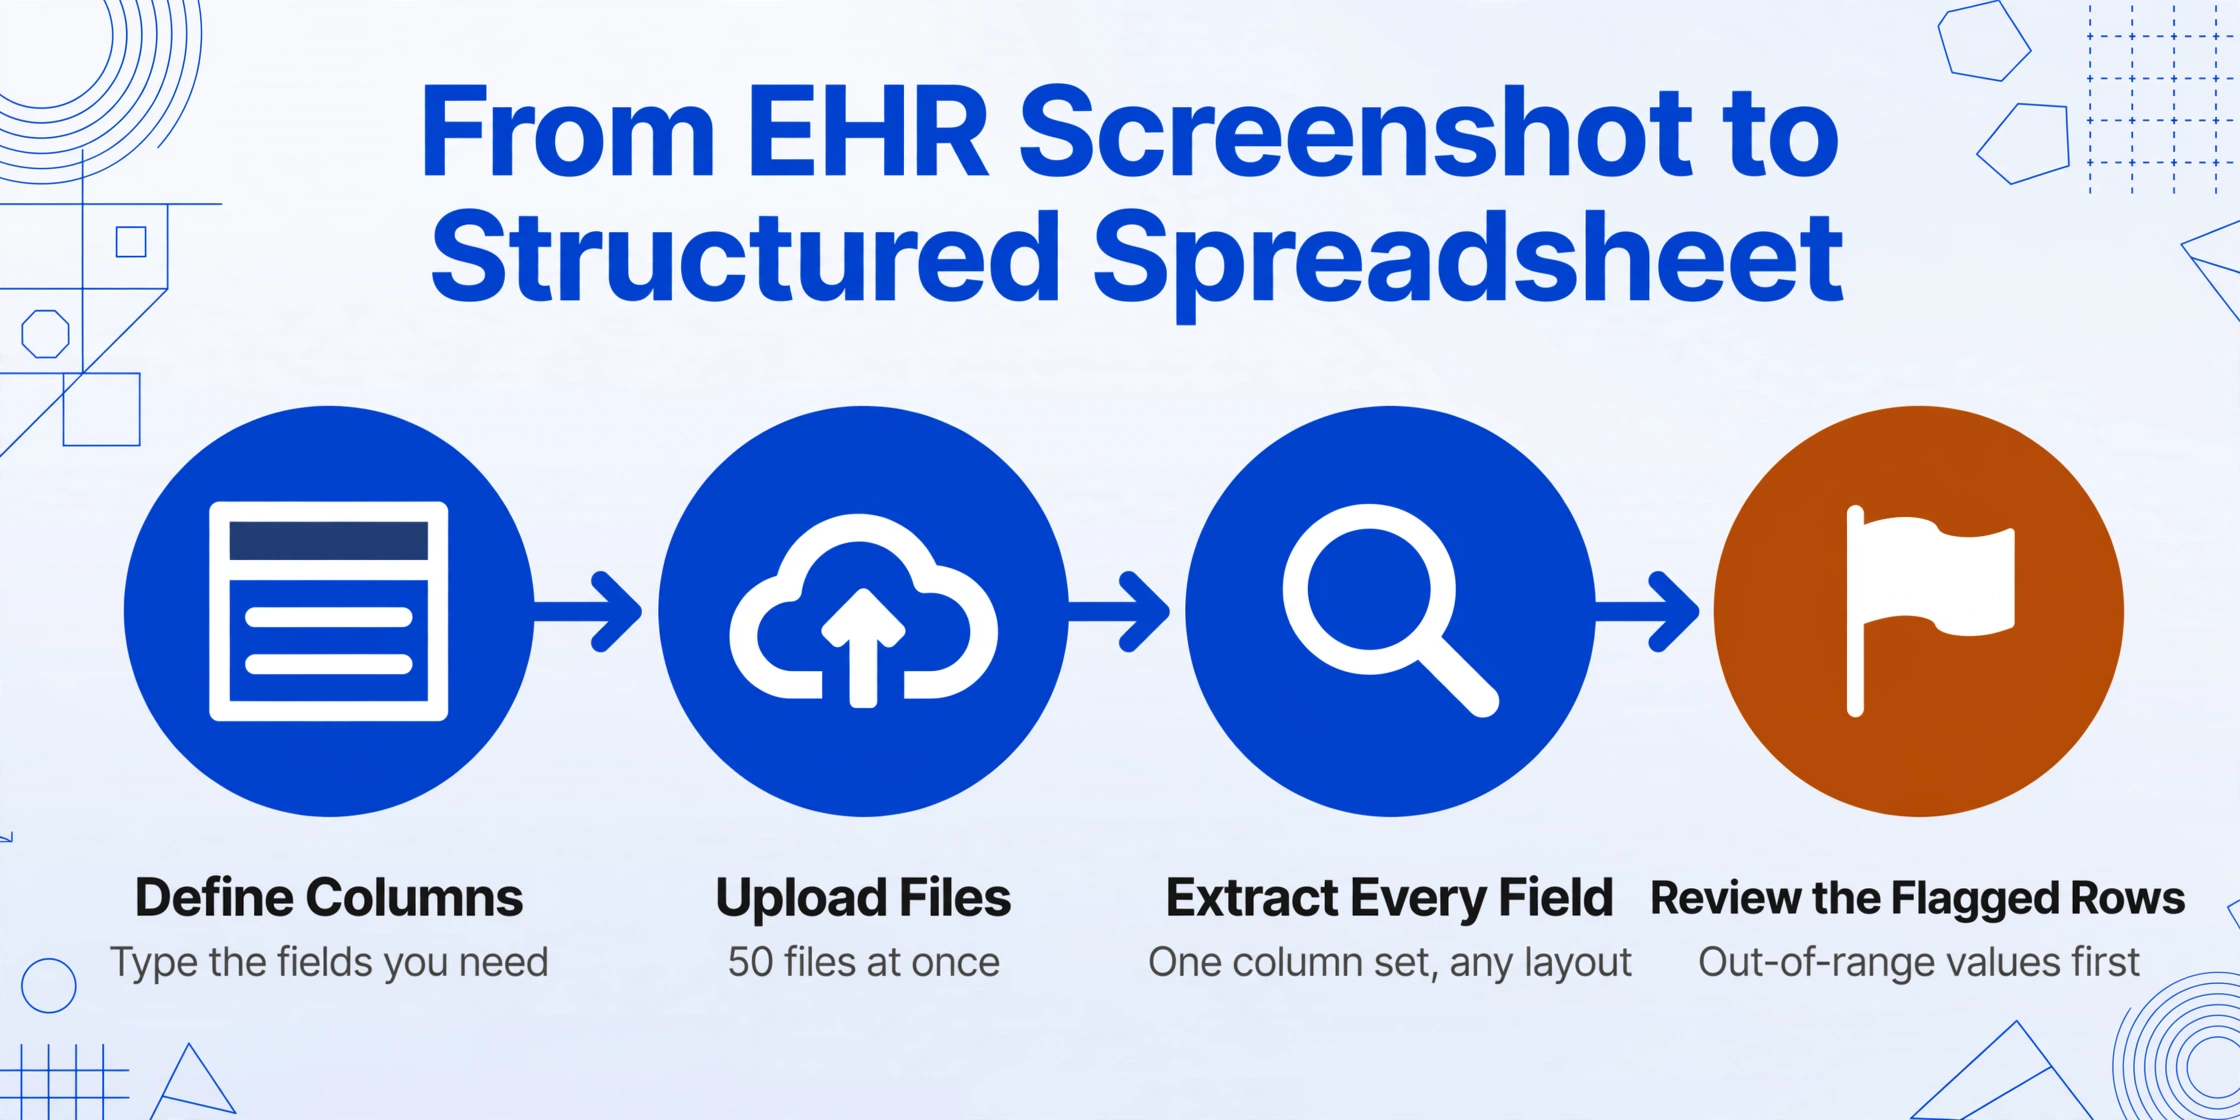
ここでは、実際の臨床データアブストラクションのシナリオを用いた抽出ワークフローの全体像をご紹介します: Epicのカルテスクリーンショットから循環器レジストリ提出用の主要変数を抽出します。
列を定義する
必要なデータフィールドを入力します: 「患者MRN」「入院日」「退院時診断」「LVEF(%)」「トロポニンピーク値」「退院時抗血小板薬」。また、推論列を含めることもできます — AIが文書の内容に基づいて判断を下すフィールドです。例えば、「LVEFカテゴリー(選択肢: 保持/軽度低下/低下)」と指定すると、AIが駆出率の値を読み取り、臨床的閾値と比較して適切なカテゴリーを出力します — 「LVEFカテゴリー」がカルテに明示的に印刷されていなくてもです。
ファイルをアップロードする
スクリーンショット、エクスポートしたPDF、スキャンした検査報告書をドラッグ&ドロップ — 形式やEHRベンダーは問いません。一度に50ファイルまでアップロードできます。JPG、PNG、PDF、WebPに対応しているため、EpicのスクリーンショットPNG、CernerからエクスポートしたPDF、FAXで送られた検査結果のスキャンがすべて同じバッチにまとめられます。
AIが全ファイルを抽出する
AIがすべてのファイルを並行処理します。各ドキュメントを読み取り、列定義に一致する値を特定し、出力テーブルに入力します。抽出は位置ベースではなく意味的であるため、ある病院のEpic画面に「cTnI: 0.04 ng/mL」と表示されたトロポニン値と、別の病院のCernerレポートに「High-Sensitivity Troponin I — 12 ng/L」と表示された値は、どちらも同じ「トロポニンピーク値」列にマッピングされます。AIは、アッセイタイプ、単位、ラベル形式が異なっていても、両方をトロポニン結果として認識します。
レビューとエクスポート
出力は、患者ごとに1行、指定した列がヘッダーとなるスプレッドシートです。完全性を確認します — 外れ値をスポットチェックし、複数ページのレポートがすべて処理されたことを確認します — その後、Excel、CSV、またはJSONにエクスポートします。Google Sheetsを使用している場合、アドオンはダウンロードや再アップロードをせずに、結果をアクティブなシートに直接書き込みます。
ファイルは安全に処理され、保存されることはありません。
抽出だけでは不十分な場合:品質チェックとエッジケース
臨床データ抽出は、請求書処理よりも重要度が高くなります。請求書で小数点の位置がずれると、請求修正が必要になります。検査値で小数点の位置がずれると、レジストリのデータ品質フラグが立つか、さらに悪い場合は患者の転帰が誤って分類される可能性があります。ここでは、重要となるエッジケースとその対処方法を説明します。
範囲外の値と単位の不一致
クレアチニン値「15.2 mg/dL」は臨床的に警告すべき値です。クレアチニン「1.2 mg/dL」は通常値です。抽出中に小数点の位置がずれると、その誤差は下流のすべての分析に波及します。これを防ぐのは抽出ステップではなく、レビューステップです。AI抽出後、患者集団の生理学的に妥当な範囲外の値が出力列にないかスキャンしてください。最新の抽出ツールは、設定可能な基準範囲と抽出値を比較して、外れ値を自動的にフラグ付けできます。これは人間によるレビューを置き換えるものではありませんが、レビュアーの注意を誤りが含まれる可能性が最も高い行に向けさせ、すべての行を均等にレビューするよりもはるかに効率的なワークフローを実現します。
重複投薬と調停アーティファクト
EHR画面の患者投薬リストには、「メトホルミン500mg 1日2回」の有効処方と、「メトホルミン1000mg 1日1回」の中止済みオーダーの両方が同じ投薬履歴ビューに表示されることがあります。すべての投薬エントリを抽出する単純な抽出では両方が取得され、誤った重複が発生します。解決策は、投薬のステータス(有効/中止/完了)を別の列として抽出するように設定し、レビュー時に抽象化担当者がフィルタリングできるようにすることです。ここで推論列が有用になります。「有効な投薬のみ(はい/いいえ)」として定義された列は、AIに各投薬エントリのステータスコンテキストを評価させ、現在有効なもののみを出力するよう指示します。
複数ページのレポートと継続ページ
CBC結果が2ページ目から始まり3ページ目に続く4ページの検査レポートでは、連続性の問題が生じます。抽出ツールは3ページ目が新しいレポートではなく継続であると理解できるでしょうか?文書を全体的に処理するセマンティック抽出モデル(すべてのページを1つの連続した臨床文書として読み取る)は、これを自然に処理します。モデルは、3ページ目の「WBC: 7.2」が2ページ目から始まった同じCBCパネルに属し、別のレポートではないと認識します。複数ページのPDFをアップロードする際は、すべてのページを分割せずに1つのファイルに含めて、AIがこの連続性コンテキストを維持できるようにしてください。
手書き注釈と欄外書き込み
臨床医は注釈を付けます。印刷された検査レポートの余白に「2週間後に再検査」と手書き。投薬リストに丸で囲まれた用量とその横に「中止 — 胃腸障害のため」と走り書き。これらの注釈には臨床的に重要な情報が含まれていますが、標準的なOCRエンジンでは見逃されたり誤読されたりします。文書を抽出テキストとしてだけでなく画像として処理するビジョンベースのAIモデルは、印刷テキストと並んで手書き文字を読み取り、構造化データと非構造化臨床コンテキストの両方を1回のパスで取得できます。手書きのメモが投薬ステータスを変更する場合、「投薬ステータス(有効/中止/変更)」のような推論列が、その注釈をレビュー担当者向けの構造化フラグとして表示できます。
HIPAA、セキュリティ、そして「コンプライアンス」の本当の意味
臨床データを扱うツールは、必ずHIPAAに対応する必要があります。しかし、HIPAAコンプライアンスは認定バッジではなく、HIPAAセキュリティルールが定める管理策、物理的対策、技術的対策の3つの要件を満たした運用状態を指します(45 CFR Part 160およびPart 164のSubpart AとC)。政府機関が「HIPAA認定」のシールを発行することはありません。重要なのは、ツールのデータ取り扱い方法がセキュリティルールの3つのカテゴリーを満たしているかどうかです。
臨床データ抽出において、関連する技術的対策は次の通りです。転送中の暗号化(HTTPS経由で送信される全データ)、保存データの暗号化、患者データの閲覧や処理を制限するアクセス制御、そしてデータ保持と削除に関する明確なポリシーです。ファイルを一時的に処理するツール(処理後に元の文書を保存せずにデータを抽出する)は、永続的なPHIリポジトリが存在しないため、リスクの大きなカテゴリーを排除します。
事業連携契約(BAA)を必要とする組織(これはHIPAAの対象事業体のほとんどに該当します)にとって、抽出ツールベンダーに問い合わせるべき重要な質問は、BAAに署名するかどうかです。BAAは、HIPAAの義務をベンダーに事業連携者として拡張する契約です。署名されたBAAがなければ、対象事業体はそのベンダーと処理のためにPHIを合法的に共有できません。これは技術的な機能ではなく、契約上の要件です。患者データをアップロードする前に確認してください。
実際には、AIを活用した臨床データ抽出のセキュリティモデルは次のようになります。ユーザーがシステムに入力するデータを制御し、システムはソースファイルを保持せずに処理し、ユーザーが出力先を制御します。PHIの永続的な保存は行いません。ユーザーデータでのトレーニングは行いません。第三者との共有は行いません。これらはマーケティング上の主張ではなく、HIPAA準拠のワークフローを一般的なファイルアップロードツールと区別する運用上の実践です。
意味抽出が得意なケースと、人間の判断が必要なケース
セマンティックAIによる抽出は、臨床データ抽象化の大半のシナリオで良好に機能しますが、人間の判断が不可欠な特定の状況もあります。存在しない摩擦のない体験を約束するよりも、これらの限界を正直に伝える方が優れています。
得意なケース: 単一画面またはレポート上の構造化または半構造化された臨床データ — バイタル表、投薬リスト、検査パネル、問題リスト、予防接種記録、退院時服薬調整。これらのデータタイプは、視覚的な表示が異なっていても予測可能な臨床セマンティクスを持ちます。AIは、基礎となる臨床概念(血圧、ヘモグロビンA1c、投薬量)が普遍的であるため、異なるEHRベンダーやレポート形式間でも高精度でデータを取得できます。
人間が確認すべきケース: データが埋め込まれたナラティブな臨床記録 — 正式な検査結果エントリなしに検査値を簡単に言及する経過記録(「今朝のKは3.1だったので補充した」)。AIは「3.1」をカリウム値として抽出するかもしれませんが、これがポイントオブケア検査であり正式な検査採取ではなく、その値がレジストリの「血清カリウム」フィールドに属さない可能性があるという臨床的コンテキストを捉えられないことがあります。同様に、アーティファクトが多いスキャン文書 — 複数回ファックスされた記録でゴーストテキストや位置ずれが生じているもの — は、結果が劣化する可能性があります。これらの場合、AI抽出は最終回答ではなく、人間のレビュー担当者が確認する初回ドラフトとして扱うべきです。
医療文書向けLLMベースの情報抽出ツールに関する2024年のベンチマーク研究(medRxivに掲載)では、現代のAIモデルは臨床IEタスクにおいて「ルールベースの手法に比べて大幅な進歩を提供する」ことが判明しましたが、パフォーマンスは文書タイプと抽出の複雑さによって異なることが指摘されています。実務者への教訓:AI抽出を生産性向上の手段として活用し、単純なデータポイントの80%を処理することで、人間の抽象化担当者は検証作業を臨床的判断を必要とする20%に集中させることができます。
他の手法との比較
臨床データ抽出の選択肢は、完全手動から完全自動まで多岐にわたります。以下は、実際の運用における比較であり、マーケティング上の表現ではありません。
| 手法 | 必要な準備 | フォーマットのばらつきへの対応 | ITアクセス不要で利用可能 | 最適な用途 |
|---|---|---|---|---|
| 手動抽出 | 不要 | 対応可(人間が適応) | 可 | 非常に低ボリューム、高い臨床的複雑性 |
| FHIR/HL7 API | IT連携+認証情報 | 該当なし(構造化データ) | 不可 | 単一EHR環境内での高ボリューム構造化データ |
| テンプレートOCR | フォーマットごとに1テンプレート | 不可 — レイアウト変更で破綻 | 可 | 高ボリューム、単一フォーマットの文書 |
| NLPパイプライン | 技術構築+学習データ | 部分的に対応 | 不可 | エンタープライズ規模、単一機関での導入 |
| セマンティックAI抽出 | 列名を入力 | 対応可 — レイアウト非依存 | 可 | マルチフォーマット・マルチソースの臨床データ抽出 |
適切な選択は、ボリューム、フォーマットの多様性、組織の技術リソースへのアクセス状況によって異なります。Epicのスクリーンショット、外部ラボのPDF、FAX送信された記録が混在する200件のカルテを抽出する臨床研究コーディネーターにとって、データベースの認証情報もAPIアクセスもNLPエンジニアリングチームもない状況では、セマンティックAI抽出が、テンプレート作成もIT連携も必要としない唯一の選択肢です。これが唯一の有効な手法というわけではありませんが、ほとんどの臨床データ抽出業務が直面する現実的な制約に適合する唯一の手法です。
よくある質問
AI抽出はどのEHRシステムのスクリーンショットでも機能しますか?
はい。特定の画面レイアウトに一致させるのではなく、データの「意味」を理解して抽出するためです。Epicのフローシート上の血圧測定値、Cernerのバイタル表、Meditechの患者サマリーはすべて、フォント、位置、ラベル形式に関係なく血圧として認識されます。AIはスクリーンショットを画像として処理し、人間の臨床医と同じように、内容を意味的に解釈して読み取ります。ただし、複数の表が縦に積み重なったもの、ポップアップオーバーレイ、小さなフォントの分割ペインビューなど、データが密集して非常に雑然とした画面では精度が低下する可能性があり、スポットチェックが必要です。
手書きの臨床記録からデータを抽出できますか?
はい、ただし条件付きです。ビジョンベースのAIモデルは、同じ文書内の印刷テキストと一緒に手書きテキストを読み取ることができます。明確で構造化された手書き(投薬注釈、紙のフローシートへのバイタルサインの記入)は確実に抽出できます。筆記体が多く、走り書きで、標準的でない略語が多い臨床手書きでは、精度が低下します。手書きコンテンツについては、AI抽出を最終的な信頼できる記録としてではなく、人間による検証が必要な初稿として扱ってください。
PHIとHIPAA要件にはどのように対応していますか?
HIPAA準拠は運用状態であり、認定ではありません。抽出ツールに関連する要素は次のとおりです。(1) データが転送中(HTTPS)および保存中に暗号化されているか、(2) ファイルが一時的に処理され、抽出後、PHIを永続的に保存せずに破棄されるか、(3) 組織が必要とする場合、ベンダーがビジネスアソシエイト契約(BAA)を締結するか、(4) 処理されたデータへのアクセスが許可されたユーザーのみに制限されているか。患者データをアップロードする前に、評価中の特定のツールでこれらの詳細を確認してください。抽出ツールはHIPAA「認定」を主張すべきではありません。そのような認定は存在しないからです。重要なのは運用上の保護策です。
マルチページPDFの検査レポートの精度は?
クリーンなスキャンの印刷テキストの場合、明確に定義されたフィールドでは99%の精度に達する可能性があります。マルチページレポートは、単一のPDFとしてアップロードすると、AIがページ間の連続性を維持できるため最適に機能します。つまり、3ページ目のWBC結果が2ページ目から始まった同じCBCパネルに属することを認識します。精度は、アーティファクトの多いスキャン(多世代ファックスによるゴースト)、極端な傾き、または非常に小さなフォントサイズで低下します。重要なレジストリ提出の場合は、一括処理の前に、抽出された結果のサンプルをソースドキュメントと照合してスポットチェックを行ってください。
一度に何百もの患者チャートを処理できますか?
はい。バッチ処理はまさにこのシナリオのために設計されています。すべてのファイルを一度にアップロードし、列ヘッダーを一度定義すると、患者ごとに1行の単一のマージされたスプレッドシートを受け取ります。処理時間はファイル数に比例するのではなく、複数のファイルが並行して処理されます。100件のスクリーンショットのバッチは通常1分未満で完了します。より大量のボリューム(500ファイル以上)の場合は、タイムアウト制限を回避し、段階的なレビューを容易にするために、複数のバッチに分割してください。
画面に明示的に書かれていないデータを抽出する必要がある場合は?
そのための機能が推論列です。推論列は、AIに画面上の値を単に書き写すのではなく、文書の内容に基づいて判断させるものです。例えば、「LVEF区分(選択肢:≧50% 維持 / 40-49% 軽度低下 / <40% 低下)」は、文書から駆出率のパーセンテージを読み取り、臨床的な閾値と比較して適切な区分を出力します。たとえ「LVEF区分」がカルテに明記されていなくてもです。同様に、「服薬調整状況(完了/未完了)」は、退院時の処方と入院時の処方が一致するかを評価し、不一致をフラグ付けできます。推論列により、抽出が単なる書き写しから、構造化された臨床データの生成へと変わります。
これは臨床データ抽出担当者の代替になりますか?
いいえ — これは、抽出担当者の時間の使い方を変えるツールです。時間の50%を手動データ入力に費やしていた(Carta Healthcare 2024年の調査結果)代わりに、担当者は検証、臨床的判断、異常値の調査に注力できるようになります。AIが単純な書き写しを担当し、人間が臨床的推論を担当します。これは担当者の代替ではなく、どの臨床医も学校で学んでいない業務 — ある画面から値を読み取り、別の画面に入力する — を排除することです。
臨床データ抽出に、人間のように画面を読み取るツールが登場しました。データの「場所」ではなく「意味」を理解するのです。セマンティックAI抽出は、抽出者の臨床的判断を代替するものではありません。コピー&ペーストを代替するのです。
現在、レジストリ、研究、品質改善プロジェクト、監査のためにEHRのスクリーンショットから臨床データを抽出しているなら、まずは自分のファイルを少量使ってこのアプローチをテストしてみてください。患者10名分のカルテを選び、抽出する列を定義し、実行します。その出力を手動での抽出結果と比較してください。AIがデータ項目の90%以上を正しく取得できていれば、現在転記に費やしている時間の大半を削減できたことになります。残りの10%こそ、あなたの臨床的専門知識が活きる領域です。