Cómo extraer datos clínicos de
capturas de pantalla de EHR: abstracción semántica sin plantillas
Un abstraccionista de datos clínicos en un sistema de salud de tamaño mediano abre Epic, navega al expediente de un paciente y comienza a revisar. Signos vitales. Medicamentos. Paneles de laboratorio. Lista de problemas. Cada dato está en la pantalla frente a ellos — completamente digital, completamente legible — pero para llevarlo a la herramienta de envío de registros, a la base de datos del registro de accidentes cerebrovasculares o a la hoja de cálculo de medidas de calidad, tienen que leerlo y volver a escribirlo. Campo por campo. Paciente por paciente. No están solos. Una encuesta de 2024 de Carta Healthcare a abstraccionistas de datos clínicos encontró que más de la mitad de los encuestados dedican la mayor parte de sus horas laborales a la entrada y extracción manual de datos, y el 70% informó encontrar errores o discrepancias resultantes de la abstracción manual — el 20% dijo que ocurre «muy a menudo». La ironía es evidente: los datos ya son digitales, almacenados en una base de datos relacional dentro de un EHR, pero en el momento en que aparecen como una captura de pantalla, un informe impreso o un PDF exportado, vuelven a ser no estructurados. Se convierten en algo que una persona tiene que transcribir.
La paradoja de la captura de pantalla: por qué los registros digitales no garantizan datos extraíbles
Se suponía que los historiales clínicos electrónicos resolverían el problema de la portabilidad de datos. En cambio, crearon uno nuevo: la captura de pantalla como unidad de facto para el intercambio de datos clínicos.
Esto no es una exageración. En r/healthIT de Reddit, un facturador de hospital describió la realidad diaria en los flujos de trabajo de datos clínicos: "Intercambiar datos entre sistemas es extremadamente engorroso y, por lo general, implica copiar y pegar cada campo que necesitas en el otro sistema." Un hilo de investigación clínica en r/clinicalresearch preguntaba por qué la entrada de datos de HCE a EDC sigue siendo manual y tediosa. La respuesta principal: "Problemas de privacidad y seguridad de cada hospital. Cada sitio es diferente y casi todos tienen problemas de confianza extremos con la PHI."
La causa raíz es estructural. Los sistemas HCE — Epic, Cerner (ahora Oracle Health), Meditech — almacenan datos en bases de datos relacionales propietarias diseñadas para el procesamiento de transacciones, no para la extracción. Epic utiliza una base de datos de informes llamada Clarity que refleja los datos clínicos de su sistema transaccional Chronicles. Cerner se basa en Millennium, que organiza los registros en cientos de tablas con esquemas específicos del proveedor. El acceso directo a la base de datos requiere conocimientos de SQL que la mayoría de los equipos clínicos no tienen, y que la mayoría de los sistemas de salud no conceden.
Esto crea la paradoja de la captura de pantalla: los datos son digitales dentro de la HCE, pero la única forma de moverlos a otro sistema —un registro clínico, una base de datos de investigación, una hoja de cálculo de informes de calidad— es a través de una pantalla. Alguien inicia sesión, navega al paciente correcto, la consulta correcta, la pestaña correcta y lee los valores que necesita. Luego los escribe en otro lugar. Esto es la abstracción de datos clínicos en la práctica: el proceso sistemático de extraer, revisar y validar información clave de los historiales médicos de los pacientes. Y a pesar de la palabra "sistemático", es abrumadoramente manual. Un estudio publicado en el Journal of AHIMA encontró que el 58% de las organizaciones de salud utilizan la abstracción manual como su método principal, mientras que solo el 18% usa procesamiento de lenguaje natural y el 12% usa consultas simples a bases de datos (Estudio PMC, 2021).
Qué Hace Que los Datos Clínicos Sean Más Difíciles de Extraer que un Formulario Estándar
Una factura estándar tiene alrededor de una docena de campos — fecha, monto, nombre del proveedor, partidas — y su significado es inequívoco entre formatos. Un registro clínico es diferente. El mismo tipo de dato aparece en representaciones muy distintas según el módulo de la HCE, el diseño del informe e incluso el hospital dentro del mismo sistema de salud que lo generó. Estas son las cuatro categorías de datos que rompen los enfoques de extracción tradicionales y por qué.
Signos Vitales: Más que Solo Números
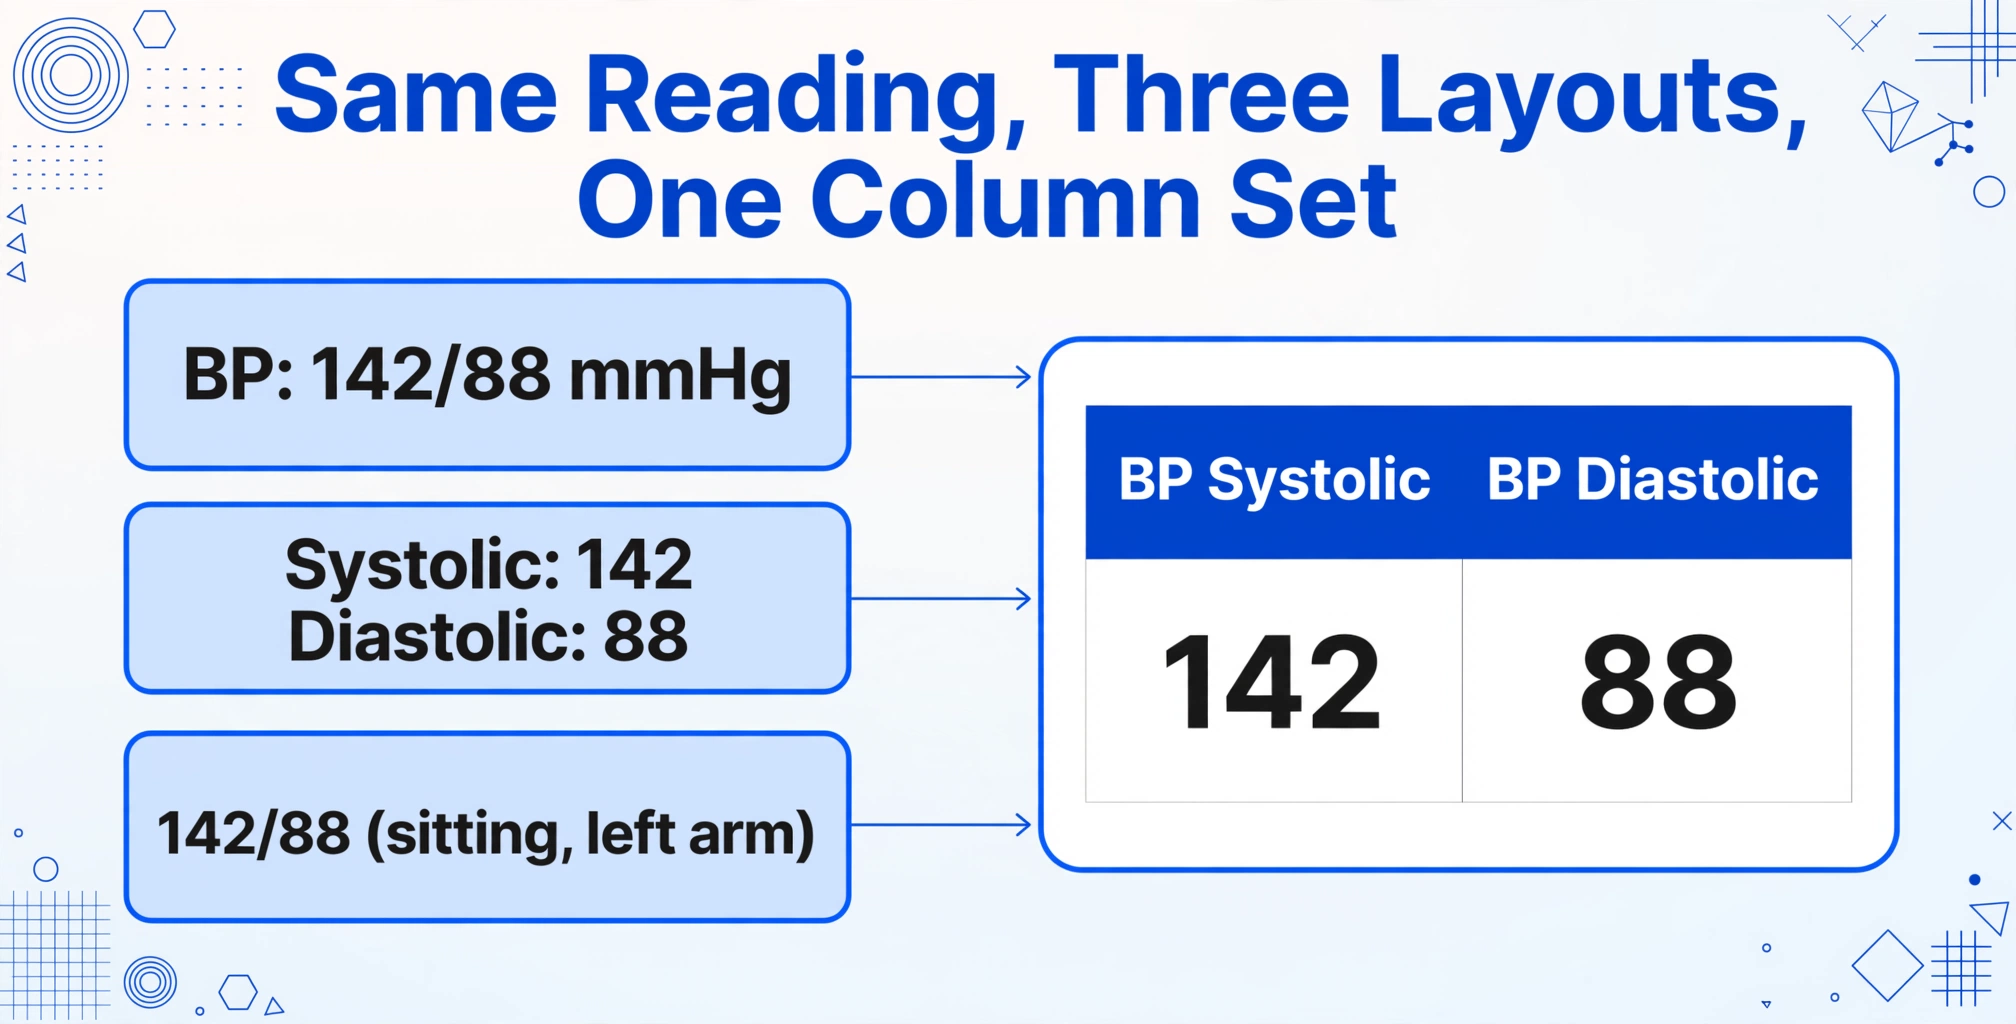
Una lectura de presión arterial de "142/88" podría aparecer en una pantalla como BP: 142/88 mmHg, en otra como una tabla de dos filas con "Systolic: 142" y "Diastolic: 88," y en una tercera como "142/88 (sentado, brazo izquierdo)" con contexto posicional añadido. Una herramienta de extracción basada en plantillas — que busca valores en coordenadas de píxeles fijas o que compara patrones con un formato de etiqueta conocido — falla ante la primera variación. Necesita una plantilla separada para cada diseño. Un modelo de extracción semántica, por el contrario, reconoce que "142/88," "Systolic 142 / Diastolic 88," y "BP 142/88" describen el mismo concepto clínico independientemente de cómo estén formateados, porque lee por significado en lugar de por posición.
Los signos vitales también conllevan rangos de referencia que cambian según la edad del paciente, el sexo y el contexto clínico. Una frecuencia cardíaca de 110 lpm es normal para un neonato y preocupante para un adulto en reposo. La herramienta de extracción no necesita hacer ese juicio clínico — el abstraccionista lo hace — pero sí necesita preservar el valor con precisión junto con su unidad y la marca de tiempo en que se registró, para que el abstraccionista tenga información completa para la revisión posterior.
La misma lectura aparece fuera de la HCE: un auxiliar de salud en el hogar que documenta una visita fotografía la pantalla del monitor de presión arterial, el glucómetro o el pulsioxímetro y luego escribe cada número en el registro de cuidados. Esa foto de signos vitales del auxiliar de salud en el hogar es el mismo problema de extracción — una fila por visita, con sistólica, diastólica, pulso y SpO2 como columnas.
Listas de Medicamentos: Análisis de Múltiples Campos en Texto Libre
Los datos de medicamentos en una pantalla de historia clínica electrónica (HCE) rara vez son una tabla limpia. Pueden aparecer como un registro de administración de medicamentos (MAR) continuo con columnas para nombre del fármaco, dosis, vía, frecuencia y hora de última administración — o pueden aparecer como una nota narrativa de reconciliación de medicamentos: "Metformin 1000 mg PO BID, Lisinopril 20 mg PO daily, Atorvastatin 40 mg PO QHS." El primer formato es una tabla. El segundo es una oración. Una herramienta de OCR basado en plantillas podría capturar el texto de ambos, pero no analizará "Metformin 1000 mg PO BID" en los campos estructurados [Fármaco: Metformin, Dosis: 1000 mg, Vía: Oral, Frecuencia: Dos veces al día] sin reglas escritas a mano para cada posible abreviatura de nombre de fármaco. Un enfoque de Semantic AI Extraction lee la oración y comprende la relación entre cada nombre de fármaco y su dosis, vía y frecuencia asociadas — de la misma manera en que un farmacéutico revisaría una lista de medicamentos y la organizaría mentalmente.
Paneles de Laboratorio: Un Valor, Muchas Etiquetas
Un resultado de glucosa sérica puede aparecer como "Glucose: 102 mg/dL" en un informe de Quest Diagnostics, "GLU 102" en una hoja de flujo de laboratorio de Cerner, y "Glucose, Serum — 102 mg/dL (Ref: 70-99)" en una pantalla de revisión de resultados de Epic. Los tres representan la misma observación clínica: una glucosa en ayunas de 102. Un enfoque basado en plantillas necesita ser entrenado en cada variante de etiqueta individualmente. Un modelo semántico reconoce que "Glucose," "GLU," y "Glucose, Serum" son tres etiquetas que apuntan al mismo analito — porque comprende la terminología clínica, no solo cadenas de texto.
Esta distinción importa enormemente en la práctica. Un coordinador de investigación clínica que extrae valores de laboratorio para 200 pacientes de una mezcla de PDFs de laboratorios externos, capturas de pantalla de HCE internas y resultados por fax no puede construir 200 plantillas de extracción. Necesita una sola pasada de extracción que funcione en todos los formatos. La extracción semántica — que identifica valores por lo que significan en lugar de dónde se ubican — es el mecanismo que hace esto posible.
Listas de Problemas: Códigos y Narrativas Lado a Lado
Una entrada de lista de problemas en Epic podría decir: "E11.9 — Diabetes mellitus tipo 2 sin complicaciones." El código ICD-10 "E11.9" se encuentra junto a su descripción de texto. Algunos informes muestran solo el código; algunos muestran solo la descripción; algunos muestran ambos. Una herramienta de extracción ingenua podría extraer "E11.9" en un campo y omitir la descripción, o extraer la descripción y perder el código. El abstraccionista necesita ambos: el código para el envío al registro y la descripción para el contexto clínico. Un enfoque de extracción semántica que comprenda la relación entre un código de diagnóstico y su descripción de texto asociada puede capturar de manera confiable el par, preservando la imagen clínica completa.
Por Qué FHIR y HL7 No Resuelven el Problema de las Capturas de Pantalla
La pregunta obvia en este punto es: ¿por qué no usar una API? FHIR (Recursos Rápidos de Interoperabilidad en Salud) es el estándar HL7 diseñado precisamente para esto: intercambio estructurado de datos clínicos entre sistemas. Epic admite SMART on FHIR. Cerner ofrece APIs Ignite en FHIR R4. La plataforma Expanse de Meditech expone endpoints FHIR R4. Entonces, ¿por qué la gente todavía copia y pega desde capturas de pantalla?
Porque las APIs FHIR cubren un conjunto limitado de elementos de datos y un conjunto limitado de usuarios. Las APIs FHIR de Epic sirven para datos demográficos de pacientes, citas, alergias y algunos documentos clínicos, pero no exponen métricas de calidad, datos de facturación detallados ni los campos personalizados que las prácticas agregan para rastrear referencias, autorizaciones previas y variables específicas del registro. Como documentó el análisis de Skyvern sobre automatización de EHR (marzo de 2026), incluso las mejores implementaciones de FHIR dejan brechas significativas en lo que es accesible programáticamente.
Más fundamentalmente, el acceso a la API requiere una infraestructura de TI que la mayoría de los equipos clínicos no controlan. Una enfermera de mejora de calidad que abstrae datos para el CathPCI Registry del ACC o un coordinador de accidentes cerebrovasculares que envía a Get With The Guidelines no tiene las credenciales, las claves API ni el soporte técnico para construir integraciones FHIR. Tienen acceso al front-end del EHR. Pueden iniciar sesión, ver los gráficos de los pacientes y tomar capturas de pantalla. Ese es su pipeline de extracción de datos, y para una gran fracción del trabajo de abstracción de datos clínicos, es el único pipeline disponible.
El equipo de Health Elements, que construye herramientas de abstracción impulsadas por IA para registros cardiovasculares, estima que un sistema de salud mediano gasta $15 millones o más anualmente en abstracción de datos clínicos en todas las líneas de servicio (análisis de Health Elements). El mismo análisis encontró que la abstracción impulsada por IA puede reducir el tiempo de abstracción hasta en un 90% y reducir los costos totales de abstracción en un 50% o más. Esos ahorros no provienen de mejores APIs, sino de herramientas que pueden leer lo que está en la pantalla de la misma manera que lo hace un abstraccionista humano, solo que más rápido y de manera más consistente.
Extracción semántica vs. OCR basado en plantillas: la diferencia que importa
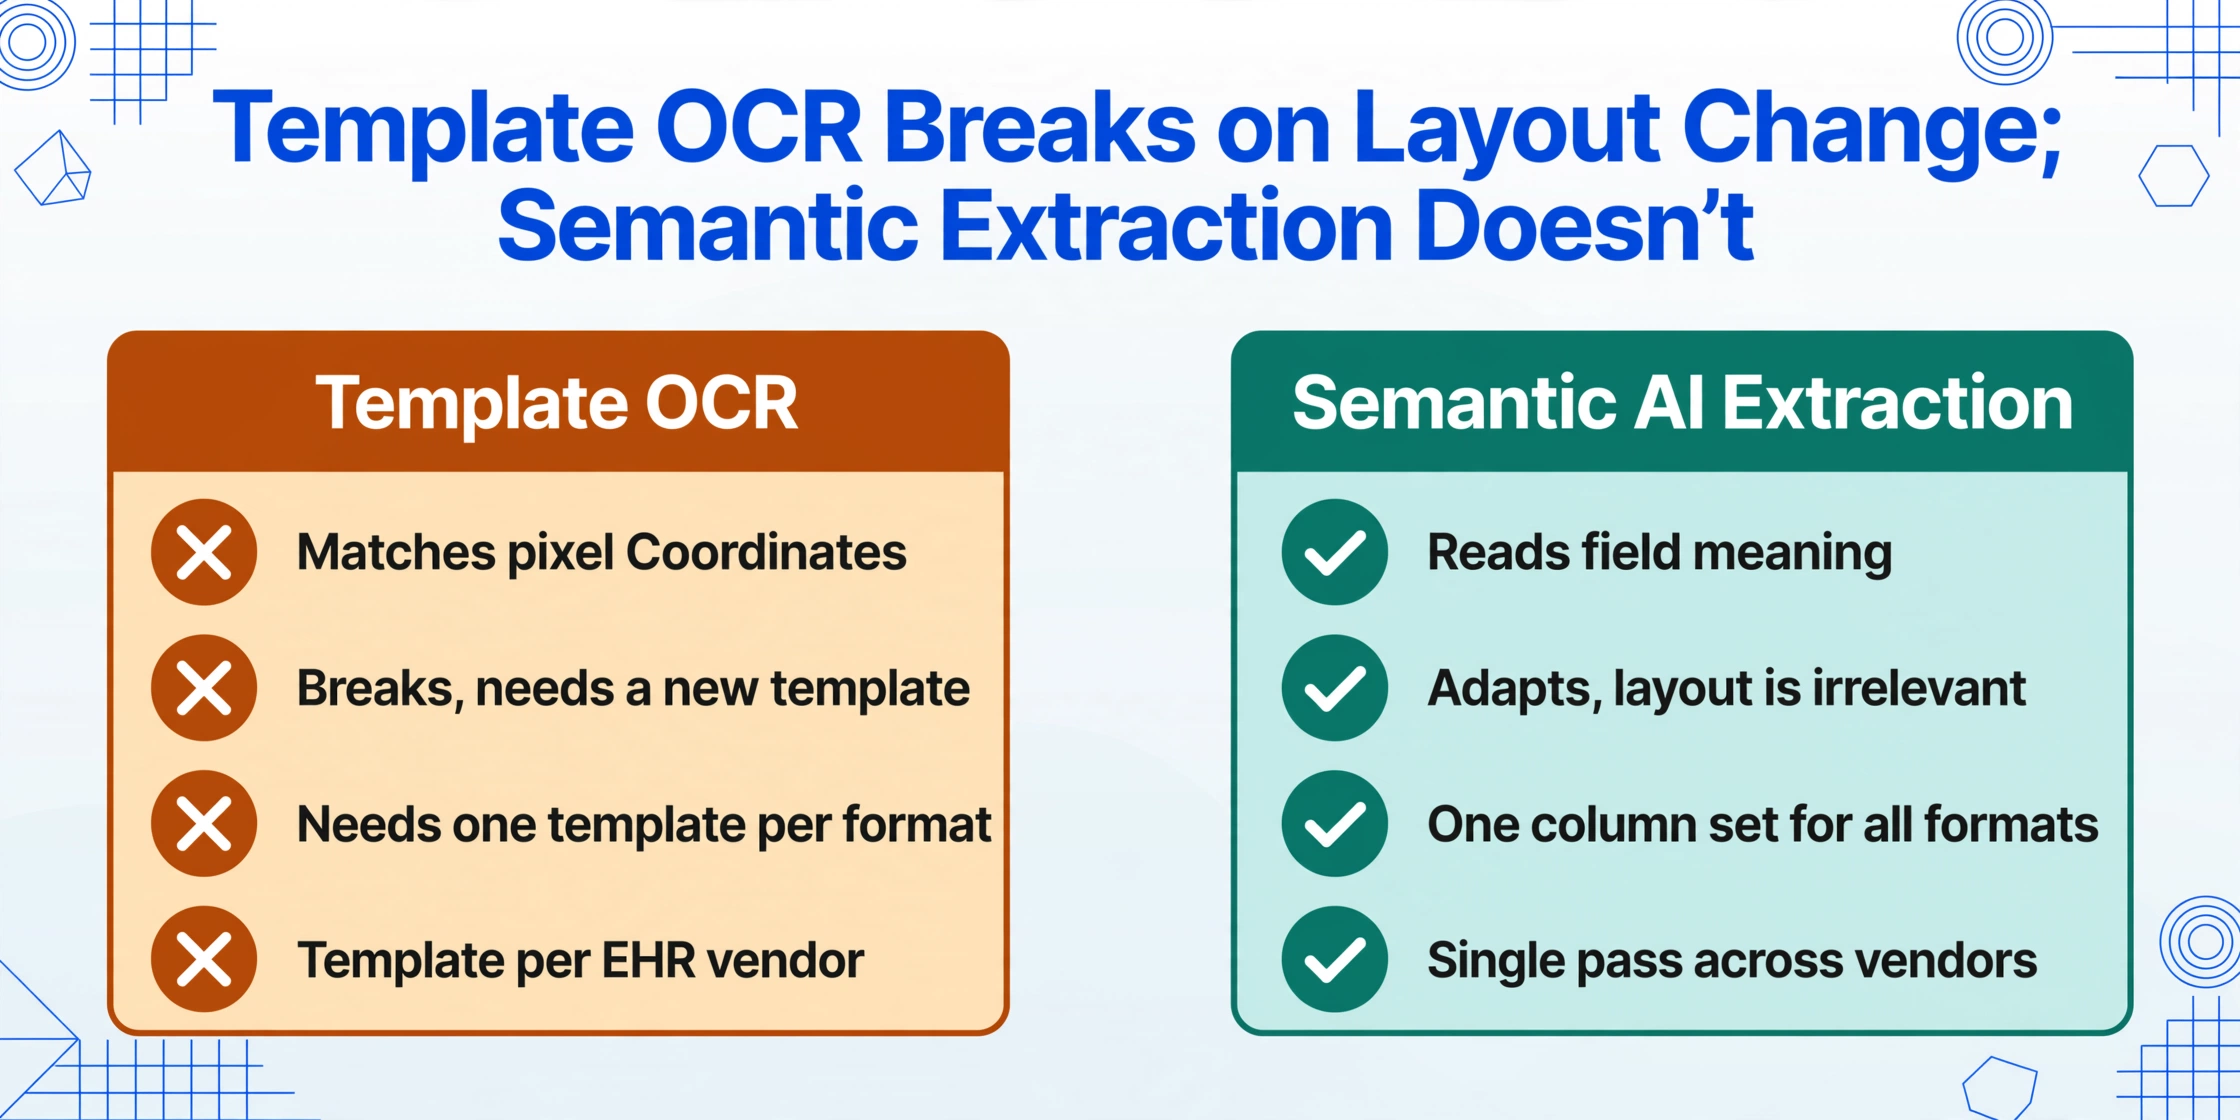
No toda la extracción con IA funciona de la misma manera. La distinción crítica para los datos clínicos es entre la extracción basada en posición (OCR basado en plantillas) y la extracción basada en semántica (IA que lee por significado).
| OCR basado en plantillas | Semantic AI Extraction | |
|---|---|---|
| Cómo encuentra los datos | Coincide coordenadas de píxeles o patrones de etiquetas | Comprende lo que cada campo significa |
| Qué sucede cuando cambia el diseño | Se rompe: requiere una nueva plantilla | Se adapta automáticamente: el diseño es irrelevante |
| Configuración por formato de informe | Una plantilla por formato | Un conjunto de nombres de columnas para todos los formatos |
| Maneja "Glucose" etiquetado como "GLU" | No: necesita una regla separada | Sí: reconoce ambos como el mismo analito |
| Funciona en Epic, Cerner, Meditech | Plantilla separada por proveedor de EHR | Una sola pasada de extracción funciona en todos los proveedores |
La diferencia es un cambio de paradigma. El OCR basado en plantillas pregunta: "¿Dónde está el valor de glucosa en esta página?" La extracción semántica con IA pregunta: "¿Qué valor en esta página significa glucosa?" El primero es un problema de geometría. El segundo es un problema de comprensión lectora. Para los datos clínicos — donde la misma observación puede aparecer bajo una docena de etiquetas diferentes en distintos EHR, proveedores de laboratorio y diseños de informes — el enfoque de comprensión lectora es el que escala.
Esto es lo que Custom Column Extraction significa en la práctica: en lugar de definir cuadros delimitadores o entrenar una plantilla en un diseño de pantalla específico de un EHR, usted escribe los encabezados de columna que desea — "Patient MRN," "BP Systolic," "BP Diastolic," "Heart Rate," "Hemoglobin A1c," "LDL Cholesterol" — y la IA localiza cada valor en cualquier parte del documento comprendiendo su significado clínico. Usted define la salida. La IA comprende la entrada.
Este enfoque también desbloquea el batch processing: subir múltiples capturas de pantalla, PDFs o informes escaneados a la vez y recibir una única hoja de cálculo combinada con una fila por paciente, con todas las columnas pobladas. Para un coordinador de investigación clínica que abstrae datos de 200 historias clínicas de pacientes — cada una con capturas de pantalla de diferentes módulos de EHR tomadas en diferentes momentos — el batch processing convierte una tarea manual de varias semanas en algo que se completa en minutos, con el papel del revisor humano pasando de la entrada de datos a la verificación de datos.
Los formularios de registro en papel no son diferentes en esencia: una ejecución de formulario de admisión de paciente a Excel toma la lista de encabezados que definió y la completa a partir de las páginas escaneadas, de modo que la mitad del expediente en papel termina en la misma tabla que las capturas de pantalla.
Un recorrido práctico: de la captura de pantalla de la HCE a la hoja de cálculo estructurada
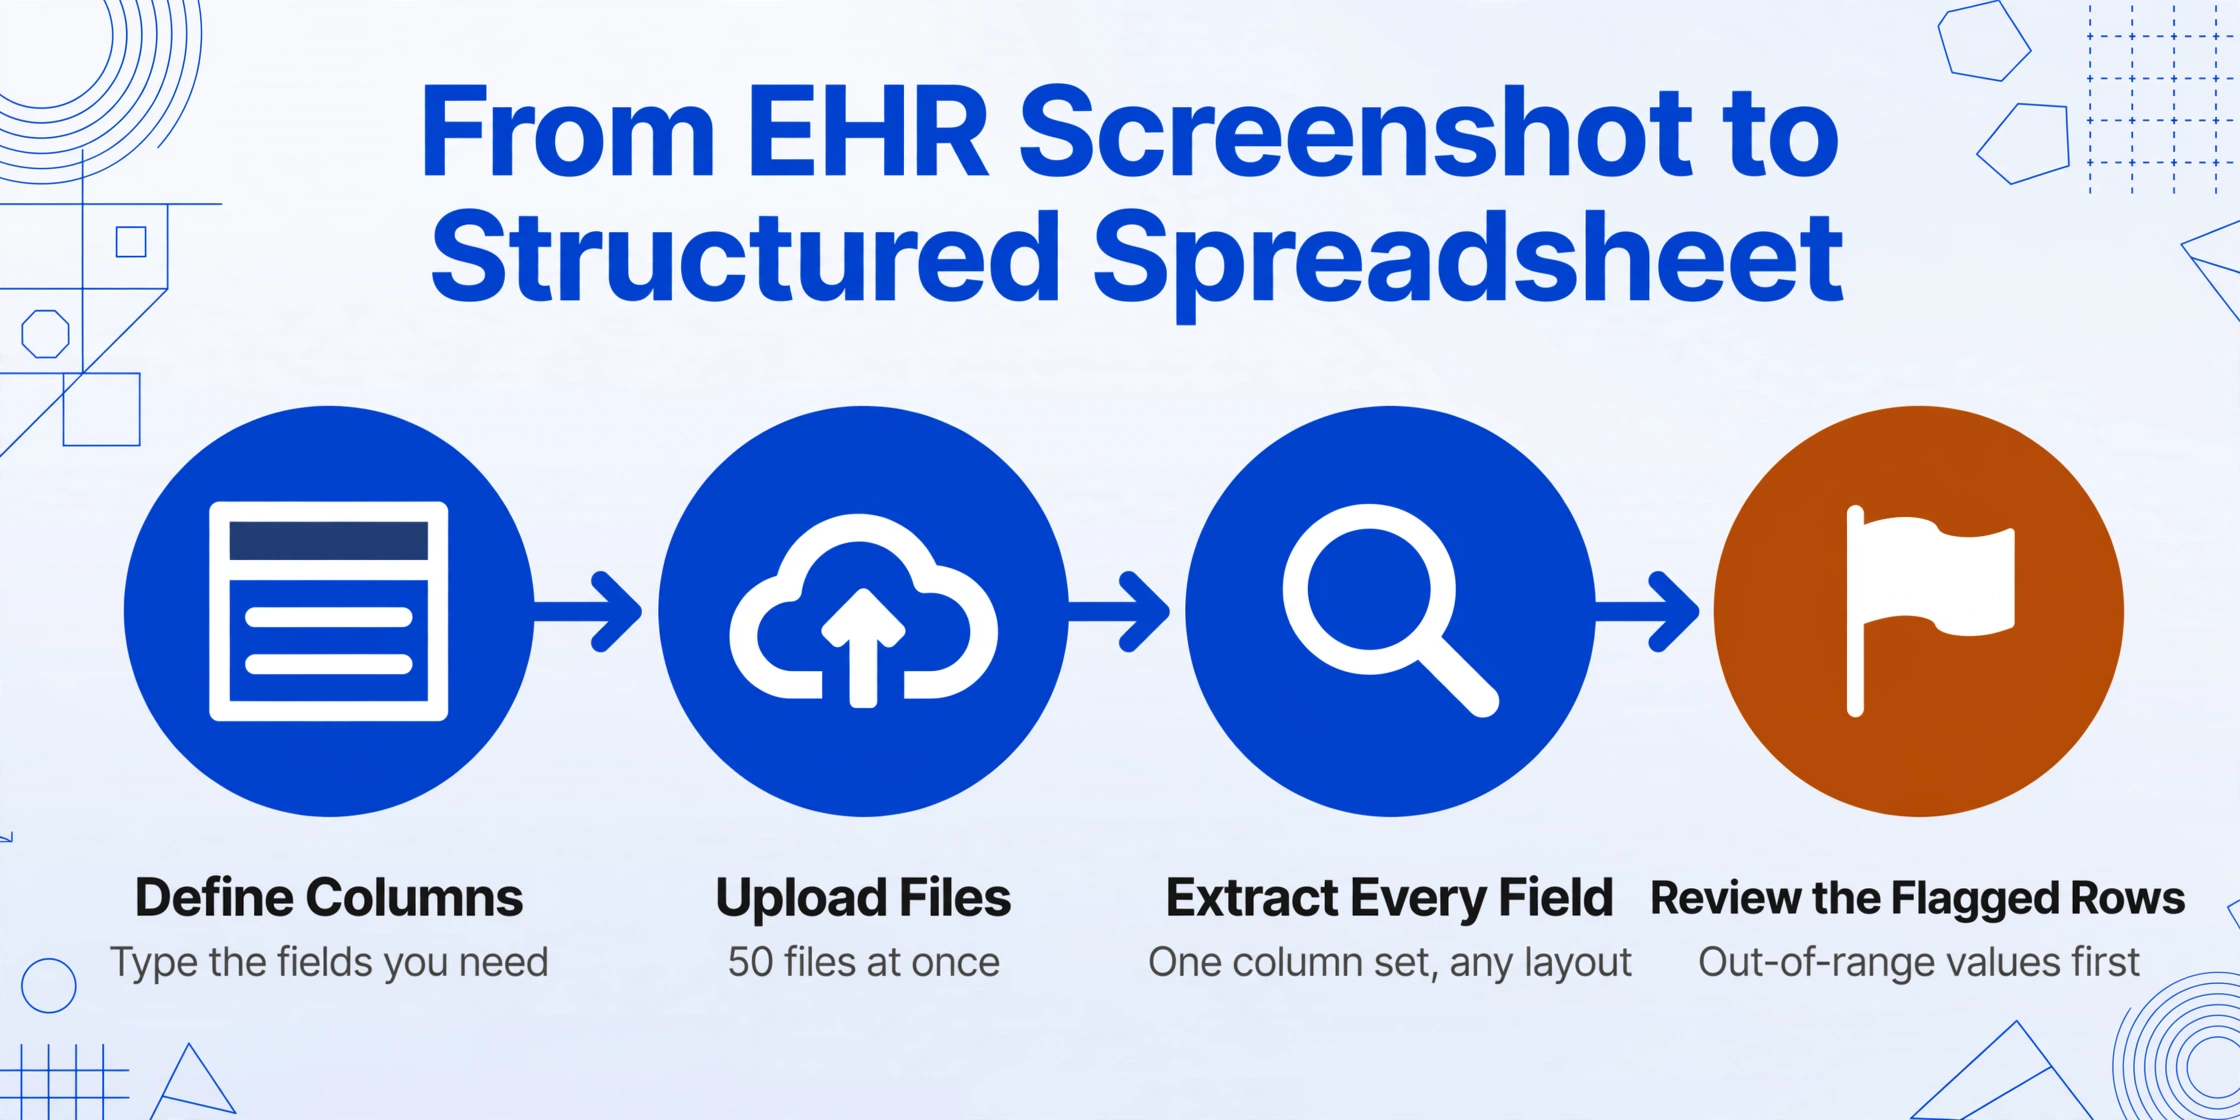
Así es como se ve el flujo de trabajo de extracción de principio a fin, utilizando un escenario real de abstracción de datos clínicos: extracción de variables clave para el envío a un registro de cardiología a partir de capturas de pantalla de gráficos de Epic.
Defina sus columnas
Escriba los campos de datos que necesita: «MRN del paciente», «Fecha de admisión», «Diagnóstico de alta», «FEVI (%)», «Pico de troponina», «Antiplaquetario al alta». También puede incluir columnas inferidas: campos en los que la IA emite un juicio basado en el contenido del documento. Por ejemplo, «Categoría de FEVI (opciones: Preservada/Levemente reducida/Reducida)» indica a la IA que lea el valor de la fracción de eyección, lo compare con los umbrales clínicos y genere la categoría adecuada, incluso aunque «Categoría de FEVI» no esté impreso explícitamente en ningún lugar del gráfico.
Sube tus archivos
Arrastre capturas de pantalla, PDF exportados, informes de laboratorio escaneados: cualquier formato, cualquier proveedor de HCE. Puede subir 50 archivos a la vez. La herramienta admite JPG, PNG, PDF y WebP, de modo que una mezcla de PNG de capturas de Epic, PDF exportados de Cerner e informes de laboratorio por fax escaneados entran todos en el mismo lote.
La IA extrae de todos los archivos
La IA procesa todos los archivos en paralelo. Lee cada documento, localiza los valores que coinciden con sus definiciones de columnas y completa la tabla de resultados. Debido a que la extracción es semántica en lugar de posicional, un valor de troponina mostrado como «cTnI: 0.04 ng/mL» en la pantalla de Epic de un hospital y «Troponina I de alta sensibilidad: 12 ng/L» en el informe de Cerner de un hospital diferente se asignan ambos a la misma columna «Pico de troponina». La IA reconoce ambos como resultados de troponina a pesar de los diferentes tipos de ensayo, unidades y formatos de etiqueta.
Revise y exporte
El resultado es una hoja de cálculo con una fila por paciente y las columnas que especificó como encabezados. Revise la integridad: verifique los valores atípicos, confirme que todas las páginas de los informes de varias páginas se procesaron y luego exporte a Excel, CSV o JSON. Si usa Google Sheets, el complemento escribe los resultados directamente en su hoja activa sin tener que descargar y volver a subir.
Los archivos se procesan de forma segura y no se almacenan.
Cuando la extracción por sí sola no basta: controles de calidad y casos límite
La extracción de datos clínicos conlleva mayores riesgos que el procesamiento de facturas. Un punto decimal mal colocado en una factura implica una corrección de facturación. Un punto decimal mal colocado en un valor de laboratorio implica una marca de calidad en el registro de datos, o peor, un resultado de paciente mal clasificado. Estos son los casos límite que importan y cómo manejarlos.
Valores fuera de rango y discrepancias de unidades
Un valor de creatinina de «15.2 mg/dL» es clínicamente alarmante. Una creatinina de «1.2 mg/dL» es habitual. Si el punto decimal se desplaza durante la extracción, el error se propaga a todos los análisis posteriores. La salvaguarda no está en el paso de extracción, sino en el paso de revisión. Después de la extracción con IA, examine la columna de salida en busca de valores fuera del rango fisiológicamente plausible para la población de pacientes. Las herramientas modernas de extracción pueden marcar valores atípicos automáticamente al comparar los valores extraídos con rangos de referencia configurables. Esto no sustituye la revisión humana, pero dirige la atención del revisor hacia las filas con mayor probabilidad de contener errores, un flujo de trabajo mucho más eficiente que revisar todas las filas por igual.
Medicamentos Duplicados y Artefactos de Conciliación
La lista de medicamentos de un paciente en una pantalla de EHR puede incluir tanto una prescripción activa de "Metformina 500 mg BID" como una orden suspendida de "Metformina 1000 mg al día", ambas visibles en la misma vista del historial de medicación. Una extracción simple que tome todas las entradas de medicamentos capturará ambas, creando un falso duplicado. La solución es configurar la extracción para que capture el estado del medicamento como una columna separada (Activo/Suspendido/Completado), permitiendo al extractor filtrar durante la revisión. Aquí es donde las columnas inferidas se vuelven valiosas: una columna definida como "Solo Medicamentos Activos (sí/no)" instruye a la IA para evaluar el contexto de estado de cada entrada de medicamento y mostrar solo aquellos actualmente activos.
Reportes Multipágina y Páginas de Continuación
Un reporte de laboratorio de 4 páginas donde los resultados de CBC comienzan en la página 2 y continúan en la página 3 presenta un desafío de continuidad. ¿La herramienta de extracción entiende que la página 3 es una continuación, no un nuevo reporte? Los modelos de extracción semántica que procesan documentos de manera holística — leyendo todas las páginas como un solo documento clínico continuo — manejan esto de forma natural. El modelo reconoce que el "WBC: 7.2" de la página 3 pertenece al mismo panel de CBC que comenzó en la página 2, no a un reporte separado. Al cargar PDFs multipágina, asegúrese de que todas las páginas estén incluidas en un solo archivo en lugar de dividirse en cargas separadas, para que la IA pueda mantener este contexto de continuidad.
Anotaciones Manuscritas y Marginalia
Los clínicos anotan. Un reporte de laboratorio impreso con "repetir en 2 semanas" escrito a mano en el margen. Una lista de medicamentos con una dosis circulada y "suspendido — causando malestar GI" garabateado al lado. Estas anotaciones contienen información clínicamente significativa que un motor OCR estándar omitirá o malinterpretará. Los modelos de IA basados en visión que procesan el documento como una imagen — no solo como texto extraído — pueden leer escritura a mano junto con texto impreso, capturando tanto los datos estructurados como el contexto clínico no estructurado en una sola pasada. Si una nota manuscrita modifica el estado de un medicamento, una columna inferida como "Estado del Medicamento (Activo/Suspendido/Modificado)" puede mostrar esa anotación como una bandera estructurada para el revisor.
HIPAA, Seguridad y lo que "Cumplimiento" Realmente Significa
Cualquier herramienta que procese datos clínicos debe abordar HIPAA. Pero el cumplimiento de HIPAA no es una insignia de certificación, sino un estado operativo definido por los requisitos de la Regla de Seguridad de HIPAA para salvaguardas administrativas, físicas y técnicas (45 CFR Parte 160 y Subpartes A y C de la Parte 164). Ninguna agencia gubernamental emite un sello "Certificado HIPAA". Lo que importa es si las prácticas de manejo de datos de la herramienta cumplen con las tres categorías de salvaguardas de la Regla de Seguridad.
Para la extracción de datos clínicos, las salvaguardas técnicas relevantes son: cifrado en tránsito (todos los datos transmitidos por HTTPS), cifrado en reposo, controles de acceso que restrinjan quién puede ver o procesar datos de pacientes, y una política clara sobre retención y eliminación de datos. Una herramienta que procesa archivos de forma efímera — extrayendo datos sin almacenar los documentos fuente después del procesamiento — elimina una categoría significativa de riesgo porque no hay un repositorio persistente de PHI que pueda ser vulnerado.
Para las organizaciones que requieren un Acuerdo de Asociado de Negocio (BAA) — que son la mayoría de las entidades cubiertas bajo HIPAA — la pregunta clave para cualquier proveedor de herramientas de extracción es si firmarán uno. Un BAA es un contrato que extiende las obligaciones de HIPAA al proveedor como asociado de negocio. Sin un BAA firmado, una entidad cubierta no puede compartir legalmente PHI con ese proveedor para su procesamiento. Esto no es una característica técnica; es un requisito contractual. Verifique antes de cargar cualquier dato de paciente.
En la práctica, el modelo de seguridad para la extracción de datos clínicos impulsada por IA debería ser: el usuario controla qué datos ingresan al sistema, el sistema los procesa sin retener los archivos fuente, y el usuario controla a dónde va la salida. Sin almacenamiento persistente de PHI. Sin entrenamiento con datos del usuario. Sin compartir con terceros. Estas son las prácticas operativas, no afirmaciones de marketing, que distinguen un flujo de trabajo compatible con HIPAA de una herramienta genérica de carga de archivos.
Cuándo destaca la extracción semántica — y cuándo necesita un humano
La extracción semántica con IA maneja bien la mayoría de los escenarios de abstracción de datos clínicos, pero hay situaciones concretas donde el juicio humano sigue siendo esencial. Ser honestos sobre estos límites es mejor que prometer una experiencia sin fricciones que no existe.
Dónde destaca: Datos clínicos estructurados o semiestructurados en una sola pantalla o informe — tablas de signos vitales, listas de medicación, paneles de laboratorio, listas de problemas, registros de vacunación, conciliaciones de medicación al alta. Estos tipos de datos tienen semántica clínica predecible incluso cuando su presentación visual varía. La IA puede capturarlos con alta precisión en distintos sistemas EHR y formatos de informe porque los conceptos clínicos subyacentes (presión arterial, hemoglobina A1c, dosis de medicación) son universales.
Dónde un humano debe verificar: Notas clínicas narrativas con datos incrustados — una nota de evolución que menciona un valor de laboratorio de paso ("K era 3.1 esta mañana, así que repusimos") sin una entrada formal de resultado de laboratorio. La IA puede extraer "3.1" como un valor de potasio, pero quizás no capte el contexto clínico de que fue una prueba de punto de atención, no una extracción formal de laboratorio, y el valor podría no corresponder al campo "Potasio sérico" del registro. Del mismo modo, documentos escaneados con muchos artefactos — registros por fax que han sido reenviados múltiples veces, creando texto fantasma y desalineación — pueden producir resultados degradados. En estos casos, la extracción con IA debe tratarse como un borrador inicial que un revisor humano confirma, no como una respuesta definitiva.
Un estudio de referencia de 2024 sobre herramientas de extracción de información basadas en LLM para documentos médicos (publicado en medRxiv) encontró que los modelos modernos de IA "ofrecen un avance significativo sobre los métodos basados en reglas" para tareas de IE clínica, pero señaló que el rendimiento varía según el tipo de documento y la complejidad de la extracción. La conclusión para los profesionales: use la extracción con IA como un multiplicador de productividad que maneja el 80% de los datos sencillos, liberando al extractor humano para centrar el esfuerzo de verificación en el 20% que requiere juicio clínico.
Comparación con otros enfoques
Las opciones de extracción de datos clínicos van desde completamente manuales hasta totalmente automatizadas. Aquí se comparan en la práctica, no en textos de marketing.
| Enfoque | Configuración requerida | Maneja variaciones de formato | Funciona sin acceso a TI | Ideal para |
|---|---|---|---|---|
| Abstracción manual | Ninguna | Sí (se adapta el humano) | Sí | Volumen muy bajo, alta complejidad clínica |
| API FHIR/HL7 | Integración TI + credenciales | N/A (datos estructurados) | No | Datos estructurados de alto volumen en un ecosistema EHR |
| OCR con plantillas | Una plantilla por formato | No — falla al cambiar el diseño | Sí | Documentos de alto volumen y formato único |
| Pipeline de PLN | Desarrollo técnico + datos de entrenamiento | Parcial | No | Implementación empresarial en una sola institución |
| Extracción con IA semántica | Escribir nombres de columnas | Sí — independiente del diseño | Sí | Abstracción de datos clínicos multifuente y multiformato |
La elección correcta depende del volumen, la diversidad de formatos y el acceso organizacional a recursos técnicos. Para el coordinador de investigación clínica que abstrae 200 historias de una mezcla de capturas de Epic, PDFs de laboratorios externos y registros enviados por fax — sin credenciales de base de datos, sin acceso a API y sin equipo de ingeniería de PLN — la extracción con IA semántica es la única opción de la lista que no requiere ni construcción de plantillas ni integración con TI. No es el único enfoque válido, pero es el único que se ajusta a las limitaciones reales de la mayoría del trabajo de abstracción de datos clínicos.
Preguntas Frecuentes
¿La extracción por IA funciona con capturas de cualquier sistema EHR?
Sí, porque la extracción se basa en entender qué significan los datos, no en buscar un diseño de pantalla específico. Una lectura de presión arterial en un flujograma de Epic, una tabla de signos vitales de Cerner y un resumen de paciente de Meditech se reconocen como presión arterial, independientemente de la fuente, posición o formato de la etiqueta. La IA procesa la captura como imagen y la lee como lo haría un clínico humano, interpretando el contenido semánticamente. Dicho esto, las pantallas muy saturadas con datos superpuestos —múltiples tablas apiladas, ventanas emergentes o vistas divididas con fuente pequeña— pueden reducir la precisión y requieren verificación puntual.
¿Puede extraer datos de notas clínicas manuscritas?
Sí, con salvedades. Los modelos de IA basados en visión pueden leer texto manuscrito junto con texto impreso en el mismo documento. La escritura clara y estructurada —anotaciones de medicamentos, signos vitales en un flujograma en papel— se extrae de forma fiable. La escritura muy cursiva, apresurada y con abreviaturas no estándar tendrá menor precisión. Para contenido manuscrito, trate la extracción por IA como un borrador que requiere verificación humana, no como un registro final autorizado.
¿Cómo maneja esto los requisitos de PHI e HIPAA?
El cumplimiento de HIPAA es un estado operativo, no una certificación. Los factores relevantes para cualquier herramienta de extracción son: (1) si los datos se cifran en tránsito (HTTPS) y en reposo, (2) si los archivos se procesan de forma efímera —extrayendo y descartando sin almacenamiento persistente de PHI—, (3) si el proveedor firma un Acuerdo de Asociado Comercial (BAA) si su organización lo requiere, y (4) si el acceso a los datos procesados está restringido solo a usuarios autorizados. Verifique estos detalles con la herramienta específica que está evaluando antes de cargar datos de pacientes. Ninguna herramienta de extracción debería afirmar tener una "certificación" HIPAA, porque dicha certificación no existe. Lo que importa son las salvaguardas operativas.
¿Cuál es la precisión en informes de laboratorio PDF de varias páginas?
Para texto impreso en escaneos limpios, la precisión puede alcanzar el 99% para campos claramente definidos. Los informes de varias páginas funcionan mejor cuando se cargan como un solo PDF para que la IA mantenga la continuidad entre páginas —reconociendo que el resultado de WBC de la página 3 pertenece al mismo panel de CBC que comenzó en la página 2. La precisión disminuye con escaneos con muchos artefactos (imagen fantasma por fax de múltiples generaciones), inclinación extrema o tamaños de fuente muy pequeños. Para envíos críticos a registros, verifique una muestra de los resultados extraídos contra los documentos fuente antes del procesamiento por lotes.
¿Puedo procesar cientos de historias clínicas a la vez?
Sí. El procesamiento por lotes está diseñado exactamente para este escenario: cargue todos los archivos a la vez, defina los encabezados de columna una vez y reciba una sola hoja de cálculo combinada con una fila por paciente. El tiempo de procesamiento escala con el número de archivos, no de forma lineal: varios archivos se procesan en paralelo. Un lote de 100 capturas suele completarse en menos de un minuto. Para volúmenes más grandes (más de 500 archivos), divida en varios lotes para evitar límites de tiempo de espera y facilitar la revisión incremental.
¿Qué pasa si necesito extraer datos que no están escritos explícitamente en pantalla?
Para eso sirven las columnas inferidas. Una columna inferida le indica a la IA que haga un juicio basado en el contenido del documento, no solo que transcriba un valor visible. Por ejemplo, "Categoría de FEVI (opciones: ≥50% Preservada / 40-49% Levemente Reducida / <40% Reducida)" lee el porcentaje de fracción de eyección del documento, lo compara con los umbrales clínicos y genera la categoría adecuada, aunque "Categoría de FEVI" nunca esté escrito en el informe. Del mismo modo, "Estado de Conciliación de Medicación (Completa/Incompleta)" puede evaluar si los medicamentos de alta coinciden con los de ingreso y señalar discrepancias. Las columnas inferidas convierten la extracción de una simple transcripción en generación estructurada de datos clínicos.
¿Esto reemplaza a los abstractores de datos clínicos?
No — es una herramienta que cambia en qué invierten su tiempo los abstractores. En lugar de dedicar el 50% de sus horas a la entrada manual de datos (hallazgo de Carta Healthcare 2024), los abstractores pueden dedicarse a la verificación, el juicio clínico y la investigación de valores atípicos. La IA se encarga de la transcripción rutinaria; el humano, del razonamiento clínico. No se trata de reemplazar abstractores. Se trata de eliminar la parte del trabajo para la que ningún clínico estudió: leer valores de una pantalla y tipearlos en otra.
La abstracción de datos clínicos necesitaba una herramienta que lea pantallas como un humano — entendiendo qué significan los datos, no dónde están. La extracción semántica con IA no reemplaza el juicio clínico del abstractor. Reemplaza el copiar y pegar.
Si hoy extraes datos clínicos de capturas de pantalla de EHR — para un registro, un estudio de investigación, un proyecto de mejora de calidad o una auditoría — el primer paso es probar el método con un lote pequeño de tus propios archivos. Elige 10 historias de pacientes. Define tus columnas. Ejecuta la extracción. Compara el resultado con tu abstracción manual. Si la IA captura correctamente el 90%+ de los datos, acabas de recuperar la mayor parte del tiempo que dedicas a transcribir. El 10% restante es donde pertenece tu experiencia clínica.