Como extrair dados clínicos de
Capturas de tela de EHR — abstração semântica sem modelos
Um abstração de dados clínicos em um sistema de saúde de médio porte abre o Epic, navega até o prontuário de um paciente e começa a revisar. Sinais vitais. Medicamentos. Painéis de laboratório. Lista de problemas. Cada dado está na tela à sua frente — totalmente digital, totalmente legível — mas para colocá-lo na ferramenta de envio de registro, no banco de dados do registro de AVC ou na planilha de medidas de qualidade, ele precisa ler e redigitar. Campo por campo. Paciente por paciente. Ele não está sozinho. Uma pesquisa da Carta Healthcare de 2024 com abstração de dados clínicos descobriu que mais da metade dos entrevistados passa a maior parte das horas de trabalho em entrada e extração manual de dados, com 70% relatando encontrar erros ou discrepâncias resultantes da abstração manual — 20% disseram que isso acontece "muito frequentemente". A ironia é evidente: os dados já são digitais, armazenados em um banco de dados relacional dentro de um EHR, mas no momento em que aparecem como captura de tela, relatório impresso ou PDF exportado, tornam-se não estruturados novamente. Tornam-se algo que uma pessoa precisa transcrever.
O Paradoxo da Captura de Tela: Por Que Registros Digitais Não Significam Dados Extraíveis
Os prontuários eletrônicos deveriam resolver o problema da portabilidade de dados. Em vez disso, criaram um novo: a captura de tela como unidade padrão de troca de dados clínicos.
Isso não é exagero. No r/healthIT do Reddit, um faturista hospitalar descreveu a realidade diária nos fluxos de trabalho de dados clínicos: "Trocar dados entre sistemas é extremamente complicado e geralmente exige copiar e colar cada campo desejado no outro sistema." Um tópico de pesquisa clínica no r/clinicalresearch perguntou por que a inserção manual de dados do prontuário eletrônico para o EDC continua tediosa. A resposta principal: "Preocupações individuais de privacidade e segurança dos hospitais. Cada site é diferente, e quase todos têm extrema desconfiança com informações protegidas de saúde (PHI)."
A causa raiz é estrutural. Os sistemas de prontuário eletrônico — Epic, Cerner (agora Oracle Health), Meditech — armazenam dados em bancos de dados relacionais proprietários, projetados para processamento de transações, não para extração. A Epic usa um banco de dados de relatórios chamado Clarity, que espelha dados clínicos de seu sistema transacional Chronicles. A Cerner depende do Millennium, que organiza registros em centenas de tabelas com esquemas específicos do fornecedor. O acesso direto ao banco de dados exige conhecimento de SQL que a maioria das equipes clínicas não possui — e a maioria dos sistemas de saúde não concede.
Isso cria o paradoxo da captura de tela: os dados são digitais dentro do prontuário, mas a única maneira de movê-los para outro sistema — um registro clínico, um banco de dados de pesquisa, uma planilha de relatórios de qualidade — é através de uma tela. Alguém faz login, navega até o paciente certo, o atendimento certo, a aba certa e lê os valores necessários. Depois, digita-os em outro lugar. Isso é a abstração de dados clínicos na prática: o processo sistemático de extrair, revisar e validar informações-chave dos prontuários médicos dos pacientes. E apesar da palavra "sistemático", é esmagadoramente manual. Um estudo publicado no Journal of AHIMA descobriu que 58% das organizações de saúde usam abstração manual como método principal, enquanto apenas 18% usam processamento de linguagem natural e 12% usam consultas simples de banco de dados (Estudo PMC, 2021).
O Que Torna os Dados Clínicos Mais Difíceis de Extrair do Que um Formulário Padrão
Uma fatura padrão tem cerca de uma dúzia de campos — data, valor, nome do fornecedor, itens de linha — e seu significado é inequívoco entre os formatos. Um registro clínico é diferente. O mesmo tipo de dado aparece em representações extremamente diferentes, dependendo do módulo do EHR, do layout do relatório e até mesmo de qual hospital dentro do mesmo sistema de saúde o gerou. Aqui estão as quatro categorias de dados que quebram as abordagens tradicionais de extração e o porquê.
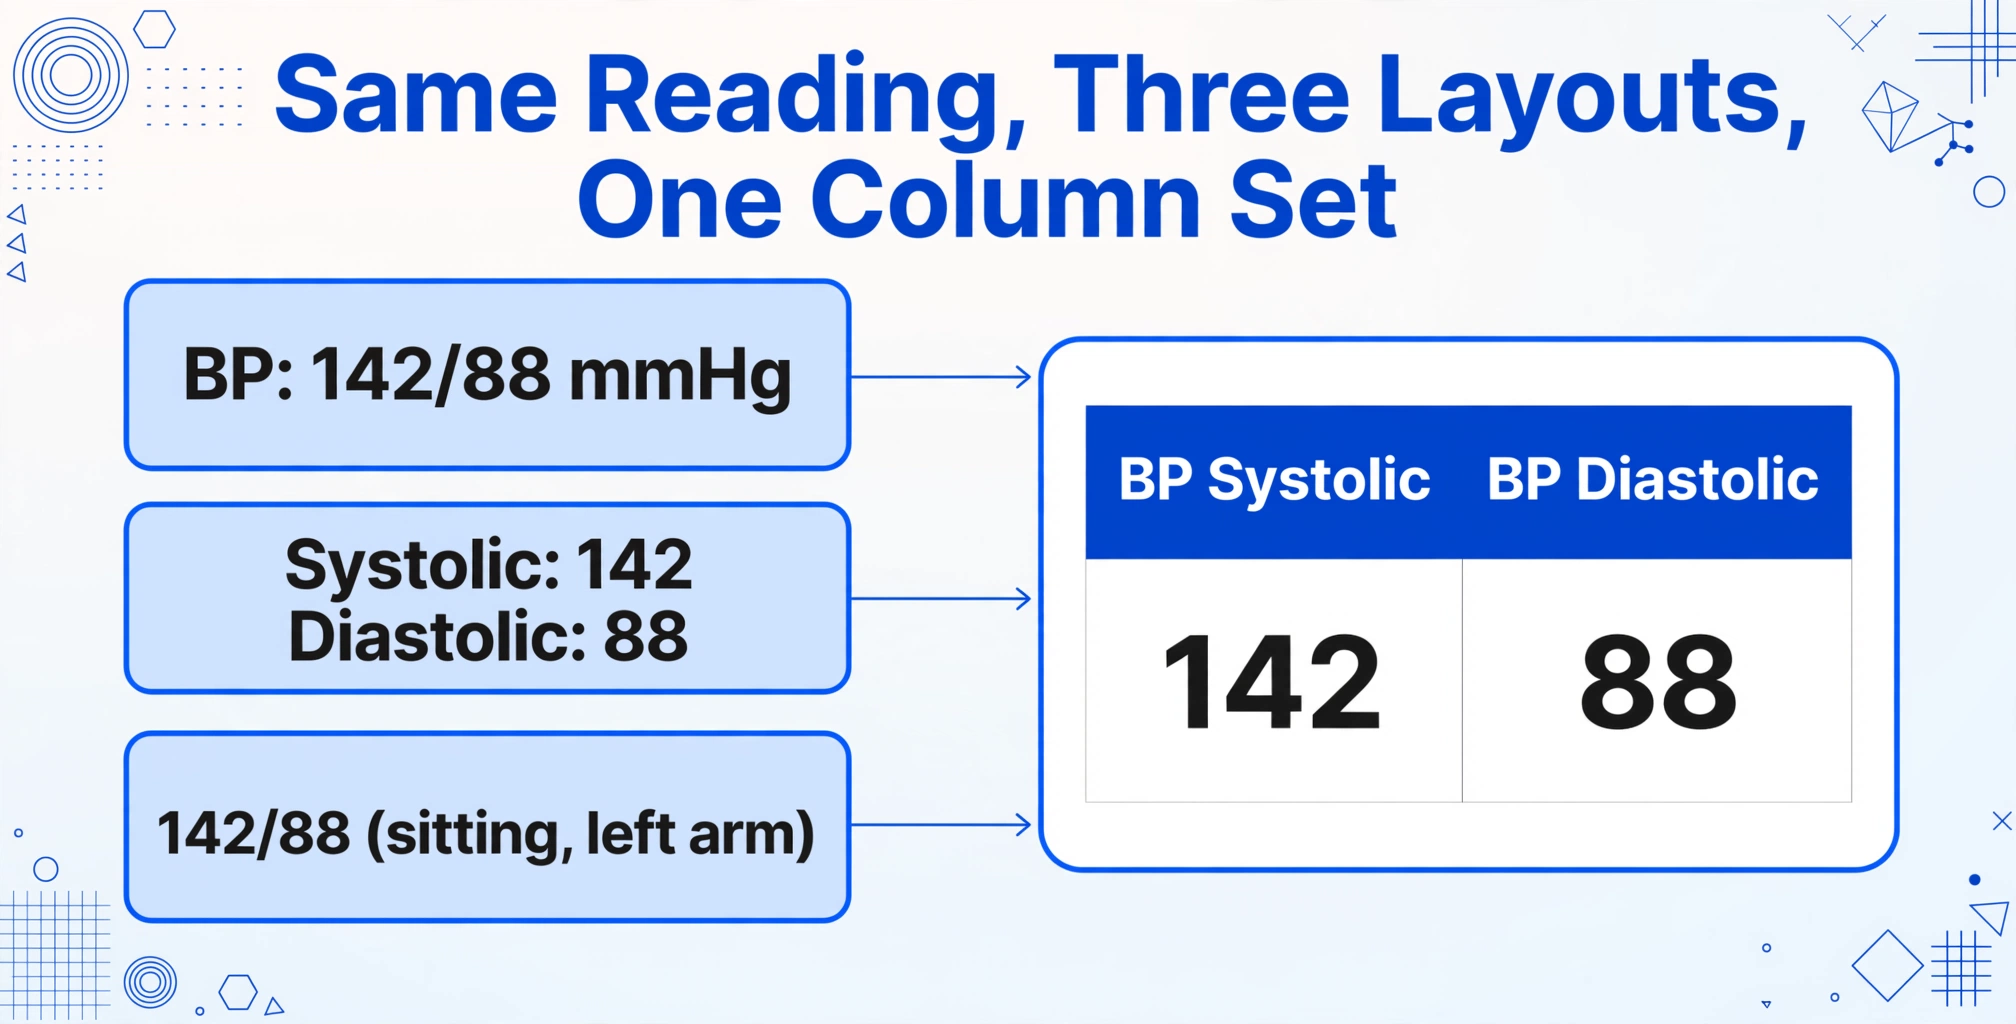
Sinais Vitais: Mais do Que Apenas Números
Uma leitura de pressão arterial de "142/88" pode aparecer em uma tela como BP: 142/88 mmHg, em outra como uma tabela de duas linhas com "Systolic: 142" e "Diastolic: 88," e em uma terceira como "142/88 (sentado, braço esquerdo)" com contexto posicional anexado. Uma ferramenta de extração baseada em modelos — que procura valores em coordenadas de pixel fixas ou faz correspondência de padrões com um formato de rótulo conhecido — quebra na primeira variação. Ela precisa de um modelo separado para cada layout. Um modelo de extração semântica, por outro lado, reconhece que "142/88," "Systolic 142 / Diastolic 88," e "BP 142/88" descrevem o mesmo conceito clínico, independentemente de como são formatados, porque lê pelo significado em vez da posição.
Os sinais vitais também carregam faixas de referência que mudam de acordo com a idade, o sexo e o contexto clínico do paciente. Uma frequência cardíaca de 110 bpm é normal para um recém-nascido e preocupante para um adulto em repouso. A ferramenta de extração não precisa fazer esse julgamento clínico — o abstraidor faz — mas precisa preservar o valor com precisão, juntamente com sua unidade e o carimbo de data/hora em que foi registrado, para que o abstraidor tenha informações completas para revisão posterior.
A mesma leitura aparece fora do EHR: um auxiliar de saúde domiciliar documentando uma visita fotografa o monitor de pressão arterial, o medidor de glicose ou o display do oxímetro de pulso e depois digita cada número no registro de cuidados. Essa foto de sinais vitais do auxiliar de saúde domiciliar é o mesmo problema de extração — uma linha por visita, com sistólica, diastólica, pulso e SpO2 como colunas.
Listas de Medicamentos: Análise de Múltiplos Campos em Texto Livre
Os dados de medicamentos em uma tela de prontuário eletrônico do paciente (PEP) raramente aparecem em uma tabela organizada. Podem ser exibidos como um registro contínuo de administração de medicamentos (MAR) com colunas para nome do medicamento, dose, via, frequência e último horário de administração — ou como uma nota narrativa de reconciliação de medicamentos: "Metformina 1000 mg VO 12/12h, Lisinopril 20 mg VO diariamente, Atorvastatina 40 mg VO ao deitar." O primeiro formato é uma tabela. O segundo é uma frase. Uma ferramenta de OCR baseada em modelos pode capturar o texto de ambos, mas não vai analisar "Metformina 1000 mg VO 12/12h" nos campos estruturados [Medicamento: Metformina, Dose: 1000 mg, Via: Oral, Frequência: Duas vezes ao dia] sem regras manuais para cada possível abreviação de nome de medicamento. Uma abordagem de IA semântica lê a frase e entende a relação entre cada nome de medicamento e sua dose, via e frequência associadas — da mesma forma que um farmacêutico examinaria uma lista de medicamentos e a organizaria mentalmente.
Painéis Laboratoriais: Um Valor, Muitos Rótulos
Um resultado de glicose sérica pode aparecer como "Glicose: 102 mg/dL" em um relatório da Quest Diagnostics, "GLU 102" em uma planilha laboratorial da Cerner e "Glicose, Soro — 102 mg/dL (Ref: 70-99)" em uma tela de Revisão de Resultados da Epic. Os três representam a mesma observação clínica: uma glicose de jejum de 102. Uma abordagem baseada em modelos precisa ser treinada em cada variante de rótulo individualmente. Um modelo semântico reconhece que "Glicose", "GLU" e "Glicose, Soro" são três rótulos que apontam para o mesmo analito — porque entende a terminologia clínica, não apenas sequências de texto.
Essa distinção é extremamente importante na prática. Um coordenador de pesquisa clínica extraindo valores laboratoriais de 200 pacientes de uma combinação de PDFs de laboratórios externos, capturas de tela de PEP internos e resultados enviados por fax não pode criar 200 modelos de extração. Ele precisa de uma única etapa de extração que funcione em todos os formatos. A extração semântica — que identifica valores pelo que eles significam em vez de onde estão — é o mecanismo que torna isso possível.
Listas de Problemas: Códigos e Narrativas Lado a Lado
Uma entrada na lista de problemas no Epic pode ser: "E11.9 — Diabetes mellitus tipo 2 sem complicações." O código ICD-10 "E11.9" fica ao lado da descrição textual. Alguns relatórios exibem apenas o código; outros apenas a descrição; alguns exibem ambos. Uma ferramenta de extração ingênua pode puxar "E11.9" para um campo e descartar a descrição, ou puxar a descrição e perder o código. O abstraidor precisa de ambos — o código para submissão ao registro e a descrição para o contexto clínico. Uma abordagem de extração semântica que entende a relação entre um código de diagnóstico e sua descrição textual associada pode capturar o par de forma confiável, preservando o quadro clínico completo.
Por que FHIR e HL7 Não Resolvem o Problema dos Screenshots
A pergunta óbvia neste ponto é: por que não usar uma API? FHIR (Fast Healthcare Interoperability Resources) é o padrão HL7 projetado precisamente para isso — troca estruturada de dados clínicos entre sistemas. O Epic suporta SMART on FHIR. A Cerner oferece APIs Ignite no FHIR R4. A plataforma Expanse da Meditech expõe endpoints FHIR R4. Então por que as pessoas ainda copiam e colam de screenshots?
Porque as APIs FHIR cobrem um conjunto limitado de elementos de dados e um conjunto limitado de usuários. As APIs FHIR do Epic atendem a dados demográficos de pacientes, consultas, alergias e alguns documentos clínicos — mas não expõem métricas de qualidade, dados detalhados de faturamento ou os campos personalizados que as práticas adicionam para acompanhar encaminhamentos, autorizações prévias e variáveis específicas de registros. Como a análise da Skyvern sobre automação de EHR documentou (março de 2026), mesmo as melhores implementações FHIR deixam lacunas significativas no que é acessível programaticamente.
Mais fundamentalmente, o acesso via API exige infraestrutura de TI que a maioria das equipes clínicas não controla. Uma enfermeira de melhoria da qualidade abstraindo dados para o CathPCI Registry do ACC ou um coordenador de AVC submetendo dados ao Get With The Guidelines não tem as credenciais, as chaves de API ou o suporte técnico para construir integrações FHIR. Eles têm acesso ao front-end do EHR. Eles podem fazer login, visualizar gráficos de pacientes e tirar screenshots. Esse é o pipeline de extração de dados deles — e, para uma grande fração do trabalho de abstração de dados clínicos, é o único pipeline disponível.
A equipe da Health Elements, que constrói ferramentas de abstração baseadas em IA para registros cardiovasculares, estima que um sistema de saúde de médio porte gasta US$ 15 milhões ou mais anualmente em abstração de dados clínicos em todas as linhas de serviço (análise da Health Elements). A mesma análise constatou que a abstração baseada em IA pode reduzir o tempo de abstração em até 90% e cortar os custos totais de abstração em 50% ou mais. Essas economias não vêm de APIs melhores — vêm de ferramentas que podem ler o que está na tela da mesma forma que um abstraidor humano faz, apenas mais rápido e com mais consistência.
Extração Semântica vs. OCR Baseado em Modelos: A Diferença Que Importa
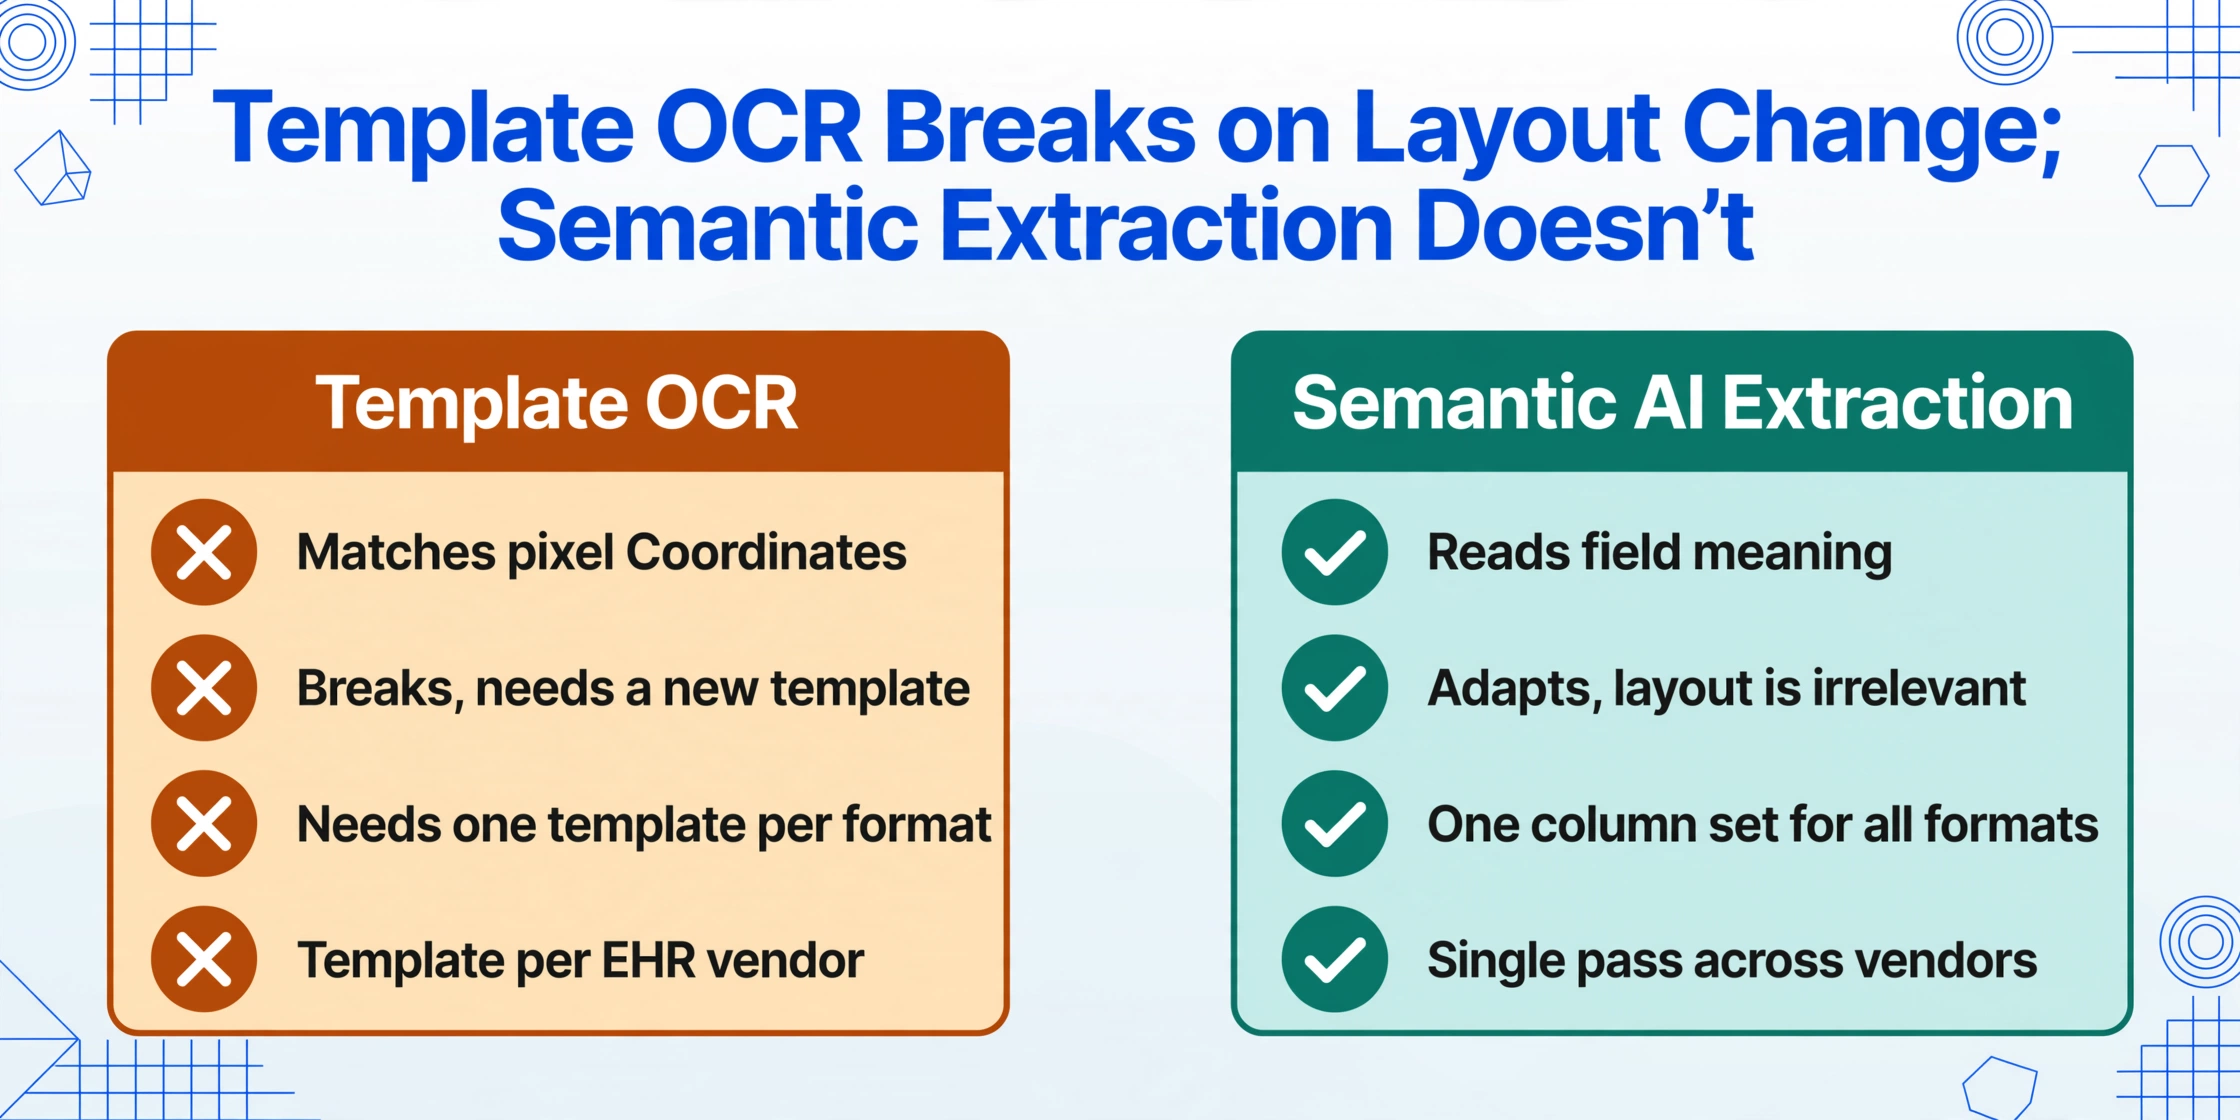
Nem toda extração com IA funciona da mesma forma. A distinção crítica para dados clínicos está entre extração baseada em posição (OCR de modelo) e extração semântica (IA que lê pelo significado).
| OCR Baseado em Modelos | Extração Semântica com IA | |
|---|---|---|
| Como encontra os dados | Corresponde a coordenadas de pixel ou padrões de rótulos | Entende o que cada campo significa |
| O que acontece quando o layout muda | Quebra — exige um novo modelo | Adapta-se automaticamente — o layout é irrelevante |
| Configuração por formato de relatório | Um modelo por formato | Um conjunto de nomes de colunas para todos os formatos |
| Lida com "Glucose" rotulado como "GLU" | Não — precisa de uma regra separada | Sim — reconhece ambos como o mesmo analito |
| Funciona em Epic, Cerner, Meditech | Modelo separado por fornecedor de EHR | Uma única passagem de extração funciona em todos os fornecedores |
A diferença é uma mudança de paradigma. O OCR baseado em modelos pergunta: "Onde está o valor de glicose nesta página?" A extração semântica com IA pergunta: "Qual valor nesta página significa glicose?" O primeiro é um problema de geometria. O segundo é um problema de compreensão de leitura. Para dados clínicos — onde a mesma observação pode aparecer sob uma dúzia de rótulos diferentes em diferentes EHRs, fornecedores de laboratório e layouts de relatórios — a abordagem de compreensão de leitura é a que escala.
É isso que Custom Column Extraction significa na prática: em vez de definir caixas delimitadoras ou treinar um modelo em um layout de tela específico de EHR, você digita os cabeçalhos das colunas que deseja — "MRN do Paciente," "PA Sistólica," "PA Diastólica," "Frequência Cardíaca," "Hemoglobina A1c," "Colesterol LDL" — e a IA localiza cada valor em qualquer lugar do documento ao compreender seu significado clínico. Você define a saída. A IA entende a entrada.
Essa abordagem também possibilita o batch processing: enviar vários screenshots, PDFs ou relatórios digitalizados de uma só vez e receber uma única planilha mesclada com uma linha por paciente, todas as colunas preenchidas. Para um coordenador de pesquisa clínica que abstrai dados de 200 prontuários de pacientes — cada um contendo screenshots de diferentes módulos de EHR capturados em momentos diferentes — o batch processing transforma uma tarefa manual de várias semanas em algo que é concluído em minutos, com o papel do revisor humano mudando de entrada de dados para verificação de dados.
Os formulários de registro em papel não são diferentes — uma execução de formulário de admissão de paciente para Excel usa a lista de cabeçalhos que você definiu e a preenche a partir das páginas digitalizadas, de modo que a parte em papel do prontuário vá para a mesma tabela que as capturas de tela.
Um passo a passo prático: da captura de tela do EHR à planilha estruturada
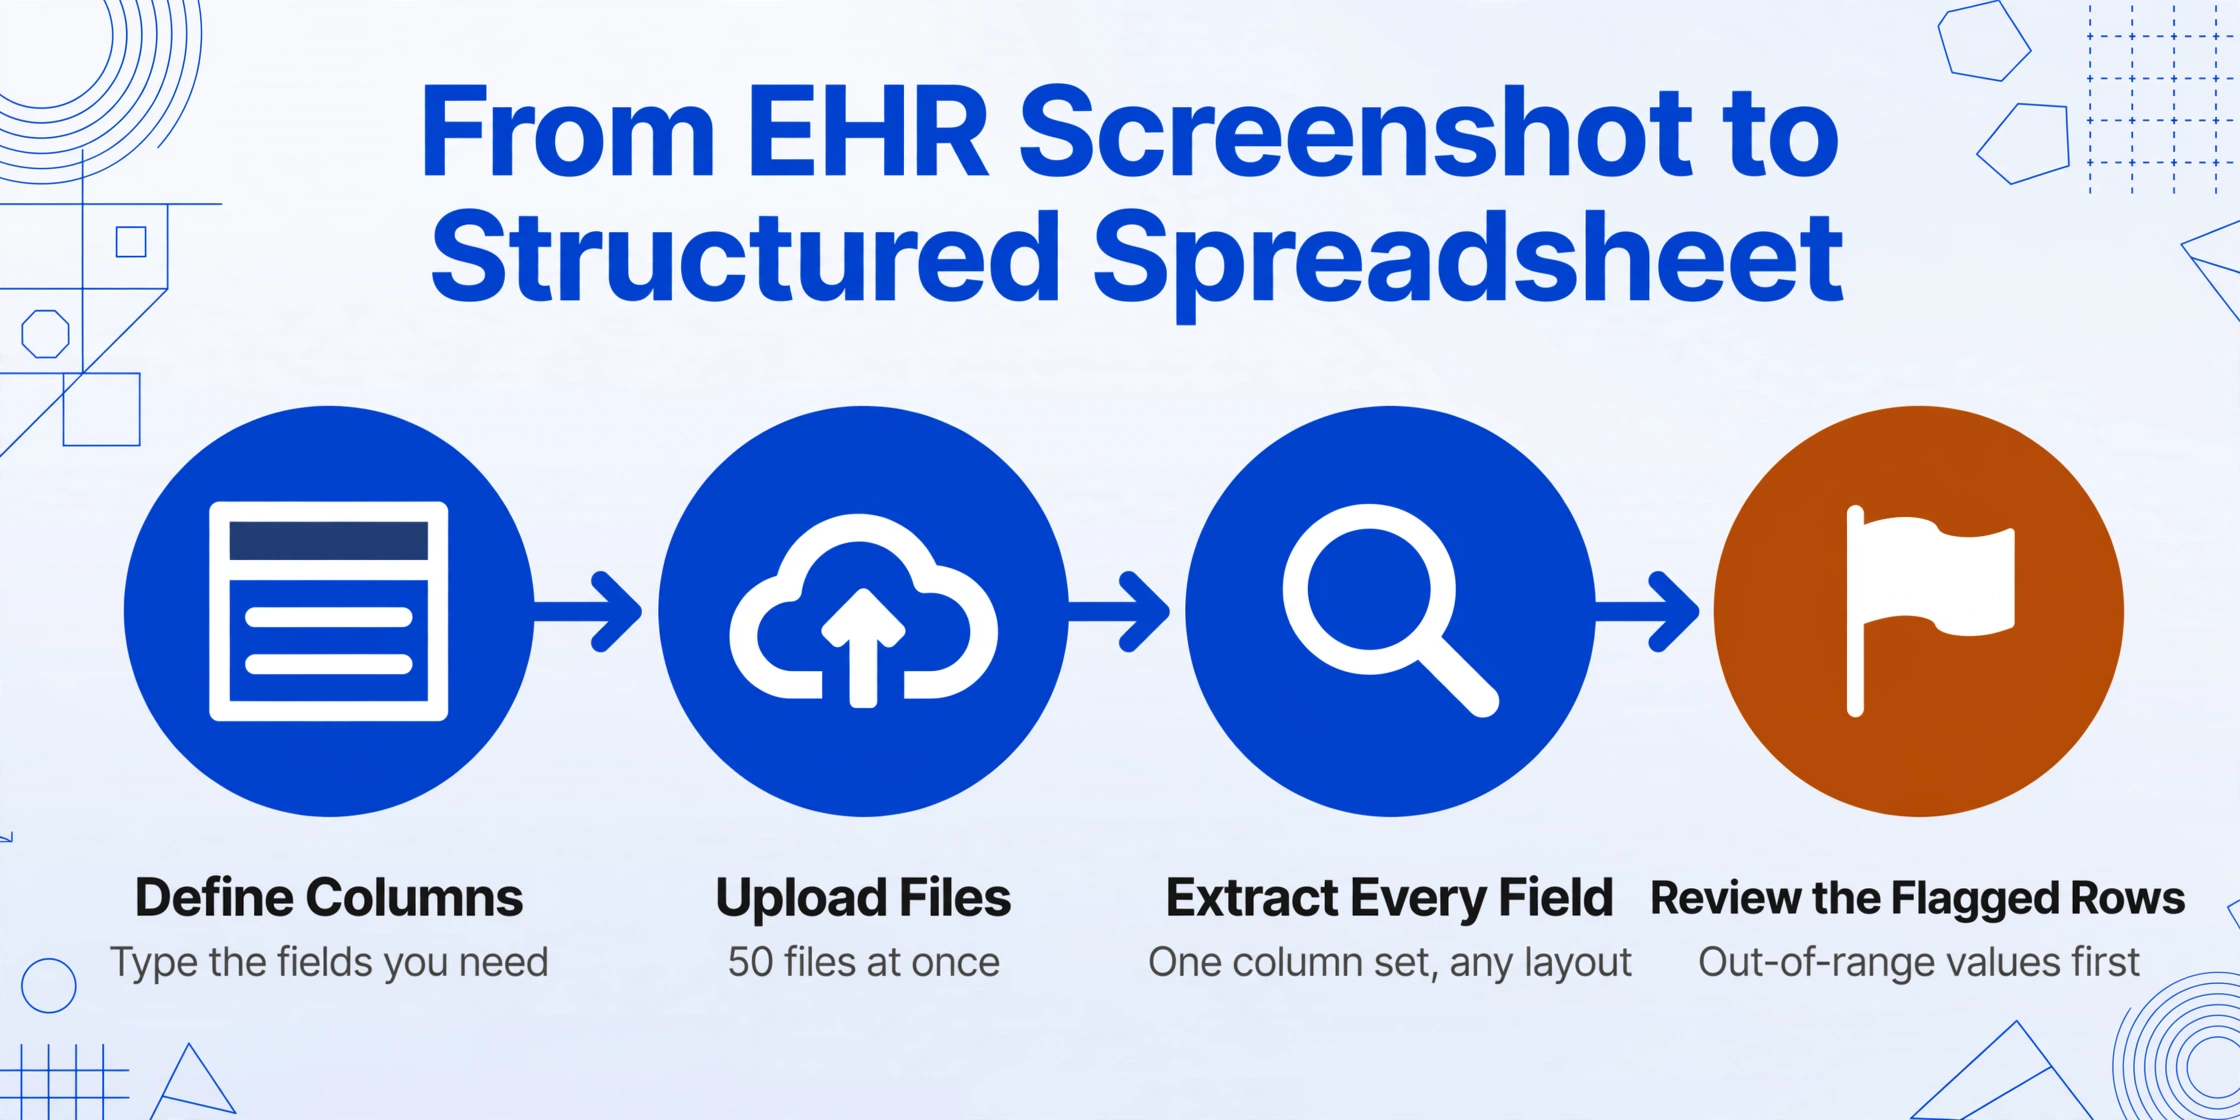
Veja como o fluxo de extração funciona de ponta a ponta, usando um cenário real de abstração de dados clínicos: extrair variáveis-chave para um envio de registro de cardiologia a partir de capturas de tela do prontuário Epic.
Defina suas colunas
Digite os campos de dados necessários: "MRN do Paciente", "Data de Admissão", "Diagnóstico de Alta", "FEVE (%)", "Pico de Troponina", "Antiplaquetário na Alta". Você também pode incluir colunas inferidas — campos em que a IA faz um julgamento com base no conteúdo do documento. Por exemplo, "Categoria de FEVE (opções: Preservada/Levemente Reduzida/Reduzida)" instrui a IA a ler o valor da fração de ejeção, compará-lo com os limites clínicos e gerar a categoria apropriada — mesmo que "Categoria de FEVE" não esteja impressa explicitamente em nenhum lugar do prontuário.
Envie seus arquivos
Arraste capturas de tela, PDFs exportados, laudos de laboratório digitalizados — qualquer formato, qualquer fornecedor de EHR. Você pode enviar 50 arquivos de uma vez. A ferramenta aceita JPG, PNG, PDF e WebP, então uma mistura de PNGs de capturas de tela do Epic, PDFs exportados do Cerner e digitalizações de laudos de laboratório enviados por fax entram no mesmo lote.
A IA extrai todos os arquivos
A IA processa todos os arquivos em paralelo. Ela lê cada documento, localiza os valores que correspondem às suas definições de coluna e preenche a tabela de saída. Como a extração é semântica e não posicional, um valor de troponina exibido como "cTnI: 0,04 ng/mL" na tela do Epic de um hospital e "Troponina I de Alta Sensibilidade — 12 ng/L" no relatório do Cerner de outro hospital são mapeados para a mesma coluna "Pico de Troponina". A IA reconhece ambos como resultados de troponina, apesar dos diferentes tipos de ensaio, unidades e formatos de rótulo.
Revise e exporte
A saída é uma planilha com uma linha por paciente e suas colunas especificadas como cabeçalhos. Revise para verificar a integridade — confira valores discrepantes, verifique se todos os relatórios de várias páginas foram processados — e depois exporte para Excel, CSV ou JSON. Se você usa o Google Sheets, o complemento grava os resultados diretamente na sua planilha ativa, sem precisar baixar e reenviar.
Os arquivos são processados com segurança e não são armazenados.
Quando a Extração Sozinha Não Basta: Verificações de Qualidade e Casos Extremos
A extração de dados clínicos tem implicações maiores do que o processamento de faturas. Uma vírgula deslocada em uma fatura significa uma correção de cobrança. Uma vírgula deslocada em um valor de laboratório significa uma marca de qualidade nos dados do registro — ou pior, um desfecho clínico classificado incorretamente. Estes são os casos extremos que importam e como lidar com eles.
Valores Fora da Faixa e Incompatibilidade de Unidades
Um valor de creatinina de "15,2 mg/dL" é clinicamente alarmante. Uma creatinina de "1,2 mg/dL" é rotineira. Se a vírgula se deslocar durante a extração, o erro se propaga para todas as análises posteriores. A salvaguarda não está na etapa de extração — está na etapa de revisão. Após a extração por IA, examine a coluna de saída em busca de valores fora da faixa fisiologicamente plausível para a população de pacientes. Ferramentas modernas de extração podem sinalizar valores atípicos automaticamente, comparando os valores extraídos com faixas de referência configuráveis. Isso não substitui a revisão humana, mas direciona a atenção do revisor para as linhas com maior probabilidade de conter erros — um fluxo de trabalho dramaticamente mais eficiente do que revisar todas as linhas igualmente.
Medicamentos Duplicados e Artefatos de Reconciliação
A lista de medicamentos de um paciente na tela de um EHR pode incluir tanto uma prescrição ativa para "Metformina 500 mg BID" quanto uma ordem descontinuada para "Metformina 1000 mg diariamente" — ambas visíveis na mesma visualização do histórico de medicamentos. Uma extração ingênua que captura todas as entradas de medicamentos capturará ambas, criando um falso duplicado. A solução é configurar a extração para capturar o status do medicamento como uma coluna separada (Ativo/Descontinuado/Concluído), permitindo que o abstrator filtre durante a revisão. É aqui que as colunas inferidas se tornam valiosas: uma coluna definida como "Apenas Medicamentos Ativos (sim/não)" instrui a IA a avaliar o contexto de status de cada entrada de medicamento e gerar apenas aqueles atualmente ativos.
Relatórios Multipáginas e Páginas de Continuação
Um relatório de laboratório de 4 páginas onde os resultados do hemograma começam na página 2 e continuam na página 3 apresenta um desafio de continuidade. A ferramenta de extração entende que a página 3 é uma continuação, e não um novo relatório? Modelos de extração semântica que processam documentos de forma holística — lendo todas as páginas como um único documento clínico contínuo — lidam com isso naturalmente. O modelo reconhece que o "Leucócitos: 7,2" da página 3 pertence ao mesmo painel de hemograma que começou na página 2, e não a um relatório separado. Ao enviar PDFs com várias páginas, certifique-se de que todas as páginas estejam incluídas em um único arquivo, em vez de divididas em envios separados, para que a IA possa manter esse contexto de continuidade.
Anotações Manuscritas e Marginalias
Clínicos anotam. Um relatório de laboratório impresso com "repetir em 2 semanas" escrito à mão na margem. Uma lista de medicamentos com uma dose circulada e "descontinuado — causando desconforto GI" rabiscado ao lado. Essas anotações contêm informações clinicamente significativas que um mecanismo de OCR padrão perderá ou interpretará erroneamente. Modelos de IA baseados em visão que processam o documento como uma imagem — não apenas como texto extraído — podem ler a caligrafia junto com o texto impresso, capturando tanto os dados estruturados quanto o contexto clínico não estruturado em uma única passagem. Se uma anotação manuscrita modificar o status de um medicamento, uma coluna inferida como "Status do Medicamento (Ativo/Descontinuado/Modificado)" pode apresentar essa anotação como um sinalizador estruturado para o revisor.
HIPAA, Segurança e o que "Conformidade" Realmente Significa
Qualquer ferramenta que processe dados clínicos deve lidar com a HIPAA. Mas a conformidade com a HIPAA não é um selo de certificação — é um estado operacional definido pelos requisitos da Regra de Segurança da HIPAA para salvaguardas administrativas, físicas e técnicas (45 CFR Parte 160 e Subpartes A e C da Parte 164). Nenhuma agência governamental emite um selo "Certificado HIPAA". O que importa é se as práticas de tratamento de dados da ferramenta atendem às três categorias de salvaguarda da Regra de Segurança.
Para extração de dados clínicos, as salvaguardas técnicas relevantes são: criptografia em trânsito (todos os dados transmitidos via HTTPS), criptografia em repouso, controles de acesso que restrinjam quem pode visualizar ou processar dados de pacientes, e uma política clara sobre retenção e exclusão de dados. Uma ferramenta que processa arquivos de forma efêmera — extraindo dados sem armazenar os documentos de origem após o processamento — remove uma categoria significativa de risco, pois não há um repositório persistente de PHI a ser violado.
Para organizações que exigem um Acordo de Associado de Negócios (BAA) — que é a maioria das entidades cobertas pela HIPAA — a principal pergunta a fazer a qualquer fornecedor de ferramenta de extração é se eles assinarão um. Um BAA é um contrato que estende as obrigações da HIPAA ao fornecedor como associado de negócios. Sem um BAA assinado, uma entidade coberta não pode compartilhar legalmente PHI com esse fornecedor para processamento. Isso não é um recurso técnico; é um requisito contratual. Verifique antes de enviar qualquer dado de paciente.
Na prática, o modelo de segurança para extração de dados clínicos com IA deve ser: o usuário controla quais dados entram no sistema, o sistema os processa sem reter os arquivos de origem, e o usuário controla para onde a saída vai. Sem armazenamento persistente de PHI. Sem treinamento em dados do usuário. Sem compartilhamento com terceiros. Estas são as práticas operacionais, não alegações de marketing, que distinguem um fluxo de trabalho compatível com HIPAA de uma ferramenta genérica de upload de arquivos.
Quando a Extração Semântica se Destaca — e Quando Precisa de um Humano
A extração semântica por IA lida bem com a maioria dos cenários de abstração de dados clínicos, mas há situações específicas em que o julgamento humano continua essencial. Ser honesto sobre esses limites é melhor do que prometer uma experiência sem atritos que não existe.
Onde se destaca: Dados clínicos estruturados ou semiestruturados em uma única tela ou relatório — tabelas de sinais vitais, listas de medicamentos, painéis laboratoriais, listas de problemas, registros de imunização, reconciliações medicamentosas de alta. Esses tipos de dados têm semântica clínica previsível, mesmo quando sua apresentação visual varia. A IA pode capturá-los com alta precisão em diferentes sistemas de prontuário e formatos de relatório, pois os conceitos clínicos subjacentes (pressão arterial, hemoglobina A1c, dose de medicamento) são universais.
Onde um humano deve verificar: Notas clínicas narrativas com dados embutidos — um relatório de evolução que menciona um valor laboratorial de passagem ("K estava 3,1 esta manhã, então repusemos") sem uma entrada formal de resultado de exame. A IA pode extrair "3,1" como um valor de potássio, mas pode não capturar o contexto clínico de que foi uma verificação à beira do leito, não uma coleta laboratorial formal, e o valor pode não pertencer ao campo "Potássio Soro" do registro. Da mesma forma, documentos digitalizados com muitos artefatos — registros enviados por fax várias vezes, criando texto fantasma e desalinhamento — podem produzir resultados degradados. Nesses casos, a extração por IA deve ser tratada como um rascunho inicial que um revisor humano confirma, em vez de uma resposta final.
Um estudo de referência de 2024 sobre ferramentas de extração de informações baseadas em LLM para documentos médicos (publicado no medRxiv) constatou que os modelos modernos de IA "oferecem um avanço significativo em relação aos métodos baseados em regras" para tarefas de IE clínica, mas observou que o desempenho varia conforme o tipo de documento e a complexidade da extração. A lição para os profissionais: use a extração por IA como um multiplicador de produtividade que lida com os 80% de dados diretos, liberando o abstraidor humano para concentrar o esforço de verificação nos 20% que exigem julgamento clínico.
Comparação com Outras Abordagens
O cenário de opções para extração de dados clínicos varia do totalmente manual ao totalmente automatizado. Veja como elas se comparam na prática, e não no discurso de marketing.
| Abordagem | Configuração Necessária | Lida com Variação de Formato | Funciona sem Acesso de TI | Melhor Para |
|---|---|---|---|---|
| Abstração manual | Nenhuma | Sim (humano se adapta) | Sim | Volume muito baixo, alta complexidade clínica |
| API FHIR/HL7 | Integração de TI + credenciais | N/A (dados estruturados) | Não | Dados estruturados de alto volume em um ecossistema de prontuário |
| OCR por modelo | Um modelo por formato | Não — falha com mudança de layout | Sim | Documentos de alto volume e formato único |
| Pipeline de PLN | Construção técnica + dados de treinamento | Parcial | Não | Implantação empresarial em instituição única |
| Extração por IA Semântica | Digitar nomes das colunas | Sim — independente de layout | Sim | Abstração de dados clínicos de múltiplos formatos e fontes |
A escolha certa depende do volume, da diversidade de formatos e do acesso organizacional a recursos técnicos. Para o coordenador de pesquisa clínica que abstrai 200 prontuários de uma mistura de capturas de tela do Epic, PDFs de laboratórios externos e registros enviados por fax — sem credenciais de banco de dados, sem acesso a API e sem equipe de engenharia de PLN — a extração por IA semântica é a única opção na lista que não exige construção de modelos ou integração de TI. Não é a única abordagem válida, mas é a única que corresponde às restrições do mundo real da maioria dos trabalhos de abstração de dados clínicos.
Perguntas Frequentes
A extração por IA funciona com capturas de tela de qualquer sistema EHR?
Sim, porque a extração se baseia em entender o que os dados significam, e não em corresponder a um layout de tela específico. Uma leitura de pressão arterial em um fluxograma Epic, uma tabela de sinais vitais Cerner e um resumo de paciente Meditech são todos reconhecidos como pressão arterial — independentemente da fonte, posição ou formato do rótulo. A IA processa a captura de tela como uma imagem e a lê como um clínico humano faria, interpretando o conteúdo semanticamente. Dito isso, telas extremamente poluídas com dados densos e sobrepostos — várias tabelas empilhadas verticalmente, pop-ups ou visualizações divididas com fontes pequenas — podem reduzir a precisão e exigir verificação pontual.
Consegue extrair dados de anotações clínicas manuscritas?
Sim, com ressalvas. Modelos de IA baseados em visão podem ler texto manuscrito junto com texto impresso no mesmo documento. Caligrafia clara e estruturada — anotações de medicamentos, notações de sinais vitais em um fluxograma de papel — é extraída de forma confiável. Caligrafia muito cursiva, apressada e com abreviações não padronizadas terá menor precisão. Para conteúdo manuscrito, trate a extração por IA como um primeiro rascunho que precisa de verificação humana, não como um registro final e autoritativo.
Como isso lida com os requisitos de PHI e HIPAA?
A conformidade com a HIPAA é um estado operacional, não uma certificação. Os fatores relevantes para qualquer ferramenta de extração são: (1) se os dados são criptografados em trânsito (HTTPS) e em repouso, (2) se os arquivos são processados de forma efêmera — extraídos e depois descartados sem armazenamento persistente de PHI, (3) se o fornecedor assinará um Acordo de Parceiro de Negócios (BAA) se sua organização exigir um, e (4) se o acesso aos dados processados é restrito apenas a usuários autorizados. Verifique esses detalhes com a ferramenta específica que você está avaliando antes de fazer upload de dados de pacientes. Nenhuma ferramenta de extração deve alegar "certificação" HIPAA — porque essa certificação não existe. O que importa são as salvaguardas operacionais.
Qual é a precisão em relatórios de laboratório PDF com várias páginas?
Para texto impresso em digitalizações limpas, a precisão pode chegar a 99% para campos claramente definidos. Relatórios com várias páginas funcionam melhor quando enviados como um único PDF, para que a IA possa manter a continuidade entre as páginas — reconhecendo que o resultado de leucócitos da página 3 pertence ao mesmo hemograma que começou na página 2. A precisão diminui com digitalizações com muitos artefatos (fantasmas de fax de múltiplas gerações), inclinação extrema ou tamanhos de fonte muito pequenos. Para submissões críticas a registros, verifique uma amostra dos resultados extraídos em relação aos documentos de origem antes do processamento em massa.
Posso processar centenas de prontuários de pacientes de uma só vez?
Sim. O processamento em lote foi projetado exatamente para este cenário: faça upload de todos os arquivos de uma vez, defina os cabeçalhos das colunas uma vez e receba uma única planilha mesclada com uma linha por paciente. O tempo de processamento escala com o número de arquivos, não linearmente — vários arquivos são processados em paralelo. Um lote de 100 capturas de tela normalmente é concluído em menos de um minuto. Para volumes maiores (500+ arquivos), divida em vários lotes para evitar limites de tempo limite e facilitar a revisão incremental.
E se eu precisar extrair dados que não estão escritos explicitamente na tela?
É para isso que servem as colunas inferidas. Uma coluna inferida instrui a IA a fazer um julgamento com base no conteúdo do documento, não apenas transcrever um valor visível. Por exemplo, "Categoria de FEVE (opções: ≥50% Preservada / 40-49% Levemente Reduzida / <40% Reduzida)" lê a porcentagem de fração de ejeção do documento, compara com os limites clínicos e gera a categoria apropriada — mesmo que "Categoria de FEVE" nunca esteja escrita no prontuário. Da mesma forma, "Status de Reconciliação Medicamentosa (Completa/Incompleta)" pode avaliar se os medicamentos de alta correspondem aos de admissão e sinalizar discrepâncias. Colunas inferidas transformam a extração de simples transcrição em geração estruturada de dados clínicos.
Isso substitui os abstraidores de dados clínicos?
Não — é uma ferramenta que muda como os abstraidores gastam seu tempo. Em vez de dedicar 50% das horas à entrada manual de dados (descoberta da Carta Healthcare em 2024), os abstraidores podem migrar para verificação, julgamento clínico e investigação de anomalias. A IA cuida da transcrição mecânica; o humano cuida do raciocínio clínico. Não se trata de substituir abstraidores. Trata-se de eliminar a parte do trabalho para a qual nenhum clínico estudou — ler valores de uma tela e digitá-los em outra.
A abstração de dados clínicos esperava por uma ferramenta que lesse telas como um humano — entendendo o que os dados significam, não onde estão. A extração semântica por IA não substitui o julgamento clínico do abstracionista. Ela substitui o copiar-colar.
Se você extrai dados clínicos de capturas de tela de prontuários eletrônicos hoje — para um registro, um estudo de pesquisa, um projeto de melhoria de qualidade ou uma auditoria — o primeiro passo é testar a abordagem em um pequeno lote de seus próprios arquivos. Escolha 10 prontuários de pacientes. Defina suas colunas. Execute a extração. Compare o resultado com sua abstração manual. Se a IA capturar 90%+ dos pontos de dados corretamente, você acabou de recuperar a maior parte do tempo que gasta atualmente transcrevendo. Os 10% restantes são onde sua expertise clínica pertence.