So extrahieren Sie klinische Daten aus
EHR-Screenshots – Semantische Abstraktion ohne Vorlagen
Ein klinischer Datenabstraktor in einem mittelgroßen Gesundheitssystem öffnet Epic, navigiert zur Patientenakte und beginnt mit der Überprüfung. Vitalwerte. Medikamente. Laborpanels. Problemliste. Jeder Datenpunkt steht auf dem Bildschirm – vollständig digital, vollständig lesbar – aber um ihn in das Register-Einreichungstool, die Schlaganfall-Registerdatenbank oder die Qualitätskennzahlen-Tabelle zu übertragen, muss er ihn lesen und neu abtippen. Feld für Feld. Patient für Patient. Er ist damit nicht allein. Eine Carta-Healthcare-Umfrage unter klinischen Datenabstraktoren aus dem Jahr 2024 ergab, dass mehr als die Hälfte der Befragten den Großteil ihrer Arbeitszeit mit manueller Dateneingabe und -extraktion verbringt, wobei 70% angaben, dass sie Fehler oder Diskrepanzen aus der manuellen Abstraktion feststellen – 20% sagten, dies geschehe „sehr häufig“. Die Ironie ist offensichtlich: Die Daten sind bereits digital und in einer relationalen Datenbank innerhalb der EHR gespeichert, aber sobald sie als Screenshot, gedruckter Bericht oder exportierte PDF erscheinen, werden sie wieder unstrukturiert. Sie werden zu etwas, das eine Person transkribieren muss.
Das Screenshot-Paradoxon: Warum digitale Aufzeichnungen nicht gleich extrahierbare Daten bedeuten
Elektronische Patientenakten sollten das Problem der Datenportabilität lösen. Stattdessen haben sie ein neues geschaffen: den Screenshot als De-facto-Standard für den klinischen Datenaustausch.
Das ist keine Übertreibung. Auf Reddits r/healthIT beschrieb ein Krankenhaus-Abrechner den Arbeitsalltag in klinischen Daten-Workflows: "Der Datenaustausch zwischen Systemen ist extrem umständlich und erfolgt meist durch Kopieren und Einfügen jedes einzelnen Feldes in das andere System." Ein Thread zur klinischen Forschung auf r/clinicalresearch fragte, warum die Dateneingabe von EMR zu EDC immer noch manuell und mühsam ist. Die Top-Antwort: "Individuelle Datenschutz- und Sicherheitsbedenken der Krankenhäuser. Jeder Standort ist anders, und fast alle haben extremes Misstrauen gegenüber PHI."
Die Ursache ist struktureller Natur. EHR-Systeme – Epic, Cerner (jetzt Oracle Health), Meditech – speichern Daten in proprietären relationalen Datenbanken, die für die Transaktionsverarbeitung ausgelegt sind, nicht für die Extraktion. Epic verwendet eine Berichtsdatenbank namens Clarity, die klinische Daten aus dem Chronicles-Transaktionssystem spiegelt. Cerner setzt auf Millennium, das Aufzeichnungen über Hunderte von Tabellen mit anbieterspezifischen Schemata organisiert. Der direkte Datenbankzugriff erfordert SQL-Kenntnisse, die die meisten klinischen Teams nicht haben – und die meisten Gesundheitssysteme gewähren ihn nicht.
Dies erzeugt das Screenshot-Paradoxon: Die Daten sind digital im EHR, aber der einzige Weg, sie in ein anderes System zu übertragen – ein klinisches Register, eine Forschungsdatenbank, eine Qualitätsberichts-Tabelle – führt über einen Bildschirm. Jemand meldet sich an, navigiert zum richtigen Patienten, zum richtigen Fall, zum richtigen Tab und liest die benötigten Werte ab. Dann tippt er sie woanders ein. Das ist klinische Datenextraktion in der Praxis: der systematische Prozess des Extrahierens, Überprüfens und Validierens von Schlüsselinformationen aus Patientenakten. Und trotz des Wortes "systematisch" ist sie überwiegend manuell. Eine im Journal of AHIMA veröffentlichte Studie ergab, dass 58 % der Gesundheitsorganisationen die manuelle Extraktion als primäre Methode verwenden, während nur 18 % natürliche Sprachverarbeitung und 12 % einfache Datenbankabfragen nutzen (PMC-Studie, 2021).
Was klinische Daten schwieriger zu extrahieren macht als ein Standardformular
Eine Standardrechnung hat etwa ein Dutzend Felder – Datum, Betrag, Lieferantenname, Positionen – und deren Bedeutung ist formatübergreifend eindeutig. Ein klinischer Datensatz ist anders. Derselbe Datentyp erscheint in völlig unterschiedlichen Darstellungen, je nach EHR-Modul, Berichtslayout und sogar je nachdem, welches Krankenhaus innerhalb desselben Gesundheitssystems ihn erstellt hat. Hier sind die vier Datenkategorien, die herkömmliche Extraktionsansätze scheitern lassen, und warum.
Vitalzeichen: Mehr als nur Zahlen
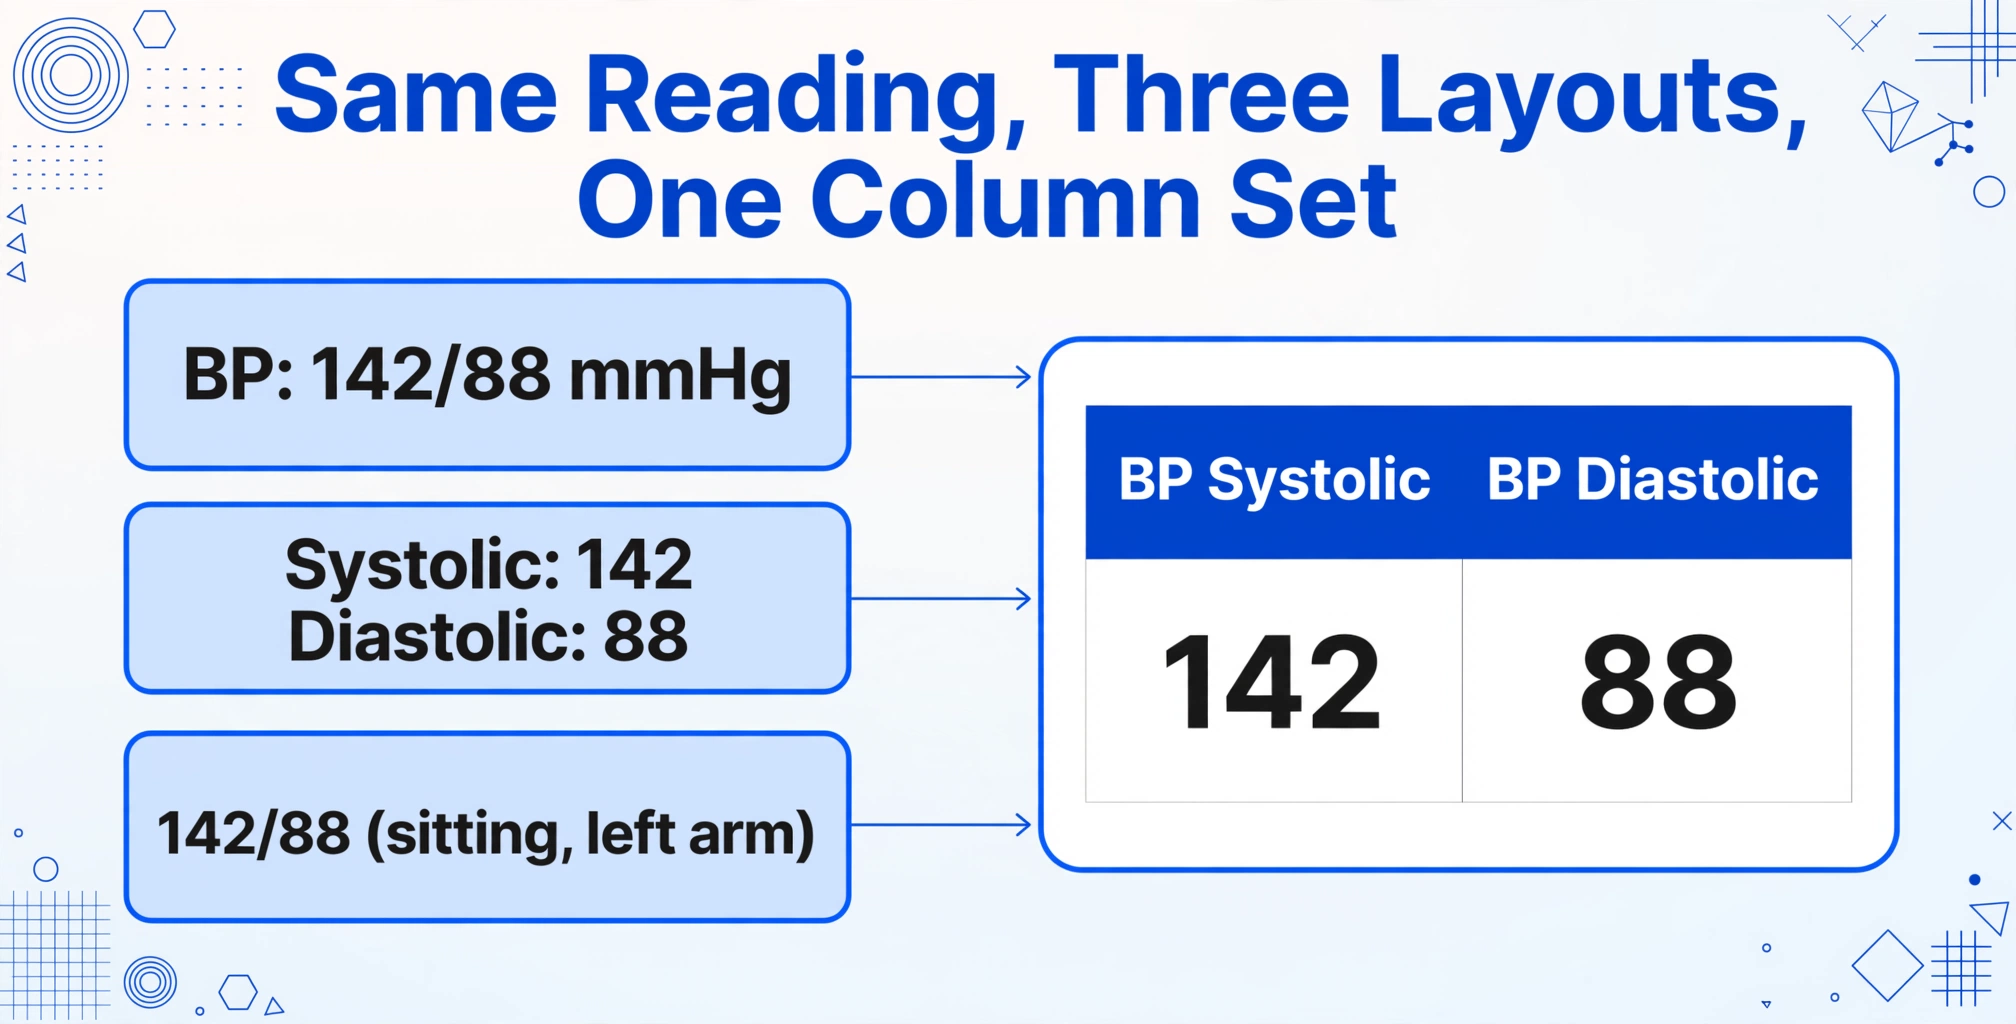
Ein Blutdruckwert von „142/88“ kann auf einem Bildschirm als BP: 142/88 mmHg erscheinen, auf einem anderen als zweizeilige Tabelle mit „Systolisch: 142“ und „Diastolisch: 88“ und auf einem dritten als „142/88 (sitzend, linker Arm)“ mit zusätzlichem Positionskontext. Ein Template-basiertes Extraktionstool – eines, das nach Werten an festen Pixelkoordinaten sucht oder gegen ein bekanntes Labelformat abgleicht – scheitert bereits bei der ersten Variante. Es benötigt ein separates Template für jedes Layout. Ein Semantisches Extraktionsmodell erkennt dagegen, dass „142/88“, „Systolisch 142 / Diastolisch 88“ und „BP 142/88“ dasselbe klinische Konzept beschreiben, unabhängig vom Format, weil es nach Bedeutung statt nach Position liest.
Vitalzeichen enthalten auch Referenzbereiche, die je nach Patientenalter, Geschlecht und klinischem Kontext variieren. Eine Herzfrequenz von 110 bpm ist für ein Neugeborenes normal und für einen ruhenden Erwachsenen besorgniserregend. Das Extraktionstool muss dieses klinische Urteil nicht fällen – das tut der Abstraktor –, aber es muss den Wert zusammen mit seiner Einheit und dem Zeitstempel der Aufzeichnung genau bewahren, damit der Abstraktor vollständige Informationen für die nachgelagerte Prüfung hat.
Derselbe Wert taucht auch außerhalb der EHR auf: Ein Pflegehelfer im häuslichen Bereich dokumentiert einen Besuch, fotografiert das Display des Blutdruckmessgeräts, Glukosemessgeräts oder Pulsoximeters und tippt später jede Zahl in das Pflegeprotokoll. Dieses Foto der Vitalzeichen eines Pflegehelfers im häuslichen Bereich ist dasselbe Extraktionsproblem – eine Zeile pro Besuch mit Systolisch, Diastolisch, Puls und SpO2 als Spalten.
Medikationslisten: Mehrfeld-Parsing in Freitext
Medikationsdaten auf einem EHR-Bildschirm sind selten eine saubere Tabelle. Sie können als kontinuierlicher Medikamentenverabreichungsdatensatz (MAR) mit Spalten für Medikamentenname, Dosis, Verabreichungsweg, Häufigkeit und letzte Verabreichungszeit erscheinen – oder als narrative Medikationsabstimmungsnotiz: „Metformin 1000 mg PO BID, Lisinopril 20 mg PO täglich, Atorvastatin 40 mg PO QHS.“ Das erste Format ist eine Tabelle. Das zweite ist ein Satz. Ein Template-basiertes OCR-Tool könnte den Text aus beiden erfassen, aber es wird „Metformin 1000 mg PO BID“ nicht ohne handgeschriebene Regeln für jede mögliche Medikamentennamensabkürzung in die strukturierten Felder [Medikament: Metformin, Dosis: 1000 mg, Verabreichungsweg: Oral, Häufigkeit: Zweimal täglich] parsen. Ein Semantic-AI-Ansatz liest den Satz und versteht die Beziehung zwischen jedem Medikamentennamen und seiner zugehörigen Dosis, Verabreichungsweg und Häufigkeit – so wie ein Apotheker eine Medikamentenliste überfliegen und mental organisieren würde.
Laborpanels: Ein Wert, viele Bezeichnungen
Ein Serumglukoseergebnis kann als „Glucose: 102 mg/dL“ in einem Quest Diagnostics-Bericht, als „GLU 102“ in einem Cerner-Labordatenblatt und als „Glucose, Serum — 102 mg/dL (Ref: 70-99)“ auf einem Epic Results Review-Bildschirm erscheinen. Alle drei repräsentieren dieselbe klinische Beobachtung: eine Nüchternglukose von 102. Ein Template-basierter Ansatz muss für jede Bezeichnungsvariante einzeln trainiert werden. Ein semantisches Modell erkennt, dass „Glucose“, „GLU“ und „Glucose, Serum“ drei Bezeichnungen für denselben Analyten sind – weil es klinische Terminologie versteht, nicht nur Textzeichenfolgen.
Dieser Unterschied ist in der Praxis enorm wichtig. Ein klinischer Forschungskoordinator, der Laborwerte für 200 Patienten aus einer Mischung aus externen Labor-PDFs, internen EHR-Screenshots und gefaxten Ergebnissen extrahiert, kann nicht 200 Extraktionsvorlagen erstellen. Er benötigt einen einzigen Extraktionsdurchlauf, der über alle Formate hinweg funktioniert. Semantische Extraktion – die Werte danach identifiziert, was sie bedeuten, nicht wo sie stehen – ist der Mechanismus, der dies ermöglicht.
Problemlisten: Codes und Beschreibungen nebeneinander
Ein Eintrag in der Problemliste in Epic könnte lauten: „E11.9 – Typ-2-Diabetes mellitus ohne Komplikationen.“ Der ICD-10-Code „E11.9“ steht neben seiner Textbeschreibung. Einige Berichte zeigen nur den Code an; einige zeigen nur die Beschreibung; einige zeigen beides. Ein naives Extraktionstool könnte „E11.9“ in ein Feld ziehen und die Beschreibung verwerfen, oder die Beschreibung ziehen und den Code verlieren. Der Abstraktor benötigt beides – den Code für die Registereinreichung und die Beschreibung für den klinischen Kontext. Ein Ansatz zur semantischen Extraktion, der die Beziehung zwischen einem Diagnosecode und seiner zugehörigen Textbeschreibung versteht, kann das Paar zuverlässig erfassen und so das vollständige klinische Bild bewahren.
Warum FHIR und HL7 das Screenshot-Problem nicht lösen
Die naheliegende Frage an dieser Stelle ist: Warum nicht eine API verwenden? FHIR (Fast Healthcare Interoperability Resources) ist der HL7-Standard, der genau dafür entwickelt wurde – strukturierter klinischer Datenaustausch zwischen Systemen. Epic unterstützt SMART on FHIR. Cerner bietet Ignite-APIs auf FHIR R4. Die Expanse-Plattform von Meditech stellt FHIR-R4-Endpunkte bereit. Warum kopieren und fügen Menschen also immer noch aus Screenshots ein?
Weil FHIR-APIs eine begrenzte Menge an Datenelementen und eine begrenzte Benutzergruppe abdecken. Die FHIR-APIs von Epic bedienen Patientendemografie, Termine, Allergien und einige klinische Dokumente – aber sie legen keine Qualitätskennzahlen, detaillierte Abrechnungsdaten oder die benutzerdefinierten Felder offen, die Praxen hinzufügen, um Überweisungen, Vorautorisierungen und registerspezifische Variablen zu verfolgen. Wie die Skyvern-Analyse der EHR-Automatisierung dokumentierte (März 2026), lassen selbst die besten FHIR-Implementierungen erhebliche Lücken bei dem, was programmatisch zugänglich ist.
Grundsätzlicher ist, dass der API-Zugriff eine IT-Infrastruktur erfordert, die die meisten klinischen Teams nicht kontrollieren. Eine Krankenschwester für Qualitätsverbesserung, die Daten für das CathPCI-Register des ACC abstrahiert, oder ein Schlaganfallkoordinator, der an Get With The Guidelines übermittelt, hat weder die Anmeldedaten, die API-Schlüssel noch den technischen Support, um FHIR-Integrationen aufzubauen. Sie haben Zugriff auf das EHR-Frontend. Sie können sich anmelden, Patientenakten einsehen und Screenshots machen. Das ist ihre Datenextraktions-Pipeline – und für einen großen Teil der klinischen Datenabstraktionsarbeit ist es die einzige verfügbare Pipeline.
Das Health Elements-Team, das KI-gesteuerte Abstraktionstools für kardiovaskuläre Register entwickelt, schätzt, dass ein mittelgroßes Gesundheitssystem 15 Millionen US-Dollar oder mehr pro Jahr für klinische Datenabstraktion über alle Leistungsbereiche hinweg ausgibt (Health Elements-Analyse). Dieselbe Analyse ergab, dass KI-gesteuerte Abstraktion die Abstraktionszeit um bis zu 90 % reduzieren und die gesamten Abstraktionskosten um 50 % oder mehr senken kann. Diese Einsparungen kommen nicht von besseren APIs – sie kommen von Tools, die das, was auf dem Bildschirm steht, so lesen können wie ein menschlicher Abstraktor, nur schneller und konsistenter.
Semantische Extraktion vs. Template-basierte OCR: Der Unterschied, der zählt
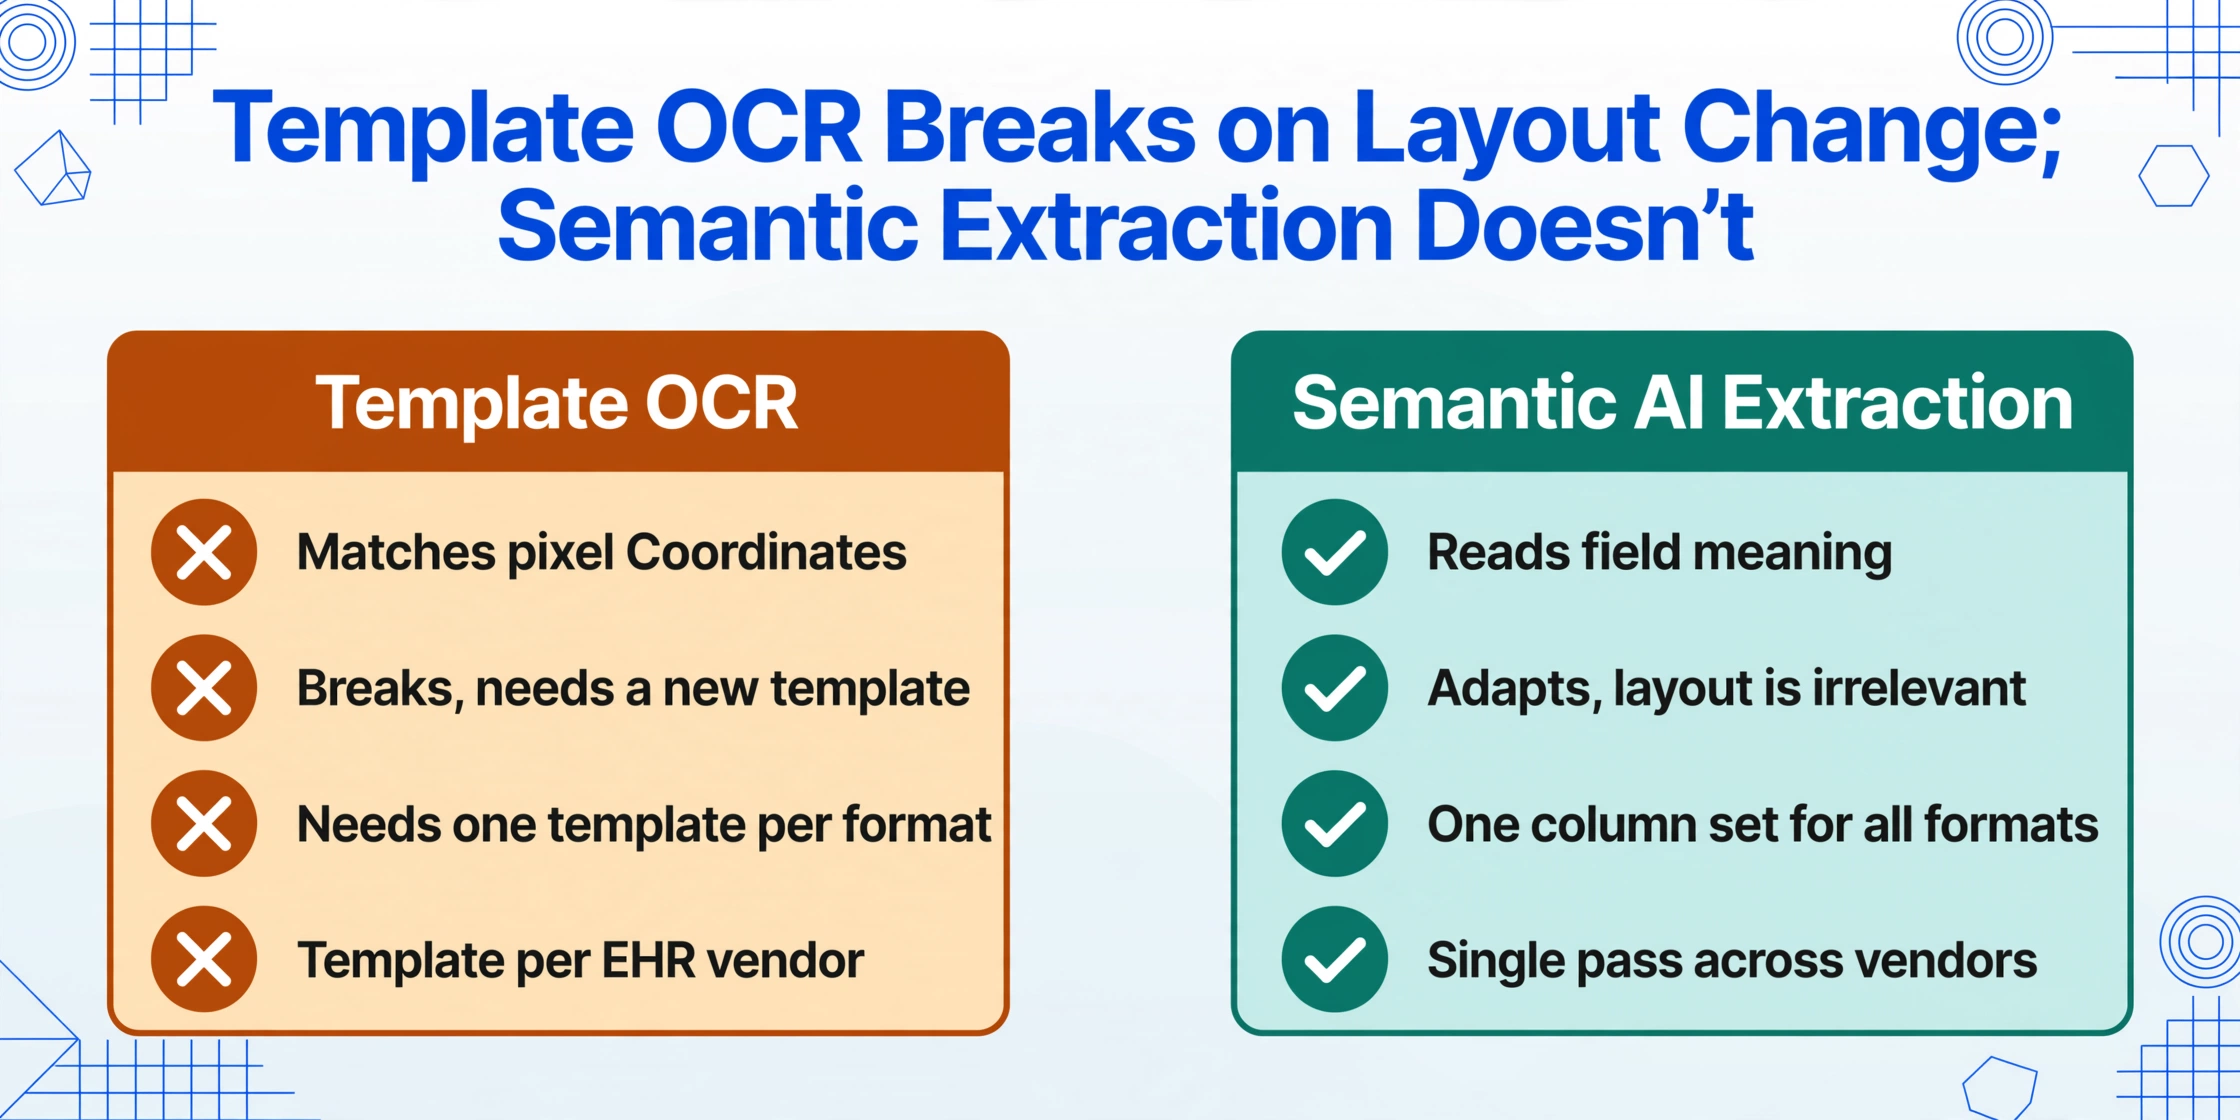
Nicht jede KI-Extraktion funktioniert gleich. Der entscheidende Unterschied für klinische Daten liegt zwischen positionsbasierter Extraktion (Template-OCR) und semantischer Extraktion (KI, die nach Bedeutung liest).
| Template-basierte OCR | Semantic AI Extraction | |
|---|---|---|
| So findet sie Daten | Gleicht Pixelkoordinaten oder Label-Muster ab | Versteht, was jedes Feld bedeutet |
| Was passiert, wenn sich das Layout ändert | Bricht ab – erfordert eine neue Vorlage | Passt sich automatisch an – Layout ist irrelevant |
| Einrichtung pro Berichtsformat | Eine Vorlage pro Format | Ein Satz Spaltennamen für alle Formate |
| Behandelt „Glucose“ als „GLU“ beschriftet | Nein – benötigt eine separate Regel | Ja – erkennt beides als denselben Analyten |
| Funktioniert mit Epic, Cerner, Meditech | Separate Vorlage pro EHR-Anbieter | Ein einziger Extraktionsdurchlauf funktioniert anbieterübergreifend |
Der Unterschied ist ein Paradigmenwechsel. Template-basierte OCR fragt: „Wo ist der Glukosewert auf dieser Seite?“ Semantic AI Extraction fragt: „Welcher Wert auf dieser Seite bedeutet Glukose?“ Ersteres ist ein Geometrieproblem. Zweiteres ist ein Leseverständnisproblem. Für klinische Daten – wo dieselbe Beobachtung unter einem Dutzend verschiedener Labels in verschiedenen EHRs, Laboranbietern und Berichtslayouts erscheinen kann – ist der Ansatz des Leseverständnisses derjenige, der skaliert.
Das bedeutet Custom Column Extraction in der Praxis: Statt Begrenzungsrahmen zu definieren oder ein Template auf einem bestimmten EHR-Bildschirmlayout zu trainieren, geben Sie die gewünschten Spaltenüberschriften ein – „Patienten-MRN“, „BD systolisch“, „BD diastolisch“, „Herzfrequenz“, „Hämoglobin A1c“, „LDL-Cholesterin“ – und die KI lokalisiert jeden Wert überall im Dokument, indem sie dessen klinische Bedeutung versteht. Sie definieren die Ausgabe. Die KI versteht die Eingabe.
Dieser Ansatz ermöglicht auch Batch Processing: das gleichzeitige Hochladen mehrerer Screenshots, PDFs oder gescannter Berichte und den Erhalt einer einzigen zusammengeführten Tabelle mit einer Zeile pro Patient und allen gefüllten Spalten. Für einen klinischen Forschungskoordinator, der Daten aus 200 Patientenakten abstrahiert – jede mit Screenshots aus verschiedenen EHR-Modulen, die zu unterschiedlichen Zeitpunkten aufgenommen wurden – verwandelt Batch Processing eine mehrwöchige manuelle Aufgabe in etwas, das in Minuten erledigt ist, wobei sich die Rolle des menschlichen Prüfers von der Dateneingabe zur Datenverifizierung verschiebt.
Papierbasierte Anmeldeformulare unterscheiden sich nicht grundsätzlich davon — ein Patientenaufnahmeformular in Excel-Lauf übernimmt die von Ihnen definierte Kopfzeilenliste und füllt sie aus den gescannten Seiten aus, sodass die Papierhälfte der Patientenakte in derselben Tabelle landet wie die Screenshots.
Ein praktischer Leitfaden: Vom EHR-Screenshot zur strukturierten Tabelle
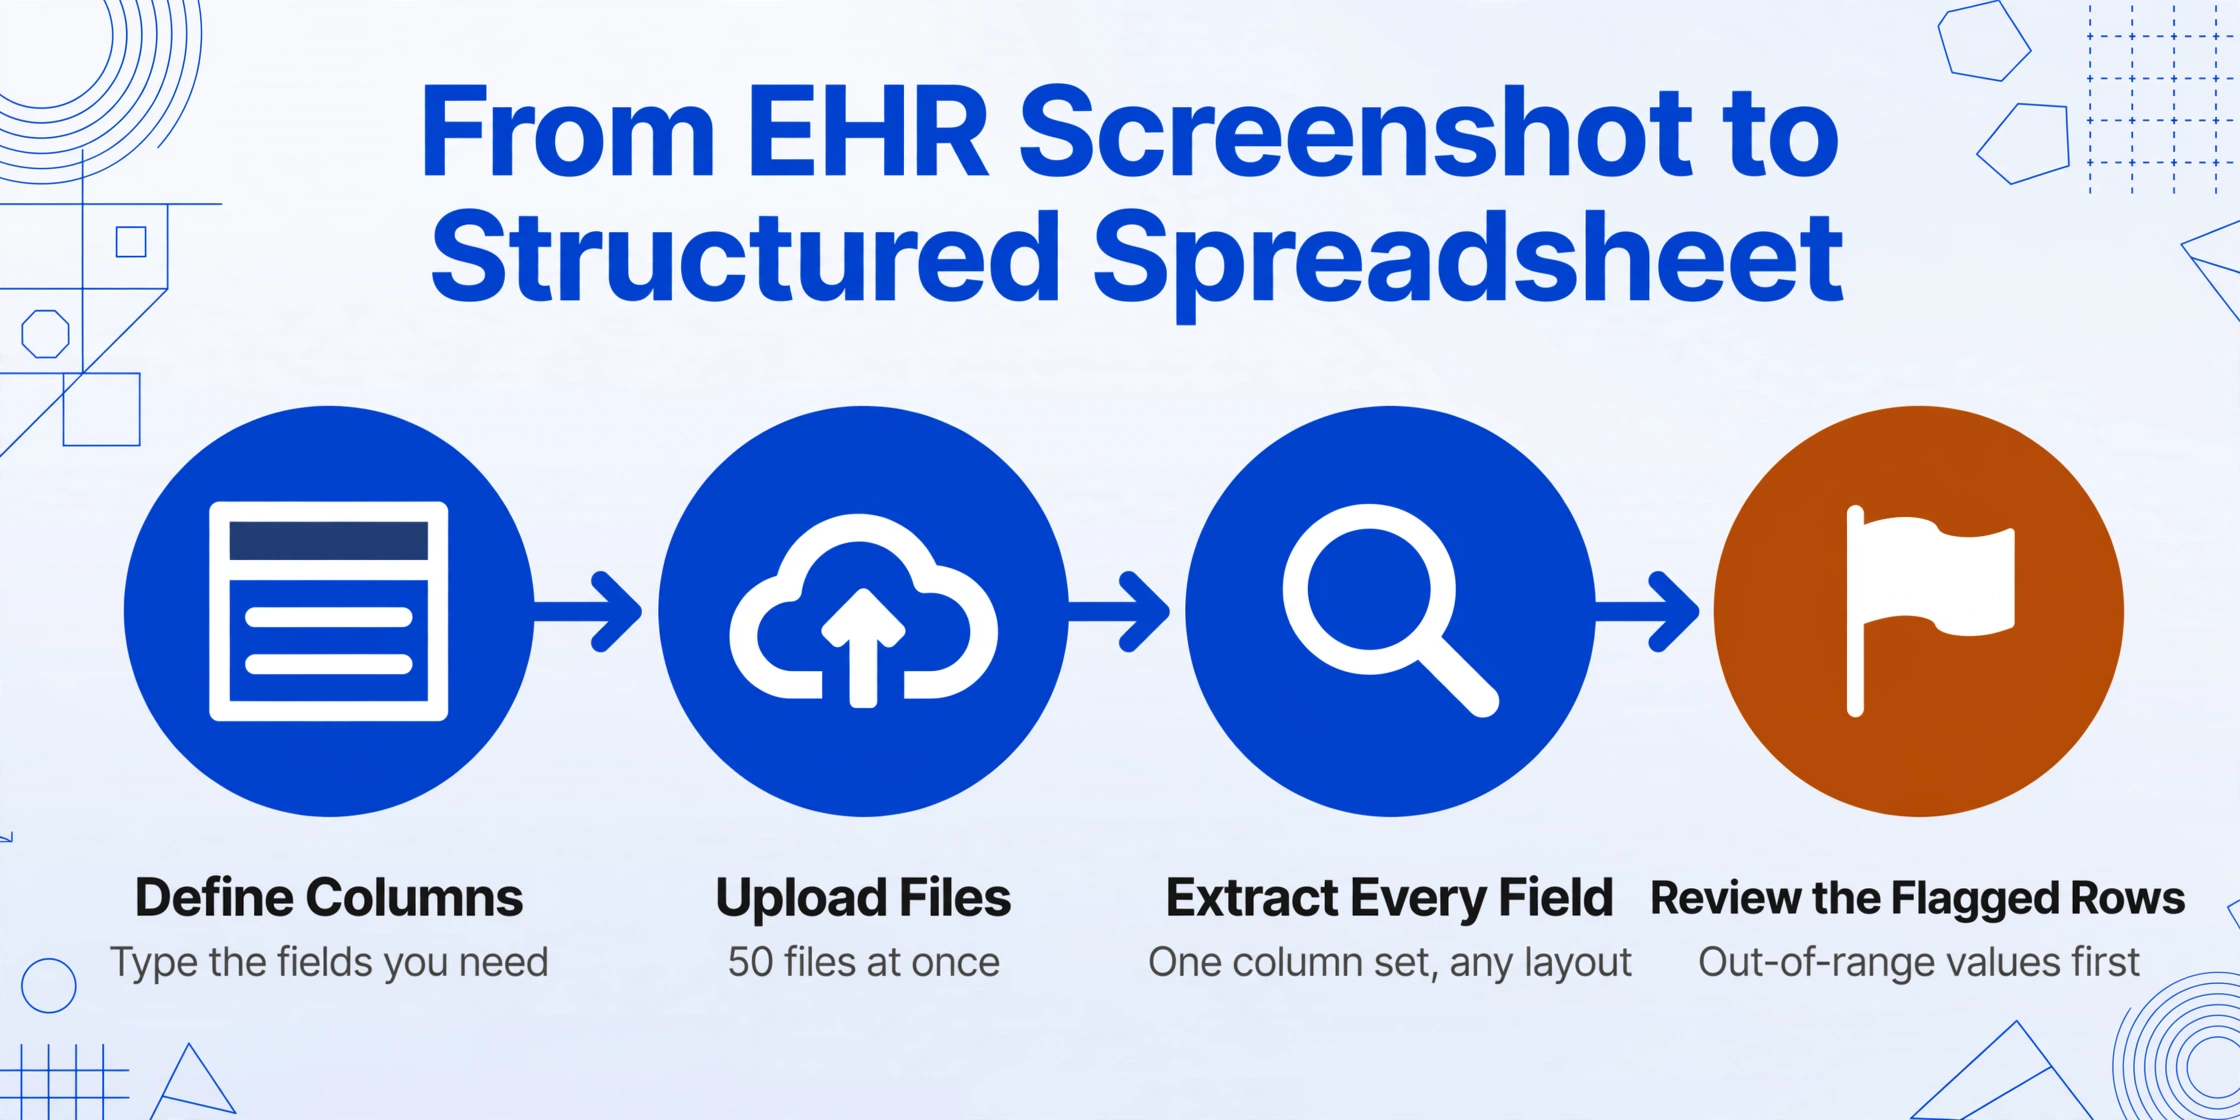
So sieht der Extraktionsworkflow von Anfang bis Ende aus, anhand eines realen Szenarios der klinischen Datenabstraktion: Extraktion von Schlüsselvariablen für eine kardiologische Registereinreichung aus Epic-Diagramm-Screenshots.
Definieren Sie Ihre Spalten
Geben Sie die benötigten Datenfelder ein: „Patienten-MRN", „Aufnahmedatum", „Entlassungsdiagnose", „LVEF (%)", „Troponin-Spitzenwert", „Thrombozytenaggregationshemmer bei Entlassung". Sie können auch abgeleitete Spalten einbeziehen — Felder, bei denen die KI eine Beurteilung basierend auf dem Dokumentinhalt vornimmt. Beispielsweise weist „LVEF-Kategorie (Optionen: Erhalten/Leicht reduziert/Reduziert)" die KI an, den Auswurfanteilswert zu lesen, ihn mit klinischen Schwellenwerten zu vergleichen und die entsprechende Kategorie auszugeben — obwohl „LVEF-Kategorie" nirgendwo explizit auf dem Diagramm gedruckt ist.
Laden Sie Ihre Dateien hoch
Ziehen Sie Screenshots, exportierte PDFs, gescannte Laborberichte hinein — jedes Format, jeder EHR-Anbieter. Sie können 50 Dateien gleichzeitig hochladen. Das Tool verarbeitet JPG, PNG, PDF und WebP, sodass eine Mischung aus Epic-Screenshot-PNGs, von Cerner exportierten PDFs und gefaxten Laborergebnisscans in denselben Batch gelangen.
KI extrahiert aus allen Dateien
Die KI verarbeitet alle Dateien parallel. Sie liest jedes Dokument, lokalisiert die Werte, die Ihren Spaltendefinitionen entsprechen, und füllt die Ausgabetabelle. Da die Extraktion semantisch und nicht positionsbasiert ist, werden ein Troponinwert, der auf dem Epic-Bildschirm eines Krankenhauses als „cTnI: 0,04 ng/ml" angezeigt wird, und „High-Sensitivity-Troponin-I — 12 ng/l" in einem Cerner-Bericht eines anderen Krankenhauses derselben Spalte „Troponin-Spitzenwert" zugeordnet. Die KI erkennt beide als Troponinergebnisse, trotz unterschiedlicher Assay-Typen, Einheiten und Labelformate.
Überprüfen und exportieren
Die Ausgabe ist eine Tabelle mit einer Zeile pro Patient und Ihren angegebenen Spalten als Kopfzeilen. Überprüfen Sie auf Vollständigkeit — stichprobenartig Ausreißerwerte prüfen, verifizieren, dass bei mehrseitigen Berichten alle Seiten verarbeitet wurden — und exportieren Sie dann nach Excel, CSV oder JSON. Wenn Sie Google Sheets verwenden, schreibt das Add-on die Ergebnisse direkt in Ihr aktives Blatt, ohne dass Sie herunterladen und erneut hochladen müssen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wenn Extraktion allein nicht ausreicht: Qualitätsprüfungen und Sonderfälle
Die klinische Datenextraktion birgt höhere Risiken als die Rechnungsverarbeitung. Ein verschobener Dezimalpunkt in einer Rechnung bedeutet eine Korrektur der Abrechnung. Ein verschobener Dezimalpunkt bei einem Laborwert bedeutet eine Qualitätskennzeichnung in den Registerdaten – oder schlimmer, ein falsch klassifiziertes Patientenergebnis. Hier sind die Sonderfälle, die zählen, und wie man sie behandelt.
Werte außerhalb des Bereichs und Einheitenkonflikte
Ein Kreatininwert von „15,2 mg/dL“ ist klinisch alarmierend. Ein Kreatininwert von „1,2 mg/dL“ ist Routine. Wenn sich der Dezimalpunkt während der Extraktion verschiebt, pflanzt sich der Fehler in jede nachgelagerte Analyse fort. Die Absicherung liegt nicht im Extraktionsschritt – sondern im Prüfschritt. Nach der KI-Extraktion sollten Sie die Ausgabespalte auf Werte außerhalb des physiologisch plausiblen Bereichs für die Patientengruppe scannen. Moderne Extraktionstools können Ausreißer automatisch kennzeichnen, indem sie extrahierte Werte mit konfigurierbaren Referenzbereichen vergleichen. Das ersetzt keine menschliche Prüfung, lenkt aber die Aufmerksamkeit des Prüfers auf die Zeilen, die am wahrscheinlichsten Fehler enthalten – ein deutlich effizienterer Arbeitsablauf als jede Zeile gleichmäßig zu prüfen.
Doppelte Medikamente und Abgleichsartefakte
Auf einem EHR-Bildschirm kann die Medikamentenliste eines Patienten sowohl ein aktives Rezept für „Metformin 500 mg BID“ als auch einen abgesetzten Eintrag für „Metformin 1000 mg täglich“ enthalten – beide sind in derselben Medikamentenhistorie sichtbar. Eine naive Extraktion, die jeden Medikamenteneintrag erfasst, würde beide übernehmen und so ein falsches Duplikat erzeugen. Die Lösung besteht darin, die Extraktion so zu konfigurieren, dass der Medikamenten-Status als separate Spalte erfasst wird (Aktiv/Abgesetzt/Abgeschlossen), sodass der Abstraktor beim Review filtern kann. Hier werden abgeleitete Spalten wertvoll: Eine Spalte mit der Definition „Nur aktive Medikamente (ja/nein)“ weist die KI an, den Statuskontext jedes Medikamenteneintrags zu bewerten und nur die aktuell aktiven auszugeben.
Mehrseitige Berichte und Fortsetzungsseiten
Ein 4-seitiger Laborbericht, bei dem die CBC-Ergebnisse auf Seite 2 beginnen und auf Seite 3 fortgesetzt werden, stellt eine Kontinuitätsherausforderung dar. Versteht das Extraktionstool, dass Seite 3 eine Fortsetzung und kein neuer Bericht ist? Semantische Extraktionsmodelle, die Dokumente ganzheitlich verarbeiten – alle Seiten als ein zusammenhängendes klinisches Dokument lesen – handhaben dies natürlich. Das Modell erkennt, dass „WBC: 7,2“ auf Seite 3 zum selben CBC-Panel gehört, das auf Seite 2 begann, und nicht zu einem separaten Bericht. Achten Sie beim Hochladen mehrseitiger PDFs darauf, dass alle Seiten in einer einzigen Datei enthalten sind und nicht auf mehrere Uploads verteilt werden, damit die KI diesen Kontinuitätskontext beibehalten kann.
Handschriftliche Anmerkungen und Randnotizen
Kliniker machen Anmerkungen. Ein ausgedruckter Laborbericht mit handschriftlichem „in 2 Wochen wiederholen“ am Rand. Eine Medikamentenliste mit einem eingekreisten Dosiseintrag und daneben gekritzeltem „abgesetzt – verursacht GI-Beschwerden“. Diese Anmerkungen enthalten klinisch bedeutsame Informationen, die eine Standard-OCR-Engine entweder übersehen oder falsch lesen würde. KI-Modelle auf Basis der Bildverarbeitung, die das Dokument als Bild verarbeiten – nicht nur als extrahierten Text – können Handschrift neben gedrucktem Text lesen und sowohl die strukturierten Daten als auch den unstrukturierten klinischen Kontext in einem Durchgang erfassen. Wenn eine handschriftliche Notiz einen Medikamentenstatus ändert, kann eine abgeleitete Spalte wie „Medikamentenstatus (Aktiv/Abgesetzt/Geändert)“ diese Anmerkung als strukturiertes Flag für den Prüfer sichtbar machen.
HIPAA, Sicherheit und was „Compliance“ tatsächlich bedeutet
Jedes Tool, das klinische Daten verarbeitet, muss sich mit HIPAA befassen. Aber HIPAA-Compliance ist kein Zertifikat – es ist ein betrieblicher Zustand, der durch die Anforderungen der HIPAA-Sicherheitsregel an administrative, physische und technische Sicherheitsvorkehrungen definiert wird (45 CFR Teil 160 sowie Unterteile A und C von Teil 164). Keine Regierungsbehörde stellt ein „HIPAA-zertifiziertes“ Siegel aus. Entscheidend ist, ob die Datenverarbeitungspraktiken des Tools die drei Sicherheitskategorien der Regel erfüllen.
Für die klinische Datenextraktion sind die relevanten technischen Sicherheitsvorkehrungen: Verschlüsselung während der Übertragung (alle Daten über HTTPS), Verschlüsselung im Ruhezustand, Zugriffskontrollen, die festlegen, wer Patientendaten einsehen oder verarbeiten darf, sowie eine klare Richtlinie zur Datenaufbewahrung und -löschung. Ein Tool, das Dateien flüchtig verarbeitet – Daten extrahiert, ohne die Quelldokumente nach der Verarbeitung zu speichern – eliminiert eine erhebliche Risikokategorie, da kein dauerhafter PHI-Speicher vorhanden ist, der kompromittiert werden könnte.
Für Organisationen, die eine Business Associate Agreement (BAA) benötigen – was auf die meisten gedeckten Einrichtungen unter HIPAA zutrifft – ist die entscheidende Frage an jeden Anbieter von Extraktionstools, ob er eine solche unterzeichnet. Eine BAA ist ein Vertrag, der die HIPAA-Verpflichtungen auf den Anbieter als Geschäftspartner ausweitet. Ohne unterzeichnete BAA darf eine gedeckte Einrichtung keine PHI zur Verarbeitung an diesen Anbieter weitergeben. Dies ist keine technische Funktion, sondern eine vertragliche Anforderung. Überprüfen Sie dies, bevor Sie Patientendaten hochladen.
In der Praxis sollte das Sicherheitsmodell für KI-gestützte klinische Datenextraktion wie folgt aussehen: Der Benutzer kontrolliert, welche Daten in das System gelangen, das System verarbeitet sie, ohne Quelldateien zu speichern, und der Benutzer kontrolliert, wohin die Ausgabe geht. Keine dauerhafte Speicherung von PHI. Kein Training mit Benutzerdaten. Keine Weitergabe an Dritte. Dies sind die betrieblichen Praktiken, nicht Marketingbehauptungen, die einen HIPAA-kompatiblen Workflow von einem generischen Datei-Upload-Tool unterscheiden.
Wann semantische Extraktion glänzt – und wann sie einen Menschen braucht
Semantische KI-Extraktion bewältigt die meisten klinischen Datenextraktionsszenarien zuverlässig, aber es gibt Situationen, in denen menschliches Urteilsvermögen unerlässlich bleibt. Ehrlich mit diesen Grenzen umzugehen, ist besser, als eine reibungslose Erfahrung zu versprechen, die es nicht gibt.
Wo sie glänzt: Strukturierte oder halbstrukturierte klinische Daten auf einem einzigen Bildschirm oder Bericht – Vitalparameter-Tabellen, Medikationslisten, Laborpanels, Problemlisten, Impfaufzeichnungen, Entlassungsmedikationsabgleiche. Diese Datentypen haben vorhersagbare klinische Semantik, selbst wenn ihre visuelle Darstellung variiert. Die KI kann sie mit hoher Genauigkeit über verschiedene EHR-Anbieter und Berichtsformate hinweg erfassen, da die zugrunde liegenden klinischen Konzepte (Blutdruck, HbA1c, Medikamentendosis) universell sind.
Wo ein Mensch überprüfen sollte: Narrative klinische Notizen mit eingebetteten Daten – ein Verlaufsbericht, der beiläufig einen Laborwert erwähnt („K war heute Morgen 3,1, daher haben wir substituiert“) ohne formellen Laboreintrag. Die KI extrahiert möglicherweise „3,1“ als Kaliumwert, erfasst aber nicht den klinischen Kontext, dass es sich um eine Point-of-Care-Messung handelte, nicht um eine formelle Laborentnahme, und der Wert möglicherweise nicht in das Feld „Serumkalium“ des Registers gehört. Ebenso können gescannte Dokumente mit starken Artefakten – mehrfach gefaxte Aufzeichnungen mit Geistertext und Ausrichtungsversatz – zu minderwertigen Ergebnissen führen. In diesen Fällen sollte die KI-Extraktion als erster Entwurf behandelt werden, den ein menschlicher Prüfer bestätigt, nicht als endgültige Antwort.
Eine Benchmark-Studie von 2024 zu LLM-basierten Informationsextraktionstools für medizinische Dokumente (veröffentlicht auf medRxiv) ergab, dass moderne KI-Modelle „einen signifikanten Fortschritt gegenüber regelbasierten Methoden“ für klinische IE-Aufgaben darstellen, stellte jedoch fest, dass die Leistung je nach Dokumenttyp und Extraktionskomplexität variiert. Die Schlussfolgerung für Praktiker: Nutzen Sie KI-Extraktion als Produktivitätsmultiplikator, der die 80 % der unkomplizierten Datenpunkte übernimmt, damit der menschliche Abstraktor seine Überprüfungsarbeit auf die 20 % konzentrieren kann, die klinisches Urteilsvermögen erfordern.
Vergleich mit anderen Ansätzen
Die Bandbreite klinischer Datenextraktionslösungen reicht von vollständig manuell bis vollautomatisch. Hier ein praxisnaher Vergleich – ohne Marketingfloskeln.
| Ansatz | Einrichtungsaufwand | Formatsvariationen | Ohne IT-Zugang nutzbar | Ideal für |
|---|---|---|---|---|
| Manuelle Extraktion | Keiner | Ja (menschliche Anpassung) | Ja | Sehr geringe Fallzahlen, hohe klinische Komplexität |
| FHIR/HL7-API | IT-Integration + Zugangsdaten | Nicht zutreffend (strukturierte Daten) | Nein | Große Mengen strukturierter Daten in einem EHR-Ökosystem |
| Vorlagen-OCR | Eine Vorlage pro Format | Nein – scheitert bei Layoutänderungen | Ja | Große Mengen, einheitliches Dokumentenformat |
| NLP-Pipeline | Technischer Aufbau + Trainingsdaten | Teilweise | Nein | Unternehmensweiter Einsatz in einer Einrichtung |
| Semantische KI-Extraktion | Spaltennamen eingeben | Ja – layoutunabhängig | Ja | Multi-Format, Multi-Quelle klinische Datenextraktion |
Die richtige Wahl hängt von Fallzahlen, Formatvielfalt und den verfügbaren technischen Ressourcen ab. Für die klinische Studienkoordinatorin, die 200 Patientenakten aus einer Mischung von Epic-Screenshots, externen Labor-PDFs und Faxdokumenten extrahieren muss – ohne Datenbankzugang, ohne API und ohne NLP-Entwicklungsteam – ist die semantische KI-Extraktion die einzige Option in der Liste, die weder Vorlagenkonstruktion noch IT-Integration erfordert. Es ist nicht der einzig valide Ansatz, aber der einzige, der den realen Rahmenbedingungen der meisten klinischen Datenextraktion entspricht.
FAQ
Funktioniert die KI-Extraktion mit Screenshots aus jedem KIS?
Ja, denn die Extraktion basiert auf dem Verständnis der Datenbedeutung, nicht auf der Erkennung eines bestimmten Bildschirmlayouts. Ein Blutdruckwert in einem Epic-Flowsheet, einer Cerner-Vitaltabelle und einer Meditech-Patientenübersicht wird als Blutdruck erkannt – unabhängig von Schriftart, Position oder Bezeichnungsformat. Die KI verarbeitet den Screenshot als Bild und liest ihn wie ein menschlicher Kliniker, indem sie den Inhalt semantisch interpretiert. Allerdings können sehr überladene Bildschirme mit dicht überlappenden Daten – mehrere übereinander gestapelte Tabellen, Popup-Overlays oder geteilte Ansichten mit kleiner Schrift – die Genauigkeit beeinträchtigen und eine stichprobenartige Überprüfung erforderlich machen.
Können handschriftliche klinische Notizen extrahiert werden?
Ja, mit Einschränkungen. Bildbasierte KI-Modelle können handschriftlichen Text zusammen mit gedrucktem Text im selben Dokument lesen. Klare, strukturierte Handschrift – Medikamentennotizen, Vitalzeichenvermerke auf einem Papier-Flowsheet – wird zuverlässig extrahiert. Stark verschnörkelte, hastige klinische Handschrift mit nicht standardisierten Abkürzungen hat eine geringere Genauigkeit. Bei handschriftlichen Inhalten sollte die KI-Extraktion als erster Entwurf betrachtet werden, der eine menschliche Überprüfung erfordert, nicht als endgültige autoritative Aufzeichnung.
Wie wird mit PHI und HIPAA-Anforderungen umgegangen?
HIPAA-Compliance ist ein operativer Zustand, keine Zertifizierung. Die relevanten Faktoren für jedes Extraktionstool sind: (1) ob Daten während der Übertragung (HTTPS) und im Ruhezustand verschlüsselt sind, (2) ob Dateien flüchtig verarbeitet werden – extrahiert und dann ohne dauerhafte Speicherung von PHI verworfen werden, (3) ob der Anbieter eine Business Associate Agreement (BAA) unterzeichnet, falls Ihre Organisation dies verlangt, und (4) ob der Zugriff auf verarbeitete Daten nur autorisierten Benutzern gestattet ist. Überprüfen Sie diese Details mit dem spezifischen Tool, das Sie evaluieren, bevor Sie Patientendaten hochladen. Kein Extraktionstool sollte eine HIPAA-"Zertifizierung" behaupten – denn eine solche existiert nicht. Entscheidend sind die operativen Sicherheitsvorkehrungen.
Wie genau ist die Extraktion bei mehrseitigen PDF-Labordaten?
Bei gedrucktem Text in sauberen Scans kann die Genauigkeit für klar definierte Felder 99 % erreichen. Mehrseitige Berichte funktionieren am besten, wenn sie als einzelnes PDF hochgeladen werden, damit die KI die seitenübergreifende Kontinuität wahren kann – und erkennt, dass das WBC-Ergebnis auf Seite 3 zum selben CBC-Panel gehört, das auf Seite 2 begann. Die Genauigkeit nimmt bei stark artefaktbehafteten Scans (Geisterbilder durch mehrfaches Faxen), extremer Schräglage oder sehr kleinen Schriftgrößen ab. Für kritische Registereinreichungen überprüfen Sie vor der Stapelverarbeitung eine Stichprobe der extrahierten Ergebnisse mit den Quelldokumenten.
Kann ich hunderte Patientenakten auf einmal verarbeiten?
Ja. Die Stapelverarbeitung ist genau für dieses Szenario konzipiert: Laden Sie alle Dateien auf einmal hoch, definieren Sie Ihre Spaltenüberschriften einmal und erhalten Sie eine einzige zusammengeführte Tabelle mit einer Zeile pro Patient. Die Verarbeitungszeit skaliert mit der Dateianzahl, nicht linear – mehrere Dateien werden parallel verarbeitet. Ein Stapel von 100 Screenshots ist normalerweise in unter einer Minute abgeschlossen. Bei größeren Volumina (500+ Dateien) teilen Sie den Vorgang in mehrere Stapel auf, um Timeout-Limits zu vermeiden und die schrittweise Überprüfung zu erleichtern.
Was ist, wenn ich Daten extrahieren muss, die nicht explizit auf dem Bildschirm stehen?
Dafür gibt es abgeleitete Spalten. Eine abgeleitete Spalte weist die KI an, eine Beurteilung auf Basis des Dokumentinhalts vorzunehmen, anstatt nur einen sichtbaren Wert zu transkribieren. Beispielsweise liest „LVEF-Kategorie (Optionen: ≥50 % erhalten / 40–49 % leicht reduziert / <40 % reduziert)“ den Ejektionsfraktionsprozentsatz aus dem Dokument, vergleicht ihn mit den klinischen Schwellenwerten und gibt die entsprechende Kategorie aus – obwohl „LVEF-Kategorie“ nie auf dem Befund steht. Ebenso kann „Medikationsabgleichsstatus (Vollständig/Unvollständig)“ bewerten, ob die Entlassungsmedikation mit der Aufnahmemedikation übereinstimmt, und Abweichungen kennzeichnen. Abgeleitete Spalten verwandeln die Extraktion von einfacher Transkription in strukturierte klinische Datengenerierung.
Ersetzt dies klinische Datenextraktoren?
Nein – es ist ein Werkzeug, das verändert, wofür Extraktoren ihre Zeit aufwenden. Anstatt 50 % ihrer Arbeitszeit mit manueller Dateneingabe zu verbringen (Erkenntnis von Carta Healthcare 2024), können sich Extraktoren auf Verifizierung, klinische Beurteilung und Ausreißeruntersuchung konzentrieren. Die KI übernimmt die reine Transkription; der Mensch übernimmt die klinische Argumentation. Es geht nicht darum, Extraktoren zu ersetzen. Es geht darum, den Teil der Arbeit zu entfernen, für den kein Kliniker studiert hat – Werte von einem Bildschirm abzulesen und in einen anderen einzutippen.
Die klinische Datenextraktion wartet auf ein Werkzeug, das Bildschirme so liest wie ein Mensch – indem es versteht, was Daten bedeuten, nicht wo sie stehen. Semantische KI-Extraktion ersetzt nicht das klinische Urteilsvermögen des Abstraktors. Sie ersetzt das Kopieren und Einfügen.
Wenn Sie heute klinische Daten aus EHR-Bildschirmfotos extrahieren – für ein Register, eine Forschungsstudie, ein Qualitätsverbesserungsprojekt oder ein Audit – testen Sie den Ansatz zunächst an einer kleinen Stichprobe Ihrer eigenen Dateien. Wählen Sie 10 Patientenakten aus. Definieren Sie Ihre Spalten. Führen Sie die Extraktion durch. Vergleichen Sie die Ausgabe mit Ihrer manuellen Abstraktion. Wenn die KI 90 %+ der Datenpunkte korrekt erfasst, haben Sie den Großteil der Zeit zurückgewonnen, die Sie derzeit mit Transkribieren verbringen. Die restlichen 10 % sind der Bereich, in den Ihre klinische Expertise gehört.