中小メーカーがサプライヤーのPOデータを
Google スプレッドシートに手入力なしで取り込む方法
米国生産性品質センター(APQC)のベンチマークによると、1件の購買発注(PO)を処理するコストは50〜150ドル、中央値は約100ドルです。この金額には、要求、承認、発行、納品確認、請求書照合までの全ライフサイクルが含まれます。しかし、Google スプレッドシートで調達を管理している中小メーカーにとって、そのコストの大部分は1つの場面に集中しています。それは、サプライヤーのPDF形式のPOが受信トレイに届き、誰かがその内容をトラッカーに入力しなければならない瞬間です。この記事の目的は、その瞬間をなくすことです。スプレッドシートを変えるのではありません。スプレッドシートは機能しています。変えるのは、データの入力方法です。
重要なポイント
- PO1件あたり50〜150ドル。 これはAPQCのベンチマークが示すPO処理コストです。Google スプレッドシートでPOを管理している中小メーカーにとって、そのコストの大部分は1つの瞬間に集中しています。それは、誰かがサプライヤーのPDFを1行ずつトラッカーに入力する瞬間です。
- テンプレートベースのPO抽出ツールは、サプライヤーのフォーマットごとに個別の設定が必要で、サプライヤーがPDFレイアウトを変更すると静かに壊れます。データのずれは、エラーがすでにPOログ全体に広がった後の照合時に、数日経ってから発見されます。
- 位置ではなく意味でPOを読み取るセマンティックAIを使用すると、ImageToTable.aiサイドバーからあらゆる形式のサプライヤーデータを既存のシートに抽出できます。金曜午後のタイピング作業が、数量の不一致や納品漏れを素早く確認する作業に変わります。
シートベース調達に潜む見えないボトルネック
オハイオ州の小さな金属加工工場は、6社のサプライヤーから原材料を仕入れています。板金はRyerson、棒鋼は地域の鉄鋼ディストリビューター、ファスナーはMcMaster-Carr、仕上げ用化学品は地元のメッキ加工業者から。各サプライヤーは発注確認書をPDF添付ファイルで送ってきます。各PDFのレイアウトは異なり、フィールド名も列の順序もテーブル構造もバラバラです。工場ではすべての未完了POをGoogle スプレッドシートで管理しています。PO番号、サプライヤー、品目説明、注文数量、単価、行合計、注文日、納入予定日、ステータス。このシートは3年間かけて磨き上げられてきました。納期遅れを警告する条件付き書式もあり、オーナーが毎週月曜の朝に確認するサマリータブもあります。
シート自体は優れています。問題は、そこにデータを流し込む仕組みです。
サプライヤーからPO確認PDFが届くと、誰か — 多くの場合オーナー自身か、出荷ラベル・顧客請求書・人事書類も担当するオフィスマネージャー — が別タブでPDFを開き、明細行テーブルから数量と価格を読み取り、シートに戻って各値を正しいセルに入力します。1件のPOに約3〜4分。週8件のサプライヤーPOなら、月に30分の転記作業。1か月で2時間 — それは調達分析にも、サプライヤー交渉にも、機械的にタイピングしていて見逃してしまった数量の不一致を発見することにも使われない時間です。
これこそ、誰も書かないボトルネックです。「purchase order Google Sheets template」で上位表示される記事は、テンプレート設計、列構造、ステータスのドロップダウン、ピボットテーブルのダッシュボードを扱っています — いずれもデータがすでにシートにあることを前提としています。クラスの書式設定は解決しても、クラスのデータ取り込みは解決していません。WhatsAppとExcelで中国・米国・欧州のサプライヤーからの30件以上の未完了POを管理している小規模企業にとって、スプレッドシートの構造は問題ではありません。問題は取り込みパイプラインです — そしてそれを解決するのにERPは必要ありません。
中小メーカーに必要なのは新しい調達システムではありません。すでに構築したシステムにサプライヤーのPOデータを取り込む方法です。
サプライヤーが増えるとテンプレート型PO抽出ツールが壊れる理由
発注書からデータを抽出するツールのほとんどは、テンプレートマッチングかルールベース解析のいずれかの方式を採用しています。テンプレートマッチングでは、サンプルのPO上で各フィールドの周囲にバウンディングボックスを描画する必要があります。「PO番号はここ、日付はここ、品目説明はここから始まる」という具合に設定し、その座標をそのサプライヤーからの将来のすべての文書に適用します。ルールベース解析はキーワードトリガーと位置オフセットを使用します。「PO番号」というテキストを見つけて、同じ行または隣接セルにある後続の内容を取得します。
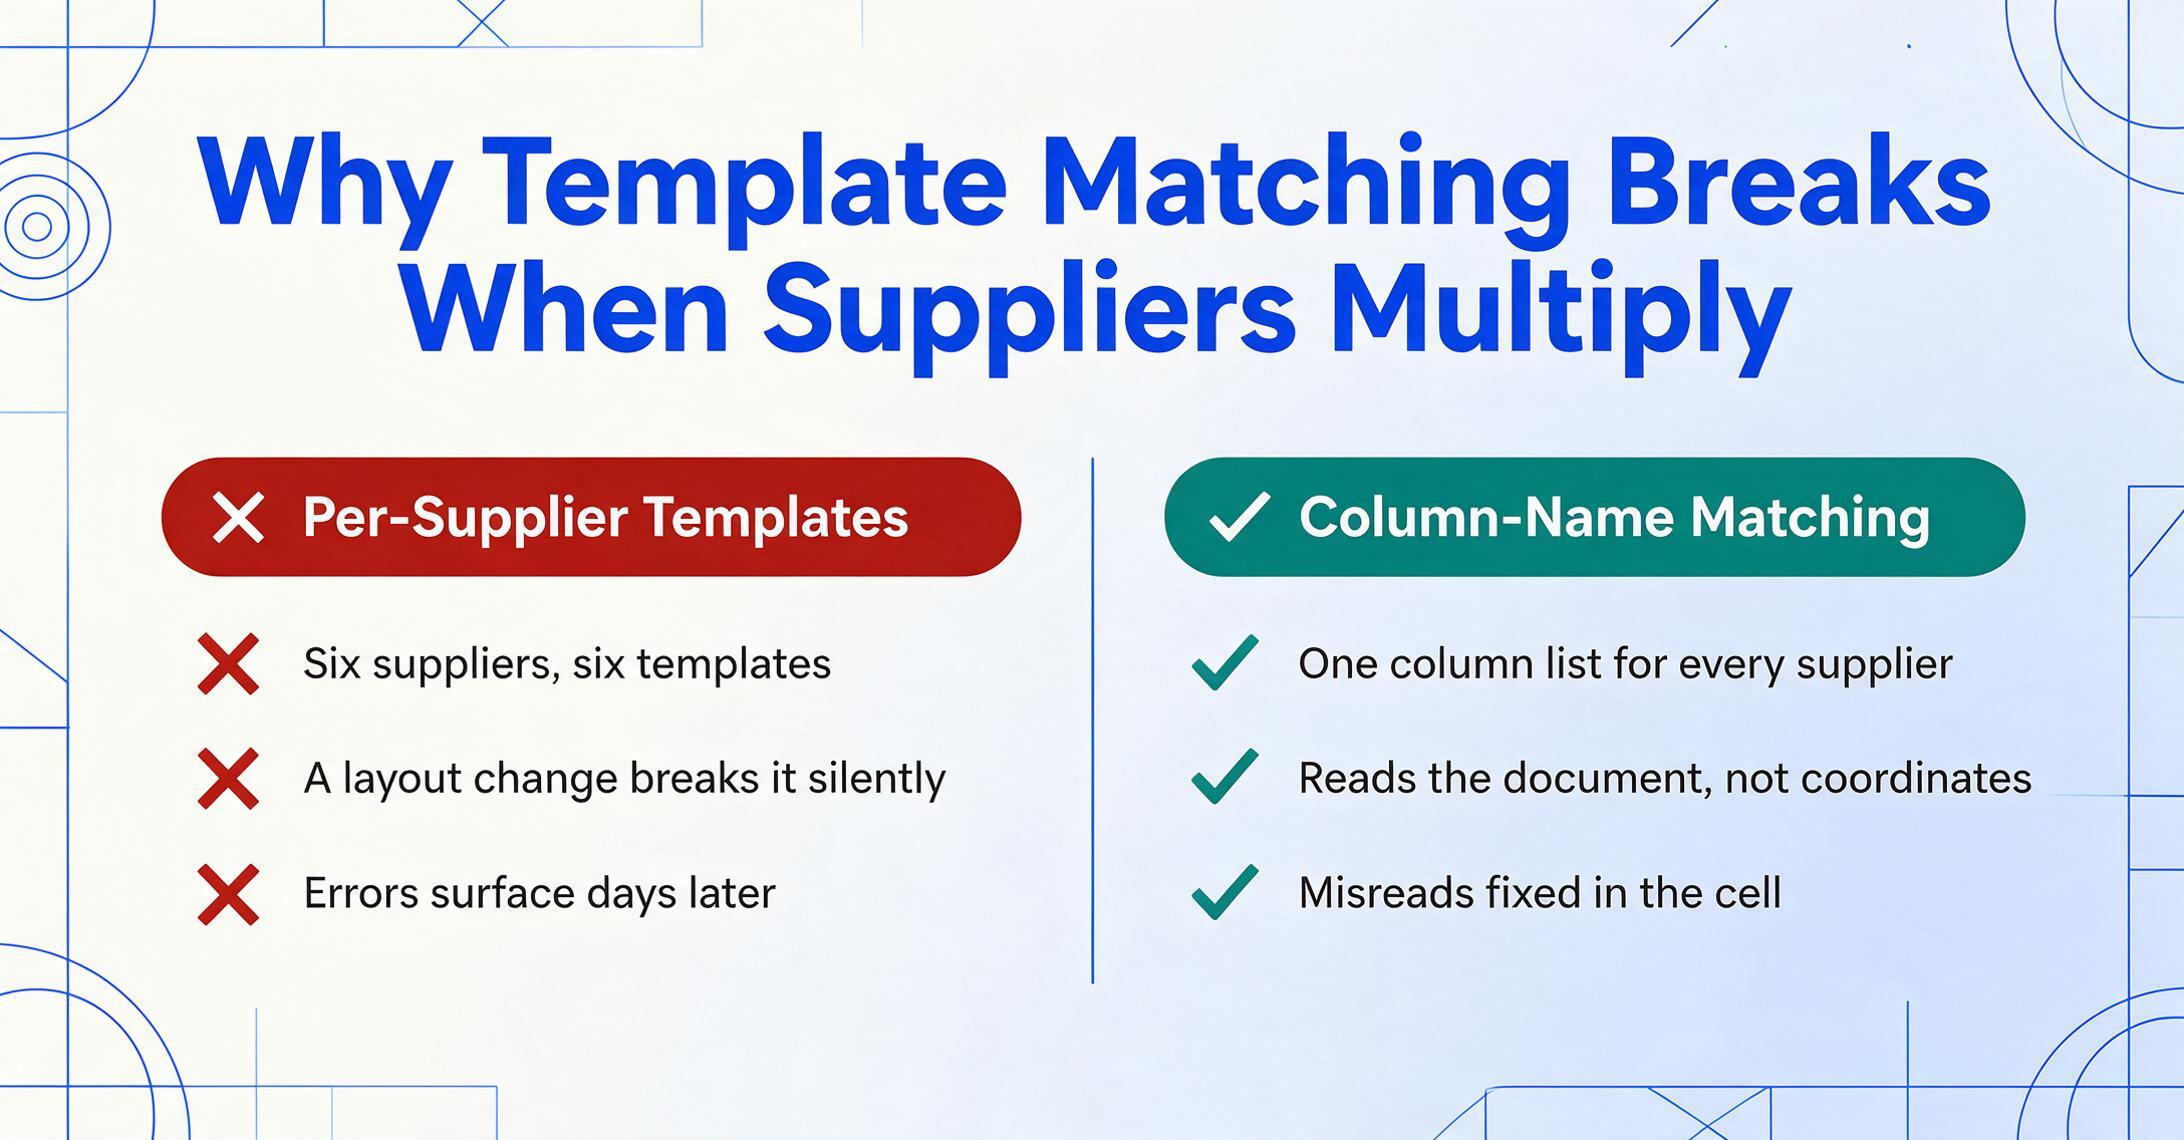
どちらの方式も同じ箇所で破綻します。それは、サプライヤーのフォーマットが複数に増えたときです。6社のサプライヤーを持つ工場では、6つのテンプレート設定を構築・維持する必要があるかもしれません。あるサプライヤーがPDFレイアウトを変更した場合——ERPのアップグレード、請求プラットフォームの切り替え、レターヘッドの改訂などで発生します——テンプレートは静かに壊れます。抽出されたデータはずれて出力されます。誰かがそれを発見するのは、数時間後または数日後、差異チェックや入庫照合のときです。その頃には、エラーはPOログに伝播しており、修正するにはどの行がどのサプライヤーのどのフォーマット版から来たのかを遡って特定する必要があります。
これが、中小メーカーが抽出ツールを諦めて手入力に戻ることが多い理由です。ツールが機能しないからではなく、メンテナンスコストが新しいサプライヤーごとに増大し、障害コストが静かに複利のように膨らむからです。APQCの調査によると、組織は1件のPO処理に14ドルから54ドル以上を費やしており、その差は主に購買業務の構造によって生じています。手作業によるやり直し——抽出、修正、再抽出——は、コストの上限側で不均衡な割合を占めています。
この方程式を変えるのは意味ベースの抽出です。つまり、位置ではなく意味によって文書を読み取るAIです。「Order Ref」「PO #」「Purchase Order Number」がすべて同じフィールドを指していることを、ラベルがページのどこにあるか、値がテーブル・ヘッダー・自由テキストブロックのどこにあるかに関係なく理解します。このアプローチ——列名抽出とも呼ばれます——は、サプライヤー別テンプレートの設定を完全に不要にします。フィールドを一度定義するだけです。AIがすべての文書上でそれらを特定します。サプライヤーが来月レイアウトを変更しても、何も壊れません。AIは人間と同じように、内容の意味を理解して新しいレイアウトを読み取ります。
アドオン取り込みポイント:別タブを開かずにサプライヤーPOを抽出
Google スプレッドシートのアドオンは、スプレッドシート内で開くサイドバーパネルです。POログとサプライヤーリストが含まれる同じシートと並んで、拡張機能メニューからアクセスできます。インストールすると、Sheetsワークスペースの一部になります。同じウィンドウ、同じスプレッドシート、同じデータファイルです。抽出はサイドバー内で行われます。結果はアクティブなシートに反映されます。ログインする別のWebダッシュボードも、設定するメール転送アドレスも、構築して監視するZapierワークフローもありません。対応フィールドタイプ、形式、プラン詳細の完全な機能一覧については、Google スプレッドシート抽出アドオン概要をご覧ください。
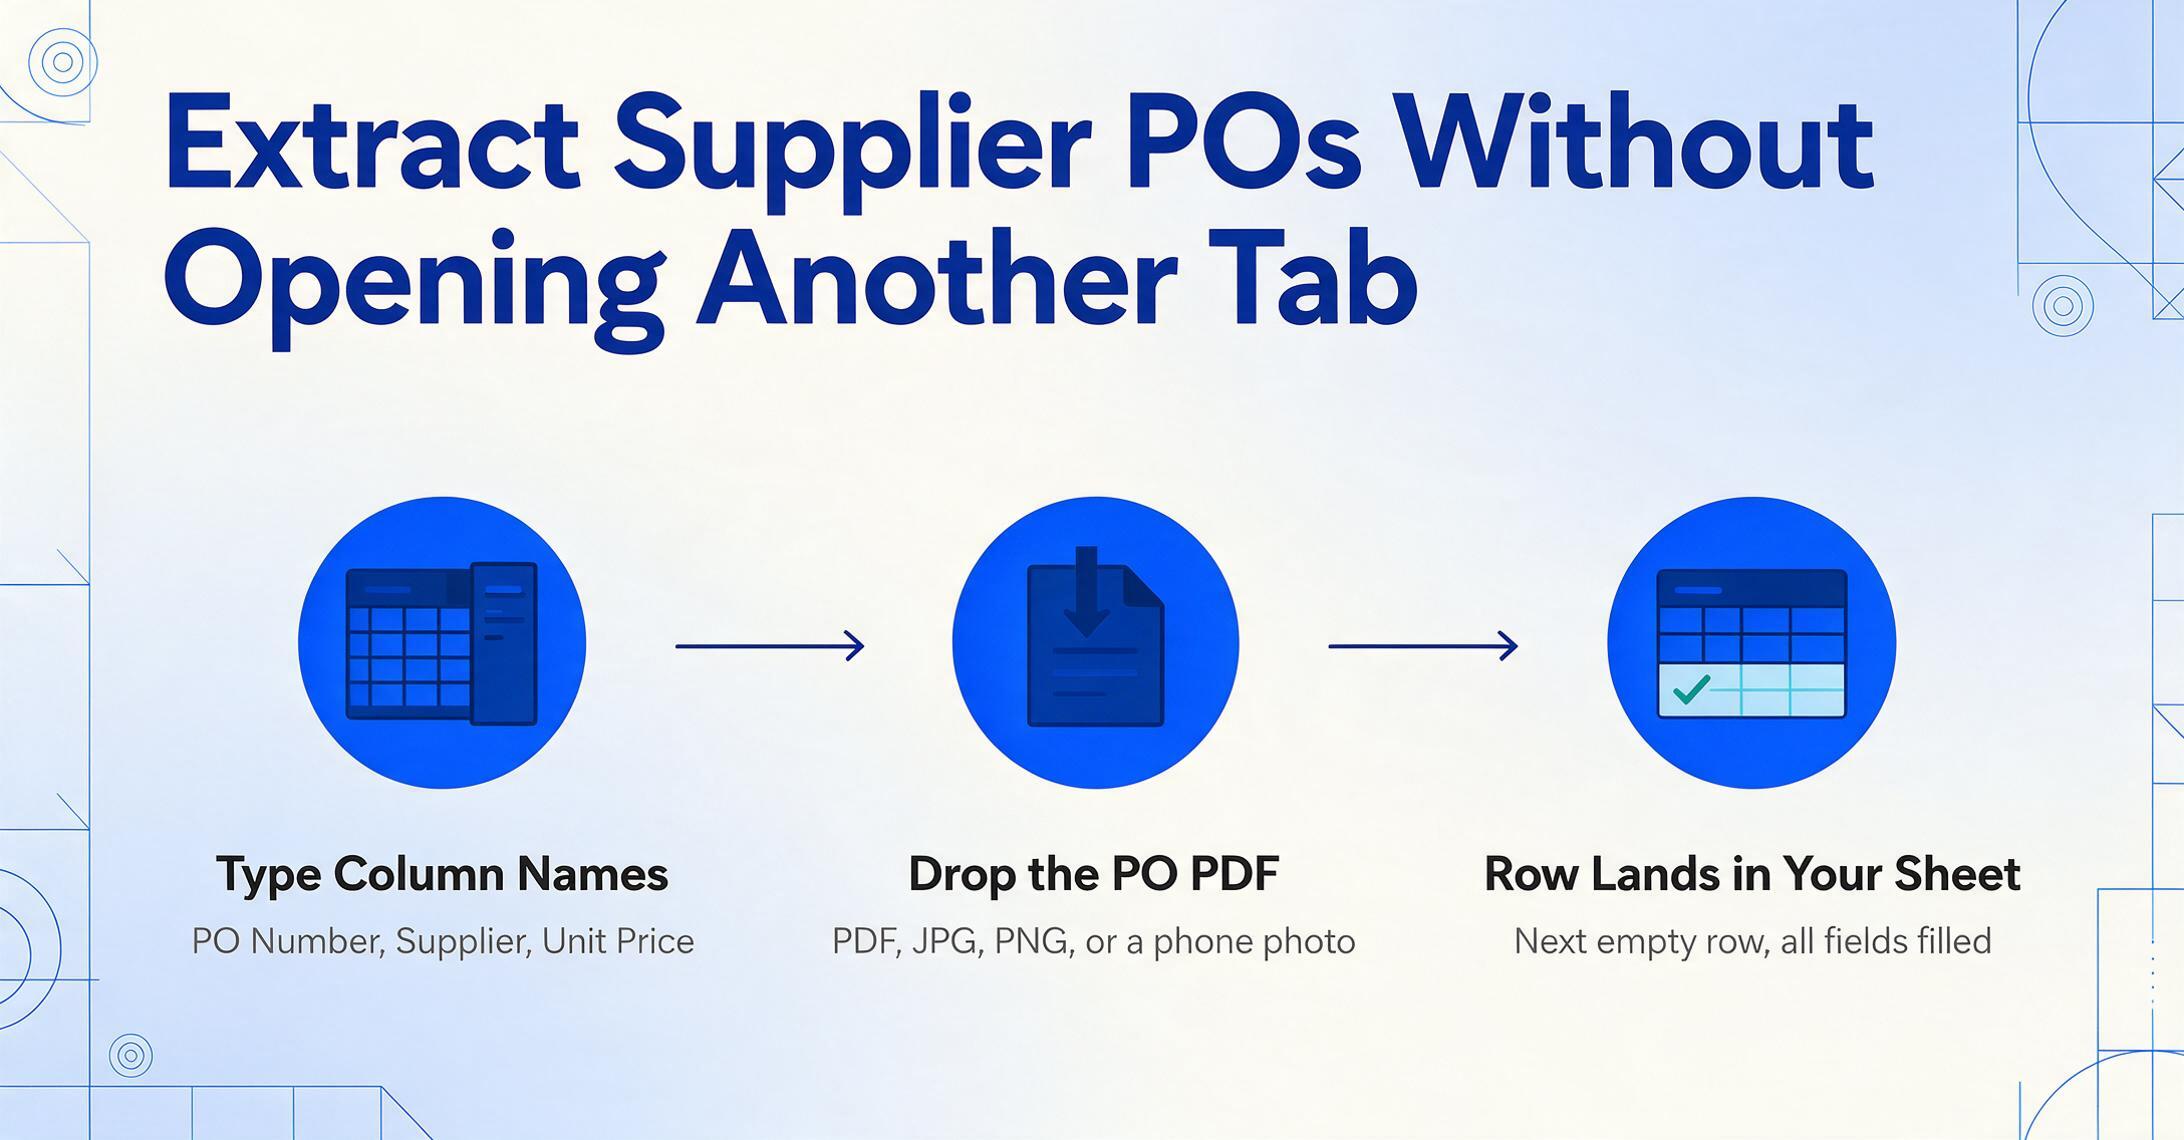
サプライヤーPOの取り込みフローは次のとおりです。
追跡するフィールドに名前を付けます。
サイドバーで、PO追跡シートに一致する列名を入力します:PO番号、サプライヤー、品目説明、数量、単価、行合計、注文日、納入予定日。入力した列名は、アップロードされたすべてのPOでAIが検索するフィールドになります。各サプライヤーがどのようにラベル付けしていても関係ありません。
サプライヤーのPO PDFをアップロードします。
メールやデスクトップからサイドバーパネルにPDFをドラッグします。アドオンはPDF、JPG、PNG、WebP、AVIFに対応しています。大手サプライヤーからのデジタルPO、スキャンしたPO確認書、ベンダーポータルの注文ページのスクリーンショットなどに対応します。1件ずつアップロードするか、週末処理用に複数ファイルを一括アップロードします。
データが次の空の行に表示されます。
抽出を実行します。AIがPOを読み取り、列名に一致する値を特定し、アクティブなシートに新しい行を追加します。列の順序は定義したとおりです。既存の数式(サプライヤー別のSUMIF合計、納期遅延の条件付き書式、支出分析のピボットテーブル)はそのまま維持されます。新しい行は単なる次の行です。
3つのステップが手動のループに取って代わります。他のPO抽出ツールとの主な違いは、スプレッドシートから離れる必要がないことです。サイドバーがツールです。シートは抽出指示のソースであり、結果の宛先でもあります。中間ファイルも、CSVエクスポートも、アプリ間のコピー&ペーストもありません。データはシート以外の場所に存在することはありません。
ファイルは安全に処理され、保存されることはありません。
PO追跡列の設定(AIにフィールドをマッチングさせる)
サイドバーに入力する列名は、従来の意味でのテンプレートではありません。AIにページ上のフィールドの位置や、その周囲に描くバウンディングボックスを指示しているわけではないのです。あなたが何を重視しているかをAIに伝え、レイアウトの測定ではなく文書の理解によって、それらの値を見つけさせるのです。この違いは調達において重要です。サプライヤーのPO形式は本質的に多様であり、サプライヤーを追加するたびにその多様性はさらに増すからです。
メーカーのPO追跡シートのコア列セットには、通常以下のものが含まれます:
| 列名 | AIが探すもの | 値の例 |
|---|---|---|
| PO番号 | 「PO #」「注文番号」「参照」などのラベルが付いたフィールド、または文書上部にある独立した英数字の連番 | PO-2026-0482、4500123456 |
| サプライヤー | 文書のヘッダーまたは送信者欄にある会社名 | Ryerson、McMaster-Carr Supply Co. |
| 品目説明 | 注文テーブル内の明細行の製品・サービス説明 | 304 SS Sheet 16ga 4'x8'、Hex Bolt M10x1.5 |
| 数量 | 明細行ごとの数値数量 | 25、3、200 |
| 単価 | 1単位あたりのコスト — AIはこれを合計額と区別します | $4.32、$12.75、$0.18 |
| 行合計 | 明細行ごとの金額(数量 × 単価) | $108.00、$38.25、$36.00 |
| 注文日 | POが発行された日付。ラベル(「注文日」「日付」「発行日」)に関係なく取得します | 2026-06-02 |
| 納入予定日 | 納品日または出荷日。文脈から注文日と区別します | 2026-06-17 |
| ステータス | 推論列 — 「注文済み/一部受領済み/受領済み/完了」などのオプションを定義すると、文書の内容に基づいてAIが値を入力できます | 注文済み |
列名を指定せずに、AIに文書内のすべてを自動検出させることもできます。これは、構造をまだ把握していない取引先のPOを一度だけ処理する場合に便利です。自動検出の結果から、文書に含まれる内容の全体像がわかります。その後、同じ取引先からの今後のアップロード用に列リストを調整できます。
列と文書フィールドを対応付ける仕組みはセマンティックフィールドマッチングです。AIは取引先のPOを全体として読み取り、ラベルと値の関係を理解し、抽出した各フィールドを指定した列にマッピングします。ある取引先がフィールドを「Purchase Order Number」とラベル付けし、別の取引先が「Reference No.」とラベル付けしても、AIは両方を定義済みのPO番号列として認識します。これにより、取引先ごとの設定が不要になり、同じサイドバーがすべての取引先のフォーマットで設定作業なしに機能するのです。
20件のPDFから数分で最新のPOログへ
単一POのワークフローは直感的です。バッチワークフローこそ、時間の節約が積み重なり、アドオンの設計上の選択が調達業務に最も影響を与える部分です。
毎週のサイクルで発注書を発行する中小メーカーを考えてみましょう。毎週月曜日に、新しいPOをサプライヤーに発行します。週の間に、サプライヤーからの確認書がPDF添付ファイルとして少しずつ届きます。火曜日に届くものもあれば、金曜日に届くものもあり、翌週の月曜日に「遅れて申し訳ありません」というメモ付きで届くものもあります。金曜日の午後までに、調達担当者のフォルダには、追跡シートにまだ反映されていない7〜12件のサプライヤー確認PDFが溜まっています。手作業のアプローチでは、各ファイルを開き、明細行を読み、スプレッドシートに切り替えて入力する必要があります。これは金曜日の午後の儀式であり、45分の集中力を消耗し、それでも3件のPOは「月曜日に入力予定」のまま残ります。
バッチアップロードはこのリズムを変えます:
サプライヤーのPO PDFを1つのフォルダに集めます。
受信したサプライヤーメールにラベルを付け、添付ファイルをGoogle ドライブのフォルダに保存するGmailフィルタを設定します。または、デスクトップからアドオンのサイドバーのバッチアップロードダイアログにファイルをドラッグします。どちらの方法でも、目的は集約です。処理前にすべての確認書を1か所にまとめます。
サイドバーにバッチアップロードします。
12件すべてのサプライヤーPDFを1回のアップロードで選択します。アドオンはそれらを処理用にキューに入れ、すべてのファイルに同じ列名抽出を適用します。順次ではなく、同時にです。サプライヤー間のフォーマットの多様性は問題になりません。各ドキュメントは同じセマンティックAIによって独立して処理されるからです。
シートで確認・検証します。
PO追跡シートに12件の新しい行が表示されます。サプライヤーPOごとに1行です。明らかな異常(数量がおかしい、サプライヤー名が省略形で入力されたなど)がないか行をスキャンします。シートが作業面なので、修正はセル内で直接行います。学習したり操作したりするための別のレビューインターフェースはありません。
バッチアップロードは単一ファイル処理より速いだけではありません。作業の質を変えます。手動入力では、一度に1つのPOを、行ごとに考える必要があります。バッチ抽出では、行単位で考えることができます。12行をスキャンして不一致を見つけ、パターン(特定のサプライヤーが一貫して特定の材料を安く見積もっている?)に気づき、異常にフラグを立てます。データ入力係から調達レビュー担当者への精神的なシフトは、まさに入力作業をしなくなったからこそ起こります。
このワークフローは、一貫して更新されるPOログからデータを受け取る下流の調達プロセスの基盤も整えます。すべてのサプライヤーPO行が、どのサプライヤーPDFから来たかにかかわらず、同じフィールドが同じ順序で構造化されていれば、完全で最新のデータに依存する受領照合チェックリスト、配送追跡ダッシュボード、サプライヤー別支出レポートを構築できます。POログは履歴記録ではなくなり、運用ダッシュボードになります。1週間分のサプライヤーPOをSheetsのライブダッシュボードに変換する実例(部分納品の追跡やステータス列を含む)については、Google スプレッドシートでのバッチPOダッシュボード作成ガイドをご覧ください。スリーウェイマッチング(PO、受領報告書、サプライヤー請求書の照合)を計画しているチームにとって、常に最新のPOログは前提条件です。それがなければ、スリーウェイマッチングは、不完全なPO記録を、同じ注文を参照しているかどうかわからない他の2つの文書と照合することになります。
サプライヤーPOを処理するのと同じアドオンが、サプライヤー請求書をGoogle スプレッドシートに変換することもできます。これは調達インテークパイプラインの照合側です。POデータと請求書データの両方が同じサイドバーを通じて構造化されたシートに流れ込むと、スリーウェイマッチングは、PDFを手作業で探し回るのではなく、一貫して構造化された2つの行の比較になります。
成長する調達スタックにおけるアドオンの位置づけ
調達ツールはエンドツーエンドのカバレッジを約束しながら、各段階で浅いカバレッジしか提供しない傾向があるため、アドオンが何をしないのかを明確にしておく価値があります。
アドオンが処理するのは1つのステップだけです。サプライヤーPOデータをPDFからシートの構造化された行に取り込むことです。サプライヤーに送る発注書の生成は行いません(それは出力側で、自社のPOテンプレートまたは別のツールを使って行います)。受領報告書や請求書に対するスリーウェイマッチングも実行しません(ただし、その比較の両側に一貫したデータを供給します)。承認ワークフローの管理、支出制限の執行、会計ソフトの総勘定元帳との統合も行いません。これはインテーク層であり、それがポイントです。埋めるギャップは、現実的であるほど狭く、重要であるほど深いのです。
この狭さは制限ではなく、特徴です。中小メーカーの調達プロセスは通常、有機的に成長してきました。長年にわたって進化してきたGoogle スプレッドシートのPOログ、メールと電話で管理されるサプライヤー関係の混合、物理的な受領プロセス(印刷されたPOと照合して納品を確認する)、月末に最終POデータをQuickBooksまたはXeroに入力する経理担当者。どの段階でERPを導入しても、他の3つのプロセスを混乱させるでしょう。インテーク段階(PDFが行になるポイント)にアドオンを導入すれば、下流の作業方法を誰にも強制することなく、チェーン全体が改善されます。
テンプレートなしで任意の文書形式からPOデータ抽出を処理する方法の詳細については、セマンティック抽出が重要である理由を理解するための背景として、発注書から必要なフィールドのみを抽出するガイドをご覧ください。調達ソフトウェアが普及してもPOデータ入力がボトルネックであり続ける理由のより広い議論については、POデータ入力の問題が手動入力を存続させる構造的な力を考察しています。また、POデータをSheetsではなくExcelにエクスポートする必要がある場合は、発注書からExcelへの変換ツールが同じ列名抽出アプローチで単一ドキュメントの変換を処理します。
よくある質問
アドオンはスキャン済みや撮影済みの紙の注文書に対応していますか?
はい。JPG、PNG、WebP、PDFのすべてに対応しています。印刷されたPO確認書のスマホ写真、デスクトップスキャナでのスキャン、クリーンなデジタルPDFのいずれでも動作します。AIは埋め込まれたテキストレイヤーを解析するのではなく、文書を視覚的に読み取るため、スキャン文書や写真もデジタルPDFと同じように処理されます。極端に傾いた写真やコントラストが非常に低い文書(かすれた感熱印刷、照明不足)では、部分的な結果になる場合があります。平らで明るい写真が最も高品質な抽出結果をもたらします。
アドオンはヘッダーフィールドだけでなく、明細行の詳細も抽出できますか?
はい。「品目説明」「数量」「単価」「行合計」など、品目レベルのデータ用の列を定義すると、AIがPOの明細行テーブルからすべての行を抽出します。各明細行はシート内で独自の行になり、PO番号やサプライヤーなどのヘッダーレベルのフィールドはトレーサビリティのために各行に繰り返されます。明細行が非常に多いPO(30行以上)の場合、バッチ処理ではなく1ファイルずつ処理することで、明細行の精度がより安定します。
AIがフィールドを誤って読み取った場合はどうなりますか?
抽出された値はシート内の編集可能なセルとして表示されます。「注文日」がサプライヤーの記載「2026-06-02」に対して「2026/06/05」として抽出された場合は、セル内で修正します。専用のレビューインターフェースも、ロックされたデータも、別の検証画面もありません。シート自体が検証画面です。つまり、抽出エラーは、ツール固有のレビューインターフェースを行き来するのではなく、最終的にデータが置かれる場所、つまり追跡シート内で発見・修正されるのです。
アドオンは異なる言語のサプライヤーからの注文書に対応していますか?
AIは英語、中国語、日本語、韓国語、ドイツ語、フランス語、スペイン語、ポルトガル語の文書を読み取ります。異なる言語のフィールドラベル(ドイツ語の「Bestellnummer」、スペイン語の「Número de Pedido」、フランス語の「Numéro de Commande」)は認識され、英語の列名にマッピングされます。サイドバーで定義する列名は、入力言語に関係なく英語のままです。
複数のサプライヤーからのPOを、各サプライヤーの文書形式が異なっていても、1つのバッチで処理できますか?
はい、これが主なユースケースです。列名抽出アプローチは、レイアウトではなく意味的な意味に基づいて各文書を個別に読み取ります。McMaster-CarrからのPO(デジタルPDF、横型レイアウト、品目コードが別の列にある)と、地域の鉄鋼サプライヤーからのPO(スキャン、縦型レイアウト、手書きの数量)をまとめてバッチ処理できます。それぞれが同じ列構造にマッピングされた独自の行を生成します。
このアドオンはERPや調達ソフトウェアを置き換えますか?
いいえ。このアドオンは、「PDFがある」状態から「行がある」状態の間にある、サプライヤーのPOデータを追跡シートに取り込むという1つのギャップを埋めるものです。本格的な調達プラットフォーム(Procurify、Tradogram、Precoro)は、要求ルーティング、承認フロー、予算管理、サプライヤー管理、ERP統合を処理します。運用がSheetsをシステム・オブ・レコードとして使い続けるには大きくなりすぎた場合(部門をまたぐ多段階承認、自動再発注トリガー、リアルタイムの予算可視性が必要な場合)は、調達プラットフォームが次の正しいステップです。しかし、SheetsのPOログがまだ機能しており、ボトルネックがデータ入力であるなら、このアドオンはワークフロー全体を移行することなくボトルネックを解消します。ERPを購入せずにデータ入力コンポーネントだけを自動化するステップバイステップのガイドについては、ERPなしでPOデータ入力を自動化する方法をご覧ください。
購買発注を追跡するために作ったシートは、今も機能しています。そのシートにデータを供給する手作業のループ(PDFを開く、フィールドを読む、タブを切り替える、値を入力する、繰り返す)こそが、PO1件あたり50〜150ドルのコストの正体です。今週届いたサプライヤーの確認書でこのアドオンを試して、データ取り込みのステップが本来あるべき姿になるかどうか確認してください。タイピング作業ではなく、サイドバーへのアップロードに。
POワークフロー用のGoogle Sheetsアドオンを試す