M&AデューデリジェンスでCOIデータを
抽出する方法(2026年版ガイド)
M&A実務者を対象とした最近の調査で、国際法曹協会は対象企業の保険ポートフォリオに潜む4つのリスクカテゴリーを特定しました。保険料の未払いによる遡及的な補償の失効、規制上の罰則を招いた必須保険の欠落、バランスシートの引当金を圧迫した保険金請求の拒否、そしてクロージング後に誰も気づかなかった保険の失効です。これらのリスクはすべて、データルームに保管されていた保険証券に記載されていました。それらが見えなかったのは専門知識の不足ではなく、レビューチームが全数検査ではなくサンプリングを余儀なくされるほどの証券の量が原因でした。
重要ポイント
- 300件の証券が入った取引ルームでは、取引に必要なカバレッジ分析を始める前に、転記だけで5,250ドルのコストがかかります。
- RWI引受会社は現在、完全なポートフォリオレビューを期待しており、300件中20件のサンプリングでは、クライアントが取引を保護するために購入した保険そのものが無効になる可能性があります。
- フォルダ全体を一度エクスポートすれば、25分で完全なカバレッジマトリックスが得られ、サンプルではなくすべての証券から分析を開始できます。
M&Aのデータルームにおける保険デューデリジェンスの実態
M&A取引における保険デューデリジェンスは、下請け業者のコンプライアンス追跡とは異なる作業です。建設業では、元請け業者は各下請け業者のCOIが現場入場前にプロジェクトの最低限度額を満たしているかを確認します。質問は「準拠しているか否か」の二択です。レビュアーは通常、更新サイクルごとに下請け業者1社あたり2~3枚の証明書を処理します。
M&Aでは、レビュアーは仮想データルーム(取引情報を共有するための安全なオンライン文書リポジトリ)を開き、対象企業がこれまでに取得したすべての保険証券が含まれる保険フォルダを見つけます。物件、PL、D&O、サイバー、雇用慣行賠償、自動車、労災、アンブレラ・エクセス、環境、専門職賠償、PL、キーマン生命保険。従業員300~800人の中規模対象企業の場合、そのフォルダには通常300~500枚の保険証明書が含まれています。各証明書は1ページのACORD 25、27、28フォーム、または地域代理店が独自のレターヘッドで発行する非標準証明書です。標準フォームの仕組みの詳細は、COIデータ抽出の完全ガイドをご覧ください。
レビューチームの仕事はチェックボックスに印を付けることではありません。購入契約の表明保証条項に直接反映される一連の質問に答えることです。対象企業は事業リスクに対して適切な補償を保持しているか?保険期間満了日と予定クロージング時期の間にギャップがあり、テール補償が必要か?保険会社自体に、賢明な買い手が受け入れる財務格付けがあるか?対象企業は継続的に補償を維持しているか、それとも補償範囲外のエクスポージャー期間を生む中断があるか?
これらの質問に答えるには、各証明書から同じ15項目を抽出し、補償マトリックス(行が保険証券、列が保険会社、限度額、免責額、発効日、保険会社格付けのスプレッドシート)を作成する必要があります。マトリックスが完成して初めて、実際の分析(業界ベンチマークとの比較、取引スケジュール内に収まる満了期間の特定、買い手のリスク許容度を下回るAMベスト格付けの保険会社のフラグ付け)が始まります。
これは、ほとんどの自動化ツールが想定する建設業のCOI追跡とは根本的に異なるワークフローです。COIデータ抽出の方法では一般的な抽出アプローチを説明しています。本稿では、文書スタックがデータルーム内にあり、その出力が購入契約に反映される場合に何が変わるかに焦点を当てます。
M&Aの規模で手動COIレビューが破綻する理由
ジュニアアソシエイトがその日の50枚目の保険証券を開く頃には、5枚目で下したような質の高い判断はできなくなっています。タスクの構造そのものが彼女に不利に働いているのです。保険証券の読み取りは、契約書の一節を読むのとは異なります。略語、数値の上限、チェックボックスの状態、代理店固有の書式の癖が密集したグリッドであり、視線を導く物語的な構造のない1ページに広がっています。
各保険証券では、約15項目のフィールドの特定と転記が必要です。被保険者名、代理店または仲介業者、各保険会社とそのNAIC番号、保険種目、証券番号、開始日、満了日、1事故あたりの限度額、総限度額、その他のサブリミット(医療費、人身傷害および広告傷害、賃借物件の損害)、免責金額または自己負担額、追加被保険者の有無、求償権放棄、証券保有者、解約通知条件です。アンブレラ保険および超過保険については、別の限度額ブロックが同じ構造で異なる数値を繰り返します。
抽出だけで保険証券1件あたり3分かかるとします。これは、書式がレイアウト上の驚きのないきれいなACORD 25フォームであることを前提とした楽観的なペースですが、300件で15時間の純粋なデータ入力を消費します。中堅アソシエイトの請求可能時間単価が1時間あたり350〜500ドルであれば、転記に費やす請求可能時間は5,250〜7,500ドルになります。しかし、抽出が本当の作業ではありません。本当の作業は、マトリックスができて初めて始められる補償内容の分析であり、その分析は、300件の保険契約とその特約・保険会社の資格を対象とし、さらに25〜45時間を消費します。抽出ステップは、分析に至る道のりの料金所のようなものです。転記に費やす1分は、クライアントが実際に支払っているリスク評価に費やされない1分です。
エラー率は量に応じて悪化します。文書集約型ワークフローにおける手動データ入力精度に関する2019年の学術研究では、同じ抽出タスクを約100回繰り返すと、フィールドレベルのエラー率が約2%から8%超に上昇することが判明しました。300件の保険証券に各15フィールドあれば、4,500の個別データポイントになります。8%のエラー率は、約360フィールドが誤っていることを意味します。証券番号の誤り、限度額の桁違い、1か月ずれた日付などです。クロージングの2週間前に満了日が1つ見逃された場合、補償内容に保険未加入のギャップが生じます。そのギャップがクロージング後に表面化した場合、そのコストは、それを発見するのにかかったであろう時間ではなく、それがカバーされずに残す賠償責任の価値です。
M&Aで重要なフィールド(建設業のCOIトラッカーが見落とすもの)
建設業向けCOI追跡ソフトウェアは、1つの質問に答えるために作られています。それは、この下請け業者の保険証券がプロジェクトの最低補償要件を満たしているかどうかです。このソフトウェアが重視するフィールドは、下請け契約に明記されているものです。一般的賠償責任の1事故あたりおよび総額の限度額、労働者災害補償保険の確認、追加被保険者ステータス、および満了日です。
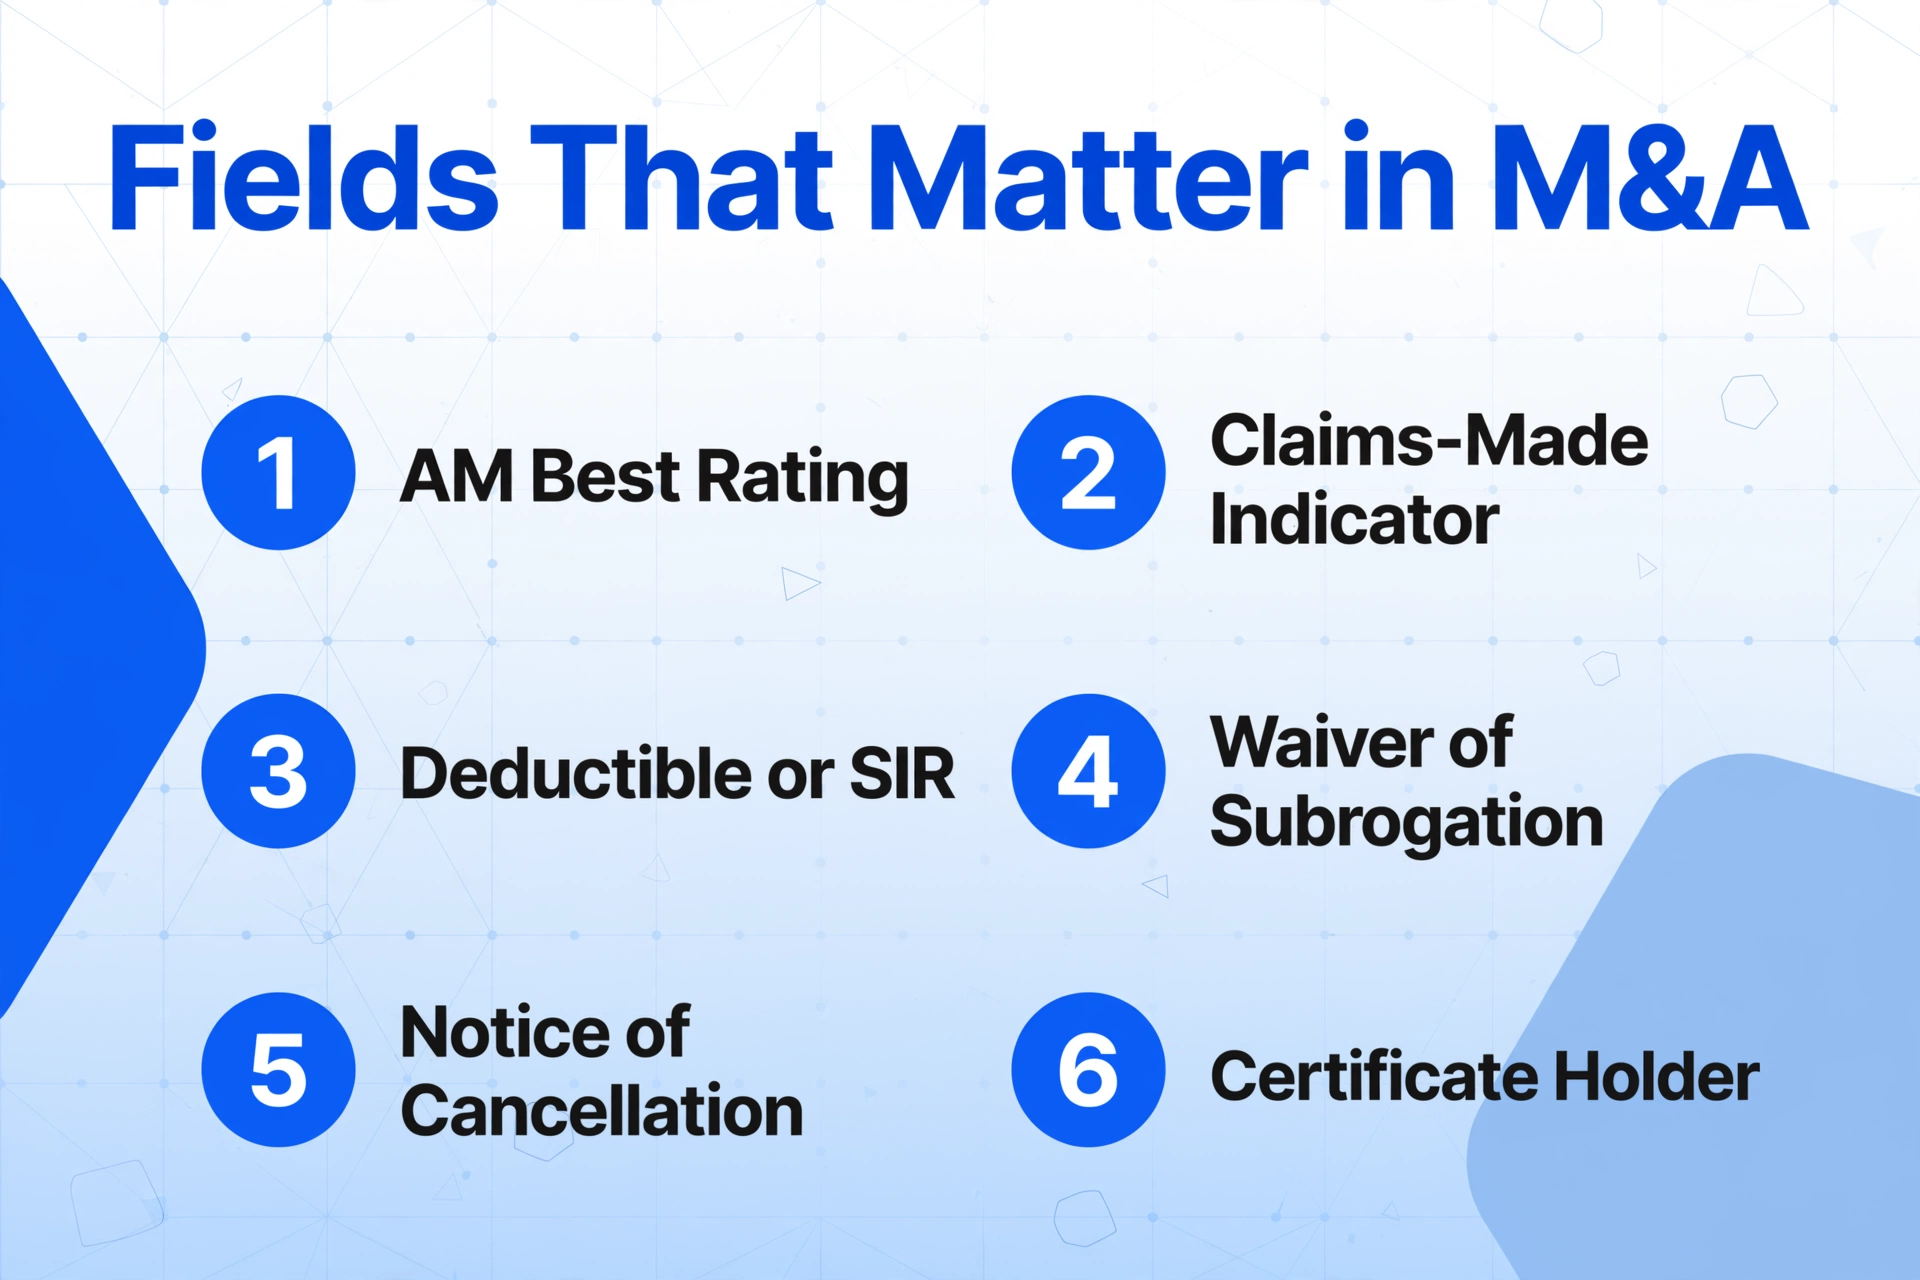
M&Aの保険デューデリジェンスでは、各保険証券について根本的に異なる一連の質問をします。以下のフィールドは、建設業向けCOIツールにはほとんど登場しませんが、取引ルームの補償マトリックスには不可欠です。
AM Best財務力格付け。AM Best格付けは、1906年から保険業界に特化した信用格付け機関が発行する、保険会社の継続的な保険債務を履行する能力に関する独立した評価です。評価スケールはA++(優良)からD(デフォルト)まで、合計13の区分があります。M&Aにおいて保険会社の格付けが重要となるのは、対象会社の補償が、それを裏付ける保険会社と同じだけ信頼できるものだからです。A-格付けの保険会社が発行した保険証券は、B++格付けの保険会社が発行したものとは根本的に異なります。そして、保険限度額を示しながら保険会社の格付けを示さない補償マトリックスは、リスク全体像の半分が欠けていることになります。ほとんどの買収契約における保険表明保証条項では、売り手が保険補償の重要な変更を開示することが求められており、取引期間中の保険会社の格下げは、まさに開示を促すべき重要な変更の一種です。AM Bestは、格付けされた各保険会社に財務規模区分(FSC)を割り当てており、クラスI(調整後保険者余剰金が100万ドル未満)からクラスXV(20億ドル超)まで、文字による格付けに加えて保険会社評価の追加的な側面を提供しています。
控除額および自己負担額(SIR)。自己負担額50万ドルの500万ドル一般賠償責任保険は、控除額1万ドルの500万ドル保険と同じ保険ではありません。最初のケースでは、対象会社は保険会社が1ドルでも支払う前に、すべての請求の最初の50万ドルを自社の貸借対照表から支払います。この請求ごとの50万ドルのエクスポージャーは、実質的に保険未加入の負債であり、保険レビューだけでなく財務デューデリジェンスモデルに含めるべきものです。建設業のCOIワークフローでは、プロジェクトの契約文言により控除額内の金額について下請け業者が責任を負うことになるため、控除額を省略することがよくあります。M&Aでは、買い手がそのSIRエクスポージャーを引き継ぎます。控除額を示さずに限度額のみを示す補償マトリックスは、半分の項目が欠けている負債台帳です。
請求ベース vs. 発生ベースとテール補償トリガー。請求ベースの保険証券は、保険期間中に報告された請求を補償します。これは、基礎となるインシデントがいつ発生したかに関係ありません。発生ベースの保険証券は、保険期間中に発生したインシデントを補償します。これは、請求がいつ提出されたかに関係ありません。この区別は、対象会社が役員賠償責任保険、専門職賠償責任保険、または雇用慣行責任保険について請求ベースの補償を保有している場合に、取引上極めて重要になります。これらの保険証券がクロージング後に更新されない場合、クロージング前の行為に起因するがクロージング後に報告された請求には補償がありません — テール保険証券(延長報告期間、またはERPとも呼ばれます)が購入されない限り。マトリックス内の各保険証券タイプについて請求ベースか発生ベースかの指定を抽出することで、取引チームは購入契約が最終確定される前に、どのラインにテール補償の予算化が必要かを把握できます。
解約通知条項。ほとんどのACORD 25/27/28フォームには、保険会社が解約について証明書保持者に通知するよう「努める」が、「通知しなかった場合でも義務や責任は発生しない」と記載された定型の解約文言が含まれています。実際の保険証券では、30日、60日、または90日の通知期間が定められている場合もあれば、通知義務がまったくない場合もあります。M&Aの買い手にとって、署名からクロージングまでの期間は通常30日から90日です。主要な賠償責任保険証券が取引の途中で取得企業への通知なしに解約される可能性がある場合、署名時点の補償内容はクロージング時点の補償内容とは異なります。各証明書から解約条項の文言を抽出し — 定型版であっても — 基礎となる条件が異なる可能性のある保険証券にフラグを立てることは、大規模な手動レビューではほぼ到達できないリスク特定ステップです。
保険期間と取引タイムラインの重複。証明書の最も単純なフィールドである満期日は、タイムラインの関係でデューデリジェンス中に最も業務上緊急性の高いものになります。10週間のデューデリジェンス期間の4週目に満期を迎える保険証券は、補償マトリックスが完了する前に更新証明書が必要です。署名とクロージングの間に満期を迎える保険証券は、売り手が保険を維持することを要求するクロージング前の誓約を通じて購入契約で対処しなければならない補償ギャップを生み出します。抽出ソフトウェアは、ユーザー定義の期間内に該当するすべての満期日にフラグを立てることができ、数時間の手動レビューを消費するカレンダー確認タスクを自動化されたフィルターに変えます。
AIがCOI文書から確実に読み取れるものと読み取れないものについての詳細な議論については、AIのCOI読み取り機能に関する分析をご覧ください。COI抽出の基本については、COIデータ抽出とはから始めてください。
多様なCOIフォーマットにおけるセマンティック抽出の仕組み
取引ルーム内のCOI書類は、数十の異なる保険代理店から提供されます。中には標準的な位置にフィールドが配置された今年版のACORD 25テンプレートを使用する代理店もあります。2014年改訂版で間隔が少し異なるものもあります。カバレッジ表を2列レイアウトに再配置した代理店管理システムから印刷されたものもあります。また、代理店独自のレターヘッドを使用した非標準の証明書も増えており、地域保険会社や超過保険会社が独自プラットフォームで証明書を発行するケースが増加しています。わずかに傾いてスキャンされた紙の証明書に、欄外に手書きの注記が入っているものもあります。そして、証明書ではなく、フィールドレイアウトがまったく異なる保険証券の宣言ページを、同等のものとして送ってくる代理店もあります。
位置ベースのOCR(従来のテンプレート抽出ツールの基盤技術)は、各フィールドがページ上のどこにあるかを記憶することで機能します。「保険証券番号」が座標(x=340, y=280)にあることを想定し、別の代理店が(x=420, y=310)に配置すると、抽出は静かに失敗し、誤ったフィールドからデータを取得するか、何も返しません。新しいAIベースのツールが使用する代替アプローチはセマンティック抽出です。システムは、テキストがどこにあるかではなく、各テキストが何を意味するかを理解することで、人間と同じように文書を読み取ります。保険証券番号は「保険証券番号としてラベル付けされ、特定のカバレッジラインに関連付けられた英数字の文字列」です。AIは、それがページの左、右、中央のどこにあっても特定できます。
この違いこそが、単一の抽出ツールが代理店ごとの設定なしで40の異なる代理店からの300枚の証明書を処理できる理由です。各証明書はゼロから読み取られ、そのフィールドは座標ではなくセマンティックな役割によって識別されます。建設業界向けに書かれた大規模なCOI追跡の分析では、テンプレート方式とセマンティック方式のパフォーマンス格差を詳しく説明しています。同じ格差はM&Aにも当てはまり、取引ルームの保険フォルダ内の代理店フォーマットの多様性によってさらに拡大されます。
デューデリジェンスの文脈でセマンティック抽出が特に価値があるのは、それが不要なものにあります。サンプル証明書をアップロードしてフィールドにラベルを付けるトレーニングフェーズはありません。保険証券番号の周りにボックスを描くテンプレートビルダーもありません。証明書の束をアップロードし、出力に必要な列名(「被保険者名」「保険種別」「保険証券番号」「GL 1回あたり発生額」「GL総合限度額」「満了日」「AM Best格付け」「控除額/自己負担額」)を入力するだけで、AIがすべての文書を読み取り、それらのフィールドがどこにあっても特定します。出力は、各証明書が行、各フィールドが列となる1つのスプレッドシートです。
300枚の保険証券からカバレッジマトリックスへ:抽出ワークフロー
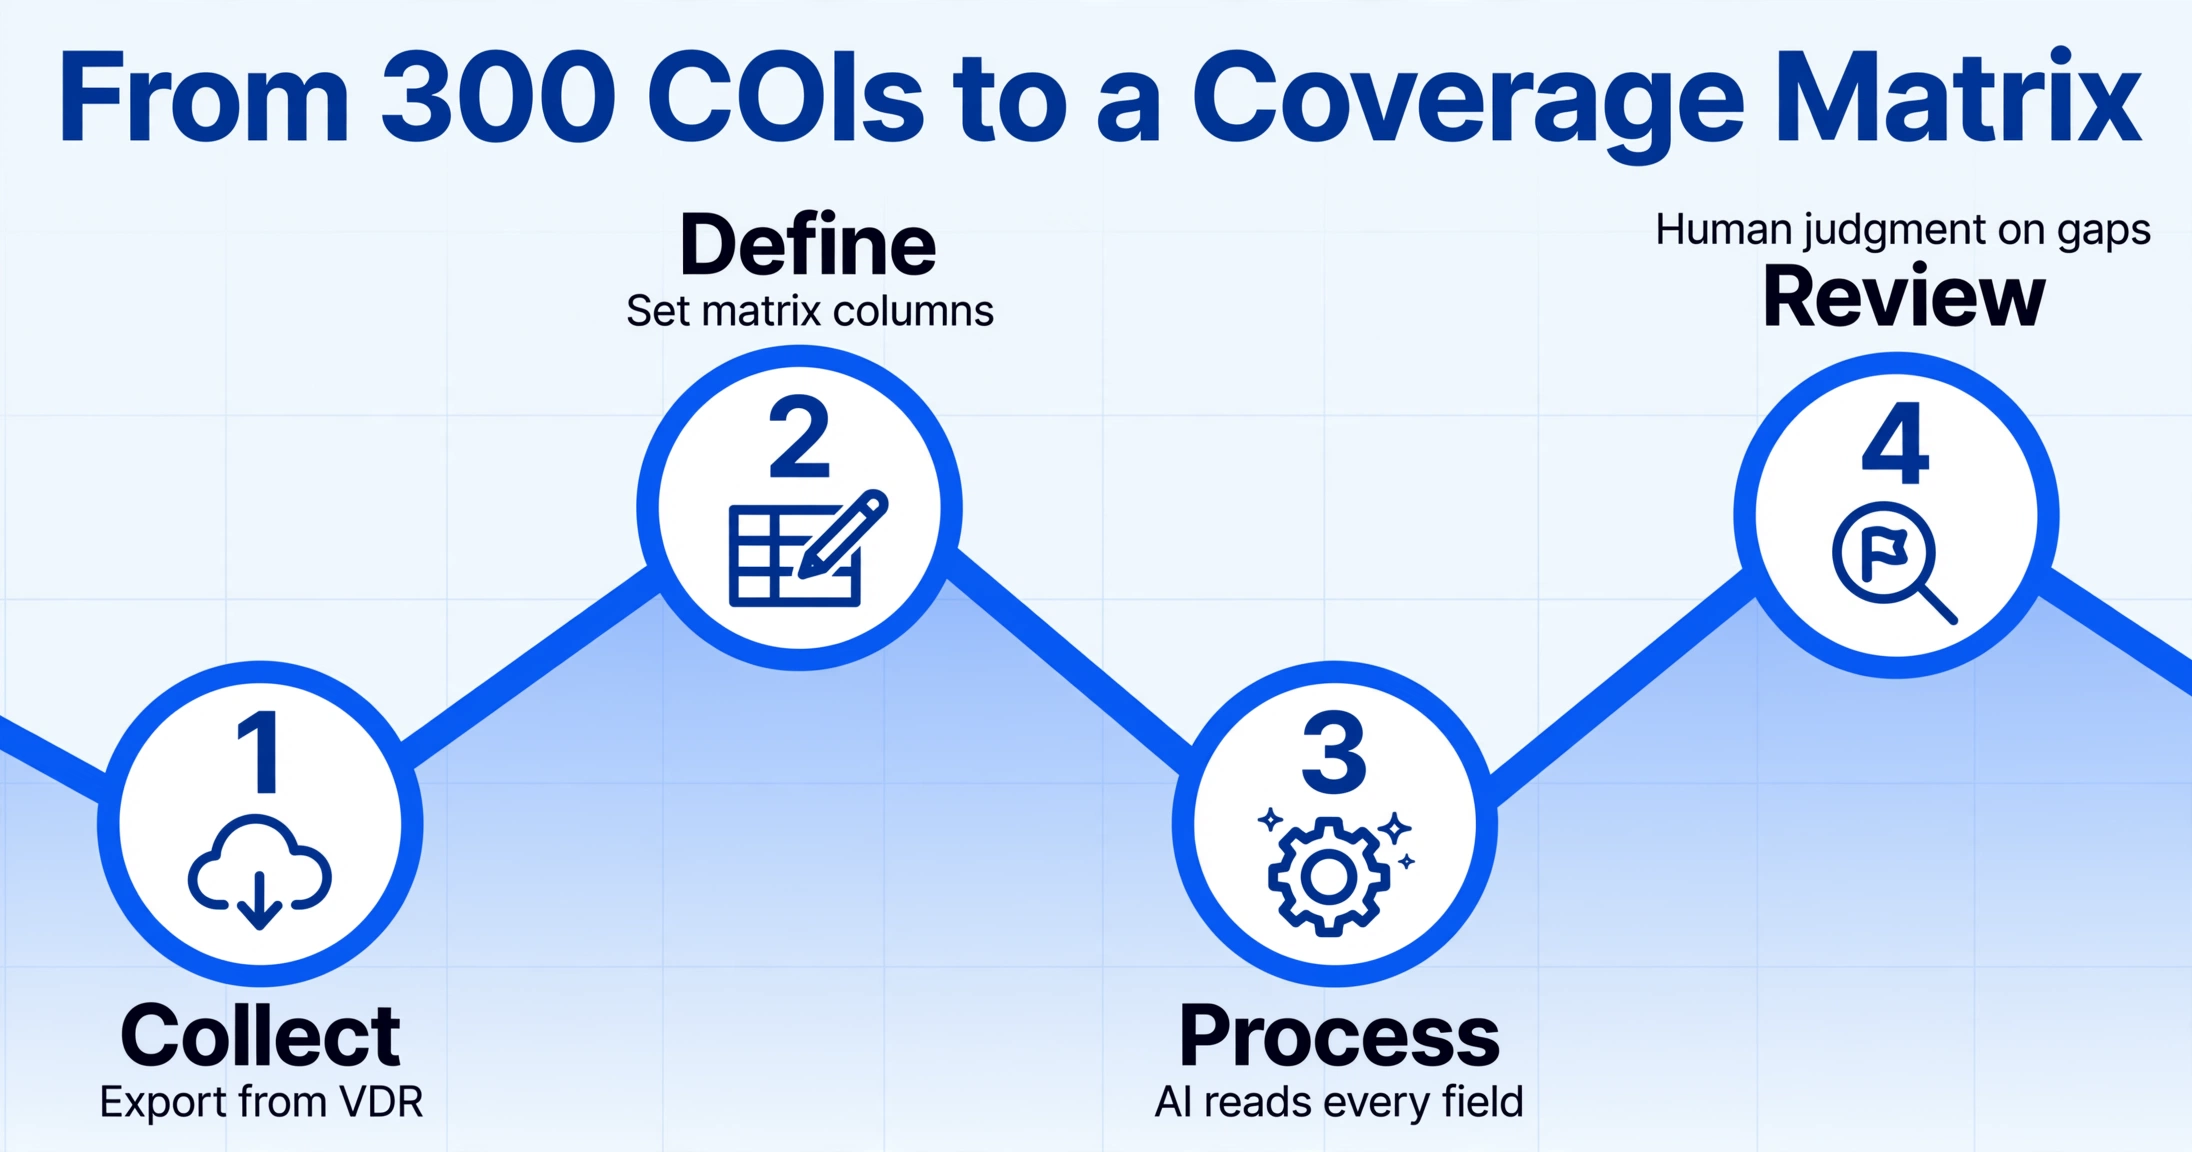
取引ルームの保険フォルダーからカバレッジマトリックスへのワークフローは、5つのステップで構成されています。抽出ツールはステップ2から4を担当し、レビュアーの判断はステップ5で重要となります。
ステップ1 — 保険証券を収集します。 仮想データルームから保険フォルダーをエクスポートします。ほとんどのVDRプラットフォーム(DealRoom、Datasite、Intralinks、Ansarada)では、フォルダー単位での一括ダウンロードが可能です。保険証券は通常PDFで届きますが、ターゲット企業のブローカーが転送したメールチェーンにスクリーンショットとして埋め込まれている場合もあり、その場合は個別の画像ファイルとして抽出する必要があります。
ステップ2 — 列を定義します。 ここでM&Aの文脈が、建設コンプライアンス追跡ツールとは異なる出力を生み出します。「最低限度額を満たしているか(Y/N)」ではなく、カバレッジマトリックスを構成するフィールドが列となります:被保険者、プロデューサーまたは代理店、保険会社名、保険会社NAIC番号、AM Best格付け、保険種別、保険証券番号、発効日、満了日、クレームメイド表示(Y/N)、一般賠償責任(1事故あたり)、一般賠償責任(総合)、アンブレラまたは超過賠償(1事故あたり)、アンブレラまたは超過賠償(総合)、控除額または自己負担額、追加被保険者(Y/N)、代位放棄(Y/N)、解約通知、保険証券保有者。
ステップ3 — アップロードして処理します。 すべての保険証券をアップロードエリアにドラッグします。ツールはそれらを並列処理します — バッチファースト処理により、1つ目の処理が完了するのを待つことなく次の処理が開始されます。300枚の保険証券の場合、処理時間はツールの同時実行数に依存しますが、AIベースの抽出ツールは各保険証券を5〜10秒で処理し、完全な抽出実行は約25〜50分で完了します。15時間の手動転記と比較すると、このツールは単に速いだけでなく — レビュアーを、これまでデータ入力に妨げられていた分析作業に解放します。
ステップ4 — カバレッジマトリックスをエクスポートします。 出力は、各保険証券が1行に対応するExcelファイルです。満了日で並べ替えると、クロージング前に満了する保険が確認できます。AM Best格付けで並べ替えると、買い手のリスク閾値を下回る保険会社を特定できます。保険種別でピボットすると、ターゲット企業が買い手の業界が期待するすべての補償ラインを保有しているかどうかを確認できます。マトリックスは成果物ではなく、ステップ5のカバレッジ分析への入力です。
ファイルは安全に処理され、保存されることはありません。
ステップ5 — 補償ギャップを分析する。 ここでレビュアーの判断が不可欠になります。マトリックスはどのような補償が存在するかを示しますが、どの補償が欠けているかは示しません。製造業の対象企業に製造物賠償責任保険がない場合、またはSaaS企業にサイバー補償がない場合、マトリックスはそのギャップを可視化しますが、解釈はしません。レビュアーはマトリックスを業界標準の補償期待値と比較し、各証明書の背後にある保険約款を検討し(証明書は保険の証拠であり、保険そのものではありません)、購入契約の開示スケジュールに記載すべきギャップを特定します。
抽出でできないこと(そして依然として人間が必要なこと)
ツールにできないことを明確にすることは、できることを説明するのと同じくらい重要です。抽出完了後も、以下の3つの事項は明確に人間のレビュアーの領域に残ります。
補償の十分性評価。 抽出では、1事故あたり200万ドルの限度額の保険が存在することがわかります。200万ドルで十分かどうかはわかりません。GL補償が200万ドルの化学メーカーは、業界基準に照らして補償不足です。同じ限度額のソフトウェア企業はそうではありません。その判断には、対象企業の業界、事業リスク、請求履歴に関する知識が必要です — これらは抽出ソフトウェアにはありません。
担保の解釈。 COIに証明書保持者が追加被保険者であると記載されていても、特定の担保フォームが重要です。CG 20 10担保は進行中の事業についてのみ追加被保険者をカバーします。CG 20 37は完成した事業にまで補償を拡大します。CG 20 33は、指名被保険者が契約上補償義務を負うあらゆる事業体に対して自動的に追加被保険者ステータスを提供します。抽出ではチェックボックスがチェックされていることを検出できますが、保険に組み込まれた基礎となる担保文言を読むことはできません。担保は証明書にはなく、証明書が要約する保険証券文書にあるからです。
ギャップから表明保証への変換。 取引弁護士が保険デューデリジェンスにもたらす最も価値のあるスキルは、データ抽出ではなく、補償ギャップを特定の契約上の保護に変換することです。役員賠償責任保険の延長報告期間補償のギャップは、売り手がクロージング前に6年間の延長報告期間保険を購入することを要求する誓約になります。格付けの低い保険会社は、すべての保険がAM BestでA-以上の格付けの保険会社に付保されるという表明保証になります。無保険のバランスシートエクスポージャーを生み出す免責金額構造は、特別補償になります。抽出はギャップを明らかにするデータを生成します。弁護士はそれに対する取引条件を生成します。
抽出作業はレビューチームを不要にするのではなく、むしろ迅速化します。その価値は人間の判断を代替することではなく、人間の判断に十分な時間を割けなくしている転記作業を排除することにあります。
RWIファクター:今、保険デューデリジェンスがより重要である理由
表明保証保険(RWI)—— 購入契約における売主の表明と保証の違反による損失を補償する保険——は、現在、プライベートエクイティのM&A取引の推定75%、大規模な戦略的買収の64%で利用されています。RWIは、保険デューデリジェンスの計算式を決定的に変えます。RWI引受会社は、補償を拘束する前に買主のデューデリジェンスプロセスを審査します。買主の保険レビューが表面的で、300通中20通の証明書を開封して完了とした場合、引受会社は買主が適切なデューデリジェンスを実施しなかったとして、保険関連の損失をRWIの補償対象から除外することができます。
これにより、デューデリジェンスのフィードバックループが生まれます。証明書をより徹底的にレビューすればするほど、RWIの補償範囲は強化されます。保険レビューを省略したりサンプリングしたりすることは、補償のギャップが発見されないままになるだけでなく、買主がクロージング後の驚きから守るために購入した保険そのものを危険にさらします。IBA企業・M&A法委員会と協力して発行されたIBA法的デューデリジェンスハンドブックは、不十分な保険デューデリジェンスを買主に対する取引後責任の原因として特定し、「ターゲットが適切な保険契約を購入していないことは、取引後の責任につながる可能性がある」と指摘しており、買主のデューデリジェンスが不十分な場合、RWIがこれをカバーしない可能性があります。(IBA法的デューデリジェンスハンドブック)
この環境において、問題はすべての証明書をレビューするかどうかではなく、ツールが数秒で処理できるデータ入力を可処分時間で消費することなく、完全にレビューする方法です。上記の抽出ワークフローは、フォルダ内のすべての証明書からレビュー可能なマトリックスを生成します。RWI引受会社は、買主がサンプルではなく全母集団をレビューしたことを確認します。表面化したギャップは、見落としではなく、意図的な調査結果です。
FAQ:M&AデューデリジェンスにおけるCOI抽出
一般的なM&A保険デューデリジェンスでは、何件のCOIを扱いますか?
従業員300~800名で複数州に事業展開するミッドマーケットの対象企業の場合、データルームの保険フォルダには通常200~500件の証明書が含まれます。これにはプライマリ層保険、アンブレラ・超過保険、対象企業が資格を有する複数管轄区域向けの州固有届出書類が含まれます。国際事業、複数の子会社、または厳格な規制産業を有する大規模な対象企業では、1,000件を超えることもあります。
COIの半数が地域代理店による非標準フォーマットの場合はどうなりますか?
フィールドの位置ではなく意味で読み取るセマンティック抽出は、代理店ごとの設定なしで非標準の証明書を処理します。標準的なACORD 25であれ、地域の超過保険ブローカーによる独自様式であれ、AIは記憶された座標ではなく、セマンティックな役割(例:「これは証券番号」「これは満期日」)に基づいてフィールドを識別します。テンプレートの作成やトレーニングデータの提供は不要です。
COI書類に対するAI抽出の精度はどの程度ですか?
標準的なACORD様式の印刷テキストでは、90%台後半の精度を達成します。手書きの注釈、大きく傾いたスキャン、水濡れした紙の証明書では精度が低下します。これらは人間が読むのも困難にする要因と同じです。当社の記事「AIはCOI書類を読み取れるか」では、フォーマット別の精度の内訳を詳しく説明しています。デューデリジェンスの目的において、実用的な比較は「抽出 vs. 完璧」ではなく、「抽出 vs. その日の187枚目の証明書を確認しているレビュアー」です。
RWI引受会社は、デューデリジェンスの一環としてAI抽出された保険データを受け入れますか?
RWI引受会社は、使用された特定のツールではなく、買い手のデューデリジェンスプロセスの徹底性を評価します。フォルダ内のすべての証明書を網羅する抽出マトリックスは、保険ポートフォリオの完全なレビューを示します。引受会社にとって重要なのは、買い手が全母集団をレビューし、重要なギャップを特定したかどうかです。データ入力を迅速化したツールは、デューデリジェンスの質を低下させるものではなく、レビューチームが取引スケジュール内でカバーできる範囲を拡大するものです。
データルームのOCR検索でCOIのキーワードを探せば十分ではないか?
DatasiteやIntralinksなどのVDRプラットフォームは、OCRによる全文検索を全ドキュメントに対して提供している。これは「Chubb」や「AIG」に言及するすべての証明書を見つけるのに役立つが、構造化されたマトリックスは生成しない。「General Liability」を含む47件の文書という検索結果は、その用語がどこに出現するかを示すが、47件の保険証券それぞれの1事故あたりの限度額を列に表示するわけではない。全文検索は文書の特定に役立つ。抽出は文書を分析可能なデータセットに変換する。
クレームズメイドの保険証券にテール補償が必要かどうか、抽出で判断できるか?
抽出は、どの保険証券がクレームズメイドか(証明書の「Claims-Made」チェックボックスや表示を読み取ることで)および発生ベースかを識別できる。テール補償が必要かどうかを判断することはできない。それは、取引の構造、保険証券の遡及日、対象会社のクレーム履歴、買い手のリスク許容度に基づく判断である。抽出はマトリックスに「クレームズメイド」の列を提供する。取引弁護士がその列を読み、どのラインにテール補償の予算計上が必要かを判断する。