ACORD 140請求急増
ハリケーンシーズン前に備える方法
ハリケーン・イアンは2022年9月に上陸し、フロリダの保険会社は1週間で50万件以上の不動産請求を受けました。50人の調整士が5,000件の商業請求に対応。FNOLキューは72時間を超えて滞留。そして、各請求ファイルの中心にあるのはACORD 140の不動産セクションです。COPEデータ、補償限度額、控除額、所在地スケジュールの40フィールドが、トリアージの優先順位、調整士の割り当て、準備金の設定を決定します。ボトルネックは損害評価ではありません。フォームからデータを取得し、請求システムに十分な速さで入力して、規制上の時計に間に合わせることです。フロリダでは現在、保険会社に受領確認のための猶予が14日ではなく7日間与えられています。
重要ポイント
- ハリケーン・イアンにより、フロリダの保険会社には1週間で50万件の不動産請求が殺到しました。そして、すべての請求ファイルにはACORD 140フォームが含まれており、その40のCOPEフィールドを、調整士が損害評価を開始する前に誰かが手作業で再入力する必要がありました。
- 災害急増時のボトルネックは、調整士の人数や評価スキルではありません。500フォームの受付時にチームが費やす100時間の機械的なデータ再入力です。誰も補償判断を下す前に、この作業が発生します。
- 2〜3週間のセマンティック抽出パイプラインにより、データ再入力のステップを完全に排除できます。フォーム上の位置ではなく、必要なフィールド値を定義するだけで、構造化された出力を既存のGuidewireまたはDuck Creekシステムに直接供給できます。
50倍の急増:ハリケーン上陸時、保険金請求業務に実際何が起きるのか
通常時の商業物件保険金請求業務は、予測可能なリズムで進む。中規模の地域保険会社であれば、50人のアジャスターで1日あたり約100件の請求を処理する。複雑さにもよるが、1人あたり2~5件程度だ。ACORD 140フォームが届けば、誰かが主要項目(所在地、構造種別、補償限度額、免責額構成)を抽出し、Guidewire ClaimCenterやDuck Creek Claimsに入力し、ファイルを割り当てる。フォーム1件あたり、手動データ入力に10~15分かかる。
そこにハリケーンが襲来する。
ハリケーン・ミルトン(2024年)は、約18万7000件の物件保険金請求を発生させ、総額26億8000万ドルの再調達費用を生み出した。Veriskの2025年ClaimSearch Trends Reportによると、数カ月経過後も8%が未処理だった。ハリケーン・イアンは、フロリダ州で1週間以内に50万件以上の物件保険金請求を発生させた(災害請求プラットフォームRegureのデータによる)。冬の暴風雨ウリ(2021年)は、テキサス州で72時間以内に40万件以上の請求を生み出した。パターンは繰り返される。名前のついた嵐が上陸すると、48時間以内に請求件数は通常業務の10倍から50倍に跳ね上がる。
通常の50倍の件数になると、保険金請求の計算は破綻する。50人のアジャスターが5000件のACORD 140フォームを処理する場合、1人あたり100件のフォームとなる。1件12分として、損害写真を確認する前に、1人あたり20時間もの純粋なデータ入力が必要になる。FNOL受付ラインは72時間以上滞留する。アジャスターには、作業負荷のバランス調整なしにランダムに請求が割り当てられる。誰が何を担当しているか把握できないため、フォームは未処理のまま山積みになる。
そして、この急増に対応する人々は、その影響を痛感している。ある災害デスクのアジャスターはRedditでこう述べている。「悪い嵐が一つ来るだけで、すべてが終わる」。別の、入社18カ月の保険金請求担当者はこう投稿した。「アジャスターとして常にストレスが溜まっている」。高件数を扱うアジャスターのスレッドでは、新たな常態がこう捉えられている。「全体的な件数が急増している」。
これは人員の問題ではない。ハリケーン予報から上陸までの72時間で、200人の臨時アジャスターを採用・訓練することは不可能だ。これはデータ入力の問題である。ACORD 140フォームは、所在地スケジュール、構造分類、防火設備、補償選択、免責額にわたる40以上のデータ項目を持ち、それがボトルネックとなる。COPEデータの再入力に費やす1分1秒は、実際の保険金請求判断(補償分析、支払備金設定、アジャスター派遣)に使えない時間なのだ。
規制上の時計が手動トリアージをコンプライアンスリスクにする理由
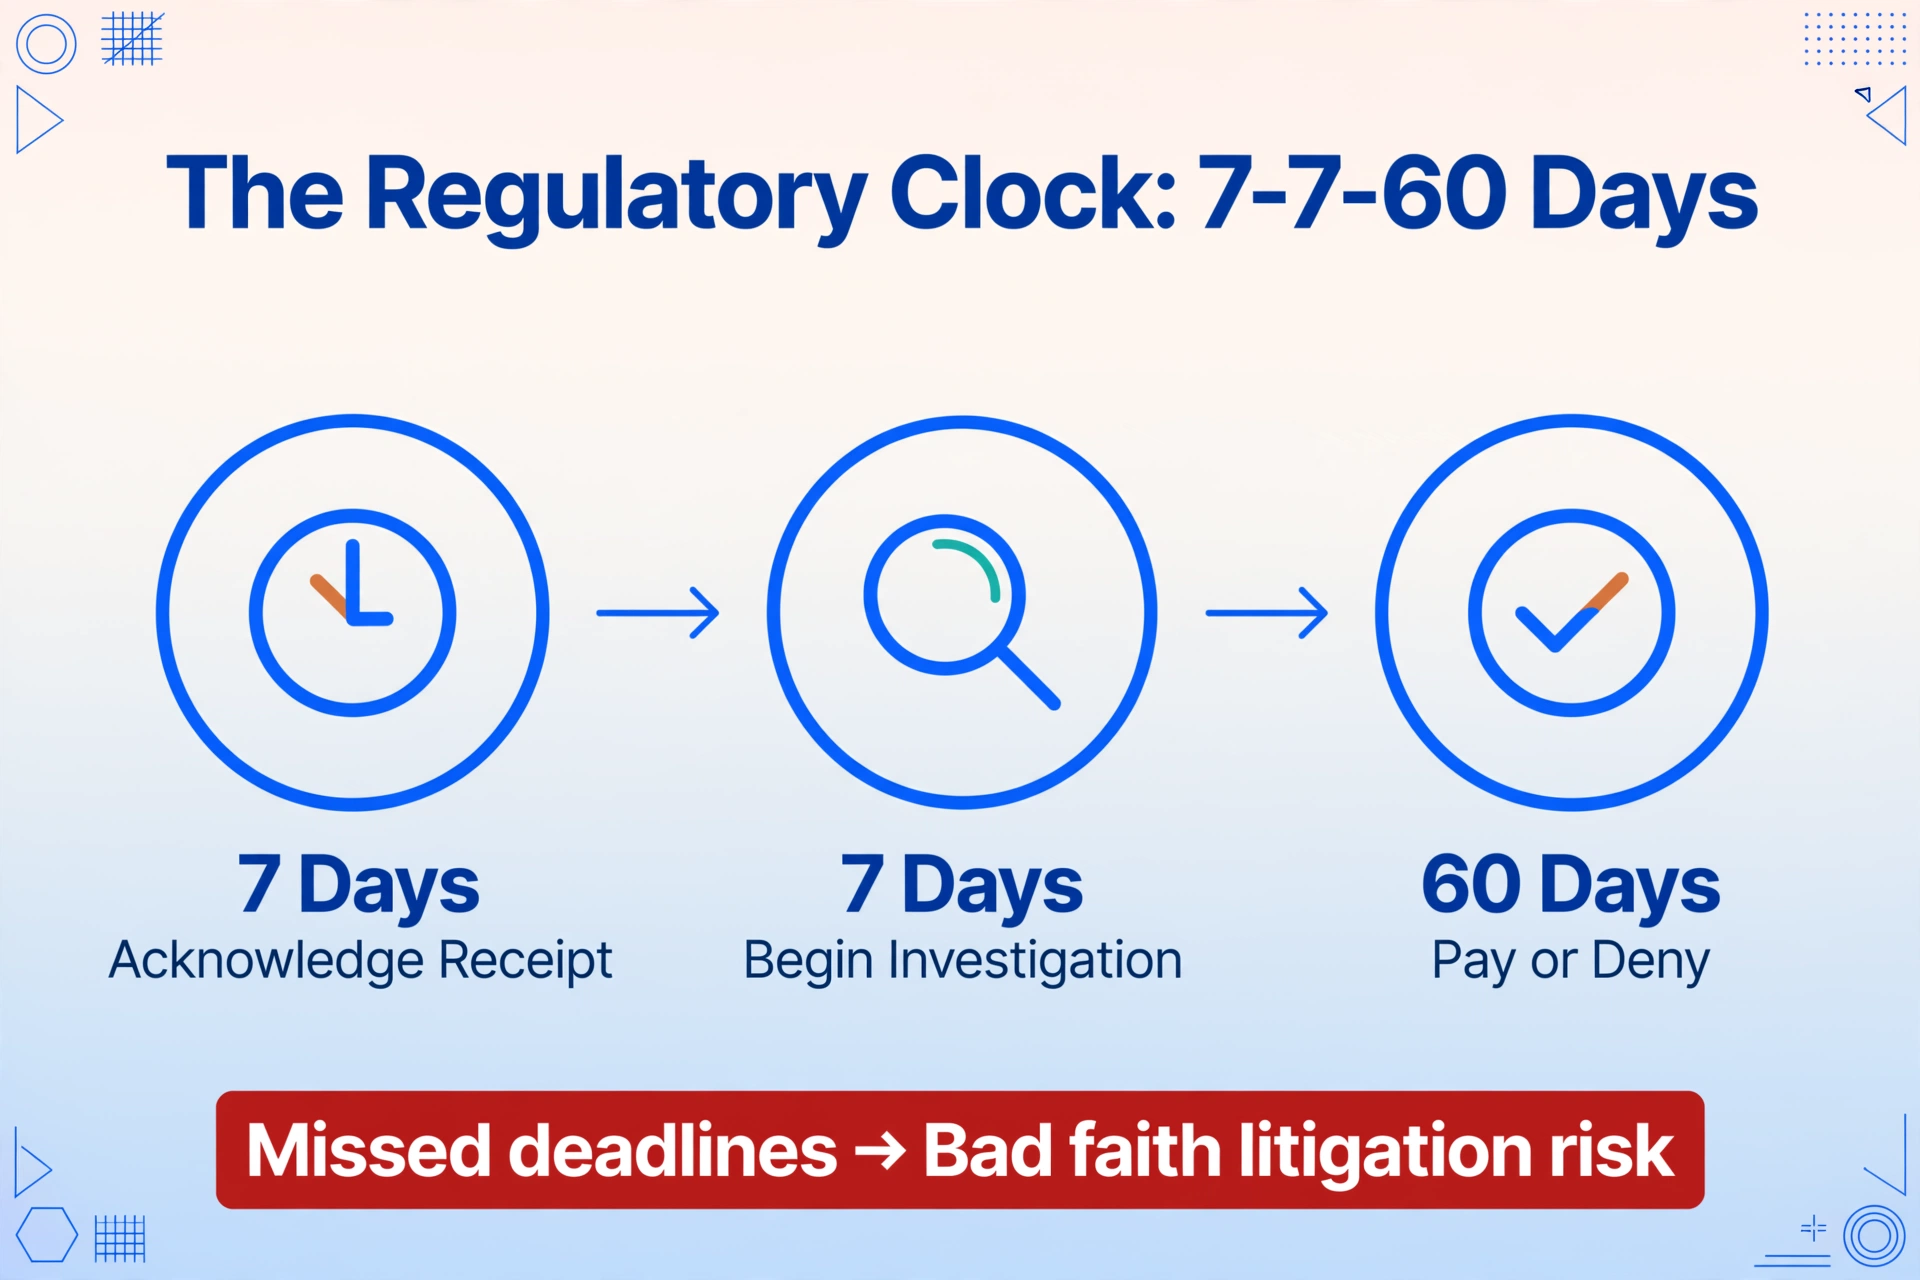
スピードが重要なのは、業務上の理由だけではありません。州の保険局は請求処理に厳格な期限を課しており、その期限は短くなっています。
フロリダ州の上院法案2-A(2023年3月施行)は、フロリダ州法627.70131に基づく不動産保険請求のスケジュールを書き換えました。保険会社は現在、請求の受領確認に7暦日以内(従来は14日)で対応する必要があります。損失証明書の受領後、調査開始まで7日(従来は14日)です。調査完了から支払いまたは拒否までの期限は60日(従来は90日)に短縮されました。宣言された緊急事態中は、90日以内に支払いを行う必要があります。これらはガイドラインではありません。強制力のある規制要件であり、フロリダ州保険規制局は違反があった場合、保険会社の免許を停止する権限を持っています。
これらの期限下での大災害時の請求急増の計算は容赦ありません。1週間に5,000件の請求が到着し、それぞれACORD 140だけで10〜15分の手動データ入力が必要で、さらに実際の調査も行う必要があります。そして、すべての請求を7日以内に受領確認しなければなりません。手動フォーム処理を中心に構築された請求ワークフローを持つ保険会社は、50倍のボリュームで期限を守ることは構造的に不可能です。
期限を逃すと何が起こるのでしょうか。保険契約者の苦情が急増し、保険局の監視が強化されます。悪意のある訴訟リスクが高まります。そして、保険会社が法定期間内に請求を処理できないことを実証できれば、原告側弁護士には明確な論拠が生まれます。Millimanの大災害時の需要急増に関する分析では、複合的な影響が指摘されています。請求処理の遅延は「時間の経過とともに請求コストの増加と関連する」のです。フォームを十分な速さで処理できない保険会社は、規制上のリスクに加えて、1件あたりの支払い額も増えてしまいます。
ACORD 140は、このボトルネックの中心です。トリアージ、調整担当者の割り当て、補償範囲の確認、積立金の見積もりなど、下流のすべての意思決定を左右する構造化された不動産データを保持しているからです。このデータを数時間ではなく数分でシステムに取り込むことは、効率化ではなく、規制上の生存を意味します。
一括抽出パイプラインの構築:7ステップの準備チェックリスト
目標は明確です。ハリケーン後に500件のACORD 140フォームが受付キューに届いたとき、それらが構造化されたスプレッドシートに流れ込むようにすることです。すべてのCOPEデータ、すべての補償限度額、すべての所在地スケジュールが各フォームから1時間以内に抽出され、調整士が1人もPDFを開くことなく処理されます。次の嵐が来る前に、その能力を構築する方法をご紹介します。
単一のACORD 140フォームの抽出の詳細な手順(どのフィールドを取得するか、AIがCOPEデータ構造をどのように解釈するか、出力がどのようなものか)については、ACORD 140不動産損失通知データをExcelに抽出するための併用ガイドをご覧ください。この記事では、単一フォームの抽出機能をすでにお持ちであることを前提に、災害規模に拡大したときに何が変わるかに焦点を当てます。
ACORD 140フォーマットのバリエーションを監査する
データ抽出の前に、抽出対象を把握する必要があります。自社のポートフォリオから、全MGA、全保険会社、全州にわたって200件のACORD 140フォームをサンプル抽出してください。フォーマットのバリエーションをマッピングします。デジタル入力されたPDFか、スキャンされた紙か?保険会社によって異なるバージョンのフォームを使用しているか?手書きの注釈は一般的か?この監査により、必要な抽出テンプレートの数と、パイプラインが手書き認識を処理する必要があるかが明らかになります。手書き認識は、テンプレートベースのOCRツールでは通常対応できない処理次元を追加します。
クレームトリアージ抽出スキーマを定義する
ACORD 140のすべてのフィールドが災害トリアージに重要なわけではありません。クレームオペレーションが最初の1時間に実際に必要とするものを捉えるスキーマを定義します。被保険者名、所在地住所、建物構造種別(ISOクラス)、築年数、総床面積、建物価額、事業用動産価額、損失原因(基本/包括/特別)、風災・雹災免責額、その他危険免責額、スプリンクラー割合、保護クラス、および所在地固有の備考。このスキーマが抽出テンプレートとなり、AI抽出エンジンに投入する列名になります。スキーマに追加するフィールドごとに、バッチ全体で三角測量されるデータポイントが増えます。
カスタム列抽出テンプレートを構築する
ここでImageToTable.aiの中核機能であるカスタム列抽出が本領を発揮します。フィールドの周りにボックスを描画するテンプレート(異なる保険会社のACORD 140でレイアウトが少し異なるだけで機能しなくなる)ではなく、抽出したい列名(「建物価額」「風災免責額」「構造種別」)を定義します。AIは、フィールドがページ上のどこにあるかではなく、意味的に何を表すかを理解することで、各フォーム上の値を特定します。出力を定義するのはあなた。入力を処理するのはAIです。この意味論的アプローチにより、ステップ1で見つかったACORD 140フォーマットのバリエーション(異なる保険会社のレイアウト、異なるPDFレンダリング、スキャンとデジタル)全体で、単一の抽出テンプレートが機能します。テンプレートはフォーマットに依存しません。
クレームシステムとの連携ポイントを設計する
一括抽出の構造化出力は、チームが既に使用しているシステムに取り込める必要があります。Guidewire ClaimCenterやDuck Creek Claimsをご利用の場合、抽出データは構造化されたスプレッドシート(ExcelまたはCSV)として出力され、クレームシステムの取込モジュールにインポートできます。ステップ2の列名は、ClaimCenterのFNOL受付画面やDuck Creekのクレーム作成ワークフローの該当フィールドに直接マッピングされます。Xactimateユーザーの場合、抽出された建物評価額、構造種別、延べ床面積、建築年が物件査定ワークフローに直接連携され、クレーム受付から初回見積もりまでの時間を短縮します。連携レイヤーはスプレッドシートのインポートであり、API構築ではありません。これにより、数ヶ月ではなく数日で導入が可能になります。
乾季にベンチマークテストを実施する
ハリケーンシーズンが始まる前に、自社の保有契約から実際のACORD 140フォーム100件を使用してベンチマークを実施します。これらを一括アップロードし、アップロード→抽出→出力スプレッドシートまでの全サイクルを計測します。抽出精度は、20件のフォームから無作為に20フィールドを抽出して検証します。エッジケース(手書き部分、複数拠点のスケジュールが複数ページにわたるケース、標準外の控除額体系など)を文書化します。このベンチマークにより、「準備完了」の基準値が得られると同時に、実際の需要急増前に解決すべきフォーマットの問題を早期に発見できます。このテストは四半期ごとに実施し、新たなキャリアフォームのバージョン、MGAフォーマットの変更、PDFレンダリングの更新などの変化を検出します。
災害時アクティベーションプレイブックを作成する
乾季テストで機能するパイプラインも、起動手順が誰にも分からなければ災害時には機能しません。プレイブックに以下を文書化します:抽出ツールへのアクセス権限者(クレーム受付チームリーダー+指名されたバックアップ)。フォームファイルの保存場所(共有ドライブ、メール取込フォルダ、またはFNOLシステムのエクスポート先)。バッチ名の命名規則(トレーサビリティのため「嵐の名前-日付」の形式)。トリアージ用スプレッドシートの出力形式と受信者。抽出例外の処理方法(抽出に失敗したフォームは、黙って破棄せずに手動レビュー用にフラグを立てる)。ハリケーン警報が発令された際に、どのクレームスーパーバイザーでも従える1ページのPDF。プレイブックこそが、技術的な能力を運用能力に変えるものです。
アジャスターに新しいトリアージワークフローをトレーニングする
このパイプラインを使用するアジャスターは、何が変わったのか、変わらなかったのかを理解する必要があります。変わったこと:個別のACORD 140 PDFを開いて物件データを再入力する必要がなくなりました。代わりに、すべてのフォームが抽出・整理された事前入力済みのトリアージスプレッドシートを受け取ります。変わらないこと:補償判断、準備金の設定、保険契約者との関係管理は引き続き行います。このパイプラインはデータ入力工程を排除しますが、判断工程には影響しません。プレシーズン準備週に30分のトレーニングセッションを実施してください。アップロード→抽出→トリアージスプレッドシート→最初のアジャスターアクションまで、バッチ全体を一通り体験させます。アジャスターが実際のワークフローを目の当たりにすると、「新しいテクノロジー」への抵抗は通常消え去ります。なぜなら、彼らが失うのは誰もやりたがらない仕事の部分だからです。
導入前と導入後:一括抽出の有無による500件の請求の違い
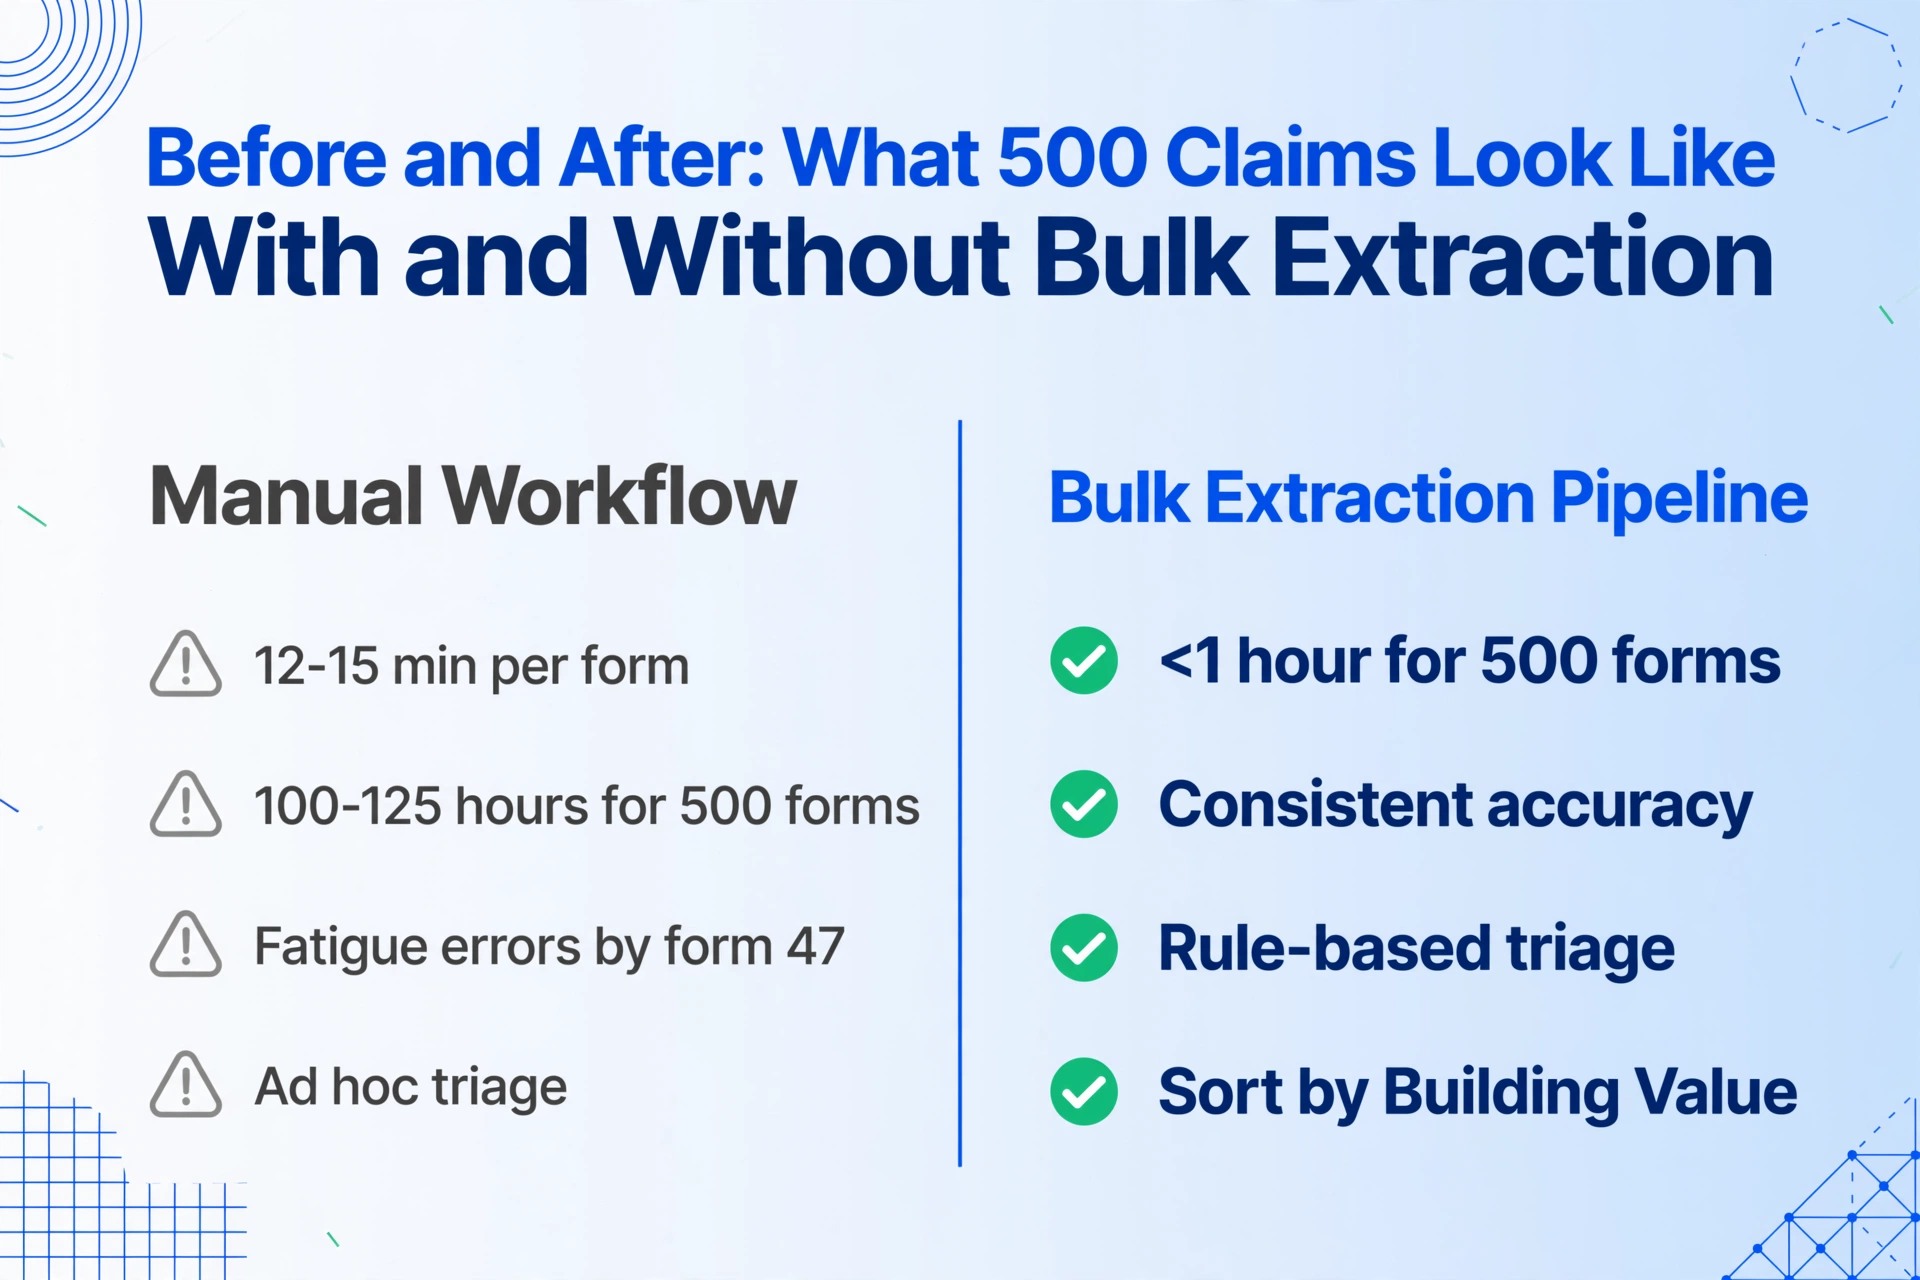
実際のACORD 140データ入力作業量に基づく、中規模保険会社の現実的なシナリオである500件の災害時急増に対する運用上の違いを数値で示します。
| 段階 | 手動ワークフロー | 一括抽出パイプライン |
|---|---|---|
| フォーム受付 | PDFがメール/FNOLシステムに届きます。整理はされていません。調整士が1件ずつ開きます。 | すべてのPDFが単一バッチとしてアップロードされます。処理が自動的に開始されます。 |
| データ抽出 | フォーム1件あたり12〜15分 × 500件 = 100〜125時間の手動再入力。10人の調整士で分担しても、1人あたり10〜12.5時間。実際の請求業務の前にかかります。 | AIがすべてのフォームを単一バッチで抽出します。500件が1時間未満で処理されます。すべてのスキーマフィールドが入力された構造化スプレッドシートが出力されます。 |
| エラー率 | ACORD 140の47件目あたりで疲労が生じます。構造種別「Joisted Masonry」が「Joisted Mason」になる——誤ったISO格付けにつながる誤分類です。控除額の桁の取り違え。補償限度額の読み間違い。 | AI抽出は500件すべてで一貫しています——疲労による変動はありません。スポットチェック検証でエッジケースを捕捉。大半のフィールドは500件目でも1件目と同じ精度で抽出されます。 |
| トリアージ | 場当たり的です。調整士がフォームを開き、建物価額と構造種別を読み、頭の中で優先順位を付け、次のフォームへ。体系的な優先順位付けはありません。 | 抽出されたスプレッドシートによりルールベースのトリアージが可能:建物価額の降順で並べ替え(最大エクスポージャーを最優先)、風災控除額 >$50Kでフィルタリング(詳細な確認が必要な高控除額の商業物件)、構造種別でグループ化(木造 = 高 severity リスク)。トリアージ判断が数時間ではなく数分で完了します。 |
| 規制コンプライアンス | 7日間の受領確認期限:5,000件 ÷ 50人の調整士 = 1人あたり100件。1件12分だと、7日間のうちに1人あたり20時間のデータ入力——さらに調査時間も必要です。期限に間に合わない請求も出ます。 | 500件すべてが受付から数時間以内にシステムで確認されます——フロリダ州の7日間の期限内に十分収まります。調整士はデータ不足ではなくデータ準備が整った状態から調査を開始できます。 |
この表では、二次的な影響である「アジャスターの定着率」が捉えられていません。アジャスターが災害対応の最初の20時間を、本来の業務(損害評価、準備金設定、保険契約者との対応)ではなく、ACORD 140フィールドの再入力に費やすと、バーンアウトが加速します。「悪い嵐が一度来るだけで埋もれてしまう」とCATアジャスターがRedditで語るのは、ハードワークへの不満ではありません。それは、存在すべきでない仕事が、判断に使うべき時間を奪うという、構造的な無駄についての指摘です。
既存のクレーム処理スタックとの連携
新しいクレーム処理ツールに対するよくある反対意見は、統合の摩擦です。「すでにGuidewireを使っている。それを置き換えるつもりはない」というものです。ここで説明する一括抽出パイプラインは、クレーム管理システムの代替品ではありません。システムの前、つまりデータ取り込みポイントに位置し、構造化データを既存のシステムに供給するレイヤーです。
最も広く導入されている3つのクレーム処理プラットフォーム(Guidewire ClaimCenter、Duck Creek Claims、Xactimate)は、共通のアーキテクチャパターンを共有しています。すなわち、手動入力またはAPI統合を通じて構造化データがシステムに入力されることを前提としています。通常時はこの前提は成り立ちますが、災害時のサージ時には、手動入力の帯域が不足し、すべての保険会社のフォーマットに対応したAPI統合が構築されていないため、機能しなくなります。
一括抽出はこのギャップを埋めます。出力は構造化されたスプレッドシートであり、あらゆるクレームシステムが取り込めるユニバーサルフォーマットです。Guidewire ClaimCenterの場合、抽出されたデータはFNOL取り込みフィールドにマッピングされ、システムの標準データインポートワークフローを介してインポートできます。Duck Creek Claimsの場合も、同じスプレッドシートがクレーム作成に供給され、フィールドマッピングは取り込み設定に一致します。Xactimateの場合、ACORD 140から抽出された建物特性(構造種別、延べ床面積、築年数、防火等級)は、不動産評価モジュールに直接供給され、クレーム作成から最初の見積もり作成までの時間を大幅に短縮します。
このアーキテクチャが重要なのは、抽出パイプラインをITプロジェクトなしで導入できることを意味するからです。API開発も、システム移行も、ベンダー調達サイクルも必要ありません。スプレッドシートのインポートパスは、主要なクレームプラットフォームすべてにすでに存在します。新しいコンポーネントは抽出ステップ自体だけであり、それは開発契約ではなく、Webインターフェースを通じて制御できます。
異なるACORDフォームタイプ(保険証券)についても、同じ一括抽出アプローチが、異なる検証ルールセット(契約要件に対する補償限度額のチェック、期限切れポリシーのフラグ付け、コンプライアンスダッシュボードの生成)で適用できます。この並行ワークフローについては、ACORD 25保険証券を契約限度額に対して一括検証するに関する記事をご覧ください。
シーズン間のメンテナンス:パイプラインを常に稼働可能に保つ
6月に完璧に動作していた一括抽出パイプラインも、実際にハリケーンが襲来する10月まで放置すれば機能しません。災害シーズンの合間には、パイプラインの意図的なメンテナンスが必要です。技術が劣化するからではなく、フォームやビジネス環境が変化するからです。
四半期ごとに実施すべき3つのメンテナンス活動:
1. フォームバージョンのドリフトチェック。保険会社はACORD 140テンプレートを更新します。新たなMGAが異なるPDFレンダリングエンジンで加入することもあります。Q1で正常に抽出できたフォームが、Q3では新しいフィールドレイアウトになっている可能性があります。四半期ごとに20~30件の最新フォームでベンチマークテスト(チェックリストのステップ5)を実施し、バージョンドリフトを本番直前で発見できるようにします。
2. 抽出スキーマのレビュー。ステップ2で定義したトリアージスキーマは、運用経験に応じて進化させる必要があります。各災害シーズン後、クレームチームは以下を確認します:トリアージに最も役立った抽出フィールドはどれか?抽出したが使用しなかったフィールドはあるか?優先順位付けを改善する新しいデータポイントはあるか?スキーマを更新し、ベンチマークを再実行し、プレイブックを更新します。
3. 担当者とアクセス権の監査。アクティベーションプレイブック(ステップ6)は、特定の権限を持つ特定の担当者に依存します。担当者の退職、役割の変更、パスワードの期限切れが発生します。四半期ごとに、指定された抽出オペレーターのアカウントが有効であること、ワークフローを把握していること、テストバッチを最初から最後まで実行できることを確認します。4月に主要オペレーターが退職した場合、ハリケーン上陸48時間前の6月2日にその事実を知ることのないようにします。
このメンテナンス作業は四半期あたり約3~4時間です。たった一度の規制期限の遅延や悪意のある保険金請求のコストと比較すれば、無視できる程度です。
よくある質問
スキャンされたACORD 140フォームや手書きのフォームでも機能しますか?
はい。ImageToTable.aiのAIモデルは、筆記体、活字体、混在文書を含む手書き文字認識でトレーニングされています。これは災害時のクレーム処理において重要です。なぜなら、中小の商業代理店は、カバレッジの変更、免責額の調整、場所のメモなど、手書き注釈が入ったスキャン紙のACORD 140を提出することが多いからです。デジタル入力されたPDFのみを処理するパイプラインでは、これらのクレームは取り残されます。セマンティックAI抽出は、ピクセルパターンの一致ではなく、フィールドの意味を理解することで、手書きも印刷テキストと同様に読み取ります。
抽出データはAPI経由でGuidewireやDuck Creekに直接連携できますか?
直接出力形式は構造化されたスプレッドシート(Excel/CSV)です。Guidewire ClaimCenterとDuck Creek Claimsはどちらも、標準機能としてスプレッドシートベースのデータインポートをサポートしており、カスタムAPI開発は不要です。プログラムによる連携が必要なチーム向けには、抽出データをJSON形式でエクスポートし、クレームシステムのAPIで利用することも可能です。アーキテクチャは両方の経路をサポートします。スプレッドシートインポートは最も迅速に導入でき、API連携は自動化を提供しますが、クレームシステム側での開発作業が必要です。
パイプラインをゼロから構築するにはどのくらいの時間がかかりますか?
ステップ1~3(監査、スキーマ定義、テンプレート作成)は、サンプルのACORD 140フォームにアクセスできる典型的な中規模保険会社の場合、おおむね1~2週間かかります。ステップ4~7(統合設計、ベンチマークテスト、プレイブック作成、トレーニング)にはさらに1週間かかります。合計:意思決定から運用準備完了まで2~3週間です。最もリードタイムが長いのは、通常、フォーム監査(ステップ1)です。これは技術的なセットアップではなく、ポートフォリオ全体から代表的なサンプルを収集する作業です。
保険会社がACORD 140ではなく非標準の財産損失フォームを使用する場合はどうなりますか?
抽出はテンプレートベースではなく意味論的に行われるため、定義されたデータフィールドを含むフォームであれば、標準のACORD 140、保険会社固有の財産補足、ブローカー作成の評価明細書のいずれでも、同じカラムスキーマが機能します。データの意味(建物評価額、構造種別、免責金額)に基づいて抽出を行い、特定のフォームテンプレート上の位置には依存しません。パイプラインはフォーマットのバリエーションに自動的に適応します。これはすべてのバッチ抽出ワークフローを支える同じメカニズムです。ドキュメントタイプ全体でのバッチ処理の仕組みの詳細については、バッチOCRとドキュメント抽出のガイドをご覧ください。
これはハリケーン請求のみに使用されますか?
同じパイプラインは、財産請求の急増を引き起こすあらゆる災害イベントに機能します。山火事(カリフォルニア州の保険会社)、竜巻の多発(中西部/南東部)、洪水(沿岸部および河川流域)、冬の嵐や氷結イベント(テキサス州、北東部)などです。ACORD 140は、ユニバーサルな商業財産データキャリアです。季節的な準備フレームワーク(監査、スキーマ、ベンチマーク、プレイブック)は、山火事シーズン(西部では6月~11月)、竜巻シーズン(南部では3月~6月)、冬の嵐シーズン(北部では11月~3月)に適用されます。具体的な規制上の期限は州によって異なります(テキサス州は受領確認に15日間、フロリダ州は7日間)が、運用上のプレッシャーは同じです。期限の時計が切れる前にデータを抽出することです。
これは、災害査定人を増やすのと比べてどうですか?
災害査定人の配置には、厳しい拡大限界があります。米国保険金請求専門家協会によると、米国には約12万5千人の保険金請求専門家がいます。大規模なハリケーンが発生すると、被災地域のすべての保険会社が、同じ限られた独立系査定人のプールを奪い合います。需要の急増により日当は高騰します。また、査定人を確保できたとしても、データ入力のステップ(ACORD 140のフィールドを請求システムに再入力する作業)は、査定人の専門知識の恩恵を受けません。これは機械的な作業であり、補償範囲の分析や準備金の設定に費やすべき時間を何時間も消費します。一括抽出パイプラインは、この機械的な部分を機械の速度で処理するため、現在いる査定人(社員、独立系問わず)は意思決定に時間を割くことができます。
シーズン間の準備期間は今です
大西洋のハリケーンシーズンは6月1日から11月30日までですが、準備期間は、名前のついた嵐がNHCの予報円錐図に現れた瞬間に終わります。この記事のチェックリストをゼロから実行するには、2~3週間かかります。つまり、次のハリケーンに備えてこの機能を構築するための期間は、今から次の6月1日まで、あるいはシーズン中にこれを読んでいるのであれば、今から次の熱帯低気圧が大西洋で発生するまでの間です。
大規模な災害対応を経験したことのある請求責任者なら誰でも、最初の72時間がどのようなものか知っています。未読メールの山。滞留するFNOLキュー。データ入力に追われるだけで1日16時間働く査定人。そして、一部の請求が規制上の期限に間に合わないという、沈むような現実。それは、悪意があるからでも、準備金が不十分だからでもなく、ACORD 140のデータを十分な速さで抽出できなかったからです。
そのボトルネックは解決可能です。準備期間は2~3週間。抽出テンプレートは1つ。500フォームのサージあたり、手動データ入力を7,500分削減。次のハリケーンは統計的に確実です。あなたの請求チームがACORD 140を数時間で処理するか、数週間かけるかは、嵐が来る前に行う選択です。