年間8万行を1枚のスプレッドシートに
年度横断分析のためのSPEDレイアウトファイルの一括処理方法
中規模のブラジル企業は、年間およそ8万〜15万行のデジタル会計帳簿(Escrituração Contábil Digital、ECD)データを提出します。3年間の比較期間では、パイプ区切りのRegistroコードが3つの別々のテキストファイルにまたがって25万行にもなります — それぞれがReceita Federalによる機械検証用に構造化されており、人間の分析用にはできていません。すべての行は必要なレコードになり得ます:試算表エントリ、仕訳行、またはe-Lalur税務調整です。しかし、複数年度にわたって必要な特定の勘定を抽出するには、各ファイルを開き、Registroコードでフィルタリングし、列を手動で整列させ、結果を新しいスプレッドシートに結合する必要があります。その作業は、誰かが年度横断の質問をするたびに繰り返されます。
この記事では、別のアプローチについて説明します。複数年にわたるSPEDファイルを単一のバッチとして扱い、出力列を一度だけ定義し、必要なデータだけを分析可能な1つのテーブルに抽出する方法です。ソースデータが2つのECDファイル、1つのECFファイル、または異なるLeiauteバージョンの3つの税年度にまたがる場合でも対応できます。このアプローチでは、すべてのRegistroタイプに対応するパーサーは不要です。年度をまたぎ、レイアウトバージョンをまたぎ、ECD↔ECFの境界も越えて機能します。
「一度に1ファイルを開く」方法が複数年分析に適さない理由
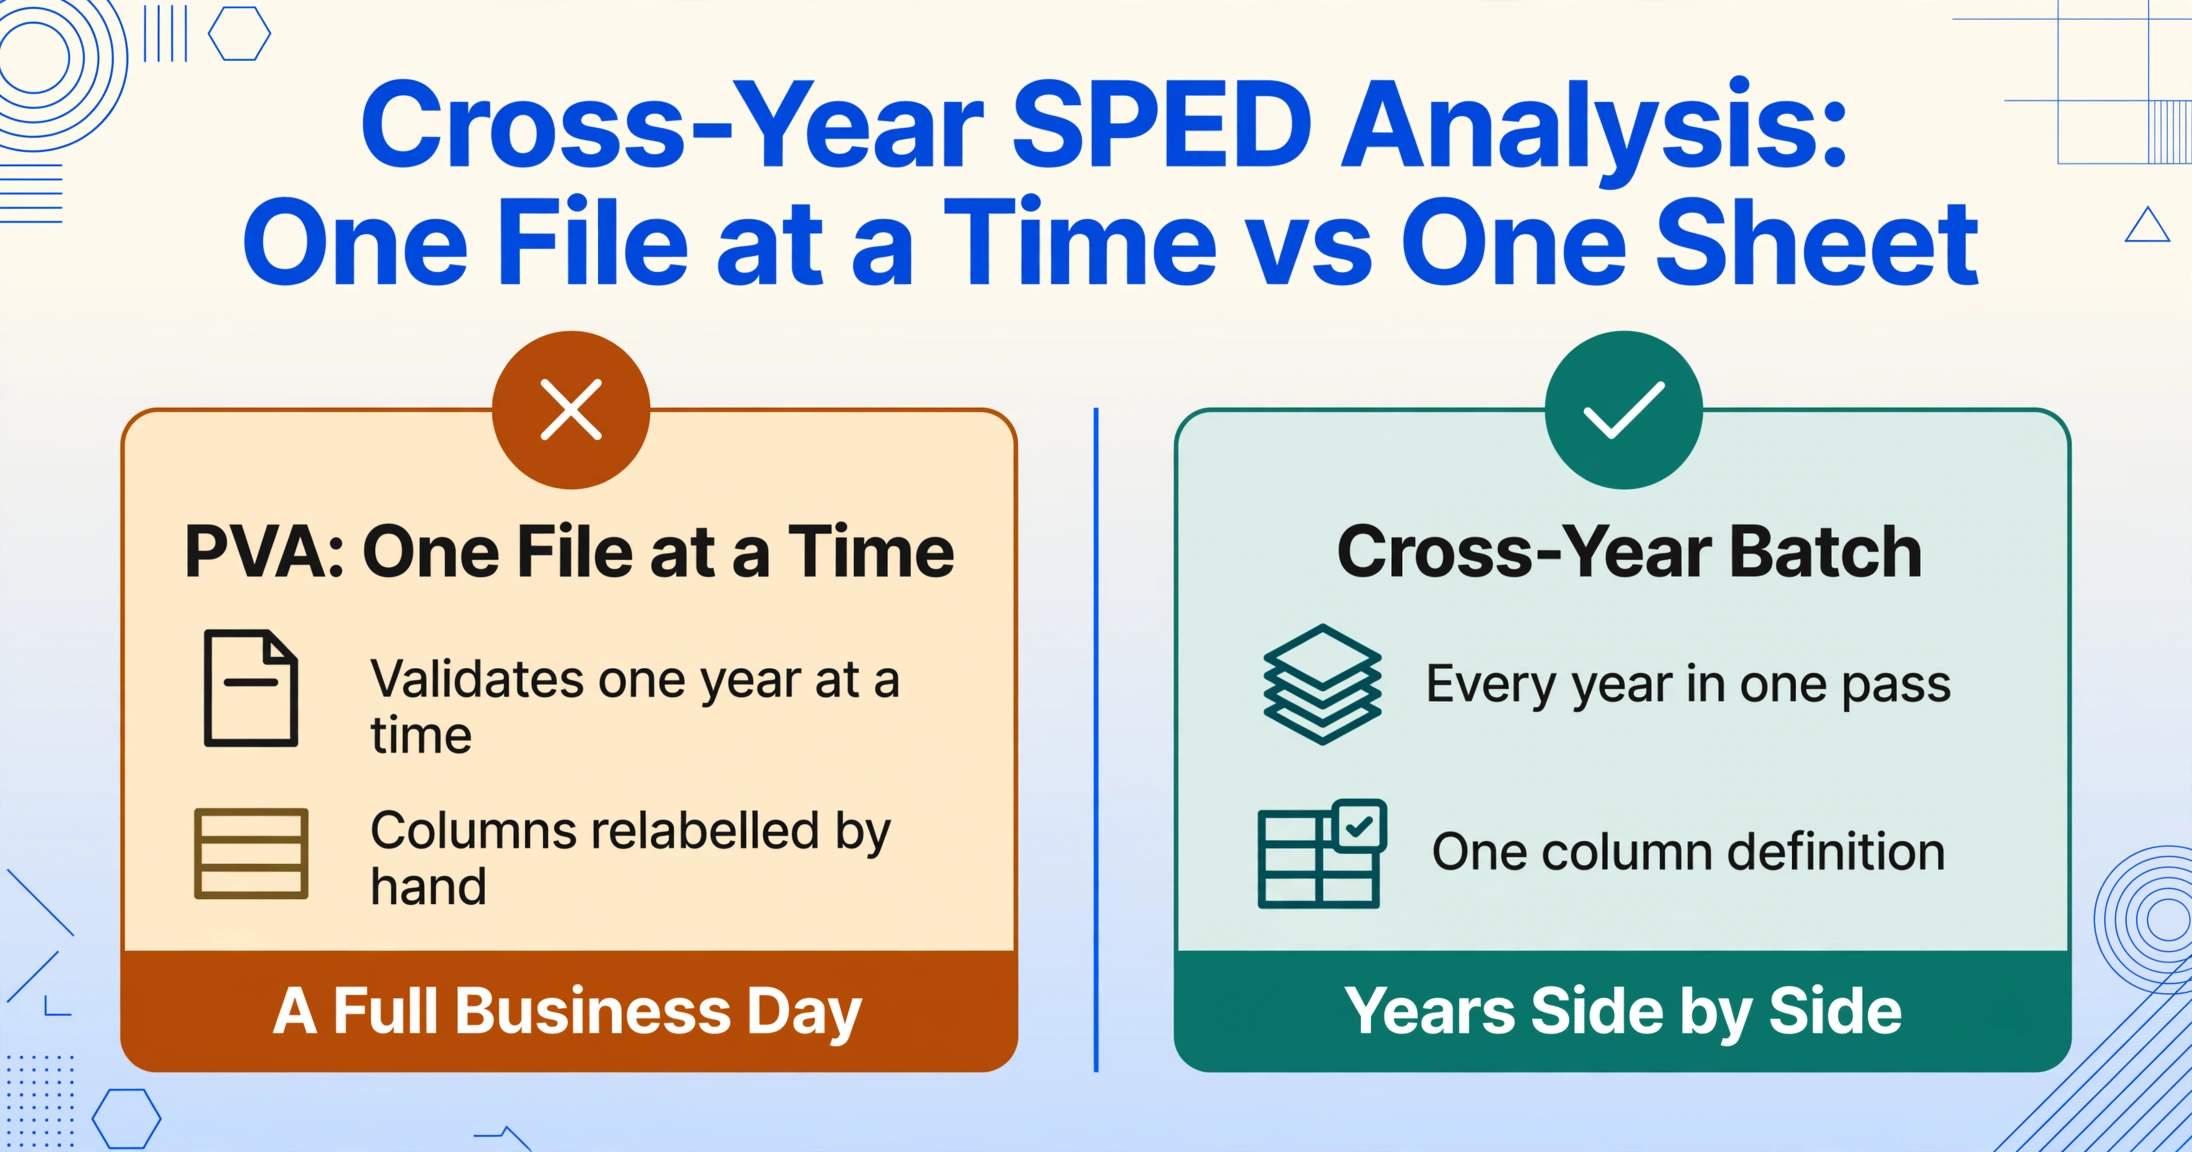
公的デジタル簿記システム(Sistema Público de Escrituração Digital、通称SPED)は、Receita Federalが会計記録を受け取るための単一の標準化されたパイプラインを提供することを目的として設計されました。その目的は達成されています。しかし、ある年度のデータを別の年度と比較するための組み込みメカニズムは提供されていません。各会計年度は独自のECDファイルと独自のデジタル税務簿記(Escrituração Contábil Fiscal、通称ECF)ファイルを生成します。検証・署名プログラム(Programas Validadores e Assinadores、PVA)は個々のファイルを検証して送信します。2つのファイルを並べて開くことはありません。
つまり、すべての複数年分析は同じ手動作業の流れをたどります。PVAからYear 1のECDをエクスポートし、Year 2のECDをエクスポートし、それぞれをExcelでテキストインポートウィザード(パイプ区切り)を使って開き、関連するRegistroコードでフィルタリングし、列名を付け直し(フィルタリングしたRegistroによって列の位置が変わります)、比較テーブルをゼロから作成し、ECFの税調整データについても同じ作業を繰り返します。この作業は技術的に難しいわけではありません。機械的に反復的で、エラーが発生しやすく、毎回数時間かかります。
2つの税制(1年目はLucro Real、2年目は合併)にわたる3年分のECDデータを扱うcontabilidadeチームは、単一の分析質問のための入力データを準備するだけで、丸1営業日を費やす可能性があります。
クロスイヤーSPED分析に実際に必要なもの
財務コントローラーや税務マネージャーが複数年度の比較を求める場合、通常は以下のいずれかのビューを必要としています。
「過去3年間の全勘定の期首残高、期末残高、純増減を並べて表示してほしい。」
これには、各年度のECDからC155 Registro(試算表)を抽出し、C050の勘定科目表から勘定コードを整合させ、各行が参照勘定科目表 (Plano de Contas Referencial) コードで、各年度の残高が隣接する列に表示される横比較テーブルを構築する必要があります。
「e-Lalurの永久差異のうち、前年比で大きく変動したものはどれか?」
これは、各年度のECFからM300 Registro(e-Lalur Part A調整)を抽出し、調整タイプ(加算、減算、補償)でフィルタリングし、年間値を並べて比較することを意味します。特定の調整タイプで30%の変動があれば、事業の変化または分類エラーの可能性を示しており、調査する価値があります。
「実効税率は3年間でどのように推移し、どの調整がその変動を牽引したのか?」
これには、複数年度にわたるECDデータ(ECFのBloco Eからの会計上の利益ベース)とECFデータ(Bloco Mからのe-Lalur調整)を組み合わせる必要があります。つまり、2つの異なるファイルタイプ、2つの異なるRegistro構造、1つの分析上の問いかけです。
共通点は、すべての質問が複数のファイル、複数のRegistroタイプ、複数の年度にまたがっていることです。ボトルネックはデータが存在するかどうかではありません。データは詳細に存在します。ボトルネックは、SPEDエコシステムのファイル指向レイアウトから、質問指向レイアウトへの再構築です。
バッチ処理戦略:ファイル形式ではなく出力列で考える
SPEDファイルをバッチ処理する上で重要なのは、Registro構造は一見わかりにくいものの、内部的には一貫しているという点です。昨年の試算表を担ったC155 Registroレイアウトは、今年も同じものを使用します。昨年の永久差異を説明したM300フィールドも、今年のものを説明します。レイアウト変更は頻度が低く、フィールドレベル(ECDのLeiaute 8から9、またはECFの11から12への移行)であり、Registroタイプとそれが表す会計概念との基本的な関係を変えるものではありません。
この一貫性により、出力構造を一度定義すれば、それを複数年にわたって適用できます。「2024年のECDを開いて、C155でフィルタリングし、フィールドをマッピングして、それを2025年にも繰り返す」と考える代わりに、「2024年と2025年の勘定残高を並べて表示したい」と考え、抽出レイヤーにファイルごとの再構築を任せることができます。
カスタム列抽出は、まさにこのシナリオのために設計されています。「勘定コード」「勘定名」「期首残高」「期末残高」など、必要な列に名前を付けると、AIがSPEDファイルを読み取り、関連するRegistroレコードからそれらの値を特定して抽出します。どの年のファイルを指定しても同じです。2023年のECDからクリーンな試算表を生成した同じ列定義は、2024年と2025年のECDファイルからも同一の構造を生成します。これは、Registro C155と「試算表」という概念との意味的な関係が、年をまたいでも変わらないためです。
実際の効果:3年分のECDデータを処理する場合、列の定義は3回ではなく1回で済みます。作業は「150,000行を3回フィルタリングして整列する」から「1つの列定義で3つのファイルを指定する」へと変わります。
ステップバイステップ:複数年のECDデータをバッチ処理して年次比較試算表を作成する
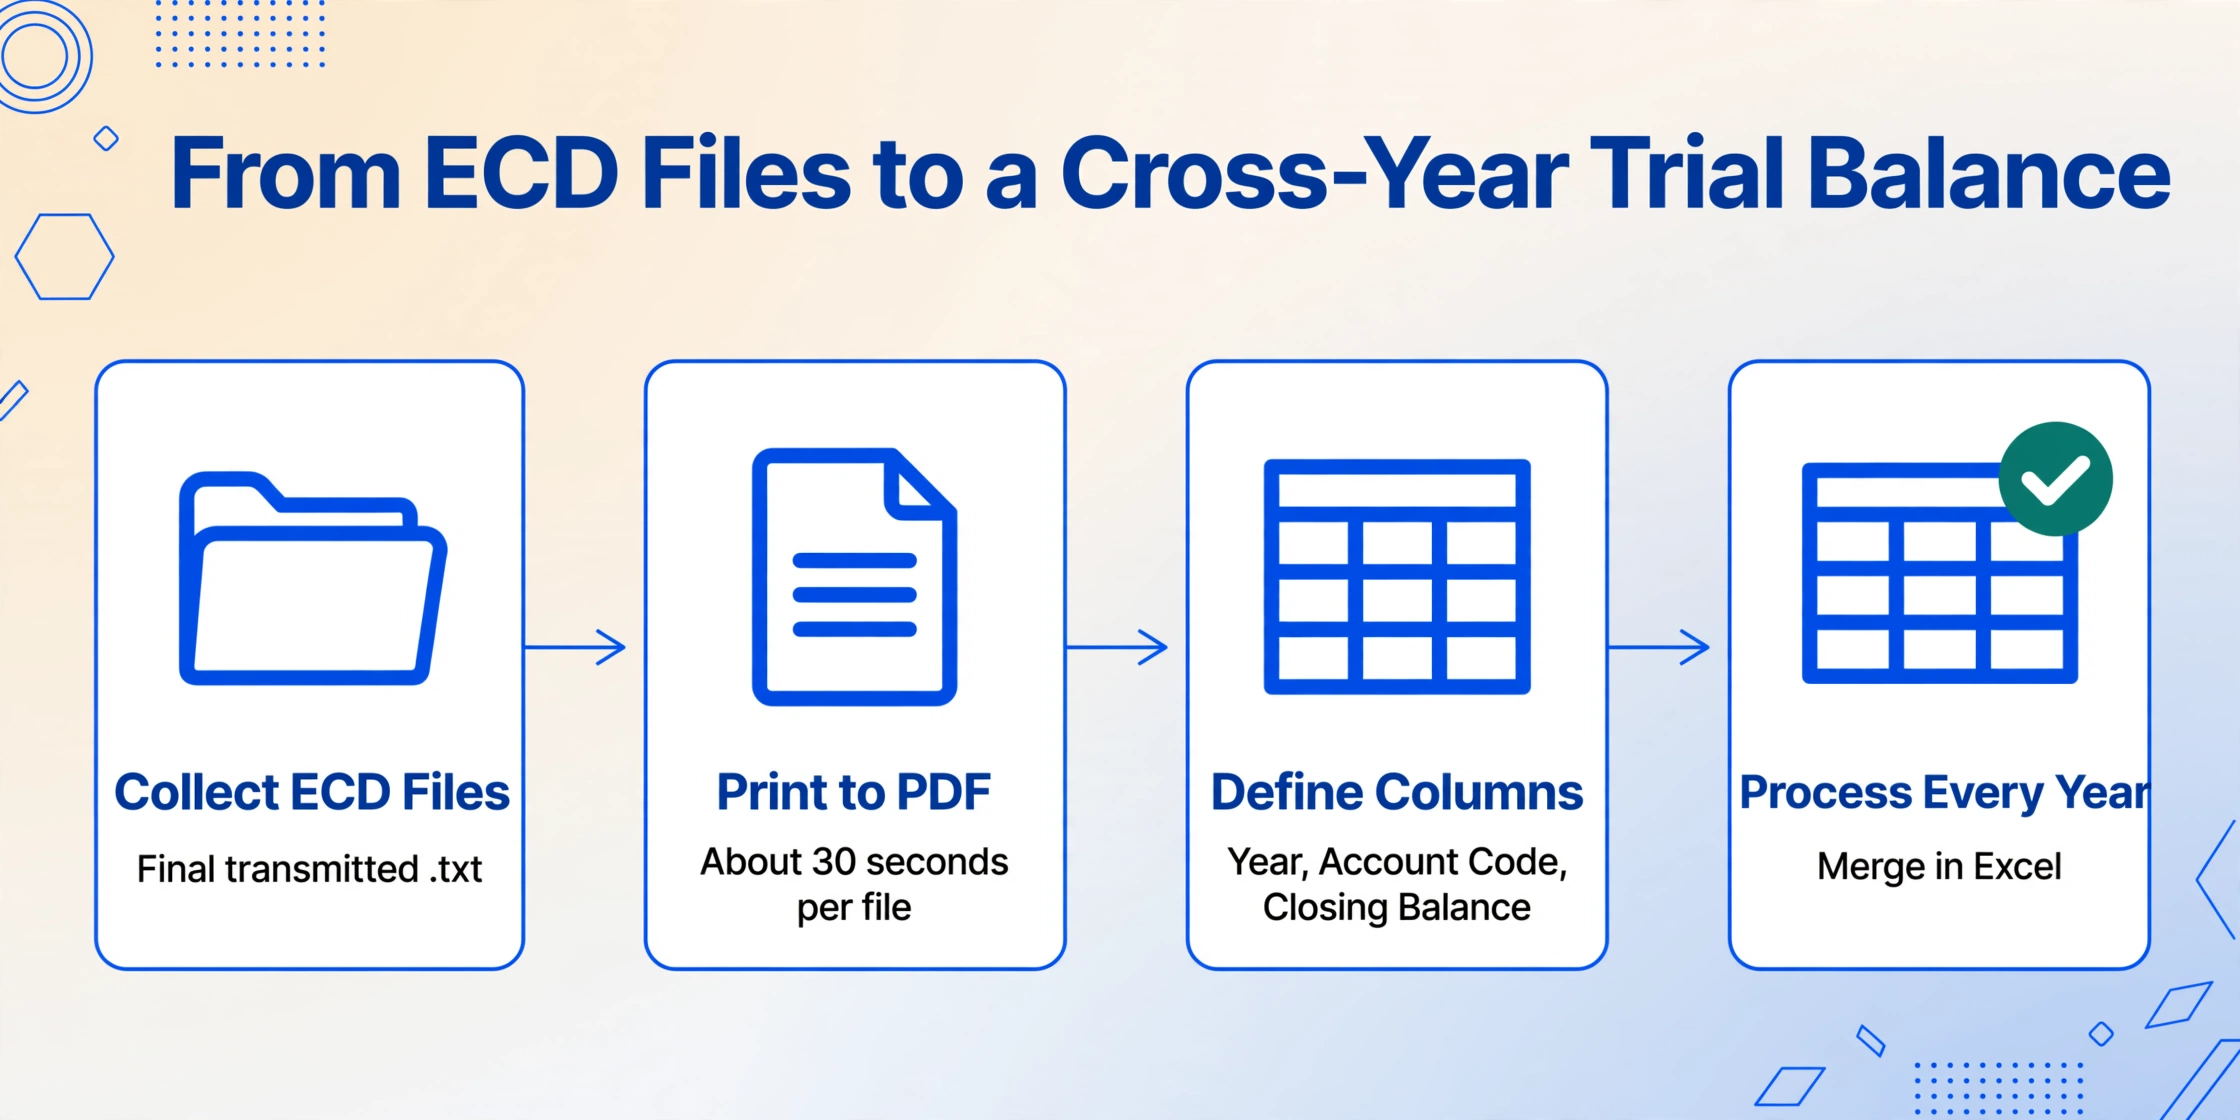
ここでは、2年分または3年分のECDファイルを、前年比の勘定比較表に変換するワークフローを示します。同じロジックがECFデータや、ECD+ECFを組み合わせた分析にも適用されます。
ERP(Omie、Conta Azul、Senior、Domínio、SAP TDF、またはSPED生成に使用しているシステム)またはPVAアーカイブから、検証済みの.txtファイルをエクスポートします。送信済みの最終版が必要です。下書きではありません。送信済みファイルはReceita Federalが受信したものと一致するためです。全年度分を1つのフォルダに保存します。
ImageToTable.aiはPDF、JPG、PNG、WebPの入力に対応しています。.txtファイルの場合、各ECDをテキストビューアまたはPVAのファイルビューアで開き、PDFに印刷します。SPED形式の固定幅レイアウト(パイプ区切り、整列された列)は視覚的に一貫しているため、PDFはAIが読み取る構造を保持します。この手順はファイルあたり約30秒かかります。
任意の年度のECDから試算表を取得する列定義を1つ設定します。列は次のとおりです: 年度、勘定科目コード、勘定科目名、期首残高、借方移動、貸方移動、期末残高。「年度」列を追加すると、複数年度の結果を1つのテーブルにまとめられます。勘定科目コードは、年度間の標準化のためにC050の参照勘定科目表 (Plano de Contas Referencial) に対応させる必要があります。
年度1のPDFをアップロードし、列定義を使用して抽出を実行します。年度2、年度3についても繰り返します。列定義は意味論的であり、AIに「勘定科目コード」「期末残高」などをバイトオフセットではなく意味で探すよう指示するため、PVAが年度間でレイアウトをわずかに異なる形式でエクスポートした場合でも、ファイル間で同じように機能します。各実行で、指定したヘッダーを持つクリーンなテーブルが生成されます。
各年度の結果を.xlsxとしてエクスポートし、「年度」列を使用して各行のソース期間を識別しながら1つのファイルに積み重ねます。比較テーブルを作成します: 勘定科目コードでフィルタリングし、各年度の期首残高と期末残高を隣接する列に配置します。前年比変動(絶対値とパーセンテージ)の計算列を追加し、移動が20%やR$100,000などのしきい値を超えた勘定科目にフラグを付ける条件付き書式を設定します。
.txtファイルから構造化された年度横断テーブルまでの全サイクルは、列定義を保存すれば、3年分のデータで約30分かかります。同じ作業をExcelでテキストインポートウィザードと手動調整を使用して完全に行う場合、推定3〜4時間かかり、手動フィルタリングとフィールドマッピングによるエラー率も高くなります。
この分析を毎年繰り返す場合(ECF作成サイクルの一環として、各新年度を前年と比較する場合)、列定義をテンプレートとして保存します。翌年は、新しいファイルに対してのみステップ4を実行し、その結果を既存の複数年度スプレッドシートに追記します。
バッチの拡張: ECF税調整データの追加
同じバッチロジックがECFファイルにも適用されます。ECFのBloco Mには、IRPJおよびCSLLの納税義務を決定するe-Lalur調整が含まれており、これらの調整を年度ごとに比較することで、税務計画や永久差異の推移が明らかになります。
ECFデータを複数年度分析に追加するには、ECFのM300(e-Lalur Part A)およびM350(e-Lacs Part A)Registroを対象とする2つ目の列定義を作成します:
Year, Registro, Account Code, Adjustment Type (Addition/Exclusion/Compensation), Adjustment Amount, Reference Process Number
この定義を使用して各年度のECF PDFを処理し、エクスポートして、ECD試算表データとともに統合スプレッドシートにマージします。これで、ECD↔ECFの境界をまたぐ質問に答えられる単一のファイルが手に入ります。例えば、「のれん償却の永久差異は2024年から2025年にかけて変化したか、また対応する会計引当金は各年度のECDに正しく記録されたか」といった質問です。
重要な洞察: ECFのBloco E(E010、E015)には、ECDの会計残高をECFの税調整にリンクするマッピング勘定が含まれています。これらをバッチに含めることで、ECF調整を元のECD勘定に遡って追跡するために必要な相互参照テーブルが得られます。これはPVAが代わりに実行してくれないチェックです。
レイアウトが変更された場合の対応
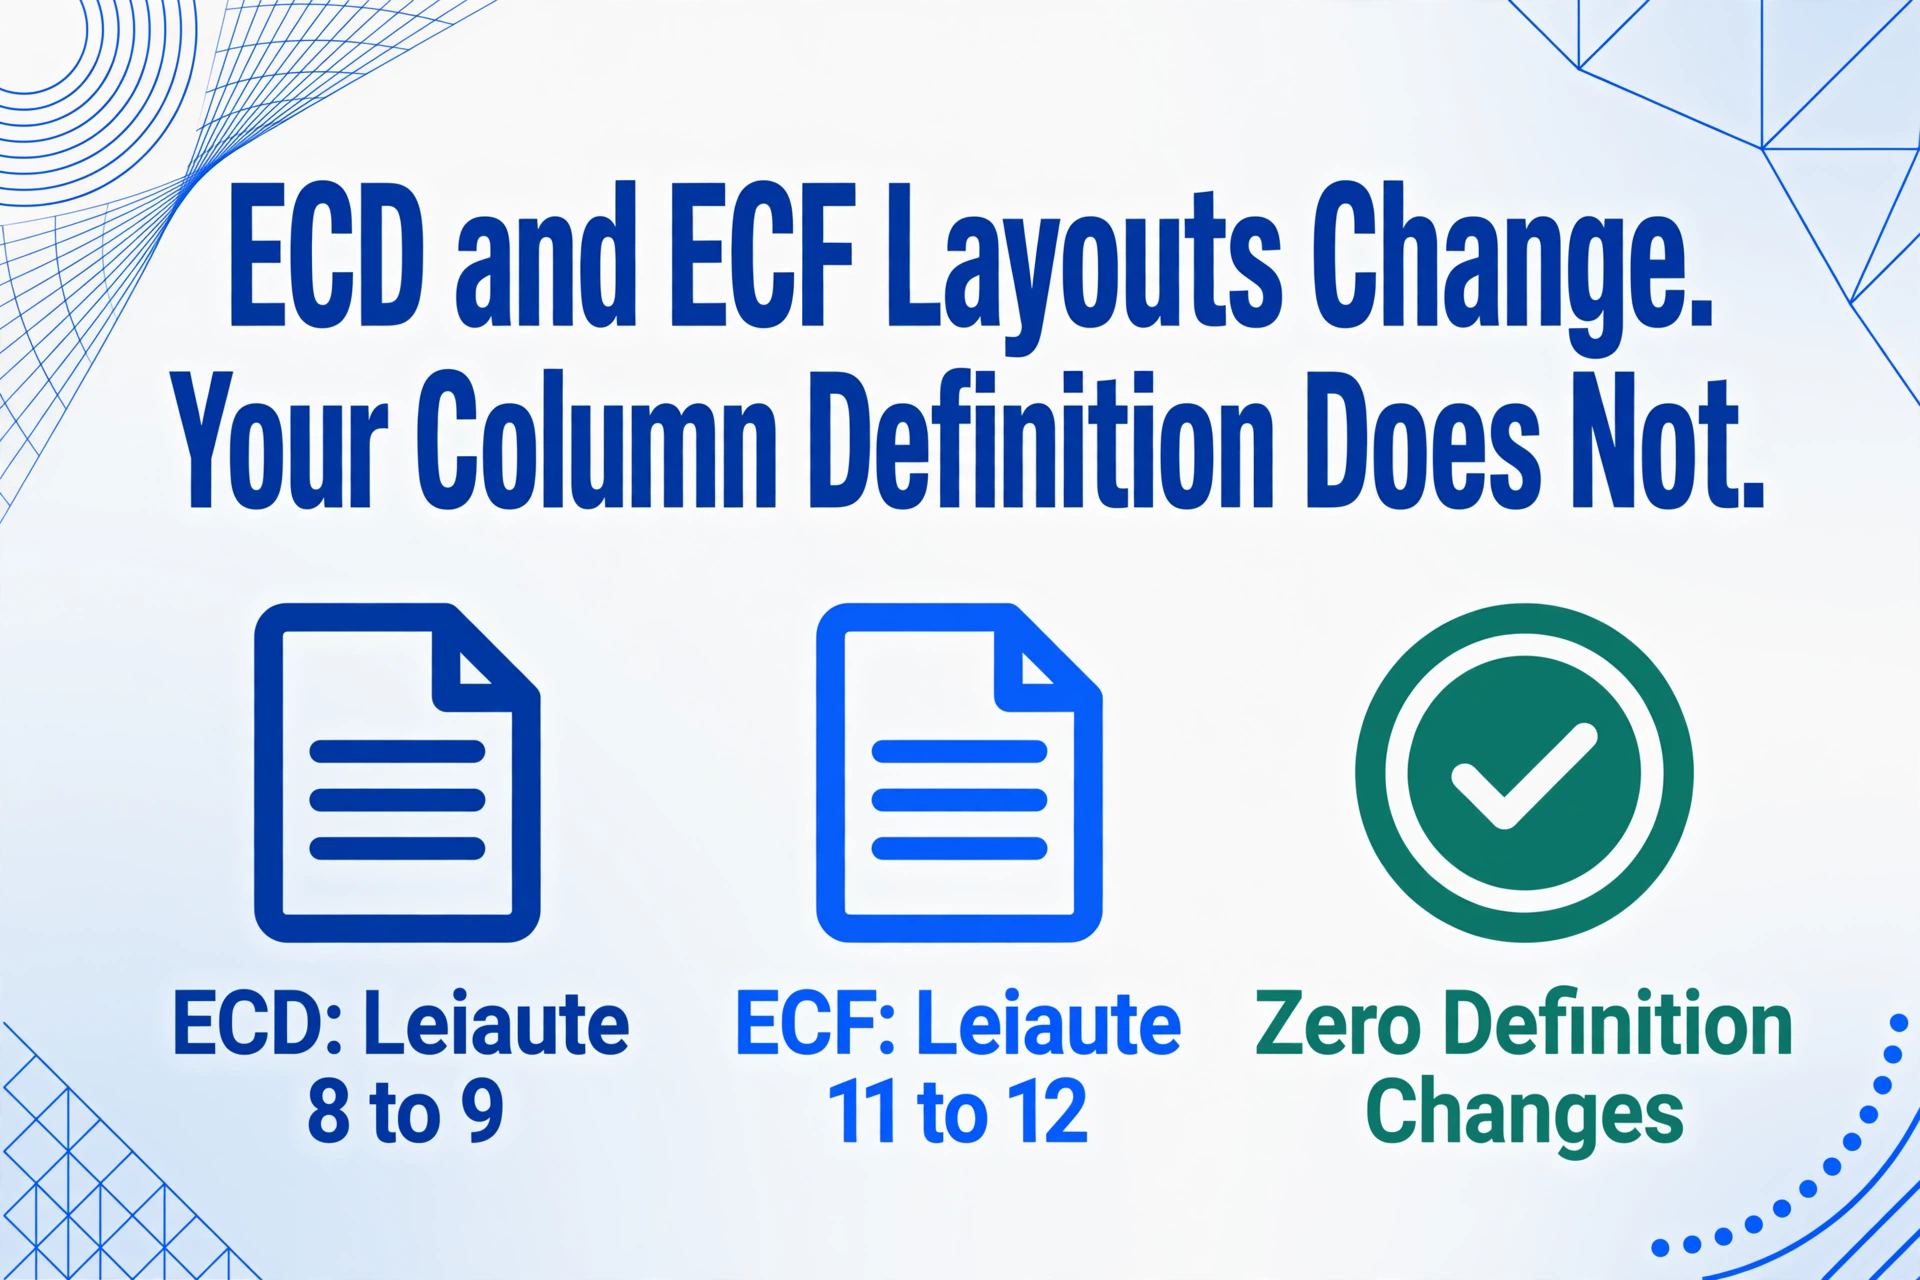
ブラジルのSPEDレイアウトは進化します。ECDは2020年にLeiaute 9へ移行しました(その後は安定しており、ADE Cofisの裁定によるフィールドレベルの更新のみ)。ECFは2026年の2025暦年申告用にLeiaute 12を採用しました。レイアウトが変更されると、スクリプトベースのパーサーはコードの更新が必要になります。セマンティック抽出アプローチでは、この移行の処理が異なります。AIが意味によって読み取るため(「この固定幅ブロックは試算表エントリを記述している」など)、絶対的なバイト位置ではなく、Registroコードとレコードの概念構造が維持されている限り、同じ列定義がレイアウトバージョン間で頻繁に機能します。実際には、ECDのLeiaute 8から9、ECFの11から12への移行では、試算表またはe-Lalur抽出のための列定義の変更は必要ありませんでした。これは、中核となるRegistro構造(C155、M300)が安定していたためです。
よくある質問
Q: ECDとECFを一括で処理できますか?
それぞれのファイルはRegistroの構造が異なるため、個別に抽出処理が必要です。ただし、一度作成した列定義はテンプレートとして保存し、毎年再利用できます。ECDの処理に1回、ECFの処理に1回のパスが必要で、両方をエクスポートした後、Excelで統合作業を行います。
Q: ECDに部門別元帳(Bloco K)がある会社の場合はどうなりますか?
ECDにBloco Kのレコードが含まれている場合、定義に「コストセンター」または「部門」列を追加できます。AIがECDのC100およびK固有のRegistroからKレベルのコストセンタータグを読み取り、出力テーブルに含めます。これは、事業部門別の年度をまたがる収益性分析に特に役立ちます。
Q: 合併や組織再編により、年度間で勘定科目コードが変わった場合はどうなりますか?
これはデータ抽出の問題ではなく、データマッチングの問題です。各年度のECDから、試算表データと一緒にC050の勘定科目一覧を抽出してください。会社内部の勘定科目番号(変更されている可能性があります)ではなく、Receita Federalによって標準化された参照勘定科目表(Plano de Contas Referencial)の参照勘定科目コードを、年度間のマッチングキーとして使用します。
Q: バッチ処理にファイルサイズの制限はありますか?
ImageToTable.aiは、ECDファイルをPDFまたは一連のページ画像として処理します。一般的なECDファイル(80,000〜150,000行)の場合、PDF版は約200〜400ページになります。ツールはページごとに処理します。非常に大きなファイルの場合は、ページ範囲を指定したPDF分割を使用して、Blocoごとにセクションに分割できます(例:Bloco Cを1回のパスで、Bloco Iを別のパスで処理する)。
Q: この方法はLucro Presumidoの会社でも使えますか?
はい、使えます。Lucro Presumidoの会社も同じRegistro構造でECDを提出し、年度間の勘定科目比較が同様に必要です。ECFの範囲は狭くなりますが(恒久的差異のあるe-Lalurはありません)、ECDの抽出と年度間の試算表分析は全く同じように機能します。
コンプライアンスの負担から分析資産へ
SPEDの提出は、ある意味で分析の可能性を無駄にしています。会計システムが1年かけて生成したデータ — すべての仕訳、すべての勘定残高、すべての税調整 — は、一人の読者(Receita Federalの検証システム)に最適化された形式に再構成され、多大な手作業なしには他の目的に事実上使用できません。皮肉なことに、これは御社の会計年度の最も完全な財務記録であり、ERPがエクスポートするどの管理レポートよりも詳細です。
バッチ処理がこの状況を変えます。複数年度の試算表、税調整、コストセンターデータをたった1回の午後で抽出できるようになれば、SPEDファイルは「提出して忘れる」コンプライアンス成果物から、積極的に活用する分析データセットへと変わります。前年比の差異分析、実効税率のトレンド追跡、部門別収益性のトレンドライン。これらすべてが、同じ抽出ワークフローの出力になります — 別々のデータ準備サイクルを必要とする別々のプロジェクトではありません。
今年作成する列定義は、再利用可能な資産です。来年、新しいECDファイルが届いたら、同じ定義に対して実行するだけです。比較結果は数分で、数時間ではなく、すぐに得られます。