80.000 Zeilen pro Jahr, eine Tabelle
So verarbeiten Sie SPED-Leiaute-Dateien im Batch für die Analyse über mehrere Jahre
Ein mittelständisches brasilianisches Unternehmen meldet jährlich rund 80.000 bis 150.000 Zeilen Digital Accounting Bookkeeping-Daten (Escrituração Contábil Digital, kurz ECD). Über einen Vergleichszeitraum von drei Jahren sind das eine Viertelmillion Zeilen mit durch Pipe getrennten Registro-Codes, verteilt auf drei separate Textdateien – jede für die maschinelle Validierung durch die Receita Federal strukturiert, nicht für die menschliche Analyse. Jede Zeile ist ein Datensatz, den Sie möglicherweise benötigen: ein Saldenlisteneintrag, eine Journalzeile oder eine e-Lalur-Steueranpassung. Doch um die benötigten Konten über mehrere Jahre hinweg zu extrahieren, müssen Sie jede Datei öffnen, nach Registro-Code filtern, Spalten manuell ausrichten und die Ergebnisse in einer neuen Tabelle zusammenfügen. Diese Arbeit wiederholt sich bei jeder Frage, die mehrere Jahre betrifft.
Dieser Artikel befasst sich mit der Alternative: mehrere Jahre SPED-Dateien als einen einzigen Batch zu behandeln, die Ausgabespalten einmal zu definieren und nur die benötigten Daten in eine analysefertige Tabelle zu extrahieren – unabhängig davon, ob die Quelldaten zwei ECD-Dateien, eine ECF-Datei oder drei Steuerjahre mit unterschiedlichen Leiaute-Versionen umfassen. Der Ansatz erfordert keinen Parser für jeden Registro-Typ. Er funktioniert über Jahre hinweg, über Layout-Versionen hinweg und über die ECD↔ECF-Grenze hinweg.
Warum „Eine Datei nach der anderen öffnen“ für die Jahresübergreifende Analyse nicht funktioniert
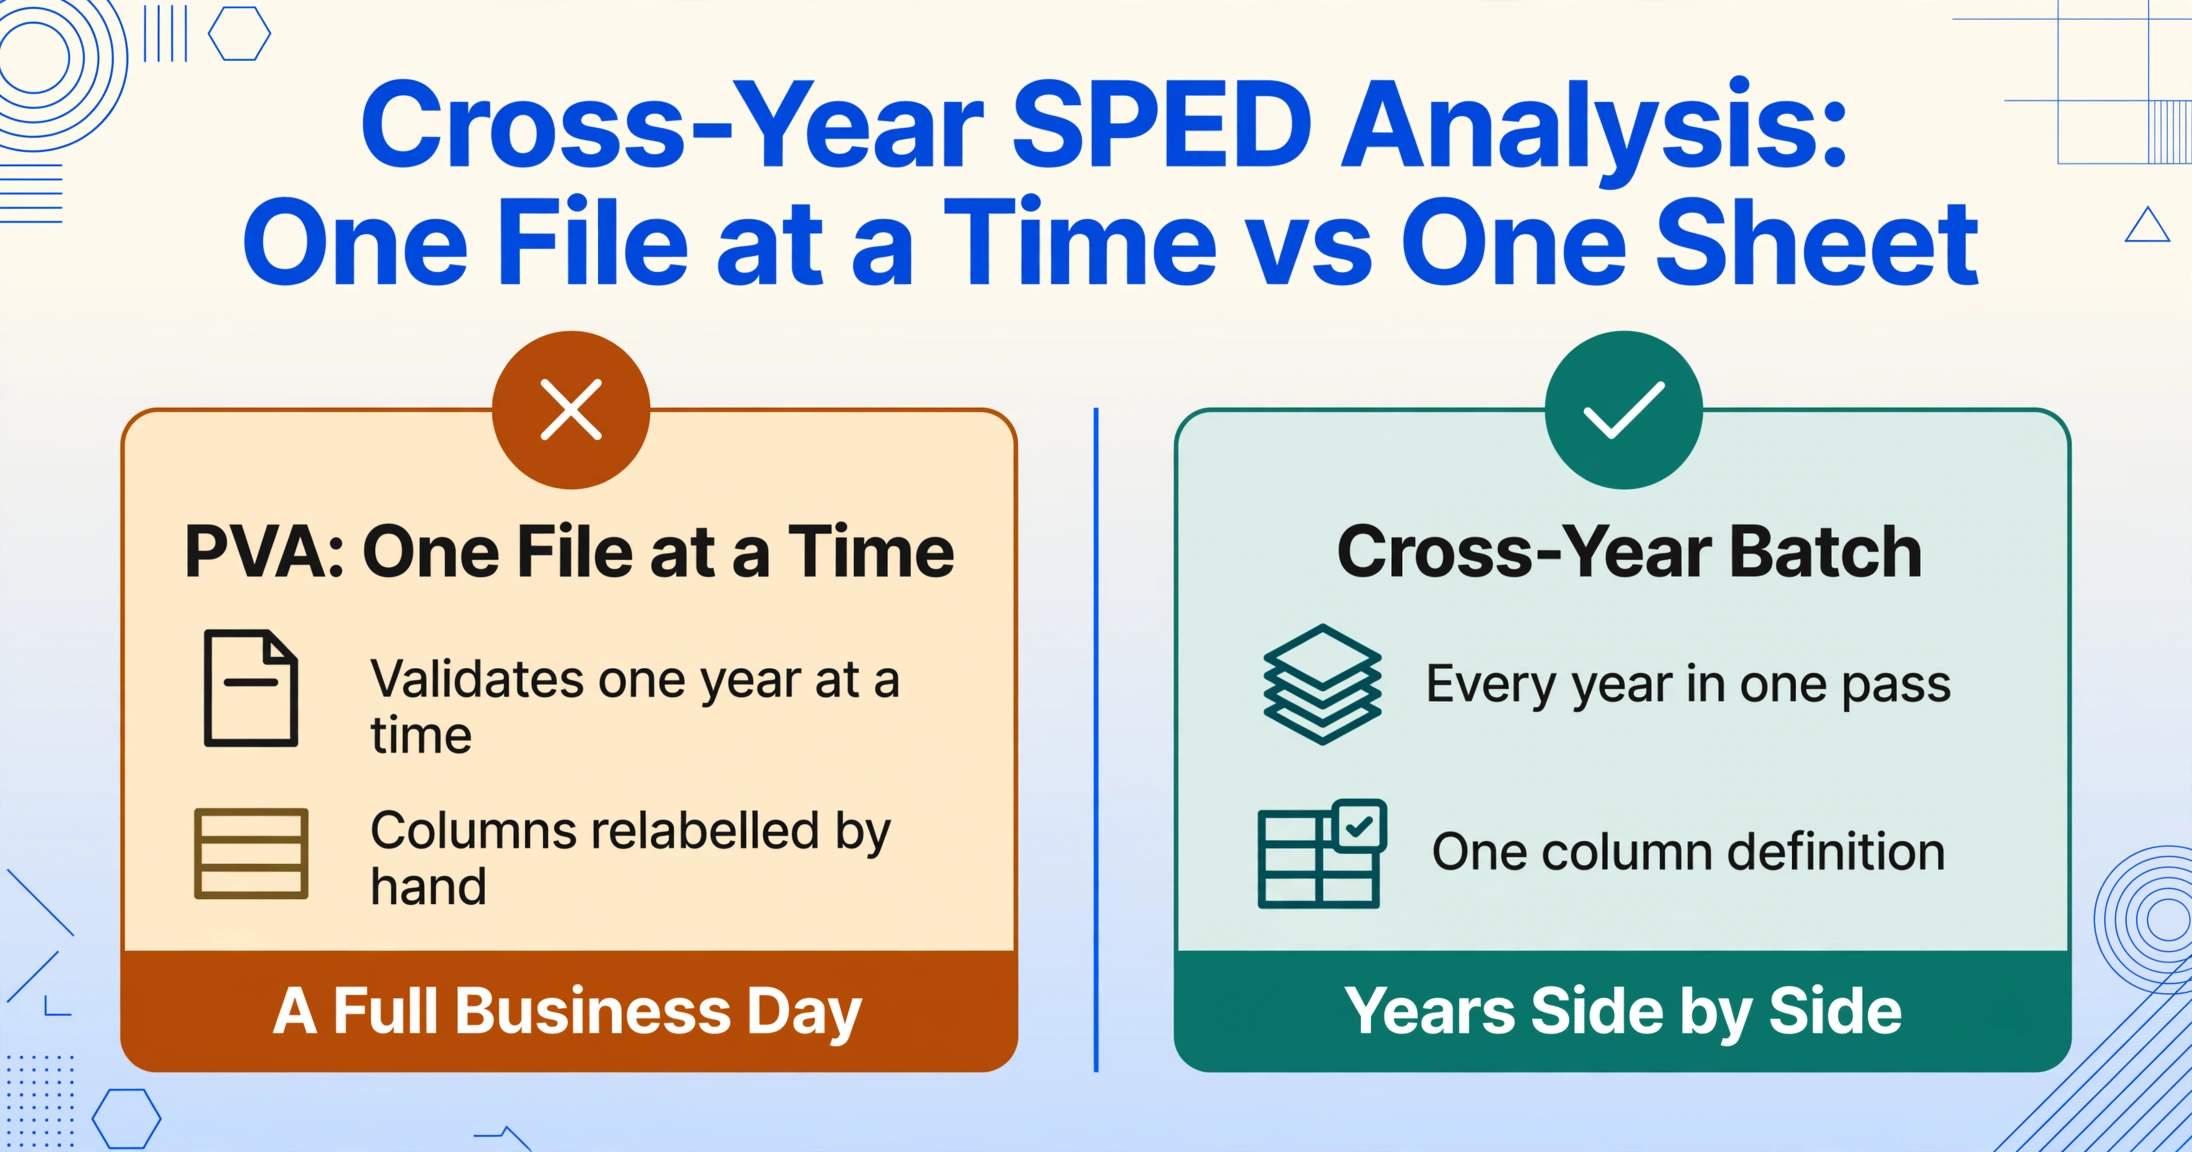
Das Öffentliche Digitale Buchführungssystem (Sistema Público de Escrituração Digital, oder SPED) wurde entwickelt, um der Receita Federal eine einzige, standardisierte Pipeline für den Empfang von Buchhaltungsunterlagen zu bieten. Das ist gelungen. Was es nicht bietet, ist ein integrierter Mechanismus zum Vergleich der Daten eines Jahres mit denen eines anderen. Jedes Steuerjahr erzeugt eine eigene ECD-Datei und eine eigene Digitale Steuerbuchführung (Escrituração Contábil Fiscal, oder ECF)-Datei. Die Programas Validadores e Assinadores (PVAs) validieren und übertragen einzelne Dateien. Sie öffnen nicht zwei nebeneinander.
Das bedeutet, dass jede jahresübergreifende Analyse demselben manuellen Ablauf folgt: Exportieren Sie Jahr-1-ECD aus dem PVA, exportieren Sie Jahr-2-ECD, öffnen Sie jede in Excel mit dem Textimport-Assistenten (Pipe-Trennzeichen), filtern Sie nach den relevanten Registro-Codes, benennen Sie die Spalten um (die je nach gefiltertem Registro ihre Position ändern), erstellen Sie eine Vergleichstabelle von Grund auf neu und wiederholen Sie dies für die Steueranpassungsdaten des ECF. Die Arbeit ist technisch nicht schwierig – sie ist mechanisch repetitiv, fehleranfällig und kostet jedes Mal Stunden.
Ein Contabilidade-Team, das drei Jahre ECD-Daten über zwei Steuerregime hinweg verarbeitet (ein Jahr Lucro Real, im zweiten Jahr eine Fusion), könnte leicht einen ganzen Arbeitstag nur mit der Aufbereitung der Eingabedaten für eine einzige analytische Frage verbringen.
Was eine SPED-Analyse über mehrere Jahre tatsächlich benötigt
Wenn ein Finanzcontroller oder Steuerverantwortlicher einen Mehrjahresvergleich anfordert, möchte er in der Regel eine der folgenden Ansichten sehen:
„Zeigen Sie mir den Eröffnungssaldo, den Schlusssaldo und die Nettoveränderung jedes Kontos für die letzten drei Jahre – nebeneinander.“
Dies erfordert die Extraktion des C155-Registros (Bilanzsumme) aus der ECD jedes Jahres, den Abgleich der Kontonummern aus dem C050-Kontenplan und die Erstellung einer horizontalen Vergleichstabelle, in der jede Zeile einem Referenzkontenplan (Plano de Contas Referencial) entspricht und die Salden jedes Jahres in benachbarten Spalten erscheinen.
„Welche dauerhaften Differenzen im e-Lalur haben sich im Jahresvergleich signifikant verändert?“
Dies bedeutet, das M300-Registro (e-Lalur Teil-A-Anpassungen) aus der ECF jedes Jahres zu extrahieren, nach Anpassungsart zu filtern (Hinzurechnungen, Kürzungen, Kompensationen) und die jährlichen Werte nebeneinander zu vergleichen. Eine Schwankung von 30 % bei einer bestimmten Anpassungsart deutet entweder auf eine Geschäftsänderung oder einen Klassifizierungsfehler hin, der untersucht werden sollte.
„Wie hat sich unser effektiver Steuersatz über drei Jahre entwickelt, und welche Anpassungen haben diese Entwicklung verursacht?“
Dies erfordert die Kombination von ECD-Daten (handelsrechtliche Gewinnbasis aus Bloco E in der ECF) mit ECF-Daten (e-Lalur-Anpassungen aus Bloco M) über mehrere Jahre – zwei verschiedene Dateitypen, zwei verschiedene Registro-Strukturen, eine analytische Fragestellung.
Der gemeinsame Nenner: Jede Frage erstreckt sich über mehrere Dateien, mehrere Registro-Typen und mehrere Jahre. Der Engpass liegt nicht darin, ob die Daten existieren – sie existieren in erschöpfender Detailtiefe. Der Engpass liegt in der Umstrukturierung von der dateiorientierten Darstellung des SPED-Ökosystems hin zu einer fragestellungsorientierten Darstellung.
Batch-Verarbeitungsstrategie: Denken Sie in Ausgabespalten, nicht in Dateiformaten
Der entscheidende Einblick für die Batch-Verarbeitung von SPED-Dateien ist, dass die Registro-Struktur – obwohl obskur – intern konsistent ist. Das gleiche C155-Registro-Layout, das die Saldenliste des letzten Jahres trug, trägt auch die des aktuellen Jahres. Die gleichen M300-Felder, die die permanenten Differenzen des letzten Jahres beschrieben, beschreiben auch die des aktuellen Jahres. Die Layoutänderungen sind selten und erfolgen auf Feldebene (der Übergang von Leiaute 8 zu 9 für ECD bzw. 11 zu 12 für ECF) und ändern nicht die grundlegende Beziehung zwischen Registro-Typen und den Buchhaltungskonzepten, die sie repräsentieren.
Diese Konsistenz bedeutet, dass Sie Ihre Ausgabestruktur einmal definieren und über Jahre hinweg anwenden können. Statt zu denken „Ich muss die ECD 2024 öffnen, nach C155 filtern, die Felder zuordnen und das dann für 2025 wiederholen“, denken Sie „Ich benötige Kontensalden für 2024 und 2025 nebeneinander“ – und überlassen Sie der Extraktionsebene die dateispezifische Umstrukturierung.
Benutzerdefinierte Spaltenextraktion ist genau für dieses Szenario konzipiert. Sie benennen die gewünschten Spalten – „Kontonummer“, „Kontoname“, „Eröffnungssaldo“, „Schlusssaldo“ – und die KI liest die SPED-Datei, um diese Werte aus den relevanten Registro-Datensätzen zu lokalisieren und zu extrahieren, unabhängig davon, auf welche Jahresdatei Sie sie richten. Dieselbe Spaltendefinition, die aus der ECD 2023 eine saubere Saldenliste erzeugt hat, erzeugt aus den ECD-Dateien 2024 und 2025 eine identische Struktur, da sich die semantische Beziehung zwischen Registro C155 und dem Konzept „Saldenliste“ zwischen den Jahren nicht geändert hat.
Der praktische Effekt: Die Verarbeitung von drei Jahren ECD-Daten erfordert, dass Sie Ihre Spalten einmal definieren, nicht dreimal. Die Arbeit verschiebt sich von „150.000 Zeilen dreimal filtern und abgleichen“ zu „drei Dateien mit einer Spaltendefinition verarbeiten“.
Schritt für Schritt: Batch-Verarbeitung mehrerer Jahre ECD-Daten zu einer jahresübergreifenden Saldenliste
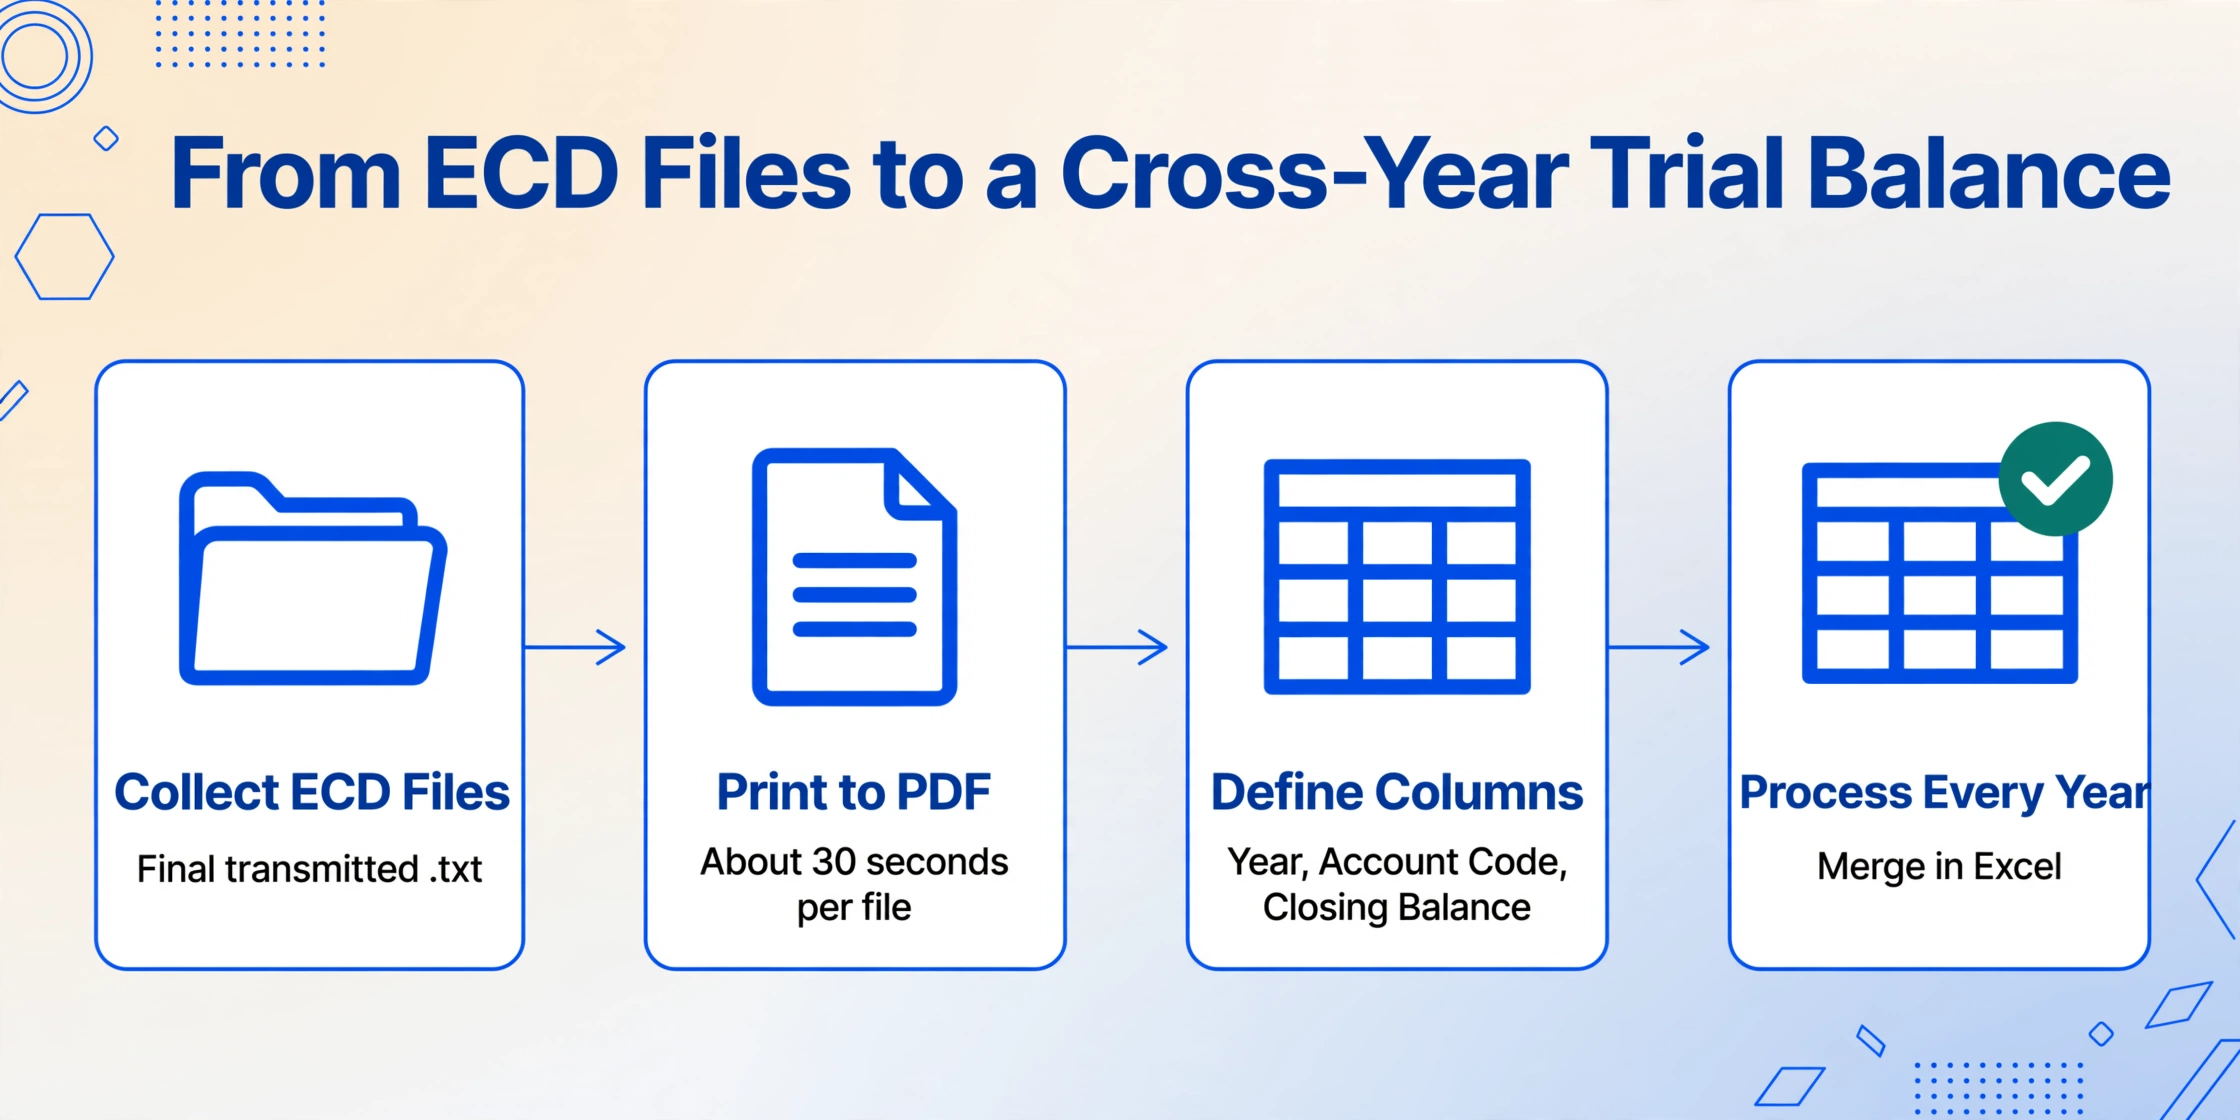
Hier ist der Workflow, um zwei oder drei Jahre ECD-Dateien in eine Jahresvergleichstabelle der Konten zu verwandeln. Die gleiche Logik gilt für ECF-Daten oder gemischte ECD+ECF-Analysen.
Exportieren Sie die validierten .txt-Dateien aus Ihrem ERP (Omie, Conta Azul, Senior, Domínio, SAP TDF oder welches System Sie auch immer für die SPED-Erstellung verwenden) oder aus den PVA-Archiven. Sie benötigen die endgültige, übermittelte Version – keinen Entwurf –, da die übermittelte Datei derjenigen entspricht, die die Receita Federal erhalten hat. Speichern Sie alle Jahre in einem einzigen Ordner.
ImageToTable.ai akzeptiert PDF-, JPG-, PNG- und WebP-Eingaben. Öffnen Sie für .txt-Dateien jede ECD in einem Textbetrachter oder im Dateibetrachter der PVA und drucken Sie sie als PDF. Das Festbreitenlayout des SPED-Formats (Pipe-Trennzeichen, ausgerichtete Spalten) ist visuell konsistent, sodass ein PDF die Struktur bewahrt, die die KI liest. Dieser Schritt dauert etwa 30 Sekunden pro Datei.
Richten Sie eine Spaltendefinition ein, die die Saldenliste aus der ECD eines beliebigen Jahres erfasst. Ihre Spalten: Jahr, Kontonummer, Kontoname, Eröffnungssaldo, Soll-Bewegung, Haben-Bewegung, Schlusssaldo. Durch Hinzufügen einer Spalte „Jahr“ können Sie Ergebnisse aus mehreren Jahren in einer einzigen Tabelle zusammenführen. Die Kontonummer sollte dem Referenzkontenplan (Plano de Contas Referencial) aus C050 für eine jahresübergreifende Standardisierung entsprechen.
Laden Sie das PDF für Jahr 1 hoch und führen Sie die Extraktion mit Ihrer Spaltendefinition durch. Wiederholen Sie dies für Jahr 2 und Jahr 3. Da die Spaltendefinition semantisch ist – sie fordert die KI auf, „Kontonummer“, „Schlusssaldo“ usw. anhand der Bedeutung zu finden, nicht anhand des Byte-Offsets – funktioniert sie über alle Dateien hinweg identisch, selbst wenn die PVA das Layout mit geringfügigen Formatierungsunterschieden zwischen den Jahren exportiert hat. Jeder Durchlauf erzeugt eine saubere Tabelle mit Ihren Kopfzeilen.
Exportieren Sie die Ergebnisse jedes Jahres als .xlsx und stapeln Sie sie in einer Datei, wobei Sie die Spalte „Jahr“ verwenden, um den Quellzeitraum jeder Zeile zu identifizieren. Erstellen Sie Ihre Vergleichstabelle: Filtern Sie nach Kontonummer und platzieren Sie den Eröffnungs- und Schlusssaldo jedes Jahres in benachbarten Spalten. Fügen Sie berechnete Spalten für die Veränderung gegenüber dem Vorjahr (absolut und prozentual) sowie eine bedingte Formatierung hinzu, um Konten zu kennzeichnen, bei denen die Bewegung einen Schwellenwert wie 20 % oder R$100.000 überschritten hat.
Der gesamte Zyklus – von .txt-Dateien bis zu einer strukturierten jahresübergreifenden Tabelle – dauert für drei Jahre Daten etwa 30 Minuten, sobald die Spaltendefinition gespeichert ist. Für dieselbe Arbeit, die vollständig in Excel mit Textimport-Assistent und manueller Ausrichtung durchgeführt wird, liegt die Schätzung bei drei bis vier Stunden mit einer höheren Fehlerquote durch manuelles Filtern und Feldzuordnung.
Wenn Sie diese Analyse jährlich wiederholen (wobei Sie jedes neue Jahr mit dem Vorjahr im Rahmen des ECF-Erstellungszyklus vergleichen), speichern Sie die Spaltendefinition als Vorlage. Im nächsten Jahr führen Sie Schritt 4 nur mit der neuen Datei aus und hängen die Ergebnisse an Ihre bestehende jahresübergreifende Tabelle an.
Erweiterung des Batches: Hinzufügen von ECF-Steueranpassungsdaten
Dieselbeine Batch-Logik gilt für ECF-Dateien. Der Bloco M der ECF enthält die e-Lalur-Anpassungen, die Ihre IRPJ- und CSLL-Verbindlichkeiten bestimmen – und der Vergleich dieser Anpassungen über die Jahre zeigt, wie sich Steuerplanung und permanente Differenzen entwickeln.
Um ECF-Daten zu Ihrer jahresübergreifenden Analyse hinzuzufügen, erstellen Sie eine zweite Spaltendefinition, die auf die M300- (e-Lalur Teil A) und M350- (e-Lacs Teil A) Registros der ECF abzielt:
Jahr, Registro, Kontonummer, Anpassungsart (Addition/Ausschluss/Kompensation), Anpassungsbetrag, Referenzverfahrensnummer
Verarbeiten Sie die ECF-PDF jedes Jahres mit dieser Definition, exportieren Sie sie und führen Sie sie in Ihre konsolidierte Tabelle zusammen, zusammen mit den ECD-Saldendaten. Jetzt haben Sie eine einzige Datei, in der Sie Fragen beantworten können, die die ECD↔ECF-Grenze überschreiten – wie etwa „Hat sich die permanente Differenz für die Abschreibung des Geschäfts- oder Firmenwerts zwischen 2024 und 2025 geändert, und wurde die entsprechende buchhalterische Rückstellung in jedem Jahr korrekt im ECD erfasst?“
Wichtige Erkenntnis: Der Bloco E (E010, E015) der ECF enthält die zugeordneten Konten, die ECD-Buchhaltungssalden mit ECF-Steueranpassungen verknüpfen. Wenn Sie diese in Ihren Batch aufnehmen, erhalten Sie die Referenztabelle, die Sie benötigen, um jede ECF-Anpassung auf ihr ursprüngliches ECD-Konto zurückzuführen – eine Prüfung, die der PVA nicht für Sie durchführt.
Was passiert, wenn sich das Layout ändert
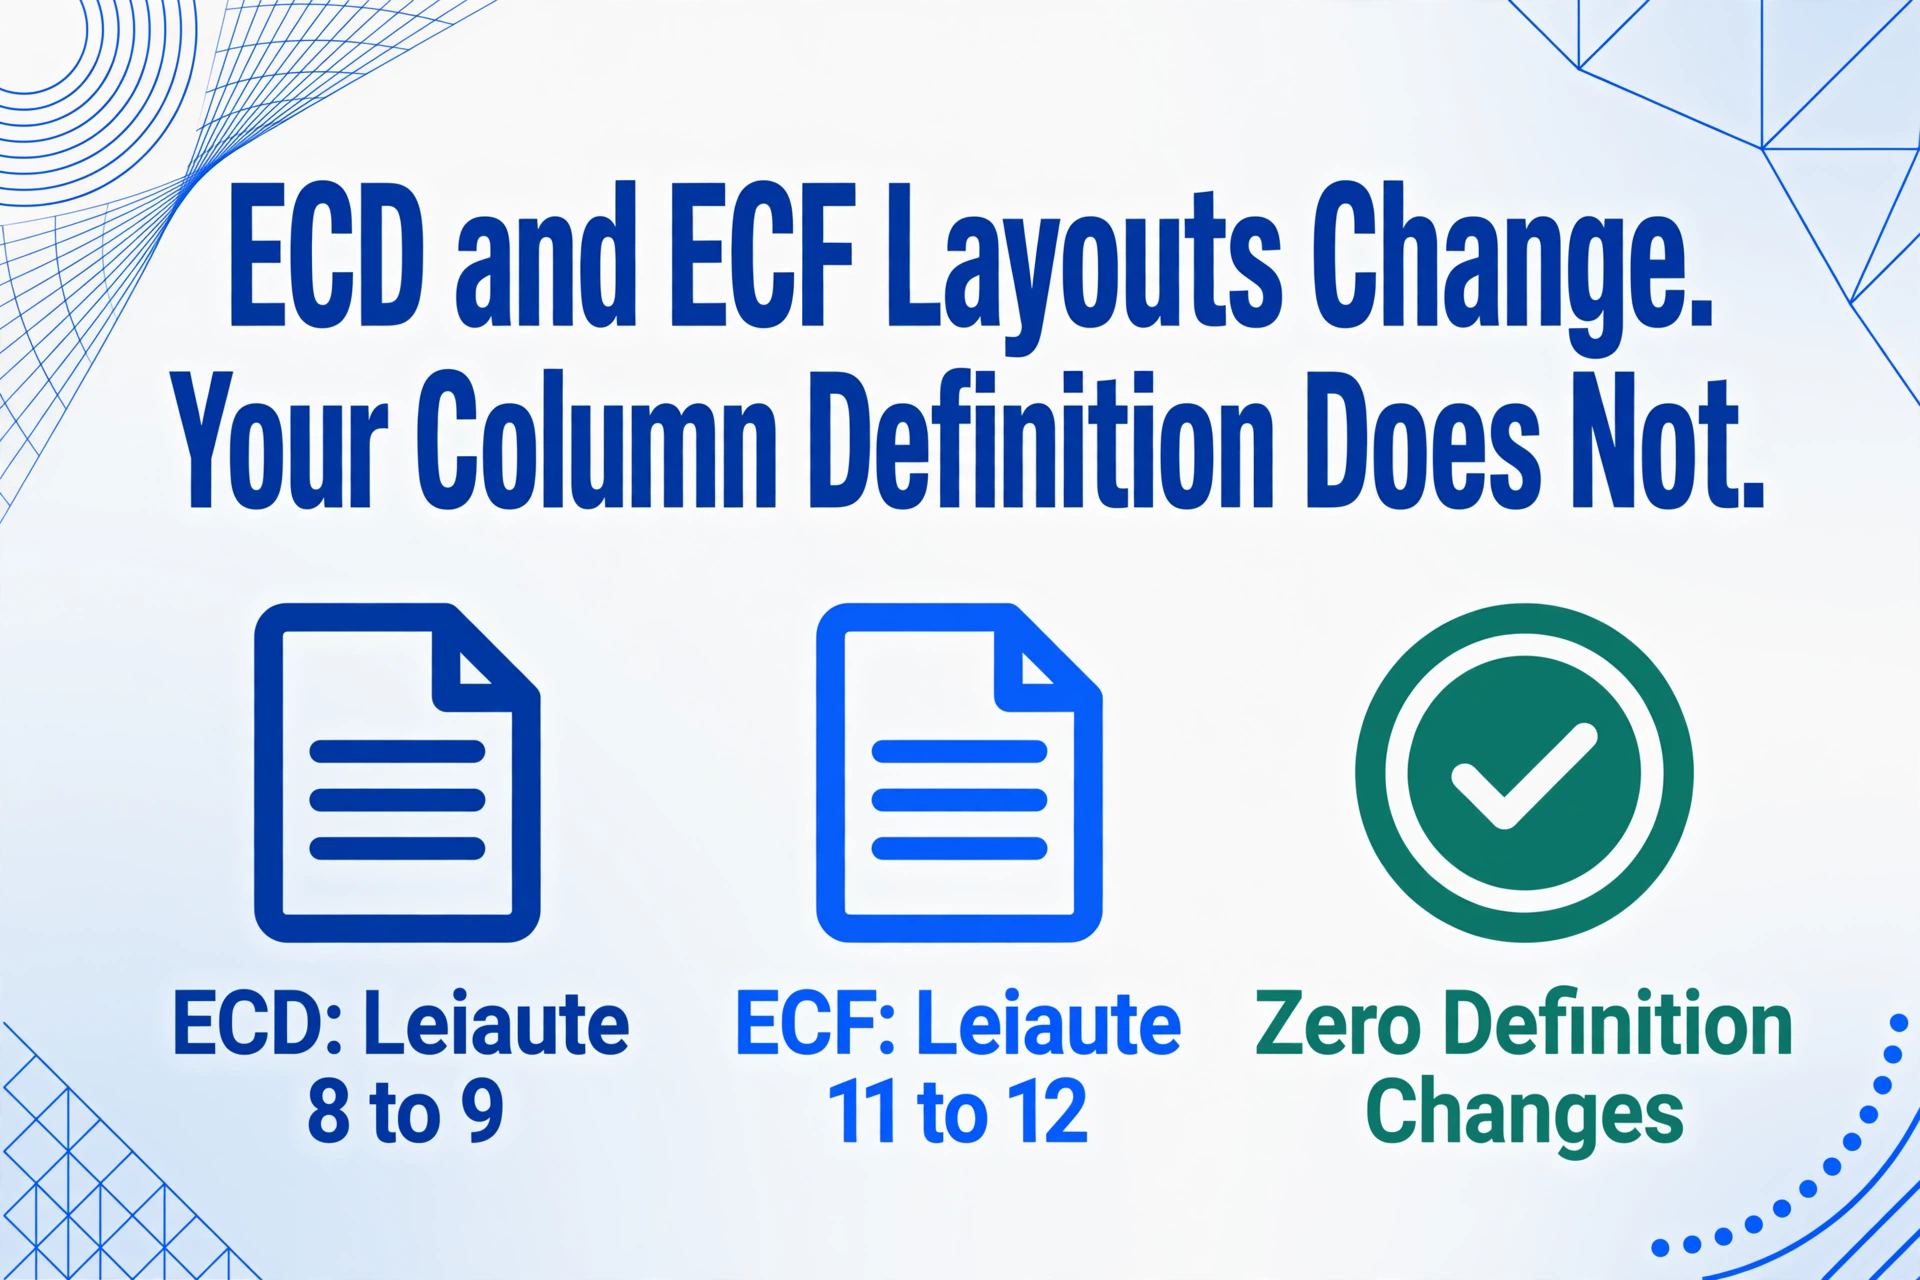
Die brasilianischen SPED-Layouts entwickeln sich weiter. Die ECD wechselte 2020 auf Leiaute 9 (seitdem stabil, mit feldbezogenen Aktualisierungen durch ADE-Cofis-Verfügungen). Die ECF übernahm Leiaute 12 für die Kalenderjahr-2025-Meldungen im Jahr 2026. Wenn sich ein Layout ändert, benötigen skriptbasierte Parser Code-Updates. Ein semantischer Extraktionsansatz bewältigt den Übergang anders: Da die KI nach Bedeutung liest – „dieser Festbreitenblock beschreibt einen Saldovortragseintrag“ – und nicht nach absoluter Byte-Position, funktioniert dieselbe Spaltendefinition häufig über Layout-Versionen hinweg, solange der Registro-Code und die konzeptionelle Struktur des Datensatzes erhalten bleiben. In der Praxis erforderte der Übergang von Leiaute 8 auf 9 für ECD und von 11 auf 12 für ECF keine Änderungen an den Spaltendefinitionen für die Saldovortrags- oder e-Lalur-Extraktion, da die Kern-Registro-Strukturen (C155, M300) stabil blieben.
Häufig gestellte Fragen
F: Kann ich die ECD und ECF in einem einzigen Durchlauf verarbeiten?
Jede Datei benötigt einen eigenen Extraktionsdurchlauf, da die Registro-Strukturen unterschiedlich sind. Die Spaltendefinitionen können jedoch einmal erstellt, als Vorlagen gespeichert und jedes Jahr wiederverwendet werden. Die Verarbeitung der ECD erfolgt in einem Durchlauf, die der ECF in einem zweiten, und die Konsolidierung findet nach dem Export beider Dateien in Excel statt.
F: Wie funktioniert das bei Unternehmen mit Bereichsbuchhaltung (Bloco K) in der ECD?
Wenn Ihre ECD Bloco-K-Aufzeichnungen enthält, können Sie Ihrer Definition eine Spalte „Kostenstelle“ oder „Bereich“ hinzufügen. Die KI liest die Kostenstellenkennzeichnungen auf K-Ebene aus den C100- und K-spezifischen Registros der ECD und fügt sie in die Ausgabetabelle ein. Dies ist besonders nützlich für die jahresübergreifende Rentabilitätsanalyse nach Geschäftsbereich.
F: Was passiert, wenn sich die Kontonummern aufgrund einer Fusion oder Umstrukturierung zwischen den Jahren geändert haben?
Dies ist ein Problem des Datenabgleichs, nicht der Extraktion. Extrahieren Sie den C050-Kontenplan aus der ECD jedes Jahres zusammen mit den Saldenvortragsdaten. Verwenden Sie die Referenzkontonummern (aus dem Referenzkontenplan (Plano de Contas Referencial), der von der Receita Federal standardisiert wird) als jahresübergreifenden Abgleichsschlüssel, anstelle der internen Kontonummern des Unternehmens, die sich geändert haben könnten.
F: Gibt es eine Dateigrößenbeschränkung für die Stapelverarbeitung?
ImageToTable.ai verarbeitet die ECD-Datei als PDF oder als Satz von Seitenbildern. Bei einer typischen ECD-Datei (80.000–150.000 Zeilen) umfasst die PDF-Version etwa 200–400 Seiten. Das Tool verarbeitet Seite für Seite. Bei sehr großen Dateien können Sie diese mit der Seitenbereichsaufteilung des PDFs in Abschnitte nach Bloco aufteilen (z. B. Bloco C in einem Durchlauf, Bloco I in einem anderen).
F: Funktioniert dieser Ansatz auch für Lucro Presumido-Unternehmen?
Ja. Lucro Presumido-Unternehmen reichen die ECD mit derselben Registro-Struktur ein und haben denselben Bedarf an jahresübergreifenden Kontenvergleichen. Der ECF-Umfang ist geringer (kein e-Lalur mit permanenten Differenzen), aber die ECD-Extraktion und die jahresübergreifende Saldenvortragsanalyse funktionieren identisch.
Von der Compliance-Last zur Analyse-Ressource
Jede SPED-Übermittlung ist in gewisser Weise eine Verschwendung analytischen Potenzials. Die Daten, die Ihr Buchhaltungssystem das ganze Jahr über produziert hat – jeder Buchungssatz, jeder Kontosaldo, jede Steuerkorrektur – werden in ein Format umstrukturiert, das für einen einzigen Leser optimiert ist (das Validierungssystem der Receita Federal) und ohne erheblichen manuellen Aufwand für keinen anderen Zweck nutzbar ist. Die Ironie: Dies ist der vollständigste Finanznachweis Ihres Geschäftsjahres, detaillierter als jeder Managementbericht, den Ihr ERP exportiert.
Die Batch-Verarbeitung ändert die Gleichung. Wenn Sie Saldenlisten, Steuerkorrekturen und Kostendaten aus mehreren Jahren an einem einzigen Nachmittag extrahieren können, wandelt sich die SPED-Datei von einem Compliance-Dokument, das Sie einreichen und vergessen, zu einem Analyse-Datensatz, den Sie aktiv nutzen. Vorjahresvergleichsanalysen. Trendverfolgung des effektiven Steuersatzes. Profitabilitätstrendlinien nach Abteilung. All dies wird zum Output desselben Extraktions-Workflows – nicht zu separaten Projekten, die separate Datenaufbereitungszyklen erfordern.
Die Spaltendefinition, die Sie dieses Jahr schreiben, ist eine wiederverwendbare Ressource. Nächstes Jahr, wenn die neue ECD-Datei auf Ihrem Schreibtisch landet, führen Sie sie mit derselben Definition aus. Der Vergleich ist in Minuten fertig, nicht in Stunden.