80.000 linhas por ano, uma única planilha
Como processar em lote arquivos de leiaute do SPED para análise de vários anos
Uma empresa brasileira de médio porte registra cerca de 80.000 a 150.000 linhas de dados de Escrituração Contábil Digital (ECD) por ano. Em uma janela de comparação de três anos, isso representa um quarto de milhão de linhas de códigos de Registro separados por pipe, distribuídas em três arquivos de texto distintos — cada um estruturado para validação automática pela Receita Federal, não para análise humana. Cada linha é um registro que você pode precisar: um lançamento de balancete, uma linha de diário ou um ajuste fiscal do e-Lalur. Mas extrair as contas específicas de que você precisa em vários anos significa abrir cada arquivo, filtrar pelo código de Registro, alinhar colunas manualmente e unir os resultados em uma nova planilha. Esse trabalho se repete toda vez que alguém faz uma pergunta que envolve vários anos.
Este artigo aborda a alternativa: tratar vários anos de arquivos SPED como um único lote, definir suas colunas de saída uma única vez e extrair apenas os dados necessários para uma única tabela pronta para análise — seja a origem dos dados abrangendo dois arquivos ECD, um arquivo ECF ou três anos fiscais com diferentes versões de Leiaute. A abordagem não exige um parser para cada tipo de Registro. Ela funciona entre anos, entre versões de layout e através da fronteira ECD↔ECF.
Por que "Abrir um Arquivo por Vez" Não Funciona para Análise Entre Anos
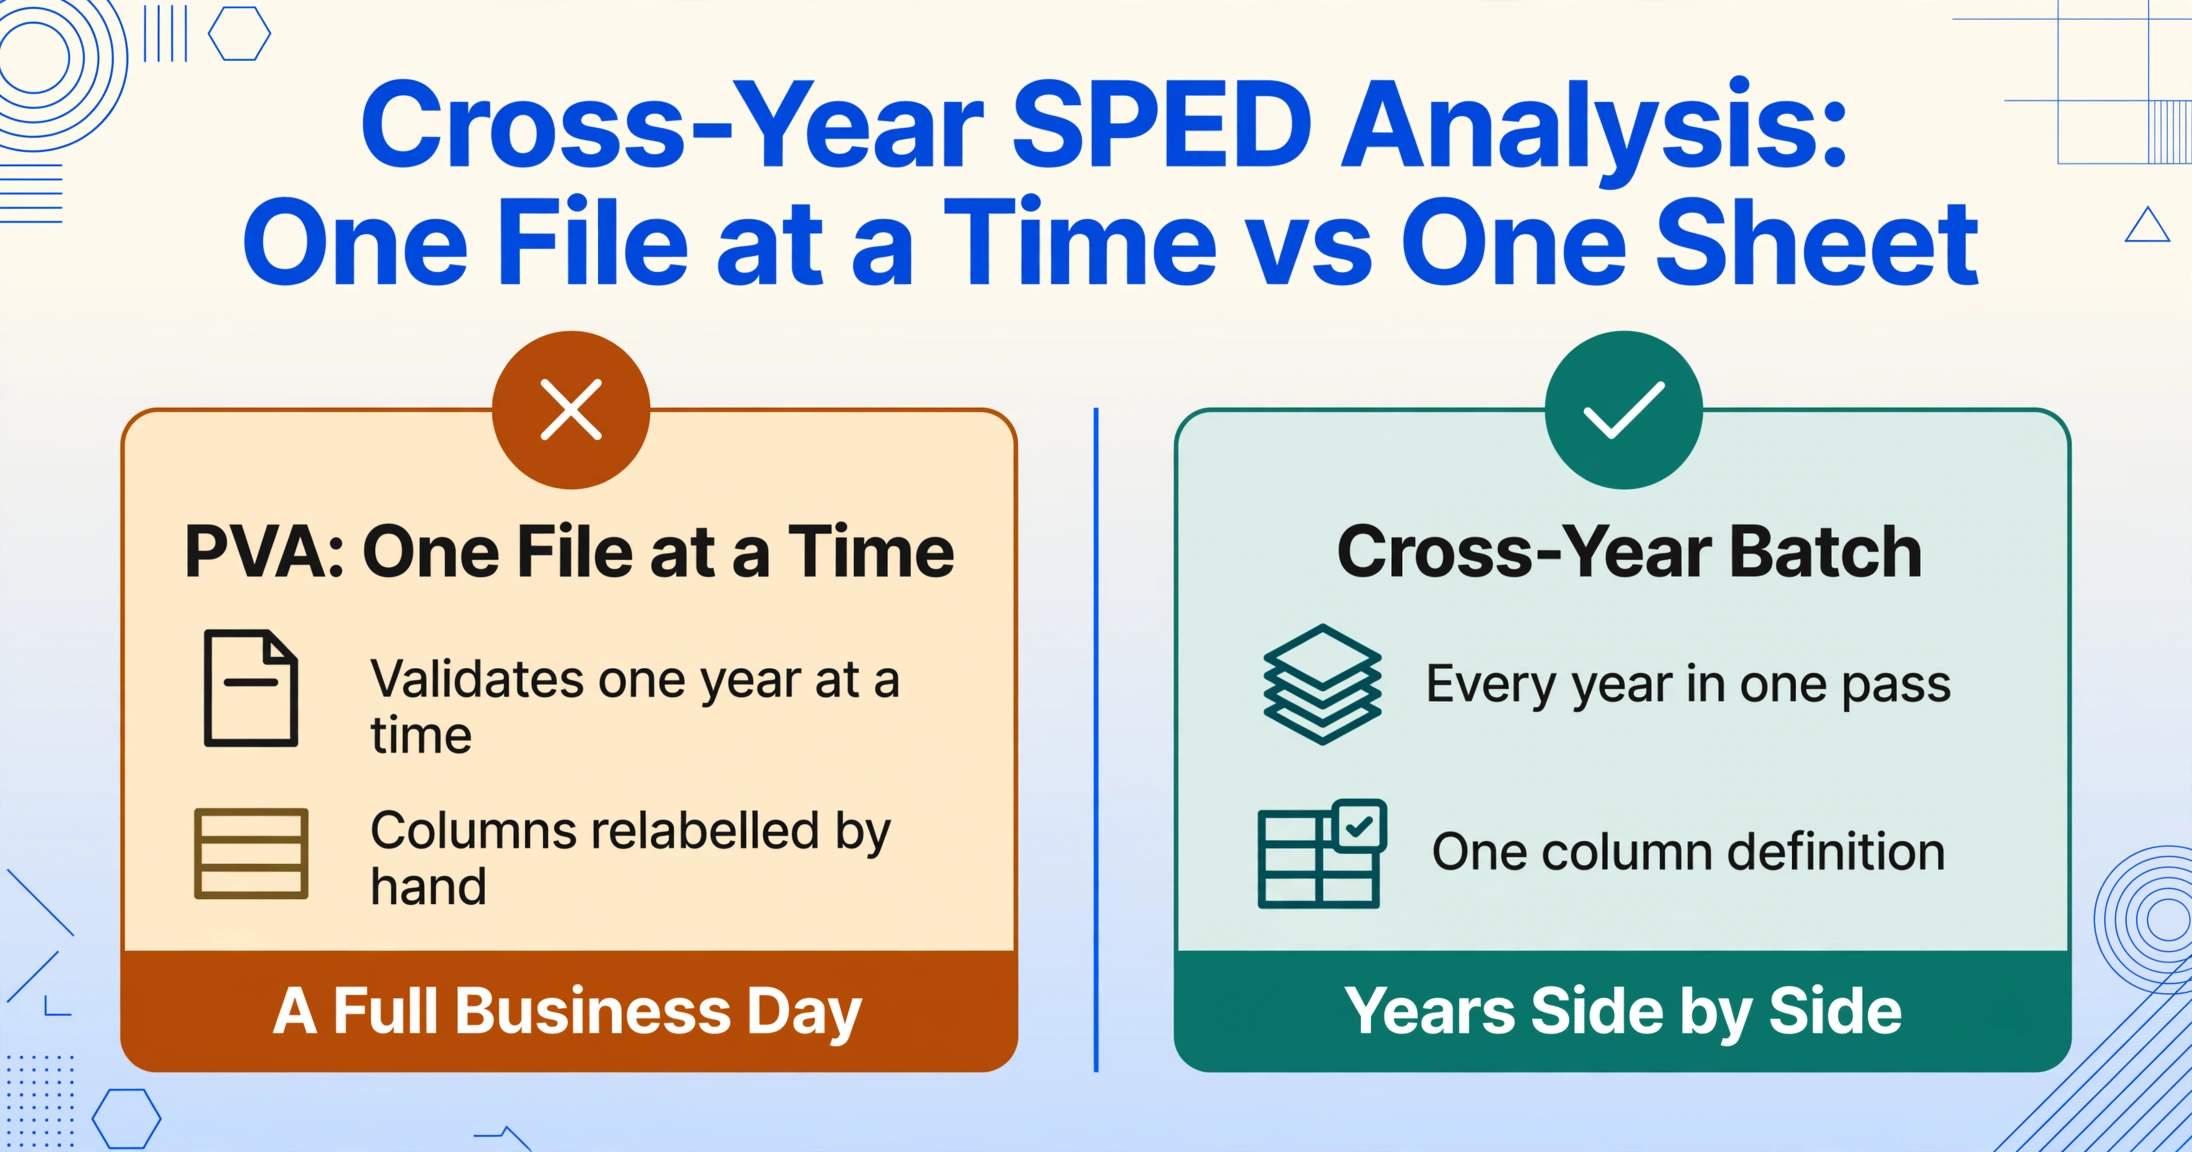
O Sistema Público de Escrituração Digital foi projetado para dar à Receita Federal um pipeline único e padronizado para receber registros contábeis. Ele teve sucesso nisso. O que ele não oferece é qualquer mecanismo embutido para comparar os dados de um ano com os de outro. Cada ano fiscal produz seu próprio arquivo ECD e seu próprio arquivo de Escrituração Contábil Fiscal (ECF). Os Programas Validadores e Assinadores (PVAs) validam e transmitem arquivos individuais. Eles não abrem dois lado a lado.
Isso significa que toda análise entre anos segue a mesma sequência manual: exportar o ECD do Ano 1 do PVA, exportar o ECD do Ano 2, abrir cada um no Excel com o assistente de importação de texto (delimitador pipe), filtrar os códigos de Registro relevantes, renomear as colunas (que mudam de posição dependendo de qual Registro você filtrou), construir uma tabela de comparação do zero e repetir para os dados de ajuste fiscal do ECF. O trabalho não é tecnicamente difícil — é mecanicamente repetitivo, propenso a erros e leva horas a cada vez.
Uma equipe de contabilidade lidando com três anos de dados ECD em dois regimes tributários (Lucro Real em um ano, uma fusão no segundo) poderia facilmente gastar um dia inteiro de trabalho apenas preparando os dados de entrada para uma única pergunta analítica.
O Que uma Análise SPED de Vários Anos Realmente Exige
Quando um controller financeiro ou gerente fiscal pede uma comparação de vários anos, eles normalmente querem uma das seguintes visões:
"Mostre-me o saldo inicial, o saldo final e o movimento líquido de cada conta nos últimos três anos — lado a lado."
Isso exige extrair o Registro C155 (balancete) de cada ano da ECD, alinhar os códigos de conta do plano de contas C050 e construir uma tabela de comparação horizontal em que cada linha é um Código de Conta Referencial e os saldos de cada ano aparecem em colunas adjacentes.
"Quais diferenças permanentes no e-Lalur mudaram significativamente de um ano para o outro?"
Isso significa extrair o Registro M300 (ajustes da Parte A do e-Lalur) de cada ano da ECF, filtrar por tipo de ajuste (adições, exclusões, compensações) e comparar os valores anuais lado a lado. Uma variação de 30% em um tipo específico de ajuste sinaliza uma mudança de negócio ou um erro de classificação que vale a pena investigar.
"Como nossa alíquota efetiva de imposto mudou ao longo de três anos e quais ajustes impulsionaram essa mudança?"
Isso exige combinar dados da ECD (base de lucro contábil do Bloco E na ECF) com dados da ECF (ajustes do e-Lalur do Bloco M) em vários anos — dois tipos diferentes de arquivo, duas estruturas diferentes de Registro, uma única pergunta analítica.
O ponto em comum: cada pergunta abrange vários arquivos, vários tipos de Registro e vários anos. O gargalo não é se os dados existem — eles existem, em detalhes exaustivos. O gargalo é reestruturá-los do layout orientado a arquivos do ecossistema SPED para um layout orientado a perguntas.
Estratégia de Processamento em Lote: Pense em Colunas de Saída, Não em Formatos de Arquivo
A principal percepção para o processamento em lote de arquivos SPED é que a estrutura do Registro — embora obscura — é internamente consistente. O mesmo leiaute do Registro C155 que carregou o balancete do ano passado carrega o deste ano. Os mesmos campos M300 que descreveram as diferenças permanentes do ano passado descrevem as deste ano. As mudanças de leiaute são pouco frequentes e em nível de campo (a transição do Leiaute 8 para 9 na ECD, ou de 11 para 12 na ECF), e não alteram a relação fundamental entre os tipos de Registro e os conceitos contábeis que eles representam.
Essa consistência significa que você pode definir sua estrutura de saída uma única vez e aplicá-la ao longo dos anos. Em vez de pensar "preciso abrir a ECD 2024, filtrar por C155, mapear os campos e repetir para 2025", você pensa "preciso dos saldos das contas de 2024 e 2025 lado a lado" — e deixa a camada de extração lidar com a reestruturação de cada arquivo.
Extração de Colunas Personalizadas foi projetada exatamente para esse cenário. Você nomeia as colunas que deseja — "Código da Conta", "Nome da Conta", "Saldo Inicial", "Saldo Final" — e a IA lê o arquivo SPED para localizar e extrair esses valores dos registros relevantes, independentemente do ano do arquivo que você indicar. A mesma definição de coluna que produziu um balancete limpo a partir da ECD 2023 gera uma estrutura idêntica a partir dos arquivos ECD 2024 e 2025, pois a relação semântica entre o Registro C155 e o conceito de "balancete" não mudou entre os anos.
O efeito prático: processar três anos de dados ECD exige definir suas colunas uma única vez, não três. O trabalho passa de "filtrar e alinhar 150.000 linhas três vezes" para "apontar para três arquivos com uma única definição de coluna".
Passo a Passo: Processamento em Lote de Múltiplos Anos de Dados ECD em um Balancete Interanual
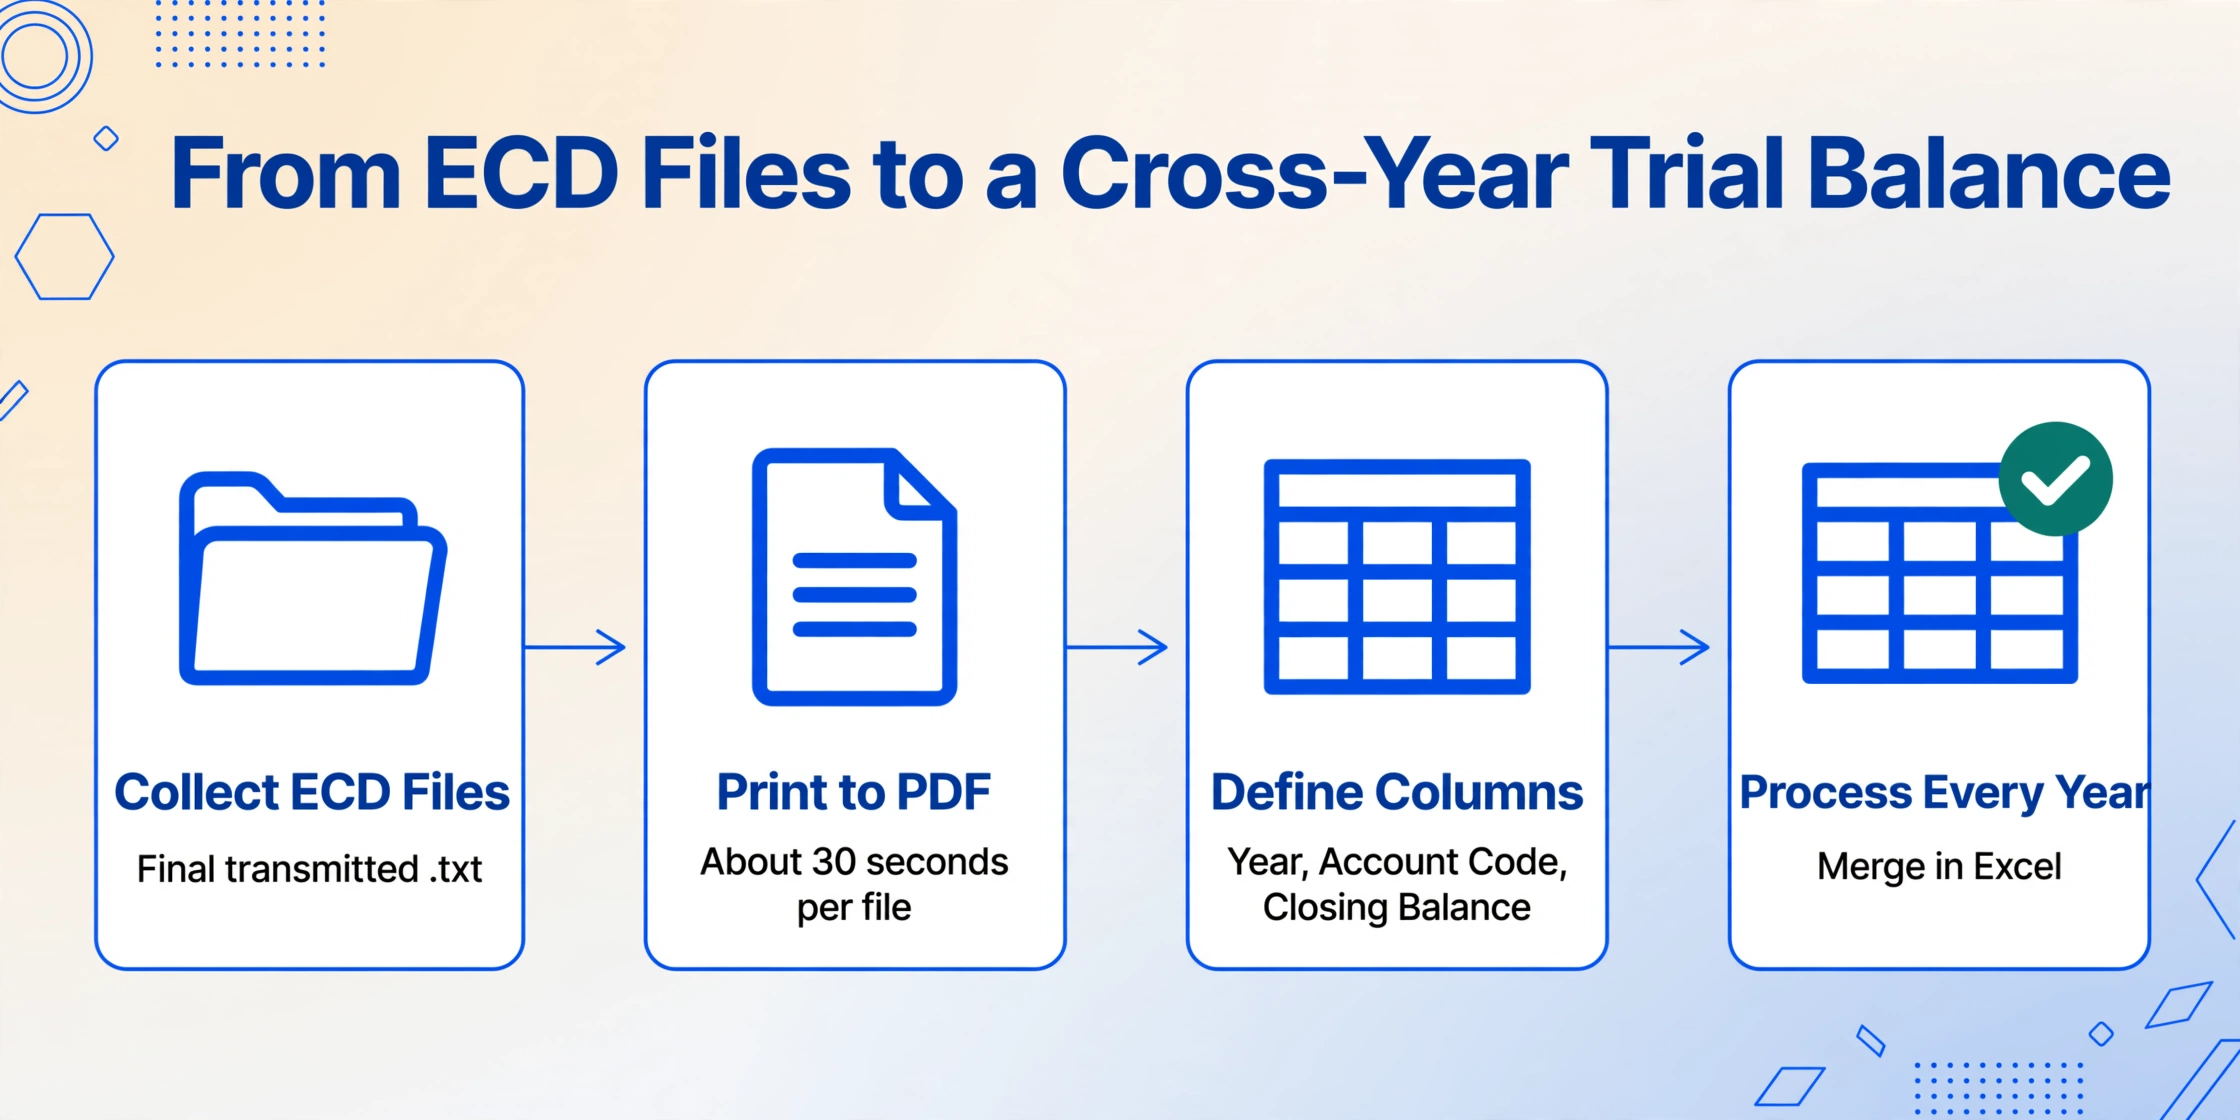
Este é o fluxo de trabalho para transformar dois ou três anos de arquivos ECD em uma tabela de comparação de contas ano a ano. A mesma lógica se aplica a dados ECF ou análises mistas de ECD+ECF.
Exporte os arquivos .txt validados do seu ERP (Omie, Conta Azul, Senior, Domínio, SAP TDF ou qualquer sistema que você use para a geração do SPED) ou dos arquivos do PVA. Você precisa da versão final transmitida — não de um rascunho — porque o arquivo transmitido é o que corresponde ao que a Receita Federal recebeu. Armazene todos os anos em uma única pasta.
O ImageToTable.ai aceita entradas em PDF, JPG, PNG e WebP. Para arquivos .txt, abra cada ECD em um visualizador de texto ou no visualizador de arquivos do PVA e imprima em PDF. O leiaute de largura fixa do formato SPED (delimitadores de pipe, colunas alinhadas) é visualmente consistente, então um PDF preserva a estrutura que a IA lê. Esta etapa leva cerca de 30 segundos por arquivo.
Configure uma definição de colunas que capture o balancete do ECD de qualquer ano. Suas colunas: Ano, Código da Conta, Nome da Conta, Saldo Inicial, Movimento Débito, Movimento Crédito, Saldo Final. Adicionar uma coluna "Ano" permite compilar resultados de vários anos em uma única tabela. O código da conta deve ser mapeado para o Plano de Contas Referencial do C050 para padronização entre anos.
Envie o PDF do Ano 1 e execute a extração com sua definição de colunas. Repita para o Ano 2 e o Ano 3. Como a definição de colunas é semântica — ela pede à IA para encontrar "Código da Conta", "Saldo Final", etc. pelo significado, não por deslocamento de bytes — ela funciona de forma idêntica entre arquivos, mesmo que o PVA tenha exportado o leiaute com pequenas diferenças de formatação entre anos. Cada execução produz uma tabela limpa com seus cabeçalhos.
Exporte os resultados de cada ano como .xlsx e empilhe-os em um único arquivo usando a coluna "Ano" para identificar o período de origem de cada linha. Monte sua tabela de comparação: filtre por código da conta e coloque o saldo inicial e final de cada ano em colunas adjacentes. Adicione colunas calculadas para a variação ano a ano (absoluta e percentual) e formatação condicional para sinalizar contas cujo movimento excedeu um limite, como 20% ou R$100.000.
O ciclo completo — de arquivos .txt a uma tabela multianual estruturada — leva cerca de 30 minutos para três anos de dados, uma vez que a definição de colunas esteja salva. Para o mesmo trabalho feito inteiramente no Excel com assistente de importação de texto e alinhamento manual, a estimativa é de três a quatro horas, com maior taxa de erro devido à filtragem manual e ao mapeamento de campos.
Se você repetir essa análise anualmente (comparando cada novo ano com o ano anterior como parte do ciclo de preparação da ECF), você salva a definição de coluna como um modelo. No ano seguinte, você executa a etapa 4 apenas no novo arquivo e anexa os resultados à sua planilha consolidada de vários anos.
Ampliando o Lote: Adicionando Dados de Ajustes Fiscais da ECF
A mesma lógica de lote se aplica aos arquivos da ECF. O Bloco M da ECF contém os ajustes do e-Lalur que determinam sua obrigação de IRPJ e CSLL — e comparar esses ajustes ano a ano revela como o planejamento tributário e as diferenças permanentes estão evoluindo.
Para adicionar dados da ECF à sua análise de vários anos, crie uma segunda definição de coluna direcionada aos Registros M300 (e-Lalur Parte A) e M350 (e-Lacs Parte A) da ECF:
Ano, Registro, Código da Conta, Tipo de Ajuste (Adição/Exclusão/Compensação), Valor do Ajuste, Número do Processo de Referência
Processe o PDF da ECF de cada ano usando essa definição, exporte e mescle em sua planilha consolidada junto com os dados do balancete da ECD. Agora você tem um único arquivo onde pode responder perguntas que cruzam a fronteira ECD↔ECF — como "a diferença permanente para a amortização do ágio mudou entre 2024 e 2025, e a provisão contábil correspondente foi registrada corretamente na ECD de cada ano?"
Insight-chave: O Bloco E da ECF (E010, E015) contém as contas mapeadas que vinculam os saldos contábeis da ECD aos ajustes fiscais da ECF. Incluí-los em seu lote fornece a tabela de referência cruzada necessária para rastrear qualquer ajuste da ECF de volta à sua conta original da ECD — uma verificação que o PVA não realiza para você.
O Que Acontece Quando o Leiaute Muda
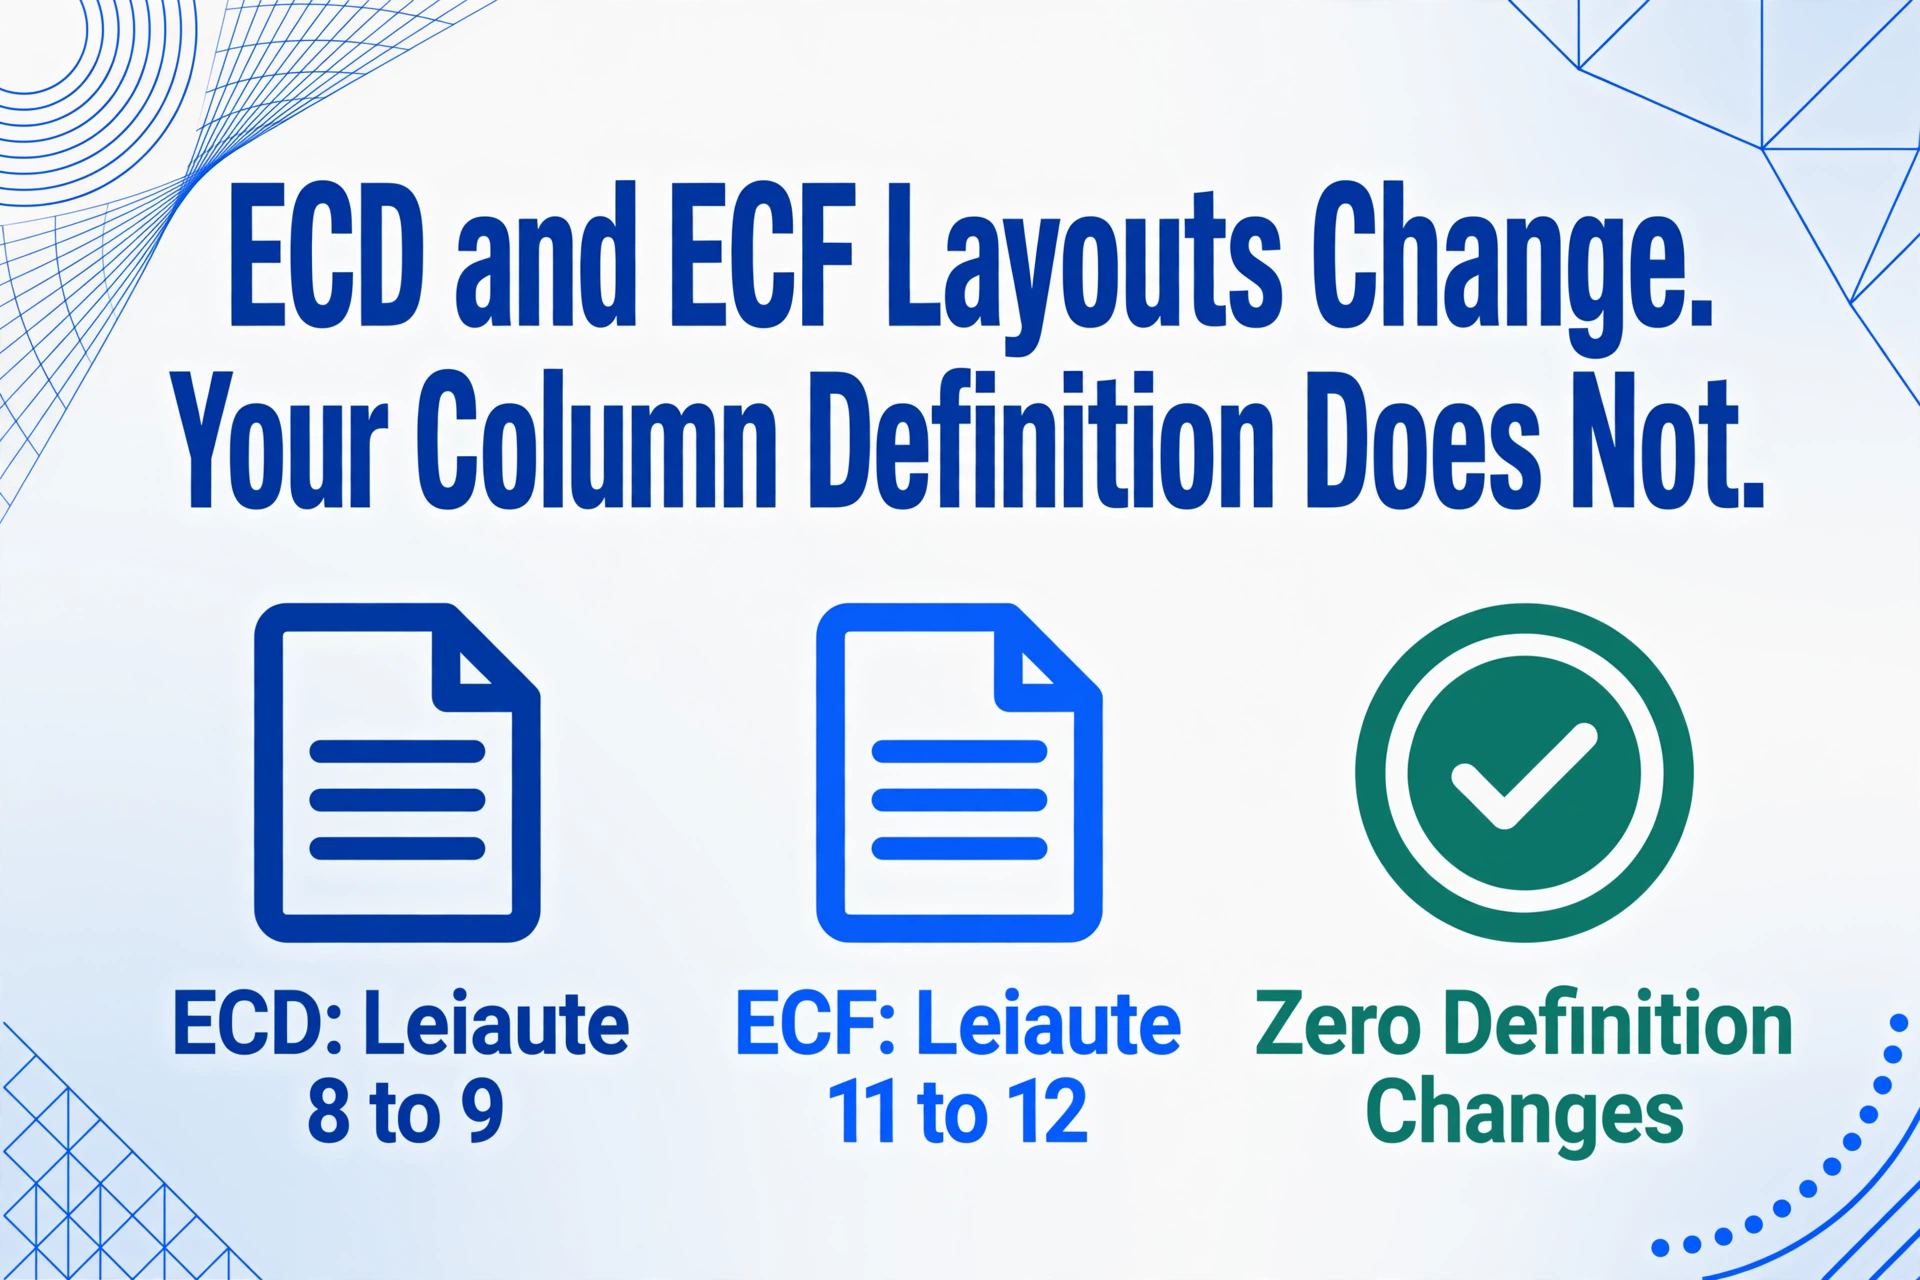
Os leiautes do SPED brasileiro evoluem. A ECD passou para o Leiaute 9 em 2020 (estável desde então, com atualizações em nível de campo por meio de atos da ADE Cofis). A ECF adotou o Leiaute 12 para as declarações do ano-calendário 2025 em 2026. Quando um leiaute muda, os parsers baseados em script precisam de atualizações de código. Uma abordagem de extração semântica lida com a transição de forma diferente: como a IA lê pelo significado — "este bloco de largura fixa descreve um lançamento de balancete" — em vez de pela posição absoluta do byte, a mesma definição de coluna frequentemente funciona em versões de leiaute, desde que o código do Registro e a estrutura conceitual do registro sejam preservados. Na prática, a transição do Leiaute 8 para 9 na ECD e de 11 para 12 na ECF não exigiu alterações na definição de coluna para extração de balancete ou e-Lalur, porque as estruturas centrais do Registro (C155, M300) permaneceram estáveis.
Perguntas Frequentes
P: Posso processar a ECD e a ECF em um único lote?
Cada arquivo precisa de sua própria passagem de extração porque as estruturas dos Registros são diferentes. Mas as definições de colunas, uma vez criadas, podem ser salvas como modelos e reutilizadas a cada ano. Processar a ECD leva uma passagem, a ECF leva uma segunda, e a consolidação acontece no Excel após a exportação de ambas.
P: Como isso lida com empresas que possuem livros departamentais (Bloco K) na ECD?
Se sua ECD incluir registros do Bloco K, você pode adicionar uma coluna "Centro de Custo" ou "Departamento" à sua definição. A IA lê as tags de centro de custo do nível K dos Registros C100 e K específicos da ECD e as inclui na tabela de saída. Isso é particularmente útil para análises de rentabilidade entre anos por unidade de negócio.
P: E se os códigos de conta mudarem entre os anos devido a uma fusão ou reestruturação?
Isso é um problema de correspondência de dados, não de extração. Extraia o plano de contas C050 de cada ano da ECD junto com os dados do balancete. Use os códigos de conta de referência (do Plano de Contas Referencial, que é padronizado pela Receita Federal) como a chave de correspondência entre anos, em vez dos números de conta internos da empresa, que podem ter mudado.
P: Existe um limite de tamanho de arquivo para processamento em lote?
O ImageToTable.ai processa o arquivo ECD como um PDF ou um conjunto de imagens de páginas. Para um arquivo ECD típico (80.000-150.000 linhas), a versão em PDF tem cerca de 200-400 páginas. A ferramenta processa página por página. Para arquivos muito grandes, você pode dividir em seções por Bloco (ex.: processar o Bloco C em uma passagem, o Bloco I em outra) usando a divisão de PDF por intervalo de páginas.
P: Esta abordagem funciona para empresas de Lucro Presumido?
Sim. Empresas de Lucro Presumido entregam a ECD com a mesma estrutura de Registros e têm a mesma necessidade de comparações de contas entre anos. O escopo da ECF é mais restrito (sem e-Lalur com diferenças permanentes), mas a extração da ECD e a análise do balancete entre anos funcionam de forma idêntica.
De Obrigação Fiscal a Ativo Analítico
Toda entrega do SPED é, de certa forma, um desperdício de potencial analítico. Os dados que seu sistema contábil produziu o ano inteiro — cada lançamento contábil, cada saldo de conta, cada ajuste fiscal — são reestruturados em um formato otimizado para um único leitor (o sistema de validação da Receita Federal) e efetivamente inúteis para qualquer outro propósito sem um trabalho manual significativo. A ironia é que este é o registro financeiro mais completo do ano fiscal da sua empresa, mais detalhado do que qualquer relatório gerencial que seu ERP exporta.
O processamento em lote muda essa equação. Quando você pode extrair balancetes, ajustes fiscais e dados de centro de custo de múltiplos anos em uma única tarde, o arquivo SPED deixa de ser uma entrega de conformidade que você submete e esquece para se tornar um conjunto de dados analíticos que você usa ativamente. Análise de variação ano a ano. Acompanhamento da tendência da alíquota efetiva de imposto. Linhas de tendência de lucratividade departamental. Tudo isso se torna resultado do mesmo fluxo de extração — não projetos separados que exigem ciclos separados de preparação de dados.
A definição de coluna que você escreve este ano é um ativo reutilizável. No ano que vem, quando o novo arquivo da ECD chegar à sua mesa, você o executa contra a mesma definição. A comparação fica pronta em minutos, não em horas.