NFS-e de Várias Cidades, Uma Planilha:
Lote Sem Modelos Municipais
O Brasil tem 5.570 municípios. Uma consultoria com prestadores de serviços em 10 deles não recebe um único formato de NFS-e (Nota Fiscal de Serviços Eletrônica). Recebe 10 — cada um com uma alíquota do ISS (Imposto Sobre Serviços) diferente, entre 2% e 5%, um layout de campos distinto e uma administração tributária municipal própria. Processar esses documentos um a um não é apenas lento. Isso oculta os padrões de conciliação que somente uma visão em lote revela. Para a análise completa de por que essa fragmentação municipal existe e quanto ela custa, consulte por que o processamento de NFS-e no Brasil é mais caro do que a maioria das equipes financeiras imagina.
Principais Conclusões
- É possível calcular o custo de tempo de digitar manualmente cada NFS-e — mas o custo real está oculto nas penalidades de retenção do ISS, nas anomalias de alíquota não detectadas e nas lacunas de conformidade que só se tornam visíveis quando todas as notas fiscais estão em uma única tabela.
- O ISS Retido na Fonte transfere legalmente o ônus do recolhimento do imposto para a sua empresa, e em 30 notas fiscais de 5 cidades, uma abordagem documento por documento garante que pelo menos uma obrigação será perdida.
- O ImageToTable.ai processa a NFS-e de todos os municípios em um único lote e evidencia discrepâncias de ISS, obrigações de retenção e totais por cidade em uma única planilha — assim, o trabalho passa de digitar números para verificá-los.
Por que o Processamento em Lote de NFS-e é um Problema Diferente da Extração de Documento Único
Se você leu o guia de extração de NFS-e individual, conhece o mecanismo central: a extração semântica lê uma NFS-e compreendendo o significado de cada campo — localizando o CNPJ do Prestador de 14 dígitos ao lado do rótulo "Prestador", a base de cálculo do ISS na seção do ISS, a alíquota do ISS onde quer que a prefeitura a tenha impresso. Um documento, um conjunto de definições de colunas, uma linha de saída. O problema da variação municipal é resolvido no nível do documento.
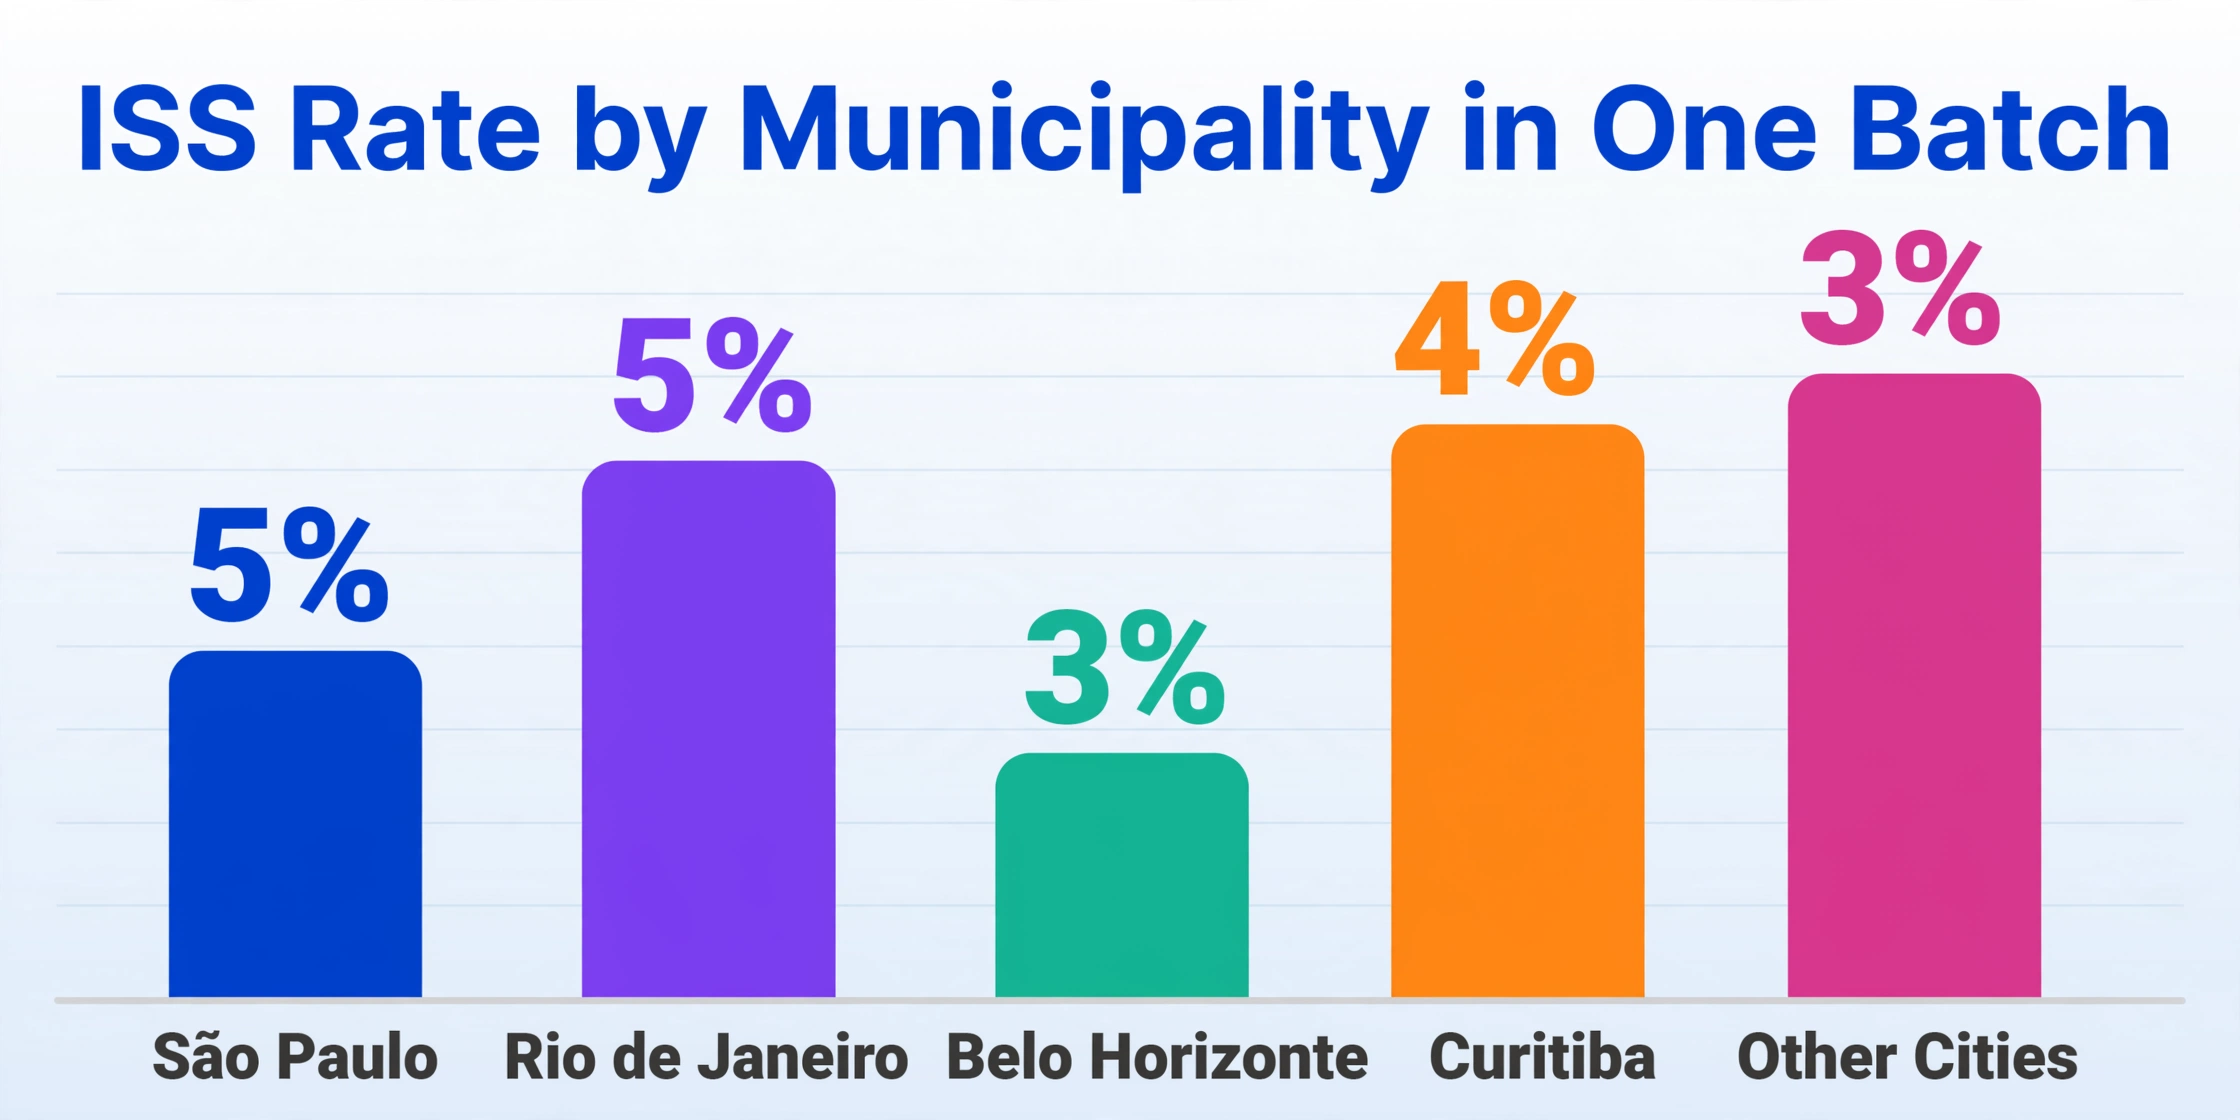
O processamento em lote introduz uma classe diferente de desafios que a extração de documento único não revela. Ao enviar 30 documentos NFS-e de prestadores de São Paulo (ISS 5% para consultoria de TI), Rio de Janeiro (ISS 5% para o mesmo serviço), Belo Horizonte (ISS 3%), Curitiba (ISS 4%) e outras seis cidades para uma única fila de processamento, três coisas acontecem que nunca acontecem com um documento único:
Primeiro, a verificação da alíquota do ISS entre cidades torna-se necessária. Uma NFS-e isolada com ISS de 3% parece correta. Mas quando você vê que o mesmo código de serviço (item 1.01 — Análise e desenvolvimento de sistemas) aparece a 5% em São Paulo, 5% no Rio e 3% em Belo Horizonte no mesmo lote, a alíquota de Belo Horizonte se destaca imediatamente. Talvez esteja correta — Belo Horizonte define suas próprias alíquotas. Talvez o prestador tenha aplicado a alíquota municipal errada. Uma visão em nível de lote é a única forma de identificar isso.
Segundo, o acompanhamento do ISS Retido na Fonte torna-se uma tarefa de conformidade em escala de lote. Quando uma NFS-e está marcada como "ISS Retido na Fonte = Sim", a obrigação de recolher o ISS passa do prestador de serviços para o tomador — você. Cada ocorrência exige um pagamento separado à prefeitura relevante, cada uma com sua própria data de vencimento e sistema de pagamento. Em 10 documentos de várias cidades, rastrear quais notas geram essa obrigação e quais não geram não é gerenciável como uma lista de verificação manual.
Terceiro, os dados em si são mais valiosos em conjunto. Totais de ISS por prestador, gastos com serviços por cidade, a proporção de imposto retido versus imposto pago pelo prestador — nada disso é visível em um documento por vez. Esses dados só emergem quando todo o lote está em uma única planilha.
Não se trata de fazer o fluxo de documento
O Que Torna o Processamento de NFS-e Entre Municípios Fundamentalmente Diferente do Lote de Notas Fiscais Padrão
O processamento padrão de notas fiscais em lote — 50 PDFs de 50 fornecedores nos EUA ou na Europa — é principalmente um problema de volume. As notas são visualmente diferentes, mas a lógica tributária subjacente é consistente: IVA à alíquota nacional, imposto sobre vendas por estado, e os campos estão em posições amplamente previsíveis, com rótulos amplamente previsíveis.
O processamento em lote de NFS-e brasileiras adiciona uma camada estrutural que o lote padrão de notas não possui. Como o ISS é um imposto municipal regido pela Lei Complementar 116/2003, e como cada município opera seu próprio sistema tributário, o mesmo campo lógico — "a alíquota do ISS" — pode ter um valor diferente para cada documento do lote, e esse valor determina se o imposto daquele documento foi calculado corretamente.
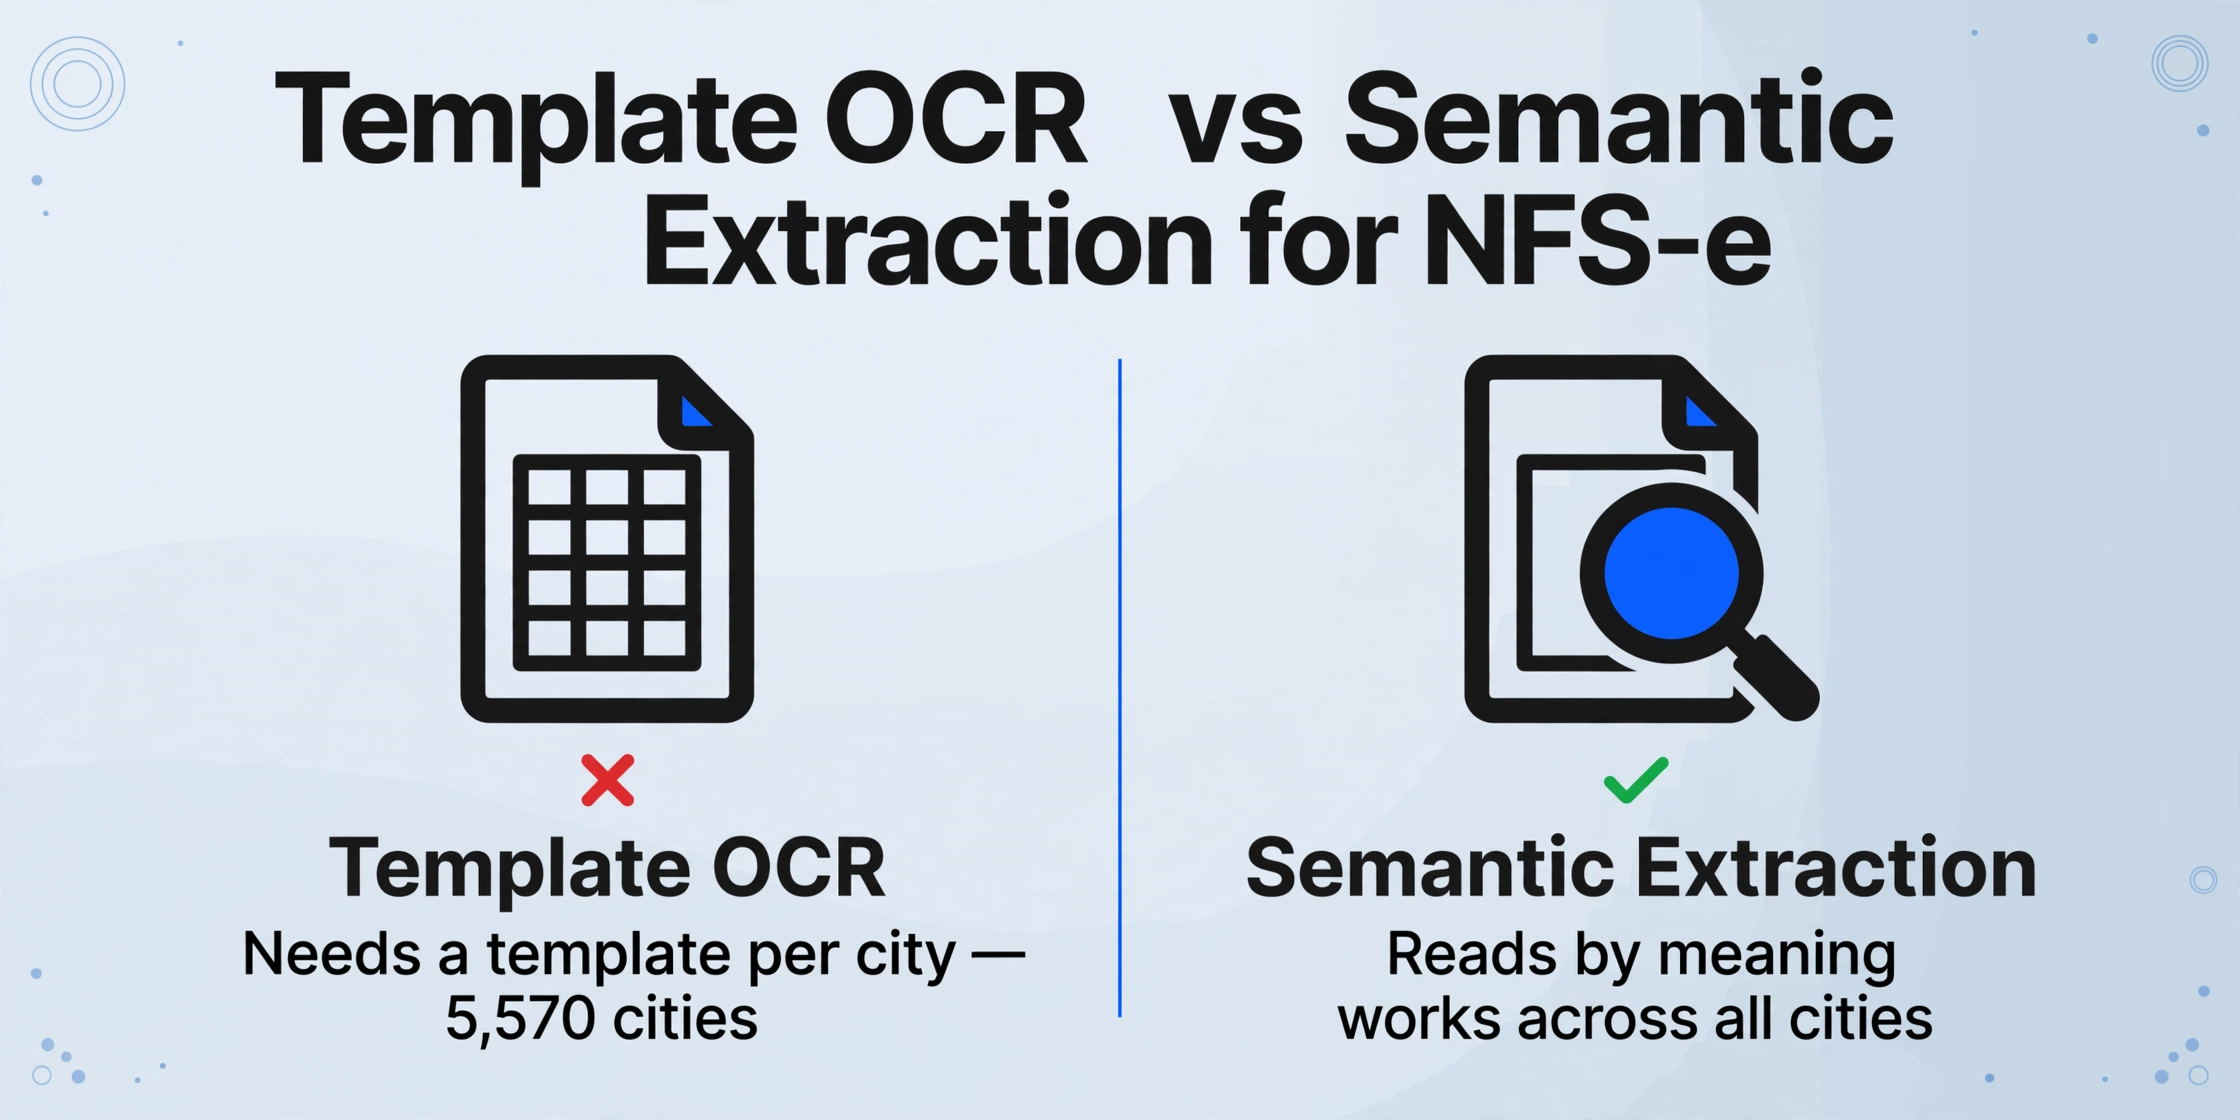
É aqui que a extração baseada em modelo — a abordagem usada pela maioria das ferramentas de extração de documentos — torna-se estruturalmente inviável. Um modelo define uma zona retangular para cada campo: "o CNPJ do Prestador está na posição de pixel (x=150, y=320)." Isso funciona para um município. Quebra para o próximo. Manter uma biblioteca de modelos para cada cidade onde seus fornecedores operam não é prático quando o número de cidades possíveis é 5.570 e o número de cidades que atualizam ativamente seus layouts — São Paulo lançou a versão 3.2 do seu manual de NFS-e em agosto de 2025 — está em constante crescimento.
A alternativa é a extração semântica: em vez de definir onde um campo está na página, o usuário informa ao mecanismo de extração o que está procurando — "o CNPJ de 14 dígitos rotulado como Prestador" — e ele lê o documento para encontrá-lo. A posição não importa porque o mecanismo entende o conteúdo do documento, não suas coordenadas. Uma NFS-e de São Paulo e uma de Porto Alegre no mesmo lote são processadas com as mesmas definições de coluna, porque a IA busca significado, não correspondência de posição.
Esta é a diferença arquitetônica: ferramentas baseadas em modelo escalam adicionando mais modelos — um por cidade, por revisão de layout. A extração semântica escala compreendendo mais conteúdo documental. Ao adicionar a NFS-e de uma 10ª cidade ao lote, o custo é efetivamente zero. Ao adicionar um modelo para uma 10ª cidade, o custo é construir, testar e manter esse modelo — e atualizá-lo sempre que a prefeitura mudar seu layout.
Para a análise completa de como a extração semântica lida com campos individuais de NFS-e — correspondência de CNPJ, classificação de serviço pela LC 116, o detalhamento do ISS — consulte o guia de extração de NFS-e individual. O fluxo de trabalho em lote herda tudo isso e adiciona a camada de múltiplos documentos.
Como a Extração Semântica Processa NFS-e de 10 Cidades em um Único Lote
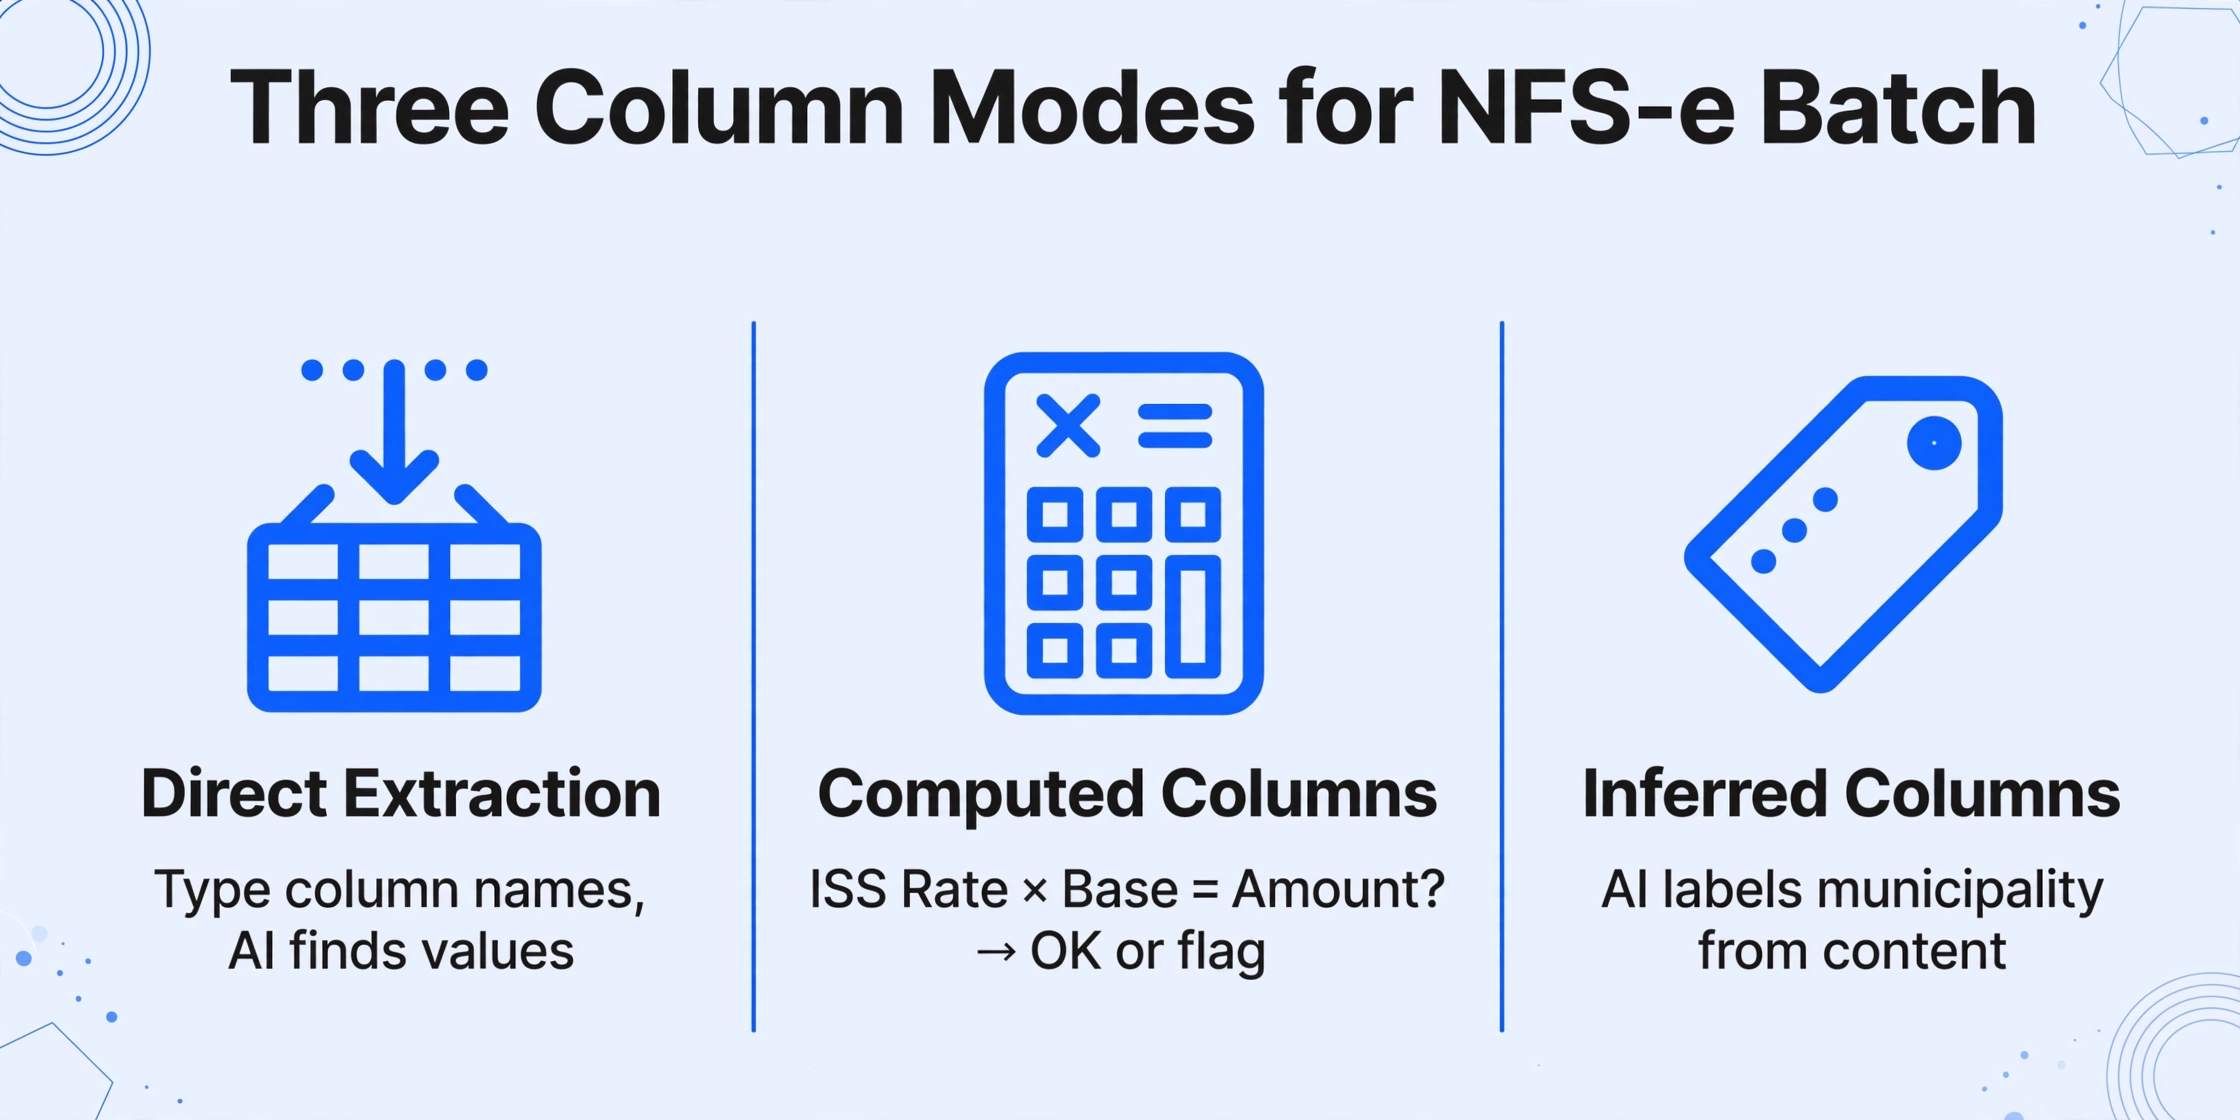
O fluxo de extração para processamento em lote de NFS-e se concentra na Extração de Colunas Personalizadas: você digita os nomes dos campos desejados na saída — "CNPJ do Prestador," "Código de Serviço (LC 116)," "Alíquota do ISS," "Valor do ISS," "ISS Retido na Fonte," "Número da NFS-e" — e a IA localiza cada valor em cada documento ao compreender o significado do rótulo. Esses nomes de coluna se tornam os cabeçalhos da sua planilha. Você os define uma vez. Eles funcionam em todos os municípios do lote.
Mas o processamento em lote de NFS-e se beneficia de ir além da extração direta. Dois modos adicionais de coluna tornam a conciliação entre cidades possível no momento da extração, não em um exercício separado de planilha:
Colunas calculadas permitem definir lógica de validação executada durante a extração. Para processamento em lote de NFS-e, a coluna calculada mais útil é uma verificação do ISS: "Alíquota do ISS × Base de Cálculo do ISS = Valor do ISS?" Quando o total calculado corresponde ao valor do ISS extraído, a coluna gera "OK." Quando não corresponde, ela gera a discrepância — sinalizando, no nível do lote, quais documentos precisam de uma segunda análise antes de importar os dados para o seu ERP. Em um único documento, essa verificação leva 30 segundos. Em 50 documentos, uma coluna calculada faz isso automaticamente — e você vê o resultado na mesma planilha dos dados extraídos.
Colunas inferidas permitem que a IA classifique ou rotule documentos com base no conteúdo. Adicione uma coluna chamada "Município (extraído do documento)" sem referência específica a campo, e a IA lê o identificador da prefeitura na NFS-e e preenche o nome da cidade. Agora sua saída em lote tem uma coluna de município classificável — tornando os totais de ISS por cidade e a declaração fiscal por cidade uma questão de tabela dinâmica, em vez de um exercício manual de referência cruzada.
Esses três tipos de coluna — extração direta, calculada e inferida — operam juntos em uma única execução de lote. Você não extrai primeiro e valida depois. A validação ocorre durante a extração, e os resultados chegam na mesma planilha.
Passo a Passo: De Pilha de NFS-e de Várias Cidades para uma Planilha
Veja o fluxo de trabalho prático para processar em lote documentos NFS-e de vários municípios brasileiros em um único arquivo Excel. Você configura isso uma vez por lote — as mesmas definições de colunas processam cada documento, independentemente da cidade de origem.
Os arquivos são processados com segurança e não são armazenados.
Conciliação de ISS entre Municípios: a Visão Exclusiva do Lote
O resultado mais valioso do processamento em lote de NFS-e não é o tempo economizado — embora passar de 3 minutos por documento para 5 a 10 segundos por página represente uma melhoria de 18x. O resultado mais valioso é a visão de conciliação que só existe quando todos os documentos estão em uma única tabela.
Veja o que essa visão permite fazer que o processamento de documentos individuais não permite:
Totais de ISS por Cidade
Agrupe a saída por município e some o valor do ISS. O resultado é o total de ISS aplicado às suas compras de serviços em cada cidade — um dado relevante por dois motivos. Primeiro, ele indica se o total de ISS de todos os prestadores em uma determinada cidade está alinhado com a sua alocação interna de custos para essa jurisdição. Segundo, se você for o responsável pela retenção do ISS em alguma dessas notas fiscais, o total por cidade é o número necessário para conciliar com os seus registros de recolhimento de impostos municipais. O guia tributário global da Dentons observa que "conflitos entre diferentes municípios, onde ambos reivindicam o ISS, são bastante comuns" — uma visão em lote é a sua trilha de auditoria caso um segundo município venha cobrar.
Acompanhamento de ISS Retido na Fonte
Quando uma NFS-e contém o indicador "ISS Retido na Fonte = Sim", a sua empresa — e não o prestador de serviços — é responsável por recolher o ISS ao município do prestador. Isso não é uma anotação de cadastro; é uma ação de conformidade fiscal com prazo e um sistema de pagamento que varia por cidade. Em uma saída em lote, classificar pela coluna ISS Retido fornece uma lista completa e unificada de todas as notas fiscais que exigem a sua ação. Sem precisar procurar em 30 PDFs individuais para encontrar as três que possuem o indicador.
O arcabouço legal em torno da retenção do ISS foi testado na mais alta corte do Brasil. Em 2020, o Supremo Tribunal Federal (STF) decidiu no RE 1167509 que os municípios não podem impor obrigações de retenção do ISS aos tomadores de serviços quando o prestador não está registrado naquele município — derrubando a exigência de cadastro no Cadastro de Prestadores de Outros Municípios (CPOM) de São Paulo. Mas as obrigações de retenção estabelecidas por lei federal, em que a combinação de tipo de serviço e município gera retenção legítima, permanecem em vigor. Saber quais notas fiscais possuem uma obrigação de retenção válida exige a visualização do lote.
Detecção de Variação da Alíquota do ISS
A LC 116/2003 estabelece alíquotas de ISS entre 2% e 5% por município e tipo de serviço. Mas os municípios competem em alíquotas para atrair empresas — o diagnóstico do PNUD sobre o sistema tributário brasileiro observa "uma guerra predatória de incentivos fiscais de ICMS e ISS". Um prestador pode aplicar uma alíquota de 2% para um código de serviço que São Paulo tributa a 5% porque o prestador está registrado em um município que reduziu sua alíquota para atrair empresas. Se essa alíquota é válida é uma determinação fiscal que a equipe contábil faz. Mas identificá-la exige enxergar o lote. Um único documento a 2% parece normal. Dez documentos a 5% e um a 2%, todos para o mesmo código de serviço — isso é uma variação que vale investigar.
O que o Padrão Nacional da NFS-e Significa para o Processamento em Lote
O SNNFS-e (Sistema Nacional da NFS-e) é o esforço do Brasil para unificar os formatos de notas fiscais de serviço entre os municípios. Em agosto de 2025, 1.463 municípios haviam aderido — mas a adesão é voluntária, e grandes cidades como São Paulo confirmaram publicamente que manterão seus próprios sistemas. O resultado é um cenário híbrido: alguns prestadores emitem NFS-e no padrão nacional de XML, outros no sistema próprio da cidade, e não há controle sobre qual será usado.
Do ponto de vista do processamento em lote, esse cenário híbrido reforça o valor da extração independente de formato. Ferramentas baseadas em modelo agora precisam de modelos tanto para os layouts municipais pré-padrão quanto para o padrão SNNFS-e — além de caminhos de atualização quando os municípios migrarem de um para o outro. A extração semântica lê o que está no documento, independentemente do padrão que o gerou. Uma NFS-e no padrão nacional e uma NFS-e no formato personalizado de São Paulo chegam no mesmo lote, definem as mesmas colunas e produzem a mesma saída. O processo de padronização muda o conteúdo do documento, não a abordagem de extração.
A reforma tributária de 2026 — que substituirá gradualmente o ISS pelo IBS (Imposto sobre Bens e Serviços) até 2033 — adiciona outra camada. Durante a transição, os documentos de NFS-e podem conter tanto campos legados de ISS quanto novos campos de IBS/CBS. A abordagem de extração se adapta adicionando novos nomes de colunas — "Valor do IBS", "Valor da CBS" — ao lado das colunas existentes de ISS. Nenhum redesenho de modelo é necessário.
Se a organização também processa notas fiscais de mercadorias brasileiras, o fluxo de extração de XML de NF-e é abordado no guia de extração de NF-e. Os dois tipos de documento podem coexistir no mesmo lote quando as definições de colunas são amplas o suficiente, embora campos específicos de NFS-e, como o código da LC 116, fiquem em branco para documentos de NF-e — o que é esperado e não causa erros.
Perguntas Frequentes: Processamento em Lote de NFS-e
Posso processar em lote documentos NFS-e de prestadores de diferentes cidades juntos?
Sim — e este é o principal caso de uso. A extração semântica lê cada documento de forma independente, entendendo o conteúdo, e não combinando com o layout de uma cidade específica. Uma NFS-e de São Paulo (ISS 5%), uma de Belo Horizonte (ISS 3%) e uma de Curitiba (ISS 4%) no mesmo lote são processadas com as mesmas definições de colunas. A IA localiza o CNPJ do Prestador, a base de cálculo do ISS e os demais campos em cada documento, independentemente de onde aparecem na página.
Como o ISS Retido na Fonte é tratado na saída do lote?
O campo "ISS Retido" é extraído como uma coluna dedicada — normalmente contendo "Sim" ou "Não". Na planilha de saída do lote, classificar por esta coluna fornece uma lista completa de todas as notas fiscais onde sua empresa é a fonte retentora. A partir daí, você calcula o valor a recolher (a alíquota de ISS × base de cada nota sinalizada) e direciona cada uma para o sistema de pagamento da prefeitura correta. A ferramenta de extração fornece os dados. O recolhimento do imposto em si permanece uma etapa de conformidade separada que sua equipe contábil realiza através do portal de pagamento de cada município.
E se um prestador emitir uma NFS-e com erros de layout ou campos ausentes?
O motor de extração lê o que está no documento. Se um campo obrigatório — o CNPJ, por exemplo — estiver ausente ou ilegível, essa célula na saída ficará em branco. Isso é útil: uma célula em branco na saída do lote identifica imediatamente qual documento precisa de acompanhamento com o prestador, enquanto a digitação manual de 30 documentos pode fazer você perder um campo em branco entre os demais. A visualização em lote torna as omissões visíveis.
Posso misturar documentos NFS-e com faturas de serviços internacionais no mesmo lote?
Sim. Se suas definições de colunas abrangerem ambos os tipos de documento — como "Número da Nota Fiscal", "Nome do Fornecedor", "Valor Total", "Valor do Imposto" — faturas internacionais e documentos NFS-e podem coexistir no mesmo lote. Colunas específicas de NFS-e, como "Código de Serviço LC 116" ou "Alíquota de ISS", ficarão em branco para documentos não brasileiros, e colunas específicas de documentos internacionais, como "Número de IVA", ficarão em branco para documentos NFS-e. Ambos os comportamentos são esperados e não causam erros.
O mecanismo de extração lida com os campos da reforma tributária de 2026 (IBS/CBS) em documentos NFS-e?
Sim — quando uma prefeitura atualiza o layout da NFS-e para incluir campos de IBS ou CBS, basta adicionar os nomes das colunas correspondentes (por exemplo, "Valor do IBS", "Valor da CBS") à definição do lote. O mecanismo de extração localiza esses novos campos compreendendo o conteúdo do documento, da mesma forma que localiza os campos existentes de ISS e CNPJ. Não é necessária reconfiguração de modelo. Durante o período de transição até 2033, é possível executar lotes contendo documentos NFS-e com campos de ISS e IBS — defina colunas para ambos, e a saída preencherá os campos presentes em cada documento.
Como o processamento em lote se compara à integração direta com a API de cada prefeitura?
A integração com APIs municipais exige criar e manter uma conexão separada para cada cidade onde seus prestadores atuam — cada uma com seu próprio método de autenticação, esquema e cronograma de atualização. O padrão nacional SNNFS-e simplifica isso para os municípios participantes, mas grandes cidades como São Paulo optaram por não aderir. A extração semântica em lote processa os documentos que você já recebe — PDFs, XMLs, impressões de DANFSE — sem exigir acesso via API a qualquer sistema municipal. Não é uma alternativa à integração via API para a emissão de NFS-e de saída. É a solução do lado do recebimento, para quando você é o tomador, não o emissor.
Para uma visão mais ampla da extração de documentos em lote além da NFS-e, veja como a extração de notas fiscais em lote para Excel funciona em diferentes tipos de documentos e moedas.
Da Digitação por Município à Conciliação por Lote
A NFS-e foi criada para tornar a arrecadação de impostos eficiente para o governo — e cumpre esse papel. Cada nota fiscal de serviço recebida foi validada pela autoridade tributária municipal antes de chegar à sua caixa de entrada. O CNPJ foi verificado. A alíquota do ISS foi conferida em relação ao código de serviço. O número da nota foi atribuído. Esses dados existem. São precisos. Passaram por uma etapa de validação governamental que a maioria das notas internacionais nunca vê.
A ineficiência está inteiramente no lado do recebimento: redigitar campos validados de documentos que variam por cidade em uma planilha que precisa estar correta para a conciliação no SPED. A extração semântica em lote elimina essa lacuna não tornando a digitação mais rápida, mas eliminando-a — e, ao fazer isso, oferece a visão entre municípios que a entrada manual jamais poderia produzir.
Na próxima vez que receber uma pilha de NFS-e de prestadores em São Paulo, Rio, Belo Horizonte e outras cidades, tente processá-las como um único lote. Defina suas colunas uma única vez. Deixe a extração rodar. Depois, classifique por município e confira os totais de ISS. Veja se a visão em lote revela algo que os documentos individuais não revelavam.
Sem necessidade de cadastro para as primeiras 50 páginas.