NFS-e aus mehreren Städten, eine Tabelle:
Batch ohne kommunale Vorlagen
Brasilien hat 5.570 Gemeinden. Eine Beratungsfirma mit Dienstleistern in 10 davon erhält nicht ein NFS-e-Format (Nota Fiscal de Serviços Eletrônica). Sie erhält 10 — jedes mit einem anderen ISS-Steuersatz (Dienstleistungssteuer) zwischen 2 % und 5 %, einem anderen Feldlayout und einer anderen Stadtverwaltung dahinter. Diese einzeln zu verarbeiten ist nicht nur langsam. Es verbirgt die Abstimmungsmuster, die nur eine Batch-Ansicht offenlegt. Die vollständige Analyse, warum diese kommunale Fragmentierung existiert und was sie kostet, finden Sie unter warum die brasilianische NFS-e-Verarbeitung teurer ist, als die meisten Finanzteams denken.
Die wichtigsten Erkenntnisse
- Sie können den Zeitaufwand für das manuelle Eintippen jeder NFS-e berechnen — doch die wahren Kosten verbergen sich in Strafen für einbehaltene ISS, übersehenen Satzanomalien und Compliance-Lücken, die erst sichtbar werden, wenn jede Rechnung in einer Tabelle steht.
- Einbehaltene ISS überträgt die Steuerabführungspflicht rechtlich auf Ihr Unternehmen, und bei 30 Rechnungen aus 5 Städten garantiert ein Dokument-für-Dokument-Ansatz, dass mindestens eine Verpflichtung übersehen wird.
- ImageToTable.ai verarbeitet die NFS-e jeder Gemeinde in einem Batch und zeigt ISS-Abweichungen, Einbehaltungspflichten und Summen pro Stadt in einer einzigen Tabelle — so verschiebt sich Ihre Aufgabe vom Eintippen von Zahlen zu deren Prüfung.
Warum die Batch-Verarbeitung von NFS-e ein anderes Problem ist als die Extraktion einzelner Dokumente
Wenn Sie den Leitfaden zur Extraktion einzelner NFS-e gelesen haben, kennen Sie den Kernmechanismus: Die semantische Extraktion liest eine NFS-e, indem sie versteht, was jedes Feld bedeutet — sie findet die 14-stellige CNPJ des Dienstleisters (steuerliche Unternehmensnummer des Dienstleisters) neben dem Label „Prestador“, die ISS-Bemessungsgrundlage im ISS-Abschnitt, den ISS-Steuersatz dort, wo die Stadtverwaltung ihn ausgedruckt hat. Ein Dokument, ein Satz Spaltendefinitionen, eine Ausgabezeile. Das Problem der kommunalen Unterschiede wird auf Dokumentebene gelöst.
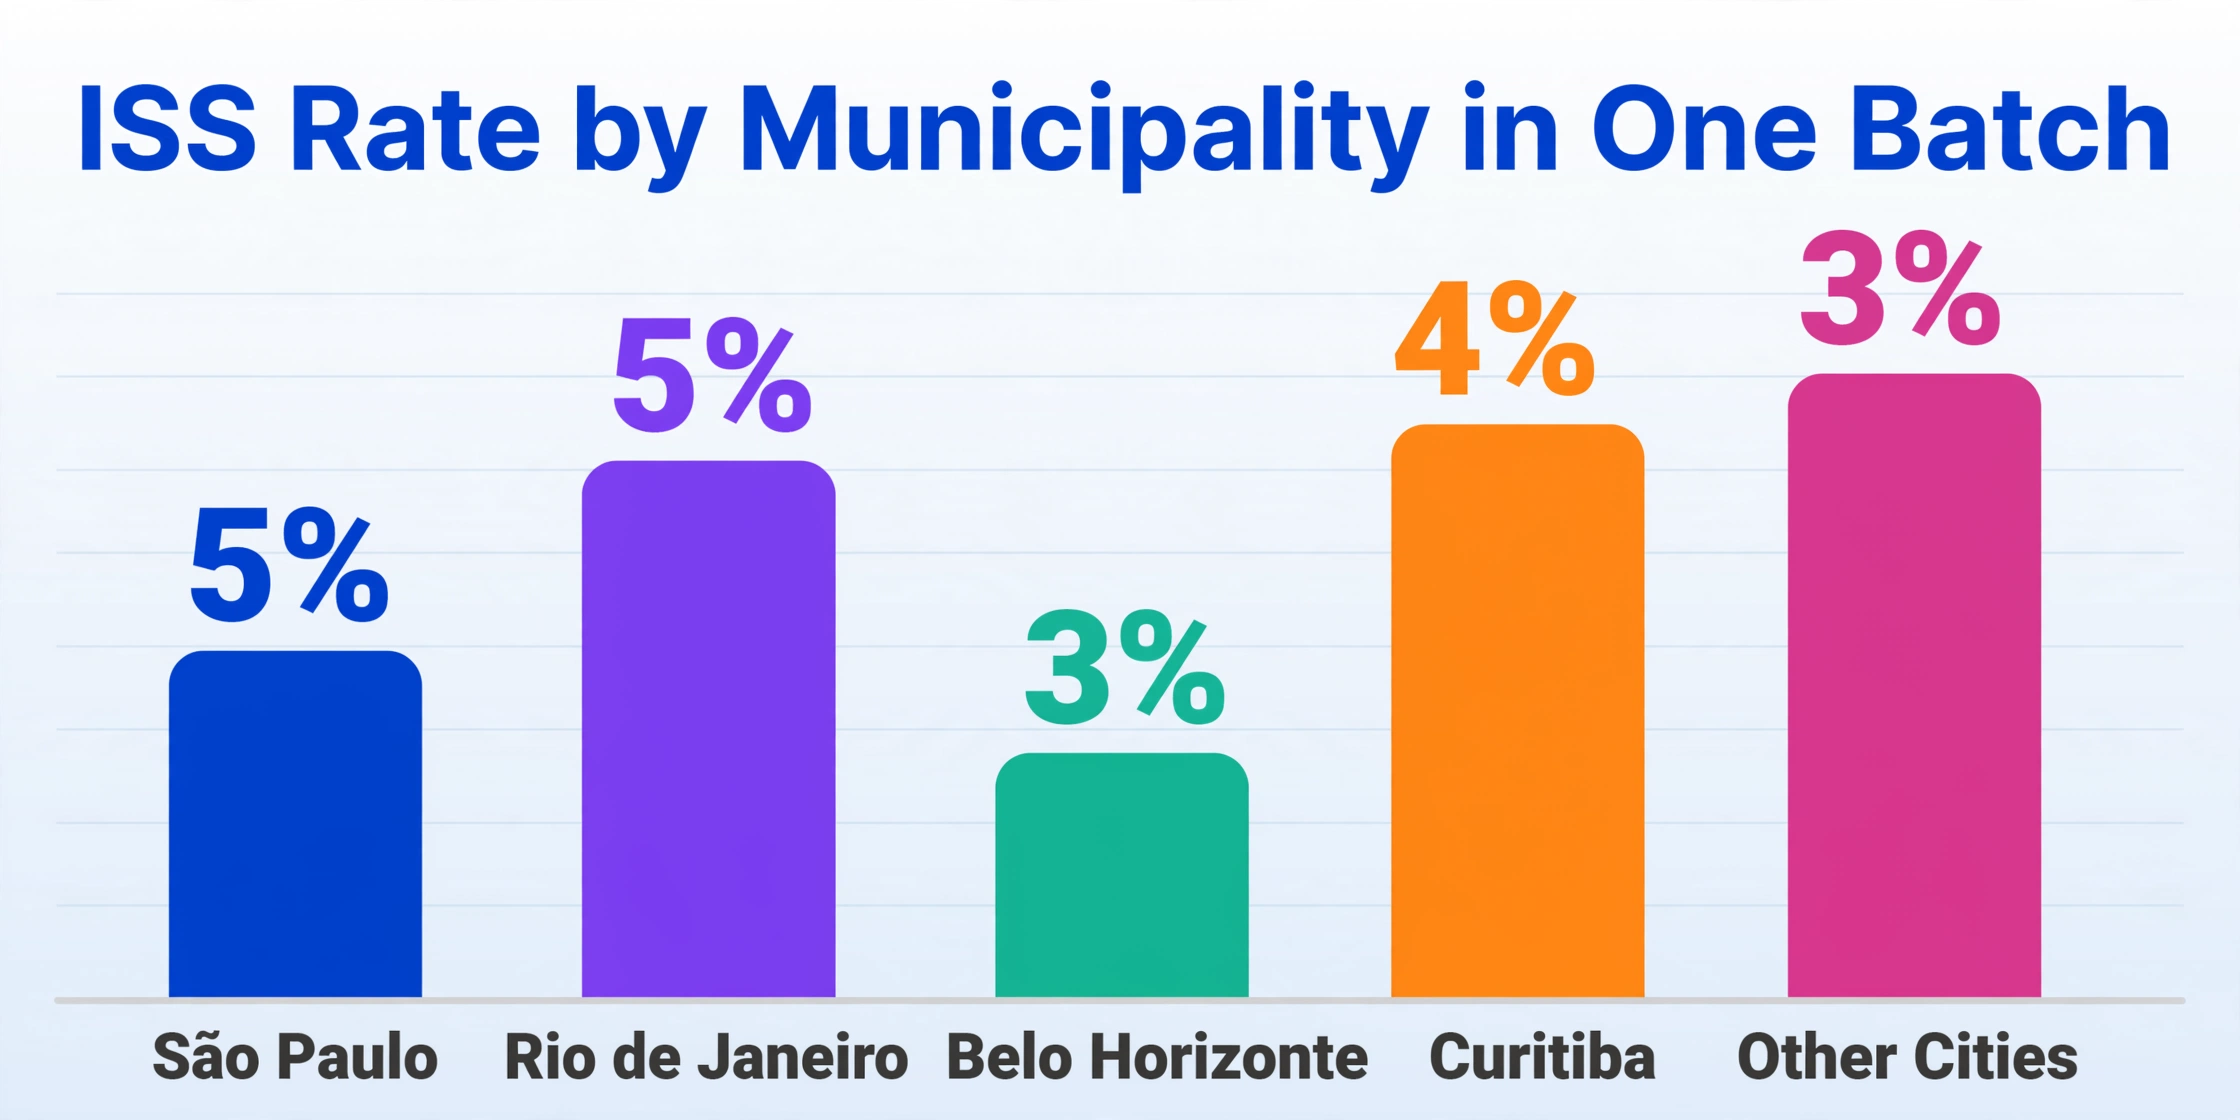
Die Batch-Verarbeitung bringt eine andere Klasse von Herausforderungen mit sich, die bei der Extraktion einzelner Dokumente nicht auftreten. Wenn Sie 30 NFS-e-Dokumente von Dienstleistern aus São Paulo (ISS 5 % für IT-Beratung), Rio de Janeiro (ISS 5 % für dieselbe Leistung), Belo Horizonte (ISS 3 %), Curitiba (ISS 4 %) und sechs weiteren Städten in eine Verarbeitungswarteschlange geben, passieren drei Dinge, die bei einem einzelnen Dokument nie passieren:
Erstens wird die stadtübergreifende Überprüfung der ISS-Steuersätze notwendig. Eine einzelne NFS-e mit 3 % ISS sieht isoliert betrachtet in Ordnung aus. Wenn jedoch derselbe Leistungscode (Position 1.01 — Análise e desenvolvimento de sistemas, also IT-Analyse und -Entwicklung) im selben Batch mit 5 % aus São Paulo, 5 % aus Rio und 3 % aus Belo Horizonte erscheint, fällt der Satz aus Belo Horizonte sofort auf. Vielleicht ist er korrekt — Belo Horizonte legt seine eigenen Sätze fest. Vielleicht hat der Dienstleister den falschen kommunalen Satz angewendet. Eine Betrachtung auf Batch-Ebene ist die einzige Möglichkeit, dies zu erkennen.
Zweitens wird die Nachverfolgung der einbehaltenen ISS zu einer Compliance-Aufgabe auf Batch-Ebene. Wenn eine NFS-e mit „ISS Retido na Fonte = Sim“ gekennzeichnet ist, geht die Verpflichtung zur Abführung der ISS vom Dienstleister auf den Dienstleistungsempfänger über — auf Sie. Jeder Fall erfordert eine separate Zahlung an die zuständige Stadtverwaltung, jeweils mit eigenem Fälligkeitsdatum und eigenem Zahlungssystem. Bei 10 Dokumenten aus mehreren Städten ist die Nachverfolgung, welche Rechnungen diese Verpflichtung auslösen und welche nicht, als manuelle Checkliste nicht zu bewältigen.
Drittens sind die Daten selbst in aggregierter Form wertvoller. ISS-Summen pro Dienstleister, Ausgaben pro Stadt, das Verhältnis von einbehaltener zu vom Dienstleister gezahlter Steuer — nichts davon ist aus einem einzelnen Dokument heraus sichtbar. Es entsteht erst, wenn der gesamte Batch in einer Tabelle vorliegt.
Hier geht es nicht darum, den Workflow für einzelne Dokumente schneller zu machen. Es geht darum, etwas zu tun, was der Workflow für einzelne Dokumente überhaupt nicht leisten kann.
Warum sich die NFS-e-Verarbeitung über mehrere Gemeinden grundlegend vom Standard-Rechnungs-Batch unterscheidet
Die Standard-Batch-Verarbeitung von Rechnungen — 50 PDFs von 50 Lieferanten in den USA oder Europa — ist in erster Linie ein Mengenproblem. Die Rechnungen sehen unterschiedlich aus, aber die zugrunde liegende Steuerlogik ist einheitlich: MwSt. zum nationalen Satz, Umsatzsteuer je Bundesstaat, und die Felder befinden sich in weitgehend vorhersehbaren Positionen mit weitgehend vorhersehbaren Bezeichnungen.
Die brasilianische NFS-e-Batch-Verarbeitung fügt eine strukturelle Ebene hinzu, die der Standard-Rechnungs-Batch nicht hat. Da es sich bei der ISS um eine kommunale Steuer handelt, die durch das Ergänzungsgesetz 116/2003 geregelt wird, und da jede Gemeinde ihr eigenes Steuersystem betreibt, kann dasselbe logische Feld — „der ISS-Steuersatz“ — für jedes Dokument im Batch einen anderen Wert tragen, und dieser Wert entscheidet darüber, ob die Steuer auf dieses Dokument korrekt berechnet wurde.
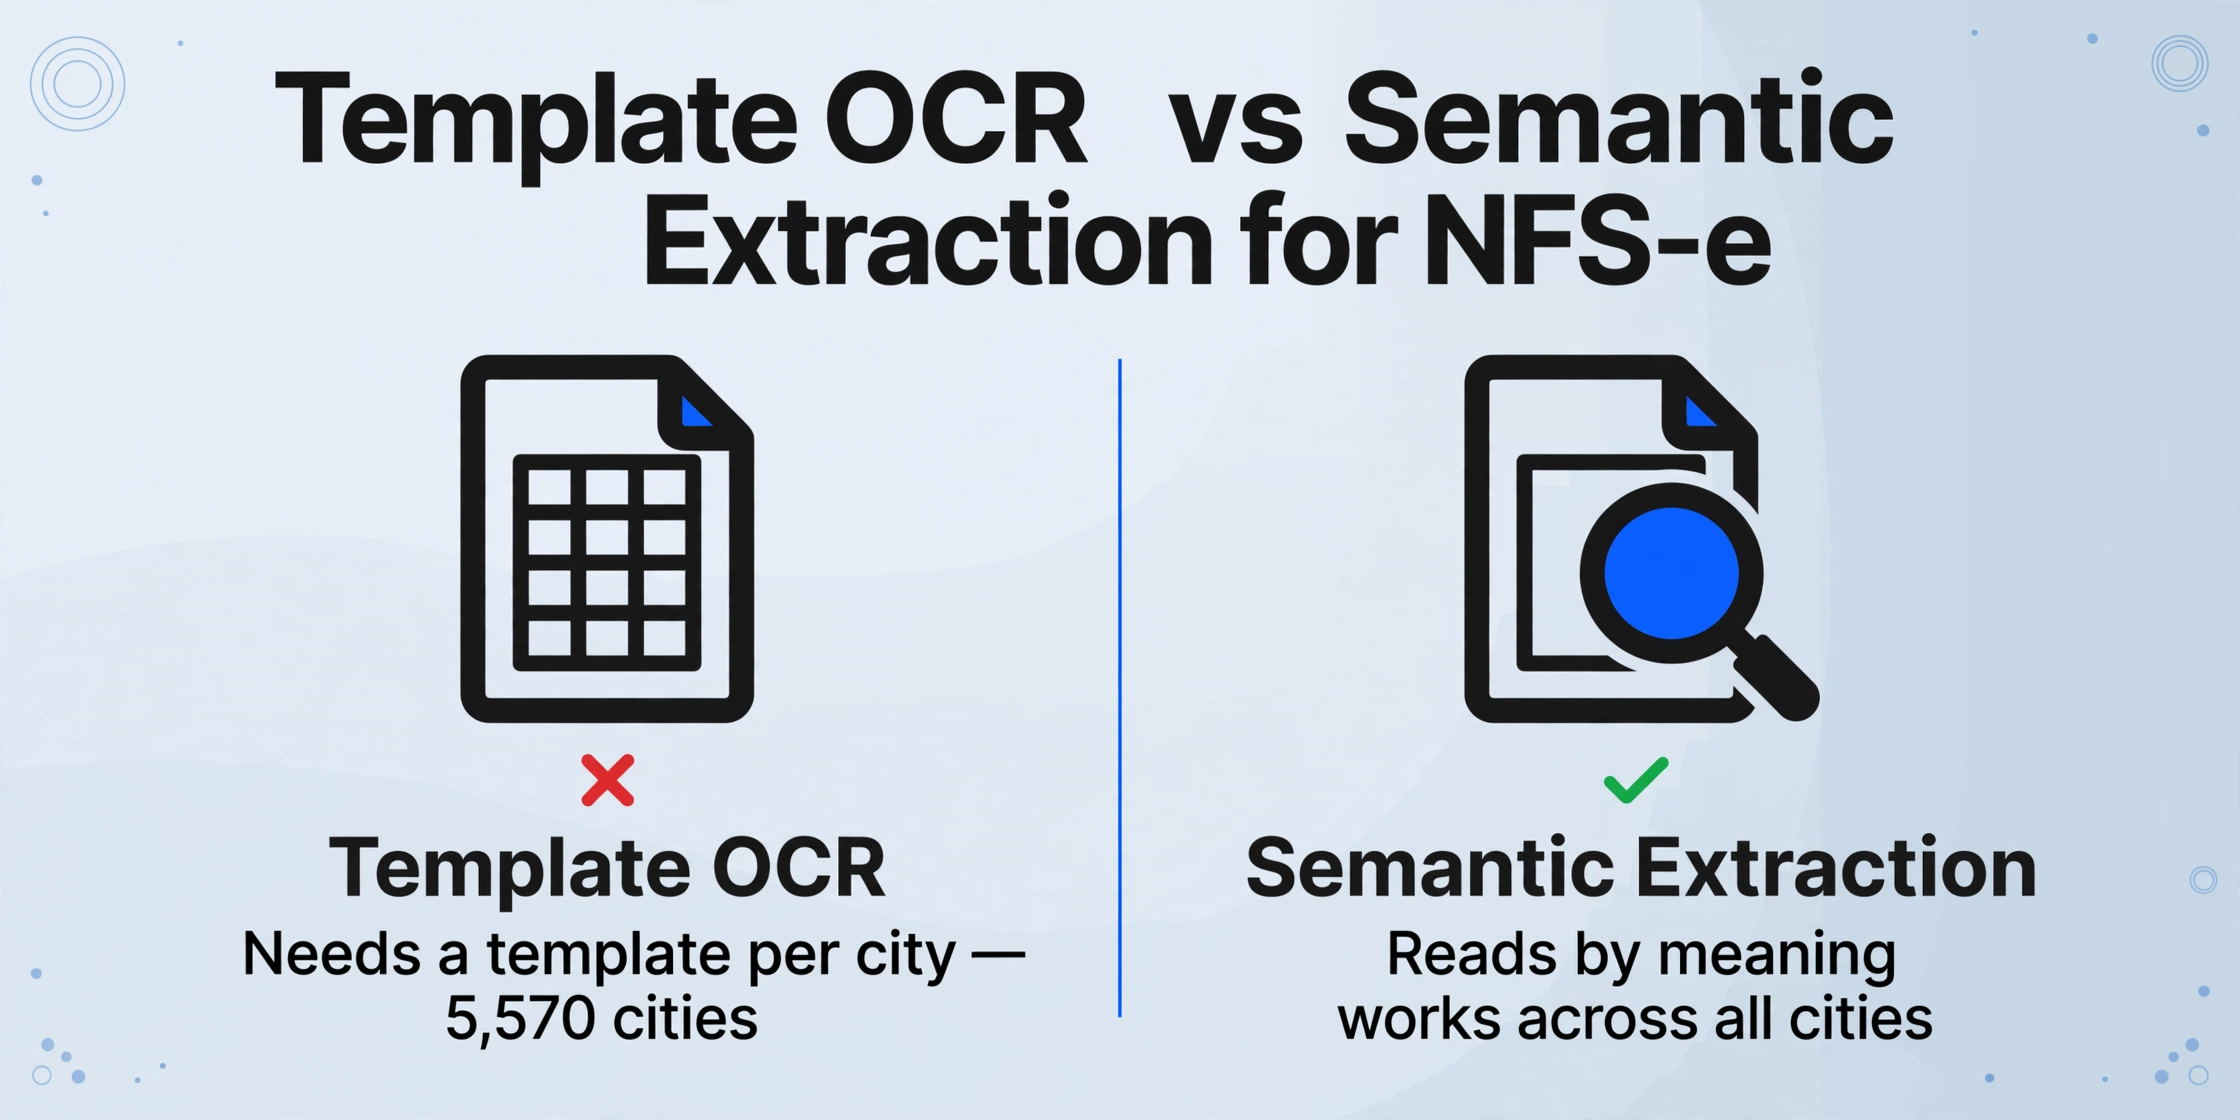
Hier wird die vorlagenbasierte Extraktion — der Ansatz, den die meisten Dokumentenextraktionstools verwenden — strukturell undurchführbar. Eine Vorlage definiert eine rechteckige Zone für jedes Feld: „CNPJ des Dienstleisters befindet sich an Pixelposition (x=150, y=320).“ Das funktioniert für eine Gemeinde. Für die nächste bricht es zusammen. Eine Vorlagenbibliothek für jede Stadt zu pflegen, in der Ihre Dienstleister tätig sind, ist nicht praktikabel, wenn die Zahl der möglichen Städte 5.570 beträgt und die Zahl der Städte, die ihre Layouts aktiv aktualisieren — São Paulo hat im August 2025 Version 3.2 seines NFS-e-Handbuchs veröffentlicht — ständig wächst.
Die Alternative ist die semantische Extraktion: Statt zu definieren, wo ein Feld auf der Seite liegt, teilen Sie der Extraktions-Engine mit, wonach Sie suchen — „die 14-stellige CNPJ mit der Bezeichnung Prestador“ — und sie liest das Dokument, um sie zu finden. Die Position spielt keine Rolle, weil die Engine den Inhalt des Dokuments versteht, nicht seine Koordinaten. Eine NFS-e aus São Paulo und eine NFS-e aus Porto Alegre im selben Batch werden mit denselben Spaltendefinitionen verarbeitet, weil die KI nach Bedeutung sucht und nicht eine Position abgleicht.
Das ist der architektonische Unterschied: Vorlagenbasierte Tools skalieren, indem sie mehr Vorlagen hinzufügen — eine pro Stadt, pro Layout-Revision. Semantische Extraktion skaliert, indem sie mehr Dokumentinhalt versteht. Wenn Sie die NFS-e einer 10. Stadt zum Batch hinzufügen, sind die Kosten praktisch null. Wenn Sie die Vorlage einer 10. Stadt hinzufügen, entstehen Kosten für Erstellung, Test und Pflege dieser Vorlage — und für ihre Aktualisierung bei jeder Layout-Änderung durch die Stadtverwaltung.
Eine vollständige Aufschlüsselung, wie die semantische Extraktion einzelne NFS-e-Felder behandelt — CNPJ-Abgleich, Klassifizierung des Leistungscodes nach LC 116, die ISS-Steueraufschlüsselung — finden Sie im Leitfaden zur Extraktion einzelner NFS-e. Der Batch-Workflow übernimmt all das und fügt die Ebene mehrerer Dokumente hinzu.
Wie die semantische Extraktion NFS-e aus 10 Städten in einem Batch verarbeitet
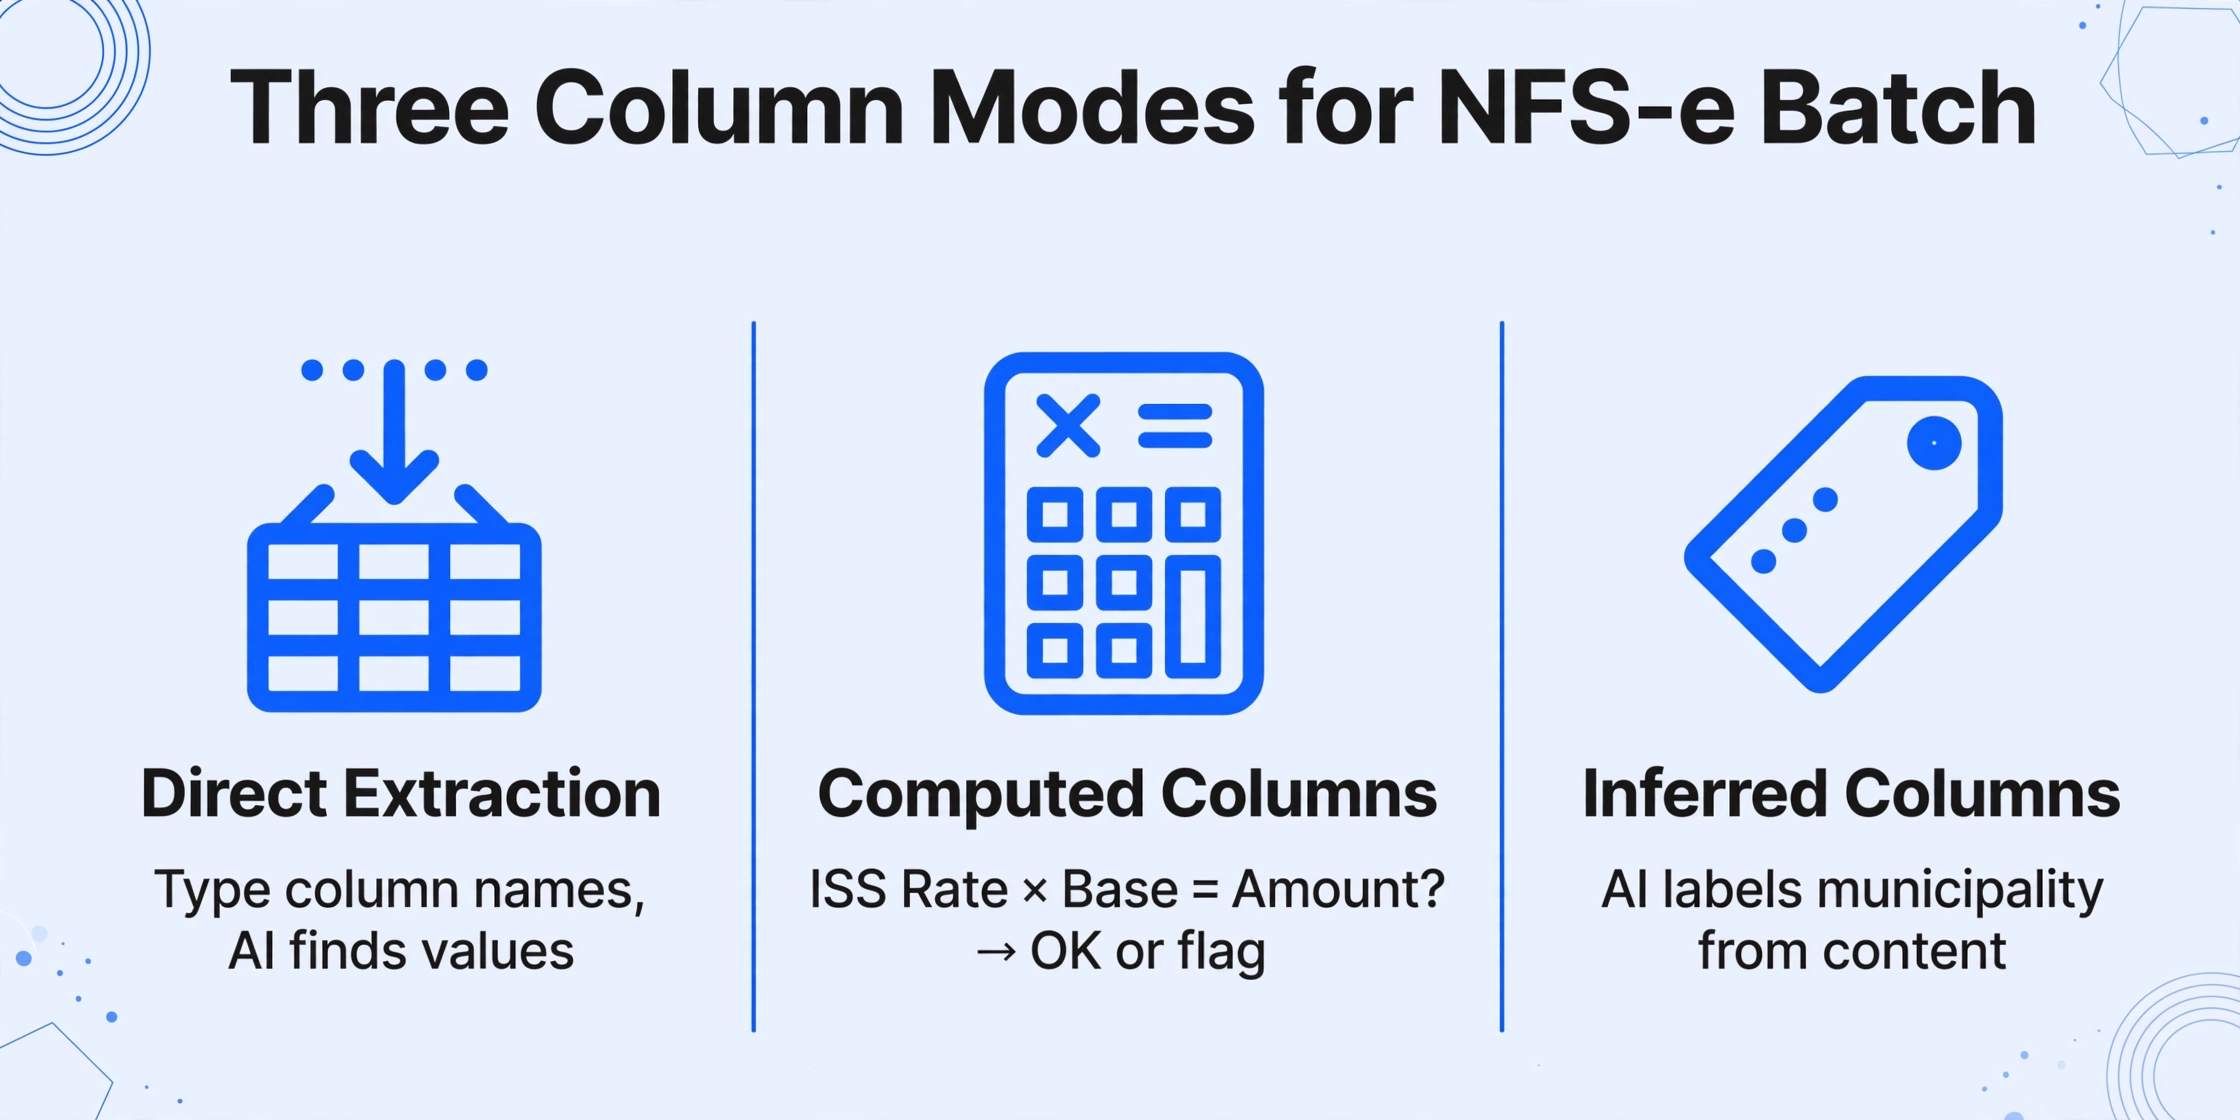
Der Extraktions-Workflow für die Batch-Verarbeitung von NFS-e dreht sich um die Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Feldnamen für Ihre Ausgabe ein — „CNPJ des Dienstleisters“, „Leistungscode (LC 116)“, „ISS-Steuersatz“, „ISS-Betrag“, „Einbehaltene ISS (Retido na Fonte)“, „NFS-e-Nummer“ — und die KI findet jeden Wert in jedem Dokument, indem sie versteht, was die Bezeichnung bedeutet. Diese Spaltennamen werden zu Ihren Tabellenkopfzeilen. Sie definieren sie einmal. Sie funktionieren in jeder Gemeinde des Batches.
Die Batch-Verarbeitung von NFS-e profitiert jedoch davon, über die direkte Extraktion hinauszugehen. Zwei zusätzliche Spaltenmodi ermöglichen den städteübergreifenden Abgleich bereits bei der Extraktion statt in einer separaten Tabellenübung:
Berechnete Spalten lassen Sie Validierungslogik definieren, die während der Extraktion ausgeführt wird. Für die NFS-e-Batch-Verarbeitung ist die nützlichste berechnete Spalte eine ISS-Prüfung: „ISS-Steuersatz × ISS-Bemessungsgrundlage = ISS-Betrag?“ Wenn die berechnete Summe mit dem extrahierten ISS-Betrag übereinstimmt, gibt die Spalte „OK“ aus. Wenn nicht, gibt sie die Abweichung aus — und markiert auf Batch-Ebene, welche Dokumente vor dem Import in Ihr ERP einen zweiten Blick benötigen. Bei einem einzelnen Dokument dauert diese Prüfung 30 Sekunden. Bei 50 Dokumenten erledigt eine berechnete Spalte das automatisch — und Sie sehen das Ergebnis in derselben Tabelle wie die extrahierten Daten.
Abgeleitete Spalten lassen die KI Dokumente anhand ihres Inhalts klassifizieren oder kennzeichnen. Fügen Sie eine Spalte namens „Gemeinde (aus Dokument extrahiert)“ ohne konkreten Feldbezug hinzu, und die KI liest die Kennung der prefeitura (Stadtverwaltung) aus der NFS-e und trägt den Städtenamen ein. Damit enthält Ihre Batch-Ausgabe eine sortierbare Gemeindespalte — und ISS-Summen pro Stadt sowie Steuerberichte pro Stadt sind nur eine Pivot-Tabelle entfernt statt einer manuellen Querverweisübung.
Diese drei Spaltentypen — direkte Extraktion, berechnete und abgeleitete — arbeiten in einem einzigen Batch-Durchlauf zusammen. Sie extrahieren nicht zuerst und validieren später. Die Validierung erfolgt während der Extraktion, und die Ergebnisse landen in derselben Tabelle.
Schritt für Schritt: Vom NFS-e-Stapel aus mehreren Städten zu einer Tabelle
Hier ist der praktische Workflow zur Batch-Verarbeitung von NFS-e-Dokumenten aus mehreren brasilianischen Gemeinden in eine einzige Excel-Datei. Sie richten dies einmal pro Batch ein — dieselben Spaltendefinitionen verarbeiten jedes Dokument, unabhängig davon, aus welcher Stadt es stammt.
Dateien werden sicher verarbeitet und nicht gespeichert.
Kommunenübergreifender ISS-Abgleich: die Batch-Only-Ansicht
Das wertvollste Ergebnis der Batch-Verarbeitung von NFS-e ist nicht die gesparte Zeit — obwohl der Sprung von 3 Minuten pro Dokument auf 5-10 Sekunden pro Seite eine 18-fache Verbesserung ist. Das wertvollste Ergebnis ist die Abgleichsansicht, die es nur gibt, wenn alle Dokumente in einer Tabelle stehen.
Diese Ansicht ermöglicht Ihnen Folgendes, was die Einzeldokumentverarbeitung nicht kann:
ISS-Summen pro Stadt
Gruppieren Sie die Ausgabe nach Gemeinde und summieren Sie den ISS-Betrag. Das Ergebnis ist der gesamte ISS, der auf Ihre Dienstleistungskäufe in jeder Stadt erhoben wurde – Daten, die aus zwei Gründen wichtig sind. Erstens zeigen sie Ihnen, ob der gesamte ISS über alle Dienstleister in einer bestimmten Stadt mit Ihrer internen Kostenverteilung für diese Gebietskörperschaft übereinstimmt. Zweitens: Wenn Sie bei einer dieser Rechnungen der ISS-Einbehaltsverpflichtete sind, ist die Summe pro Stadt die Zahl, die Sie mit Ihren kommunalen Steuerabführungsunterlagen abgleichen müssen. Der globale Steuerleitfaden von Dentons weist darauf hin, dass „Konflikte zwischen verschiedenen Gemeinden, in denen beide den ISS beanspruchen, recht häufig vorkommen“ – eine Ansicht auf Batch-Ebene ist Ihr Prüfpfad, falls eine zweite Gemeinde nachfragt.
Verfolgung von ISS Retido na Fonte
Wenn eine NFS-e das Kennzeichen „ISS Retido na Fonte = Sim“ (Einbehaltene ISS) trägt, ist Ihr Unternehmen – nicht der Dienstleister – dafür verantwortlich, den ISS an die Stadtverwaltung des Dienstleisters abzuführen. Dies ist keine Dateneingabenotiz, sondern eine steuerliche Compliance-Aufgabe mit Frist und einem Zahlungssystem, das sich von Stadt zu Stadt unterscheidet. In einer Batch-Ausgabe erhalten Sie durch Sortieren nach der Spalte „Einbehaltene ISS“ eine vollständige Liste aller Rechnungen, die Ihr Handeln erfordern – in einer einzigen Ansicht. Kein Durchsuchen von 30 einzelnen PDFs, um die drei mit dem Kennzeichen zu finden.
Der rechtliche Rahmen für den ISS-Einbehalt wurde vor Brasiliens höchstem Gericht geprüft. Im Jahr 2020 entschied der STF (Oberstes Bundesgericht) in RE 1167509, dass Gemeinden keine ISS-Einbehaltspflichten auf Dienstleistungsempfänger auferlegen können, wenn der Dienstleister nicht in dieser Gemeinde registriert ist – und hob damit die Registrierungspflicht von São Paulos CPOM (Register für Dienstleister aus anderen Gemeinden) auf. Einbehaltspflichten, die durch Bundesgesetz festgelegt sind und bei denen die Kombination aus Dienstleistungsart und Gemeinde eine rechtmäßige Einbehaltung auslöst, bleiben jedoch in Kraft. Um zu wissen, welche Rechnungen eine gültige Einbehaltspflicht tragen, müssen Sie den Batch sehen.
Erkennung von ISS-Steuersatzabweichungen
Das Ergänzungsgesetz 116/2003 legt ISS-Steuersätze zwischen 2 % und 5 % je Stadtverwaltung und Leistungsart fest. Doch Gemeinden konkurrieren über die Sätze, um Unternehmen anzuziehen — die diagnostische Prüfung des UNDP zum brasilianischen Steuersystem stellt fest: „ein räuberischer Krieg um ICMS- und ISS-Steueranreize“. Ein Dienstleister könnte einen Satz von 2 % für einen Leistungscode anwenden, den São Paulo mit 5 % besteuert, weil der Dienstleister in einer Gemeinde registriert ist, die ihren Satz gesenkt hat, um Unternehmen anzuziehen. Ob dieser Satz gültig ist, ist eine steuerliche Beurteilung, die Ihr Buchhaltungsteam vornimmt. Doch um ihn zu erkennen, muss man den Batch sehen. Ein einzelnes Dokument mit 2 % sieht normal aus. Zehn Dokumente mit 5 % und eines mit 2 %, alle für denselben Leistungscode — das ist eine Abweichung, die eine Untersuchung wert ist.
Was der nationale NFS-e-Standard für die Batch-First-Verarbeitung bedeutet
Das SNNFS-e (Nationales NFS-e-System) ist Brasiliens Bestreben, die Formate der Dienstleistungsrechnungen über alle Gemeinden hinweg zu vereinheitlichen. Stand August 2025 hatten sich 1.463 Gemeinden angeschlossen — doch die Teilnahme ist freiwillig, und große Städte wie São Paulo haben öffentlich bestätigt, dass sie ihre eigenen Systeme beibehalten werden. Das Ergebnis ist eine hybride Landschaft: Einige Ihrer Dienstleister stellen NFS-e nach dem nationalen XML-Standard aus, andere über das System ihrer Stadt, und Sie kontrollieren nicht, welches verwendet wird.
Aus Sicht der Batch-First-Verarbeitung unterstreicht diese hybride Landschaft den Wert layoutunabhängiger Extraktion. Vorlagenbasierte Tools benötigen jetzt Vorlagen sowohl für die städtischen Layouts vor dem Standard als auch für den SNNFS-e-Standard — plus Aktualisierungspfade, wenn Städte von einem zum anderen migrieren. Semantische Extraktion liest, was auch immer auf dem Dokument steht, unabhängig davon, welcher Standard es erzeugt hat. Eine NFS-e nach nationalem Standard und eine NFS-e im benutzerdefinierten São-Paulo-Format landen im selben Batch, definieren dieselben Spalten und erzeugen dieselbe Ausgabe. Der Standardisierungsprozess ändert den Inhalt der Dokumente, nicht den Extraktionsansatz.
Die Steuerreform 2026 — die ISS bis 2033 schrittweise durch IBS (Steuer auf Waren und Dienstleistungen) ersetzen wird — fügt eine weitere Ebene hinzu. Während der Übergangszeit können NFS-e-Dokumente sowohl alte ISS-Felder als auch neue IBS/CBS-Felder enthalten. Der Extraktionsansatz passt sich an, indem neue Spaltennamen — „ISS-Betrag“, „CBS-Betrag“ — neben den bestehenden ISS-Spalten hinzugefügt werden. Keine Neugestaltung der Vorlage erforderlich.
Wenn Ihre Organisation auch brasilianische Warenrechnungen verarbeitet, ist der NF-e-XML-Extraktionsworkflow im NF-e-Extraktionsleitfaden beschrieben. Die beiden Dokumenttypen können im selben Batch koexistieren, wenn Ihre Spaltendefinitionen breit genug sind, wobei NFS-e-spezifische Felder wie der LC-116-Code bei NF-e-Dokumenten leer bleiben — was zu erwarten ist und keine Fehler verursacht.
FAQ: Batch-Verarbeitung von NFS-e
Kann ich NFS-e-Dokumente von Dienstleistern aus verschiedenen Städten gemeinsam im Batch verarbeiten?
Ja — und das ist der primäre Anwendungsfall. Die semantische Extraktion liest jedes Dokument unabhängig, indem sie den Inhalt versteht, statt das Layout einer bestimmten Stadt abzugleichen. Eine NFS-e aus São Paulo (ISS 5 %), eine aus Belo Horizonte (ISS 3 %) und eine aus Curitiba (ISS 4 %) im selben Batch werden alle mit denselben Spaltendefinitionen verarbeitet. Die KI findet das CNPJ des Dienstleisters, die ISS-Bemessungsgrundlage und weitere Felder in jedem Dokument, unabhängig davon, wo sie auf der Seite stehen.
Wie wird die einbehaltene ISS in der Batch-Ausgabe behandelt?
Das Feld „ISS einbehalten“ wird als eigene Spalte extrahiert — typischerweise mit „Sim“ (ja) oder „Não“ (nein). In der Tabellenkalkulation der Batch-Ausgabe erhalten Sie durch Sortieren nach dieser Spalte eine vollständige Liste aller Rechnungen, bei denen Ihr Unternehmen der Steuerabzugsverpflichtete ist. Daraus berechnen Sie den abzuführenden Betrag (ISS-Steuersatz × Bemessungsgrundlage je markierter Rechnung) und leiten jede an das Zahlungssystem der zuständigen Stadtverwaltung weiter. Das Extraktionstool liefert die Daten. Die eigentliche Steuerabführung bleibt ein separater Compliance-Schritt, den Ihr Buchhaltungsteam über das Zahlungsportal jeder Gemeinde durchführt.
Was, wenn ein Dienstleister eine NFS-e mit Layoutfehlern oder fehlenden Feldern ausstellt?
Die Extraktions-Engine liest, was auf dem Dokument steht. Wenn ein Pflichtfeld — beispielsweise das CNPJ — fehlt oder unleserlich ist, bleibt diese Zelle in der Ausgabe leer. Das ist tatsächlich nützlich: Eine leere Zelle in der Batch-Ausgabe zeigt sofort, welches Dokument beim Dienstleister nachverfolgt werden muss, während bei der manuellen Eingabe von 30 Dokumenten leicht ein leeres Feld übersehen wird. Die Batch-Ansicht macht Auslassungen sichtbar.
Kann ich NFS-e-Dokumente mit internationalen Dienstleistungsrechnungen im selben Batch mischen?
Ja. Wenn Ihre Spaltendefinitionen beide Dokumenttypen abdecken — etwa „Rechnungsnummer“, „Lieferantenname“, „Gesamtbetrag“, „Steuerbetrag“ —, können internationale Rechnungen und NFS-e-Dokumente im selben Batch koexistieren. NFS-e-spezifische Spalten wie „LC 116 Leistungscode“ oder „ISS-Steuersatz“ bleiben bei nicht-brasilianischen Dokumenten leer, und internationale Spalten wie „MwSt.-Nummer“ bleiben bei NFS-e-Dokumenten leer. Beides ist zu erwarten und verursacht keine Fehler.
Verarbeitet die Extraktions-Engine die Felder der Steuerreform 2026 (IBS/CBS) auf NFS-e-Dokumenten?
Ja — wenn eine Stadtverwaltung ihr NFS-e-Layout aktualisiert, um IBS- oder CBS-Felder aufzunehmen, fügen Sie die entsprechenden Spaltennamen (z. B. „IBS-Betrag“, „CBS-Betrag“) zu Ihrer Batch-Definition hinzu. Die Extraktions-Engine findet diese neuen Felder, indem sie den Dokumentinhalt versteht — genauso wie sie bestehende ISS- und CNPJ-Felder findet. Eine Neukonfiguration der Vorlage ist nicht erforderlich. Während der Übergangsphase bis 2033 können Sie Batches mit NFS-e-Dokumenten ausführen, die sowohl ISS- als auch IBS-Felder enthalten — definieren Sie Spalten für beide, und die Ausgabe füllt die Felder, die auf jedem Dokument vorhanden sind.
Wie schlägt sich die Batch-Verarbeitung im Vergleich zur direkten Integration der API jeder Stadtverwaltung?
Die Integration städtischer APIs erfordert den Aufbau und die Pflege einer separaten Verbindung für jede Stadt, in der Ihre Dienstleister tätig sind — jede mit eigener Authentifizierungsmethode, eigenem Schema und eigenem Aktualisierungszyklus. Der nationale SNNFS-e-Standard vereinfacht dies für teilnehmende Stadtverwaltungen, aber große Städte wie São Paulo haben sich geweigert, beizutreten. Die semantische Batch-Extraktion verarbeitet die Dokumente, die Sie bereits erhalten — PDFs, XMLs, DANFSE-Ausdrucke —, ohne API-Zugriff auf ein kommunales System zu benötigen. Sie ist keine Alternative zur API-Integration für die Ausstellung ausgehender NFS-e. Sie ist die empfangsseitige Lösung für den Fall, dass Sie der Dienstleistungsempfänger (tomador) sind, nicht der Aussteller.
Für einen breiteren Blick auf die Batch-Dokumentenextraktion über NFS-e hinaus sehen Sie, wie die Batch-Rechnungsextraktion nach Excel über Dokumenttypen und Währungen hinweg funktioniert.
Vom Tippen pro Stadtverwaltung zum Abgleich pro Batch
Die NFS-e wurde entwickelt, um die Steuererhebung für den Staat effizient zu machen — und das tut sie. Jede Dienstleistungsrechnung, die Sie erhalten, wurde von einer kommunalen Steuerbehörde validiert, bevor sie Ihren Posteingang erreichte. Die CNPJ wurde geprüft. Der ISS-Steuersatz wurde gegen den Leistungscode verifiziert. Die Rechnungsnummer wurde vergeben. Diese Daten existieren. Sie sind korrekt. Sie haben einen staatlichen Validierungsschritt durchlaufen, den die meisten internationalen Rechnungen nie sehen.
Die Ineffizienz liegt vollständig auf der Empfangsseite: das erneute Eintippen validierter Felder aus Dokumenten, die je nach Stadt variieren, in eine Tabelle, die für den SPED-Abgleich korrekt sein muss. Die semantische Batch-Extraktion schließt diese Lücke nicht dadurch, dass sie das Tippen beschleunigt, sondern dadurch, dass sie es überflüssig macht — und verschafft Ihnen so die stadtübergreifende Sicht, die manuelle Eingabe niemals liefern könnte.
Wenn Sie das nächste Mal einen Stapel NFS-e von Dienstleistern aus São Paulo, Rio, Belo Horizonte und darüber hinaus erhalten, versuchen Sie, sie als einen Batch zu verarbeiten. Definieren Sie Ihre Spalten einmal. Lassen Sie die Extraktion laufen. Sortieren Sie dann nach Stadtverwaltung und prüfen Sie die ISS-Summen. Sehen Sie, ob die Batch-Ansicht etwas offenbart, was die einzelnen Dokumente nicht zeigten.
Keine Anmeldung erforderlich für Ihre ersten 50 Seiten.