50 brasilianische NF-e-XMLs, eine Tabelle
Wie die Batch-Verarbeitung mehrerer Lieferanten die manuelle Steuerabstimmung überflüssig macht
Die Verarbeitung einer NF-e eines Lieferanten aus São Paulo dauert 3 Minuten. Das XML ist sauber, die Felder sind eindeutig und der ICMS-Satz — 18 % intern — entspricht den Erwartungen. Das Problem beginnt, wenn Sie 50 NF-e-XMLs von 14 Lieferanten aus 7 brasilianischen Bundesstaaten haben. Lieferant Nr. 3 in Paraná wendet 19,5 % ICMS auf innerstaatliche Lieferungen an, aber 12 %, wenn er an Sie nach São Paulo liefert. Lieferant Nr. 8 in Pernambuco berechnet 20,5 % — außer bei Artikeln, die unter NCM 8471.30 klassifiziert sind und einen ermäßigten Satz erhalten. Lieferant Nr. 11 hat das DANFE-PDF, aber nicht das XML gesendet. Und irgendwo im Batch teilen sich zwei verschiedene NF-e-Dokumente dieselbe Rechnungsnummer, weil Lieferant Nr. 2 seine Nummerierungssequenz zu Beginn des Geschäftsjahres neu gestartet hat. Eine NF-e zu extrahieren ist unkompliziert. 50 zu extrahieren und eine saubere, prüffähige AP-Tabelle zu erstellen, in der die steuerliche Behandlung jeder Zeile überprüfbar ist — das ist ein völlig anderes Problem.
Wenn 50 NF-e-XMLs eintreffen — warum Batch nicht „einzeln, 50-mal wiederholt" ist
Die brasilianische NF-e-Verarbeitung ist in einer Hinsicht ungewöhnlich: Die Quelldaten sind bereits strukturiert. Anders als bei Papierrechnungen von US-amerikanischen oder europäischen Lieferanten, die eine OCR-Digitalisierung erfordern, kommt jede NF-e als XML-Datei an, die bereits gegen über 400 SEFAZ-Regeln validiert und mit einem ICP-Brasil-Zertifikat digital signiert wurde. Die Datenqualität einer einzelnen NF-e-XML ist nahezu perfekt. Das Batch-Problem in der brasilianischen Kreditorenbuchhaltung ist nicht die Genauigkeit der Datenerfassung — sondern die Datenkonsistenz über alle Lieferanten hinweg.
Wenn Sie 50 NF-e-XMLs von 14 Lieferanten in einem einzigen Batch verarbeiten, treten vier strukturelle Probleme auf, die die Einzelrechnungsverarbeitung nie offenlegt:
Fragmentierung der ICMS-Sätze. Brasiliens ICMS ist eine Mehrwertsteuer auf Bundesstaatsebene mit Sätzen, die sich nach dem Bundesstaat des Lieferanten, Ihrem Bundesstaat, der Transaktionsrichtung (innerstaatlich vs. zwischenstaatlich) und — in einigen Fällen — der NCM-Produktklassifizierung richten. Ein Batch von 50 NF-e-XMLs von Lieferanten aus 7 Bundesstaaten kann innerstaatliche Sätze von 17 %, 18 %, 19 %, 19,5 %, 20 % und 20,5 % sowie zwischenstaatliche Sätze von 4 %, 7 % oder 12 % enthalten, abhängig von den Ursprungs- und Zielkombinationen. Eine Spalte „ICMS-Betrag" in Ihrer Tabellenkalkulation ist bedeutungslos, es sei denn, Sie kennen auch den Satz, den anwendbaren Bundesstaat und ob die Transaktion innerstaatlich oder zwischenstaatlich ist — denn derselbe ICMS-Betrag von R$1.000 kann einen Satz von 17 % auf einer Basis von R$5.882 oder einen Satz von 12 % auf einer Basis von R$8.333 bedeuten. Das Steuermodul Ihres ERP-Systems benötigt die Unterscheidung.
Lücken in der CFOP-Konsistenz. Jede NF-e-Position trägt einen 4-stelligen CFOP-Code (Código Fiscal de Operações e Prestações), der die steuerliche Natur der Transaktion klassifiziert — 1.101 für Einkauf zur Weiterverarbeitung innerhalb desselben Bundesstaates, 2.102 für zwischenstaatlichen Einkauf zum Weiterverkauf, 3.101 für Import. Die erste Ziffer kodiert, ob die Transaktion innerstaatlich (1), zwischenstaatlich (2) oder internationaler Import (3) ist. Wenn Lieferant A CFOP 1.101 für eine Lieferung von São Paulo an Ihr Lager in São Paulo verwendet und Lieferant B CFOP 2.102 für eine zwischenstaatliche Lieferung aus Minas Gerais, ist das korrekt und beabsichtigt. Aber wenn Lieferant C CFOP 1.101 für eine Lieferung verwendet, die in Rio de Janeiro ihren Ursprung hat — eine zwischenstaatliche Transaktion —, stimmt der CFOP nicht mit den Bundesstaatdaten in den <ide>- und <emit>-Blöcken der XML überein. Diese Diskrepanz erzeugt ein Prüfungsflag in SPED EFD (Escrituração Fiscal Digital), dem bundesweiten digitalen Buchhaltungssystem, das CFOP-Codes über die gesamte Lieferkette hinweg abgleicht. In einem Batch von 50 Rechnungen sind 3–5 Diskrepanzen üblich — und sie manuell zu finden bedeutet, den CFOP jeder XML gegen ihr Ursprungs-Ziel-Bundesstaatspaar zu prüfen.
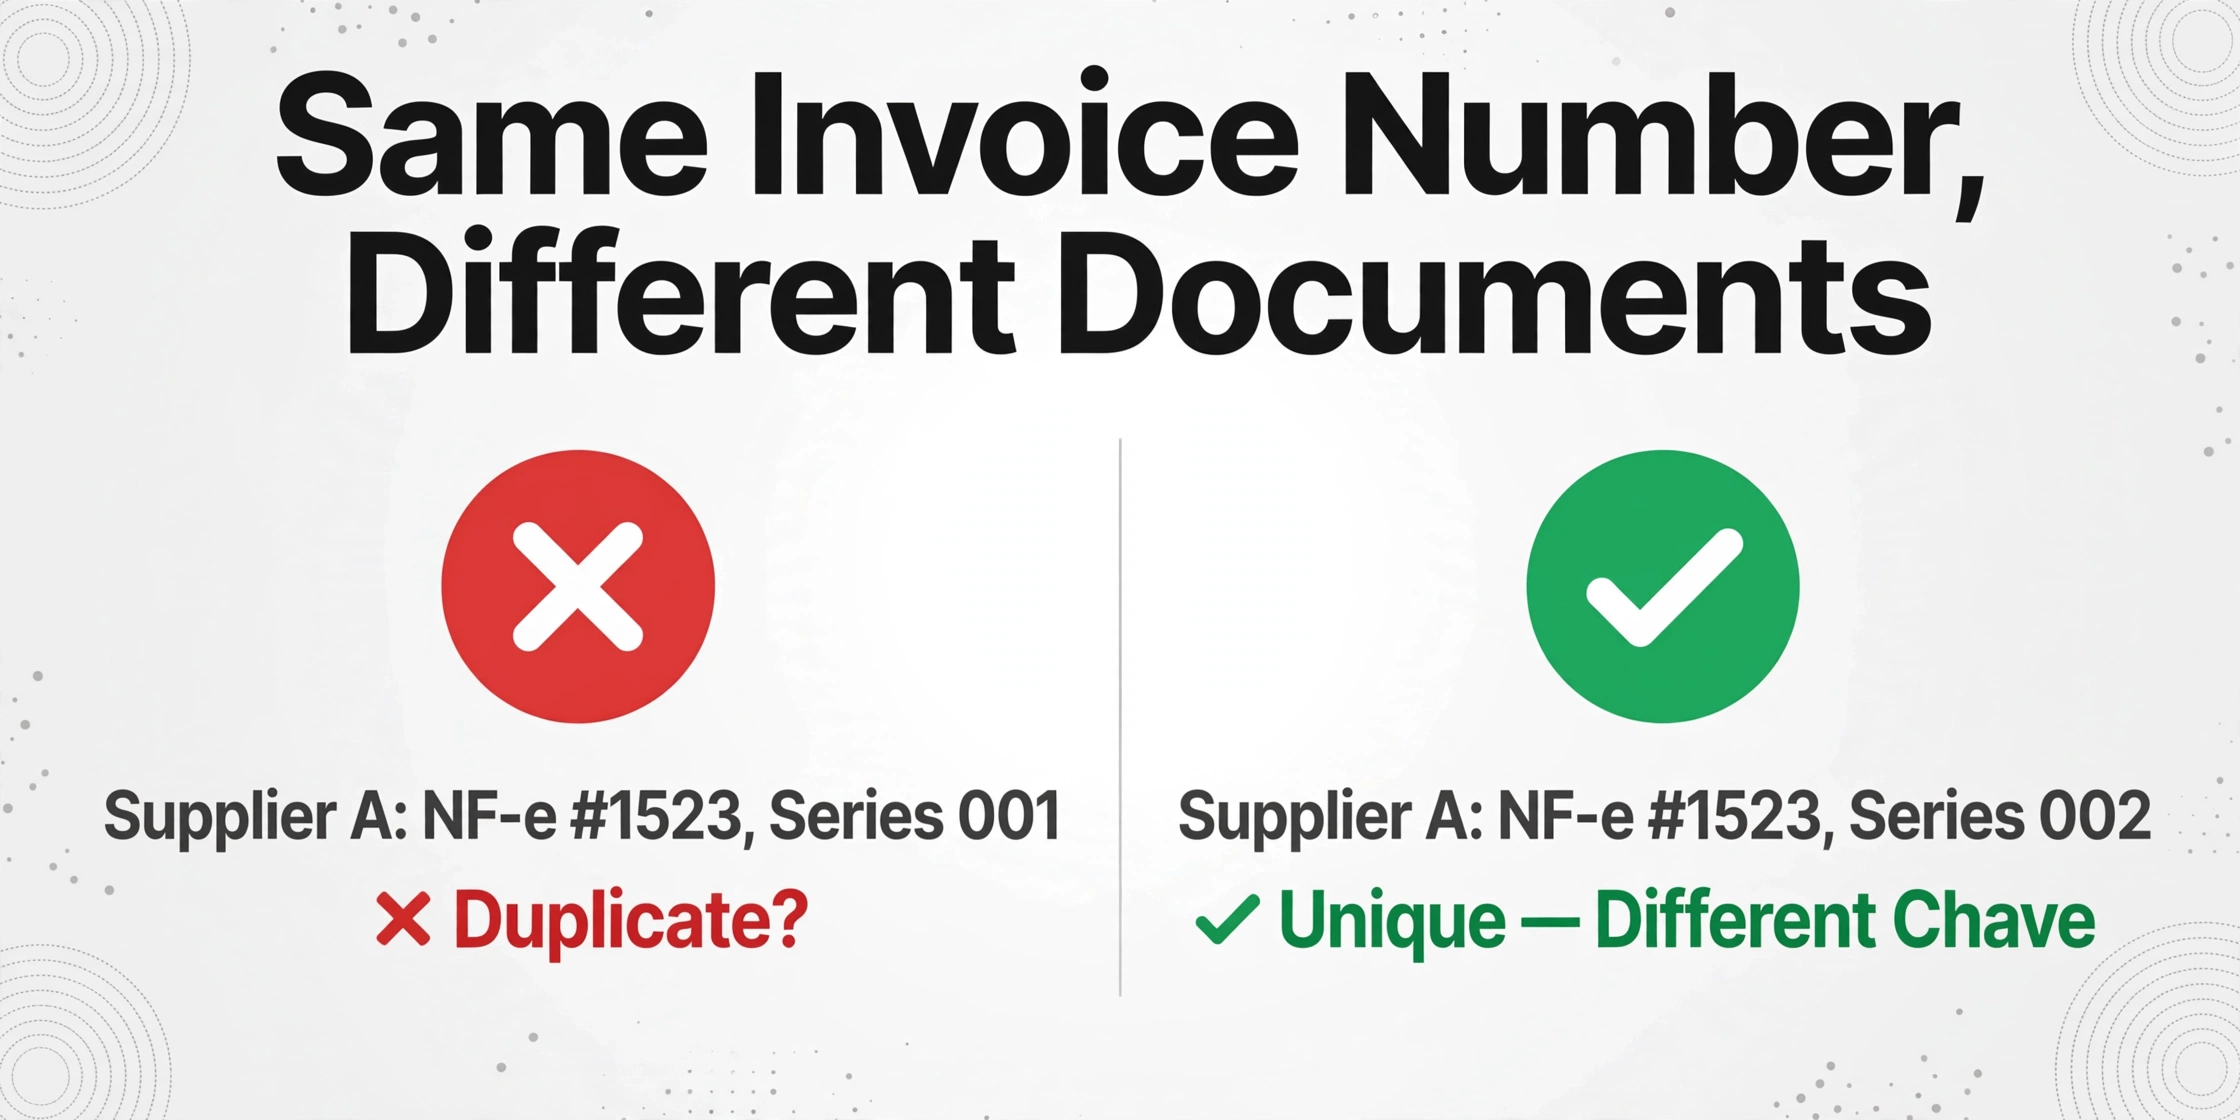
Fehlgeschlagene Duplikaterkennung anhand der Rechnungsnummer allein. In den meisten Kreditorenbuchhaltungssystemen basiert die Duplikaterkennung auf Lieferant + Rechnungsnummer. Diese Logik versagt bei brasilianischen NF-e, da die Rechnungsnummer (número da nota) nur innerhalb einer einzelnen Serie eines Lieferanten eindeutig ist. Lieferant A kann NF-e #1523 in Serie 001 ausstellen, während Lieferant B ebenfalls NF-e #1523 in ihrer Serie 001 ausstellt. Sogar derselbe Lieferant kann identische Rechnungsnummern in verschiedenen Serien ausstellen. Der global eindeutige Identifikator ist die 44-stellige Chave de Acesso — aber die meisten Batch-Extraktionstools extrahieren sie nicht oder extrahieren sie, ohne ihre Rolle als Deduplizierungsschlüssel zu verstehen. Ohne die Chave de Acesso werden zwei verschiedene Rechnungen von zwei verschiedenen Lieferanten mit derselben Rechnungsnummer als Duplikate markiert und eine wird unterdrückt — oder schlimmer, eine erneut eingereichte Rechnung mit einer korrigierten Chave de Acesso (die ein CCe-Korrekturereignis anzeigt) wird nicht als Ersatz erkannt.
Gemischte Formatquellen. In einem Batch von 50 brasilianischen Lieferantenrechnungen erhalten Sie selten 50 saubere XMLs. Einige Lieferanten – typischerweise kleinere Hersteller oder landwirtschaftliche Erzeuger – senden nur den gedruckten DANFE als PDF oder Scan. Einige senden das XML, fügen aber einen gescannten DANFE mit handschriftlichen Anmerkungen bei. Ein mittelgroßer Industrielieferant sendet möglicherweise das XML für die Haupt-NF-e, aber den Fracht-CT-e (Conhecimento de Transporte Eletrônico) als PDF. Der Batch-Verarbeitungsworkflow muss all dies in einem Durchgang verarbeiten – strukturierte Daten aus XML extrahieren, wo verfügbar, und das visuelle Dokument lesen, wo das XML fehlt – und alles in konsistente Spalten zusammenführen.
Diese vier Probleme existieren nicht bei einer einzelnen Rechnung. Bei 50 feuern alle vier gleichzeitig – und ihre Lösung ist das, was einen Batch-Verarbeitungsworkflow von „Einzelextraktion, 50-mal wiederholt" unterscheidet.
Die ICMS-Steuersatzmatrix über 7 Bundesstaaten – Warum eine einzige „Steuer"-Spalte scheitert
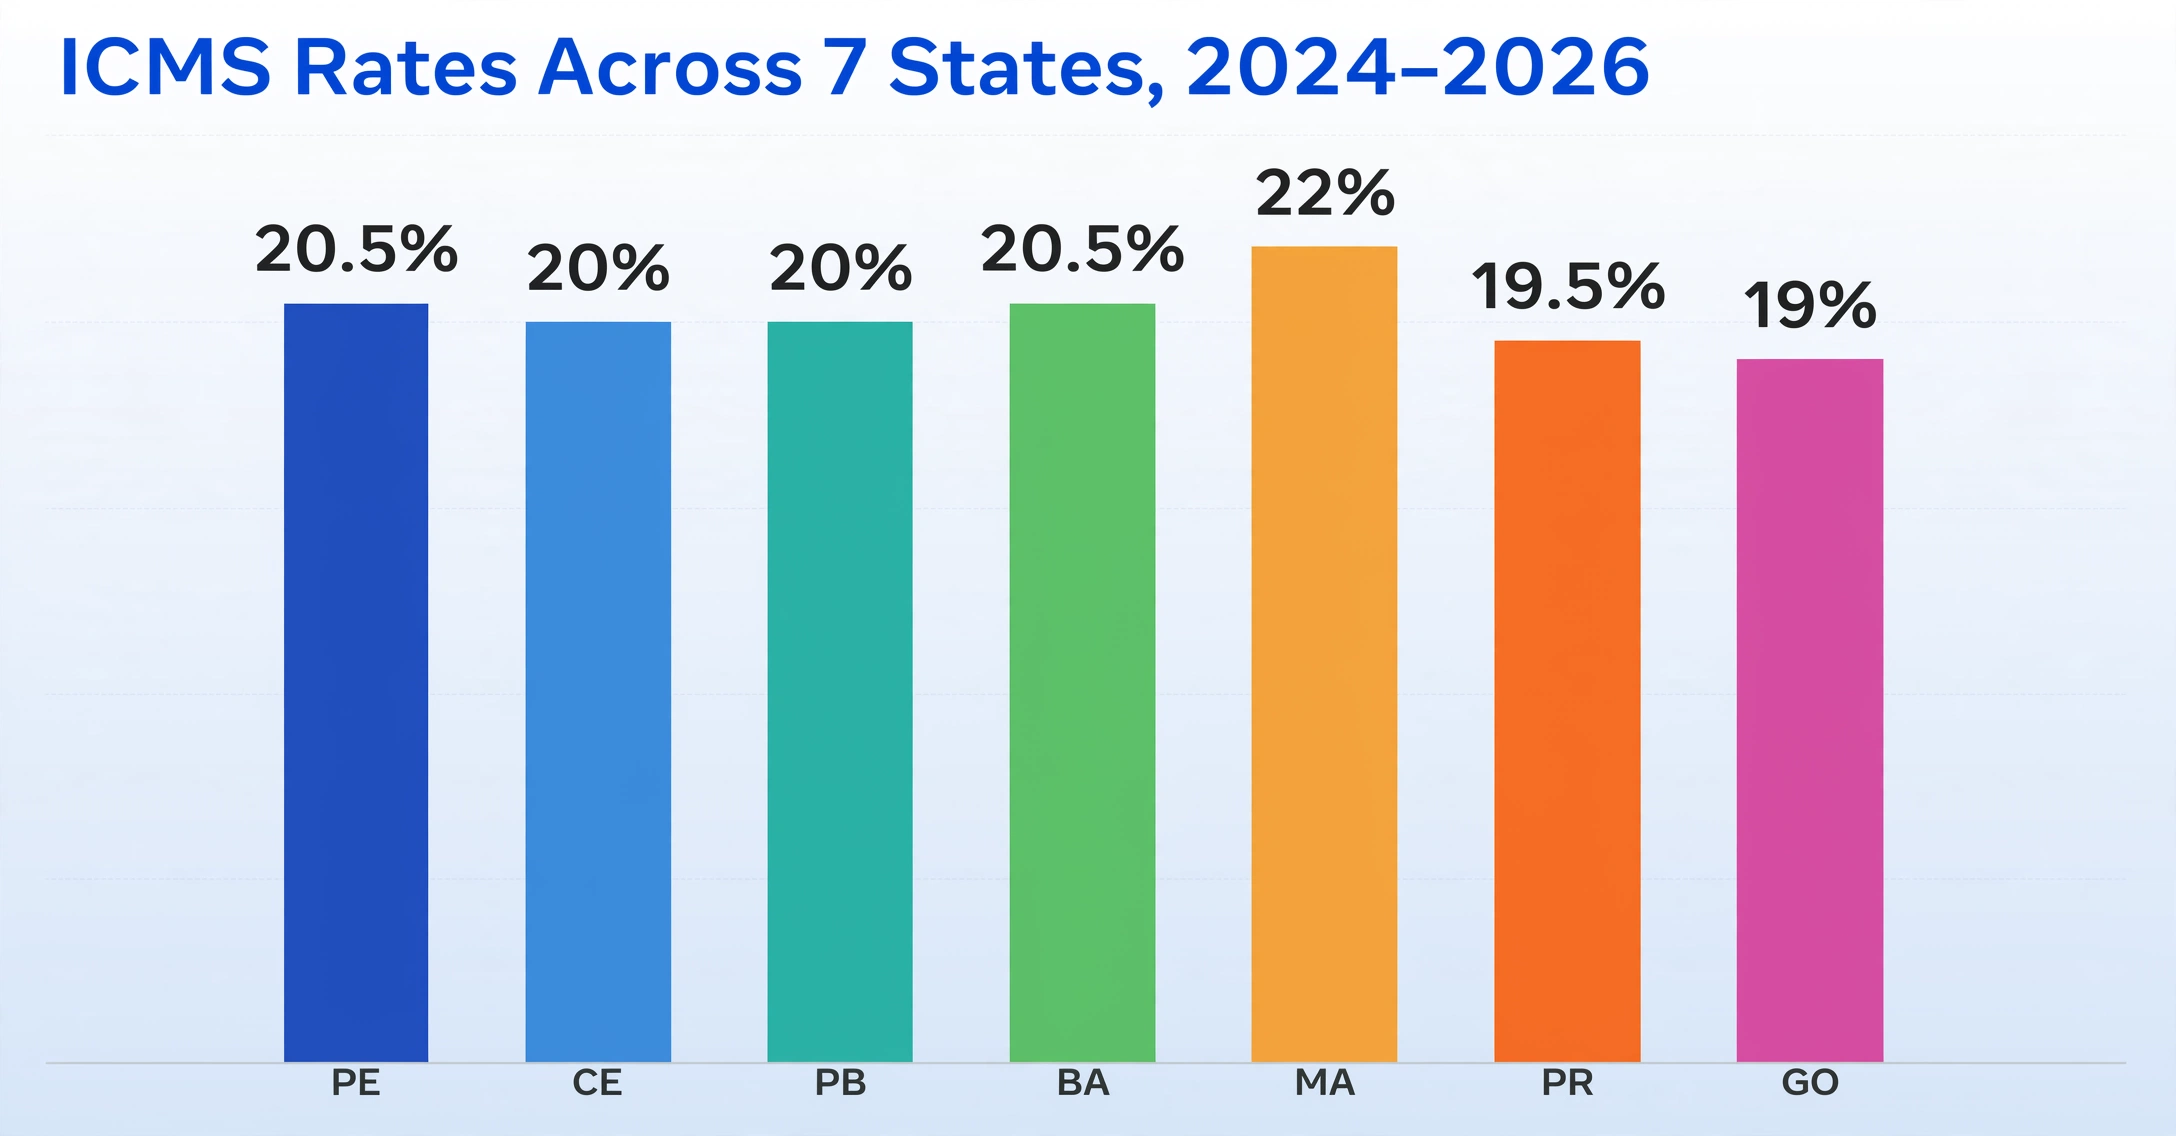
Die internen ICMS-Sätze in Brasilien haben sich 2024 erheblich verschoben, teilweise in Erwartung der Steuerreform, die ICMS zwischen 2029 und 2033 schließlich durch die neue IBS (Imposto sobre Bens e Serviços) ersetzen wird. Elf brasilianische Bundesstaaten haben ihre Standard-ICMS-Sätze im letzten Jahr geändert:
| Staat (UF) | Bisheriger Satz | Satz 2024–2026 | Gültig ab |
|---|---|---|---|
| Pernambuco | 18% | 20,5% | Jan. 2024 |
| Ceará | 18% | 20% | Jan. 2024 |
| Paraíba | 18% | 20% | Jan. 2024 |
| Bahia | 19% | 20,5% | Feb. 2024 |
| Maranhão | 20% | 22% | Feb. 2024 |
| Paraná | 19% | 19,5% | März 2024 |
| Goiás | 17% | 19% | Apr. 2024 |
| Rondônia | 17,5% | 19,5% | Jan. 2024 |
| Distrito Federal | 18% | 20% | Jan. 2024 |
| Espírito Santo | 17% | 19,5% | Apr. 2024 |
| Rio Grande do Norte | 20% | 18% | Jan. 2024 |
Quellen: Vertex Inc., Landesgesetze (Leis Estaduais). São Paulo blieb bei 18%, Minas Gerais bei 18%, Rio de Janeiro bei 20% (im gleichen Zeitraum, mit einem vorgeschlagenen Anstieg auf 22%, der noch in der parlamentarischen Debatte ist).
Die praktische Konsequenz für die Batch-Verarbeitung: Wenn Ihre Lieferantenbasis mehr als zwei brasilianische Bundesstaaten umfasst, muss Ihre Batch-Tabelle die ICMS auf der Ebene Satz × Staat × Transaktionsart erfassen – nicht in einer einzigen Spalte, die alle ICMS-Werte summiert. Eine NF-e von einem Lieferanten in Pernambuco (20,5 % innerhalb des Bundesstaates) und eine NF-e von einem Lieferanten in São Paulo (18 % innerhalb des Bundesstaates) werden in Ihrem ERP unterschiedlich behandelt, selbst wenn die ICMS-Betragsspalte denselben Wert zeigt.
Zwischenstaatliche Sätze fügen eine zweite Dimension hinzu, geregelt im brasilianischen Steuerrecht:
| Ursprungsregion | Zielregion | Zwischenstaatlicher Satz |
|---|---|---|
| Süden & Südosten (SP, RJ, MG, PR, SC, RS, ES) | Süden & Südosten | 12% |
| Norden, Nordosten & Mittelwesten | Jeder brasilianische Bundesstaat | 12% |
| Süden & Südosten | Norden, Nordosten & Mittelwesten (inkl. ES) | 7% |
| Jeder Bundesstaat — importierte Waren mit >40% ausländischem Anteil | Jeder Bundesstaat | 4% |
Kombinieren Sie diese zwischenstaatlichen Steuersatzstufen mit den 11 oben genannten Änderungen auf Landesebene, und ein Batch von NF-e-XMLs von Lieferanten aus 7 Bundesstaaten kann leicht 5 verschiedene ICMS-Sätze enthalten — jeder davon muss identifiziert, nach Typ getrennt und im richtigen Steuerkonto in Ihrem ERP verbucht werden. Tools, die ICMS als einzelne Zahl extrahieren, ohne den Satz, den Ursprungsstaat und die Transaktionsart aus dem XML zu erfassen, erzeugen eine Tabelle, die mehr Abstimmungsaufwand verursacht, als sie einspart.
Hier zahlt sich die direkte Extraktion aus der Struktur der NF-e-XML — nicht das OCR des DANFE — in großem Umfang aus. Der <imposto>-Block der XML enthält separate Elementgruppen für ICMS, IPI, PIS und COFINS, jeweils mit der Besteuerungsgrundlage (vBC), dem Satz (pICMS, pIPI usw.) und dem Betrag (vICMS, vIPI usw.) auf Positionsebene. Eine Extraktion auf Basis von Spaltennamen, die diese strukturierten Felder — „ICMS-Basis", „ICMS-Satz (%)", „ICMS-Betrag", „IPI-Betrag", „PIS-Betrag", „COFINS-Betrag" — in separate Tabellenspalten überführt, erzeugt eine Tabelle, in der jeder Steuerbetrag ohne manuelle Neuberechnung auf seinen Satz und seine Basis zurückgeführt werden kann. Eine detaillierte Aufschlüsselung der NF-e-XML-Struktur und Feldzuordnung finden Sie in der vollständigen Anleitung zur NF-e-XML-Extraktion.
CFOP-Code-Konsistenz über Lieferanten hinweg – das Audit-Flag, das im Batch niemand prüft
CFOP-Codes sind vierstellige Klassifikationen für steuerliche Vorgänge, die in jeder NF-e-Position enthalten sind. Es gibt über 500 CFOP-Codes, die von den brasilianischen Steuerbehörden definiert und nach der ersten Ziffer organisiert werden:
| Erste Ziffer | Bedeutung | Beispiel (Einkauf) |
|---|---|---|
| 1 | Innerstaatlicher Eingang (gleicher Bundesstaat) | 1.101 – Einkauf zur Industrialisierung |
| 2 | Zwischenstaatlicher Eingang (verschiedene Bundesstaaten) | 2.102 – Zwischenstaatlicher Einkauf zum Weiterverkauf |
| 3 | Internationaler Import | 3.101 – Import zur Industrialisierung |
| 5 | Innerstaatlicher Ausgang (Verkauf) | 5.101 – Verkauf eigener Produktion |
| 6 | Zwischenstaatlicher Ausgang | 6.102 – Zwischenstaatlicher Verkauf von Fremdwaren |
| 7 | Export | 7.101 – Export eigener Produktion |
Bei einer einzelnen NF-e ist eine CFOP-Diskrepanz leicht zu erkennen: Wenn der Lieferant in Minas Gerais sitzt und Ihr Unternehmen in São Paulo, sollte jeder CFOP-Code mit 2 beginnen (zwischenstaatlicher Eingang). Wenn eine Position CFOP 1.101 – innerstaatlich – aufweist, liegt ein Datenfehler vor. Im großen Maßstab, über 50 Rechnungen von mehreren Lieferanten hinweg, wird diese Art der Validierung unerlässlich und anspruchsvoll. Ein Lieferant mag CFOP 1.101 korrekt für seine lokalen Sendungen (an seine eigenen Kunden) verwenden, sollte aber 2.101 verwenden, wenn er über Staatsgrenzen hinweg an Sie liefert. Wenn sein ERP den falschen CFOP automatisch befüllt hat, erben Sie ein Audit-Risiko, das SPED EFD erkennen wird – denn das digitale Buchhaltungssystem gleicht Käufer- und Verkäufer-CFOP-Datensätze für jede Transaktion ab. Eine Abweichung zwischen Ihrem eingehenden CFOP-Datensatz und dem entsprechenden ausgehenden Datensatz des Lieferanten erzeugt automatisch ein Audit-Flag.
Batch-CFOP-Validierung bedeutet, für jede Position im Batch drei Beziehungen zu prüfen:
- Erste Ziffer vs. Bundesstaat-Paar. Die erste Ziffer des CFOP muss dazu passen, ob Lieferant und Käufer im selben Bundesstaat (1/5) oder in verschiedenen Bundesstaaten (2/6) ansässig sind. Extrahieren Sie den IBGE-Bundesstaatscode aus den Blöcken
<emit>und<dest>– Codes 35 (SP), 33 (RJ), 31 (MG), 41 (PR) usw. – und validieren Sie das CFOP-Präfix gegen die Bestimmung gleicher/verschiedener Bundesstaat. - CFOP-Suffix-Konsistenz über ähnliche Vorgänge hinweg. Wenn Lieferant A CFOP 2.102 (zwischenstaatlicher Einkauf zum Weiterverkauf) und Lieferant B CFOP 2.101 (zwischenstaatlicher Einkauf zur Industrialisierung) für denselben Produkttyp verwendet, liegt mindestens einer falsch – das CFOP-Suffix muss den tatsächlichen geschäftlichen Zweck der Transaktion widerspiegeln.
- Keine CFOP-NCM-Widersprüche. Der CFOP kodiert die Art des Vorgangs, der NCM die Produktklassifikation. Ein CFOP, der auf einen industriellen Einsatz hindeutet, gepaart mit einem NCM für ein fertiges Konsumprodukt, ist eine Warnung – das bedeutet, dass entweder der CFOP oder der NCM falsch ist, und beide beeinflussen die steuerliche Behandlung.
Die manuelle CFOP-Prüfung bei 50 NF-e-Positionen – jeweils mit 2–15 Einzelpositionen und eigener CFOP – ist eine halbtägige Übung mit hoher Fehlerquote. Mit Batch-Extraktion, die CFOP, NCM, Lieferanten-Bundesstaat und Käufer-Bundesstaat in separate Spalten erfasst, können Sie eine einfache Bedingungsprüfung ausführen: wenn Staat(Aussteller) ≠ Staat(Empfänger) UND CFOP-Präfix ≠ 2, kennzeichnen Sie die Zeile. Diese eine Regel erfasst 80 % der CFOP-Fehler in einem Batch mit mehreren Lieferanten.
Die 44-stellige Chave de Acesso – Brasiliens eingebaute Deduplizierungsschlüssel, den die meisten Batch-Tools ignorieren
Die Chave de Acesso ist eine 44-stellige Zeichenfolge, die jede in Brasilien ausgestellte NF-e dauerhaft eindeutig identifiziert. Sie ist nicht nur eine Referenznummer – sie ist ein strukturierter Identifikator, der den Bundesstaat des Ausstellers (erste 2 Ziffern, gemäß IBGE-Code), das Ausstellungsjahr und den Monat (nächste 4), die CNPJ des Ausstellers (nächste 14), das Dokumentmodell (2), die Serie (3), die fortlaufende Nummer (9), den Emissionstyp (1), einen Zufallscode zur Kollisionsvermeidung (8) und eine Modulo-11-Prüfziffer (1) kodiert. Jede NF-e-XML-Datei trägt diesen Schlüssel im Attribut <infNFe Id="NFe[chave]"> und im Element <chNFe>. Es ist das, was einem global eindeutigen Rechnungsidentifikator am nächsten kommt, den jedes Steuersystem der Welt bietet.
Doch die meisten AP-Batch-Tools extrahieren eine Spalte „Rechnungsnummer“ und belassen es dabei. In Brasilien reicht diese Spalte nicht aus:
- Lieferant A kann NF-e #1523 in Serie 001 und NF-e #1523 in Serie 002 ausstellen – gleiche Rechnungsnummer, zwei völlig verschiedene Steuerdokumente, nur unterscheidbar durch Serie und Chave de Acesso.
- Lieferant B kann NF-e #1523 in seiner eigenen Serie 001 ausstellen – gleiche Rechnungsnummer wie Lieferant A, anderer Lieferant, andere Transaktion – und eine einfache Duplikatprüfung auf Lieferant+Rechnungsnummer unterdrückt eine davon als Duplikat.
- Das SEFAZ-Stornierungs- und Korrektursystem basiert auf der Chave de Acesso. Wenn ein Lieferant eine Carta de Correção (CCe) ausstellt, um einen Tippfehler in der ursprünglichen NF-e zu korrigieren, bleibt die ursprüngliche Chave de Acesso gültig – aber der Ereignisverlauf, der an diese Chave gebunden ist, zeichnet die Korrektur auf. Ein Batch-Tool, das die Chave nicht nachverfolgt, kann nicht zwischen Original und korrigierter Version unterscheiden.
Extrahieren Sie in einem Batch aus 50 NF-e-XML-Dateien die Chave de Acesso als eigene Spalte. Implementieren Sie dann drei Prüfungen:
- Eindeutigkeit innerhalb des Batches. Keine zwei Zeilen dürfen dieselbe Chave de Acesso aufweisen. Ist dies der Fall, wurde dieselbe NF-e zweimal hochgeladen – unterdrücken Sie die doppelte Zeile und kennzeichnen Sie das Vorkommen.
- Eindeutigkeit der Rechnungsnummer innerhalb Lieferant × Serie. Gruppieren Sie nach CNPJ + Serie + Rechnungsnummer. Wenn dieselbe Kombination zweimal mit unterschiedlichen Chave de Acessos erscheint, handelt es sich wahrscheinlich um eine Korrektur – die Chave mit dem späteren Ausstellungszeitstempel hat Vorrang.
- SEFAZ-Überprüfung für Rechnungen mit hohem Wert. Für Rechnungen über einer Wesentlichkeitsgrenze verwenden Sie die Chave de Acesso, um das öffentliche Konsultationsportal von SEFAZ oder eine Drittanbieter-API wie TF Fiscal's NF-e-Lookup abzufragen und den Autorisierungsstatus (Autorizada/Cancelada/Denegada) zu verifizieren. Eine stornierte NF-e in Ihrem Batch bedeutet, dass der Lieferant sie neu ausgestellt hat – und Sie benötigen die Ersatz-Chave.
Die 44 Ziffern wirken auf nicht-brasilianische AP-Mitarbeiter einschüchternd. Aber sie sind der zuverlässigste Deduplizierungsschlüssel, der in jedem E-Rechnungs-System weltweit verfügbar ist. Sie bei der Batch-Verarbeitung nicht zu nutzen, ist, als hätte man eine Sozialversicherungsnummer und würde Personen nur mit ihrem Vornamen identifizieren.
Der gemischte XML- + DANFE-Batch – wenn einige Lieferanten die vollständige Rechnung senden und andere nur Papier
Größere brasilianische Lieferanten – insbesondere Industriehersteller und Distributoren mit SAP, TOTVS Protheus oder Oracle – senden die NF-e-XML routinemäßig. Sie wird von ihrem ERP erzeugt, mit ihrem ICP-Brasil-Zertifikat signiert und automatisch an SEFAZ übermittelt. Sie zusammen mit der DANFE an den Käufer zu senden, ist ein Ein-Klick-Vorgang.
Kleinere Lieferanten – landwirtschaftliche Genossenschaften, lokale Dienstleister, einige Baustofflieferanten – verfügen möglicherweise nicht über die ERP-Infrastruktur, um die XML-Übertragung zu verwalten. Sie drucken die DANFE, übergeben sie dem LKW-Fahrer, und das ist das einzige Dokument, das der Käufer sieht. Die Rechnung ist echt, sie wurde von SEFAZ autorisiert (das Autorisierungsprotokoll ist auf der DANFE aufgedruckt), aber die empfangende AP-Abteilung hat nur ein gescanntes PDF oder ein Foto des Papierdokuments.
Ein Batch-AP-Workflow, der nur XML oder nur PDF verarbeitet, zwingt das AP-Team, seinen monatlichen Rechnungseingang in zwei getrennte Verarbeitungspipelines aufzuteilen – eine für strukturierte XML, eine für gescannte DANFEs – und die Ergebnisse dann manuell in einen einzigen Hauptbuch-Eintrag zusammenzuführen. Die Fragmentierungskosten sind real: getrennte Upload-Sitzungen, getrennte Prüfungsdurchläufe und ein Abgleichsschritt am Ende, um sicherzustellen, dass alle Rechnungen desselben Lieferanten (einige XML, einige PDF) im selben AP-Batch landen.
Benutzerdefinierte Spaltenextraktion — der Ansatz von ImageToTable.ai, Daten nach Feldbedeutung statt nach Vorlagenkoordinaten zu extrahieren — verarbeitet beide Quellen in einem Batch-Upload. Sie definieren Ihre Spaltennamen einmal: „Chave de Acesso", „Lieferanten-CNPJ", „Lieferantenname", „NF-e-Nummer", „Serie", „Ausstellungsdatum", „CFOP", „NCM", „Positionstext", „Menge", „Einzelpreis", „Positionssumme", „ICMS-Basis", „ICMS-Satz", „ICMS-Betrag", „IPI-Betrag", „PIS-Betrag", „COFINS-Betrag", „Gesamtwert der NF-e". Die KI liest strukturierte Daten aus XML-Dateien, in denen die Felder maschinenlesbar sind, und extrahiert dieselben Felder aus gescannten DANFE-PDFs, indem sie visuell versteht, was jedes Label bedeutet — unabhängig vom Layout. Beide Quellen werden in derselben Tabelle mit denselben Spalten in einem Batch zusammengeführt.
Der praktische Vorteil liegt nicht nur in der Geschwindigkeit — sondern in der Konsistenz. Die Chave-de-Acesso-Spalte aus XML-Dateien wird direkt aus dem <chNFe>-Element extrahiert. Dieselbe Spalte aus einem DANFE-Scan wird aus dem 44-stelligen Barcode-Bereich oben rechts auf dem gedruckten Dokument gelesen. Beide Einträge landen in derselben Spalte und ermöglichen dieselbe Deduplizierungslogik wie oben beschrieben. Ohne einen einheitlichen Batch-Workflow leben die Chave de Acesso aus dem XML-Batch und die Chave de Acesso aus dem gescannten DANFE-Batch in getrennten Tabellen — und die Duplikaterkennung zwischen ihnen ist manuell.
Die Übergangsphase der Steuerreform 2026–2033 — Doppelte Compliance in einem einzigen Batch
Die brasilianische Verbrauchsteuerreform — eingeführt durch Verfassungsänderung 132 vom Dezember 2023 und geregelt durch Ergänzendes Gesetz 214 vom Januar 2025 — restrukturiert das gesamte indirekte Steuersystem des Landes über einen Zeitraum von acht Jahren. Bis 2033 werden fünf alte Steuern (PIS, COFINS, IPI, ICMS und ISS) durch ein duales Mehrwertsteuersystem ersetzt: die bundesstaatliche CBS (Contribuição sobre Bens e Serviços) und die staatlich-kommunale IBS (Imposto sobre Bens e Serviços), plus eine selektive Steuer (IS) auf gesundheits- und umweltschädliche Güter. Die Übergangsphase begann am 1. Januar 2026.
Für AP-Teams, die brasilianische NF-e-Batches verarbeiten, ist die unmittelbare operative Herausforderung die doppelte Compliance im XML-Schema. Während der Übergangsjahre werden NF-e-XMLs sowohl alte Steuerfelder (ICMS, IPI, PIS, COFINS) als auch neue Steuerfelder (CBS, IBS) gleichzeitig enthalten — das bedeutet, dass das bereits komplexe NF-e-XML mit über 500 Feldern bald noch größer wird. Hier ist der Zeitplan, der das Design der Batch-Extraktion beeinflusst:
| Jahr | Status der alten Steuern | Status der neuen Steuern | Auswirkung auf die Batch-Extraktion |
|---|---|---|---|
| 2026 | ICMS, PIS, COFINS, IPI vollständig aktiv | CBS 0,9 % + IBS 0,1 % Testsätze (abzugsfähig von PIS/COFINS, keine zusätzliche Nettobelastung) | Das NF-e-XML-Schema enthält jetzt CBS/IBS-Felder neben den bisherigen Feldern. Die Extraktion muss beide parsen – auch wenn die Testsätze die Steuerschuld netto nicht verändern. |
| 2027 | PIS, COFINS abgeschafft. ICMS, IPI bleiben bestehen. | CBS vollständig zu vollen Sätzen durchgesetzt | Das NF-e-XML entfernt PIS/COFINS-Gruppen, behält ICMS/IPI und fügt CBS hinzu. Die Spaltendefinitionen ändern sich bei einigen Lieferanten im Laufe des Jahres. |
| 2029–2032 | ICMS-Sätze sinken um 10 %/Jahr (90 % im Jahr 2029 → 60 % im Jahr 2032). ISS und IPI werden schrittweise abgebaut. | IBS-Sätze steigen proportional (10 % im Jahr 2029 → 40 % im Jahr 2032) | Die Werte der ICMS-Satzspalte sinken Jahr für Jahr. Die Werte der IBS-Spalte steigen. Vergleiche über Jahre hinweg erfordern eine Kennzeichnung des Jahressatzes. |
| 2033 | ICMS, ISS, IPI abgeschafft | CBS + IBS vollständig betriebsbereit | Das NF-e-XML enthält nur noch CBS- und IBS-Steuergruppen. Klarer Bruch – historische Daten für Prüfungen behalten jedoch die alte Struktur. |
Die praktische Auswirkung für die Batch-Extraktion im Jahr 2026: Wenn Sie jetzt Spaltendefinitionen erstellen, nehmen Sie CBS- und IBS-Spalten neben Ihren ICMS- und PIS/COFINS-Spalten auf – auch zu den Testsätzen. Die Daten sind heute bereits im XML enthalten. Die Extraktion kostet nichts. Wenn die Daten in Ihrer Tabelle vorhanden sind, wenn der Übergang 2027 an Fahrt aufnimmt, enthält Ihr historischer Batch-Datenbestand bereits die Grundlage für die CBS-basierte Berichterstattung – ohne nachträgliche Re-Extraktion archivierter NF-e-XMLs aus dem Jahr 2026.
Ein Batch-Extraktionssystem, das Feldnamen semantisch liest – „ICMS-Basis", „ICMS-Satz", „CBS-Basis", „CBS-Satz" usw. – bewältigt diesen Übergang ohne Neu-Konfiguration pro Lieferant. Die Spaltendefinitionen bleiben gleich; die KI findet die Steuerfelder, die in der aktuellen XML-Schemaversion vorhanden sind. Wenn die Nota-Técnica-Updates in den nächsten sieben Jahren neue Felder hinzufügen und alte entfernen, passt sich die Extraktionslogik an das XML an, das eintrifft – nicht an eine Vorlage, die jedes Mal neu erstellt werden muss, wenn SEFAZ eine neue Layout-Version veröffentlicht.
Ein Batch-NF-e-Verarbeitungsworkflow, der den Monatsabschluss übersteht
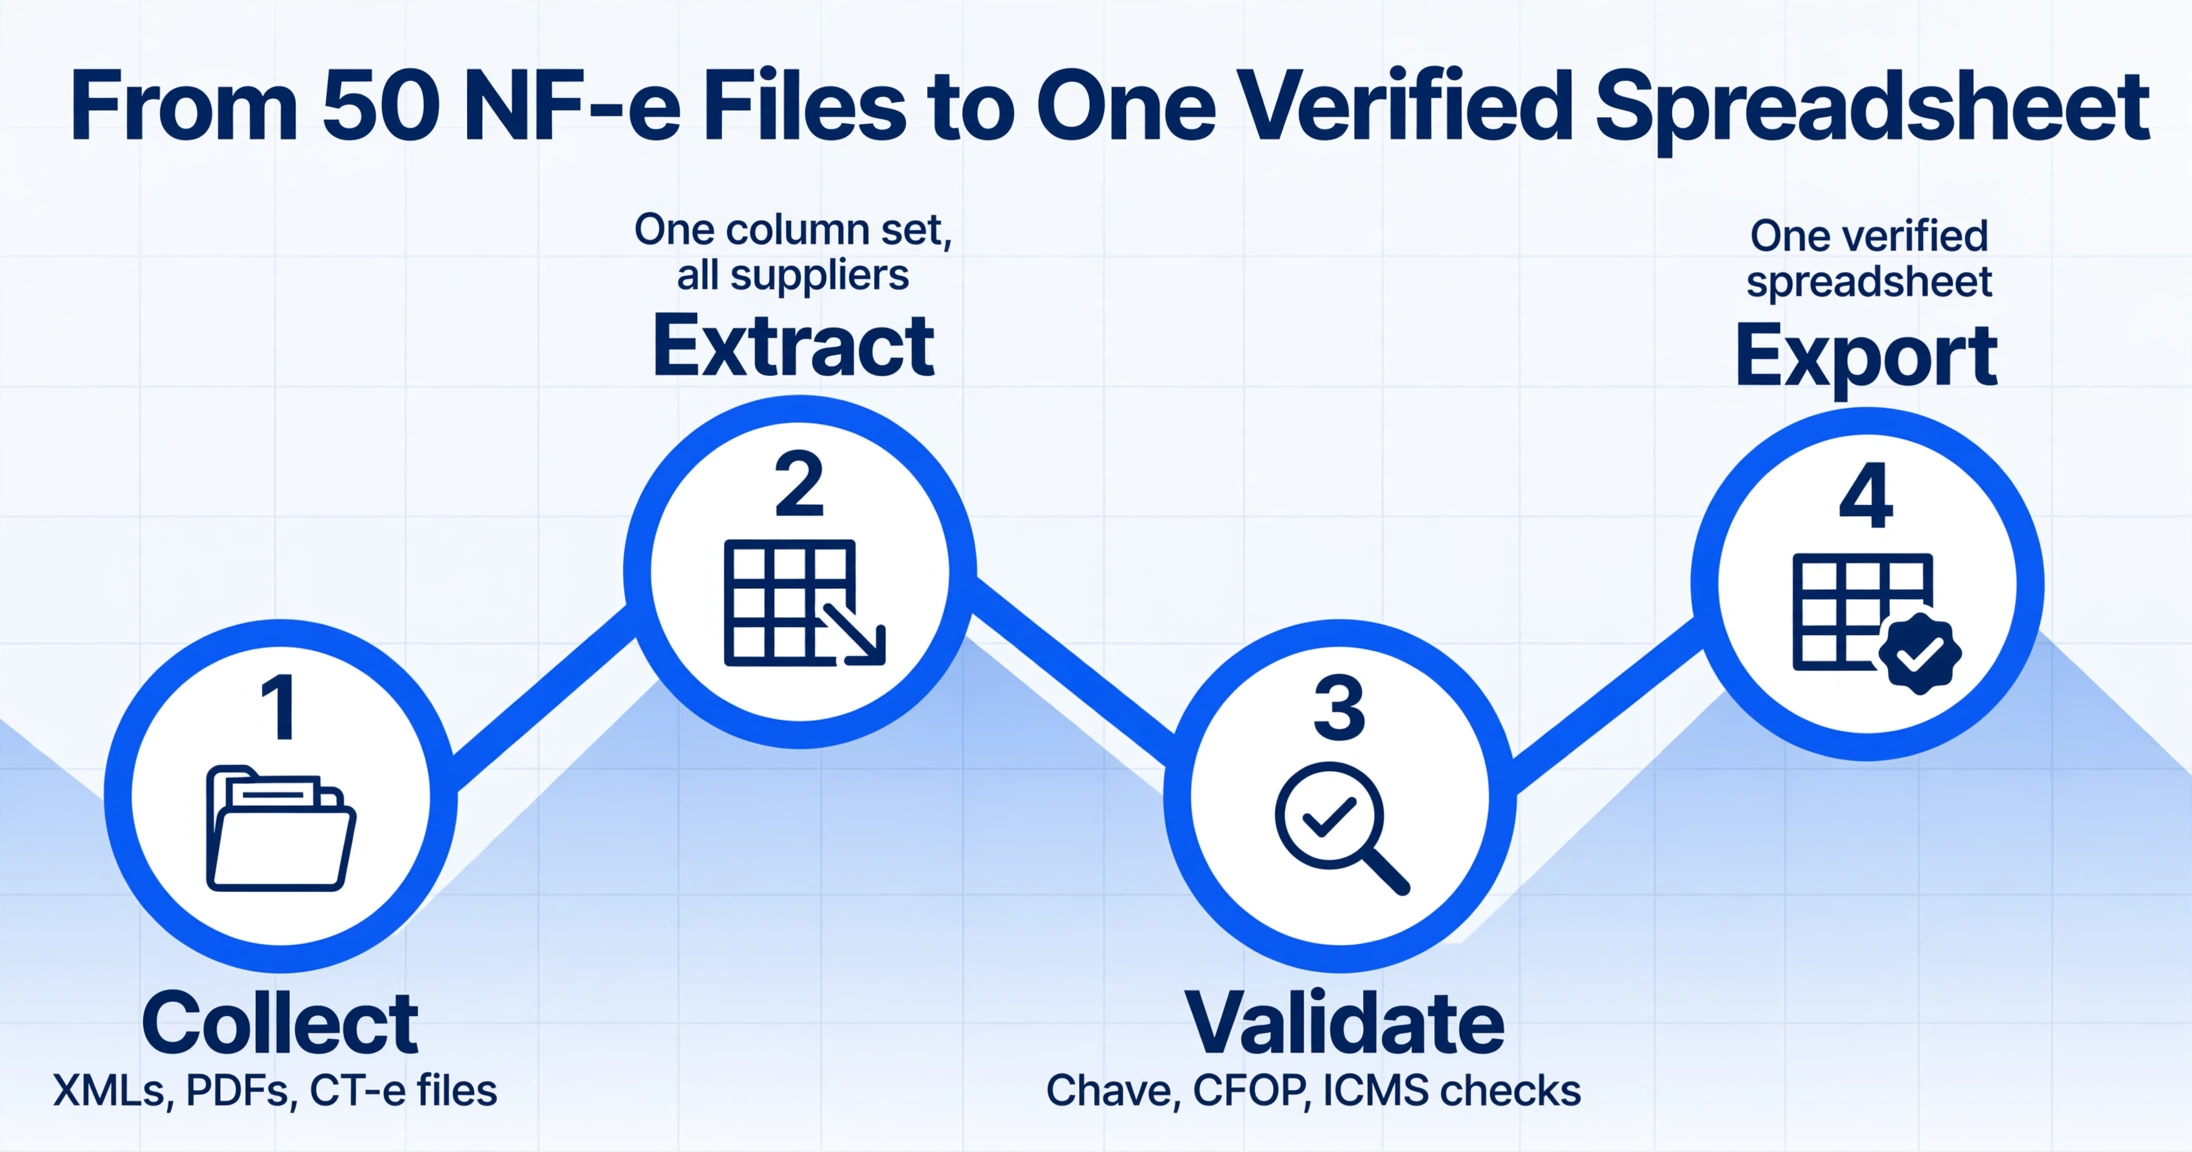
Nachdem die strukturellen Probleme erfasst sind, finden Sie hier eine Batch-Verarbeitungssequenz, die für die Realität der Multi-Lieferanten- und Multi-Bundesstaat-Umgebung brasilianischer Kreditorenbuchhaltung konzipiert ist:
- 1Quelldateien sammeln und normalisieren. Sammeln Sie alle NF-e-XMLs, DANFE-PDFs und CT-e-Frachtdokumente für den Batch-Zeitraum (in der Regel monatlich). Benennen Sie die Dateien nach einer einheitlichen Konvention um —
{CNPJ}_{NF-e-Nummer}_{Serie}_{Ausstellungsdatum}.xml— damit die Quellenzuordnung bereits im Dateinamen verankert ist. Verwerfen Sie die ursprünglichen Dateinamen nicht; fügen Sie sie als Metadaten hinzu. - 2Extraktionsspalten einmal für alle Lieferanten definieren. Legen Sie Spaltennamen fest, die alle benötigten NF-e-Daten abdecken: Lieferantenkennungen (CNPJ, Razão Social, Inscrição Estadual), Dokumentkennungen (Chave de Acesso, Número, Série, Data de Emissão), Positionen (NCM, CFOP, Descrição, Quantidade, Preço Unitário, Total da Linha) und Steuern (Base ICMS, Alíquota ICMS, Valor ICMS, Valor IPI, Base PIS, Valor PIS, Base COFINS, Valor COFINS, Valor Total da NF-e). Fügen Sie CBS- und IBS-Spalten für den Übergang 2026 hinzu. Diese Spaltennamen funktionieren für alle Lieferanten, da die Extraktion die Feldbedeutung und nicht die Feldposition liest — derselbe Ansatz, der auch beim Batch-Export von Rechnungsdaten nach Excel bei gemischten Lieferantenformaten verwendet wird.
- 3Den gesamten Batch in einer Sitzung hochladen. Ziehen Sie alle 50 Dateien — XMLs, PDFs, Scans — in den Upload-Bereich. Das System verarbeitet sie gemeinsam und führt die Ausgabe in einer Tabelle zusammen. Jede Zeile ist für die Rückverfolgbarkeit mit ihrem Quelldateinamen gekennzeichnet.
- 4Die drei batchspezifischen Validierungen durchführen. (a) Eindeutigkeitsprüfung der Chave de acesso — keine Duplikate. (b) CFOP-Erstziffer vs. Staatspaar — kennzeichnen Sie Abweichungen, bei denen ein innerstaatlicher CFOP (1xxx) bei zwischenstaatlichen Transaktionen auftritt. (c) Plausibilitätsprüfung des ICMS-Satzes — vergleichen Sie die extrahierten Sätze mit den erwarteten staatlichen Sätzen. Ein ICMS von 20,5 % bei einem Lieferanten in São Paulo (18 % innerstaatlich, 7–12 % zwischenstaatlich) deutet entweder auf einen falsch klassifizierten Lieferanten aus Pernambuco oder auf einen Datenfehler hin. Zur Überprüfung kennzeichnen.
- 5Für die ERP-Buchung nach Steuerbehandlung trennen. Verwenden Sie die extrahierten Spalten ICMS-Satz und Ursprungsstaat, um die Zeilen in Buchungs-Batches zu gruppieren: innerstaatliche Buchungen (Satz = 17–22 %), zwischenstaatliche Buchungen zu 12 %, zwischenstaatliche Buchungen zu 7 % und Buchungen zu 4 % (importierte Waren). Jede Gruppe wird in Ihrem ERP auf unterschiedliche Steuerkonten gebucht. Die gleiche Gruppierungslogik gilt für die IPI-, PIS- und COFINS-Spalten.
Dieser Workflow setzt voraus, dass Ihr Batch-Extraktionstool XML- und visuelle Dokumente in derselben Upload-Sitzung verarbeiten kann — da die brasilianische AP selten nur ein Format erhält. Wenn Ihr aktueller Prozess einen separaten Workflow für die XML-Analyse und einen separaten Workflow für die PDF-OCR erfordert, verdoppelt der Zusammenführungsschritt in Schritt 5 Ihre Verarbeitungszeit und birgt das Risiko inkonsistenter Spaltenzuordnungen zwischen den beiden Pipelines.
Häufig gestellte Fragen
Kann die Batch-Verarbeitung NF-e-XMLs und DANFE-PDFs im selben Upload verarbeiten?
Ja — wenn das Extraktionstool Semantik liest und sich nicht nur auf die XML-Analyse verlässt. Die semantische Extraktion liest die strukturierten Tags des NF-e-XML für Daten, die in beiden Formaten vorhanden sind (CNPJ, NF-e-Nummer, Summen, Steuerbeträge), und liest die DANFE visuell für Fälle, in denen nur das gedruckte Dokument verfügbar ist. Die Ausgabe wird in einer einzigen Tabelle mit konsistenten Spalten zusammengeführt. Wenn Ihr Tool nur XML parst oder nur OCR durchführt, benötigen Sie zwei separate Arbeitsabläufe und einen manuellen Zusammenführungsschritt.
Was passiert, wenn zwei NF-e-XMLs dieselbe Rechnungsnummer, aber unterschiedliche Chave de Acessos haben?
Dies ist ein legitimes Szenario — typischerweise eine korrigierte NF-e, die nach einem CCe-Ereignis neu ausgestellt wurde, oder zwei NF-e-Dokumente aus verschiedenen Serien mit derselben fortlaufenden Nummer. Die Chave de Acesso ist in beiden Fällen eindeutig. Ihre Batch-Validierung sollte für die Deduplizierung nach Chave de Acesso (nicht nach Rechnungsnummer) gruppieren und die Beziehung zwischen Rechnungsnummer, Serie und Chave für Prüfzwecke bewahren. Wenn dieselbe CNPJ + Serie + Rechnungsnummer mit zwei verschiedenen Chave de Acessos erscheint, prüfen Sie die Ausstellungszeitstempel — die spätere Chave ersetzt die frühere.
Wie gehe ich mit ICMS-ST (Steuersubstitution) in einem Batch um?
ICMS-ST erscheint im NF-e-XML als separate Steuergruppe (<ICMSTot> im Summenblock) mit eigener Bemessungsgrundlage, eigenem Satz und eigenem Betrag. Es sollte in separate Spalten extrahiert werden („ICMS-ST-Basis", „ICMS-ST-Betrag") — nicht mit regulärem ICMS zusammengeführt. ICMS-ST stellt eine bereits upstream von einem substituierenden Steuerpflichtigen gezahlte Steuer dar, und Ihr ERP behandelt sie für Gutschriftzwecke anders als reguläres ICMS. Wenn Sie beides in einer „ICMS"-Spalte mischen, überhöhen Sie Ihre verfügbaren Gutschriften.
Kann ich nur bestimmte Positionen aus einer NF-e extrahieren statt aller Positionen?
Ja. Wenn Sie Ihre Extraktionsspalten definieren, nehmen Sie die Felder auf, die Sie auf Positionsebene benötigen (NCM, CFOP, Beschreibung, Menge, Einzelpreis, Positionssumme und Steuern pro Position). Die KI extrahiert jede Position aus jeder NF-e, die Ihrer Spaltendefinition entspricht. Wenn Sie nur bestimmte Spalten benötigen — etwa NCM + Menge + CFOP ohne Einzelpreis — lassen Sie die unerwünschten Spalten aus Ihrer Definition weg. Die Extraktion erzeugt nur das, was Sie anfordern.
Ändert die Steuerreform 2026, was ich aus NF-e-XMLs extrahieren muss?
Im Jahr 2026 enthält das NF-e-XML-Schema nun CBS- und IBS-Felder mit Testsätzen (0,9 % bzw. 0,1 %) neben den bestehenden ICMS-, PIS- und COFINS-Feldern. Diese Testsätze sind vollständig von PIS/COFINS abziehbar, sodass sich die Nettosteuerlast nicht ändert. Die Felder existieren jedoch im XML und sollten jetzt extrahiert werden – wenn CBS 2027 PIS/COFINS zu vollen Sätzen ersetzt, sind Ihre Batch-Extraktionsspaltendefinitionen bereits vorhanden. Der Zeitplan der Steuerreform ist im Ergänzenden Gesetz 214/2025 und in der OECD-Analyse der Reform von 2025 kodifiziert.
Wie lange muss ich NF-e-XMLs und Extraktionsaufzeichnungen aufbewahren?
Das brasilianische Steuerrecht verlangt, dass NF-e-XMLs und zugehörige Steuerdokumente mindestens fünf Jahre ab Ende des Steuerjahres, in dem die Transaktion stattfand, archiviert werden. Dies gilt sowohl für die ursprünglichen XMLs von Lieferanten als auch für Ihre Extraktionsaufzeichnungen. Die DANFE ist bei einer Prüfung kein rechtlich ausreichender Ersatz für das XML – wenn Sie nur die gescannte DANFE aufbewahrt und das XML verworfen haben, können Sie den vollständigen Steuerdatensatz, den SEFAZ anfordern wird, nicht rekonstruieren. Best Practice: Archivieren Sie die XMLs unverändert und führen Sie die Extraktionstabelle als separates, durchsuchbares Dokument für die interne Abstimmung.