50 XML de NF-e brasileñas, una sola hoja de cálculo
Cómo el procesamiento por lotes de múltiples proveedores elimina la conciliación fiscal manual
Procesar una NF-e de un proveedor de São Paulo toma 3 minutos. El XML está limpio, los campos son inequívocos y la tasa de ICMS — 18% interna — es la esperada. El problema comienza cuando tiene 50 XML de NF-e de 14 proveedores distribuidos en 7 estados brasileños. El proveedor #3 en Paraná aplica 19,5% de ICMS en envíos intraestatales, pero 12% cuando le envía a usted en São Paulo. El proveedor #8 en Pernambuco cobra 20,5% — excepto en los artículos clasificados bajo NCM 8471.30, que reciben una tasa reducida. El proveedor #11 envió el PDF de DANFE pero no el XML. Y en algún lugar del lote, dos documentos NF-e diferentes comparten el mismo número de factura porque el proveedor #2 reinició su secuencia de numeración al comienzo del año fiscal. Extraer una NF-e es sencillo. Extraer 50 y producir una hoja de cálculo de cuentas por pagar limpia y auditable donde el tratamiento fiscal de cada fila sea verificable — ese es un problema completamente diferente.
Cuando llegan 50 XML de NF-e — Por qué el lote no es "un solo documento, repetido 50 veces"
El procesamiento de NF-e brasileño es inusual en un aspecto: los datos de origen ya están estructurados. A diferencia de las facturas en papel de proveedores estadounidenses o europeos que requieren OCR para digitalizarse, cada NF-e llega como un archivo XML que ya ha sido validado contra más de 400 reglas de SEFAZ y firmado digitalmente con un certificado ICP-Brasil. La calidad de los datos de un solo XML de NF-e es casi perfecta. El problema del lote en la AP brasileña no es la precisión de la captura de datos — es la consistencia de los datos entre proveedores.
Cuando procesa 50 XML de NF-e de 14 proveedores en un solo lote, surgen cuatro problemas estructurales que el procesamiento de facturas individuales nunca expone:
Fragmentación de la tasa de ICMS. El ICMS de Brasil es un IVA a nivel estatal con tasas que difieren según el estado del proveedor, su estado, la dirección de la transacción (intraestatal vs. interestatal) y — en algunos casos — la clasificación del producto NCM. Un lote de 50 XML de NF-e de proveedores en 7 estados puede contener tasas intraestatales de 17%, 18%, 19%, 19.5%, 20% y 20.5%, más tasas interestatales de 4%, 7% o 12% dependiendo de los pares de origen y destino. Una columna de "Monto de ICMS" en su hoja de cálculo no tiene sentido a menos que también conozca la tasa, el estado aplicable y si la transacción es interna o interestatal — porque el mismo cargo de ICMS de R$1,000 puede significar una tasa del 17% sobre una base de R$5,882 o una tasa del 12% sobre una base de R$8,333. El módulo fiscal de su ERP necesita la distinción.
Brechas de consistencia de CFOP. Cada línea de artículo de NF-e lleva un código CFOP de 4 dígitos (Código Fiscal de Operações e Prestações) que clasifica la naturaleza fiscal de la transacción — 1.101 para compra para industrialización dentro del mismo estado, 2.102 para compra interestatal para reventa, 3.101 para importación. El primer dígito codifica si la transacción es intraestatal (1), interestatal (2) o importación internacional (3). Cuando el proveedor A usa CFOP 1.101 para un envío de São Paulo a su almacén en São Paulo, y el proveedor B usa CFOP 2.102 para un envío interestatal de Minas Gerais, eso es correcto y deliberado. Pero si el proveedor C usa CFOP 1.101 en un envío que se originó en Rio de Janeiro — una transacción interestatal — el CFOP no coincide con los datos del estado en los bloques <ide> y <emit> del XML. Esa discrepancia creará una bandera de auditoría en SPED EFD (Escrituração Fiscal Digital), el sistema federal de contabilidad digital que cruza los códigos CFOP en toda la cadena de suministro. En un lote de 50 facturas, de 3 a 5 discrepancias son comunes — y encontrarlas manualmente significa verificar el CFOP de cada XML contra su par de estados de origen y destino.
Fallo en la detección de duplicados basada solo en el número de factura. En la mayoría de los sistemas de AP, la detección de duplicados se basa en proveedor + número de factura. Esta lógica falla con la NF-e brasileña porque el número de factura (número da nota) solo es único dentro de la serie de un solo proveedor. El proveedor A podría emitir la NF-e #1523 en la serie 001, mientras que el proveedor B también emite la NF-e #1523 en su serie 001. Incluso el mismo proveedor puede emitir números de factura idénticos en diferentes series. El identificador globalmente único es la chave de acesso de 44 dígitos — pero la mayoría de las herramientas de extracción por lotes no la extraen, o la extraen sin entender su papel como clave de deduplicación. Sin la chave de acesso, dos facturas diferentes de dos proveedores diferentes con el mismo número de factura se marcarán como duplicados y una se suprimirá — o peor, una factura reenviada con una chave de acesso corregida (que indica un evento de carta de corrección CCe) no se reconocerá como un reemplazo.
Fuentes de formato mixto. En un lote de 50 facturas de proveedores brasileños, rara vez se obtienen 50 XML limpios. Algunos proveedores — normalmente fabricantes más pequeños o productores agrícolas — envían solo el DANFE impreso como PDF o escaneado. Algunos envían el XML pero adjuntan un DANFE escaneado con anotaciones manuscritas. Un proveedor industrial mediano podría enviar el XML de la NF-e principal, pero el CT-e de flete (Conhecimento de Transporte Eletrônico) como PDF. El flujo de trabajo de procesamiento por lotes debe manejar todo esto en una sola pasada — extrayendo datos estructurados del XML cuando estén disponibles y leyendo el documento visual cuando falte el XML — y fusionando todo en columnas consistentes.
Estos cuatro problemas no existen en una sola factura. A las 50, los cuatro se activan simultáneamente — y resolverlos es lo que distingue un flujo de trabajo de procesamiento por lotes de "una extracción única, repetida 50 veces".
La Matriz de Tasas de ICMS en 7 Estados — Por Qué una Sola Columna de "Impuesto" Falla
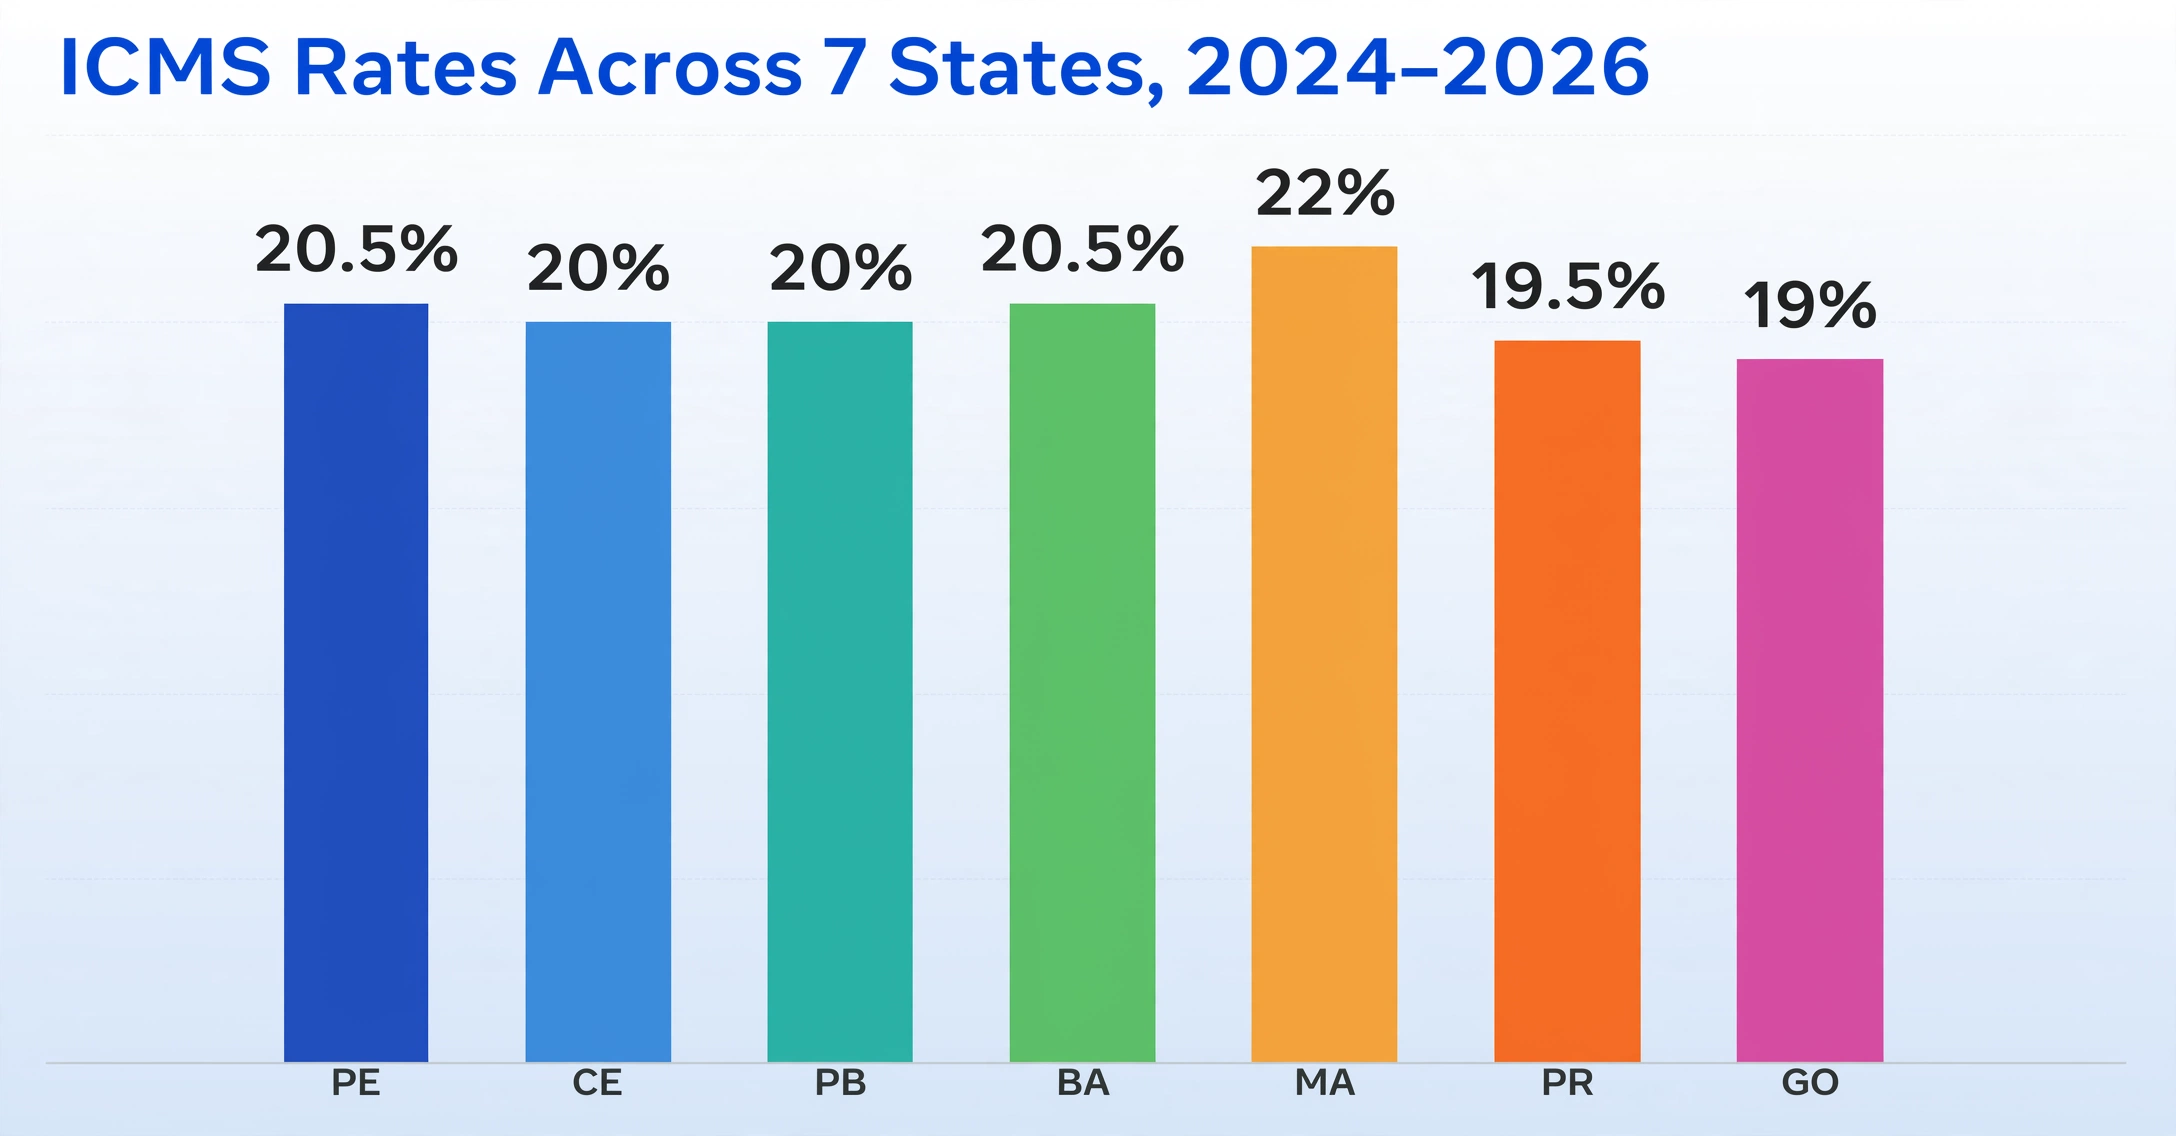
Las tasas internas de ICMS en Brasil cambiaron significativamente en 2024, en parte en anticipación a la reforma fiscal que eventualmente reemplazará el ICMS con el nuevo IBS (Imposto sobre Bens e Serviços) entre 2029 y 2033. Once estados brasileños cambiaron sus tasas estándar de ICMS el año pasado:
| Estado (UF) | Tasa anterior | Tasa 2024–2026 | Fecha de vigencia |
|---|---|---|---|
| Pernambuco | 18% | 20.5% | Ene 2024 |
| Ceará | 18% | 20% | Ene 2024 |
| Paraíba | 18% | 20% | Ene 2024 |
| Bahia | 19% | 20.5% | Feb 2024 |
| Maranhão | 20% | 22% | Feb 2024 |
| Paraná | 19% | 19.5% | Mar 2024 |
| Goiás | 17% | 19% | Abr 2024 |
| Rondônia | 17.5% | 19.5% | Ene 2024 |
| Distrito Federal | 18% | 20% | Ene 2024 |
| Espírito Santo | 17% | 19.5% | Abr 2024 |
| Rio Grande do Norte | 20% | 18% | Ene 2024 |
Fuentes: Vertex Inc., leyes estatales (Leis Estaduais). São Paulo se mantuvo en 18%, Minas Gerais en 18%, Río de Janeiro en 20% (en el mismo período, con un aumento propuesto al 22% aún en debate legislativo).
La consecuencia práctica para el procesamiento por lotes: si su base de proveedores abarca más de dos estados brasileños, su hoja de cálculo de lote debe registrar el ICMS a nivel de tasa × estado × tipo de transacción, no en una sola columna que sume todos los valores de ICMS. Una NF-e de un proveedor en Pernambuco (20.5% dentro del estado) y una NF-e de un proveedor en São Paulo (18% dentro del estado) tendrán un tratamiento de ICMS diferente en su ERP, incluso si la columna de monto de ICMS muestra la misma cifra.
Las tasas interestatales añaden una segunda dimensión, codificada en la legislación fiscal brasileña:
| Región de origen | Región de destino | Tasa interestatal |
|---|---|---|
| Sur y Sudeste (SP, RJ, MG, PR, SC, RS, ES) | Sur y Sudeste | 12% |
| Norte, Nordeste y Centro-Oeste | Cualquier estado brasileño | 12% |
| Sur y Sudeste | Norte, Nordeste y Centro-Oeste (incl. ES) | 7% |
| Cualquier estado — bienes importados con >40% de contenido extranjero | Cualquier estado | 4% |
Combine estos niveles de tasas interestatales con los 11 cambios de tasas estatales mencionados anteriormente, y un lote de NF-e XML de proveedores en 7 estados puede contener fácilmente 5 tasas de ICMS diferentes, cada una de las cuales debe identificarse, separarse por tipo y registrarse en la cuenta fiscal correcta en su ERP. Las herramientas que extraen el ICMS como un solo número sin capturar la tasa, el estado de origen y el tipo de transacción del XML están produciendo una hoja de cálculo que genera más trabajo de conciliación del que ahorra.
Aquí es donde extraer directamente de la estructura del NF-e XML, no mediante OCR del DANFE, da resultados en volumen. El bloque <imposto> del XML contiene grupos de elementos separados para ICMS, IPI, PIS y COFINS, cada uno con la base imponible (vBC), la tasa (pICMS, pIPI, etc.) y el monto (vICMS, vIPI, etc.) a nivel de partida. Una extracción basada en nombres de columnas que mapea estos campos estructurados — "Base ICMS", "Tasa ICMS (%)", "Monto ICMS", "Monto IPI", "Monto PIS", "Monto COFINS" — en columnas de hoja de cálculo separadas produce una tabla donde cada monto de impuesto se puede rastrear hasta su tasa y base, sin recálculo manual. Para un desglose detallado de la estructura del NF-e XML y el mapeo de campos, consulte la guía completa de extracción de NF-e XML.
Consistencia del Código CFOP entre Proveedores: la Señal de Auditoría que Nadie Revisa en Lotes
Los códigos CFOP son clasificaciones fiscales de operación de 4 dígitos incorporadas en cada ítem de línea de la NF-e. Existen más de 500 códigos CFOP definidos por las autoridades fiscales brasileñas, organizados por el primer dígito:
| Primer Dígito | Significado | Ejemplo (Compra) |
|---|---|---|
| 1 | Entrada dentro del estado (mismo estado) | 1.101 – Compra para industrialización |
| 2 | Entrada interestatal (estados diferentes) | 2.102 – Compra interestatal para reventa |
| 3 | Importación internacional | 3.101 – Importación para industrialización |
| 5 | Salida dentro del estado (ventas) | 5.101 – Venta de producción propia |
| 6 | Salida interestatal (ventas) | 6.102 – Venta interestatal de mercancías de terceros |
| 7 | Exportación | 7.101 – Exportación de producción propia |
En una sola NF-e, una discrepancia de CFOP es fácil de detectar: si el estado del proveedor es Minas Gerais y su empresa está en São Paulo, todo código CFOP debería comenzar con 2 (entrada interestatal). Si un ítem de línea muestra CFOP 1.101 — dentro del estado — hay un error de datos. A escala, con 50 facturas de múltiples proveedores, este tipo de validación se vuelve esencial y no trivial. Un proveedor podría usar correctamente el CFOP 1.101 para sus envíos locales (hacia sus propios clientes), pero debería usar el 2.101 al enviarle a usted a través de líneas estatales. Si su ERP autocompletó el CFOP incorrecto, usted hereda una exposición de auditoría que SPED EFD detectará — porque el sistema de contabilidad digital cruza los registros de CFOP del comprador y del vendedor para cada transacción. Una discrepancia entre su registro de CFOP de entrada y el registro de salida correspondiente del proveedor genera una señal de auditoría automática.
La validación de CFOP por lotes implica verificar tres relaciones para cada ítem de línea en el lote:
- Primer dígito vs. par de estados. El primer dígito del CFOP debe coincidir con si el proveedor y el comprador están en el mismo estado (1/5) o en estados diferentes (2/6). Extraiga el código de estado IBGE de los bloques
<emit>y<dest>— códigos 35 (SP), 33 (RJ), 31 (MG), 41 (PR), etc. — y valide el prefijo del CFOP contra la determinación de mismo estado/estados diferentes. - Consistencia del sufijo del CFOP en operaciones similares. Si el proveedor A usa CFOP 2.102 (compra interestatal para reventa) y el proveedor B usa CFOP 2.101 (compra interestatal para industrialización) para el mismo tipo de producto, al menos uno de ellos está equivocado — el sufijo del CFOP debe reflejar el propósito comercial real de la transacción.
- Sin contradicción CFOP-NCM. El CFOP codifica la naturaleza de la operación; el NCM codifica la clasificación del producto. Un CFOP que sugiere un insumo industrial combinado con un NCM para un producto de consumo terminado es una señal de alerta — significa que el CFOP o el NCM es incorrecto, y ambos afectan el tratamiento fiscal.
La validación manual de CFOP en 50 ítems de línea de NF-e —cada uno con 2 a 15 ítems de línea, cada uno con su propio CFOP— es un ejercicio de medio día con una alta tasa de error. La extracción por lotes que captura CFOP, NCM, estado del proveedor y estado del comprador en columnas separadas le permite ejecutar una verificación condicional simple: si estado(emisor) ≠ estado(destinatario) Y prefijo_CFOP ≠ 2, marque la fila. Esta única regla detecta el 80% de los errores de CFOP en un lote de múltiples proveedores.
La Chave de Acesso de 44 Dígitos — La Clave de Deduplicación Integrada de Brasil que la Mayoría de las Herramientas de Lote Ignoran
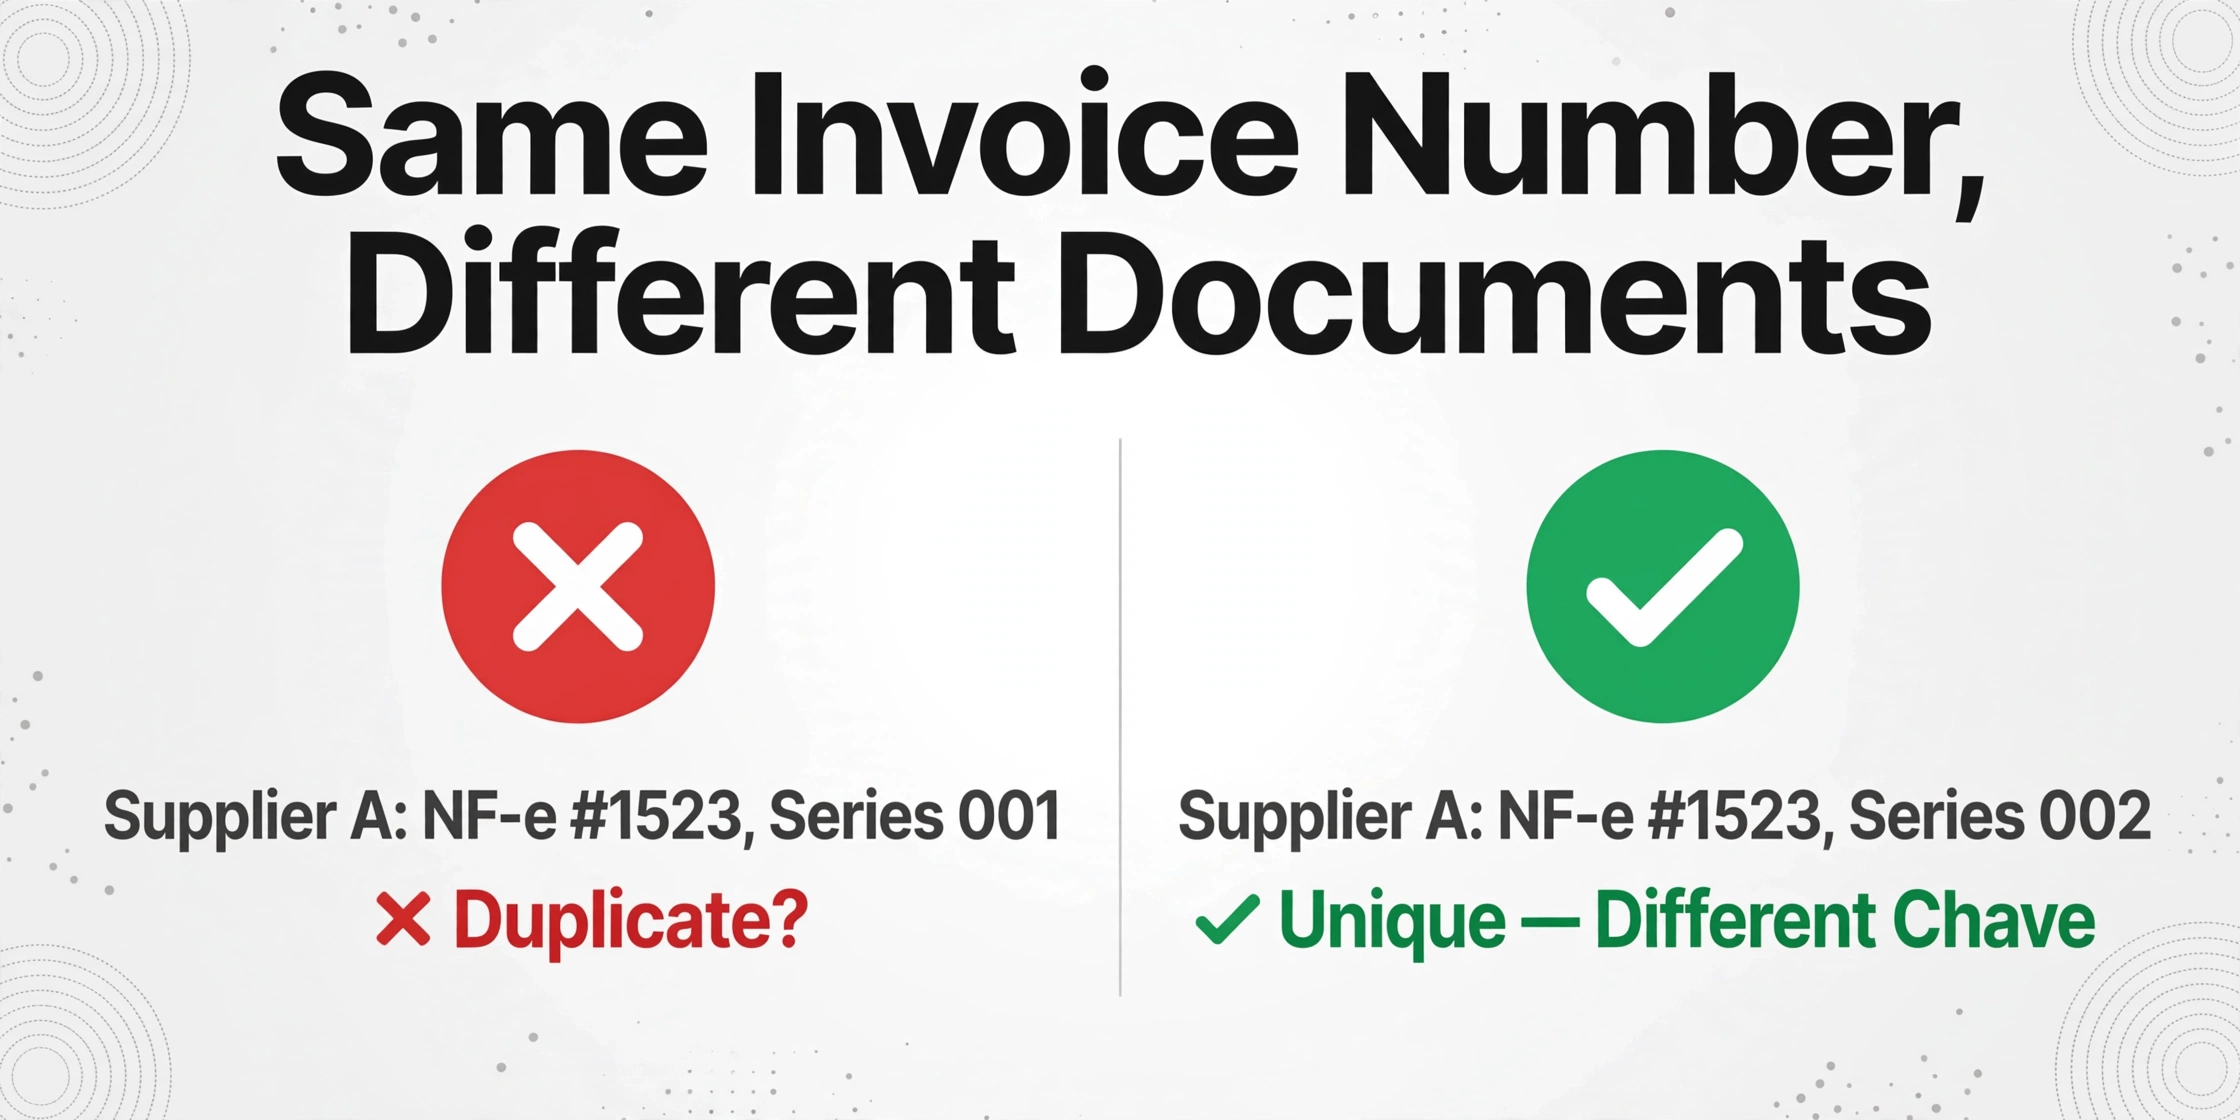
La chave de acesso es una cadena de 44 dígitos que identifica de forma única cada NF-e emitida en Brasil, para siempre. No es meramente un número de referencia — es un identificador estructurado que codifica el estado del emisor (primeros 2 dígitos, según el código IBGE), el año-mes de emisión (los siguientes 4), el CNPJ del emisor (los siguientes 14), el modelo del documento (2), la serie (3), el número secuencial (9), el tipo de emisión (1), un código aleatorio de colisión (8) y un dígito verificador módulo 11 (1). Cada XML de NF-e lleva esta clave en su atributo <infNFe Id="NFe[chave]"> y en el elemento <chNFe>. Es lo más cercano a un identificador de factura globalmente único que cualquier sistema fiscal del mundo proporciona.
Sin embargo, la mayoría de las herramientas de lote de AP extraen una columna de "Número de Factura" y lo dan por terminado. En Brasil, esa columna no es suficiente:
- El Proveedor A puede emitir la NF-e #1523 en la serie 001 y la NF-e #1523 en la serie 002 — el mismo número de factura, dos documentos fiscales completamente diferentes, distinguibles solo por la serie y la chave de acesso.
- El Proveedor B puede emitir la NF-e #1523 en su propia serie 001 — el mismo número de factura que el Proveedor A, proveedor diferente, transacción diferente — y una verificación simple de duplicados por proveedor+número_de_factura suprimirá uno como duplicado.
- El sistema de cancelación y corrección de SEFAZ se basa en la chave de acesso. Cuando un proveedor emite una Carta de Correção (CCe) para corregir un error tipográfico en la NF-e original, la chave de acesso original sigue siendo válida — pero el historial de eventos asociado a esa chave registra la corrección. Una herramienta de lote que no rastrea la chave no puede distinguir entre la versión original y la corregida.
En un lote de 50 XML de NF-e, extraiga la chave de acesso como su propia columna. Luego implemente tres verificaciones:
- Unicidad en todo el lote. No debe haber dos filas con la misma chave de acesso. Si las hay, la misma NF-e se cargó dos veces: suprima la fila duplicada y marque la ocurrencia.
- Unicidad del número de factura dentro de proveedor × serie. Agrupe por CNPJ + serie + número de factura. Si la misma combinación aparece dos veces con chaves de acesso diferentes, es probable que una sea una corrección: la chave con la marca de tiempo de emisión más reciente prevalece.
- Verificación SEFAZ para facturas de alto valor. Para facturas por encima de un umbral de materialidad, use la chave de acesso para consultar el portal público de SEFAZ o una API de terceros como la consulta de NF-e de TF Fiscal para verificar el estado de autorización (Autorizada/Cancelada/Denegada). Una NF-e cancelada en su lote significa que el proveedor la reemitió, y usted necesita la chave de reemplazo.
Los 44 dígitos resultan intimidantes para el personal de cuentas por pagar no brasileño. Pero son la clave de deduplicación más confiable disponible en cualquier régimen de facturación electrónica a nivel mundial. No usarlos en el procesamiento por lotes es como tener un número de seguro social e identificar a las personas por su nombre de pila.
El lote mixto de XML + DANFE: cuando algunos proveedores envían la factura completa y otros solo envían papel
Los proveedores brasileños más grandes — especialmente fabricantes industriales y distribuidores que usan SAP, TOTVS Protheus u Oracle — envían el XML de la NF-e como parte de su rutina habitual. Lo genera su ERP, lo firma su certificado ICP-Brasil y lo transmite a SEFAZ automáticamente. Enviarlo al comprador junto con el DANFE es una operación de un solo clic.
Los proveedores más pequeños — cooperativas agrícolas, proveedores de servicios locales, algunos proveedores de materiales de construcción — pueden no tener la infraestructura de ERP para gestionar la transmisión de XML. Imprimen el DANFE, se lo entregan al conductor del camión, y ese es el único documento que ve el comprador. La factura es real, ha sido autorizada por SEFAZ (el protocolo de autorización está impreso en el DANFE), pero el departamento de cuentas por pagar receptor solo tiene un PDF escaneado o una fotografía del documento en papel.
Un flujo de trabajo de cuentas por pagar por lotes que maneja solo XML o solo PDF obliga al equipo de cuentas por pagar a dividir su ingreso mensual de facturas en dos pipelines de procesamiento separados — uno para XML estructurado, otro para DANFEs escaneados — y luego fusionar manualmente los resultados en una sola entrada del libro mayor. El costo de la fragmentación es real: sesiones de carga separadas, revisiones separadas y un paso de conciliación al final para garantizar que todas las facturas del mismo proveedor (algunas XML, algunas PDF) lleguen al mismo lote de cuentas por pagar.
Extracción de Columnas Personalizadas — el enfoque de ImageToTable.ai de extraer datos por significado de campo en lugar de por coordenadas de plantilla — maneja ambas fuentes en una sola carga por lotes. Usted define los nombres de sus columnas una vez: "Chave de Acesso", "CNPJ del Proveedor", "Nombre del Proveedor", "Número de NF-e", "Serie", "Fecha de Emisión", "CFOP", "NCM", "Descripción del Ítem de Línea", "Cantidad", "Precio Unitario", "Total de Línea", "Base ICMS", "Tasa ICMS", "Monto ICMS", "Monto IPI", "Monto PIS", "Monto COFINS", "Valor Total de NF-e". La IA lee datos estructurados de archivos XML donde los campos son legibles por máquina, y extrae los mismos campos de PDFs DANFE escaneados al comprender qué significa cada etiqueta visualmente — independientemente del diseño. Ambas fuentes se fusionan en la misma hoja de cálculo, con las mismas columnas, en un solo lote.
La ventaja práctica no es solo la velocidad — es la consistencia. La columna de chave de acesso de los archivos XML se extrae directamente del elemento <chNFe>. La misma columna de un escaneo DANFE se lee del área de código de barras de 44 dígitos en la esquina superior derecha del documento impreso. Ambas entradas llegan a la misma columna, lo que permite la misma lógica de deduplicación descrita anteriormente. Sin un flujo de trabajo unificado por lotes, la chave de acesso del lote XML y la chave de acesso del lote DANFE escaneado viven en hojas de cálculo separadas — y la detección de duplicados entre ellas es manual.
La Transición de la Reforma Fiscal 2026–2033 — Cumplimiento Dual en un Solo Lote
La reforma fiscal al consumo de Brasil — promulgada mediante la enmienda constitucional 132 de diciembre de 2023 y regulada por la ley complementaria 214 de enero de 2025 — está reestructurando todo el sistema de impuestos indirectos del país durante una transición de ocho años. Para 2033, cinco impuestos legados (PIS, COFINS, IPI, ICMS e ISS) serán reemplazados por un sistema dual de IVA: el CBS federal (Contribuição sobre Bens e Serviços) y el IBS estatal-municipal (Imposto sobre Bens e Serviços), además de un Impuesto Selectivo (IS) sobre bienes dañinos para la salud y el medio ambiente. La transición comenzó el 1 de enero de 2026.
Para los equipos de AP que procesan lotes de NF-e brasileños, la preocupación operativa inmediata es el cumplimiento dual en el esquema XML. Durante los años de transición, los XML de NF-e contendrán tanto campos de impuestos legados (ICMS, IPI, PIS, COFINS) como nuevos campos de impuestos (CBS, IBS) simultáneamente — lo que significa que el ya complejo XML de NF-e con más de 500 campos está a punto de volverse más grande. Aquí está el cronograma que afecta el diseño de extracción por lotes:
| Año | Estado de los impuestos anteriores | Estado de los nuevos impuestos | Impacto en la extracción por lotes |
|---|---|---|---|
| 2026 | ICMS, PIS, COFINS, IPI totalmente activos | CBS 0,9% + IBS 0,1% tasas de prueba (deducibles de PIS/COFINS, sin carga adicional neta) | El esquema XML de NF-e ahora incluye campos de CBS/IBS junto con los campos anteriores. La extracción debe analizar ambos — incluso si las tasas de prueba no cambian la obligación tributaria neta. |
| 2027 | PIS, COFINS eliminados. ICMS, IPI permanecen. | CBS plenamente aplicado a tasas completas | El XML de NF-e elimina los grupos de PIS/COFINS, conserva ICMS/IPI y añade CBS. Las definiciones de columnas cambian a mitad de año para algunos proveedores. |
| 2029–2032 | Las tasas de ICMS caen un 10%/año (90% en 2029 → 60% en 2032). ISS e IPI se eliminan gradualmente. | Las tasas de IBS aumentan proporcionalmente (10% en 2029 → 40% en 2032) | Los valores de la columna de tasa de ICMS disminuyen año tras año. Los valores de la columna de IBS aumentan. Las comparaciones entre años requieren etiquetado por año de tasa. |
| 2033 | ICMS, ISS, IPI eliminados | CBS + IBS totalmente operativos | El XML de NF-e contiene solo grupos de impuestos CBS + IBS. Ruptura limpia — pero los datos históricos para auditorías conservan la estructura anterior. |
La implicación práctica para la extracción por lotes en 2026: si está creando definiciones de columnas ahora, incluya columnas de CBS e IBS junto con sus columnas de ICMS y PIS/COFINS — incluso a las tasas de prueba. Los datos están en el XML hoy. Extraerlos no cuesta nada. Tenerlos en su hoja de cálculo cuando la transición se acelere en 2027 significa que sus datos históricos por lotes ya contienen la base para la generación de informes basados en CBS, sin necesidad de reextracción retroactiva de XML de NF-e archivados de 2026.
Un sistema de extracción por lotes que lea los nombres de los campos semánticamente — "Base ICMS", "Tasa ICMS", "Base CBS", "Tasa CBS", etc. — maneja esta transición sin reconfiguración por proveedor. Las definiciones de columnas permanecen iguales; la IA encuentra los campos de impuestos presentes en la versión actual del esquema XML. A medida que las actualizaciones de Nota Técnica añadan nuevos campos y eliminen los antiguos durante los próximos siete años, la lógica de extracción se adapta al XML que llega — no a una plantilla que deba reconstruirse cada vez que SEFAZ publique una nueva versión del diseño.
Un flujo de procesamiento por lotes de NF-e que sobrevive al cierre de mes
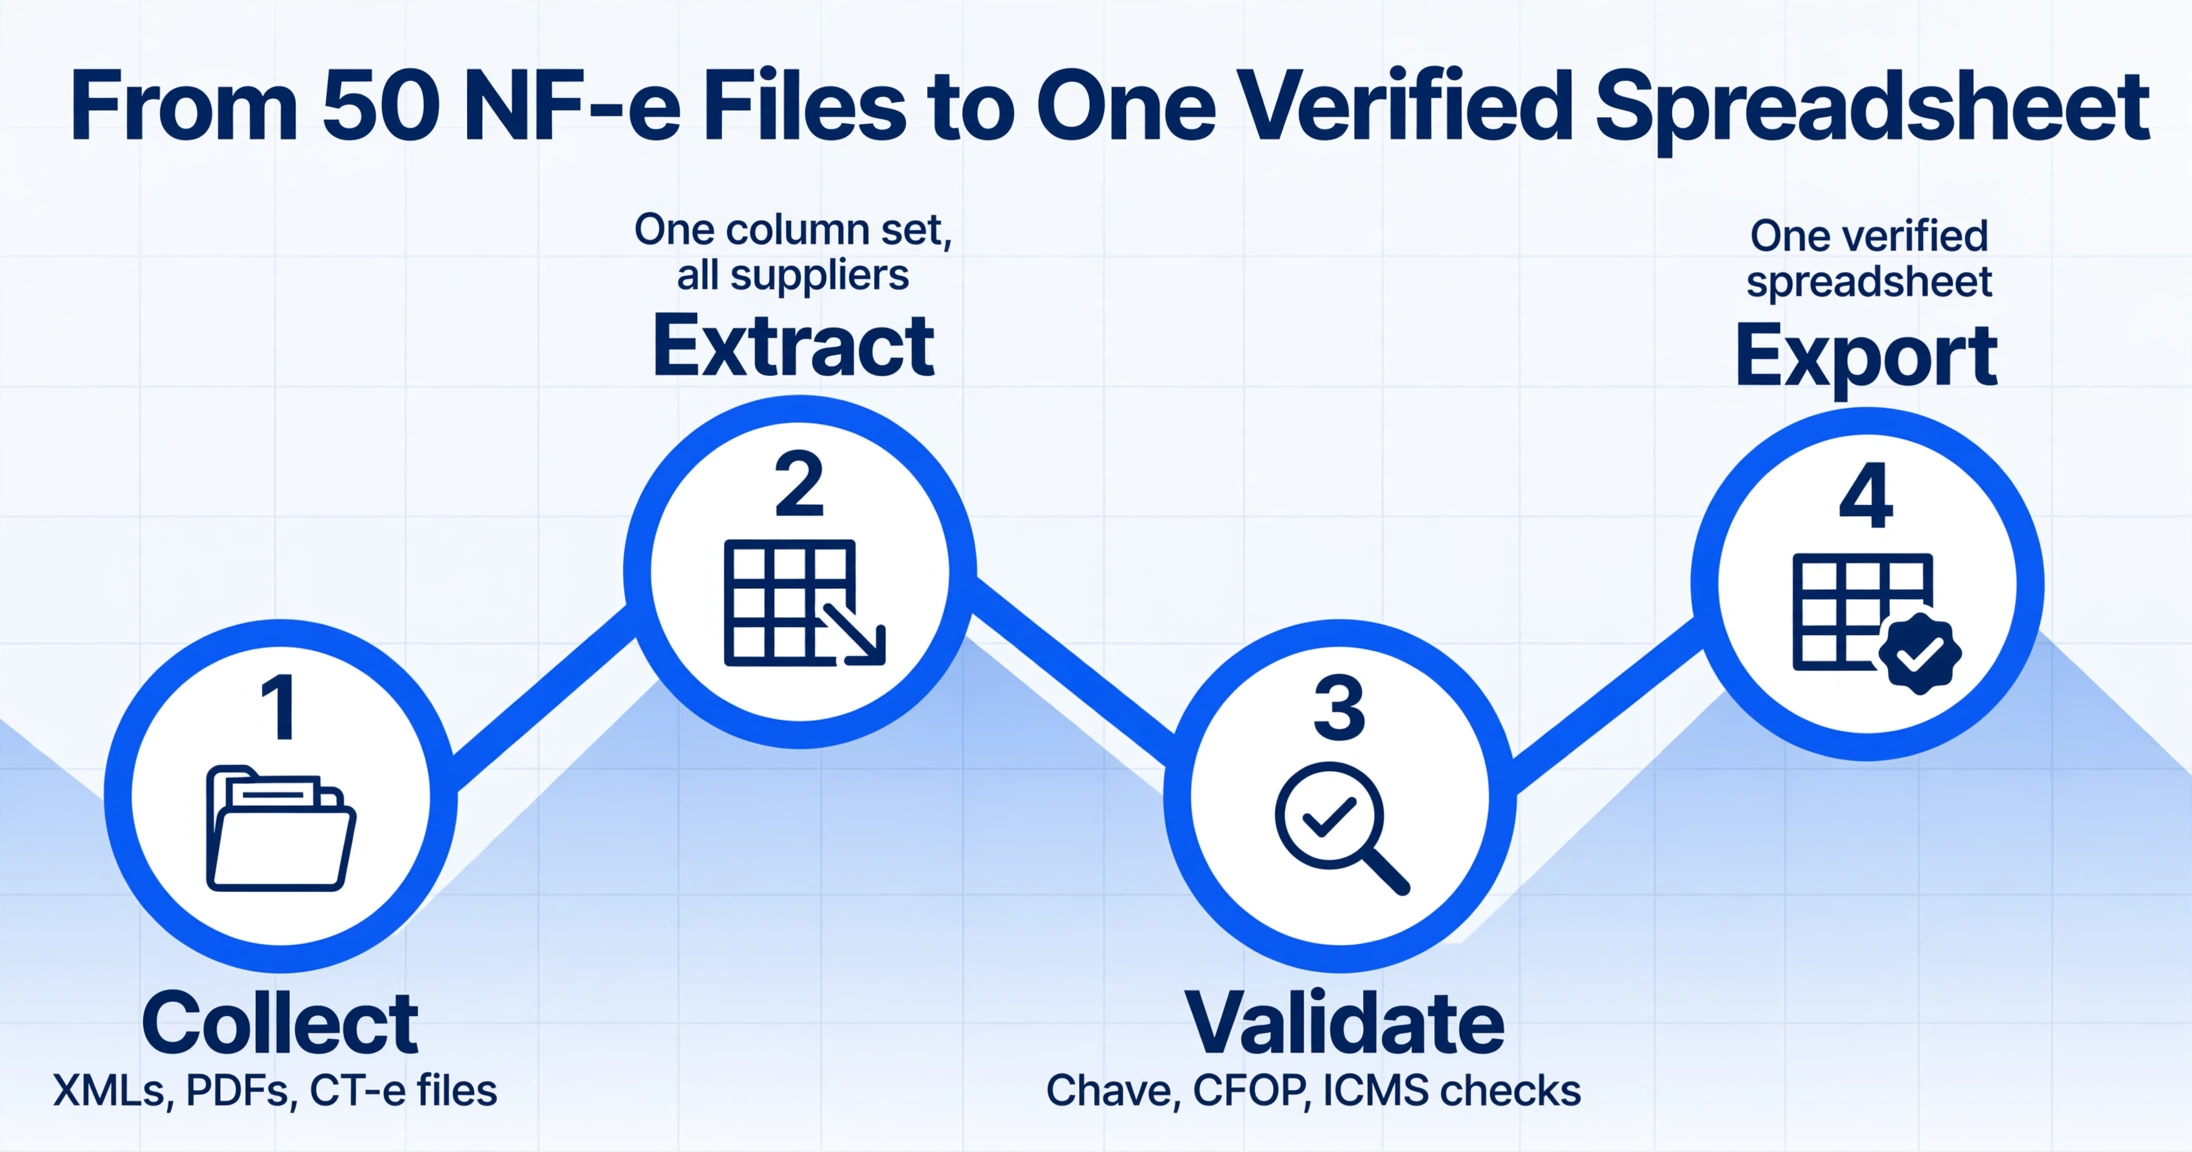
Con los problemas estructurales mapeados, esta es una secuencia de procesamiento por lotes diseñada para la realidad de las cuentas por pagar brasileñas con múltiples proveedores y múltiples estados:
- 1Recopile y normalice los archivos de origen. Reúna todos los XML de NF-e, los PDF de DANFE y los documentos de transporte CT-e para el período del lote (generalmente mensual). Renombre los archivos con una convención coherente —
{CNPJ}_{NúmeroNF-e}_{Serie}_{FechaEmisión}.xml— para que la trazabilidad del origen esté integrada en el nombre del archivo. No descarte los nombres de archivo originales; agréguelos como metadatos. - 2Defina las columnas de extracción una vez, para todos los proveedores. Configure nombres de columna que cubran todos los datos de NF-e que necesite: identificadores de proveedor (CNPJ, Razão Social, Inscrição Estadual), identificadores de documento (Chave de Acesso, Número, Série, Data de Emissão), partidas (NCM, CFOP, Descrição, Quantidade, Precio Unitario, Total de la Línea) e impuestos (Base ICMS, Alícuota ICMS, Valor ICMS, Valor IPI, Base PIS, Valor PIS, Base COFINS, Valor COFINS, Valor Total de la NF-e). Incluya columnas de CBS e IBS para la transición de 2026. Estos nombres de columna funcionan en todos los proveedores porque la extracción lee el significado del campo, no su posición — el mismo enfoque que se usa cuando extrae datos de facturas por lotes a Excel en formatos mixtos de proveedores.
- 3Cargue todo el lote en una sola sesión. Arrastre los 50 archivos — XML, PDF, escaneos — al área de carga. El sistema los procesa juntos y fusiona la salida en una sola hoja de cálculo. Cada fila se etiqueta con su nombre de archivo de origen para la trazabilidad.
- 4Ejecute las tres validaciones específicas del lote. (a) Verificación de unicidad de la Chave de acesso — sin duplicados. (b) Primer dígito del CFOP frente al par de estados — marque las discrepancias donde el CFOP intraestatal (1xxx) aparezca en transacciones interestatales. (c) Razonabilidad de la tasa de ICMS — compare las tasas extraídas con las tasas estatales esperadas. Un ICMS del 20,5% en un proveedor en São Paulo (18% intraestatal, 7–12% interestatal) es un proveedor de Pernambuco mal clasificado o un error de datos. Marque para revisión.
- 5Separe por tratamiento fiscal para el registro en ERP. Use las columnas extraídas de Tasa de ICMS y Estado de Origen para agrupar filas en lotes de contabilización: entradas intraestatales (tasa = 17–22%), entradas interestatales al 12%, entradas interestatales al 7% y entradas al 4% (bienes importados). Cada grupo se contabiliza en diferentes cuentas fiscales en su ERP. La misma lógica de agrupación se aplica a las columnas de IPI, PIS y COFINS.
Este flujo de trabajo asume que su herramienta de extracción por lotes puede manejar documentos XML y visuales en la misma sesión de carga — porque la AP brasileña rara vez recibe un solo formato de manera exclusiva. Si su proceso actual requiere un flujo de trabajo separado para el análisis de XML y otro para el OCR de PDF, el paso de fusión en el paso 5 duplica su tiempo de procesamiento e introduce el riesgo de asignaciones de columnas inconsistentes entre los dos pipelines.
Preguntas Frecuentes
¿Puede el procesamiento por lotes manejar XML de NF-e y PDF de DANFE en la misma carga?
Sí — si la herramienta de extracción lee la semántica en lugar de depender únicamente del análisis de XML. La extracción semántica lee las etiquetas estructuradas del XML de NF-e para los datos que existen en ambos formatos (CNPJ, número de NF-e, totales, montos de impuestos) y lee visualmente el DANFE para los casos en que solo se dispone del documento impreso. La salida se fusiona en una sola hoja de cálculo con columnas consistentes. Si su herramienta solo analiza XML o solo hace OCR, necesitará dos flujos de trabajo separados y un paso de fusión manual.
¿Qué sucede cuando dos XML de NF-e tienen el mismo número de factura pero diferentes chaves de acesso?
Este es un escenario legítimo — típicamente una NF-e corregida reemitida después de un evento CCe, o dos documentos NF-e de diferentes series con el mismo número secuencial. La chave de acesso es única en ambos casos. Su validación por lotes debe agrupar por chave de acesso (no por número de factura) para la deduplicación, y preservar la relación entre número de factura, serie y chave para fines de auditoría. Si el mismo CNPJ + serie + número de factura aparece con dos chaves de acesso diferentes, revise las marcas de tiempo de emisión — la chave posterior reemplaza a la anterior.
¿Cómo manejo ICMS-ST (sustitución tributaria) en un lote?
El ICMS-ST aparece en el XML de NF-e como un grupo de impuestos separado (<ICMSTot> en el bloque de totales) con su propia base, tasa y monto. Debe extraerse en columnas separadas ("Base ICMS-ST", "Monto ICMS-ST") — no fusionarse con el ICMS regular. El ICMS-ST representa impuestos ya pagados aguas arriba por un contribuyente sustituto, y su ERP lo trata de manera diferente al ICMS regular para fines de crédito. Mezclarlos en una sola columna "ICMS" sobreestimará sus créditos disponibles.
¿Puedo extraer solo elementos de línea específicos de una NF-e en lugar de todos los elementos de línea?
Sí. Al definir sus columnas de extracción, incluya los campos que necesite a nivel de elemento de línea (NCM, CFOP, descripción, cantidad, precio unitario, total de línea e impuestos por línea). La IA extrae cada elemento de línea de cada NF-e que coincida con su definición de columnas. Si solo necesita ciertas columnas — por ejemplo, NCM + cantidad + CFOP, sin precio unitario — deje las columnas no deseadas fuera de su definición. La extracción produce solo lo que usted solicita.
¿La reforma fiscal de 2026 cambia lo que necesito extraer de los XML de NF-e?
En 2026, el esquema XML de NF-e ahora incluye campos de CBS e IBS con tasas de prueba (0,9% y 0,1%, respectivamente) junto con los campos existentes de ICMS, PIS y COFINS. Estas tasas de prueba son totalmente deducibles de PIS/COFINS, por lo que la obligación tributaria neta no cambia. Sin embargo, los campos existen en el XML y deben extraerse ahora — cuando CBS reemplace a PIS/COFINS con tasas completas en 2027, sus definiciones de columnas de extracción por lotes ya estarán en su lugar. El cronograma de la reforma fiscal está codificado en la ley complementaria 214/2025 y en el análisis de 2025 de la OCDE sobre la reforma.
¿Por cuánto tiempo necesito conservar los XML de NF-e y los registros de extracción?
La ley tributaria brasileña exige que los XML de NF-e y los documentos fiscales relacionados se archiven durante un mínimo de cinco años desde el final del ejercicio fiscal en el que ocurrió la transacción. Esto aplica tanto a los XML originales recibidos de los proveedores como a sus registros de extracción. El DANFE no es un sustituto legalmente suficiente del XML durante una auditoría — si solo conservó el DANFE escaneado y descartó el XML, no podrá reconstruir el registro fiscal completo que SEFAZ solicitará. Mejor práctica: archive los XML tal como están y mantenga la hoja de cálculo de extracción como un registro separado y buscable para la conciliación interna.