複数都市のNFS-eを1つのスプレッドシートに:
自治体テンプレート不要のバッチ処理
ブラジルには5,570の自治体があります。そのうち10の自治体にサービス提供者を持つコンサルティング企業は、1つのNFS-e(電子サービス請求書)形式を受け取るわけではありません。10種類の形式を受け取ります — それぞれISS(サービス税)税率は2%から5%と異なり、フィールドレイアウトも異なり、背後にある自治体税務当局も異なります。これらを1件ずつ処理するのは単に遅いだけではありません。バッチレベルのビューでしか見えない照合パターンが隠れてしまいます。この自治体ごとの断片化がなぜ存在し、どのようなコストがかかるかの完全な分析については、ブラジルのNFS-e処理がほとんどの財務チームの想定よりもコストがかかる理由をご覧ください。
重要ポイント
- 各NFS-eを手入力する時間コストは計算できます — しかし本当のコストは、源泉徴収ISSの罰則、税率異常の見逃し、全請求書が1つのテーブルに揃って初めて見えるコンプライアンスのギャップに隠れています。
- 源泉徴収ISSは法的に税納付義務を貴社に移転します。5都市からの30件の請求書を文書単位で処理する場合、少なくとも1つの義務を見逃すことが確実です。
- ImageToTable.aiはすべての自治体のNFS-eを1つのバッチで処理し、ISSの不一致、源泉徴収義務、都市別合計を1つのスプレッドシートに表示します — あなたの仕事は数字を入力することから、検証することに変わります。
NFS-eのバッチ処理が単一書類抽出と異なる問題である理由
単一NFS-e抽出ガイドをお読みになった方なら、中核となる仕組みをご存じでしょう。意味的抽出は、各フィールドの意味を理解してNFS-eを読み取ります。「Prestador」というラベルの隣にある14桁のサービス提供者CNPJ、ISSセクションの下にあるISS課税標準額、市庁が印刷した場所にあるISS税率を特定します。1つの書類、1セットの列定義、1つの出力行。市区町村ごとの差異の問題は、書類レベルで解決されます。
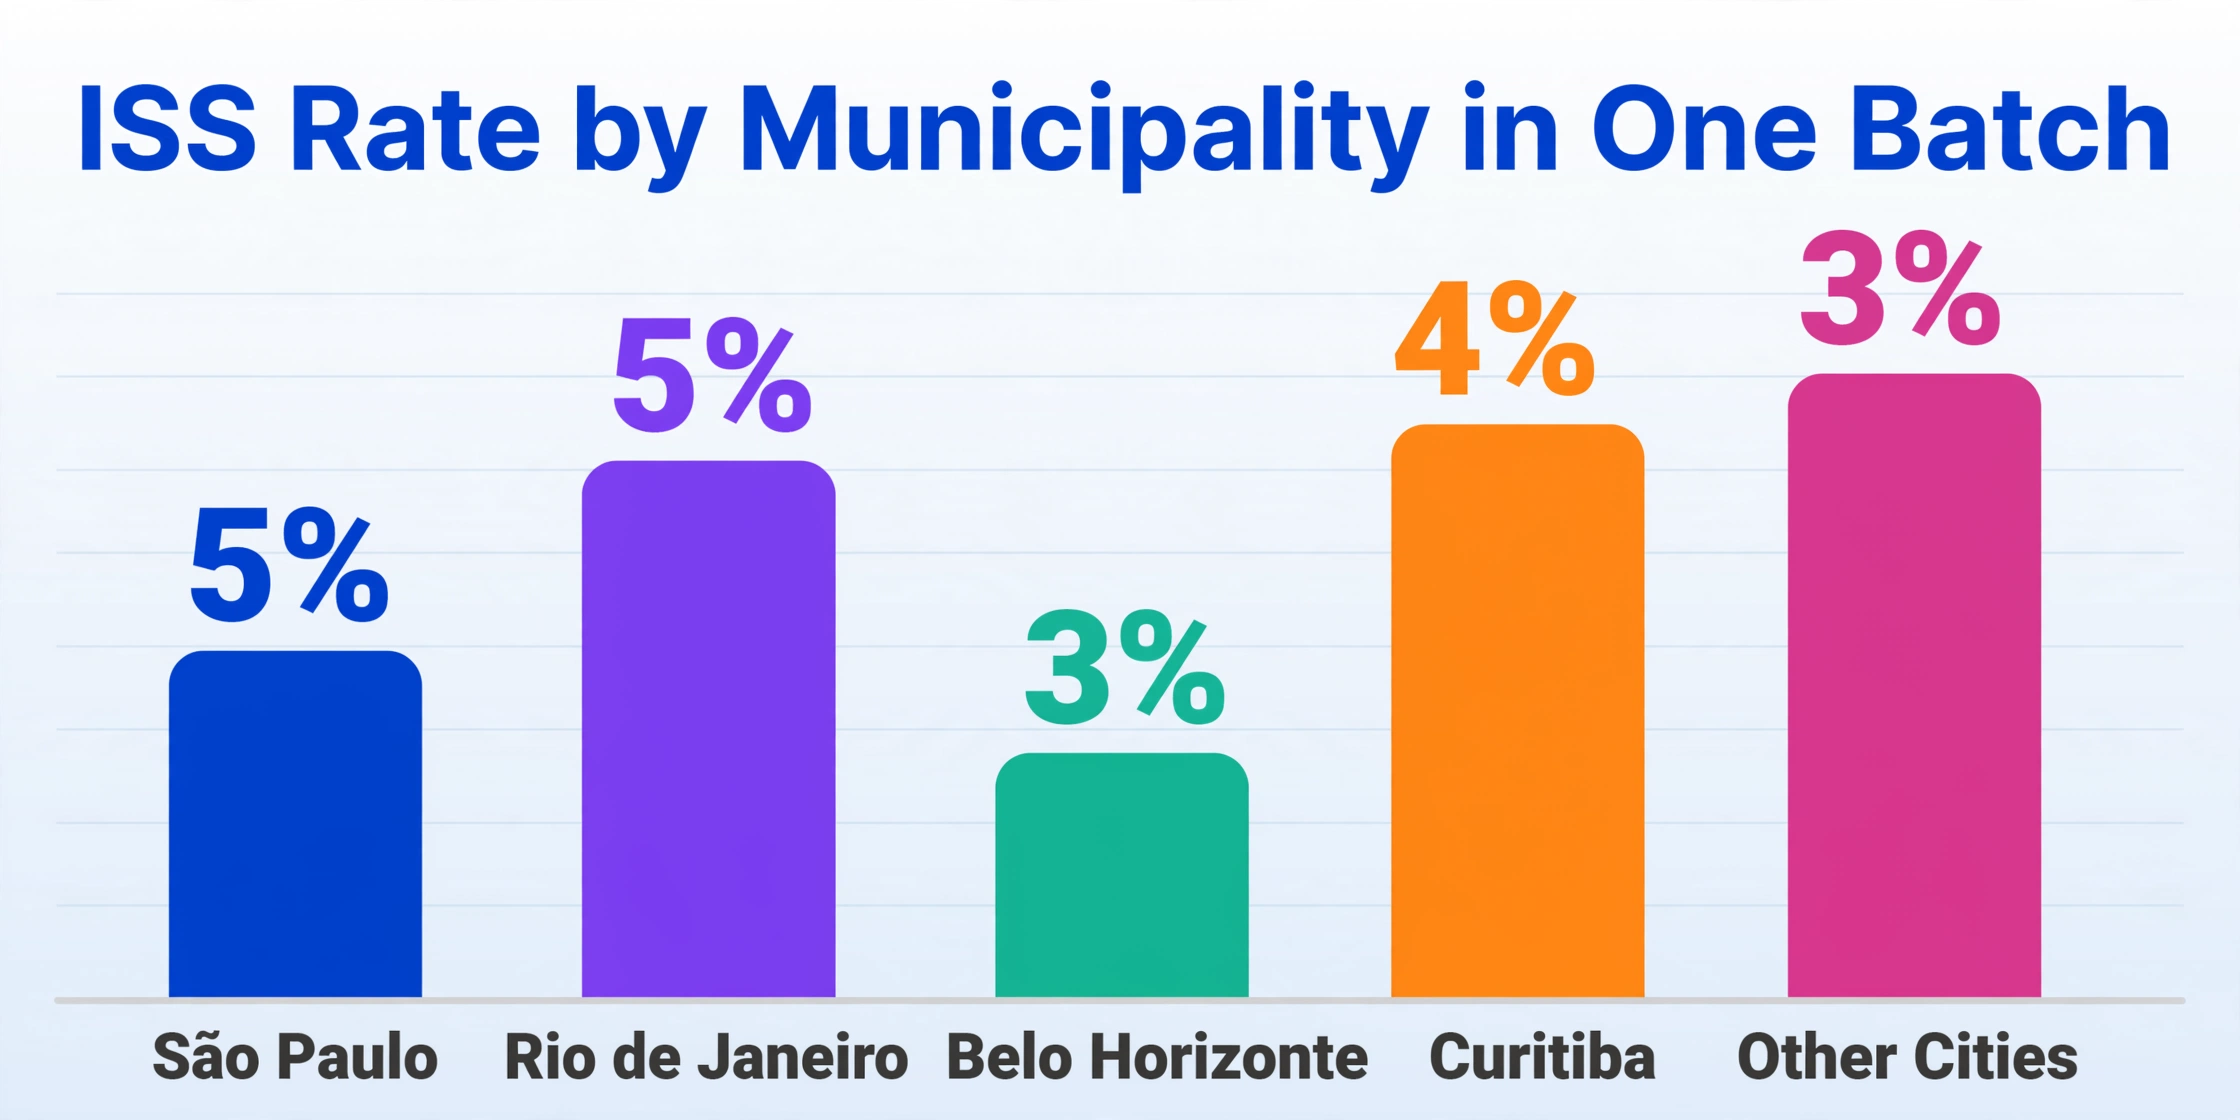
バッチ処理では、単一書類の抽出では表面化しない、別の種類の課題が生じます。サンパウロ(ITコンサルティングでISS 5%)、リオデジャネイロ(同じサービスでISS 5%)、ベロオリゾンテ(ISS 3%)、クリチバ(ISS 4%)、その他6つの都市の提供者からのNFS-e 30件を1つの処理キューに入れると、単一書類では決して起こらない3つのことが発生します。
第一に、都市間のISS税率検証が必要になります。 単一のNFS-eでISS 3%は、単独では問題なく見えます。しかし、同じサービスコード(項目1.01 — システム分析・開発)が、同じバッチ内でサンパウロから5%、リオから5%、ベースホリゾンテから3%で出現しているのを見ると、ベースホリゾンテの税率がすぐに目立ちます。正しいかもしれません — ベースホリゾンテは独自の税率を設定しています。提供者が誤った市区町村税率を適用した可能性もあります。バッチレベルの視点だけが、これを発見する唯一の方法です。
第二に、源泉徴収ISSの追跡がバッチ規模のコンプライアンス業務になります。 NFS-eに「源泉徴収ISS = はい」と記載されている場合、ISSの納付義務はサービス提供者からサービス受領者であるあなたに移ります。各発生は、それぞれの納期限と納付システムを持つ関連市への個別の支払いを必要とします。複数の都市からの10件の書類にわたって、どの請求書がこの義務を発生させるかを手動のチェックリストで追跡することは管理できません。
第三に、データ自体が集計時に価値を持ちます。 提供者別のISS合計、都市別のサービス支出、源泉徴収税と提供者支払い税の比率 — これらはどれも単一書類からは見えません。バッチ全体が1つのスプレッドシートに入ったときにのみ現れます。
これは単一書類ワークフローを高速化することではありません。単一書類ワークフローではまったくできないことを行うことです。
複数市にまたがるNFS-e処理が標準的な請求書バッチと根本的に異なる点
標準的なバッチ請求書処理 — 米国や欧州の50社のサプライヤーからの50枚のPDF — は、主に量の問題です。請求書の見た目は異なりますが、基盤となる税務ロジックは一貫しています。全国一律のVAT、州ごとの売上税、フィールドはおおむね予測可能な位置とラベルにあります。
ブラジルのNFS-eバッチ処理には、標準的な請求書バッチにはない構造的な層が追加されます。ISSは補完法116/2003に基づく市税であり、各市が独自の税制を運営しているため、同じ論理フィールド — 「ISS税率」— がバッチ内のドキュメントごとに異なる値を持つ可能性があり、その値がそのドキュメントの税が正しく計算されたかどうかを決定します。
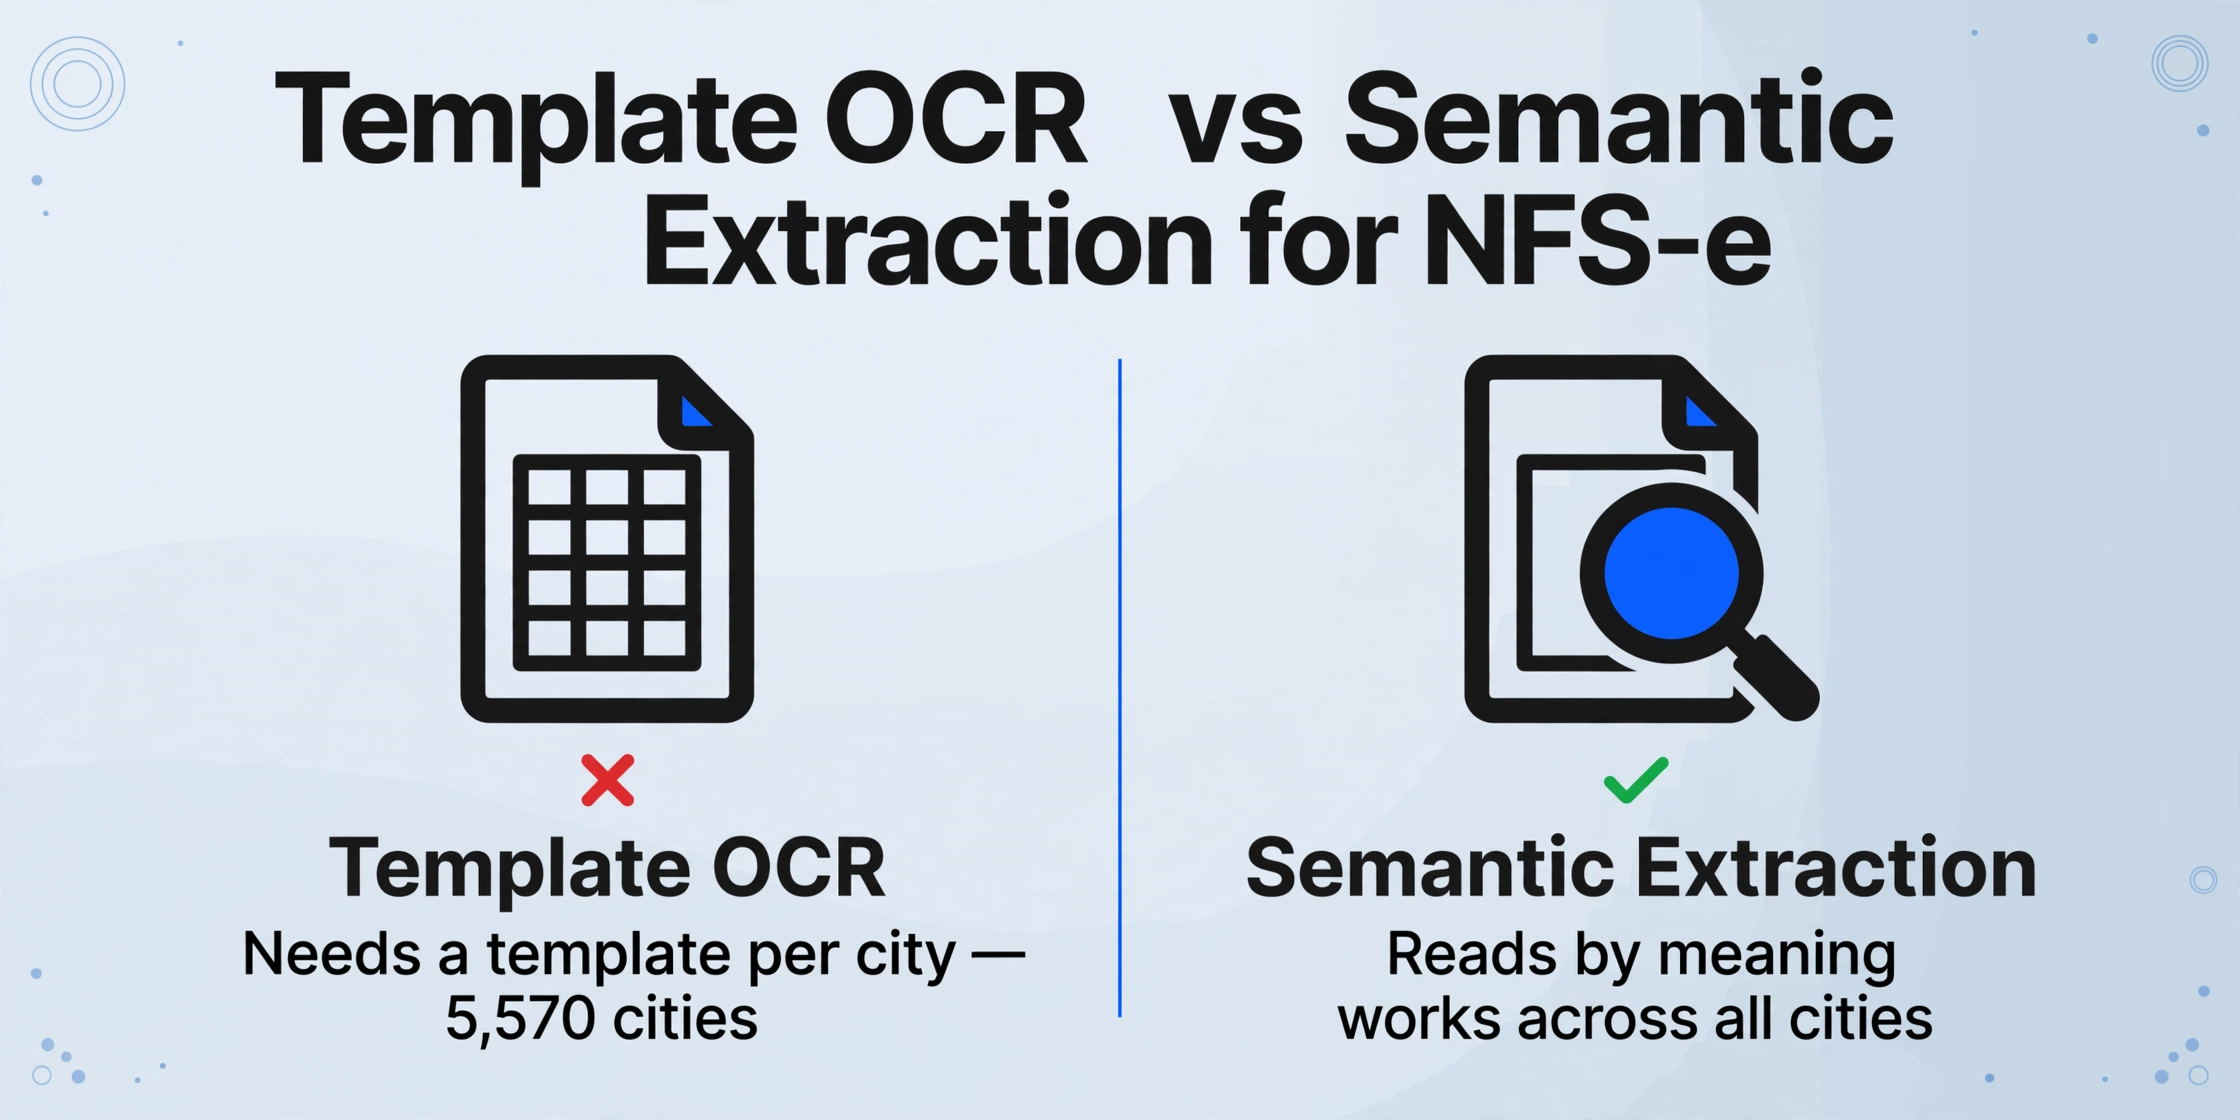
ここで、テンプレートベースの抽出 — ほとんどのドキュメント抽出ツールが使用するアプローチ — が構造的に機能しなくなります。テンプレートは各フィールドの矩形ゾーンを定義します。「サービス提供者CNPJはピクセル位置(x=150、y=320)にあります。」これは1つの市では機能します。次の市では機能しません。プロバイダーが事業を展開する可能性のあるすべての都市のテンプレートライブラリを維持することは、可能な都市の数が5,570あり、レイアウトを積極的に更新している都市の数 — サンパウロは2025年8月にNFS-eマニュアルのバージョン3.2をリリースしました — が絶えず増加している場合、現実的ではありません。
代替案は意味的抽出です。フィールドがページのどこにあるかを定義する代わりに、抽出エンジンに何を探しているかを伝えます — 「Prestadorとラベル付けされた14桁のCNPJ」— そしてエンジンはドキュメントを読み取ってそれを見つけます。エンジンはドキュメントのコンテンツを理解し、座標を理解しないため、位置は重要ではありません。同じバッチ内のサンパウロのNFS-eとポルトアレグレのNFS-eは、AIが意味を探しており、位置を照合していないため、同じ列定義で処理されます。
これがアーキテクチャ上の違いです:テンプレートベースのツールは、テンプレートを追加することでスケールします — 都市ごと、レイアウト改訂ごとに1つ。意味的抽出は、より多くのドキュメントコンテンツを理解することでスケールします。バッチに10番目の都市のNFS-eを追加する場合、コストは実質的にゼロです。10番目の都市のテンプレートを追加する場合、コストはそのテンプレートの構築、テスト、保守 — そして市庁がレイアウトを変更するたびに更新することです。
意味的抽出が個々のNFS-eフィールド — CNPJ照合、LC 116サービスコード分類、ISS税額の内訳 — をどのように処理するかの完全な内訳については、単一NFS-e抽出ガイドを参照してください。バッチワークフローはそのすべてを継承し、マルチドキュメントレイヤーを追加します。
セマンティック抽出が10都市のNFS-eを1バッチで処理する方法
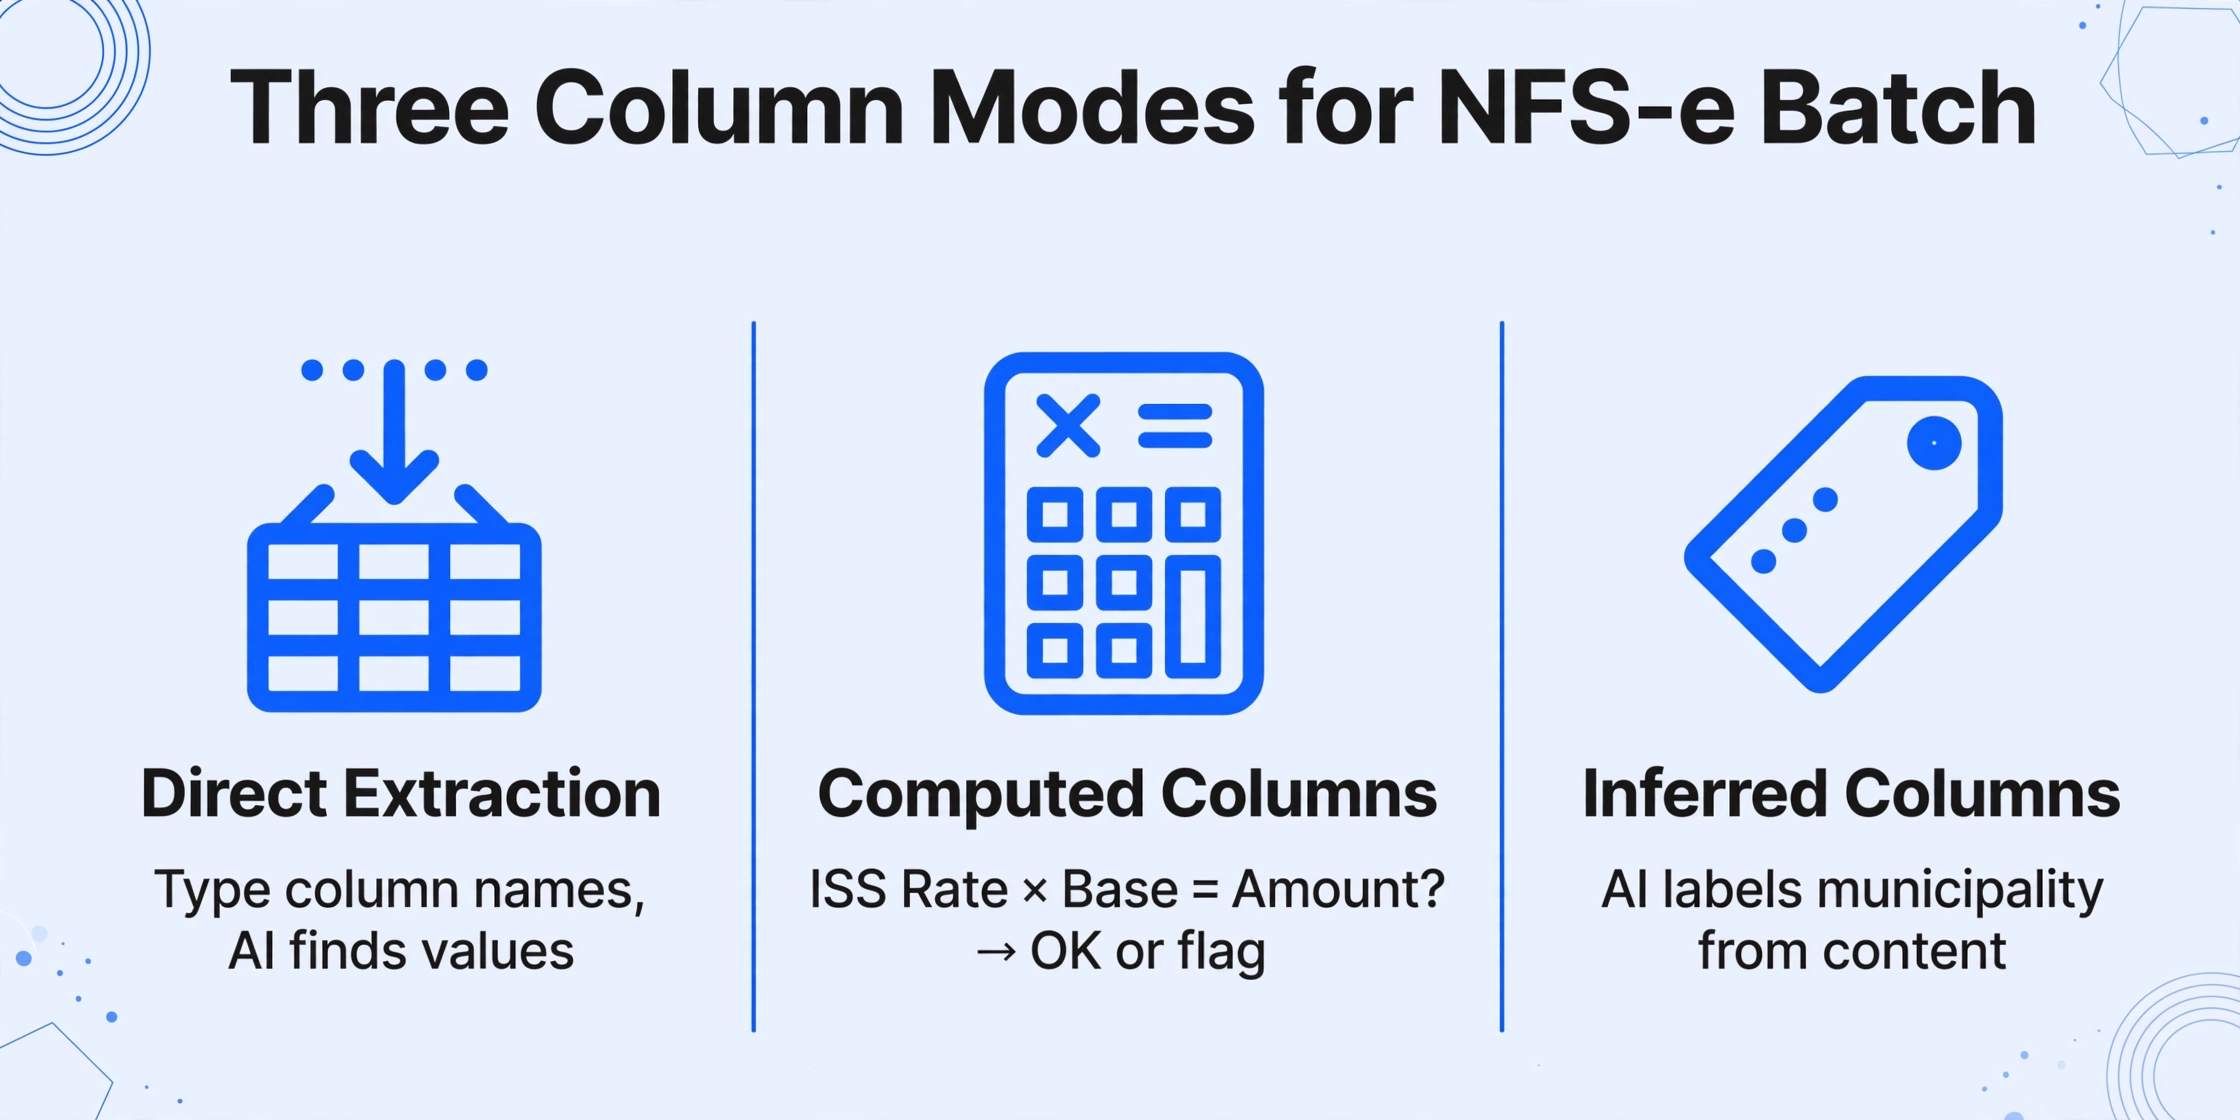
バッチNFS-e処理の抽出ワークフローはカスタム列抽出が中心です。「サービス提供者CNPJ」「サービスコード(LC 116)」「ISS税率」「ISS額」「源泉徴収ISS」「NFS-e番号」など、出力したいフィールド名を入力するだけで、AIが各ドキュメント上の値をラベルの意味を理解して特定します。これらの列名がスプレッドシートのヘッダーになります。一度定義すれば、バッチ内のすべての市区町村で機能します。
しかし、バッチNFS-e処理では直接抽出を超えた利点があります。追加の2つの列モードにより、別のスプレッドシート作業ではなく、抽出時に市区町村間の照合が可能になります。
計算列では、抽出中に実行される検証ロジックを定義できます。NFS-eバッチ処理で最も有用な計算列はISS検証です。「ISS税率 × ISS課税標準額 = ISS額?」計算結果が抽出されたISS額と一致する場合、列は「OK」と出力します。一致しない場合は差異を出力し、バッチレベルでERPにデータをインポートする前に再確認が必要なドキュメントをフラグ付けします。単一ドキュメントではこのチェックに30秒かかります。50ドキュメントの場合、計算列が自動的に実行し、抽出データと同じスプレッドシートで結果を確認できます。
推論列では、AIがドキュメントの内容に基づいて分類またはラベル付けを行います。特定のフィールド参照なしで「市区町村(ドキュメントから抽出)」という列を追加すると、AIがNFS-eから市庁の識別子を読み取り、市区町村名を入力します。これでバッチ出力に並べ替え可能な市区町村列が追加され、市区町村ごとのISS合計や税務報告が、手動のクロスリファレンス作業ではなくピボットテーブルで行えるようになります。
これら3つの列タイプ(直接抽出、計算、推論)は、単一のバッチ実行で連携して動作します。最初に抽出して後で検証する必要はありません。検証は抽出中に行われ、結果は同じスプレッドシートに出力されます。
ステップバイステップ:複数市区町村のNFS-eを1つのスプレッドシートに
複数のブラジル市区町村のNFS-e書類を一括処理し、1つのExcelファイルにまとめる実践的なワークフローです。この設定はバッチごとに1回行うだけで、どの市区町村の書類でも同じ列定義で処理できます。
ファイルは安全に処理され、保存されません。
複数自治体にまたがるISS調整:バッチ処理ならではの視点
バッチNFS-e処理の最も価値ある成果は、節約できた時間ではありません — 1ドキュメントあたり3分から1ページあたり5〜10秒になるのは18倍の改善ですが。最も価値ある成果は、すべてのドキュメントが1つのテーブルにまとまったときだけ存在する調整ビューです。
このビューでできること、単一ドキュメント処理ではできないことをご紹介します:
市区ごとのISS合計
市区町村ごとに出力をグループ化し、ISS額を合計します。得られるのは、各市区町村でのサービス購入に適用されたISSの合計です。このデータが重要な理由は2つあります。1つ目は、特定の市区町村における全サービス提供者のISS合計が、その管轄区域に対する社内コスト配分と一致しているかどうかを確認できることです。2つ目は、これらの請求書のいずれかで源泉徴収義務者である場合、市区ごとの合計が市区町村への税納付記録と照合するために必要な数値です。Dentonsのグローバル税務ガイドは、「両方の市区町村がISSを主張している場合の市区町村間の紛争は非常に一般的である」と指摘しています。バッチレベルのビューは、別の市区町村から問い合わせがあった場合の監査証跡となります。
源泉徴収ISSの追跡
NFS-eに「ISS Retido na Fonte = Sim」(源泉徴収ISS)フラグが付いている場合、ISSをサービス提供者の市区町村に納付する責任があるのはサービス提供者ではなく、あなたの会社です。これはデータ入力上のメモではなく、期限と市区町村ごとに異なる支払いシステムを伴う税務コンプライアンス上の対応項目です。バッチ出力で「源泉徴収ISS」列で並べ替えると、対応が必要なすべての請求書を1つのビューで完全に確認できます。30件の個別PDFを検索してフラグが付いた3件を見つける必要はありません。
ISS源泉徴収に関する法的枠組みは、ブラジルの最高裁判所で審理されてきました。2020年、ブラジル連邦最高裁判所(STF)はRE 1167509で、サービス提供者がその市区町村に登録されていない場合、市区町村はサービス受領者にISS源泉徴収義務を課すことはできないと判決を下しました。これにより、サンパウロのCPOM(他市サービス提供者登録)要件は覆されました。しかし、連邦法で定められた源泉徴収義務(サービス種別と市区町村の組み合わせが正当な源泉徴収を生じさせる場合)は引き続き有効です。どの請求書に正当な源泉徴収義務が付いているかを把握するには、バッチ全体を確認する必要があります。
ISS税率変動の検出
補完法116/2003は、自治体・サービス種別ごとにISS税率を2%〜5%と定めています。しかし自治体は企業誘致のため税率競争を展開しており、UNDPのブラジル税制に関する診断レビューは「ICMSおよびISS税制優遇をめぐる略奪的な競争」に言及しています。サービス提供者が、サンパウロが5%で課税するサービスコードに対して2%の税率を適用する場合があります。それは、提供者が税率を引き下げた自治体に登録しているためです。その税率が妥当かどうかは、貴社の会計チームが判断する税務上の決定事項です。しかし、それを発見するにはバッチ全体を見る必要があります。2%の文書が1件あるだけなら正常に見えます。同じサービスコードで5%の文書が10件、2%が1件あれば、それは調査に値する変動です。
全国NFS-e標準がバッチ処理に意味すること
SNNFS-e(全国NFS-eシステム)は、自治体間でのサービス請求書形式の統一を目指すブラジルの取り組みです。2025年8月時点で1,463の自治体が参加していますが、参加は任意であり、サンパウロなどの大都市は独自システムを維持すると明言しています。その結果はハイブリッドな状況です。一部のサービス提供者は全国XML標準でNFS-eを発行し、他の提供者は市の独自システムで発行しており、どちらになるかを制御することはできません。
バッチ処理の観点から見ると、このハイブリッドな状況は、レイアウト非依存の抽出の価値を強化します。テンプレートベースのツールは、標準化前の都市レイアウトとSNNFS-e標準の両方のテンプレートが必要になり、さらに都市が移行する際の更新パスも必要になります。セマンティック抽出は、どの標準で作成されたかにかかわらず、文書に記載されている内容を読み取ります。全国標準のNFS-eとサンパウロ独自フォーマットのNFS-eが同じバッチに含まれ、同じ列を定義し、同じ出力を生成します。標準化プロセスが変えるのは文書の内容であり、抽出アプローチではありません。
2026年の税制改革(2033年までにISSをIBS(物品サービス税)へ段階的に置き換えるもの)は、さらなる層を追加します。移行期間中、NFS-e文書には従来のISSフィールドと新しいIBS/CBSフィールドの両方が含まれる可能性があります。抽出アプローチは、既存のISS列に加えて「IBS額」「CBS額」という新しい列名を追加することで対応します。テンプレートの再設計は不要です。
貴組織がブラジルの物品請求書も処理している場合、NF-e XML抽出ワークフローはNF-e抽出ガイドで説明しています。列定義が十分に広範であれば、両方の文書タイプが同じバッチに共存できます。ただし、NFS-e固有のフィールド(補完法116コードなど)はNF-e文書では空白になりますが、これは想定どおりであり、エラーにはなりません。
FAQ:NFS-e一括処理
異なる都市の事業者からのNFS-eをまとめて一括処理できますか?
はい — これが主なユースケースです。セマンティック抽出は、各文書の内容を理解して個別に読み取るため、特定の都市のレイアウトに依存しません。サンパウロ(ISS 5%)、ベロオリゾンテ(ISS 3%)、クリチバ(ISS 4%)のNFS-eが同じバッチにあっても、同じ列定義で処理されます。AIは、各文書のページ上の位置に関係なく、CNPJ do Prestador、ISS base de cálculo、その他のフィールドを特定します。
一括出力では「ISS Retido na Fonte」はどのように扱われますか?
「ISS Retido」フィールドは専用の列として抽出されます — 通常は「Sim」または「Não」が入ります。一括出力のスプレッドシートでこの列を並べ替えると、貴社が源泉徴収義務者となるすべての請求書の完全なリストが得られます。そこから、該当する各請求書のISS率×課税標準で納付額を計算し、各市町村の支払いシステムに振り分けます。抽出ツールはデータを提供します。税の納付自体は別のコンプライアンス手順であり、経理チームが各自治体の支払いポータルを通じて行います。
事業者がレイアウトエラーやフィールド欠落のあるNFS-eを発行した場合はどうなりますか?
抽出エンジンは文書にあるものを読み取ります。必須フィールド(例:CNPJ)が欠落しているか判読不能な場合、出力の該当セルは空白になります。これは実際には便利です。一括出力の空白セルは、どの文書について事業者へのフォローアップが必要かを即座に示します。一方、30件の文書を手動で入力すると、他の項目に紛れて1つの空白フィールドを見逃す可能性があります。一括表示により、欠落が可視化されます。
同じバッチにNFS-eと海外サービス請求書を混在できますか?
はい。列定義が「請求書番号」「事業者名」「合計金額」「税額」など両方の文書タイプをカバーしていれば、海外請求書とNFS-eは同じバッチに共存できます。「LC 116サービスコード」や「ISS率」などのNFS-e固有の列は非ブラジル文書では空白になり、「VAT番号」などの海外固有の列はNFS-e文書では空白になります。どちらの動作も想定内であり、エラーは発生しません。
抽出エンジンはNFS-e文書の2026年税制改正項目(IBS/CBS)に対応していますか?
はい — 自治体がNFS-eのレイアウトを更新してIBSまたはCBS項目を含めるようになった場合、バッチ定義に対応する列名(例:「IBS額」「CBS額」)を追加するだけです。抽出エンジンは、既存のISSやCNPJ項目を特定するのと同じ方法で、文書の内容を理解してこれらの新しい項目を特定します。テンプレートの再設定は不要です。2033年までの移行期間中は、ISSとIBSの両方の項目を含むNFS-e文書をバッチで処理できます — 両方の列を定義すれば、各文書に存在する項目が出力に反映されます。
バッチ処理は、各自治体のAPIを直接統合する方法と比べてどうですか?
自治体APIの統合には、サービス提供者が事業を行う各都市ごとに個別の接続を構築・維持する必要があります — それぞれに独自の認証方法、スキーマ、更新スケジュールがあります。SNNFS-e(全国NFS-eシステム)の全国標準は参加自治体にとってこれを簡素化しますが、サンパウロのような主要都市は参加を辞退しています。セマンティックバッチ抽出は、すでに受け取っている文書(PDF、XML、DANFSE印刷物)を処理するもので、自治体システムへのAPIアクセスは不要です。これはNFS-e発行のためのAPI統合の代替手段ではありません。サービス受領者(tomador)として受け取る側のソリューションです。
NFS-e以外のバッチ文書抽出の全体像については、バッチ請求書のExcelへの抽出が文書タイプや通貨を超えてどのように機能するかをご覧ください。
自治体ごとの手入力からバッチごとの照合へ
NFS-eは政府にとっての税収効率化を目的に設計されました — そして実際にその役割を果たしています。受け取るすべてのサービス請求書は、届く前に自治体の税務当局による検証を受けています。CNPJはチェック済みです。ISS税率はサービスコードに対して検証済みです。請求書番号も割り当てられています。そのデータは存在し、正確で、ほとんどの国際的な請求書が経験しない政府の検証ステップを通過しています。
非効率性は完全に受け取り側にあります:都市ごとに異なる文書から検証済みの項目を再入力し、SPED(デジタル税務簿記システム)照合用に正確なスプレッドシートを作成する必要があります。バッチセマンティック抽出は、入力を速くするのではなく、入力をなくすことでこのギャップを埋めます — そしてそれによって、手入力では決して生み出せない自治体横断的なビューを提供します。
次にサンパウロ、リオ、ベロオリゾンテなど複数の都市のサービス提供者からNFS-eの束を受け取ったときは、それらを1つのバッチとして処理してみてください。列を一度定義し、抽出を実行します。その後、自治体ごとに並べ替えてISS合計を確認してください。バッチビューが個々の文書では見えなかった何かを明らかにするかどうかを確認してみてください。
最初の50ページは登録不要です。