ドイツの請求書80件、1つのスプレッドシートへ
手入力なしでRechnungのバッチ処理を行う方法
ドイツのAP(買掛金)処理のボトルネックは、1枚のRechnungからデータを抽出することではありません。まともなOCRツールなら、きれいなPDFから請求書番号と合計金額を簡単に抽出できます。本当のボトルネックは、80件すべてを抽出した後に起こります。地元のElektrikerからのRechnung #12には、同じ行に人件費7%のVATと材料費19%のVATが分かれて記載されています。MetroからのRechnung #37には、フッターに埋もれた4%のSkonto割引が適用されています。そして、ツールが生成した結合スプレッドシートには、どの請求書がどの行に対応するかを示す列がありません。1枚のRechnungの抽出には3分かかります。80件の検証と修正には午後いっぱいかかります。
Rechnungenが80件届いたとき — バッチ処理が「単純に80倍」ではない理由
1件ずつ処理する方法は、限界が来るまでは機能します。多くのドイツ企業にとっての転換点は、月あたり30〜50件のEingangsrechnungenあたりです — 「金曜の午後にできる」と「週末が潰れる」の差が開き始める閾値です。80件になると、問題は1件あたりのデータ入力速度ではありません。単一請求書ワークフローにはバッチ処理が引き継いで増幅する4つの構造的問題があるのです。
フォーマットのばらつき。 請求書を1件ずつ処理してLexwareやsevDeskに手動入力する場合、脳がレイアウトの違いを補正します — Metroの請求書の「Rechnungs-Nr.」とTransgourmetの請求書の「Rechnungsnummer」が同じフィールドだと認識できます。自動バッチ抽出には、何を探すべきかを教え込まない限り、そのような直感はありません — テンプレートの位置ではなく、意味的な意味によってです。8社のサプライヤー、8つのレイアウト、そしてそれらを1つのスプレッドシートに混在させるバッチ出力。
VATの断片化。 ドイツのEingangsrechnungenは一律のVAT税率を使用しません。ホスピタリティサプライヤーからの80件のバッチでは、最大4つのVAT処理が出現します:標準19%(設備、清掃)、軽減7%(食品、書籍)、§13b逆チャージ(下請け建設工事)、§19 Kleinunternehmer(VATなし)。各請求書から数値を取得する単一の「税」列は役に立ちません — 各行でその数値の意味が異なり、Vorsteuerabzugの計算ではタイプ別に分離する必要があるからです。各請求書の§14 UStG必須項目が抽出すべき内容を決定します — しかしバッチ処理は、その抽出を80行すべてで意味的に一貫させておくという層を追加します。
エラーの連鎖。 80件の請求書を手動入力する場合、それぞれが独立した操作です — Rechnung #44のタイプミスが#45のタイプミスに連鎖することはありません。バッチ抽出では、AIが1件の請求書でロゴの配置がずれたためにサプライヤー名を誤認識した場合、出力全体を確認するまで気づきません。また、列マッピングがずれている場合 — たとえば、日付の形式が異なるサプライヤーでLeistungsdatum列がRechnungsdatumを取得した場合 — 気づいた1件だけでなく、すべての行を確認する必要があります。
トレーサビリティの欠如。 80行の結合スプレッドシートは、どの行がどのファイルから来たかを示す必要があります。元の請求書に戻ってUSt-IdNrを確認したり、割引行をチェックしたりする必要がある場合、信頼できるファイル名から行へのマッピングが必要です。ソース文書列なしでCSVを出力するだけのバッチツールでは、監査がDownloadsフォルダーでの宝探しになります。
これらの問題は、3件の請求書を処理する場合には存在しません。80件では、4つすべてが同時に発生します — それらを解決することが、バッチ処理ワークフローと「単一抽出を80回繰り返す」ことを分けるのです。
仕入先フォーマット問題 — 1つのスプレッドシートに8つの異なるレイアウト
Metroの請求書とTransgourmetの請求書は、§14 UStGに基づく法的構造は同じですが、見た目はまったく異なります。MetroはRechnungsnummerを右上のブロックに配置し、Transgourmetはテーブルのヘッダーに配置します。地元のBäckereiは、仕入先住所ブロックに明示的なラベルがない手書きのRechnungを送るかもしれません — 左上隅にあり、通り名で始まるため、それと認識できます。これがドイツ語の請求書に対するテンプレートベースのバッチ抽出に対する中心的な反論です:新しい仕入先ごとに、新しい抽出テンプレートを作成し維持する必要があります。
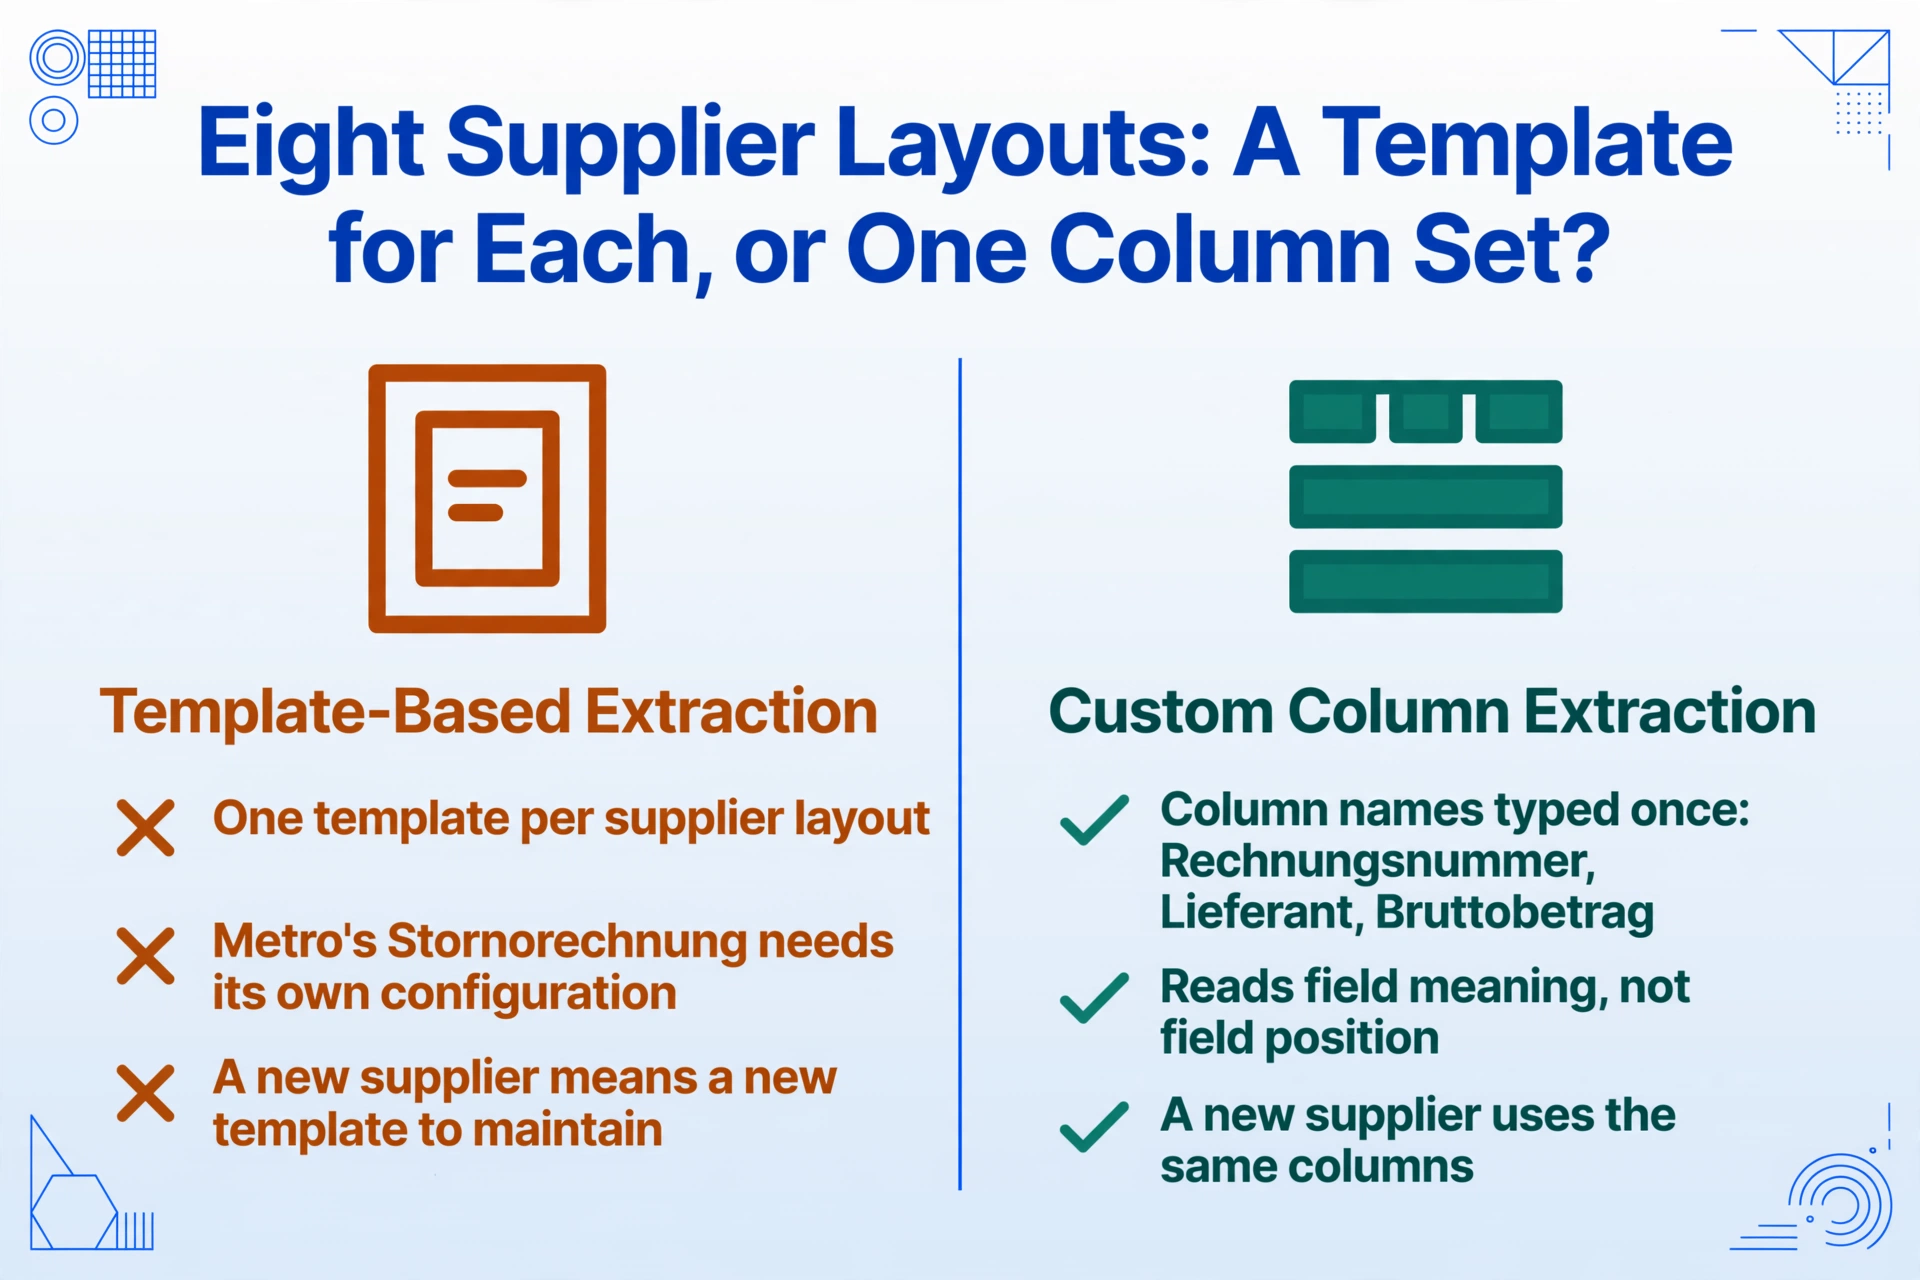
それを具体化すると、中規模のドイツのレストラングループは、Metro(食品卸売)、Transgourmet(飲料)、地元のGemüsehändler(青果)、複数のGetränkelieferanten(飲料販売業者)、清掃サービス、Wartungsfirma(設備保守)、マーケティング代理店からの請求書を受け取る可能性があります — さらに一時的な一括仕入先も含まれます。Metro内のバリエーション(標準請求書、納品書、Stornorechnung)を考慮する前から、8つの異なる請求書フォーマットがあります。これらは同じブランドレイアウトを使用しますが、フィールドを再配置します。テンプレートベースのツールでは、各バリエーションに個別の設定が必要です。セマンティック抽出では、列名を一度定義するだけです。
これが、大規模な場合の列名アプローチとテンプレートアプローチの違いです。カスタム列抽出 — ImageToTable.aiが使用する仕組み — は、座標ではなくフィールドの意味を理解することで機能します。希望する列名を入力します:「Rechnungsnummer」、「Lieferant」、「Rechnungsdatum」、「Leistungsdatum」、「Nettobetrag」、「USt-Satz」、「USt-Betrag」、「Bruttobetrag」、「USt-IdNr」 — AIは、ラベルの意味を理解することで、バッチ内の各請求書の各値を特定します。ラベルがどこに表示されるか、ラベルのテキストが異なるか(「Rechnungs-Nr.」対「Rechnungsnummer」対「RNr.」)に関係なくです。1つの列定義で、1回のバッチアップロードで8つの仕入先レイアウトすべてをカバーできます。
実際的な意味合い:月全体のEingangsrechnungenフォルダ — 全仕入先からの80のPDF、JPG、スキャン文書 — をアップロードし、フォーマットに関係なく各行が同じ列を持つRechnungを表す1つの結合スプレッドシートを取得します。仕入先ごとのテンプレートなし、フォーマットの事前分類なし、「レイアウトが異なるため、この仕入先の請求書は別途アップロードする必要がある」ということもありません。
80件の請求書にまたがるVAT税率の分割 — なぜ1つの「税」列では破綻するのか
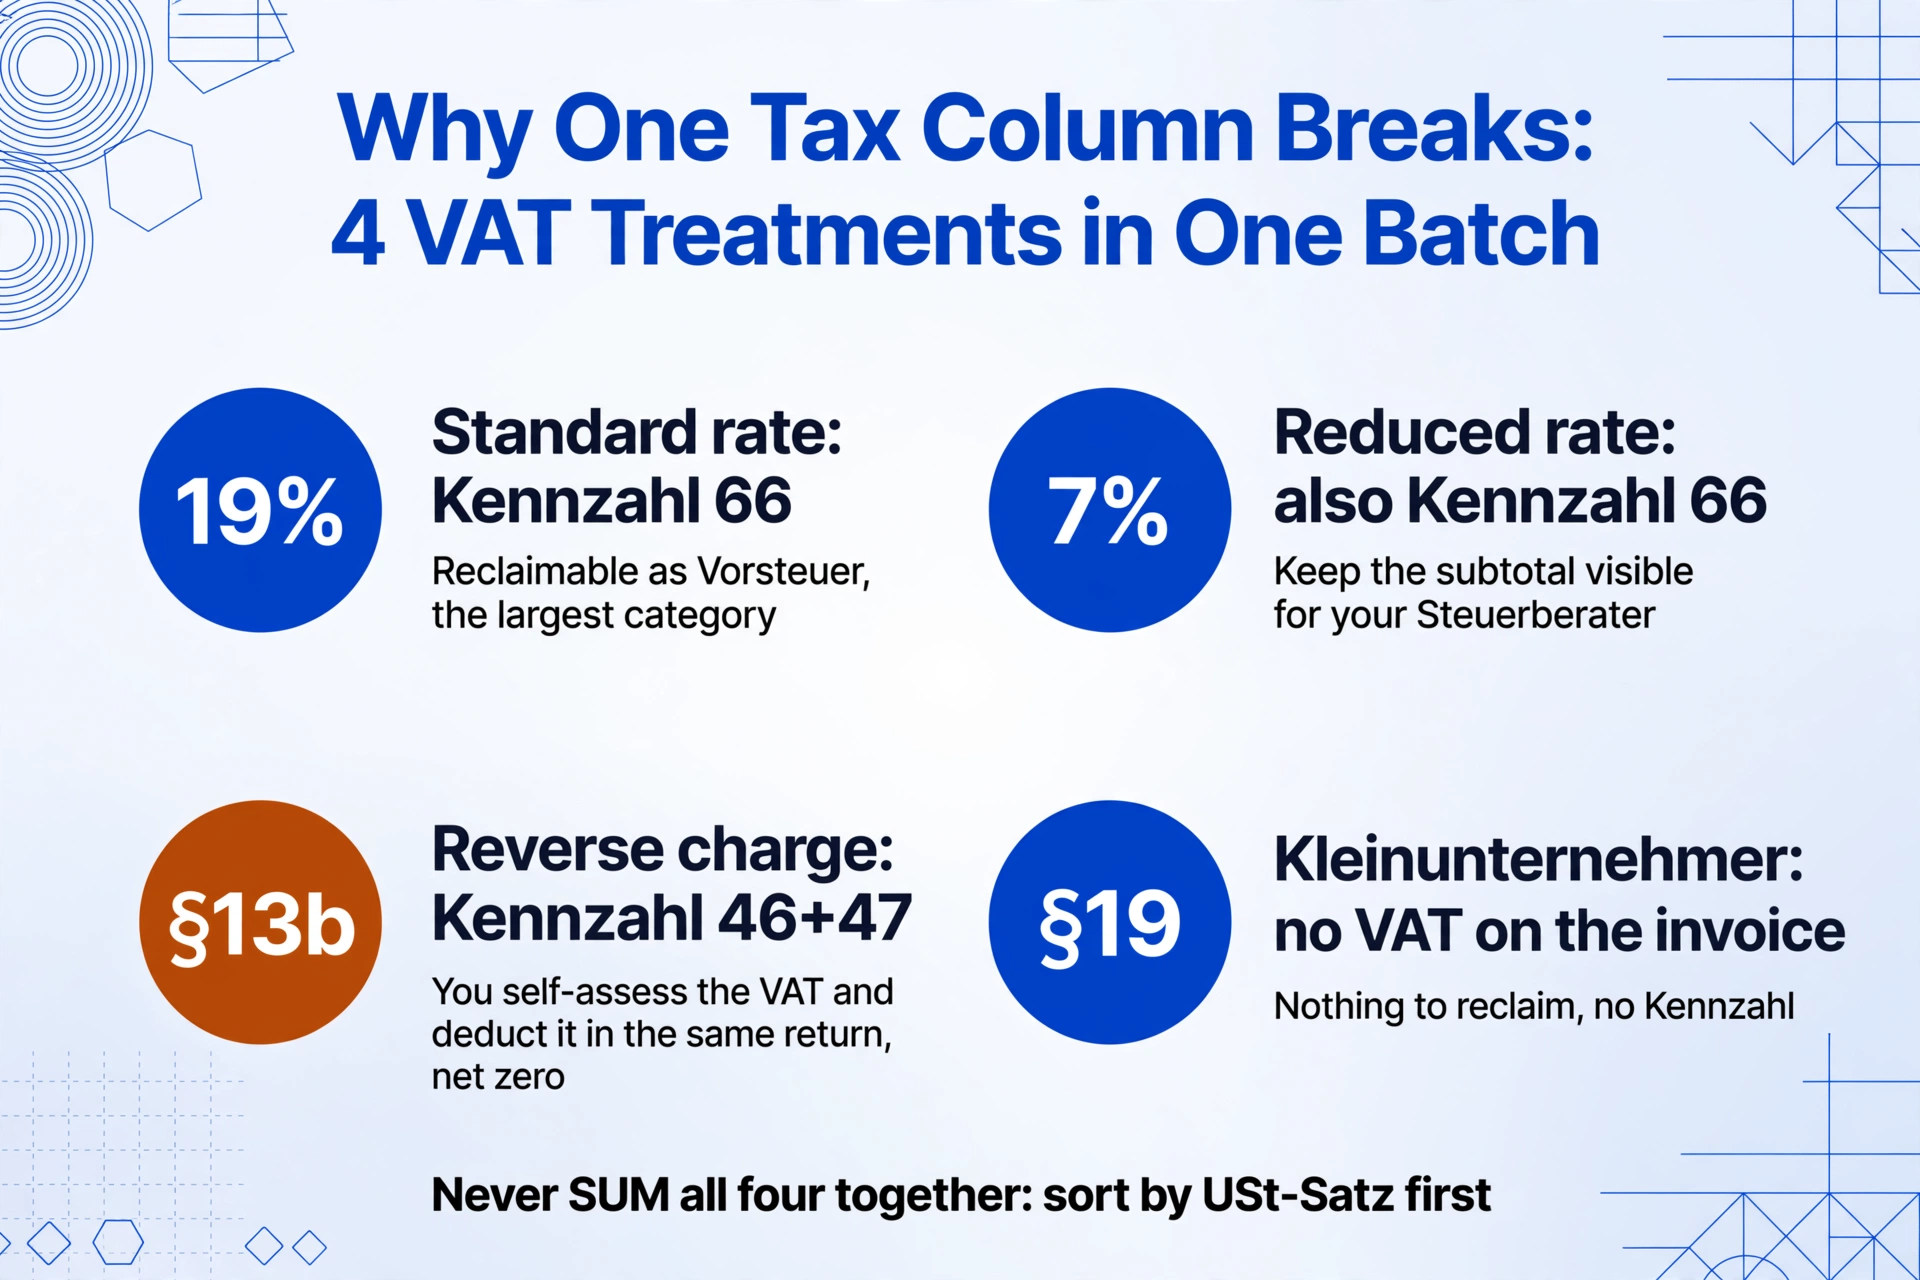
ここで、バッチ抽出が成功したと仮定しましょう。80件すべての請求書が、一貫した列を持つスプレッドシートに格納されています。次の問題は、USt-Satz列に19%、7%、0%(または空白)、「§13b」という4つの異なる値が含まれており、それぞれに異なる会計処理が必要になることです。単純にUSt-Betrag列をSUMすると、§15 UStGに基づきVorsteuerabzugとして還付可能な19%の通常VAT、控除の対象となるもののUmsatzsteuervoranmeldungの66行目などで個別に報告する必要がある7%の軽減VAT、そしてVAT納税義務が受領者に移転する§13bの金額(控除はゼロで、別途報告義務が発生)をすべて合算することになります。
Umsatzsteuervoranmeldung — ドイツの月次または四半期ごとのVAT前払申告で、ELSTERを通じて提出 — では、VAT額を特定の税コード(Kennzahlen)で報告する必要があります:
| VATシナリオ | ELSTER Kennzahl | バッチ処理での意味 | スプレッドシートで必要な対応 |
|---|---|---|---|
| 19%標準税率 | Kennzahl 66 | 還付可能な仕入VAT — ほとんどの事業者にとって最大のカテゴリ | USt-Satz = 19%の行 → SUM(USt-Betrag) → Kz 66へ |
| 7%軽減税率 | Kennzahl 66(サブセット) | こちらも還付可能だが、Steuerberaterが内訳の表示を求める場合がある | USt-Satz = 7%の行 → SUM(USt-Betrag) → 別途小計、引き続きKz 66 |
| §13bリバースチャージ | Kennzahl 46+47 | VATを自己評価し、同じ申告で控除する — 実質ゼロだが申告は必須 | USt-Satz = §13bの行 → Steuerberaterの確認用にフラグを立て、Kz 66には合算しない |
| §19 Kleinunternehmer | 該当なし | 請求書にVATなし = 控除対象なし。有効な事業経費ではある。 | USt-Satz = 空白/0の行 — VAT入力は不要だが、NettobetragはAufwandとして引き続き関連 |
| Kleinbetragsrechnung(§33 UStDV) | Kz 66(VAT込みの場合) | 総額€250未満の請求書 — Pflichtangabenは簡略化されるがVATは適用 | VATが明記されていない場合がある — 必要に応じてBruttoから19/119または7/107で算出 |
バッチ抽出でこれを実践的に扱う方法として、推論列を定義します。これは、ページに明示的に記載された値を抽出するのではなく、AIが請求書の内容に基づいて分類する列です。例えば、VAT Type (options: Standard 19%/Reduced 7%/§13b Reverse Charge/Kleinunternehmer §19)という列名を指定すると、AIが各請求書を読み取り、どのVAT制度が適用されるかを判断し、正しいカテゴリラベルを出力します。これによりフィルタリング可能な列が得られ、そこからVATタイプごとにグループ化し、各グループのUSt-Betragを個別に合計してVorsteuerabzugの申告に使用できます。抽出と分類は1回のパスで行われ、2つの別々の操作ではありません。
これはBuchhaltungの経費側でも重要です。§13bの請求書のNettobetragは、付加価値税がゼロであっても、依然として営業費用(Aufwand)です。「税がない=関係ない」という理由で経費集計から除外すると、経費を過少申告することになります。バッチ抽出では、VAT関連の部分だけでなく、財務全体の全体像を捉える必要があります。
バッチ抽出からSteuerberaterへ — 1回のエクスポートでDATEV対応
80枚の請求書をスプレッドシートに抽出すれば、データ入力の問題は解決します。しかし、そのスプレッドシートを、Steuerberaterが各行を再入力せずにDATEVにインポートできる形に変換するという引き継ぎの問題は、自動的には解決されません。ドイツの税理士はDATEVのKanzlei-RechnungswesenとUnternehmen Onlineプラットフォームを使用しており、これらは2つの主要なバッチメカニズムを通じてデータをインポートします。
CSVインポート(DATEV形式) — Kanzlei-Rechnungswesen用。固定列のCSVで、特定のフィールド順序(Belegdatum、Buchungstext、Gegenkonto、Betrag、Soll/Habenインジケータ、オプションでBuchungsschlüssel(転記キー)とKontierung(SKR03またはSKR04の勘定科目番号))が必要です。ファイルは区切り文字にセミコロン、エンコーディングにISO-8859-1、日付形式にDD.MM.YYYYを使用する必要があります。カンマとMM/DD/YYYYをデフォルトとする英語圏のツールからのCSVエクスポートは、静かに失敗します。
XMLインポート(dxso-Jobs) — DATEV Unternehmen Online用。DATEV独自のXMLスキーマを使用したバッチジョブ送信です。dxso(DATA XML Send Online)メカニズムは、DATEVのXSDスキーマに対して検証されたXMLドキュメントとして構造化された請求書データを受け入れます。Unternehmen OnlineではXMLが必須です。CSVはデスクトップ版のRechnungswesenアプリケーション用です。Steuerberaterはワークフローに応じてどちらか一方または両方を使用する場合があります。
重要なポイント:抽出列は、ターゲットシステムが期待するインポート列を反映させるべきです。SteuerberaterがDD.MM.YYYY形式のBelegdatumを必要とする場合、抽出列は「Invoice Date」ではなく「Belegdatum」として定義します。経費を勘定科目4930(SKR03:その他の費用)に計上する場合は、適切なコードを指定した「SKR03 Konto」という列を含めます。これにより、汎用の抽出結果を会計ソフトウェアのスキーマに合わせて再フォーマットする中間ステップが不要になります。抽出がそのままインポートファイルになるのです。
DATEVに送る80枚の請求書のバッチの場合、列セットは次のようになります:
- Belegdatum — DD.MM.YYYY
- Buchungstext — Lieferant + Rechnungsnummerの組み合わせ
- Gegenkonto — 仕入先のKreditor番号(SKR04では70000番台)
- Betrag — Bruttobetrag(総額)
- Soll/Haben — 借方(経費)は「S」、貸方は「H」
- SKR03 Konto — 経費勘定科目(例:雑費は4930、Warenは3400)
- USt-Satz — 19または7または0
- Vorsteuerbetrag — 還付可能なVAT額
Lexware OfficeとsevDeskは独自のCSVテンプレートを使用していますが、原理は同じです。インポートスキーマに合わせて抽出列を定義し、CSVとしてエクスポートして直接インポートします。バッチ処理の価値提案(80枚の請求書を数分で処理)は、出力結果にさらに1時間のスプレッドシート再整形が必要ない場合にのみ完全に実現されます。
ワークフロー — 80枚のEingangsrechnungenを一括処理する方法
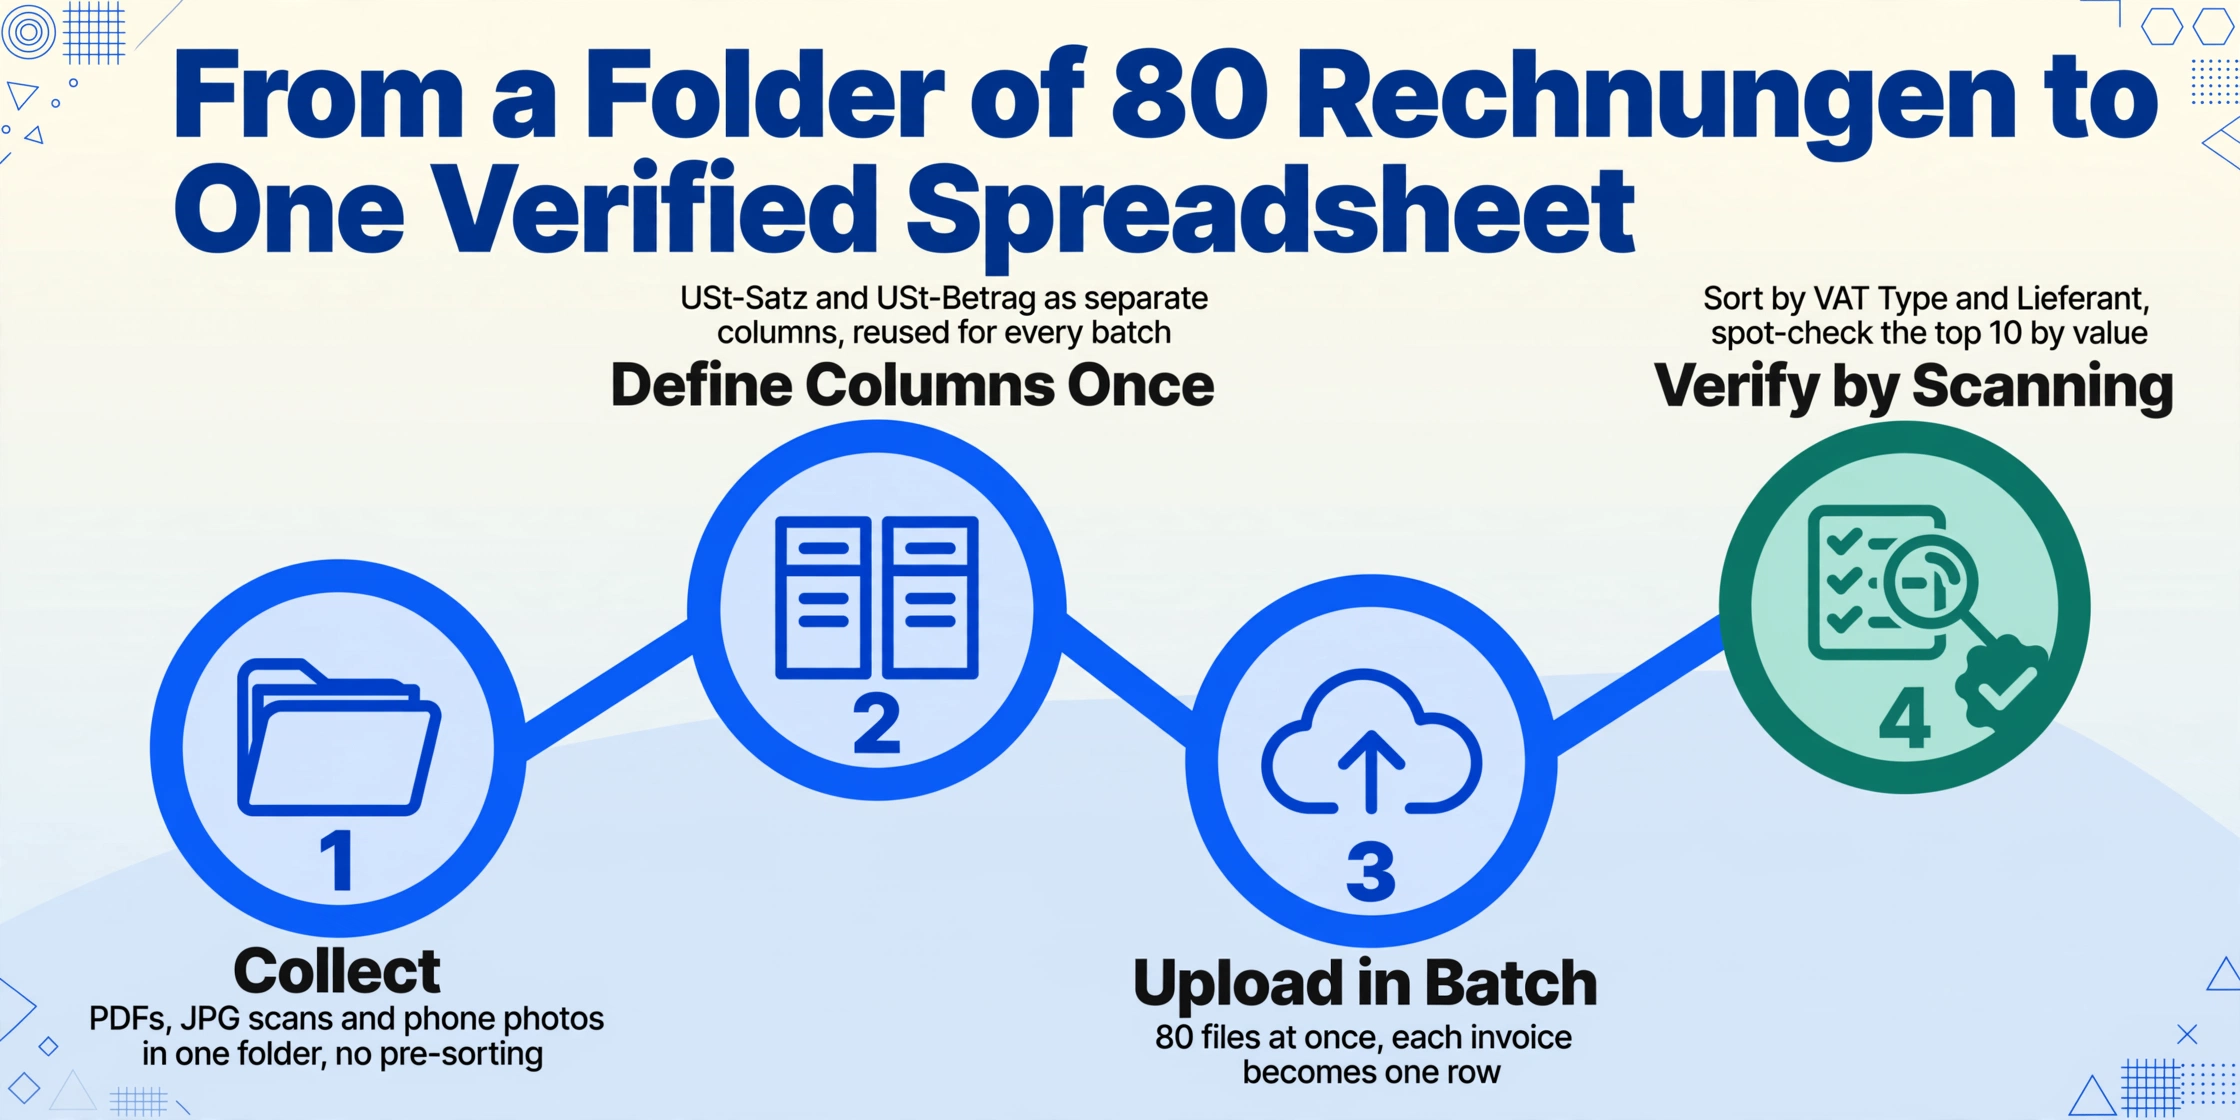
構造上の課題(フォーマットの多様性、VATの断片化、DATEV互換性)を把握した上で、80枚のRechnungenが入ったフォルダからSteuerberater対応のスプレッドシートまでのエンドツーエンドのバッチワークフローをご紹介します:
VAT Type (options: Standard 19%/Reduced 7%/§13b Reverse Charge/Kleinunternehmer §19) を追加して、各請求書を自動分類します。DATEVにエクスポートする場合は、列名をインポートスキーマに合わせます(「Date」ではなく「Belegdatum」、「Total」ではなく「Bruttobetrag」)。この列定義はすべてのバッチで再利用されます — 一度定義するだけで、バッチごとに定義する必要はありません。ファイルは安全に処理され、保存されることはありません。複数のRechnungをアップロードして、バッチ抽出の動作をご確認ください。
特に検証ステップについて:バッチ内で最もリスクが高い項目は、見た目が間違っているものではありません。見た目は正しいのに、サプライヤー固有のフォーマット癖によって特定のフィールドが系統的に誤読されているものです。Metroの請求書でNettobetragの配置が他の79件の請求書と異なる場合、エラーは表示されません。セルには数値が入り、その数値はもっともらしく見えるからです。これを検出するチェックが、Bruttobetrag上位10件のスポットチェックです:元のMetro請求書を開き、brutto合計と抽出されたbrutto合計を比較してください。一致すれば、抽出は正しい可能性が高いです。一致しなければ、調査すべきフォーマット癖があります。
GoBD準拠のバッチアーカイブ — Excelをアーカイブするのではなく、原本をアーカイブする
バッチ処理には魅力的な近道があります。80件の請求書を1つのきれいなスプレッドシートに抽出し、そのスプレッドシートをアーカイブして、散らかった原本を削除する方法です。これは自動化された請求書処理における最も一般的なGoBDコンプライアンス違反であり、監査要件を複数のレベルで満たせません。
GoBD(Grundsätze zur ordnungsmäßigen Führung und Aufbewahrung von Büchern)は、2025年7月に改訂され、ドイツの電子請求書義務化に合わせて、税務関連文書を元の受領形式で保存することを要求しています。派生的または変換された形式ではなく、元の形式です。具体的には:
- 構造化電子請求書(XRechnung XML、ZUGFeRDハイブリッドPDF):XMLが権威ある税務記録です。請求書がZUGFeRD PDFとして届いた場合、PDF/A-3ファイル全体(埋め込まれたXMLを含む)を1つの単位としてアーカイブする必要があります。2025年7月の改正では、XMLに含まれていない追加の税務関連情報(視覚レイヤー上の手書きの支払いメモなど)が含まれていない限り、別の人間が読めるPDFコピーは不要であることが確認されました。
- プレーンPDFおよびスキャン文書:元のファイルは§147 AOに基づき、10年間変更されない形式で保持する必要があります。抽出されたExcel行は作業用コピーであり、アーカイブの代替にはなりません。
- 撮影された紙の請求書:デジタル写真が記録になります。GoBDのUnveränderbarkeit(不変性)の原則は、写真ファイルが後からの変更を防ぐ方法で保存されることを意味します — タイムスタンプ、ハッシュ化、またはリビジョンロックされたシステムに保存する必要があります。
抽出出力 — 80行のExcelスプレッドシート — は運用文書であり、アーカイブ文書ではありません。日常のBuchhaltung、Vorsteuerabzug計算、DATEVインポートに役立ちます。Betriebsprüfung(税務監査)では、監査人は抽出スプレッドシートではなく、元の請求書ファイルを要求します。抽出はそれらの原本へのトレーサビリティを可能にするだけで十分です — つまり、スプレッドシートには各行のソースファイルを識別する列(ファイル名または参照番号)を含める必要があります。このトレーサビリティ列がないと、80件の請求書のバッチ抽出は、ソースに対して検証できない80のデータ行を作成することになり、抽出の正確さに関係なくGoBDコンプライアンス違反になります。
実用的なバッチアーカイブのワークフロー:元のファイルを日付付きフォルダ(例:/Eingangsrechnungen/2026-05/)に保存し、一貫した名前を付け(2026-05-03_Metro_INV-48291.pdf)、抽出出力がファイル名を列として保持することを確認します。SteuerberaterがDATEV Unternehmen Onlineを使用している場合、元の請求書ファイルはBelegverwaltung(文書管理)機能を通じて対応する仕訳エントリに添付でき、スプレッドシートからソース文書、そしてDATEV監査証跡へのトレーサビリティループを閉じることができます。
ドイツの段階的電子請求書義務化 — 2025年1月から受領義務、2027年から売上高€80万超の企業への送信義務、2028年から全面的な送信義務 — により、「散らかった原本」の問題は徐々に減少しています。サプライヤーがZUGFeRDとXRechnungに移行するにつれ、埋め込まれたXMLレイヤーがOCRなしで構造化データを提供します。しかし移行期間中、バッチパイプラインは混合を処理する必要があります:一部のZUGFeRD PDF、一部のプレーンPDF、2028年まで切り替えないサプライヤーからのスキャンされたRechnung。抽出ワークフローは3つすべてを処理し、アーカイブワークフローは3つすべてをそれぞれの元の形式で保存する必要があります。
よくある質問
Metro、Transgourmet、地元のHandwerkerからの請求書を同じバッチで本当に処理できますか?
はい、できます。抽出は列名の意味に基づいて行われるため(AIはフィールドの位置ではなく意味を読み取ります)、同じ列定義(Rechnungsnummer、Lieferant、Bruttobetragなど)が異なるサプライヤーのレイアウトでも機能します。サプライヤーごとに別のテンプレートは必要ありません。唯一の注意点:2つのサプライヤーが同じラベルを異なる意味で使用している場合(例:両方に「Datum」フィールドがあるが、一方は請求日、もう一方は納品日を意味する)、列を正確に定義してください。「Date」のような一般的なものではなく、「Rechnungsdatum」と「Lieferdatum」のように。
19%と7%の品目が混在する請求書のVAT分割はどう処理すればよいですか?
VAT率が混在する請求書の場合は、個別の列ペアを定義してください:「Nettobetrag 19%」、「USt-Betrag 19%」、「Nettobetrag 7%」、「USt-Betrag 7%」。AIは請求書から各税率グループを独立して抽出します。請求書に19%の品目しかない場合、7%の列は空になります(逆も同様)。バッチ出力では、USt-Betrag 19%列とUSt-Betrag 7%列をそれぞれ合計して、Vorsteuerabzugの計算に使用できます。分割が明確でない複雑な請求書(食品(7%)とアルコール(19%)が同じ行に混在するレストラン請求書など)の場合は、計算列を追加して、明細数量と単価から正しい分割を再計算し、請求書に記載されているVAT内訳と照合してください。
バッチ内の1つの請求書にフィールドが欠けている場合、バッチ全体が壊れますか?
いいえ。AIはバッチ内の各請求書を独立して処理します。Rechnung #23にUSt-IdNrフィールドがない場合(€250未満のKleinbetragsrechnungenでは必須ではないため一般的)、そのセルはその行のみ空になります。他のすべての行には影響しません。ワークフローの検証ステップはこれらを検出するように設計されています:必須列で並べ替えて空白を探します。欠落した値を手動で入力するか(以前の請求書からサプライヤーのUSt-IdNrを知っている場合)、正当な場合は空白を受け入れるか(Kleinbetragsrechnung)、完全な請求書の必須フィールドの場合はサプライヤーへのフォローアップとしてフラグを立てることができます。
バッチ抽出からDATEV CSV形式に直接エクスポートできますか?
Excel(XLSX)またはCSVにエクスポートしてから、Steuerberaterが必要とするDATEV CSV形式に列をマッピングできます。バッチ抽出の出力は構造化されたスプレッドシートです。定義した列がExcelの列になります。列名をDATEVインポートフィールド(Belegdatum、Buchungstext、Gegenkonto、Betragなど)に合わせると、エクスポートはすでに正しい構造になっています。列の順序を並べ替え、区切り文字と日付形式がDATEVの正確な仕様(セミコロン、DD.MM.YYYY、ISO-8859-1エンコーディング)に一致することを確認する必要があるかもしれません。このツールはネイティブにDATEV形式のCSVを生成しませんが、抽出されたデータは最小限の再フォーマットで直接マッピングできます。
バッチ処理で、ZUGFeRD XML請求書とスキャンした紙の請求書を同じアップロードに混在させて処理できますか?
はい、バッチにはZUGFeRD PDF、通常のPDF、JPGスキャン、写真を混在させることができます — AIは各文書の視覚レイヤーを読み取ります。ZUGFeRD請求書の場合、表示可能なPDFレンダリングを読み取り、埋め込まれたXMLは解析しません。実際には、ZUGFeRD請求書の抽出精度はXMLの有無ではなく、視覚的なレイアウト品質によって決まります — 通常のPDFと同じです。純粋なXRechnung XMLファイル(視覚的なPDFなし)は、このツールでは処理対象外です — それらにはXMLからCSVへの変換ツールを使用するか、サプライヤーに人間が読めるPDF版も提供してもらうよう依頼してください。
バッチ抽出でSkonto(早期支払割引)をどのように扱いますか?
Skonto — 通常7〜14日以内の支払いで2〜3%の割引 — は専用フィールドではなく注記に記載されることがよくあります(例:「2% Skonto bei Zahlung innerhalb 10 Tagen」)。追跡する必要がある場合は、「Skonto (%)」という列を定義してください — AIは請求書に記載されていればパーセンテージを抽出します。Nettobetragについては、通常はSkonto適用前の全額(Bemessungsgrundlage)を求めます。VATは§10 UStGに基づき全額に対して計算されるため、割引後の金額ではありません。請求書に割引後の合計が記載されている場合は、計算列を使用してSkonto適用前のNettobetragを逆算し、Vorsteuerabzugの目的に使用してください。税務署は割引前の総額に基づいて仕入税額控除を決定するためです。
ドイツ語請求書のバッチ処理ワークフローを開始する
ドイツ語のEingangsrechnungenのバッチ処理は、特定の分岐点に位置しています:請求書の数が「手入力は面倒だが管理可能」から「手入力が構造的な時間の無駄」に変わる地点です。ほとんどのドイツの中小企業では、その境界線は月間40〜60枚の請求書の間にあります。それ以下では、摩擦はワークフローに起因します — DATEVを開く、フィールドに入力する、保存する。それ以上では、摩擦はシステム的なものです:フォーマットの多様性、VATの断片化、そして単一請求書のワークフローでは解決できないトレーサビリティのギャップです。
ここで概説したバッチ処理アプローチ — サプライヤーのフォーマットを問わず機能する列名ベースの抽出、自動VAT分類のための推論列、DATEV準拠のエクスポートスキーマ — は、請求書ごとの速度だけでなく、システム的な問題に対処します。18倍の効率向上(手作業で請求書1枚あたり3分 vs 抽出で5〜10秒)が見出しの数字です。しかし、より大きな運用上の変化はこれです:1ヶ月分のEingangsrechnungenが1つの操作になります。 80回の操作を速く行うのではなく、1回の操作を1度行うのです。その違いは、「データ入力が速くなった」と「データ入力が月次決算の一部でなくなった」の違いです。
複数のRechnungenをアップロード — 無料でお試しいただけます。最初の50ページはアカウント不要です。