NFS-e multi-villes, une feuille de calcul unique :
Traitement par lots sans modèles municipaux
Le Brésil compte 5 570 municipalités. Un cabinet de conseil ayant des prestataires dans 10 d'entre elles ne reçoit pas un seul format de NFS-e (facture électronique de services). Il en reçoit 10 — chacun avec un taux d'ISS (taxe sur les services) différent, entre 2 % et 5 %, une disposition des champs différente et une administration fiscale municipale différente derrière. Traiter ces documents un par un n'est pas seulement lent. Cela masque les modèles de rapprochement que seule une vue au niveau du lot révèle. Pour l'analyse complète des raisons de cette fragmentation municipale et de son coût, voir pourquoi le traitement des NFS-e brésiliennes coûte plus cher que ne le pensent la plupart des équipes financières.
Points clés à retenir
- Vous pouvez calculer le temps passé à saisir manuellement chaque NFS-e — mais le coût réel réside dans les pénalités de retenue d'ISS, les anomalies de taux manquées et les lacunes de conformité qui ne deviennent visibles que lorsque chaque facture figure dans un même tableau.
- L'ISS retenue à la source transfère légalement la charge du versement de la taxe à votre entreprise, et sur 30 factures provenant de 5 villes, une approche document par document garantit qu'au moins une obligation sera manquée.
- ImageToTable.ai traite les NFS-e de chaque municipalité en un seul lot et fait ressortir les écarts d'ISS, les obligations de retenue et les totaux par ville dans une seule feuille de calcul — votre travail passe ainsi de la saisie des chiffres à leur vérification.
Pourquoi le traitement par lots des NFS-e est un problème différent de l'extraction de documents individuels
Si vous avez lu le guide d'extraction de NFS-e individuelle, vous connaissez le mécanisme de base : l'extraction sémantique lit une NFS-e en comprenant la signification de chaque champ — en localisant le CNPJ du prestataire à 14 chiffres à côté du libellé « Prestador », la base de calcul de l'ISS sous la section ISS, le taux de l'ISS où que la municipalité l'ait imprimé. Un document, un ensemble de définitions de colonnes, une ligne de sortie. Le problème de la variation municipale est résolu au niveau du document.
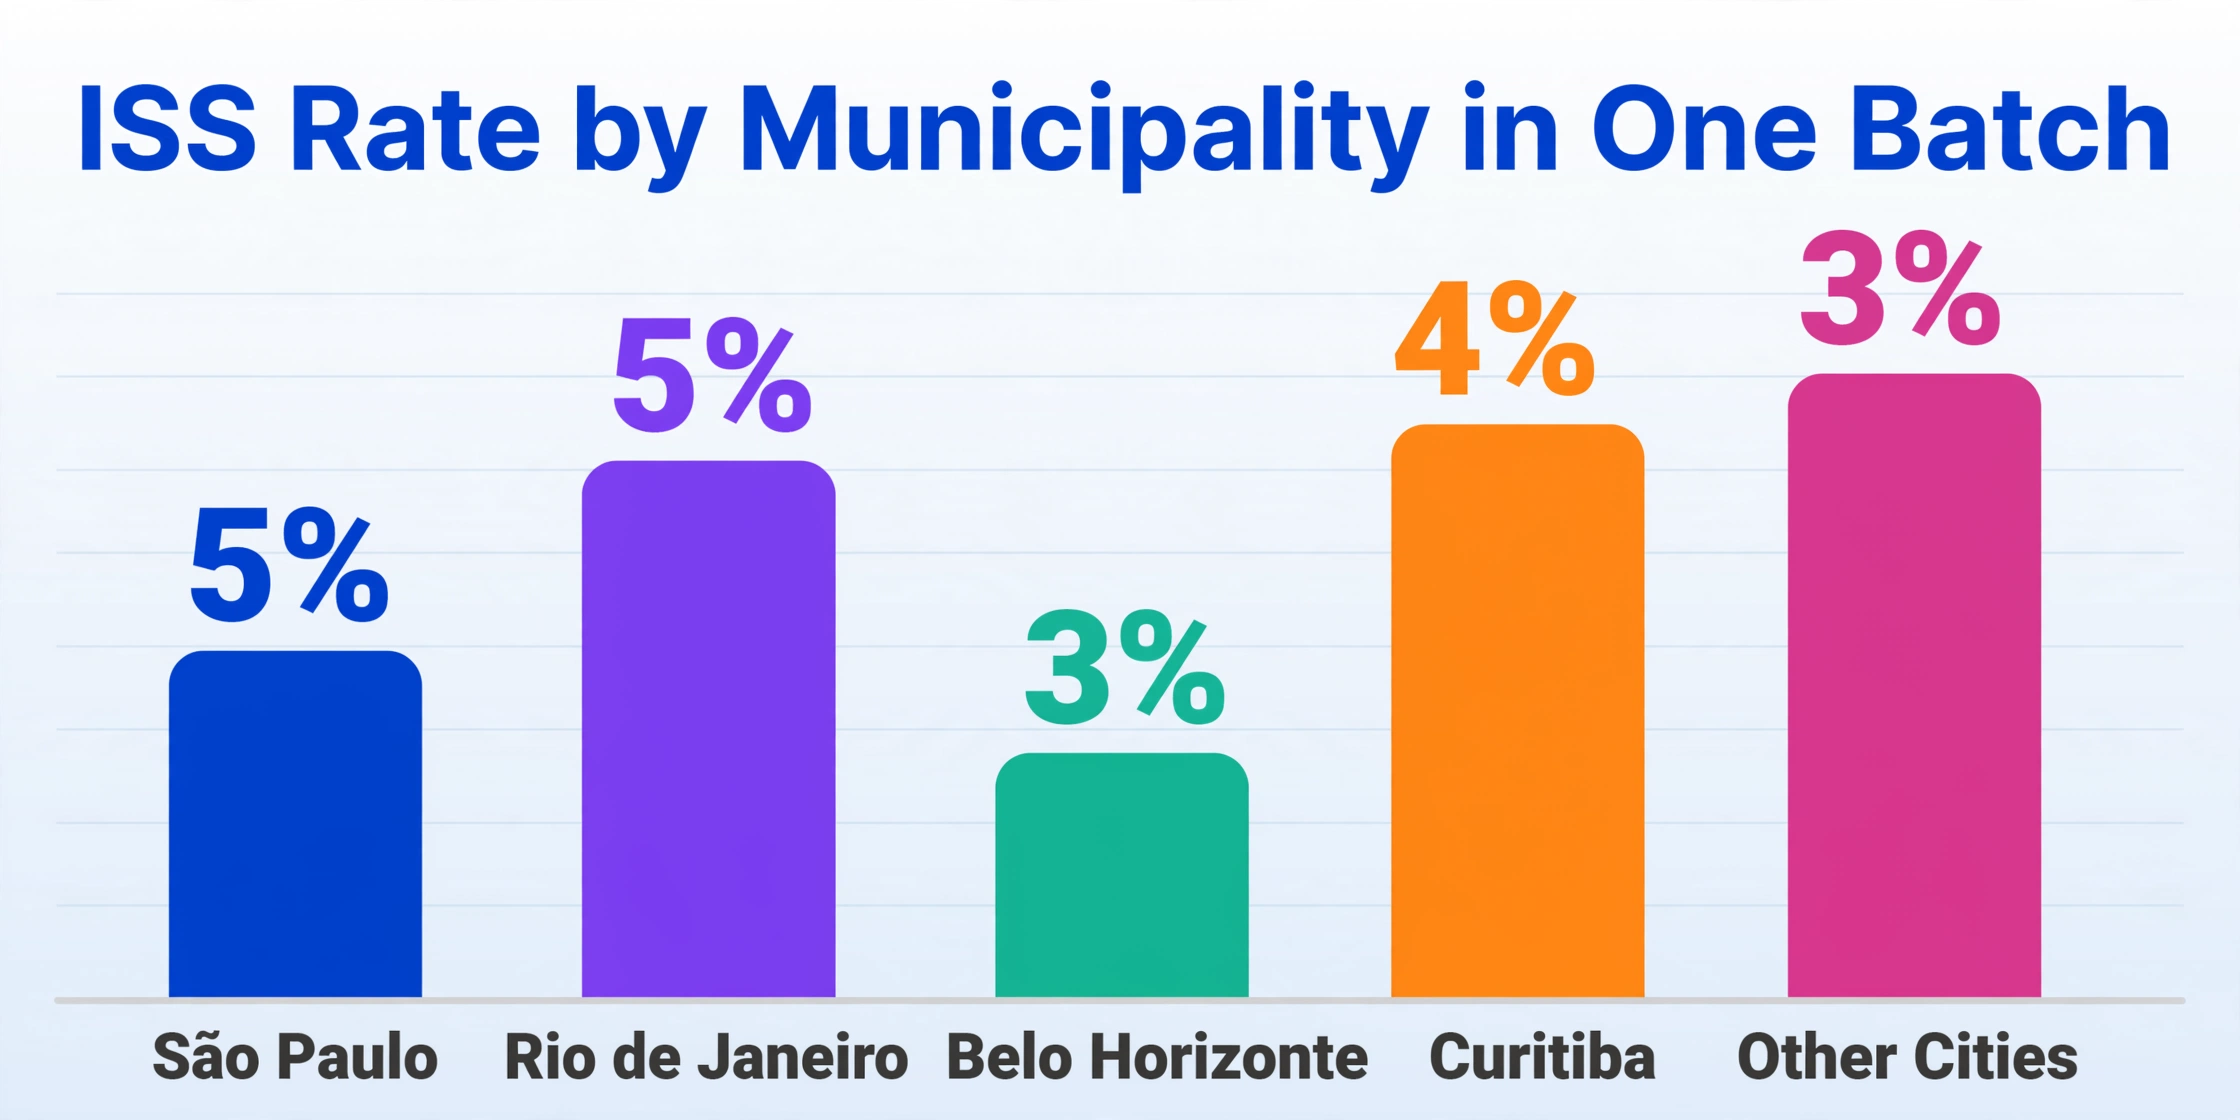
Le traitement par lots introduit une catégorie de défis différente que l'extraction de documents individuels ne révèle pas. Lorsque vous déposez 30 documents NFS-e de prestataires de São Paulo (ISS 5 % pour le conseil en informatique), de Rio de Janeiro (ISS 5 % pour le même service), de Belo Horizonte (ISS 3 %), de Curitiba (ISS 4 %) et de six autres villes dans une même file de traitement, trois choses se produisent qui n'arrivent jamais avec un document unique :
Premièrement, la vérification du taux d'ISS entre les villes devient nécessaire. Une NFS-e individuelle à 3 % d'ISS semble correcte isolément. Mais lorsque vous constatez que le même code de service (article 1.01 — Análise e desenvolvimento de sistemas, ou analyse et développement de systèmes) apparaît à 5 % à São Paulo, à 5 % à Rio et à 3 % à Belo Horizonte dans le même lot, le taux de Belo Horizonte ressort immédiatement. Peut-être est-il correct — Belo Horizonte fixe ses propres taux. Peut-être le prestataire a-t-il appliqué le mauvais taux municipal. Une vue au niveau du lot est le seul moyen de le détecter.
Deuxièmement, le suivi de l'ISS retenue à la source devient une tâche de conformité à l'échelle du lot. Lorsqu'une NFS-e est marquée « ISS Retido na Fonte = Sim », l'obligation de reverser l'ISS passe du prestataire de services au preneur de services — vous. Chaque occurrence exige un paiement séparé à la mairie concernée, chacune avec sa propre date d'échéance et son propre système de paiement. Sur 10 documents provenant de plusieurs villes, savoir quelles factures déclenchent cette obligation et lesquelles ne le font pas n'est pas gérable sous forme de liste de contrôle manuelle.
Troisièmement, les données elles-mêmes ont plus de valeur agrégées. Les totaux d'ISS par prestataire, les dépenses de services par ville, le ratio entre la taxe retenue et la taxe payée par le prestataire — rien de tout cela n'est visible à partir d'un document à la fois. Ces données n'émergent que lorsque l'ensemble du lot se trouve dans une seule feuille de calcul.
Il ne s'agit pas d'exécuter plus rapidement le flux de travail de documents individuels. Il s'agit de faire quelque chose que le flux de travail de documents individuels ne peut pas faire du tout.
Qu'est-ce qui rend le traitement des NFS-e intercommunales fondamentalement différent du traitement par lot standard de factures
Le traitement par lot standard de factures — 50 PDF provenant de 50 fournisseurs aux États-Unis ou en Europe — est avant tout un problème de volume. Les factures se présentent différemment, mais la logique fiscale sous-jacente est cohérente : TVA au taux national, taxe sur les ventes par État, et les champs sont situés à des positions globalement prévisibles avec des libellés globalement prévisibles.
Le traitement par lot des NFS-e brésiliennes ajoute une couche structurelle que le traitement par lot standard de factures ne possède pas. Parce que l'ISS est une taxe municipale régie par la Loi complémentaire 116/2003, et parce que chaque municipalité gère son propre système fiscal, le même champ logique — « le taux de l'ISS » — peut avoir une valeur différente pour chaque document du lot, et cette valeur détermine si la taxe sur ce document a été correctement calculée.
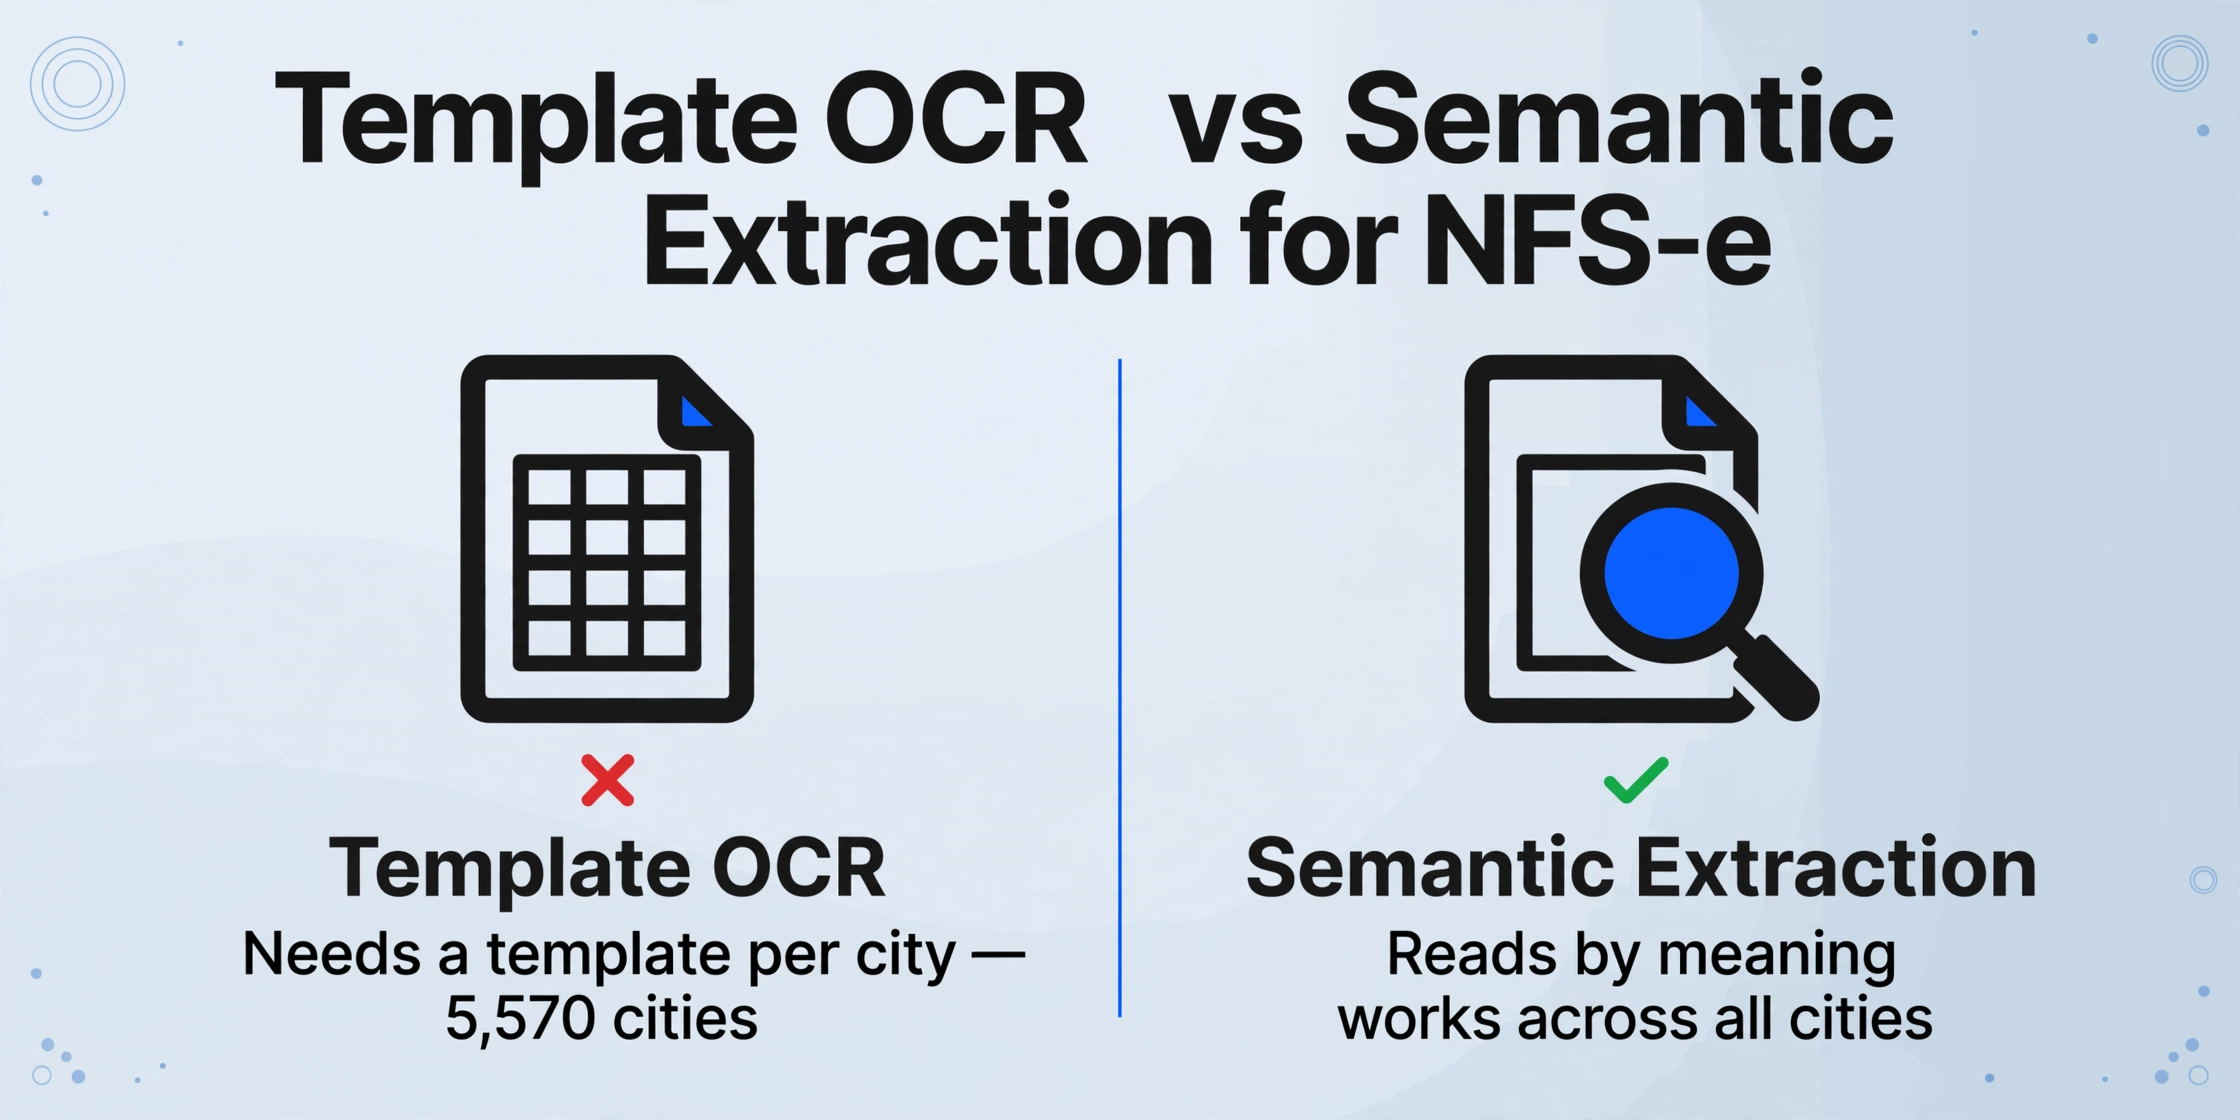
C'est là que l'extraction basée sur modèle — l'approche utilisée par la plupart des outils d'extraction de documents — devient structurellement inutilisable. Un modèle définit une zone rectangulaire pour chaque champ : « le CNPJ du prestataire se trouve à la position de pixel (x=150, y=320). » Cela fonctionne pour une municipalité. Cela échoue pour la suivante. Maintenir une bibliothèque de modèles pour chaque ville où vos prestataires opèrent n'est pas pratique lorsque le nombre de villes possibles est de 5 570 et que le nombre de villes actualisant activement leurs mises en page — São Paulo a publié la version 3.2 de son manuel NFS-e en août 2025 — ne cesse de croître.
L'alternative est l'extraction sémantique : au lieu de définir où se trouve un champ sur la page, vous dites au moteur d'extraction ce que vous recherchez — « le CNPJ à 14 chiffres libellé Prestador » — et il lit le document pour le trouver. La position n'a pas d'importance car le moteur comprend le contenu du document, pas ses coordonnées. Une NFS-e de São Paulo et une NFS-e de Porto Alegre dans le même lot sont traitées avec les mêmes définitions de colonnes, car l'IA recherche le sens, et non la correspondance d'une position.
Voici la différence architecturale : les outils basés sur modèle évoluent en ajoutant davantage de modèles — un par ville, par révision de mise en page. L'extraction sémantique évolue en comprenant davantage de contenu de document. Lorsque vous ajoutez la NFS-e d'une 10e ville au lot, le coût est effectivement nul. Lorsque vous ajoutez le modèle d'une 10e ville, le coût consiste à créer, tester et maintenir ce modèle — et à le mettre à jour chaque fois que la mairie modifie sa mise en page.
Pour une analyse complète de la façon dont l'extraction sémantique gère les champs individuels de la NFS-e — correspondance CNPJ, classification du code de service LC 116, ventilation de la taxe ISS — consultez le guide d'extraction d'une seule NFS-e. Le flux de travail par lot hérite de tout cela et ajoute la couche multi-documents.
Comment l'extraction sémantique gère les NFS-e de 10 villes en un seul lot
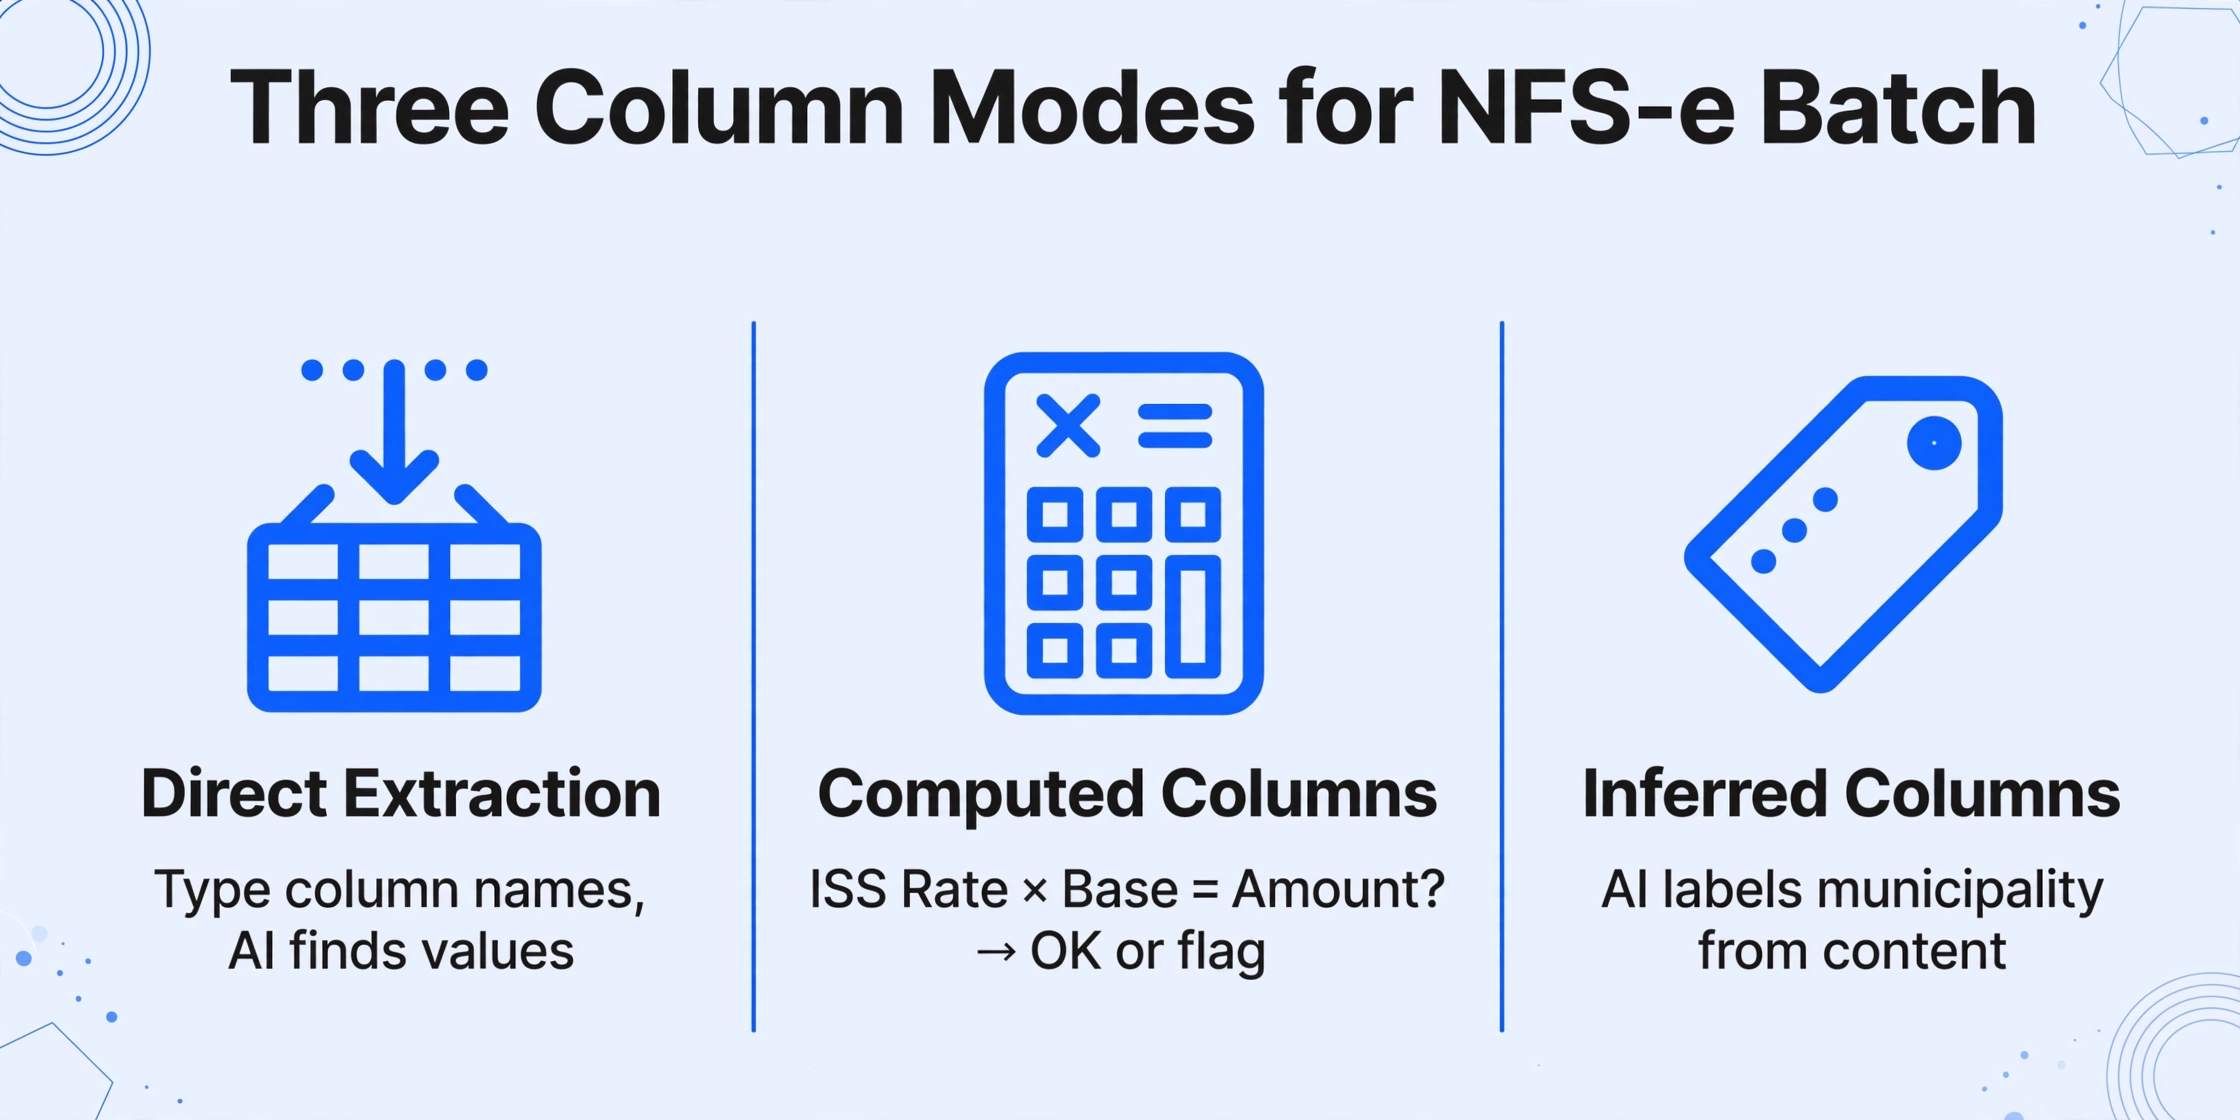
Le flux d'extraction pour le traitement par lot de NFS-e repose sur l'Extraction de colonnes personnalisées : vous saisissez les noms des champs souhaités dans votre sortie — « CNPJ du prestataire », « Code de service (LC 116) », « Taux de l'ISS », « Montant de l'ISS », « ISS retenue à la source », « Numéro NFS-e » — et l'IA localise chaque valeur sur chaque document en comprenant la signification du libellé. Ces noms de colonnes deviennent les en-têtes de votre feuille de calcul. Vous les définissez une fois. Ils fonctionnent pour toutes les municipalités du lot.
Mais le traitement par lot de NFS-e bénéficie d'aller au-delà de l'extraction directe. Deux modes de colonnes supplémentaires rendent la réconciliation inter-villes possible au moment de l'extraction, et non dans un exercice séparé sur feuille de calcul :
Les colonnes calculées vous permettent de définir une logique de validation qui s'exécute pendant l'extraction. Pour le traitement par lot de NFS-e, la colonne calculée la plus utile est une vérification de l'ISS : « Taux de l'ISS × Base de calcul de l'ISS = Montant de l'ISS ? » Lorsque le total calculé correspond au montant de l'ISS extrait, la colonne affiche « OK ». Sinon, elle affiche l'écart — signalant, au niveau du lot, quels documents nécessitent un second examen avant d'importer les données dans votre ERP. Sur un document unique, cette vérification prend 30 secondes. Sur 50 documents, une colonne calculée le fait automatiquement — et vous voyez le résultat dans la même feuille de calcul que les données extraites.
Les colonnes inférées permettent à l'IA de classer ou d'étiqueter les documents en fonction de leur contenu. Ajoutez une colonne nommée « Municipalité (extraite du document) » sans référence de champ spécifique, et l'IA lit l'identifiant de la mairie à partir de la NFS-e et remplit le nom de la ville. Votre sortie de lot dispose désormais d'une colonne municipalité triable — rendant les totaux d'ISS par ville et les déclarations fiscales par ville à un tableau croisé dynamique près, au lieu d'un exercice de recoupement manuel.
Ces trois types de colonnes — extraction directe, calculée et inférée — fonctionnent ensemble en une seule exécution de lot. Vous n'extrayez pas d'abord pour valider ensuite. La validation se produit pendant l'extraction, et les résultats atterrissent dans la même feuille de calcul.
Étape par étape : du tas de NFS-e multi-villes à un seul tableur
Voici le workflow pratique pour traiter par lots des documents NFS-e de plusieurs municipalités brésiliennes en un seul fichier Excel. Vous effectuez cette configuration une fois par lot — les mêmes définitions de colonnes traitent chaque document, quelle que soit sa ville d'origine.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Rapprochement de l'ISS entre municipalités : la vue exclusivement par lot
Le résultat le plus précieux du traitement par lot des NFS-e n'est pas le temps gagné — même si passer de 3 minutes par document à 5 à 10 secondes par page représente une amélioration de 18 fois. Le résultat le plus précieux est la vue de rapprochement qui n'existe que lorsque tous les documents sont réunis dans un seul tableau.
Voici ce que cette vue vous permet de faire, ce que le traitement de documents individuels ne permet pas :
Totaux ISS par ville
Regroupez la sortie par municipalité et additionnez le montant de l'ISS. Vous obtenez ainsi le total de l'ISS appliqué à vos achats de services dans chaque ville — des données importantes pour deux raisons. Premièrement, elles vous indiquent si le total de l'ISS de tous les prestataires d'une ville donnée correspond à votre répartition interne des coûts pour cette juridiction. Deuxièmement, si vous êtes l'agent de retenue de l'ISS sur l'une de ces factures, le total par ville est le chiffre que vous devez rapprocher de vos registres de versement de la taxe municipale. Le guide fiscal mondial de Dentons note que « les conflits entre différentes municipalités qui revendiquent toutes deux l'ISS sont assez courants » — une vue au niveau du lot constitue votre piste d'audit si une seconde municipalité vient poser des questions.
Suivi de l'ISS retenue à la source
Lorsqu'une NFS-e porte le drapeau « ISS Retido na Fonte = Sim » (ISS retenue à la source), c'est votre entreprise — et non le prestataire de services — qui est responsable du versement de l'ISS à la municipalité du prestataire. Il ne s'agit pas d'une simple note de saisie de données ; c'est une action de conformité fiscale avec une échéance et un système de paiement qui varie selon la ville. Dans une sortie par lot, le tri par la colonne ISS retenue vous donne une liste complète et unique de chaque facture nécessitant votre action. Plus besoin de chercher dans 30 PDF individuels pour trouver les trois qui portaient le drapeau.
Le cadre juridique entourant la retenue de l'ISS a été testé devant la plus haute cour du Brésil. En 2020, la Cour suprême fédérale du Brésil (STF) a statué dans le RE 1167509 que les municipalités ne peuvent pas imposer d'obligations de retenue de l'ISS aux preneurs de services lorsque le prestataire n'est pas enregistré dans cette municipalité — annulant ainsi l'exigence d'enregistrement du CPOM (registre des prestataires d'autres municipalités) de São Paulo. Mais les obligations de retenue établies par la loi fédérale, lorsque la combinaison du type de service et de la municipalité déclenche une retenue légitime, restent en vigueur. Savoir quelles factures comportent une obligation de retenue valide nécessite de voir le lot.
Détection des écarts de taux d'ISS
La LC 116/2003 établit des taux d'ISS entre 2 % et 5 % selon la municipalité et le type de service. Mais les municipalités se font concurrence sur les taux pour attirer les entreprises — le diagnostic du PNUD sur le système fiscal brésilien note « une guerre prédatrice sur les avantages fiscaux liés à l'ICMS et à l'ISS ». Un prestataire peut appliquer un taux de 2 % pour un code de service que São Paulo taxe à 5 %, parce qu'il est enregistré dans une municipalité qui a abaissé son taux pour attirer les entreprises. La validité de ce taux relève d'une décision fiscale que votre équipe comptable doit prendre. Mais le repérer exige de voir le lot. Un document isolé à 2 % semble normal. Dix documents à 5 % et un à 2 %, tous pour le même code de service — voilà un écart qui mérite d'être examiné.
Ce que la norme nationale NFS-e signifie pour le traitement par lots
Le SNNFS-e (système national de la NFS-e) est la démarche du Brésil pour unifier les formats de factures de services entre les municipalités. En août 2025, 1 463 municipalités y avaient adhéré — mais l'adoption est volontaire, et de grandes villes comme São Paulo ont publiquement confirmé qu'elles conserveraient leurs propres systèmes. Le résultat est un paysage hybride : certains de vos prestataires émettent des NFS-e selon la norme XML nationale, d'autres selon le système de leur ville, et vous ne contrôlez pas lequel.
Du point de vue du traitement par lots, ce paysage hybride renforce la valeur de l'extraction indépendante de la mise en page. Les outils basés sur des modèles ont désormais besoin de modèles pour les formats municipaux antérieurs à la norme et pour la norme SNNFS-e — sans oublier les chemins de mise à jour lorsque les villes migrent de l'un à l'autre. L'extraction sémantique lit ce qui figure sur le document, quel que soit le standard qui l'a produit. Une NFS-e au format national et une NFS-e au format personnalisé de São Paulo arrivent dans le même lot, définissent les mêmes colonnes et produisent la même sortie. Le processus de normalisation change le contenu du document, pas l'approche d'extraction.
La réforme fiscale de 2026 — qui remplacera progressivement l'ISS par l'IBS (taxe sur les biens et services) d'ici 2033 — ajoute une autre couche. Pendant la transition, les documents NFS-e peuvent comporter à la fois les champs ISS hérités et les nouveaux champs IBS/CBS. L'approche d'extraction s'adapte en ajoutant de nouveaux noms de colonnes — « Montant IBS », « Montant CBS » — aux côtés des colonnes ISS existantes. Aucune refonte de modèle requise.
Si votre organisation traite également des factures de marchandises brésiliennes, le flux d'extraction XML NF-e est couvert dans le guide d'extraction NF-e. Les deux types de documents peuvent coexister dans le même lot lorsque vos définitions de colonnes sont suffisamment larges, bien que les champs spécifiques à la NFS-e comme le code LC 116 soient vides pour les documents NF-e — ce qui est attendu et ne provoque pas d'erreurs.
FAQ : Traitement par lot des NFS-e
Puis-je traiter par lot des NFS-e de prestataires de différentes villes ensemble ?
Oui — c'est même le cas d'usage principal. L'extraction sémantique lit chaque document indépendamment en comprenant le contenu, sans se baser sur la mise en page d'une ville spécifique. Une NFS-e de São Paulo (ISS 5 %), une de Belo Horizonte (ISS 3 %) et une de Curitiba (ISS 4 %) dans le même lot sont toutes traitées avec les mêmes définitions de colonnes. L'IA localise le CNPJ do Prestador, la base de cálculo de l'ISS et les autres champs sur chaque document, peu importe où ils apparaissent sur la page.
Comment l'ISS Retido na Fonte est-il géré dans l'export par lot ?
Le champ « ISS Retenu » est extrait dans une colonne dédiée — contenant généralement « Sim » (oui) ou « Não » (non). Dans le tableur de l'export par lot, trier par cette colonne vous donne la liste complète de toutes les factures pour lesquelles votre entreprise est l'agent de retenue. Ensuite, vous calculez le montant à reverser (taux d'ISS × base de chaque facture concernée) et vous dirigez chaque paiement vers le système de la préfecture correspondante. L'outil d'extraction fournit les données. Le reversement de la taxe reste une étape de conformité distincte que votre équipe comptable effectue via le portail de paiement de chaque municipalité.
Que faire si un prestataire émet une NFS-e avec des erreurs de mise en page ou des champs manquants ?
Le moteur d'extraction lit ce qui figure sur le document. Si un champ obligatoire — le CNPJ par exemple — est manquant ou illisible, la cellule correspondante dans l'export sera vide. C'est en fait utile : une cellule vide dans l'export par lot identifie immédiatement le document à relancer auprès du prestataire, alors qu'une saisie manuelle de 30 documents pourrait vous faire passer à côté d'un champ vide parmi les autres. La vue par lot rend les omissions visibles.
Puis-je mélanger des NFS-e et des factures de services internationales dans le même lot ?
Oui. Si vos définitions de colonnes couvrent les deux types de documents — par exemple « Numéro de facture », « Nom du fournisseur », « Montant total », « Montant de la taxe » — les factures internationales et les NFS-e peuvent coexister dans le même lot. Les colonnes spécifiques aux NFS-e comme « Code service LC 116 » ou « Taux d'ISS » seront vides pour les documents non brésiliens, et les colonnes spécifiques aux factures internationales comme « Numéro de TVA » seront vides pour les NFS-e. Ces deux comportements sont normaux et ne génèrent pas d'erreurs.
Le moteur d'extraction gère-t-il les champs de la réforme fiscale 2026 (IBS/CBS) sur les documents NFS-e ?
Oui — lorsqu'une municipalité met à jour son format NFS-e pour inclure les champs IBS ou CBS, vous ajoutez les noms de colonnes correspondants (par exemple, « Montant IBS », « Montant CBS ») à votre définition de lot. Le moteur d'extraction localise ces nouveaux champs en comprenant le contenu du document, de la même manière qu'il localise les champs ISS et CNPJ existants. Aucune reconfiguration de modèle n'est requise. Pendant la période de transition jusqu'en 2033, vous pouvez exécuter des lots contenant des documents NFS-e avec à la fois des champs ISS et IBS — définissez des colonnes pour les deux, et la sortie renseignera les champs présents sur chaque document.
Comment le traitement par lots se compare-t-il à l'intégration directe de l'API de chaque municipalité ?
L'intégration des API municipales nécessite de créer et de maintenir une connexion distincte pour chaque ville où vos prestataires opèrent — chacune avec sa propre méthode d'authentification, son schéma et son calendrier de mise à jour. La norme nationale SNNFS-e simplifie cela pour les municipalités participantes, mais les grandes villes comme São Paulo ont refusé d'y adhérer. L'extraction sémantique par lots traite les documents que vous recevez déjà — PDF, XML, impressions DANFSE — sans nécessiter d'accès API à aucun système municipal. Ce n'est pas une alternative à l'intégration API pour l'émission sortante de NFS-e. C'est la solution côté réception lorsque vous êtes le preneur de services (tomador), et non l'émetteur.
Pour une vue plus large de l'extraction documentaire par lots au-delà de la NFS-e, découvrez comment l'extraction de factures par lots vers Excel fonctionne sur différents types de documents et devises.
De la saisie par municipalité à la réconciliation par lot
La NFS-e a été conçue pour rendre la collecte fiscale efficace pour le gouvernement — et elle l'est. Chaque facture de services que vous recevez a été validée par une autorité fiscale municipale avant d'arriver dans votre boîte de réception. Le CNPJ a été vérifié. Le taux de l'ISS a été contrôlé par rapport au code de service. Le numéro de facture a été attribué. Ces données existent. Elles sont exactes. Elles ont passé une étape de validation gouvernementale que la plupart des factures internationales ne connaissent jamais.
L'inefficacité se situe entièrement côté réception : ressaisir des champs validés provenant de documents qui varient selon la ville dans une feuille de calcul qui doit être correcte pour la réconciliation SPED. L'extraction sémantique par lots comble cet écart non pas en accélérant la saisie mais en la supprimant — et ce faisant, elle vous offre la vue inter-municipalités que la saisie manuelle ne pourrait jamais produire.
La prochaine fois que vous recevrez une pile de NFS-e de prestataires à São Paulo, Rio, Belo Horizonte et au-delà, essayez de les traiter comme un seul lot. Définissez vos colonnes une fois. Laissez l'extraction s'exécuter. Puis triez par municipalité et vérifiez les totaux de l'ISS. Voyez si la vue par lots révèle quelque chose que les documents individuels ne montraient pas.
Aucune inscription requise pour vos 50 premières pages.