50 bulletins de paie, une
synthèse de paie
Un cabinet comptable de São Paulo qui gère la paie de 30 entreprises clientes traite environ 1 200 holerites chaque mois — chacun provenant d'un employeur différent, généré par un système de paie différent, avec une mise en page PDF différente. Le goulot d'étranglement n'est pas la technologie d'extraction. C'est le moment où vous terminez l'extraction du 50e holerite et réalisez que la somme des INSS de tous les employés ne correspond pas au montant de la DARF (Documento de Arrecadação de Receitas Federais) versée par l'employeur — et vous n'avez aucune idée de quelle ligne est erronée.
Points clés à retenir
- Plus de 40 heures par mois à saisir des holerites n'est pas seulement lent — avec un taux d'erreur de saisie manuelle de 1 à 3 %, un lot de 1 200 lignes garantit statistiquement 12 à 36 valeurs INSS ou IRRF incorrectes que vous ne détecterez qu'au moment où l'avocat d'un ancien employé le fera.
- L'Article 467 de la CLT double chaque sous-paiement découvert à la résiliation, et chaque erreur non corrigée se cumule en silence, car la saisie des données ligne par ligne ne vous donne jamais une vue d'ensemble des retenues de tous les employés côte à côte.
- ImageToTable.ai réduit 50 à 1 200 holerites de n'importe quel système de paie en un seul téléversement par lot, un ensemble de colonnes défini et une feuille de calcul unifiée — puis un simple tri de colonne signale chaque anomalie de retenue chez chaque employé, transformant une corvée de saisie de 40 heures en un audit de 15 minutes.
Pourquoi l'extraction de bulletins de paie un par un ne passe pas à l'échelle
Extraire un seul bulletin de paie brésilien (holerite/contracheque) dans Excel résout la question des données d'un employé. Mais dès que vous avez besoin de réponses concernant toute une entreprise — total de la cotisation INSS, dépôts FGTS agrégés, retenue IRRF moyenne par tranche de salaire — l'extraction de fichiers un par un cesse d'être un flux de travail et devient un projet de rapprochement de données au ralenti.
Si vous avez déjà lu notre guide sur l'extraction d'un bulletin de paie brésilien vers Excel avec INSS et IRRF, vous en connaissez les principes fondamentaux : définir les noms de colonnes, télécharger un PDF de holerite, et l'IA extrait chaque champ en comprenant la signification de l'étiquette, et non sa position à l'écran. Cela fonctionne pour un bulletin. Mais lorsque vous avez 50 holerites provenant de 12 entreprises différentes, le défi change de trois manières structurelles qu'un flux de travail un par un ne peut pas résoudre.
Premièrement, l'incohérence multi-format. Un prestataire de paie qui sert 30 clients ne reçoit pas 30 PDF identiques. TOTVS RM génère des holerites dans une mise en page ; ADP Brésil dans une autre ; Senior Sistemas dans une troisième. Un petit client professionnel pourrait vous remettre une photo prise avec un smartphone d'un bulletin imprimé — papier thermique, encre délavée, aucune couche de données lisibles par machine. Dans un flux de travail un par un, vous vous adaptez manuellement à chaque format. Dans un flux de travail par lots, l'outil doit tous les gérer simultanément sans reconfiguration. L'extraction sémantique — trouver « INSS » en comprenant l'étiquette, et non en faisant correspondre une coordonnée fixe — fait la différence entre le traitement par lots et la mise en lots de vos problèmes.
Deuxièmement, la charge de rapprochement se multiplie. Un seul holerite comporte quatre retenues légales — INSS, IRRF, FGTS, et des retenues facultatives comme le bon de transport et les cotisations syndicales. Vérifier les retenues d'un bulletin par rapport au barème fiscal officiel prend quelques secondes. Pour 1 200 holerites, la même vérification est une tâche à temps plein. Pire encore, le DARF et la GFIP mensuels de l'employeur (Guia de Recolhimento do FGTS e Informações à Previdência Social — bientôt entièrement remplacés par la DCTFWeb via eSocial conformément au Décret n° 8.373/2014) déclarent les totaux agrégés INSS/IRRF/FGTS de tous les employés. Si les totaux de votre lot extrait ne correspondent pas aux déclarations agrégées de l'employeur, vous devez identifier quelle ligne d'employé spécifique est erronée — et avec 1 200 lignes, cette recherche n'est ni rapide ni facturable.
Troisièmement, le risque de conformité est amplifié, et non ajouté. En vertu de l'Article 467 de la CLT, si un employeur sous-déclare les retenues salariales — par exemple en déclarant un montant INSS ou IRRF incorrect — et que le manque est découvert lors de la résiliation, l'employé a droit au double du montant sous-payé. Pour un employé, un mois, l'exposition financière est douloureuse mais limitée. Pour 50 employés sur 12 mois, une seule erreur systématique — disons, une mauvaise configuration du logiciel de paie qui sous-calcule la retenue IRRF d'une tranche — se cumule sur 600 points de données. Le flux de travail par lots ne rend pas seulement l'extraction plus rapide. Il vous donne un ensemble de données unifié unique où vous pouvez auditer les 600 valeurs par rapport au barème progressif de la Receita Federal en une seule vue, détectant l'erreur systématique avant qu'elle ne devienne une responsabilité systématique.
Le flux de traitement par lots — 50 holerites en entrée, une feuille de paie en sortie
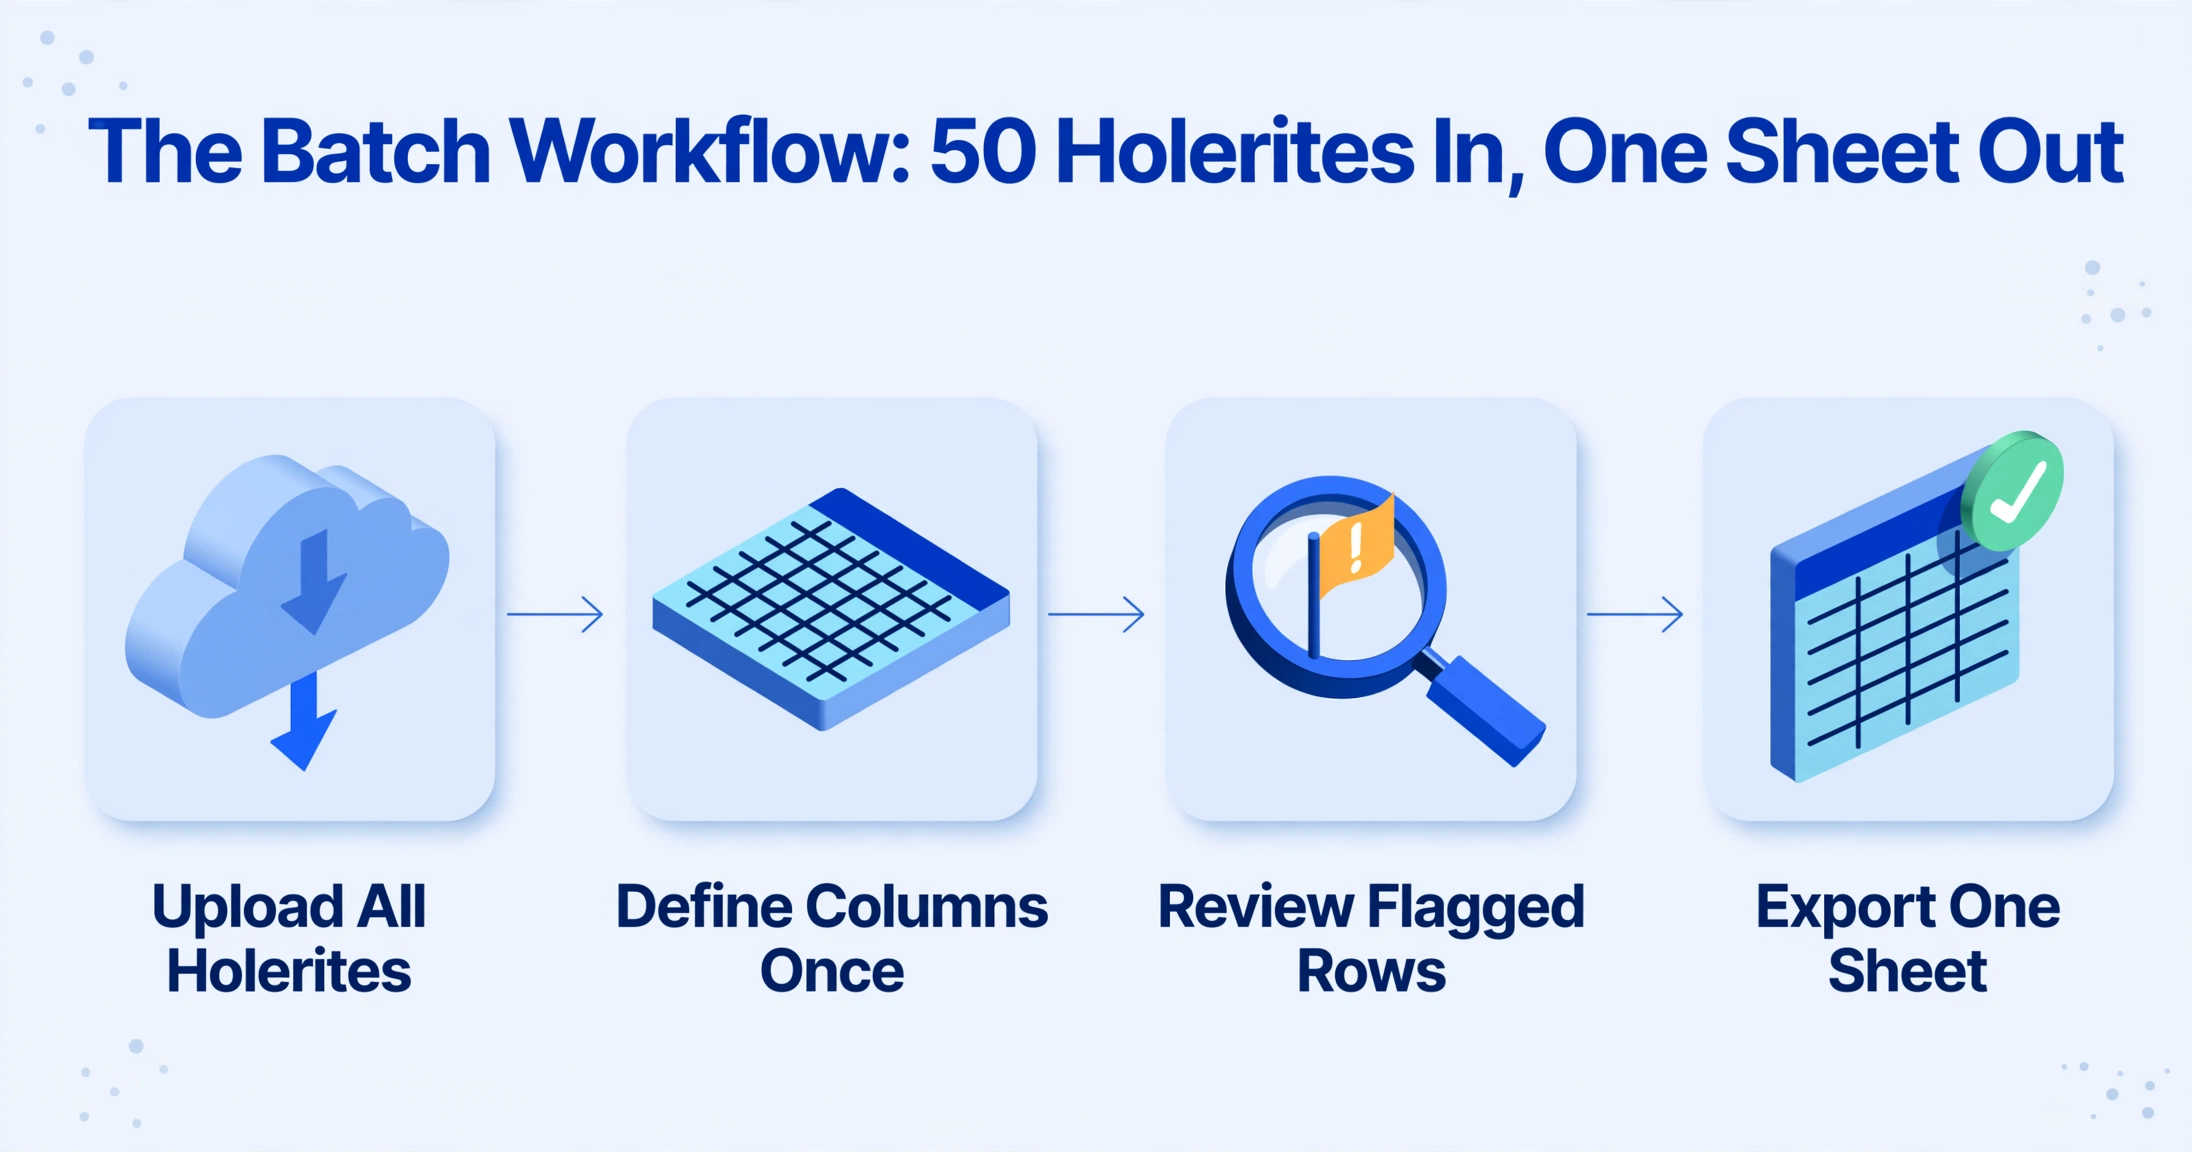
Le flux de traitement par lots inverse la relation entre la variété des entrées et la cohérence des sorties. Vous acceptez que vos 50 holerites proviennent de 8 systèmes de paie différents dans 8 mises en page PDF différentes — et vous produisez une feuille de calcul où chaque ligne suit exactement la même structure de colonnes.
Le mécanisme qui rend cela possible est l'Extraction de colonnes personnalisées. Contrairement à l'OCR basé sur un modèle qui exige de dessiner des cadres de délimitation autour de chaque champ sur chaque document, l'extraction de colonnes personnalisées fonctionne de manière sémantique : vous saisissez les noms de champs souhaités — « Salaire brut », « Cotisation INSS », « IRRF retenu », « Dépôt FGTS », « Salaire net » — et l'IA localise la valeur correspondante sur chaque document en comprenant la signification du libellé. Un holerite TOTVS qui libelle le champ « INSS Contribuição » et un holerite ADP qui le libelle « Previdência INSS » aboutissent tous deux à la même colonne de sortie, car l'IA lit le sens, pas les coordonnées.
Voici comment le flux de traitement par lots fonctionne en pratique :
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Un lot ne se soucie pas de vos noms de fichiers. Contrairement aux flux de travail Excel manuels où vous nommez les fichiers comme « Holerite_Joao_Maio.pdf » pour pouvoir retracer les données jusqu'à la source, le traitement par lots conserve le nom du fichier source dans la sortie. Vous pouvez téléverser des fichiers avec les noms que le système de paie a exportés — la feuille de calcul de sortie comporte une colonne « Fichier source » qui trace chaque ligne jusqu'à son origine.
Rapprochement du lot — Comparaison des totaux extraits avec DARF, GFIP et eSocial
La feuille de calcul arrive. 1 200 lignes. 50 employés répartis sur 30 clients. Vous pouvez maintenant filtrer par CNPJ, trier par tranche de salaire brut et faire des tableaux croisés des retenues INSS par mois de référence. Mais avant de vous y fier, une question doit trouver une réponse : est-ce que la somme de ce que l'IA a extrait correspond à ce que l'employeur a déclaré ?
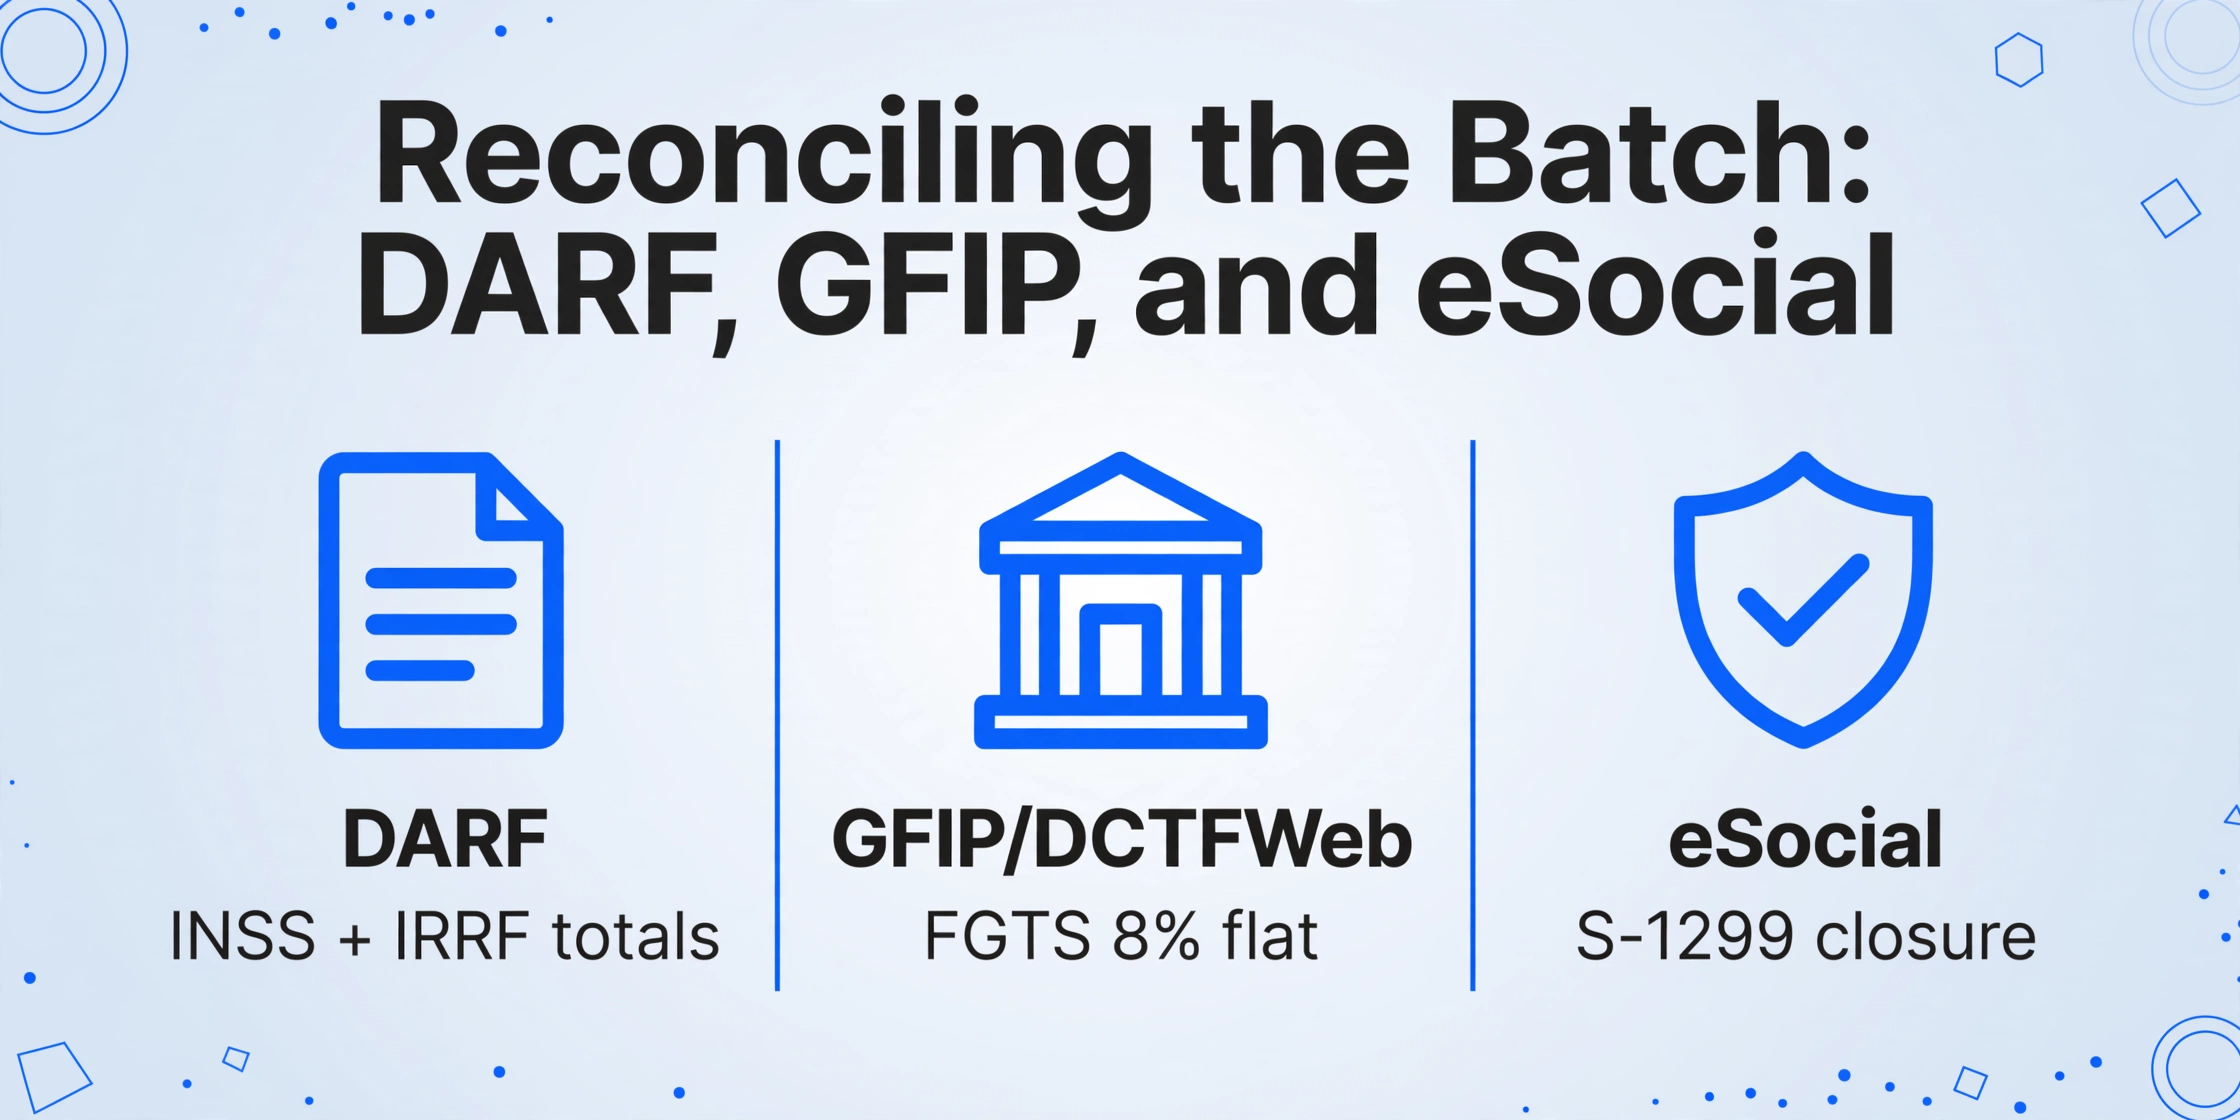
Chaque mois, les employeurs brésiliens effectuent trois versements fiscaux agrégés basés sur leur masse salariale totale :
- DARF Previdenciário — le paiement INSS consolidé pour tous les employés, versé le 20 du mois suivant. Le montant total INSS sur le DARF doit être égal à la somme des retenues INSS de chaque employé dans votre sortie de lot, plus la cotisation patronale de 20 % de l'employeur, qui figure dans les registres comptables de l'employeur mais pas sur le holerite individuel.
- FGTS via GFIP et désormais DCTFWeb — le dépôt patronal de 8 % sur le salaire brut de chaque employé, versé via Caixa Econômica Federal le 7 du mois suivant conformément à la Loi n° 8.036/1990. Le total FGTS sur la GFIP/DCTFWeb doit correspondre à la somme des montants FGTS de chaque employé issus de la sortie de lot — ce qui devrait toujours être le cas, car le FGTS est un taux fixe de 8 % sans tranches progressives.
- IRRF via DARF — le total de l'impôt sur le revenu retenu sur tous les employés. C'est le plus délicat à rapprocher, car l'IRRF de chaque employé est calculé de manière progressive, avec une déduction pour personne à charge de R$189,59/mois par personne à charge, et les tranches ont changé à la mi-2025 lorsque le seuil d'exonération est passé de R$2 259,20 à R$2 428,80 conformément à la Loi n° 15.191/2025.
L'étape de rapprochement elle-même est rapide une fois les données dans Excel. Ajoutez une colonne SOMME en bas de chaque colonne de retenue. Comparez le total INSS à la valeur INSS du DARF. Comparez le total FGTS à la valeur GFIP. Si les chiffres correspondent — et ils correspondront, à condition que l'extraction soit précise et que la paie de l'employeur ait été configurée correctement — vous disposez d'un ensemble de données validé, prêt pour la soumission croisée via eSocial.
Lorsque les chiffres ne correspondent pas, la feuille de calcul unifiée devient un outil d'investigation plutôt qu'un problème mathématique. Filtrez par employé, triez par salaire net décroissant, comparez les valeurs IRRF individuelles au barème progressif de la Receita Federal. Un audit de 15 minutes sur une feuille de calcul de 1 200 lignes remplace ce qui serait autrement des heures d'ouverture de holerites PDF individuels et de revérification manuelle des retenues.
La pénalité de l’Article 467 de la CLT à grande échelle — pourquoi un seul chiffre manqué dans un lot s’accumule
Le droit du travail brésilien ne fait pas de distinction entre une erreur de paie découverte par l’employeur et une erreur découverte par l’avocat de l’employé. Lorsqu’une déduction est incorrecte — que la cause soit un bug du logiciel de paie, une mauvaise classification de tranche ou une erreur de saisie manuelle — le délai de responsabilité commence au moment où l’erreur se produit, pas au moment où vous la découvrez.
Article 467 de la CLT établit un mécanisme spécifique : si lors de la résiliation, l’employeur omet de payer l’intégralité du montant dû — y compris les montants corrigés pour les sous-paiements passés — l’employé a droit au double de la différence. Dans un environnement de paie manuelle où un seul analyste RH saisit 50 holerites par mois, le taux d’erreur est une certitude actuarielle. Les études sur la saisie manuelle de données dans les contextes de paie constatent généralement des taux d’erreur de 1 % à 3 % — ce qui signifie que dans un lot de 1 200 holerites, 12 à 36 lignes contiennent au moins une valeur incorrecte.
Ce qui distingue l’approche de traitement par lots, ce n’est pas qu’elle élimine entièrement les erreurs — aucune méthode d’extraction n’atteint une précision de 100 % sur tous les types de documents. Ce qui change, c’est quand vous détectez les erreurs et combien vous en détectez à la fois.
Dans un flux manuel, chaque holerite est une unité de vérification indépendante. Vous saisissez les valeurs, vous regardez le bulletin, vous passez au suivant. Il n’existe aucun contrôle d’intégrité transversal. Une mauvaise classification de tranche INSS qui affecte 14 employés sur la même tranche salariale ressemble à 14 erreurs indépendantes dans le flux manuel — et peut passer inaperçue pendant des mois.
Dans un flux de traitement par lots, la sortie unifiée rend les anomalies visibles sur l’ensemble des lignes. Triez la colonne des cotisations INSS en ordre décroissant. Les employés ayant le même salaire brut doivent avoir des retenues INSS identiques (ajustées pour le calcul progressif par tranches). Si 12 des 14 employés de la tranche de 3 000 R$ présentent la retenue INSS correcte d’environ 219 R$ (les deux premières tranches appliquées progressivement), et que 2 présentent 240 R$, vous avez identifié les deux lignes nécessitant une vérification — en une seule opération de tri, et non en 14 vérifications individuelles.
Le coût réel de la paie manuelle par lots ne réside pas dans les 40 heures consacrées à la saisie des données. C’est la responsabilité qui s’accumule à cause des erreurs restées non détectées, faute d’une vue unique des déductions de tous les employés côte à côte. L’extraction par lots transforme la vérification de la paie d’une tâche par document en un audit par colonne — et c’est cette différence opérationnelle qui rend le traitement par lots non seulement plus rapide, mais aussi plus sûr.
Ce que le traitement par lots change pour la clôture de fin de mois
Pour un cabinet comptable servant plusieurs clients, la clôture de paie de fin de mois suit une séquence prévisible : réception des PDF de holerite de chaque système de paie client → saisie manuelle ou exportation des champs clés dans le logiciel comptable du cabinet → rapprochement des totaux avec les agrégations DARF/GFIP → dépôt des événements de clôture mensuelle eSocial S-1299 → génération des rapports clients. L'extraction par lots condense les deux étapes intermédiaires, passant d'un processus de saisie de données de plusieurs jours à une seule session d'extraction et de vérification.
Le changement ne réside pas seulement dans la rapidité. Il s'agit de ce qui devient possible lorsque les données de paie de 30 clients sont dans un format structuré plutôt que dans des PDF. Vous pouvez répondre à des questions comme « quel client a la charge INSS moyenne par employé la plus élevée » ou « quelle tranche salariale a connu la plus forte augmentation de retenue IRRF entre le T1 et le T2 » en filtrant un tableur, sans avoir à relire des centaines de holerites individuels.
Pour les entreprises qui traitent à la fois les fiches de paie et les factures fournisseurs — un chevauchement courant dans les cabinets comptables qui gèrent la paie et les comptes fournisseurs pour un même client — la même approche par lots s'applique à différents types de documents. Le mécanisme d'extraction par lots des données des NF-e brésiliennes repose sur le même principe : définir les colonnes une fois, tout télécharger, obtenir un seul tableur. Le format de sortie est identique, que l'entrée soit un holerite, un DANFE ou un XML de NF-e.
La plupart des équipes de paie ne passent pas au traitement par lots parce qu'elles veulent extraire les données plus rapidement. Elles changent parce qu'elles réalisent que les données de paie saisies manuellement ne sont jamais auditées — il n'y a tout simplement pas le temps. L'extraction par lots fait de l'audit la règle, et non l'exception, car les données nécessaires pour vérifier les chiffres se trouvent déjà dans le même tableur que les chiffres eux-mêmes.
FAQ
Combien de holerites puis-je traiter en un seul lot ?
Il n'y a pas de limite stricte quant au nombre de fichiers par lot. L'outil les traite séquentiellement dans une file d'attente unique. Pour les cabinets comptables gérant 30 clients ou plus, le téléchargement de tous les holerites d'un mois donné — même 1 200 fichiers — fonctionne en un seul lot. La sortie fusionne le tout dans un seul fichier Excel où vous pouvez ensuite filtrer par CNPJ ou nom d'entreprise pour séparer les clients. Pour les lots extrêmement volumineux, le quota mensuel de fichiers de votre forfait est la contrainte déterminante, et non la limite technique de téléchargement.
Et si différents employeurs utilisent des noms de champs différents — comme « INSS » vs « Previdência » ?
L'IA extrait sémantiquement, c'est-à-dire qu'elle trouve la valeur associée au concept « cotisation INSS », quel que soit le libellé exact sur le PDF. Un bulletin de paie de TOTVS qui l'intitule « INSS Contribuição », un autre d'ADP qui utilise « Previdência INSS », et un de Senior qui écrit « Desconto INSS » correspondent tous à la même colonne de sortie, car l'IA comprend la signification des libellés. C'est l'avantage fondamental par rapport à l'OCR par modèle : vous définissez vos colonnes une fois, et chaque format source se résout en une structure identique.
Puis-je utiliser les colonnes calculées pour vérifier l'INSS et l'IRRF lors du traitement par lots ?
Oui. Vous pouvez définir une colonne calculée qui calcule l'INSS attendu à partir du salaire brut extrait, en utilisant la formule des tranches progressives. Par exemple, une colonne nommée « INSS attendu (calcul progressif) » avec une règle de calcul appliquant les quatre tranches INSS au salaire brut produit une déduction attendue. Comparez-la à la colonne « Cotisation INSS » extraite : toute ligne où les deux valeurs divergent est signalée pour révision — un audit par lots intégré, sans quitter le tableur de sortie.
La sortie par lots inclut-elle le nom du fichier source pour que je puisse tracer chaque ligne jusqu'au PDF d'origine ?
Oui. Chaque ligne de la sortie comporte une colonne « Fichier source » qui identifie le document téléchargé ayant produit cette ligne. C'est essentiel pour les flux de conformité — si un auditeur demande le holerite d'un employé spécifique pour un mois donné, vous pouvez localiser instantanément le fichier source en filtrant le tableur, plutôt que de chercher dans un dossier de PDF.
Que se passe-t-il si un holerite dans un lot de 50 ne s'extrait pas correctement ?
Le traitement par lots continue — l'échec d'un fichier n'arrête pas le reste. Après le traitement, vous pouvez vérifier quels fichiers ont eu des problèmes (généralement signalés si l'IA n'a pas pu localiser un champ en raison de problèmes extrêmes de qualité d'image). Vous pouvez ensuite retélécharger uniquement ces fichiers dans un lot de suivi plus petit. Pour la plupart des PDF de paie brésiliens — générés par ordinateur par un logiciel de paie et ayant des mises en page structurées et propres — la fiabilité d'extraction est constamment élevée d'un lot à l'autre.
Ceci remplace-t-il un logiciel de paie comme TOTVS ou ADP ?
Non. Le logiciel de paie calcule les déductions, génère les holerites et produit les fichiers eSocial. L'extraction par lots intervient après le logiciel de paie dans le flux de travail — elle prend les PDF déjà produits par le système de paie et les convertit en données structurées pour l'analyse, la consolidation multi-clients et la vérification de conformité. Elle ne remplace pas le moteur de paie ; elle comble le fossé entre « avoir des PDF d'holerites » et « pouvoir analyser les données de paie par employé, mois et client ».
Un Audit, Pas Seulement un Export
Saisir manuellement 50 holerites dans Excel produit un tableur. Extraire par lots 50 holerites produit aussi un tableur. La différence n'est pas le format de fichier — c'est qu'un tableur contient des valeurs dont vous espérez qu'elles sont correctes parce que vous les avez tapées avec soin, et l'autre contient des valeurs que vous pouvez vérifier car les mêmes colonnes vous permettent d'auditer l'ensemble des employés en un seul coup d'œil.
La paie brésilienne comporte quatre tranches progressives pour l'INSS, cinq pour l'IRRF, un taux fixe de FGTS, et une contribution patronale de 20% à l'INSS qui triple la surface de rapprochement par rapport à un pays avec un seul taux fixe de taxe sur les salaires. Traiter cette complexité un holerite à la fois est défendable quand vous avez 5 employés. À 50, c'est intenable. À 1 200, c'est dangereux — car le coût d'une erreur non détectée en vertu de l'article 467 de la CLT est le double du montant sous-payé, et dans un lot aussi important, non détectée est l'état par défaut de la saisie manuelle.
Pour les fondamentaux d'un seul holerite — tranches progressives de l'INSS, retenue d'IRRF par tranche salariale, mécanismes du FGTS et le flux d'extraction étape par étape — commencez par notre guide pour extraire les données des fiches de paie brésiliennes vers Excel. Revenez ensuite ici quand vous serez prêt à exécuter ce même processus sur l'ensemble de votre paie, un lot à la fois.