ブラジルのNF-eノタ・フィスカル・エレトロニカ
XMLからExcelへの抽出
机の上にある印刷された書類、DANFE(ダンフィ)には、仕入先のNF-eに含まれるデータの10%未満しか記載されていません。明細ごとの税額計算、すべてのCFOP税務コード、すべてのNCM製品分類、そして仕入税額控除を決定するPIS/COFINSの完全な内訳、そのすべてがこの書類には記載されていません。完全な請求書は、ブラジルの仕入先がすでに生成しているXMLファイルであり、あなたが費用を支払っているのに活用していない500以上の構造化フィールドが含まれています。
重要なポイント
- あなたのAPチームがExcelに手入力しているDANFE(ダンフィ)は、貨物輸送中に高速道路の警察がバーコードをスキャンするために設計されたものであり、会計用ではありません。請求書データの90%が省略されており、ICMS(州売上税)とPIS/COFINS(連邦社会負担金)の税額控除回収を決定する明細ごとの税額内訳もすべて省略されています。
- 完全な請求書、つまり500以上の機械可読フィールドを持つNF-e XML(ノタ・フィスカル・エレトロニカ、ブラジルの電子請求書形式)は、ブラジルの法律により、商品が合法的に倉庫から出荷される前に、仕入先がデジタル署名して州税務当局であるSEFAZに提出することが義務付けられているため、すべての取引ですでに存在しています。
- ブラジルのERPローカライゼーションモジュールは必要ありません。NF-e XMLまたはDANFE(ダンフィ)をImageToTable.aiに取り込み、必要な列を一度定義するだけで、CFOP(税務操作コード)、NCM(製品分類)、ICMS金額など、すべての税務詳細を、XPathクエリを1つも書かずにExcelに取得できます。
このガイドと他のNF-eコンテンツとの関連性:このページは手法の比較です。3つの抽出アプローチ(ERPモジュール、XMLスクリプト、AI抽出)と、それぞれが復元できるフィールドについて説明します。完全な技術リファレンス(XMLフィールドマッピング表の全体、CST/CFOP/NCMコード表、ICMS-STの処理、イベント駆動型抽出(キャンセル、CC-e、緊急時))が必要な場合は、完全なNF-e抽出フィールドマッピングガイドをご覧ください。NF-eがまったく初めての方は、ノタ・フィスカル・エレトロニカ入門ガイドから始めてください。
DANFE(ダンフィ)の罠:なぜ多くの海外APチームが誤った書類を処理しているのか
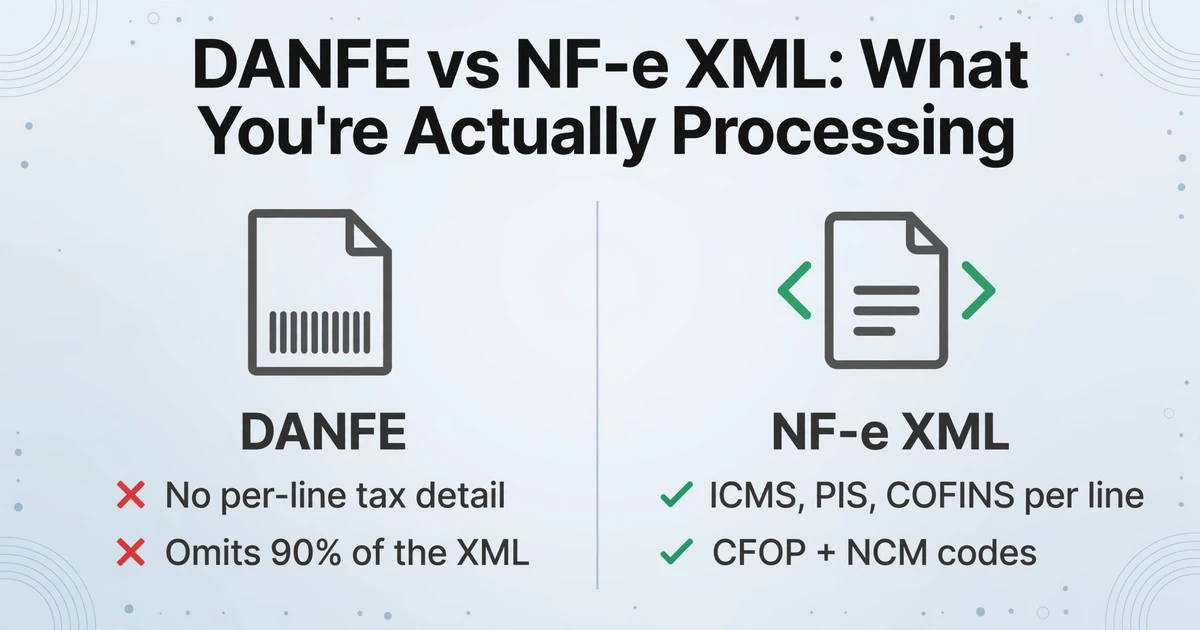
ブラジルのサプライヤーから出荷が到着すると、ドライバーはバーコードと右上に44桁の数字が印刷された書類を手渡します。これがDANFE(ダンフィ)— Documento Auxiliar da Nota Fiscal Eletrônica(ノタ・フィスカル・エレトロニカ補助文書) — であり、その名称に含まれる「補助」という言葉は飾りではありません。DANFEは、高速道路の検問所で税務当局がバーコードをスキャンして出荷内容を確認できるよう、物理的な商品に同行するという唯一の目的のために存在します。完全な請求書として設計されたものではないのです。
しかし、ブラジル製品を受け取る大多数の国際APチームにとって、DANFE(ダンフィ)こそが請求書となっています。スキャンされ、OCR処理され、または手作業でERPに入力されます。44桁のアクセスキーは、忠実に—全44桁—「請求書番号」というフィールドにコピーされます。そしてAP担当者は次の書類へと進みますが、すべてのベンダー、すべての出荷について、完全な請求書がすでに機械可読なXML形式で存在していることに気づいていません。そのXMLは、商品が合法的に倉庫を出る前に、ブラジル政府が売り手に対して生成、ICP-Brasil証明書によるデジタル署名、SEFAZ(州税務当局)への提出を義務付けているものです。
データ損失の規模は軽微ではありません。DANFE(ダンフィ)には要約情報—ベンダー名、購入者名、日付、数量と単価付きの明細項目、合計金額—が印刷されます。一方、NF-e XMLは、承認時にSEFAZが実行する400以上の自動検証ルールに準拠し、現在のレイアウトバージョン4.0(Nota Técnica 2016/002で定義)では500以上の構造化タグを含んでいます。この2つの書類の違いは、レシートと取引の完全な税務記録との違いです—それは、あなたの仕入税額控除、税関調整、そして今後5年間の監査証跡を左右するものです。
DANFE(ダンフィ)とXMLの区別は、些細な技術的詳細ではありません。ブラジルのベンダー請求書を扱うあらゆるAP部門にとって最も重要な概念であり、直接的な財務的影響を伴います:もしあなたのチームがDANFE(ダンフィ)からデータを入力しているなら、構造化され機械可読な形式ですでに存在する情報の一部を手作業で再入力していることになり、さらに、すべての取引でICMS、IPI、PIS、COFINSの正しい金額を回収しているかどうかを左右する税務詳細を見逃していることになるのです。
NF-e XMLの中身 — なぜAPにとって重要なのか
NF-e XMLは、単なる山括弧で書かれた請求書ではありません。売り手の電子署名が付与され、SEFAZの400以上のルールに照らして検証済みの、法的に有効な税務文書です。また、ブラジル国外の電子請求書標準を超える粒度で税データを保持しています。比較すると、欧州のPeppol BIS標準は約100の要素を使用しますが、NF-eはその5倍の要素を持ち、すべてが機械可読です。
抽出ワークフローを設計する前に、何を抽出するのかを理解する必要があります。以下は、すべてのNF-e XMLに含まれる主要な要素グループと、それぞれが買掛金管理にとって重要な理由です。
| XML要素グループ | 内容 | AP(買掛金)担当者に必要な理由 |
|---|---|---|
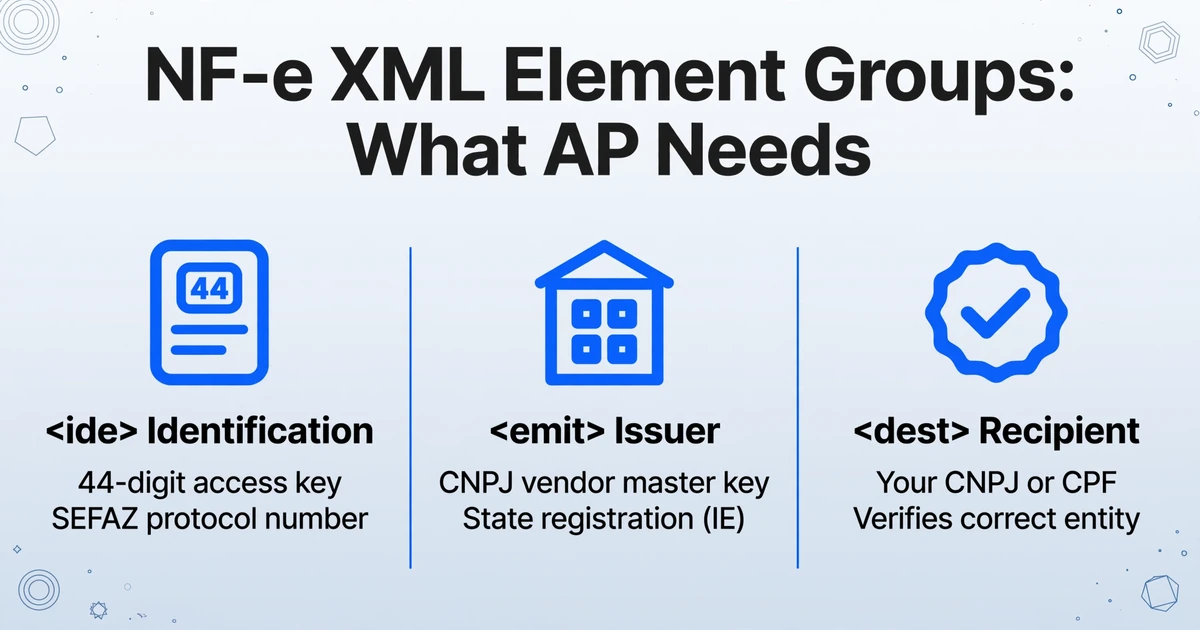
<ide>(識別) | 44桁のアクセスキー、文書モデル(55=NF-e)、シリーズ、番号、発行日時、発行区分、SEFAZ認証プロトコル | すべてのNF-eをグローバルに一意に識別します。プロトコル番号はSEFAZ認証を確認します。アクセスキーを使用していつでも真正性を検証できます。 |
<emit>(発行者) | CNPJ(14桁の法人税ID)、法人名、商号、IBGE市区町村コードを含む完全な住所、州登録番号(Inscrição Estadual(州登録番号)) | CNPJは仕入先マスターキーであり、サプライヤー記録と一致します。州登録番号は、どのSEFAZ管轄が取引を所管するかを決定します。 |
<dest>(受領者) | 貴社のCNPJまたはCPF、法人名、住所、州登録番号、ISUF(税額控除代替指標) | 請求書が貴社の正しいブラジル法人宛に発行されたことを検証します。税額控除の適格性に重要です。 |
<det>(明細行) | 製品コード、説明、NCM(8桁のメルコスール分類)、CFOP(4桁の fiscal 取引コード)、数量、単価、行合計 | 各行には独自のNCMとCFOPが含まれます。この2つのコードが適用税率と控除適格性を決定します。これらはDANFE(ダンフィ)には表示されません。 |
<imposto>(税金) | ICMS(課税標準、税率、金額、CST課税状況コード、原産地)、IPI(課税標準、税率、金額、CST)、PIS(課税標準、税率、金額、CST)、COFINS(課税標準、税率、金額、CST) | 明細行レベルでの完全な税計算。ICMS税率は発送元と発送先の州によって異なります(州間:4%、7%、12%、州内:17%〜22%)。PIS/COFINSは連邦税額控除を決定します。これらはDANFE(ダンフィ)には一切表示されません。 |
<total>(合計) | ICMS合計、ICMS-ST(税額控除代替)合計、IPI合計、PIS合計、COFINS合計、運送費、保険料、割引、NF-e正味合計 | すべての税集計の列ごとの内訳。ERPの税勘定と照合します。 |
<transp>(輸送) | 運送業者CNPJ、輸送モード、車両ナンバープレート、出荷量と重量 | 物流記録との3ウェイマッチング。運送費はICMS課税標準に影響します。 |
<cobr>(請求) | 支払条件、分割払い日と金額、銀行詳細 | APの支払いスケジュール管理。ブラジルの請求書には複数回の分割払い構造(duplicatas(分割払い手形))が含まれることがよくあります。 |
44桁のアクセスキー(chave de acesso(アクセスキー))は、NF-eの普遍的な識別子です。発行元の州(最初の2桁、IBGEコードに基づく — サンパウロは35、リオデジャネイロは33、ミナスジェライスは31)、発行年月(次の4桁)、発行元のCNPJ(次の14桁)、文書モデル(2桁)、系列(3桁)、連番(9桁)、発行タイプ(1桁)、ランダムな衝突回避コード(8桁)、モジュロ11チェックディジット(1桁)をエンコードしています。すべてのNF-e XMLは、このキーを<infNFe Id="NFe...>属性に保持しており、このキーを使ってSEFAZに直接照会し、真正性の検証、取消しの確認、またはベンダーがDANFEのみを送信した場合の完全なXMLのダウンロードが可能です。
DANFEは請求書ではありません。XMLこそが請求書です。ブラジルの税法では、署名済みXMLを取引の法的に権威のある記録として最低5年間保存することが義務付けられています。DANFE — 普通紙に印刷され、署名がなく、データの一部のみを含む — は、商品輸送中の物理的検査要件を満たすためだけに存在します。あなたの買掛金チームがDANFEから仕訳を登録している場合、ブラジルの税法が補足的なものとみなす文書に基づいて監査証跡を構築していることになります。
NF-e XML抽出ワークフローの設定
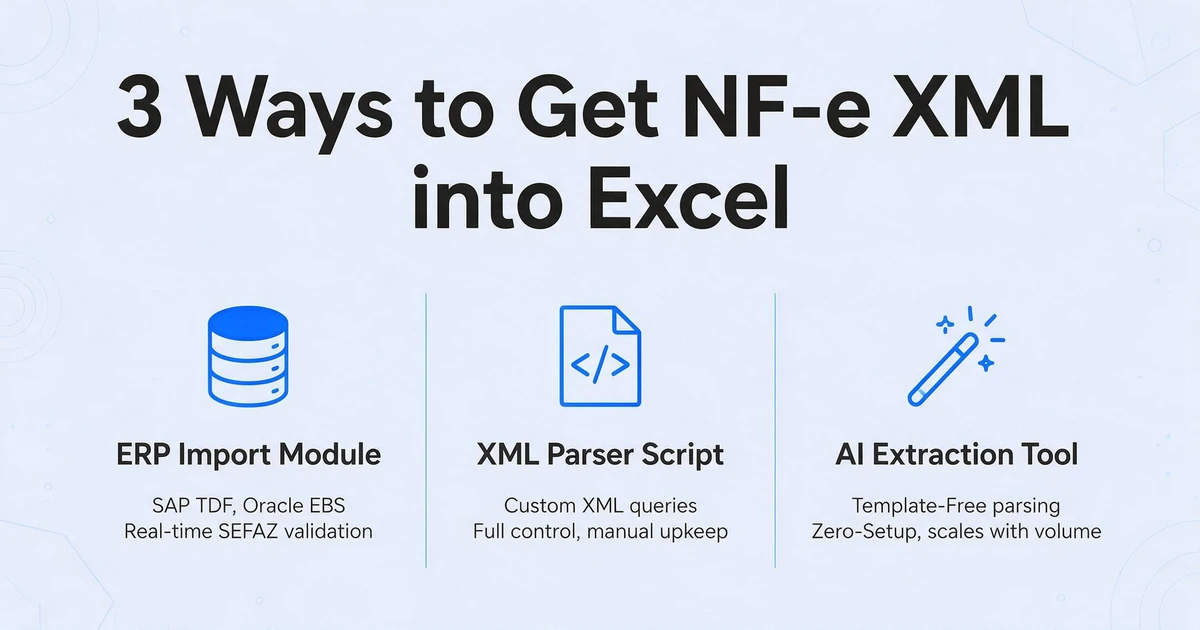
NF-e XMLデータをExcelスプレッドシートに取り込むには3つの異なるアプローチがあり、コストと複雑さのスペクトラム上で非常に異なる位置にあります。どれが適しているかは、ボリューム、ERP環境、そしてブラジル子会社がすでにローカライゼーションモジュールを運用しているかどうかによって異なります。
方法1:ERPインポートモジュール(SAP TDF、Oracle EBS Brazil、Dynamics 365 Finance)
貴社がSAP、Oracle EBS、またはMicrosoft Dynamics 365をブラジルローカライゼーションモジュールを有効にして運用している場合、ERP自体がNF-e XMLファイルを直接インポートできます。SAPのTDF(Nota Fiscalモジュール)は、トランザクションJ1BNFEを通じて受信したNF-e XMLを処理し、各XML要素を対応するSAPテーブルにマッピングします。Oracle EBS Brazilローカライゼーション(12.2.6以降で利用可能)は、インポートにXML Generator SEFAZプログラム(P76B601)を使用します。Dynamics 365 Financeは、買掛金勘定>ブラジルローカライゼーション>NF-e XMLのインポートの下に専用のインポートワークフローを提供します。
これはゴールドスタンダードです。SEFAZに対してリアルタイムで検証し、正しい税勘定に転記し、三者照合を自動的に処理します。ただし、それなりのコストがかかります。SAPおよびOracle Brazilローカライゼーションモジュールは別途ライセンス費用がかかり、ブラジル中堅企業市場で支配的なERPであるTOTVS(最新のFundação Getúlio Vargas(FGV、ジェトゥリオ・ヴァルガス財団)調査によると33%の市場シェア)は、完全にブラジルに特化しており、国外ではあまり一般的ではありません。貴社のグローバルAPチームにブラジルのERPローカライゼーションがない場合、このアプローチは利用できません。
方法2:XMLからExcelへの変換
最も基本的なレベルでは、NF-e XMLはXMLファイルであり、あらゆるXMLファイルをスプレッドシート形式に変換できます。Microsoft Excelの組み込みXMLインポート(データ>データの取得>ファイルから>XMLから)、オンラインコンバーター、またはxml.etree.ElementTreeなどのライブラリを使用したPythonスクリプトなどのツールは、XML構造を行と列にフラット化できます。
汎用XML変換の課題は、NF-eスキーマの深さです。単一のNF-e XMLは、明細データを<det>要素内にネストし、各要素には独自の<imposto>サブツリーがあり、ICMS、IPI、PIS、COFINSグループがそれぞれ分かれています。単純なXMLからCSVへの変換では、これを数百の列を持つ単一の行にフラット化し、多くは同じ名前になります(すべての明細にvProdフィールドがあり、すべての税グループにvBCフィールドがあります)。出力は技術的には「Excelにある」ものですが、大幅なクリーンアップなしでは使用できません。
明示的なXPathクエリを使用したPythonのxml.etreeまたはlxmlは、正確な制御を提供します。必要な要素だけを抽出し、名前付きの列にマッピングできます。これは開発リソースが利用可能な場合にうまく機能しますが、NF-eスキーマが更新されるたびに壊れるXPathマッピングの維持が必要です。2026年の税制改革でスキーマに新しいCBS/IBS要素グループが追加されるため(下記参照)、それらのマッピングの更新が必要になります。
方法3:AIを活用したドキュメント抽出
3つ目のアプローチは、ERPローカライズのコストとXPathスクリプトの脆弱性の両方を回避する方法で、AIベースのドキュメント抽出です。XMLを直接解析するのではなく、DANFE(ダンフィ)(またはベンダーのシステムでPDFにレンダリングされたNF-e XML)を抽出ツールにアップロードし、出力テーブルに含めたい列(「CNPJ」「請求書番号」「ICMS課税標準」「ICMS税額」「NCMコード」「CFOP」など)を指定するだけで、AIがドキュメントを読み取り、ページ上のどこに表示されているかに関係なく各値を特定します。
このアプローチは、カスタム列抽出と呼ばれることもあり、テンプレートベースのOCRとは動作が異なります。従来のOCRでは、サプライヤーごとの請求書レイアウトにテンプレートを定義し、「請求書番号は常に座標(x,y)にある」とシステムに指示する必要があります。レイアウトが変更されると、テンプレートは機能しなくなります。一方、列ベースの抽出は意味理解によって機能します。必要なフィールドに名前を付けると、AIはフィールドが何を意味するかを理解してドキュメント内のどこからでも対応する値を見つけ出します。これは、ブラジルのサプライヤーのDANFEレイアウトが大きく異なるため、NF-e処理に特に関連性が高いです。標準化された視覚的テンプレートは存在せず、その下にある標準化されたXMLスキーマのみが存在します。
正直なところ、この方法の限界は、機械可読なXMLではなく、DANFEの視覚的レイアウトから抽出しているという点です。取得できるのはDANFEに表示されているデータの10%であり、XML内の500以上のフィールドではありません。多くのAPユースケース(ヘッダーデータ、明細項目、合計)では、これで十分であり、手入力よりもはるかに高速です。ただし、XMLにのみ存在するPIS/COFINSの明細ごとの計算、CFOPコード、CST課税状況コードなどが必要な場合、DANFEからのAI抽出では、ページに印刷されていないデータを復元することはできません。
| 方法 | 抽出できるもの | コストレベル | セットアップ工数 | 継続的なメンテナンス |
|---|---|---|---|---|
| ERPインポートモジュール | XMLフィールドの100% — 完全な税務詳細、CFOP、NCM、CST、輸送、請求 | エンタープライズ(ライセンス+実装) | 高 — ローカライズモジュールの導入が必要 | 中 — ERPバージョンアップに伴うスキーマ更新 |
| XMLからExcel(スクリプト/コンバーター) | XMLフィールドの100% — XPathを作成する任意の要素 | 低(開発時間または無料ツール) | 中 — XPathマッピング、スキーマ知識が必要 | 高 — スキーマ変更でXPathクエリが破損。2026年のCBS/IBSフィールドは書き換えが必要 |
| DANFEからのAI抽出 | DANFEに印刷されているすべて(XMLデータの10%):ヘッダー、明細項目、合計、アクセスキー | 低(ドキュメント単位またはサブスクリプション) | 低 — 列名を定義し、ドキュメントをアップロードするだけ | 最小限 — 維持するテンプレートなし。レイアウト変更はAIが処理 |
| 手動データ入力 | AP担当者が入力する時間があるものすべて | 隠れたコスト — 1ページあたり3分の人件費、自動抽出の約18倍遅い | なし | 量が増えるとエラー率も悪化 |
NF-eフィールドをスプレッドシートにマッピング:抽出すべき項目とその理由
XML解析用のXPathクエリを作成する場合でも、AI抽出用の列名を定義する場合でも、選択する列が出力の有用性を左右します。ここでは、ベンダー検証、三者照合、税額控除の計上という3つの主要な買掛金(AP)ワークフローをカバーする実践的なフィールドマッピングを、実際のXML要素パスを使用して紹介します。
| スプレッドシートの列 | NF-e XML要素(XPath) | 用途 |
|---|---|---|
| 請求書番号 | /nfeProc/NFe/infNFe/ide/nNF | 文書識別 |
| アクセスキー | /nfeProc/NFe/infNFe/@Id("NFe"以降の44桁を抽出) | SEFAZ検証、取消確認、XML取得 |
| 発行日 | /nfeProc/NFe/infNFe/ide/dhEmi(ISO 8601日時、現地日付に変換) | 予約日、支払条件計算 |
| 承認日 | /nfeProc/NFe/infNFe/ide/dhSaiEnt | 実際の出荷日 — SEFAZ承認はこのタイムスタンプ以前 |
| 供給者CNPJ | /nfeProc/NFe/infNFe/emit/CNPJ | 仕入先マスタ照合(14桁、書式なし) |
| 供給者名 | /nfeProc/NFe/infNFe/emit/xNome | 仕入先確認 |
| 供給者州IE | /nfeProc/NFe/infNFe/emit/IE | 州税登録 — ICMS管轄を決定 |
| 明細NCM | /nfeProc/NFe/infNFe/det[n]/prod/NCM | 製品分類 — IPI税率と輸入関税適用の有無を検証 |
| 明細CFOP | /nfeProc/NFe/infNFe/det[n]/prod/CFOP | 税務取引種別 — 税務処理とクレジット適格性を決定 |
| 明細説明 | /nfeProc/NFe/infNFe/det[n]/prod/xProd | 発注照合 |
| 数量 | /nfeProc/NFe/infNFe/det[n]/prod/qCom | 入庫照合 |
| 単価 | /nfeProc/NFe/infNFe/det[n]/prod/vUnCom | 発注価格照合 |
| 明細合計 | /nfeProc/NFe/infNFe/det[n]/prod/vProd | 明細金額検証 |
| ICMS課税標準 | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/vBC(ICMSサブグループにより異なる) | 税額控除計算 — 発地・着地州ペアのICMS税率と一致する必要あり |
| ICMS税率 | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/pICMS | 正しい州税率と照合(南部・南東部州間12%、その他地域へ7%、輸入4%、州内17%~22%) |
| ICMS金額 | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/vICMS | 計上する実際のICMSクレジット |
| ICMS CST | /nfeProc/NFe/infNFe/det[n]/imposto/ICMS/*/CST | 税務状況 — 00=課税、40=免除、60=既課税など |
| IPI金額 | /nfeProc/NFe/infNFe/det[n]/imposto/IPI/*/vIPI | 連邦物品税 — 工業事業者はクレジットとして回収可能 |
| PIS金額 | /nfeProc/NFe/infNFe/det[n]/imposto/PIS/*/vPIS | 連邦社会負担金 — 非累積方式1.65% |
| COFINS金額 | /nfeProc/NFe/infNFe/det[n]/imposto/COFINS/*/vCOFINS | 連邦社会負担金 — 非累積方式7.6%、最大の連邦税項目 |
| 請求書合計 | /nfeProc/NFe/infNFe/total/ICMSTot/vNF | 正味請求額 — 支払金額 |
重要な詳細:ICMS要素のパスは課税状況によって異なります。NF-eスキーマはICMSの区分ごとに異なるXMLサブグループを使用します — ICMS00は標準課税取引、ICMS40は免税、ICMS60は税額控除済みの課税代替です。抽出ロジックはこの分岐構造をナビゲートする必要があります:<ICMS>の下にどのサブグループが存在するかを確認してから、その子要素の読み取りを試みてください。
抽出データにおけるブラジルの税制複雑性への対応
データの抽出は最初のステップです。実際の作業は検証から始まります — そして、税務監査中に表面化するエラーのほとんどはここで発生します。ブラジルの税制は3つの政府レベル(連邦、州、市)にわたって運用され、税率は製品分類、発地・着地の組み合わせ、取引の法的性質によって異なります。以下は、NF-eデータ抽出ワークフローに含めるべき検証チェックです:
州ペア別のICMS税率検証
ICMS税率は一律ではありません。州間取引の場合、税率は発地州と着地州によって決定されます:
| 発地(発地地域) | 着地(着地地域) | 州間ICMS税率 |
|---|---|---|
| 南部・南東部(SP、RJ、MG、RS、SC、PR、ES) | 南部・南東部 | 12% |
| 南部・南東部 | 北部・北東部・中西部+エスピリトサント州 | 7% |
| 北部・北東部・中西部 | 全州 | 12% |
| 全州(外国産材含有率40%超の輸入品) | 全州 | 4% |
州内取引の場合、税率は州によって17%から22%の範囲です。2024年時点で、ペルナンブコ州は20.5%、バイーア州は20.5%、マラニョン州は22%、リオデジャネイロ州は20%、サンパウロ州は18%、サンタカタリーナ州は17%です。これらの税率は2024年だけで11州で変更されました — バイーア州は2月7日に19%から20.5%へ、マラニョン州は2月19日に20%から22%へ引き上げられました — 抽出検証ロジックは、請求書を受け取るすべてのブラジル州の最新の税率表に追従している必要があります。
CFOPコードの解釈
CFOP(Código Fiscal de Operações e Prestações)は、取引の税務上の性質を分類する4桁のコードです。SEFAZによって事前に定義されており、自由記述ではありません。先頭の桁で、これが入荷か出荷か、および商品の原産州がわかります。
| CFOPプレフィックス | 意味 | 例 |
|---|---|---|
| 1xxx | 入荷 — 州内 | 1101 = 工業化目的の購入(州内) |
| 2xxx | 入荷 — 他州から | 2101 = 工業化目的の購入(州間) |
| 3xxx | 入荷 — 海外から(輸入) | 3101 = 工業化目的の輸入 |
| 5xxx | 出荷 — 州内 | 5101 = 自社生産・組立品の販売(州内) |
| 6xxx | 出荷 — 他州へ | 6101 = 自社生産・組立品の販売(州間) |
| 7xxx | 出荷 — 海外へ(輸出) | 7101 = 自社生産・組立品の輸出 |
受取人にとって、入荷インボイス(1xxx、2xxx、3xxx)のCFOPは、ICMSおよびIPIの税額控除が利用可能かどうか、またそのルールを決定します。CFOP 1101(州内の工業化目的の購入)は、通常、内部税率での全額ICMS控除の対象となります。CFOP 1102(州内の再販目的の購入)は、異なる扱いとなる場合があります。そしてこれはCST(Código de Situação Tributária)と相互に関連します。CSTは、品目が課税(00)、非課税(40)、税額代替(60)、または特別制度の対象となるかを指定する2桁のコードです。CFOPはこれがどの種類の取引かを示し、CSTはどのように課税されるかを示します。両方を抽出し、相互検証する必要があります。
NCM分類とその下流への影響
NCM(メルコスール共通命名法)は、国際的なHSコードにメルコスール固有の2桁を追加した8桁のコードです。すべての明細行に表示され、その製品のIPI税率(連邦歳入庁が更新する400ページ以上のPDFであるTIPI表に掲載)、輸入関税率、そして重要なことに、標準的な税計算を上書きする税制上の優遇措置(軽減税率、みなし控除、または免除)の対象となるかどうかを決定します。
税制優遇措置の対象となるNCMコードは、請求書に表示されている標準のICMSまたはIPI税率が、実際に控除として計上すべき金額ではない可能性があることを意味します。抽出ワークフローでは、NCMが既知の優遇カテゴリに一致する明細行にフラグを立て、税務チームが総額の税率が正しいと単純に想定するのではなく、控除計算を検証できるようにする必要があります。
2026年の税制改革と抽出ワークフローへの影響
ブラジルの税制改革は、憲法改正第132/2023号により制定され、補完法第214/2025号により規制されており、国の間接税制度を根本的に再構築しています。5つの既存税(PIS、COFINS、ICMS、ISS、IPI)は、連邦レベルのCBS(財・サービス貢献)、州・市町村レベルのIBS(財・サービス税)、および健康や環境に有害とみなされる財に対する選択税(IS)からなる二重VATモデルに段階的に置き換えられています。
移行スケジュールは以下の通りです。
| 年 | 内容 | NF-e抽出への影響 |
|---|---|---|
| 2026年 | テスト段階:CBS 0.9%、IBS 0.1%を請求書に表示するが徴収はしない。新旧両方の税フィールドがXMLに存在。 | NF-eスキーマが拡張され、既存の<ICMS>、<PIS>、<COFINS>グループに加えて、新しい<CBS>および<IBS>要素グループが追加。抽出ロジックは二重スキーマを処理する必要がある。 |
| 2027年 | CBSの徴収開始、PISとCOFINSを置き換え。IPI税率の段階的引き下げ開始。 | 抽出では、どの税フィールドが会計上(実際の金銭的影響)で、どのフィールドが情報提供用(依然として存在するレガシーフィールド)かを区別する必要がある。 |
| 2029年 | IBSの段階的導入開始、州ごとにICMSとISSを置き換え。二重制度:一部の州はレガシーICMS、他の州はIBS。 | 州ごとの税率変動の問題が深刻化。売り手の州の移行状況に応じて、ある請求書はICMS、別の請求書はIBSとなる。 |
| 2033年 | 完全実施:ICMS、ISS、PIS、COFINS、IPIを廃止。CBS、IBS、選択税のみが残る。 | XMLスキーマが安定。抽出マッピングを最終的なフィールドセットに統合できる。 |
APチームにとって当面の運用上の懸念は、2026年から2033年までのデュアルスキーマ期間です。この期間中、NF-e XMLファイルには従来の税要素グループと新しい税要素グループが同時に含まれます。2026年以前のスキーマにハードコードされたフィールドマッピング(vICMS、vPIS、vCOFINSのみを読み取る)を使用する抽出ワークフローでは、新しいCBS/IBSフィールドが黙って無視されます。これは将来の問題ではなく、今始まっています。2026年8月1日以降、CBS/IBSフィールドなしで提出されたNF-e XMLはSEFAZによって拒否されます。スキーマ変更は必須であり、オプションではありません。
XML解析スクリプトを作成している場合は、スキーマ分岐を計画してください。ドキュメントに存在する税グループを検出し、存在するものを抽出し、一貫した出力列セットに正規化します。DANFEからAIベースの抽出を使用している場合は、CBS/IBSフィールドが印刷表現に表示され始めたときに認識されるかどうかをプロバイダーに確認してください。
よくある質問
DANFEだけで完全なXMLデータを取得できますか?
いいえ。DANFEは印刷された要約であり、XML内のデータの90%以上が省略されています。これは輸送中の物理的な検査用に設計されたものであり、財務処理用ではありません。完全な税内訳、CFOPコード、NCM分類、CST税状況コード、輸送詳細はXMLにのみ存在します。ベンダーがDANFEのみを送信した場合は、XMLを依頼してください。法的に提供が義務付けられており、DANFEに印刷された44桁のアクセスキーを使用してSEFAZから取得することもできます。
特定の請求書にどのICMS税率が適用されるかを知るにはどうすればよいですか?
NF-eのICMS税率は、発行元の州(<emit>内の発行者の州登録から抽出)、宛先の州(<dest>内のエンティティの州)、および商品に40%を超える輸入含有量があるかどうか(州の組み合わせに関係なく4%の税率が適用される)によって決定されます。XML自体には、売り手が適用した税率がpICMSに含まれていますが、売り手が正しく適用したと想定するのではなく、正しい税率表に対して検証する必要があります。税率の誤りは一般的な監査指摘事項です。
AIはCFOPコードを自動的に正しく解釈できますか?
CFOPコードは文書からそのまま抽出されます。4桁のコードはDANFEとXMLに表示されます。ツールがコードを解釈できるか(例:「州内購入(再販用)」と「州間購入(工業化用)」の区別)は、ツールの機能に依存します。一部のAI抽出ツールは、参照テーブルを使用してCFOPコードを説明にマッピングできます。解釈がワークフローに不可欠な場合は、ツールプロバイダーにCFOPマッピング対応を確認するか、抽出したコードをデコードするための別のExcelルックアップテーブルを維持してください。
当社にはブラジルのERPローカライゼーションがありません。それでもNF-eデータを抽出できますか?
はい。XML自体は標準形式のファイルであり、XMLファイルがあればどの企業でも解析できます。SAP TDFやOracle Brazilローカライゼーションは不要です。Pythonスクリプト、オンラインのXML-to-Excel変換ツール、またはAI抽出ツールを使用して、データをスプレッドシートに取り込むことができます。ERPローカライゼーションモジュールは統合(自動転記、SEFAZ検証、税勘定マッピング)を追加しますが、抽出には必須ではありません。
NF-e抽出はSPED報告要件をカバーしますか?
いいえ。SPED(Sistema Público de Escrituração Digital)はブラジルのデジタル簿記システムであり、州税のEFD-ICMS/IPI、PIS/COFINSのEFD-Contribuições、デジタル会計帳簿のECDなど、個別の申告が必要です。NF-e抽出は請求書データをExcelに取り込みますが、SPED準拠のファイルは生成しません。SPED申告には、抽出したデータを特定のSPEDレイアウトコードにマッピングし、政府認定ソフトウェアを通じて提出する必要があります。これは、ブラジルの会計チームまたは税務コンプライアンスプロバイダーが処理する別のワークフローです。
ベンダーがデータ抽出後にNF-eをキャンセルした場合はどうなりますか?
NF-eは、商品がまだ出荷されていない場合、発行者が認可から24時間以内にキャンセルできます。キャンセルにより、同じ44桁のアクセスキーにリンクされたイベント(キャンセルイベント)がSEFAZのシステムに作成されます。そのキーに対するクエリは、キャンセルされたステータスを返します。抽出ワークフローは、特に支払期日近くの請求書について、定期的にSEFAZに対してアクセスキーを検証し、キャンセルされた文書に対する仕訳入力を回避する必要があります。2026年の改革では、課税事象後のキャンセルには税額の66%の罰金が科せられるため、遅延キャンセルの頻度は減少するはずですが、検証は引き続き必要な管理策です。
複数のNF-e XMLファイルを一括抽出するにはどうすればよいですか?
XMLベースの方法では、XMLファイルのディレクトリをループ処理するスクリプトを使用し、各ファイルから同じXPathクエリでデータを抽出して、結果を累積スプレッドシートに追加します。DANFE PDFからのAI抽出の場合は、バッチ処理機能を利用してください。複数のDANFEファイルをまとめてアップロードし、列定義を一度指定するだけで、各ドキュメントからデータを抽出し、結果を1つのExcelファイルに統合します。この方法は混合形式にも対応します。一部のベンダーがDANFE PDFを送信し、他のベンダーがXMLを印刷したものを送信する場合でも、バッチ処理は両方から同時に抽出します。
NF-eデータ抽出の精度は手動入力と比べてどのくらいですか?
XMLベースの抽出では、対象フィールドの精度は実質100%です。これは、視覚的なレイアウトを解釈するのではなく、機械可読ファイルから構造化データを読み取るためです。DANFEからのAI抽出では、印刷テキストの精度は最大99%に達しますが、44桁のアクセスキーのような複雑なフィールド(1桁の誤りでキーが無効になる)の精度は、長い数値文字列の処理方法に依存します。手動入力に対する真の精度向上は、文字レベルの正確さだけではありません。完全性が重要です。人間がDANFEからデータを入力する場合、通常1枚の請求書あたり8~12フィールドを取得します。自動抽出では、すべてのドキュメントから指定したすべてのフィールドを取得するため、手動入力で最も一般的で見落とされがちなエラーであるデータの欠落を排除します。
DANFE(ダンフィ)からスプレッドシートへ
印刷されたDANFE(ダンフィ)を処理する場合とNF-e XMLから抽出する場合とでは、データ品質の向上は漸進的なものではありません。10項目と500項目の違いです。さらに重要なのは、ブラジルの税額控除を推測するか、検証するかの違いです。ベンダーが生成するすべてのNF-e XMLには、回収資格のある正確なICMS、IPI、PIS、COFINSの金額が含まれており、DANFE(ダンフィ)のみから処理する場合、その詳細は読まれないままになります。